MineDraft: A Framework for Batch Parallel Speculative Decoding
MineDraft:批量并行推测解码框架
MineDraft: A Framework for Batch Parallel Speculative Decoding
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MineDraft: A Framework for Batch Parallel Speculative Decoding |
| 作者 | Zhenwei Tang, Arun Verma, Zijian Zhou, Zhaoxuan Wu, Alok Prakash, Daniela Rus, Bryan Kian Hsiang Low |
| 机构 | MIT, NUS |
| 论文 | https://arxiv.org/abs/2603.18016 |
| 发布 | 2026-02-24 |
| 类别 | cs.CL (计算语言学), cs.AI, cs.DC, cs.LG |
核心亮点
- 批量并行推测解码(Batch Parallel SD):将drafting和verification重叠执行
- 吞吐量提升最高75%:相比标准SD
- 延迟降低最高39%:相比标准SD
- vLLM插件实现:可直接集成到生产级推理系统
二、核心思想
问题定义
推测解码(Speculative Decoding, SD)通过使用较小的draft模型提出draft tokens,然后由较大的target模型验证,从而加速LLM推理。然而,标准SD的性能受限于drafting和verification阶段的严格顺序执行。
解决方案概述
本文提出MineDraft,一个批量并行推测解码(PSD)框架,通过重叠drafting和verification来隐藏drafting延迟。
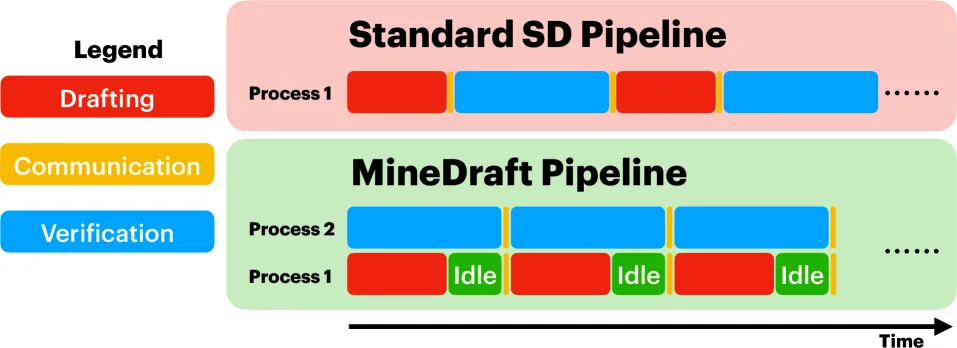
Figure 1: MineDraft并行化drafting和verification:draft模型生成tokens的同时,target模型并行验证之前生成的draft tokens,从而隐藏drafting延迟并提高整体推理吞吐量。
核心设计:维护两个batch的requests,一个batch进行drafting的同时另一个batch进行verification,交替执行。
三、技术架构
3.1 理论效率分析
Drafting Pareto Frontier:设 为draft模型的Pareto frontier,表征给定drafting时间预算下可达到的最大verification success rate。
标准SD的推理时间:
其中 是总token数, 是每步drafting时间, 是每步verification时间。
PSD的推理时间:
理论保证(Theorem 1):设 ,当 时:
即PSD相比标准SD至少实现37%的推理时间减少。
3.2 MineDraft架构
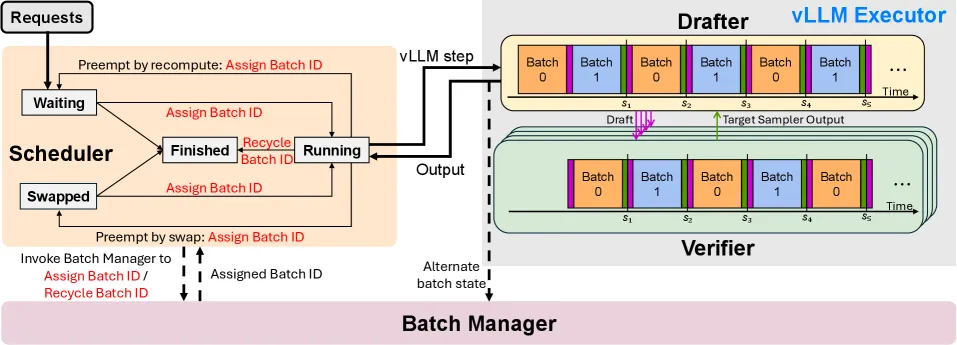
Figure 2: MineDraft架构概述。(左) Scheduler管理request生命周期和batch ID,与Batch Manager协调,Batch Manager维护两个batch以实现并行。(右) Drafter和Verifier在推测解码步骤间的并行执行时间线。品红色块/箭头表示从Drafter到Verifier的draft广播,深绿色块/箭头表示从Verifier到Drafter的target sampler输出点对点分发。
四个核心组件:
| 组件 | 功能 |
|---|---|
| Batch Manager | 管理两个batch,分配batch ID,跟踪balance状态 |
| Scheduler | 管理request生命周期,KV block分配 |
| Drafter | Draft模型,生成draft tokens |
| Verifier | Target模型,验证draft tokens |
3.3 Batch Manager
状态变量:
- 每个request分配batch ID(0或1)
balance = |Batch 1| - |Batch 0|跟踪两个batch的不平衡度
Batch ID分配策略:
- 第一个SD步骤:如果
balance >= 0,新request分配到Batch 0;否则分配到Batch 1 - 后续步骤:新request分配到当前
skip_batch,确保仅在draft tokens可用时进行verification
Batch状态交替:
- 每个SD步骤结束时(sync point),
skip_batch切换到另一个batch - 目标batch(上一步的draft batch)由Verifier验证,同时Drafter为另一个batch生成draft tokens
3.4 Scheduler补丁
问题:vLLM默认scheduler假设所有running requests在每步都会生成,为所有request分配KV blocks。在Batch Parallelism下,这会导致draft batch的requests获得冗余分配。
解决方案:引入 has_deferred 集合跟踪延迟KV block分配的request IDs。修改后的分配逻辑:
- 当两个batch都非空时,跳过decoding stage requests的KV block分配
- 仅在verification时分配和填充KV blocks
效果:减少内存浪费,支持更大batch size。
3.5 执行流程
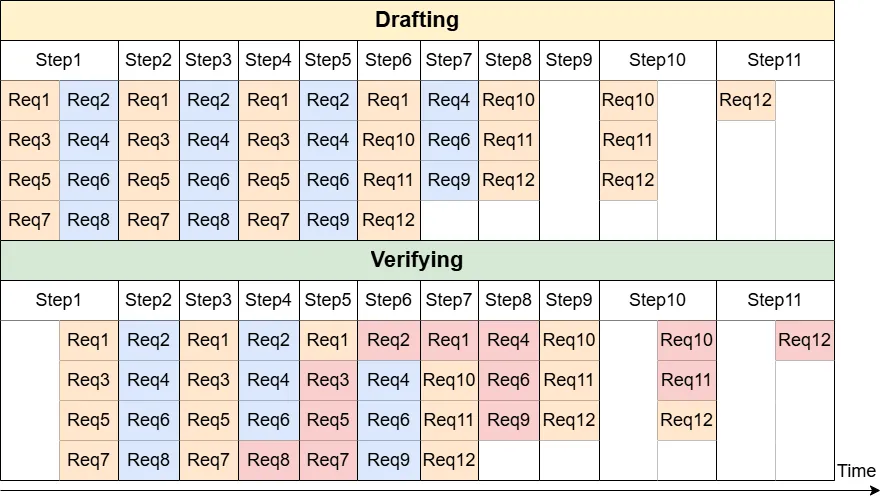
Figure 7: Batch Parallelism生命周期示例。橙色背景的requests属于Batch 0,蓝色背景属于Batch 1,红色背景已完成执行。
第一个SD步骤:
- Drafter为Batch 0生成drafts
- 广播drafts到Verifier
- Drafter同时为Batch 1生成drafts
- Verifier处理Batch 0并返回输出
后续SD步骤:
- Verifier验证上一步的draft batch
- Drafter同时为当前draft batch生成draft tokens
- 两个batch交替角色,实现重叠执行
Fallback机制:当一个batch变空时,回退到标准SD。
四、实验结果
4.1 实验设置
模型配置:
| 设置 | Target模型 | Draft模型 | GPU | Batch Size |
|---|---|---|---|---|
| 1 | Qwen3-32B | Qwen3-0.6B | 55× L40 | 16 |
| 2 | Qwen3-32B | Qwen3-1.7B | 55× L40 | 16 |
| 3 | Qwen3-32B | Qwen3-4B | 55× L40 | 16 |
| 4 | Qwen3-32B | Qwen3-8B | 55× L40 | 16 |
| 5 | Llama-3.3-70B-AWQ-INT4 | Llama-3.1-8B | 5× H100 | 64 |
| 6 | vicuna-33b-v1.3 | EAGLE-Vicuna-33B | 5× L40 | 16 |
| 7 | vicuna-13b-v1.3 | EAGLE-Vicuna-33B | 5× L40 | 16 |
数据集:ShareGPT, Arena, LLM-Tough-Questions (Tough), Spec-Bench
4.2 吞吐量结果
Settings 1-3(Qwen3-32B + 小draft模型):
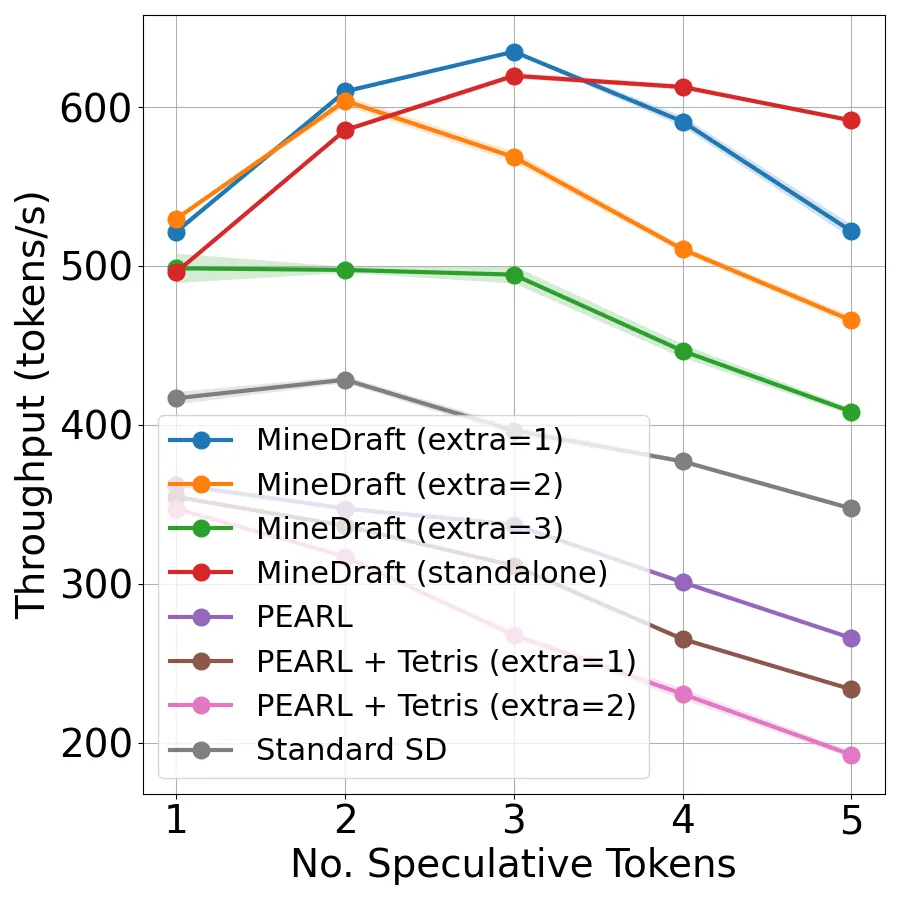
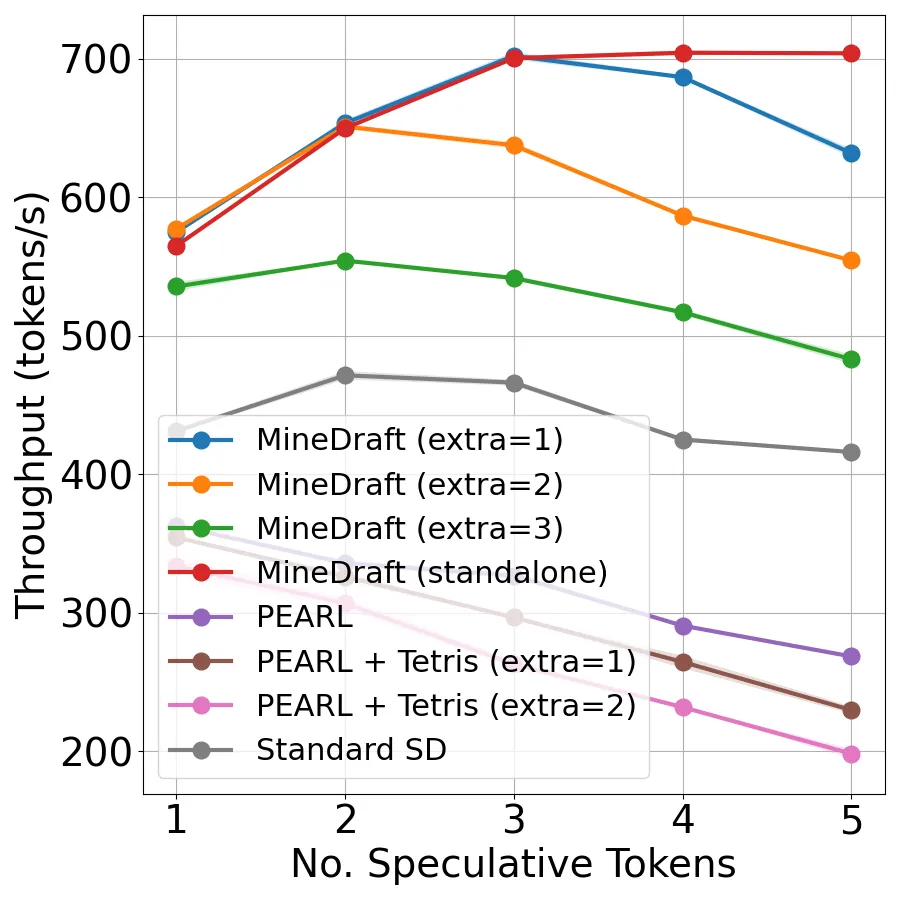
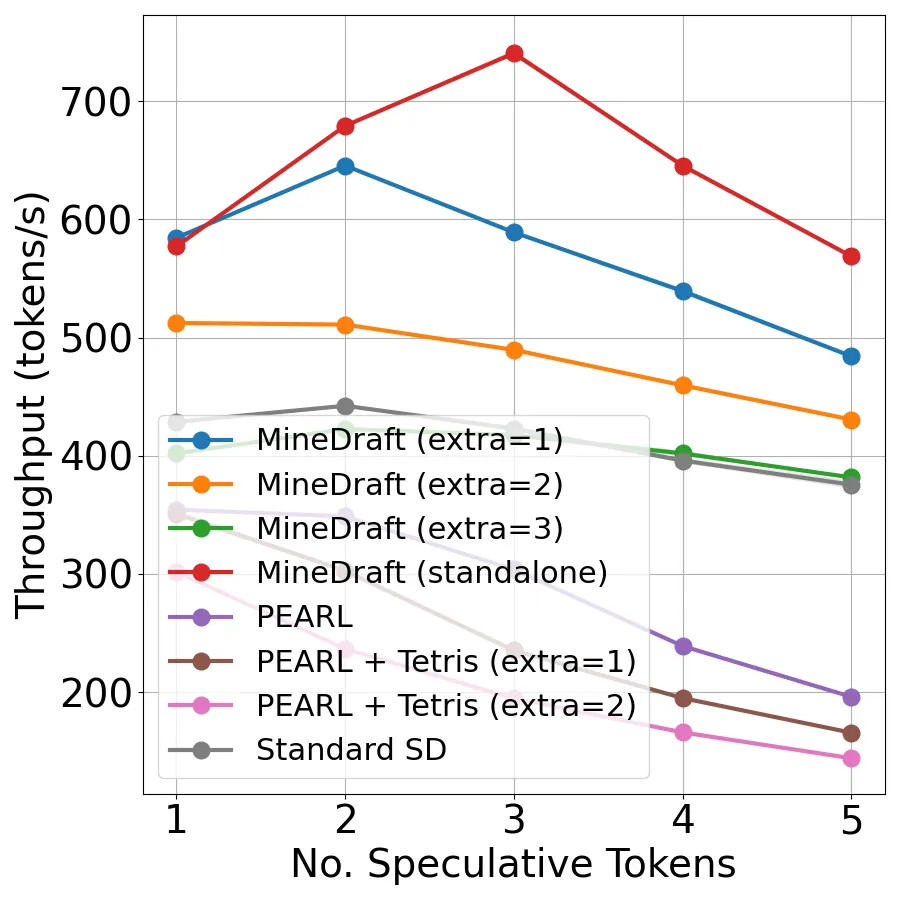
关键结果:
- MineDraft相比最佳baseline平均吞吐量提升38.62% - 65.02%
- 相比标准SD最大提升57.95% - 75.68%
Setting 5(Llama-70B + Llama-8B):
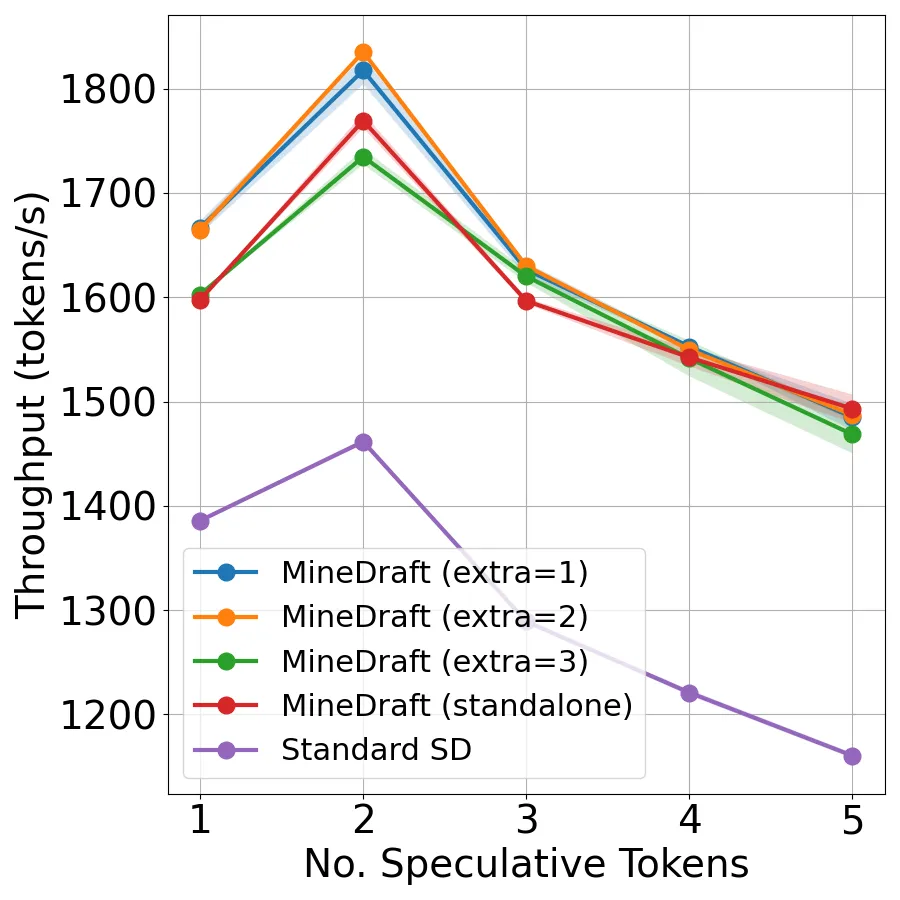
- 相比standalone EAGLE平均吞吐量提升37.06%
- 相比标准SD提升22.09%
Setting 4(Qwen3-32B + Qwen3-8B):
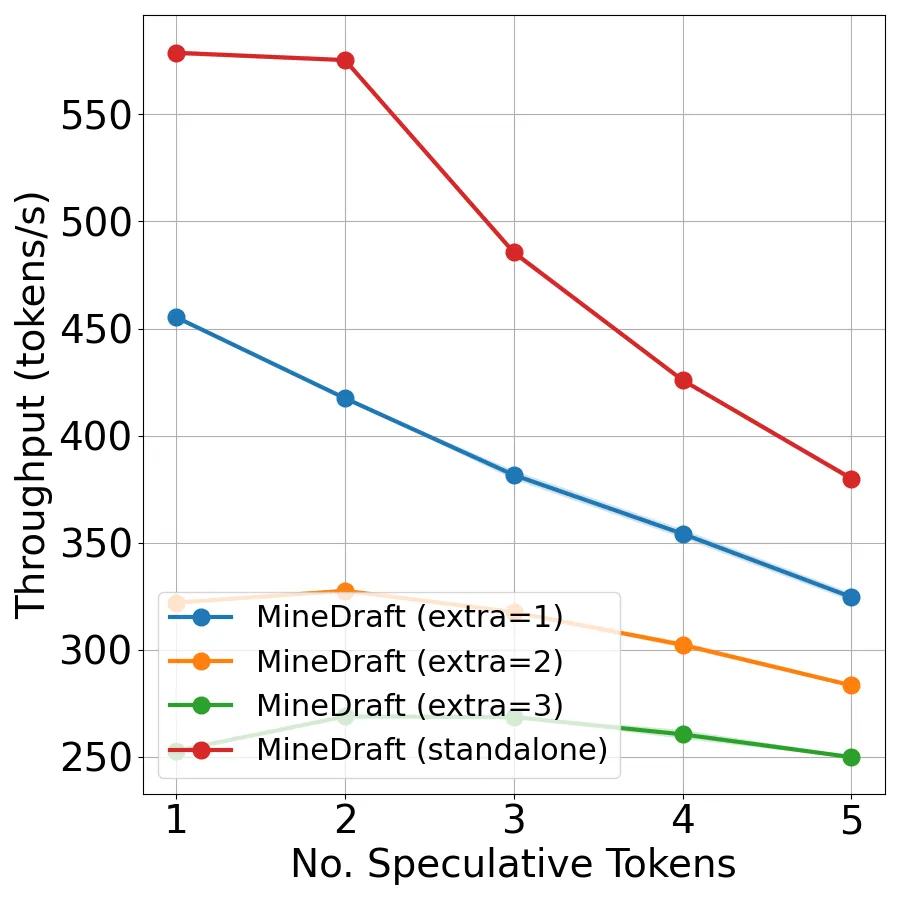
- 标准SD在此设置下因OOM失败
- MineDraft成功运行,展示了内存效率优势
4.3 延迟结果
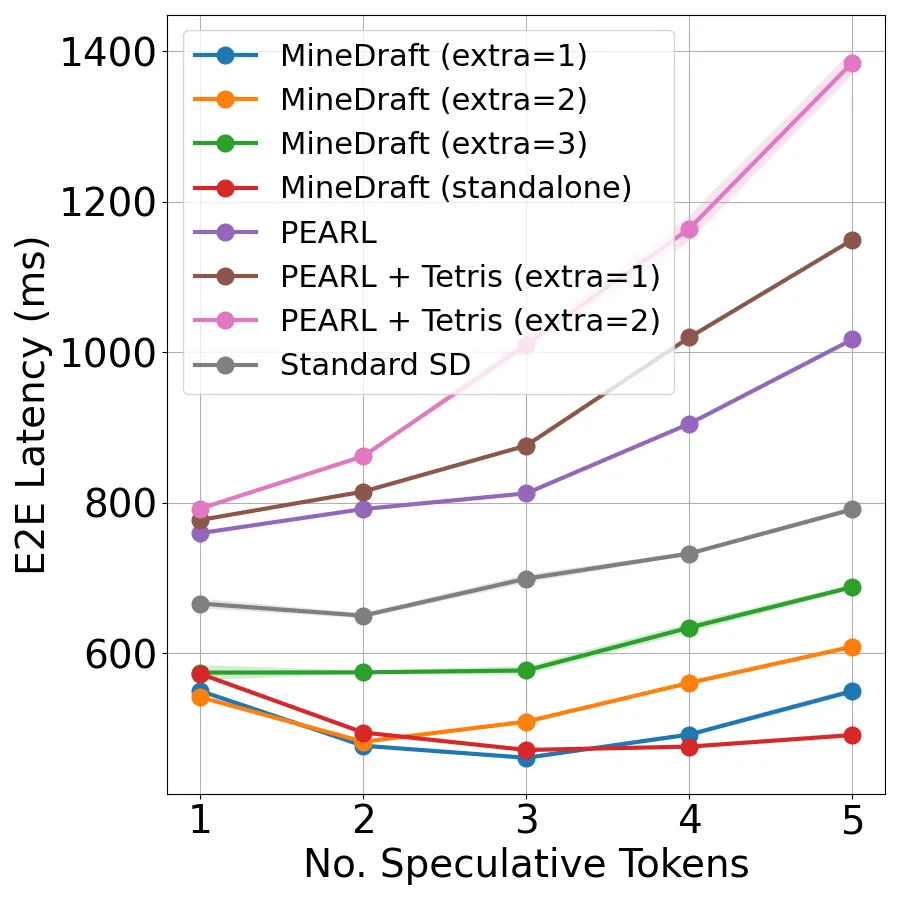
Figure 6(a): MineDraft相比baselines持续降低端到端延迟。
- 延迟降低最高39%
4.4 消融实验
Draft模型选择:
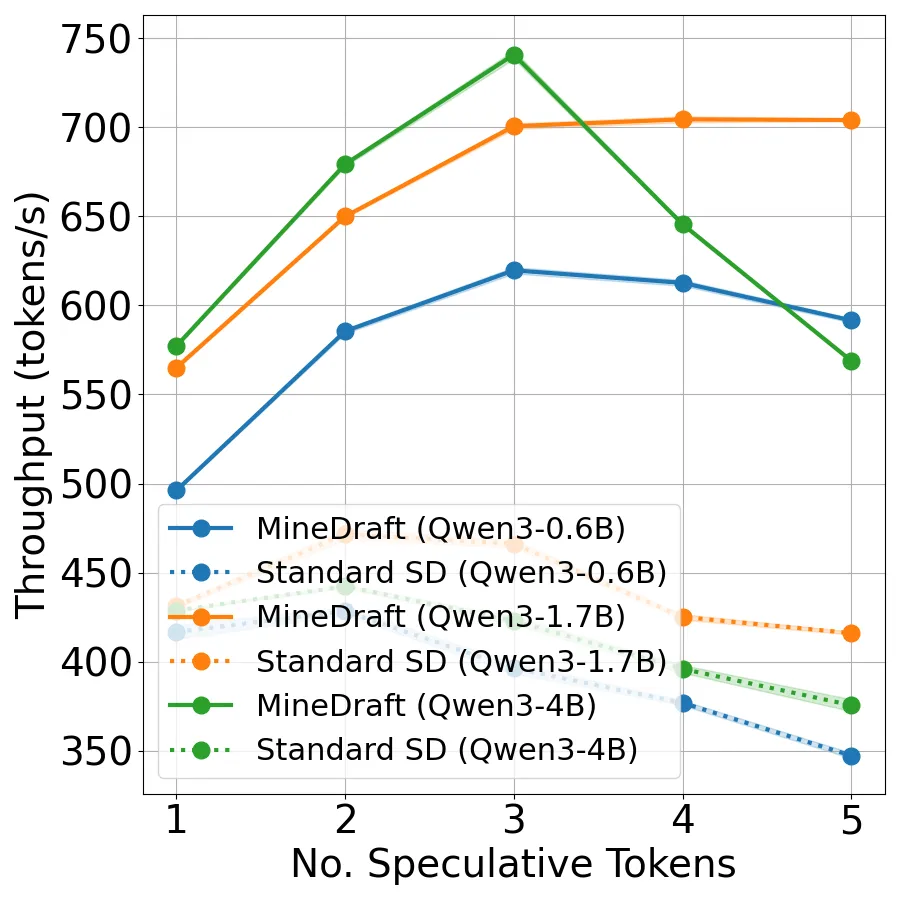
Figure 6(b): 不同draft模型影响MineDraft的并行收益。
Sequences per request (n)的影响:
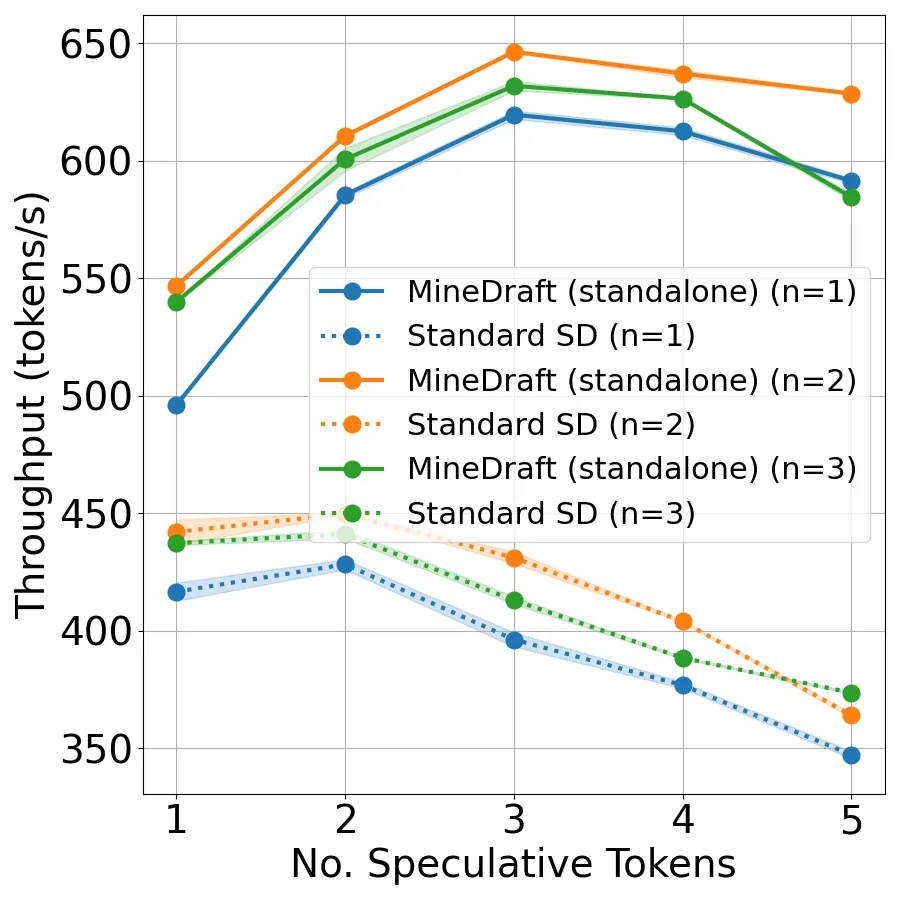
Figure 6(c): MineDraft随n增大而扩展。
Batch size (m)的影响:
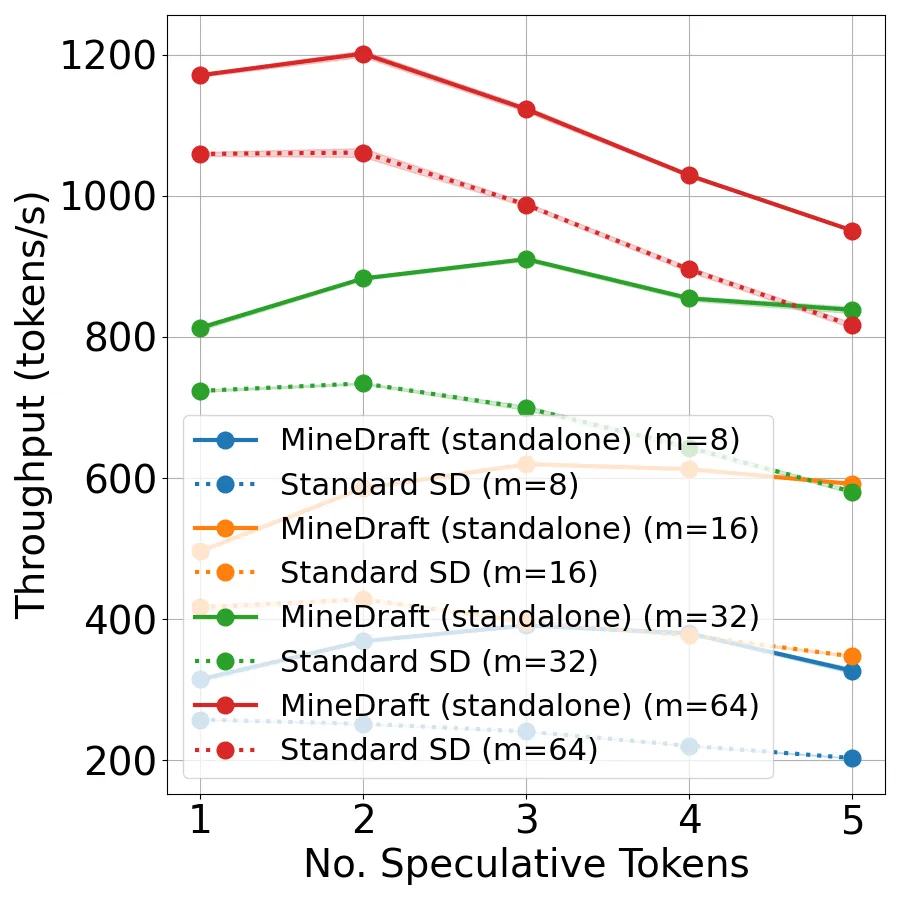
Figure 6(d): MineDraft随m增大而扩展。
4.5 调度器视角
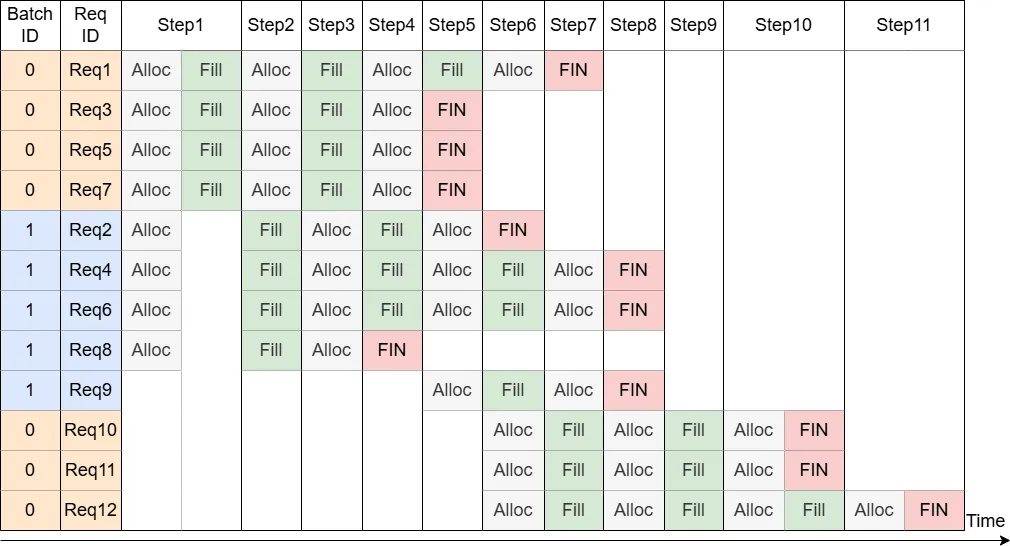
Figure 8: Batch Parallelism生命周期的调度器视角。每个时间点,Alloc表示Scheduler为request分配KV blocks,Fill表示分配的blocks被更新的KV向量填充,FIN表示request完成。
五、与现有方法对比
| 方法 | 特点 | 与MineDraft对比 |
|---|---|---|
| 标准SD | 顺序执行drafting和verification | MineDraft快最高75% |
| PEARL | 推测解码优化 | MineDraft持续优于PEARL |
| EAGLE | 特征级drafting | MineDraft可集成EAGLE,进一步提升37% |
| TETRIS | 动态draft token管理 | MineDraft可与TETRIS组合 |
| Medusa | 多头drafting | MineDraft可集成Medusa |
六、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| 批量并行SD | 两个batch交替drafting/verification | 隐藏drafting延迟 |
| 理论保证 | 证明PSD至少37%推理时间减少 | 理论基础 |
| Batch Manager | 智能batch分配和balance跟踪 | 负载均衡 |
| Scheduler补丁 | 延迟KV block分配 | 减少内存浪费 |
| vLLM插件 | 生产级实现 | 实用性 |
| Fallback机制 | batch空时回退到标准SD | 鲁棒性 |
七、总结
核心贡献
- 批量并行推测解码框架:首次提出将drafting和verification重叠执行的系统化方法
- 理论分析:证明PSD相比SD至少37%的效率提升
- MineDraft实现:包含Batch Manager、Scheduler补丁、Drafter/Verifier并行执行
- vLLM集成:作为vLLM插件实现,可直接用于生产环境
- 广泛兼容性:可与EAGLE、TETRIS、Medusa等现有drafting技术组合
技术影响
- LLM推理加速:为推测解码提供新的并行维度
- 生产实用性:vLLM插件实现可直接部署
- 理论基础:为并行推测解码提供理论保证
- 可组合性:可与现有drafting技术叠加使用
实际应用
- 高吞吐量服务:batch size较大时效果更显著
- 长序列生成:n较大时并行收益更大
- 大模型推理:70B+模型上效果显著
局限性
- Batch平衡依赖:需要维持两个batch的平衡,batch空时回退到标准SD
- GPU资源:需要额外GPU运行draft模型
- Draft模型选择:过大draft模型可能抵消并行收益
- 内存开销:需要维护两个batch的KV cache
八、参考资源
- 论文: https://arxiv.org/abs/2603.18016
- vLLM: https://github.com/vllm-project/vllm
- EAGLE: https://github.com/SafeAILab/EAGLE
- TETRIS: 动态draft token管理技术