Fast-WAM: Do World Action Models Need Test-time Future Imagination?
世界动作模型是否需要测试时未来想象?
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Fast-WAM: Do World Action Models Need Test-time Future Imagination? |
| 作者 | Tianyuan Yuan, Zibin Dong, Yicheng Liu, Hang Zhao |
| 论文 | https://arxiv.org/abs/2603.16666 |
| 主页 | https://yuantianyuan01.github.io/FastWAM/ |
| 发布 | 2026-03-17 (v1), 2026-03-23 (v2) |
| 类别 | cs.CV, cs.AI |
核心亮点
- 核心问题:WAM的价值来自训练时的视频建模还是测试时的未来想象?
- Fast-WAM:保留训练时视频联合训练,跳过测试时未来预测
- 190ms推理延迟:比现有imagine-then-execute WAM快4倍以上
- 实时控制:单次前向传播直接预测动作,无需迭代视频去噪
- 无需具身预训练:在LIBERO和RoboTwin上达到SOTA水平
- 关键发现:视频联合训练的价值 > 测试时未来想象的价值
二、核心思想
问题定义
World Action Models (WAMs)结合未来视觉预测和动作建模,是具身控制的有前景方法。现有WAM大多遵循imagine-then-execute范式:先生成未来观测,再基于想象的未来预测动作。这引入了大量测试时延迟(迭代视频去噪)。
核心问题:WAM的有效性来自哪里?
- 训练时的视频预测目标:帮助模型学习物理先验和动作条件表示
- 测试时的显式未来生成:为动作预测提供额外的预见性
现有WAM系统将这两个因素纠缠在一起,难以确定哪个是真正有效的。
解决方案概述
Fast-WAM解耦训练时视频建模与测试时未来生成:
- 训练时:保留视频联合训练,视频预测目标塑造视频DiT编码物理运动和交互结构
- 测试时:跳过未来预测,视频DiT单次前向传播处理观测上下文,提供潜在世界表示用于动作去噪
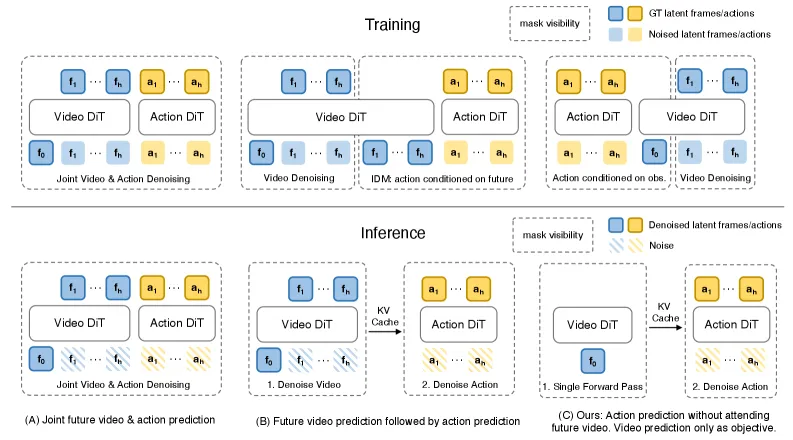
Figure 1: 三种代表性WAM范式。(A) 联合建模WAM:联合去噪未来视频和动作token;(B) 因果WAM:先生成未来观测,再条件化动作预测;(C) Fast-WAM:训练时保留视频联合训练,推理时跳过未来生成,直接从潜在世界表示预测动作。
三、技术架构
3.1 模型架构
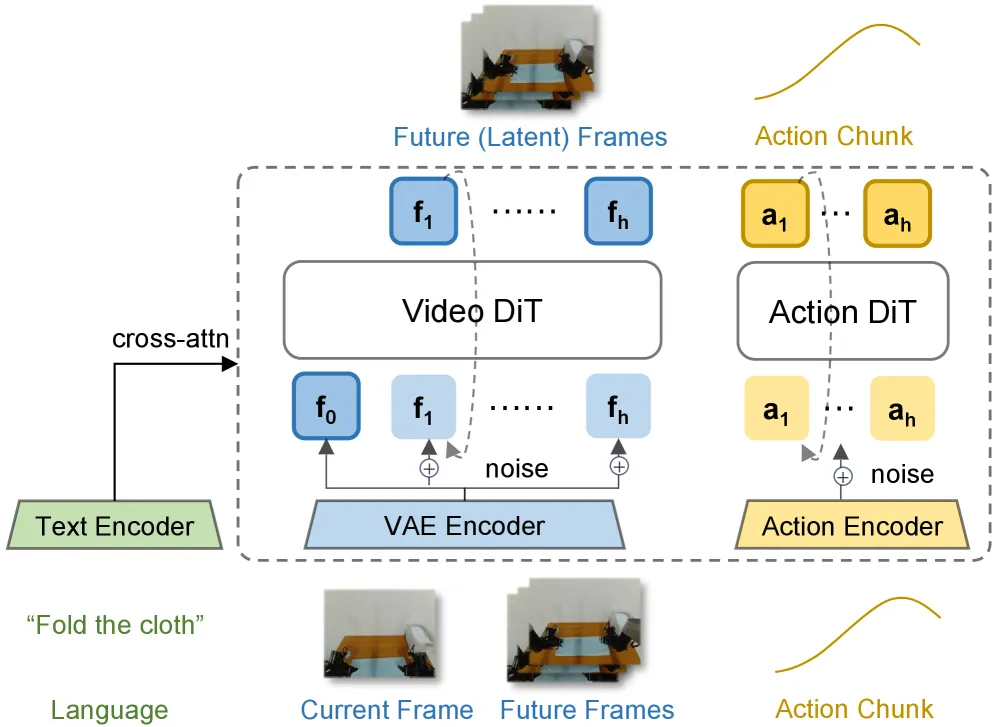
Figure 2(a): Fast-WAM模型架构。基于Wan2.2-5B视频DiT构建,引入动作专家DiT,形成Mixture-of-Transformer (MoT)架构,视频和动作分支共享注意力。
模型组成:
| 组件 | 说明 | 参数量 |
|---|---|---|
| 视频DiT | Wan2.2-5B预训练视频Diffusion Transformer | 5B |
| 动作专家DiT | 共享注意力,隐藏维度 | 1B |
| 文本编码器 | T5编码器,通过交叉注意力提供语言条件 | — |
| 视频VAE | 预训练VAE,将视觉观测映射为潜在视频token | — |
| 总计 | MoT架构 | 6B |
3.2 训练与推理掩码
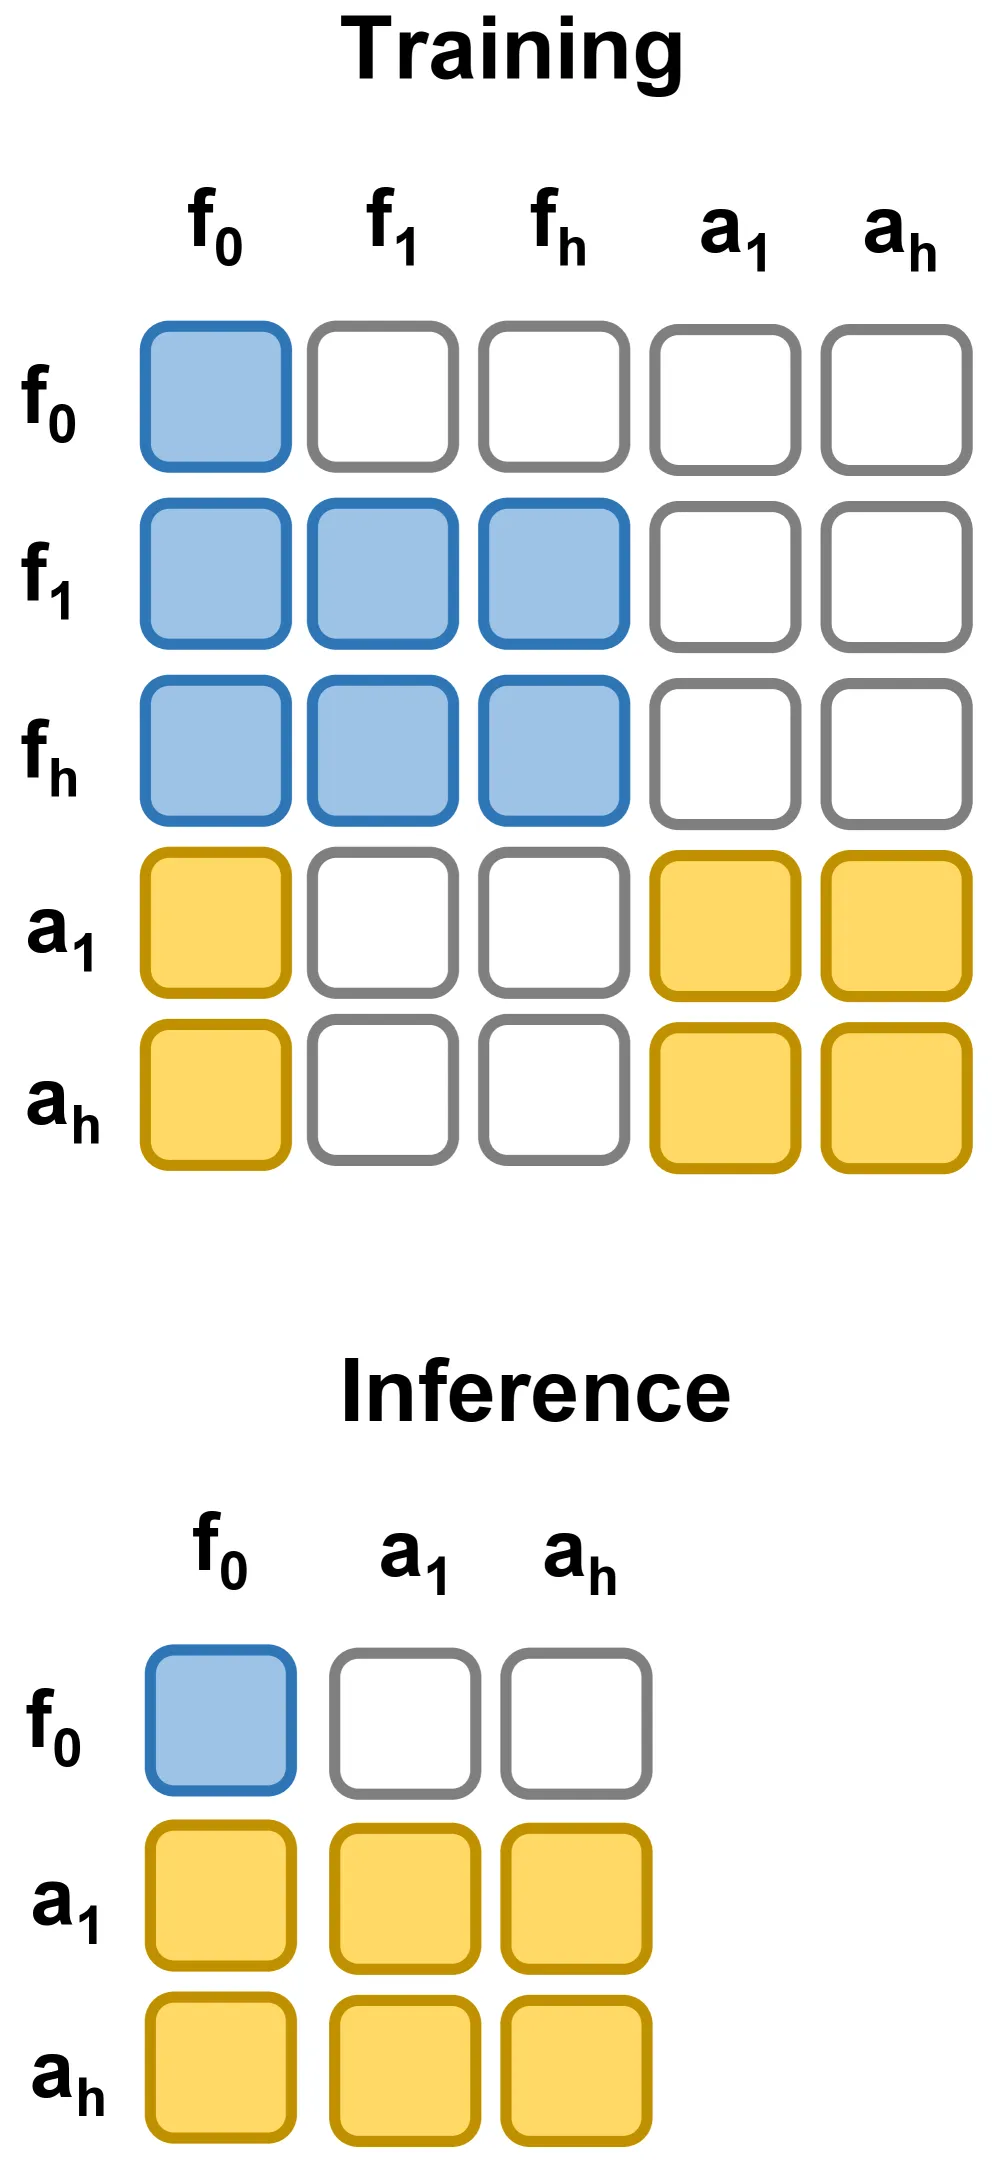
Figure 2(b): 训练和推理掩码。训练时视频和动作token联合去噪;推理时仅处理干净的观测帧token,单次前向传播获得潜在世界表示。
3.3 核心公式
标准VLA策略:
Imagine-then-execute WAM:
Fast-WAM:
其中 是视频骨干网络基于当前上下文产生的潜在世界表示,通过单次前向编码获得,而非在推理时显式采样或去噪未来观测 。
3.4 训练细节
| 参数 | 值 |
|---|---|
| 骨干网络 | Wan2.2-5B |
| 动作专家隐藏维度 | |
| 动作 horizon | |
| 视频帧时间下采样 | 4x(每chunk 9帧) |
| 噪声调度 | Logit-normal分布 |
| 推理去噪步数 | 10 |
| CFG scale | 1.0 |
| 优化器 | AdamW |
| 学习率 | |
| 权重衰减 | 0.01 |
| 学习率调度 | 余弦退火 |
| 梯度裁剪 | 1.0 |
| 硬件 | 单张RTX 5090D V2 32GB |
3.5 Fast-WAM变体
为控制比较,实例化多个变体:
| 变体 | 说明 | 对应范式 |
|---|---|---|
| Fast-WAM | 训练时视频联合训练,推理时跳过未来预测 | Figure 1(C) |
| Fast-WAM-Joint | 允许视频和动作token之间的注意力 | Figure 1(A) |
| Fast-WAM-IDM | 跟随LingBot-VA,对ground-truth视频token应用噪声增强(p=0.5) | Figure 1(B) |
| Fast-WAM w/o video co-train | 去除视频联合训练,仅训练动作预测 | 消融对照 |
四、实验结果
4.1 RoboTwin基准
Table 1: RoboTwin结果
| 方法 | 具身预训练 | Clean | Rand. | Average |
|---|---|---|---|---|
| π₀ | ✓ | 65.92 | 58.40 | 62.2 |
| π₀.₅ | ✓ | 82.74 | 76.76 | 79.8 |
| Motus | ✓ | 88.66 | 87.02 | 87.8 |
| LingBot-VA | ✓ | 92.90 | 91.50 | 92.2 |
| Fast-WAM | ✗ | 91.88 | 91.78 | 91.8 |
| Fast-WAM-Joint | ✗ | 90.84 | 90.32 | 90.6 |
| Fast-WAM-IDM | ✗ | 91.16 | 91.34 | 91.3 |
| Fast-WAM w/o video co-train | ✗ | 82.76 | 84.80 | 83.8 |
关键发现:
- Fast-WAM无需具身预训练即可达到91.8%(vs LingBot-VA 92.2%有预训练)
- 去除视频联合训练导致大幅下降:91.8% → 83.8%(-8.0%)
- Fast-WAM与imagine-then-execute变体(Joint、IDM)性能接近
4.2 LIBERO基准
Table 2: LIBERO结果
| 方法 | 具身预训练 | Spatial | Object | Goal | Long | Average |
|---|---|---|---|---|---|---|
| OpenVLA | ✓ | 84.7 | 88.4 | 79.2 | 53.7 | 76.5 |
| π₀ | ✓ | 96.8 | 98.8 | 95.8 | 85.2 | 94.1 |
| π₀.₅ | ✓ | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| LingBot-VA | ✓ | 98.5 | 99.6 | 97.2 | 98.5 | 98.5 |
| Motus | ✓ | 96.8 | 99.8 | 96.6 | 97.6 | 97.7 |
| Fast-WAM | ✗ | 98.2 | 100.0 | 97.0 | 95.2 | 97.6 |
| Fast-WAM-Joint | ✗ | 99.6 | 99.4 | 98.2 | 96.8 | 98.5 |
| Fast-WAM-IDM | ✗ | 98.8 | 97.8 | 97.8 | 97.6 | 98.0 |
| Fast-WAM w/o video co-train | ✗ | 89.2 | 99.2 | 95.4 | 90.0 | 93.5 |
关键发现:
- Fast-WAM达到97.6%,与Motus (97.7%)和LingBot-VA (98.5%)竞争力相当
- 去除视频联合训练:97.6% → 93.5%(-4.1%)
- Fast-WAM-Joint甚至达到98.5%,与LingBot-VA持平
4.3 真实世界任务
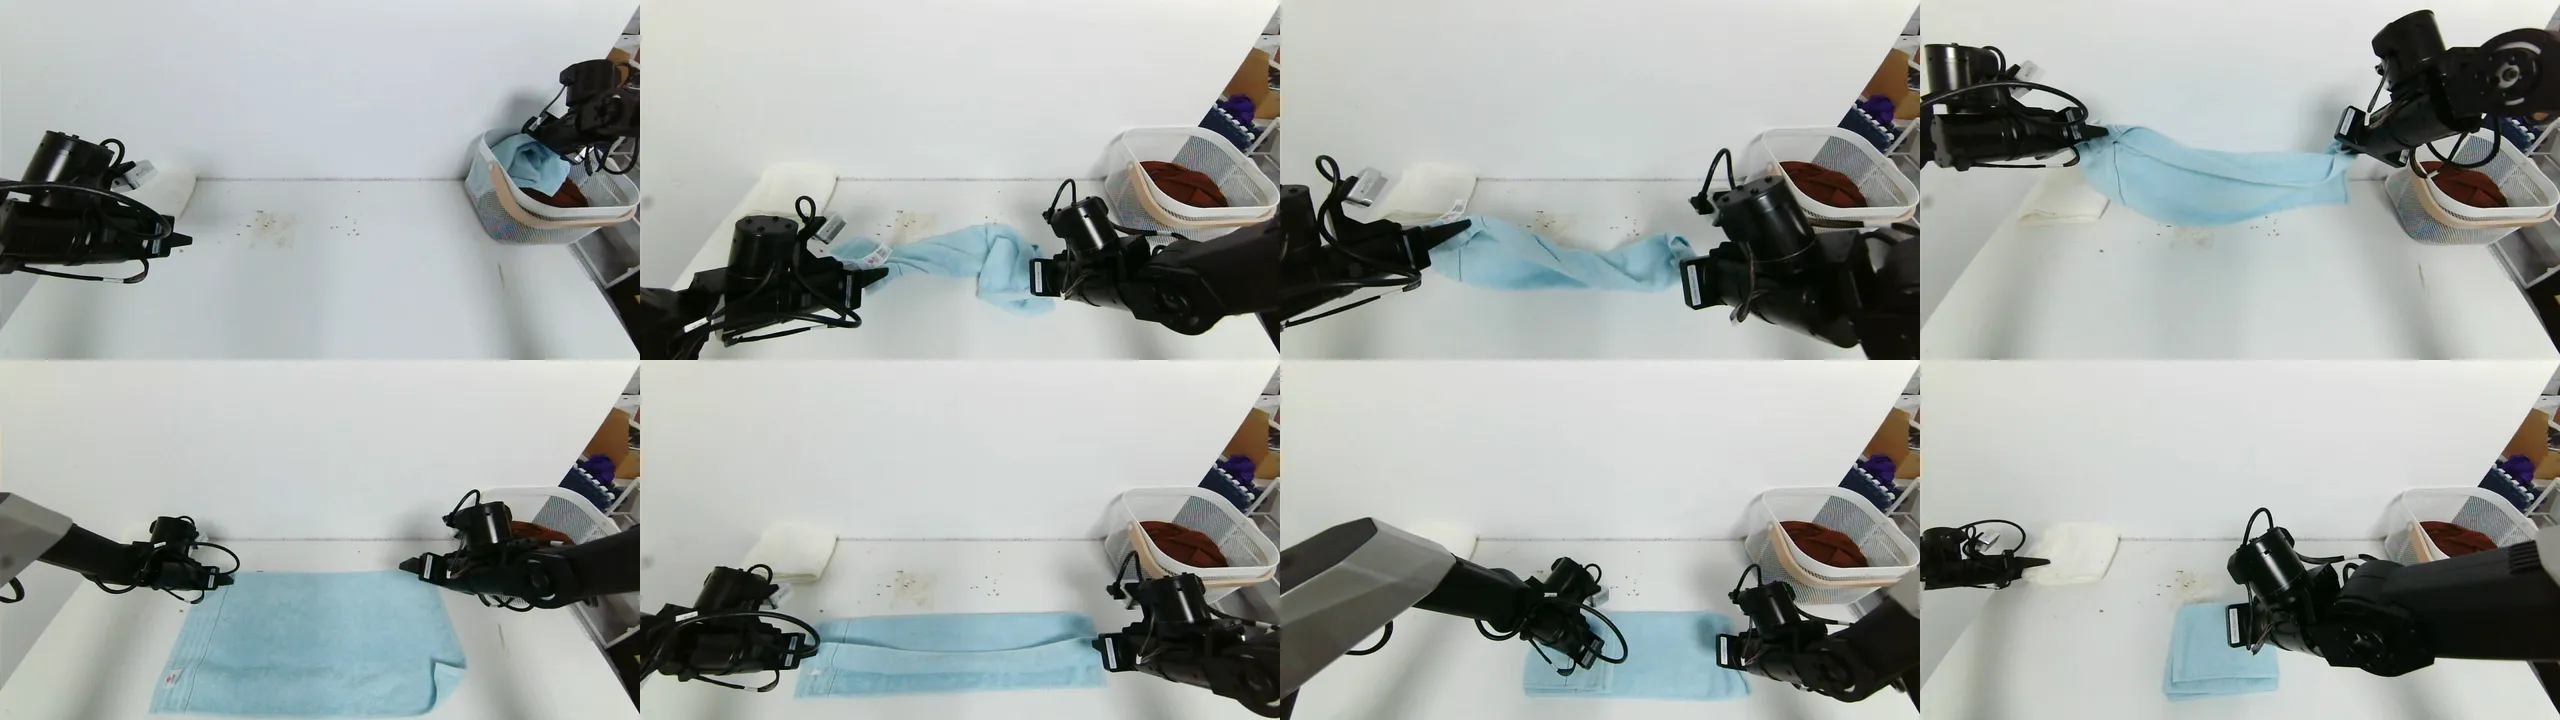
Figure 3: 真实世界毛巾折叠任务。折叠可变形物体需要长horizon规划和精确闭环操作。
实验设置:
- 平台:Galaxea R1 Lite
- 任务:毛巾折叠(长horizon、可变形物体)
- 数据:60小时遥操作演示
- 训练:30k步
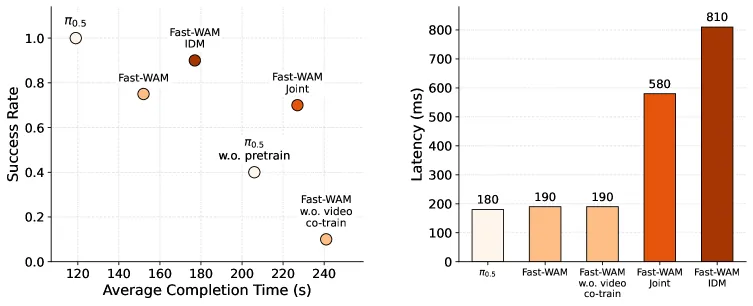
Figure 4: 真实世界结果。左图:成功率vs平均完成时间(左上更好);右图:推理延迟对比。Fast-WAM以显著更低的延迟实现强大的真实世界性能。
关键结果:
| 指标 | Fast-WAM | Imagine-then-execute |
|---|---|---|
| 推理延迟 | 190ms | ~800ms+ |
| 速度提升 | — | 4x+ |
| 成功率 | 竞争力相当 | 略高 |
| 完成时间 | 竞争力相当 | — |
4.4 核心发现
消融分析总结:
| 操作 | 性能变化 | 结论 |
|---|---|---|
| Fast-WAM → Fast-WAM-Joint | -1.2% (RoboTwin) | 测试时未来想象贡献有限 |
| Fast-WAM → Fast-WAM-IDM | -0.5% (RoboTwin) | 测试时未来想象贡献有限 |
| Fast-WAM → w/o video co-train | -8.0% (RoboTwin) | 视频联合训练贡献巨大 |
核心结论:
- WAM的主要价值来自训练时的视频建模(学习更好的世界表示)
- 而非测试时的显式未来想象(生成未来观测)
- Fast-WAM保留了训练收益,消除了推理成本
五、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| 解耦训练与推理 | 保留训练时视频联合训练,跳过测试时未来预测 | 4x+速度提升,性能接近 |
| 单次前向传播 | 视频DiT作为世界编码器,非生成器 | 190ms实时推理 |
| MoT架构 | 视频DiT + 动作专家DiT,共享注意力 | 有效利用预训练视频模型 |
| 控制变体设计 | Fast-WAM/Joint/IDM/w.o.co-train | 隔离训练vs推理因素 |
| 关键洞察 | 视频联合训练 > 测试时未来想象 | 指导未来WAM设计 |
六、与现有方法对比
| 方法 | 测试时未来生成 | 视频联合训练 | 推理延迟 | LIBERO | RoboTwin |
|---|---|---|---|---|---|
| π₀ | × | × | 快 | 94.1 | 62.2 |
| π₀.₅ | × | × | 快 | 96.9 | 79.8 |
| Motus | ✓ (联合去噪) | ✓ | 慢 | 97.7 | 87.8 |
| LingBot-VA | ✓ (因果生成) | ✓ | 慢 | 98.5 | 92.2 |
| Fast-WAM | × | ✓ | 190ms | 97.6 | 91.8 |
七、总结
核心贡献
- 提出关键问题:WAM的价值来自训练时视频建模还是测试时未来想象?
- Fast-WAM架构:保留训练时视频联合训练,跳过测试时未来预测
- 控制变体实验:隔离训练vs推理因素的贡献
- 关键发现:视频联合训练的价值远大于测试时未来想象
- 实时推理:190ms延迟,4x+速度提升
- 无需具身预训练:在LIBERO和RoboTwin上达到SOTA水平
技术影响
- WAM设计范式转变:从imagine-then-execute到train-with-imagination-infer-directly
- 实时具身控制:190ms延迟使实时机器人控制成为可能
- 计算效率:消除测试时视频生成的巨大计算开销
- 未来研究方向:更大规模预训练数据和模型scaling的影响
局限性
- 模型规模:6B参数模型,部署成本较高
- 任务范围:主要验证操作任务,导航等任务待验证
- 预训练依赖:依赖Wan2.2-5B预训练视频模型
- 单动作chunk:未考虑自回归rollout的影响
- 数据需求:真实世界任务仍需60小时遥操作数据
八、参考资源
- 论文: https://arxiv.org/abs/2603.16666
- 主页: https://yuantianyuan01.github.io/FastWAM/
- Wan2.2-5B: 预训练视频DiT骨干网络
- LIBERO: 仿真基准
- RoboTwin 2.0: 双臂操作基准
- Galaxea R1 Lite: 真实世界机器人平台