V-JEPA 2.1: Unlocking Dense Features in Video Self-Supervised Learning
Next-gen JEPA model with dense predictive loss, deep self-supervision, and multi-modal tokenizers achieving SOTA on dense visual tasks (depth, segmentation, STA) while retaining global scene understanding
V-JEPA 2.1: Unlocking Dense Features in Video Self-Supervised Learning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | V-JEPA 2.1: Unlocking Dense Features in Video Self-Supervised Learning |
| 作者 | Lorenzo Mur-Labadia*, Matthew Muckley*, Amir Bar, Mido Assran, Koustuv Sinha, Mike Rabbat, Yann LeCun, Nicolas Ballas, Adrien Bardes*† |
| 机构 | FAIR at Meta / Universidad de Zaragoza |
| 论文 | https://arxiv.org/abs/2603.14482 |
| 代码 | https://github.com/facebookresearch/vjepa2 |
| 发布 | arXiv:2603.14482v1 [cs.CV], Mar 15, 2026 |
| 许可 | 未明确 |
二、核心思想
问题定义
V-JEPA 2 (Assran et al., 2025) 在全局场景理解(运动识别、动作预判)方面表现优异,但其学到的表示缺乏密集空间结构:
- 稀疏特征图:V-JEPA 2 的特征图存在噪声,难以用于需要像素级/patch 级定位的任务(深度估计、语义分割、物体跟踪)
- 全局-密集权衡:现有方法难以同时保持全局场景理解能力和密集空间结构
- 机器人操控局限:V-JEPA 2 AC 在真实机器人抓取任务中成功率较低
解决方案概述
本文提出 V-JEPA 2.1——一个能够学习密集高质量视觉表示的 JEPA 模型家族,同时保留强大的全局场景理解能力。核心四大创新:
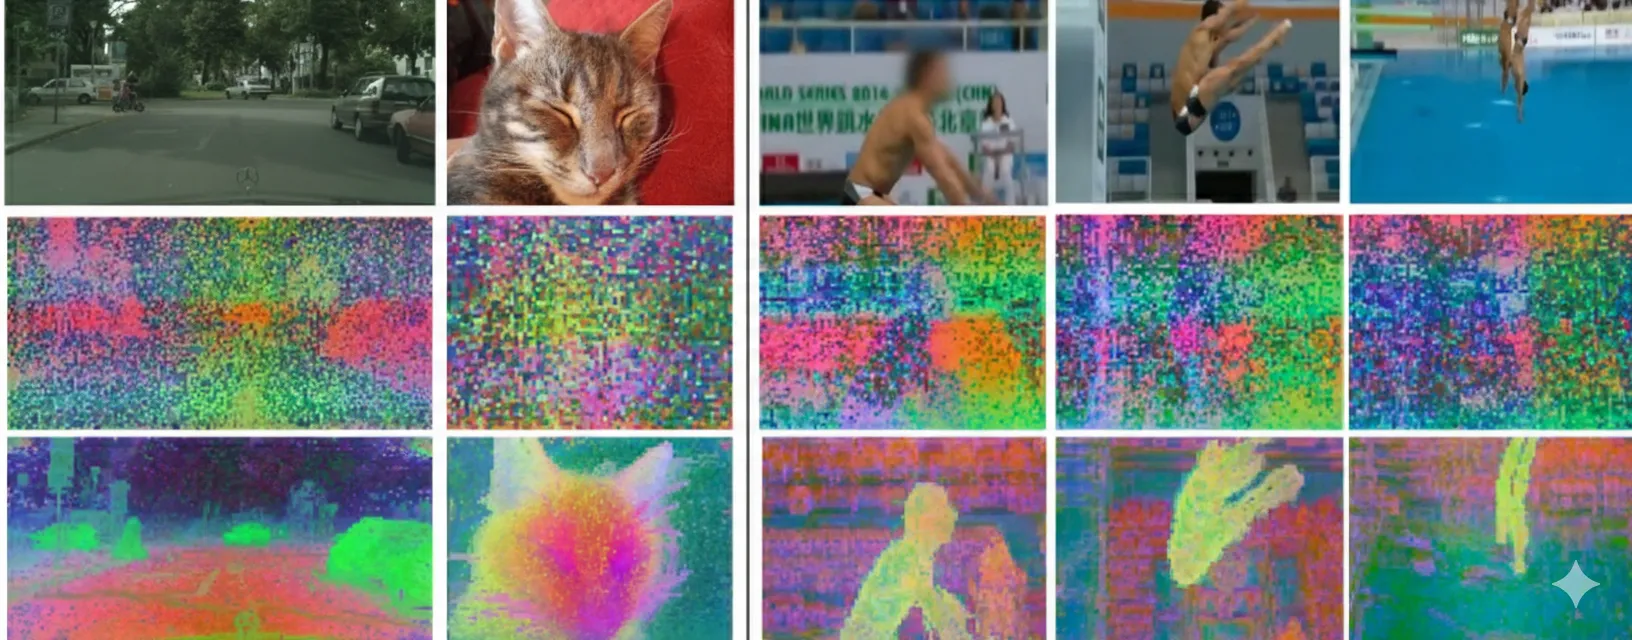
- Dense Predictive Loss(密集预测损失):让所有 tokens(可见上下文 + masked tokens)都贡献训练信号,鼓励显式空间和时间定位
- Deep Self-Supervision(深度自监督):在多个中间编码器层上分层应用自监督目标,提升表示质量
- Multi-Modal Tokenizers(多模态 tokenizer):支持图像和视频的统一训练
- 有效扩展:模型容量和训练数据的双重扩展
与 V-JEPA 2 的关键区别
| 特性 | V-JEPA 2 | V-JEPA 2.1 |
|---|---|---|
| 预测损失 | 仅 masked tokens | 所有 tokens(masked + context) |
| 监督层级 | 仅顶层 | 多层(deep self-supervision) |
| Tokenizer | 独立图像/视频 | 统一多模态 |
| 密集特征质量 | 有限(噪声大) | SOTA(空间一致) |
| 全局理解 | 强 | 保持并增强 |
三、技术架构
整体架构
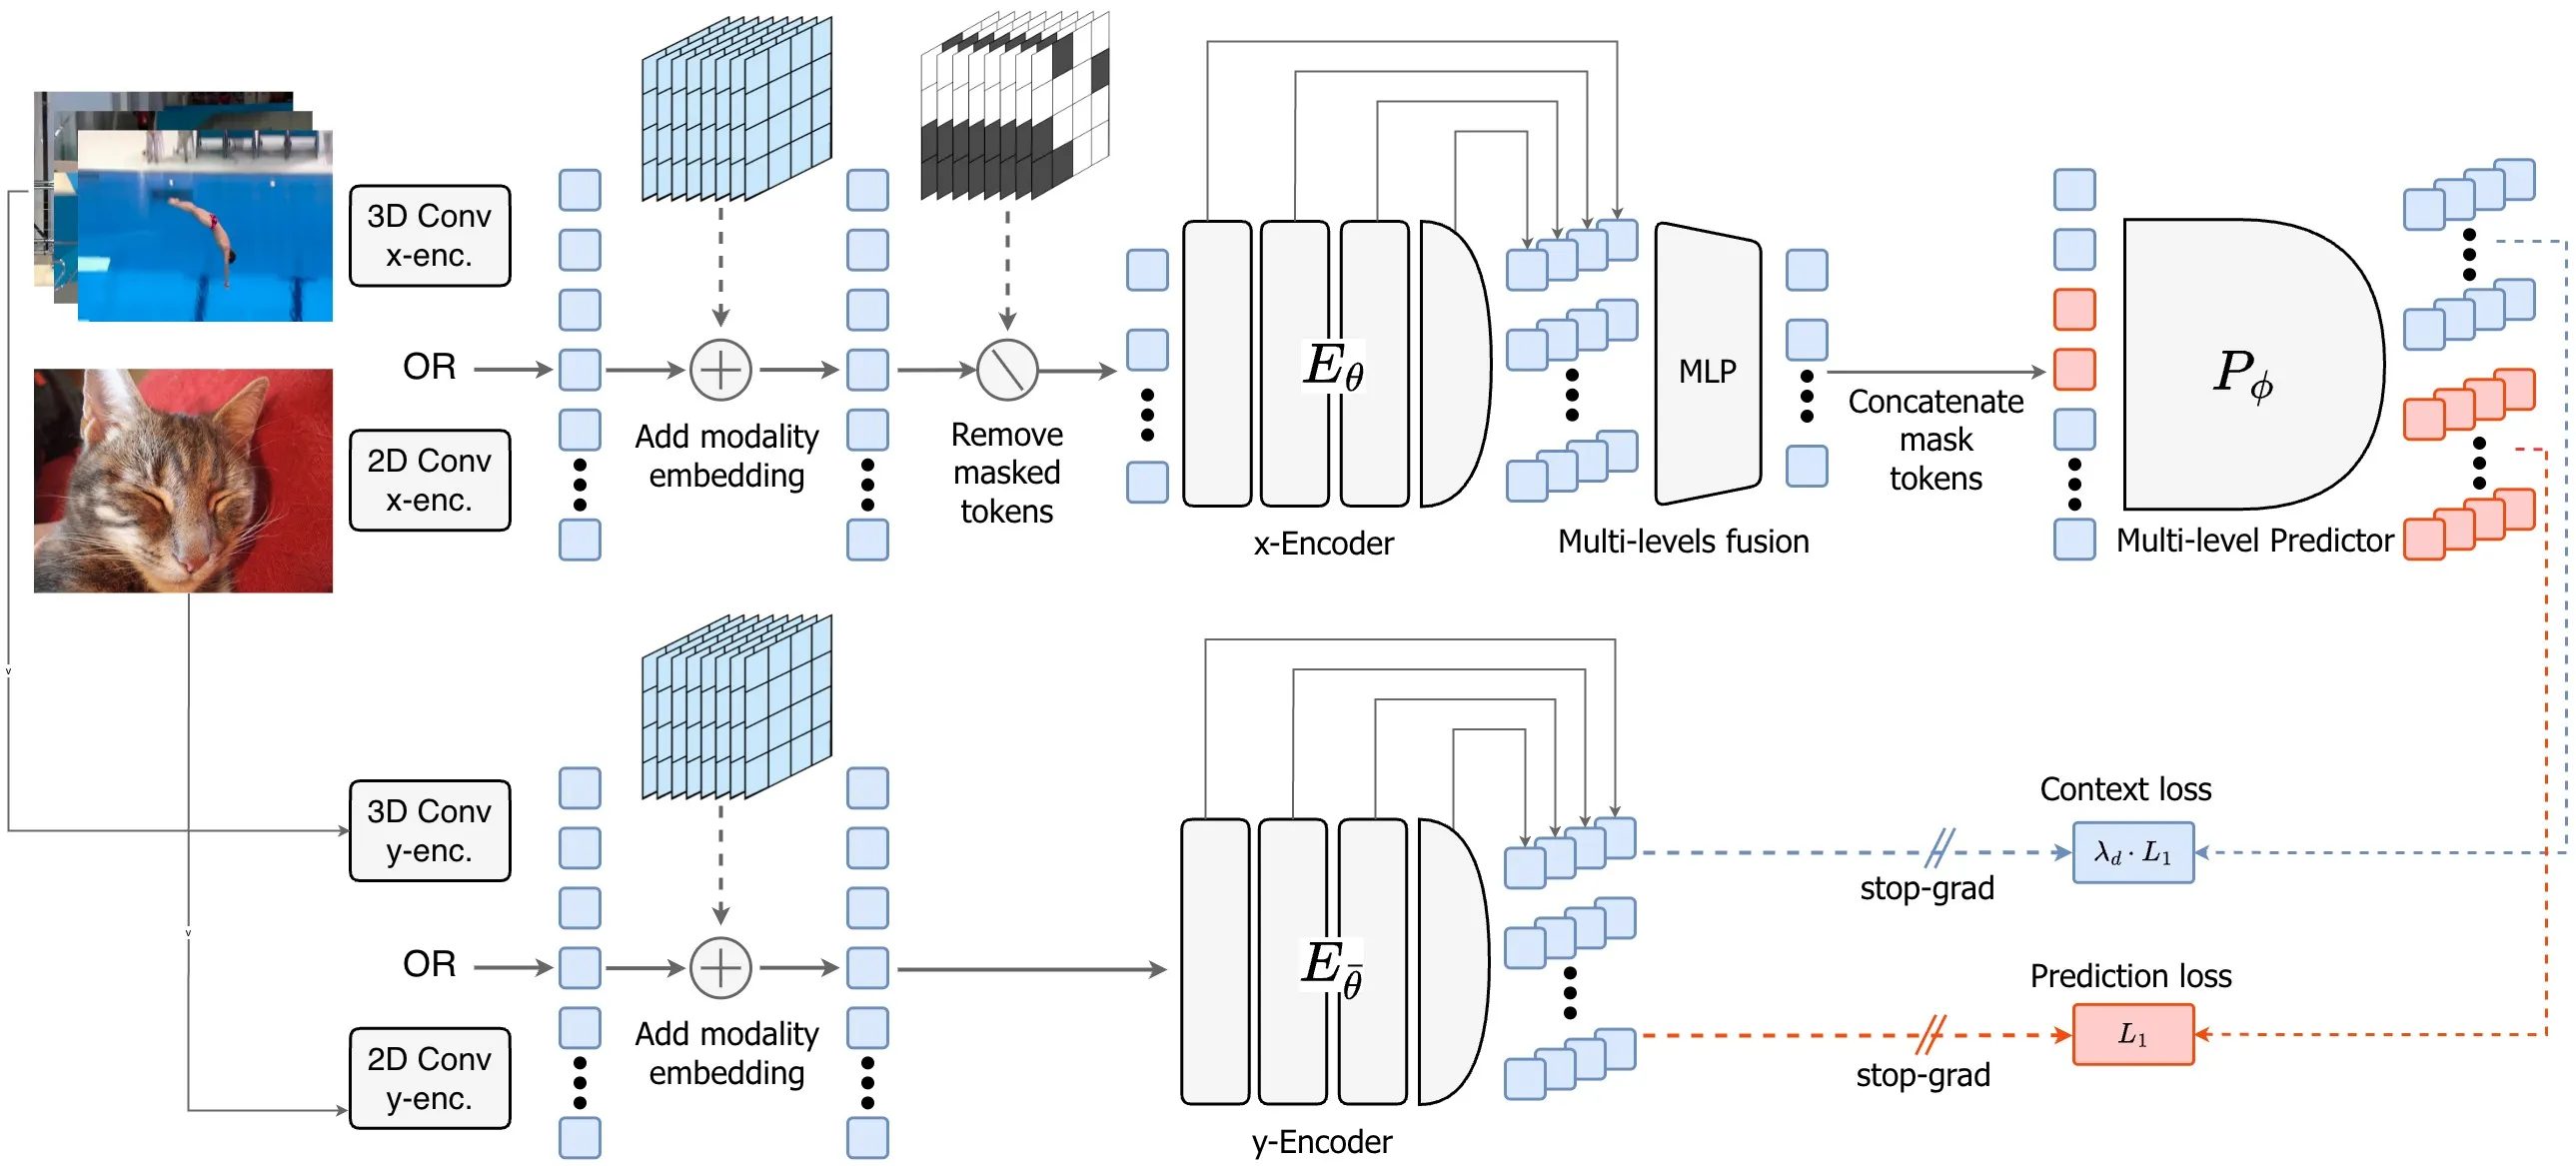
Input: Image or Video
    ↓
2D Conv Tokenizer (image) 或 3D Conv Tokenizer (video)
    ↓
+ 3D Rotational Positional Encoding (RoPE)
+ Learnable Modality Embedding
    ↓
┌─────────────────────────────────────┐
│              x-encoder               │
│  (processes visible tokens)          │
│                                      │
│  Multi-level embeddings from         │
│  intermediate encoder blocks         │
│  → concatenated → MLP fusion         │
│  → reduced dimensionality            │
│  = Context Tokens                    │
└─────────────────────────────────────┘
    ↓
Context Tokens + Learnable Mask Tokens (spatio-temporal pos)
    ↓
┌─────────────────────────────────────┐
│             Predictor                │
│  (multi-level predictions for        │
│   masked tokens)                     │
└─────────────────────────────────────┘
    ↓
┌─────────────────────────────────────┐
│              y-encoder               │
│  (target encoder, EMA weights)       │
│                                      │
│  Multi-level embeddings              │
│  = Target Representations            │
└─────────────────────────────────────┘
    ↓
Two Losses:
  ① L1 Loss on masked-token predictions (original V-JEPA objective)
  ② Distance-weighted L1 Loss on nearby context tokens (new context loss)
核心公式
原始 V-JEPA 损失(Masked Token Prediction)
其中 是 predictor 对 masked tokens 的预测, 是 y-encoder(EMA target)的输出。
Dense Predictive Loss(新增 Context Loss)
其中 是基于空间/时间距离的权重——邻近 tokens 获得更高权重。
关键洞察:传统 JEPA 只监督 masked tokens 的预测,而 context tokens 不参与损失计算。V-JEPA 2.1 通过 显式监督所有可见上下文的预测,使模型学到具有显式空间结构的表示。
对比可视化:
- V-JEPA 2:仅显示碎片化的局部空间结构
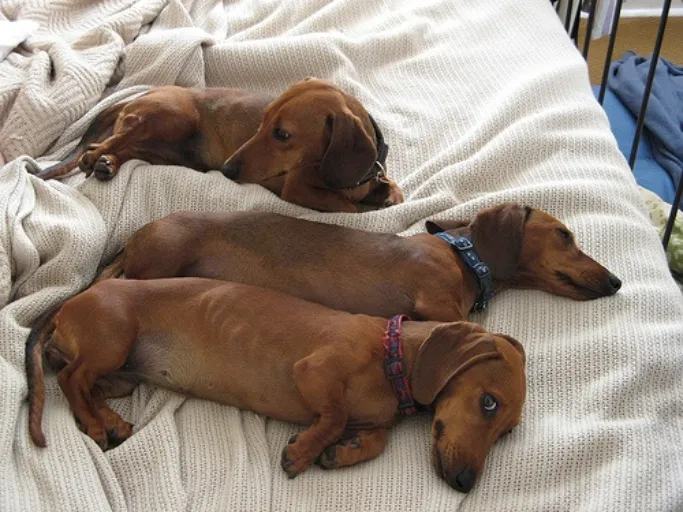
- V-JEPA 2 + :特征图呈现连贯的空间结构,相似语义部分(如狗头、车轮)映射到相同 PCA 分量
Deep Self-Supervision
在多个中间编码器层上分层应用自监督目标:
其中 是在第 层输出的嵌入上计算的预测损失。
x-encoder 的输出包含来自中间编码器块的多层嵌入拼接,经过 MLP 融合后降维。
总损失
Multi-Modal Tokenizers
- 2D Conv Tokenizer(图像):标准卷积 patch embedding
- 3D Conv Tokenizer(视频):时空卷积 patch embedding
- 统一处理图像和视频,共享大部分架构参数
训练流程
Ablation 路径(Fig. 5)
从 ViT-L 基线开始逐步添加组件:
- Weighted-Context SSL():显著提升分割性能,分类略有下降
- Deep Self-Supervision:恢复分类性能,进一步提升分割
- VisionMix 163M 数据集 + Multi-Modal Tokenizer:进一步改善结果
- 模型规模扩展 + 高分辨率 cooldown:最终提升
预训练细节
数据:
- VisionMix 163M 数据集(大规模图像/视频混合)
- 100 万+ 小时视频(延续 V-JEPA 2 的数据规模)
模型规模:
- ViT-L / ViT-G / ViT-G+
- 最高参数规模超过 1B
训练策略:
- 渐进式分辨率训练(延续 V-JEPA 2)
- Cooldown 阶段使用更高分辨率和更长视频片段
- EMA target encoder(延续 V-JEPA 2)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Dense Predictive Loss | 所有 tokens(可见+masked)都参与损失计算 | Fig. 3: PCA 可视化显示连贯空间结构 |
| Context Loss | 基于距离加权的 L1 损失监督邻近 context tokens | 分割任务显著改善,代价是分类略降 |
| Deep Self-Supervision | 多层编码器输出均受自监督目标约束 | 恢复分类性能,进一步提升分割 |
| Multi-Modal Tokenizers | 2D/3D 卷积 tokenizer 统一训练图像和视频 | 消除图像/视频分别训练的开销 |
| VisionMix 163M 数据扩展 | 更大规模的混合图像/视频数据 | 持续提升各任务性能 |
| 全局-密集统一 | 首次在同一模型中实现 SOTA 密集特征 + 全局理解 | 15 项基准测试中多项 SOTA |
五、实验结果
整体性能对比(Fig. 2)
V-JEPA 2.1 ViT-G 相比 V-JEPA 2 ViT-g 的全面改进:
| 任务类别 | 具体任务 | 改进幅度 |
|---|---|---|
| 密集预测 | Depth Estimation (NYUv2) | SOTA |
| 密集预测 | Semantic Segmentation (VOC12/Cityscapes) | SOTA |
| 密集预测 | Object Tracking | SOTA |
| 全局理解 | SSv2 Action Recognition | 77.7% (SOTA) |
| 全局理解 | Kinetics-400 | SOTA |
| 全局理解 | Image Classification | SOTA |
| 动作预判 | EPIC-KITCHENS Recall@5 | 40.8 (SOTA) |
| 短期待判 | Ego4D STA mAP | 7.71 (SOTA) |
| 机器人 | Real-Robot Grasping | +20% vs V-JEPA 2 AC |
| 机器人 | TartanDrive Navigation ATE | 5.687 (SOTA) |
密集特征质量
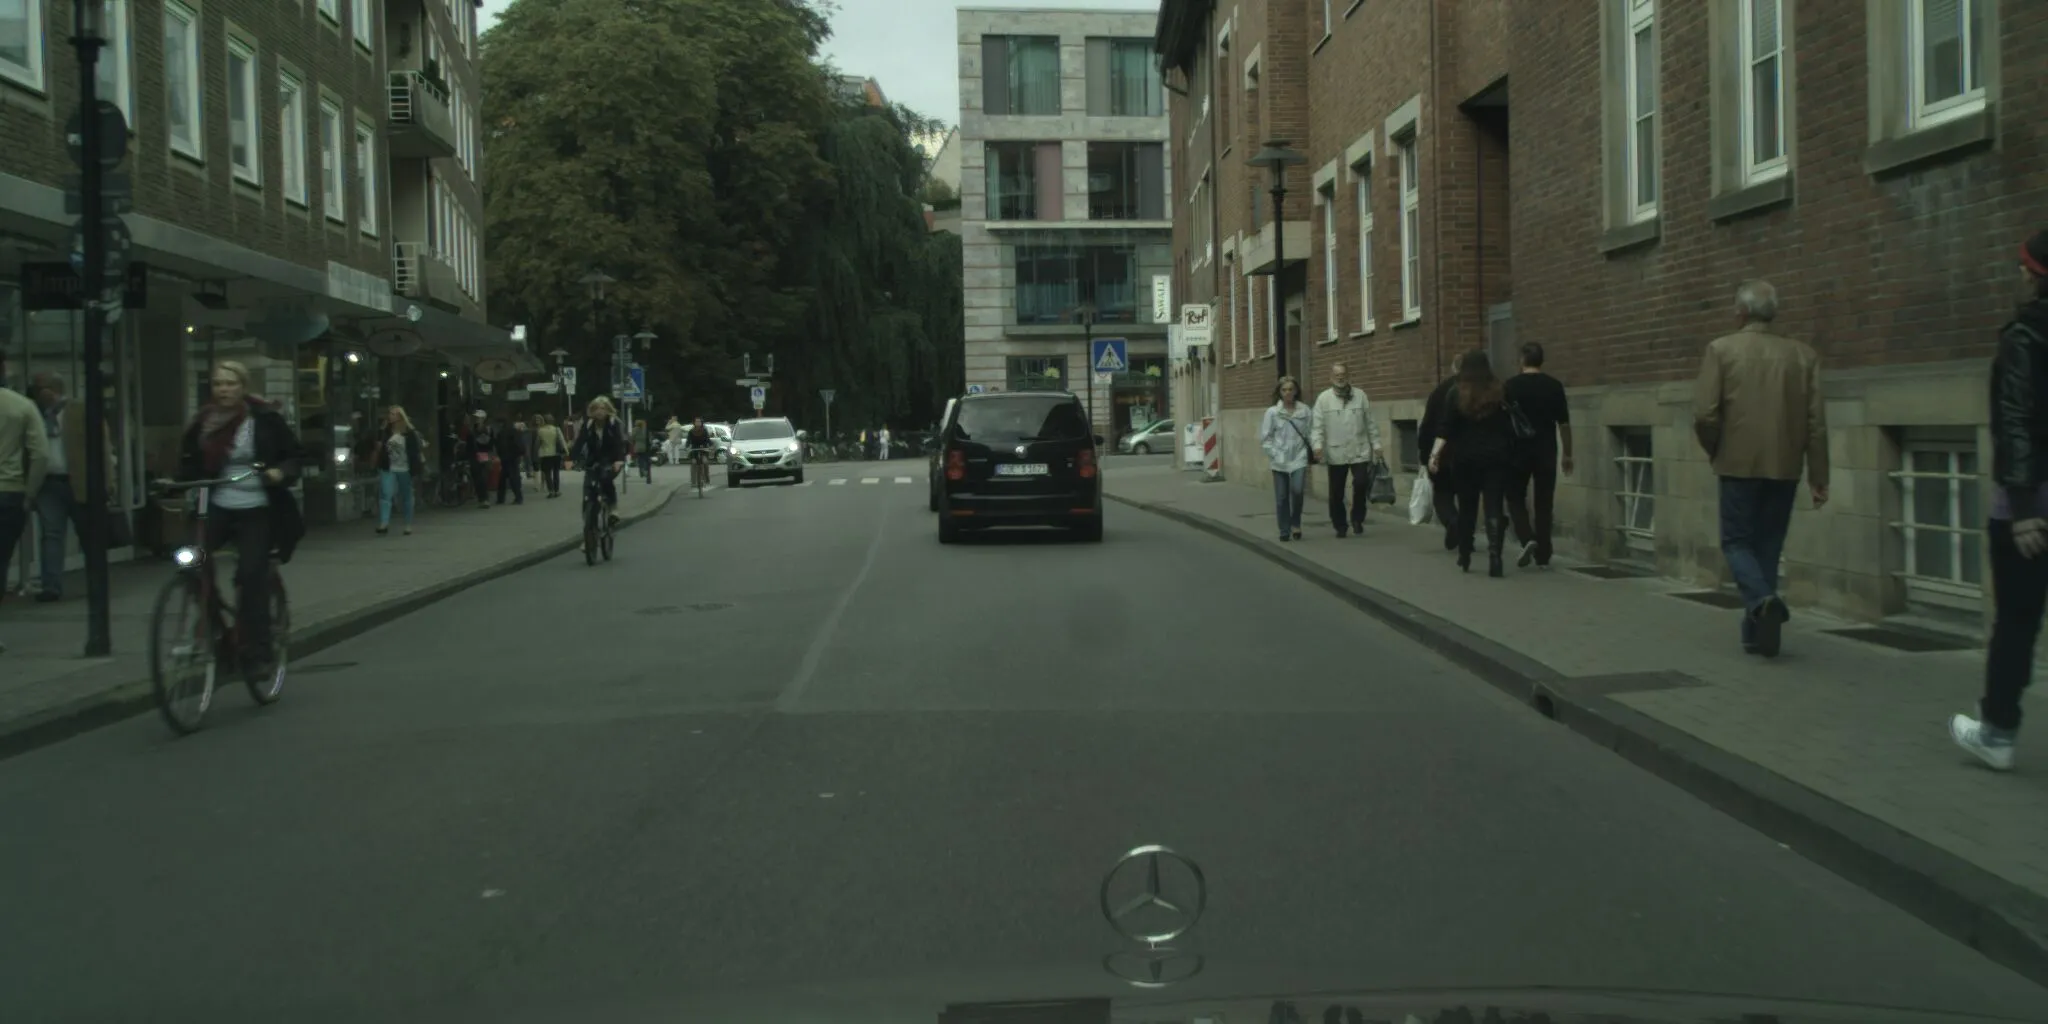
对比不同 SSL 方法的密集特征:
- DINOv2 ViT-g
- DINOv3 ViT-H+
- V-JEPA 2 ViT-g
- V-JEPA 2.1 ViT-G ← 本文
V-JEPA 2.1 在 Cityscapes 图像上展现出最清晰、最一致的密集特征。
视频密集特征
在 Ego4D、Cityscapes、Diving48、MOCA 等数据集上展示:
- 动态物体的时间一致性显著改善
- 整个视频序列处理时保持一致的语义编码
深度估计
- V-JEPA 2:捕获整体场景几何但缺乏局部一致性和精确边界结构
- V-JEPA 2.1:产生更锐利、更连贯、更细粒度的深度图
- NYUv2 RMSE: 0.307(线性探测)
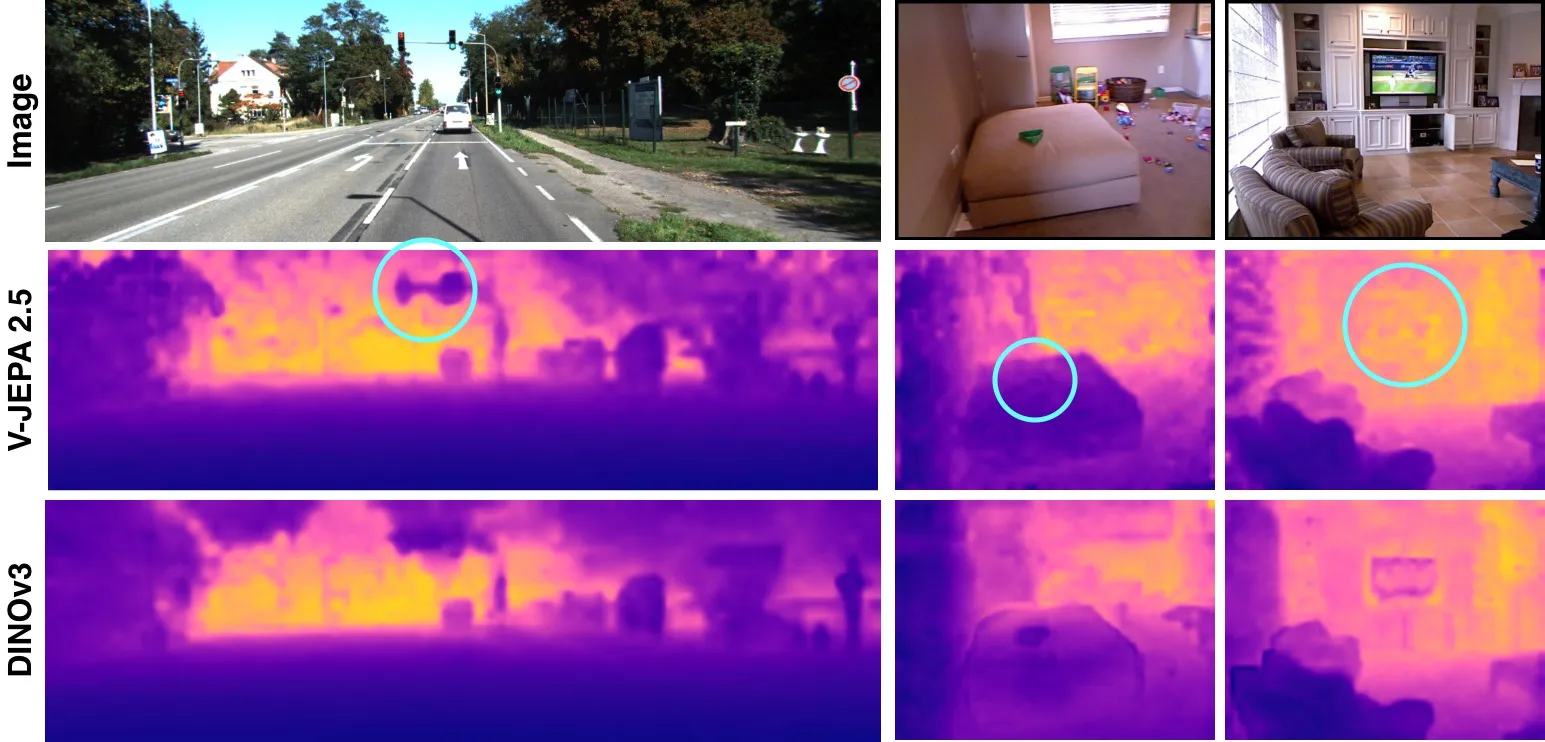
- V-JEPA 2.1 ViT-G 在细粒度细节(如交通灯轮廓)和尺度一致性上优于 DINOv3 ViT-H++
- DINOv3 在某些场景中错误判断绿色物体和电视的深度
语义分割
- V-JEPA 2 因特征图噪声产生稀疏语义掩码
- V-JEPA 2.1 达到与 DINOv3 ViT-H+ 竞争的性能
视频目标分割(VOS)
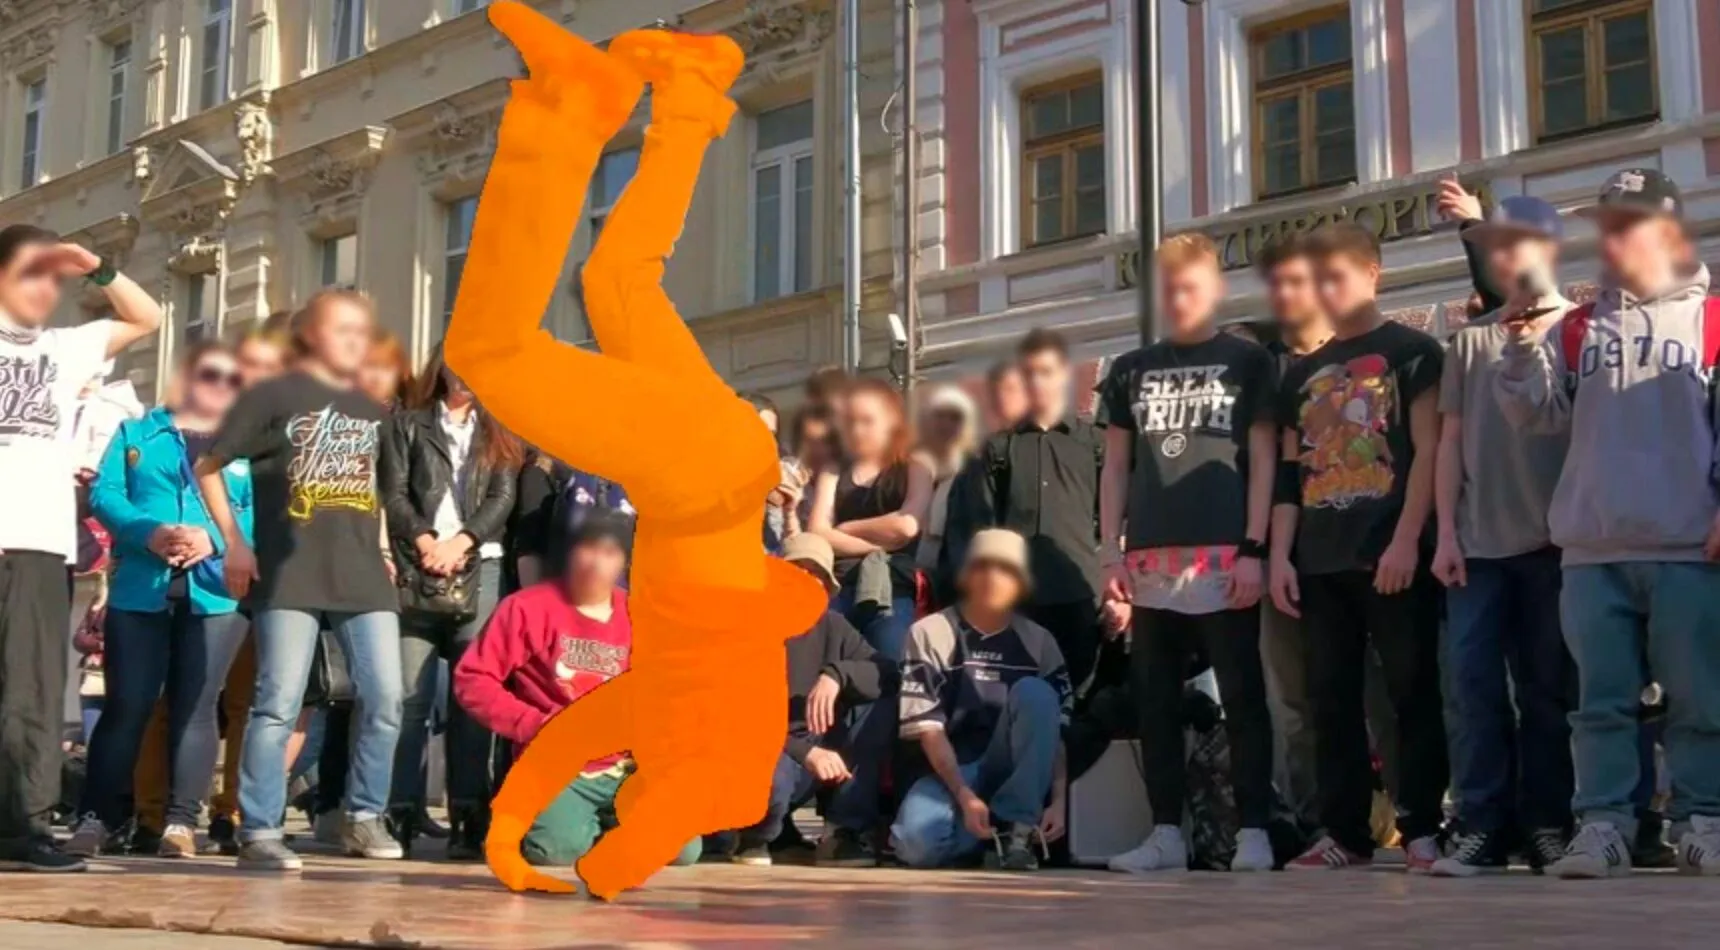
给定初始帧的 ground-truth 对象掩码,基于 V-JEPA 2.1 嵌入空间中的 patch 相似度传播实例掩码到后续帧。
短期待判(Short-Term Anticipation, STA)
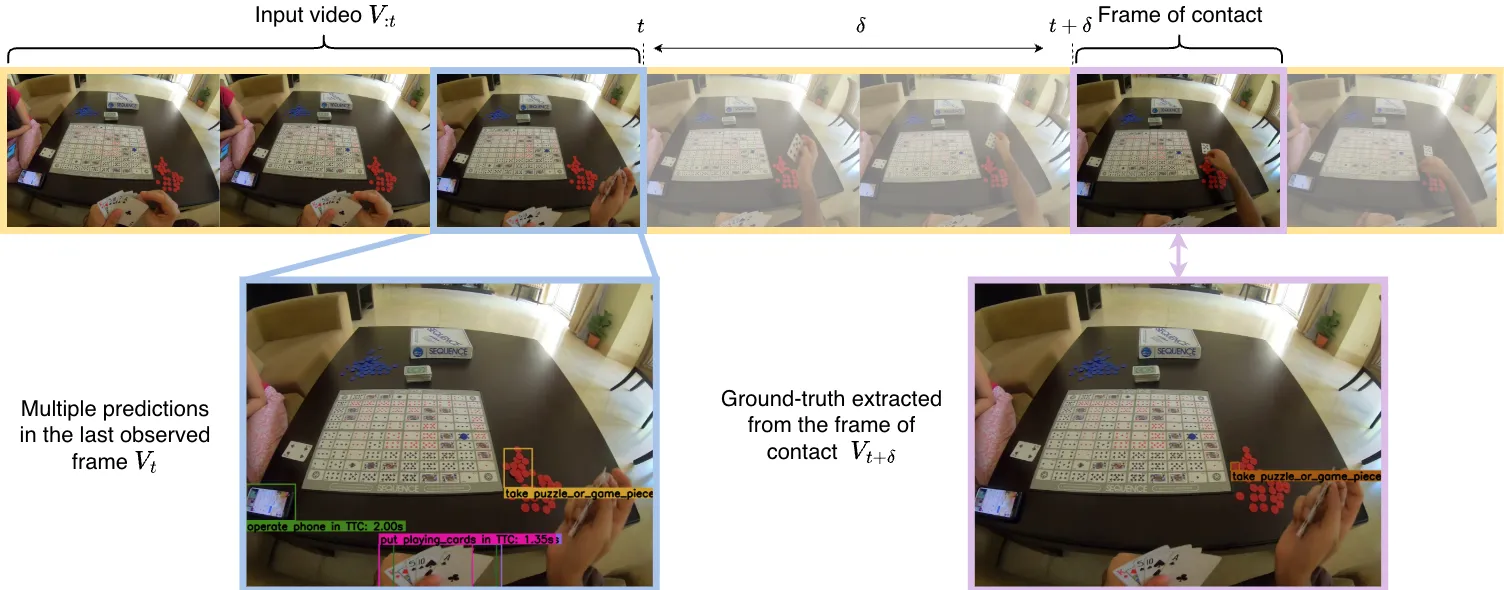
Ego4D 基准:7.71 mAP(SOTA)
给定观察到时刻 的视频 ,模型预测未来对象-交互事件集合:
- 边界框(定位将被交互的对象)
- 名词类别(对象类型)
- 动词类别(即将发生的交互)
- 期待时间 (当前帧到交互开始之间的秒数)
Ground-truth 标签从接触帧 导出,但在最后观测帧 的坐标系中表示。
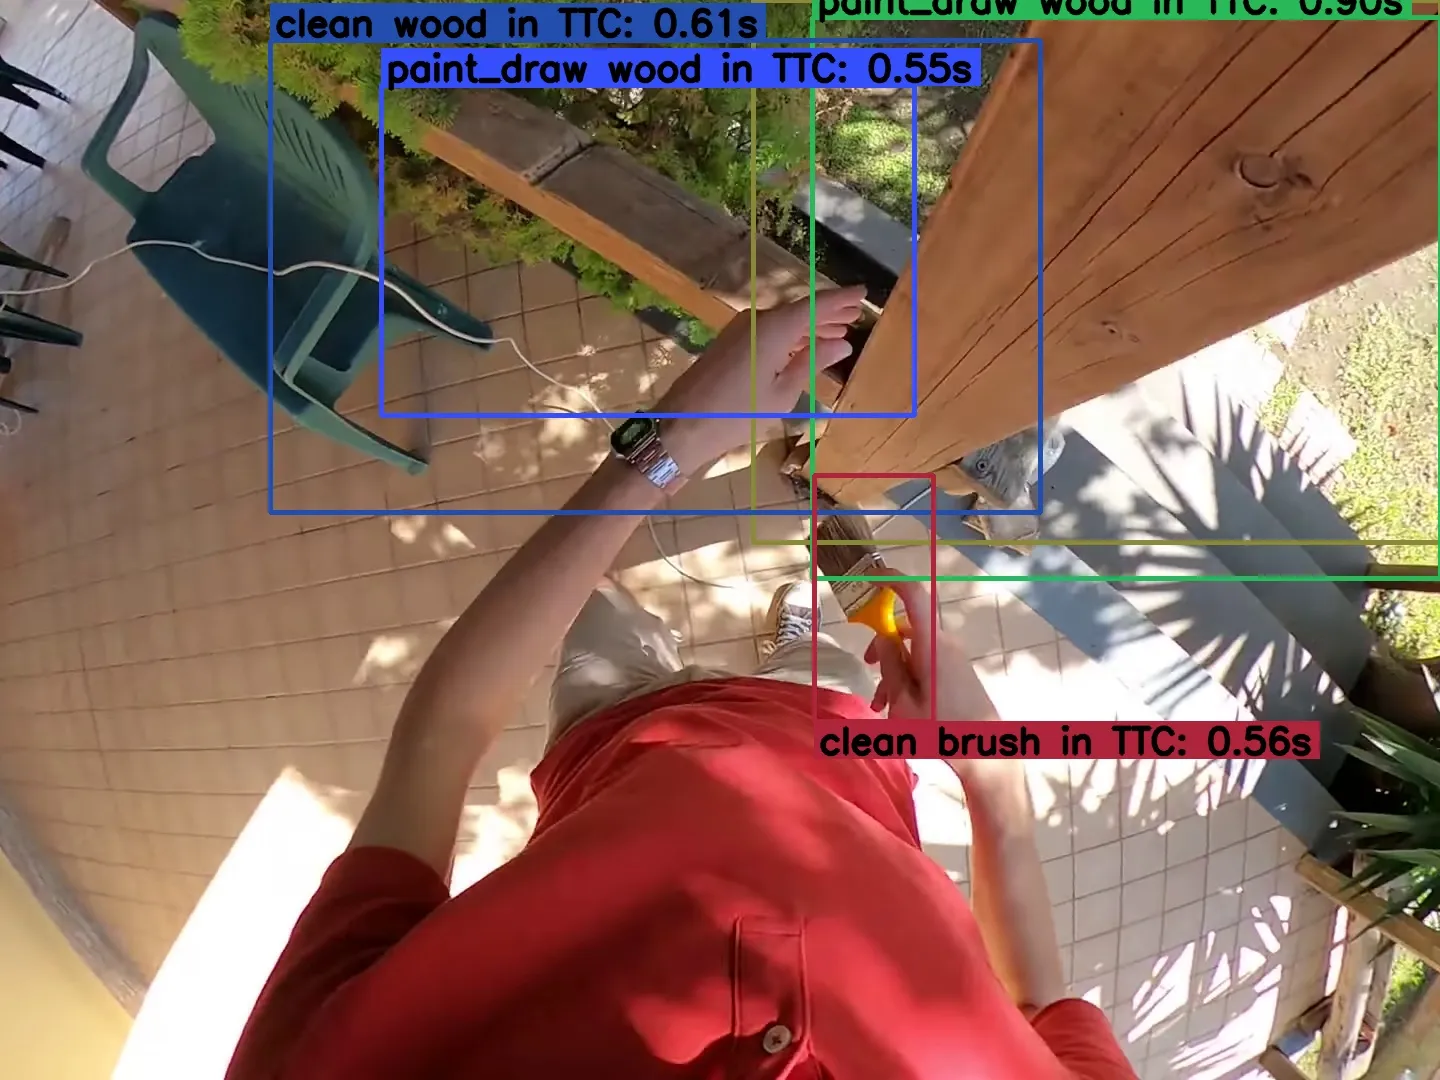
V-JEPA 2.1 预测多个场景,预测的对象和动词类别对应合理的人-物交互。
动作预判(Action Anticipation)
EPIC-KITCHENS-100:40.8 Recall@5(超越 prior 任务特定模型)
机器人任务
真实机器人抓取
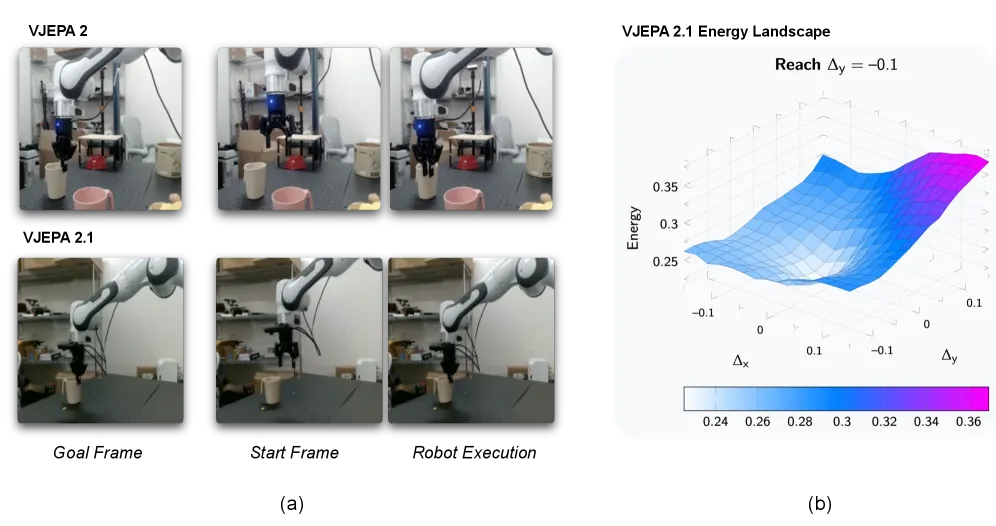
在 Franka Panda 机械臂上的零样本评估:
- V-JEPA 2.1 特征更好地编码深度信息
- 在涉及沿相机深度轴推理的抓取任务中,抓取成功率提升 20%
- 使用 MPC 和视觉目标规格
导航规划
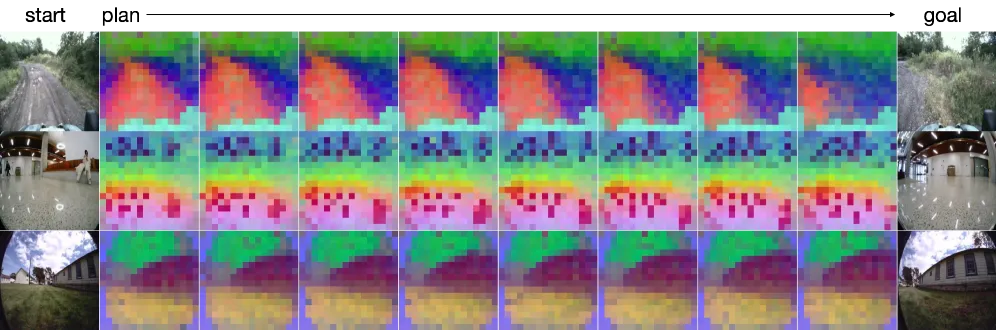
- V-JEPA 2.1 实现 10x 更快且更准确的导航规划
- 比 (Bar et al., 2025) 的基线快 10 倍
- TartanDrive:5.687 ATE(SOTA)
- 在潜在空间中展示 start→goal 的 10×10 规划轨迹
六、消融实验
各组件影响(Fig. 5)
从 ViT-L 基线开始逐步添加:
| 步骤 | 添加组件 | ADE20k 分割 | SSv2 分类 |
|---|---|---|---|
| 1 | Baseline | - | - |
| 2 | + Weighted-Context SSL () | ↑↑ | ↓ |
| 3 | + Deep Self-Supervision | ↑↑↑ | ↑ (恢复并超越) |
| 4 | + VisionMix 163M + Multi-Modal Tokenizer | ↑ | ↑ |
| 5 | + Model Scaling + High Res Cooldown | ↑↑ | ↑↑ |
关键发现:
- 单独提升分割但损害分类
- Deep Self-Supervision 恢复分类性能并进一步提升分割
- 两者结合产生最佳效果
与 DINOv3 对比
V-JEPA 2.1 ViT-G 在多项密集任务上达到或超越 DINOv3 ViT-H++(参数量更大):
- 深度估计:更锐利、更一致的深度图
- 语义分割:更精细的边界结构
- 物体跟踪:更好的尺度一致性
七、相关工作
| 工作 | 关系 |
|---|---|
| V-JEPA 2 (Assran et al., 2025) | 前身,仅 masked token 预测,密集特征质量有限 |
| V-JEPA (Bardes et al., 2024) | 原始版本,使用 stop-gradient + EMA |
| I-JEPA | 图像版本 JEPA |
| DINO/DINOv2/DINOv3 (Caron et al.) | 对比学习 SSL,密集特征质量好但全局理解弱于 JEPA |
| MAE (He et al.) | 掩码自编码器,重建像素级信号 |
| PLDM | 端到端 JEPA,使用 VICReg |
| DINO-WM | 冻结 DINOv2 编码器用于世界模型 |
| STAformer | 短期待判 SOTA,但非自监督方法 |
八、总结
核心贡献
- Dense Predictive Loss:首个在 JEPA 框架下让所有 tokens(visible + masked)参与训练损失的方法
- Context Loss :基于距离加权的 L1 损失,显式监督邻近 context tokens 的预测
- Deep Self-Supervision:多层编码器输出分层应用自监督目标
- Multi-Modal Tokenizers:统一图像和视频训练的 2D/3D 卷积 tokenizer
- SOTA 密集特征:深度估计、语义分割、物体跟踪等多项密集任务 SOTA
- SOTA 全局理解:SSv2 77.7%、EK100 40.8 Recall@5、Ego4D STA 7.71 mAP
- 机器人提升:真实机器人抓取成功率提升 20%,导航规划快 10x
技术影响
- 打破了 JEPA 全局-密集的权衡:首次在同一模型中实现 SOTA 密集特征和全局理解
- 为视觉世界模型提供了更高质量的表示:密集特征对于深度估计、分割、跟踪等下游任务至关重要
- 证明了 context supervision 的价值:不仅 masked tokens,可见 tokens 也受益于自监督目标
局限性
- Context loss 对分类的负面影响:单独使用 会降低分类性能,需配合 deep self-supervision
- 计算开销增加:多层监督和 context loss 增加了训练成本
- 3D tokenizer 容量需求:视频 tokenizer 需要更多内存和计算
- 深度估计精度仍有限:虽然比 V-JEPA 2 大幅改善,但与专门方法仍有差距
- 机器人部署范围有限:仅在 table-top Franka Panda 上验证
九、参考资源
- arXiv: https://arxiv.org/abs/2603.14482
- HTML: https://arxiv.org/html/2603.14482v1
- Code: https://github.com/facebookresearch/vjepa2
- V-JEPA 2 前身: Assran et al. (2025), https://arxiv.org/abs/2506.09985
- V-JEPA 原版: Bardes et al. (2024)
- DINOv3: Siméoni et al. (2025)
- STAformer: Mur-Labadia et al. (2024)