Fish Audio S2 Technical Report
开源可控文本到语音系统,支持多说话人、多轮对话和自然语言指令控制
Fish Audio S2 Technical Report
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Fish Audio S2 Technical Report |
| 作者 | Shijia Liao, Yuxuan Wang, Songting Liu, Yifan Cheng, Ruoyi Zhang, Tianyu Li, Shidong Li, Yisheng Zheng, Xingwei Liu, Qingzheng Wang, Zhizhuo Zhou, Jiahua Liu, Xin Chen, Dawei Han |
| 机构 | Fish Audio |
| 论文 | arXiv:2603.08823 |
| 代码 | GitHub |
| 模型 | HuggingFace |
| 演示 | fish.audio |
| 发布 | 2026年3月 |
| 许可 | CC BY 4.0 |
| 硬件平台 | NVIDIA H200 GPU(推理) |
二、核心思想
问题定义
高质量、可控的文本到语音(TTS)系统在现代 AI 应用中至关重要,包括有声书朗读、视频配音和个性化聊天机器人等场景。当前 TTS 系统面临以下关键挑战:
- 指令跟随能力不足: 难以通过自然语言描述精细控制语音生成的韵律、情感和说话风格
- 数据标注瓶颈: 为大规模语音数据生成细粒度自然语言指令仍然是主要瓶颈
- 分布偏移问题: 预训练过滤模型与 RL 奖励信号之间的分布不匹配导致训练效果不佳
- 多说话人多轮对话: 现有系统难以在单次生成中处理多个说话人的交错对话
解决方案概述
Fish Audio S2 是一个开源 TTS 系统,基于 Fish Audio S1 的 decoder-only Transformer 骨干和 RVQ 音频编解码器,通过以下核心创新实现突破:
- Dual-AR 架构: 解耦时间语义建模和深度声学建模
- 多用途数据管道: 语音质量模型和富转录 ASR 模型同时用于预训练过滤和 RL 奖励信号
- 多维度 RL 对齐: 基于 GRPO 的多奖励强化学习,联合优化语义准确性、声学质量和说话人相似度
核心性能
- RTF: 0.195(实时因子)
- TTFA: <100 ms(首音时间)
- 吞吐量: 3000+ 声学 tokens/秒
- WER: 中文 0.54%,英文 0.99%(Seed-TTS-Eval)
- 支持语言: 80+ 种语言和方言
三、技术架构
整体框架
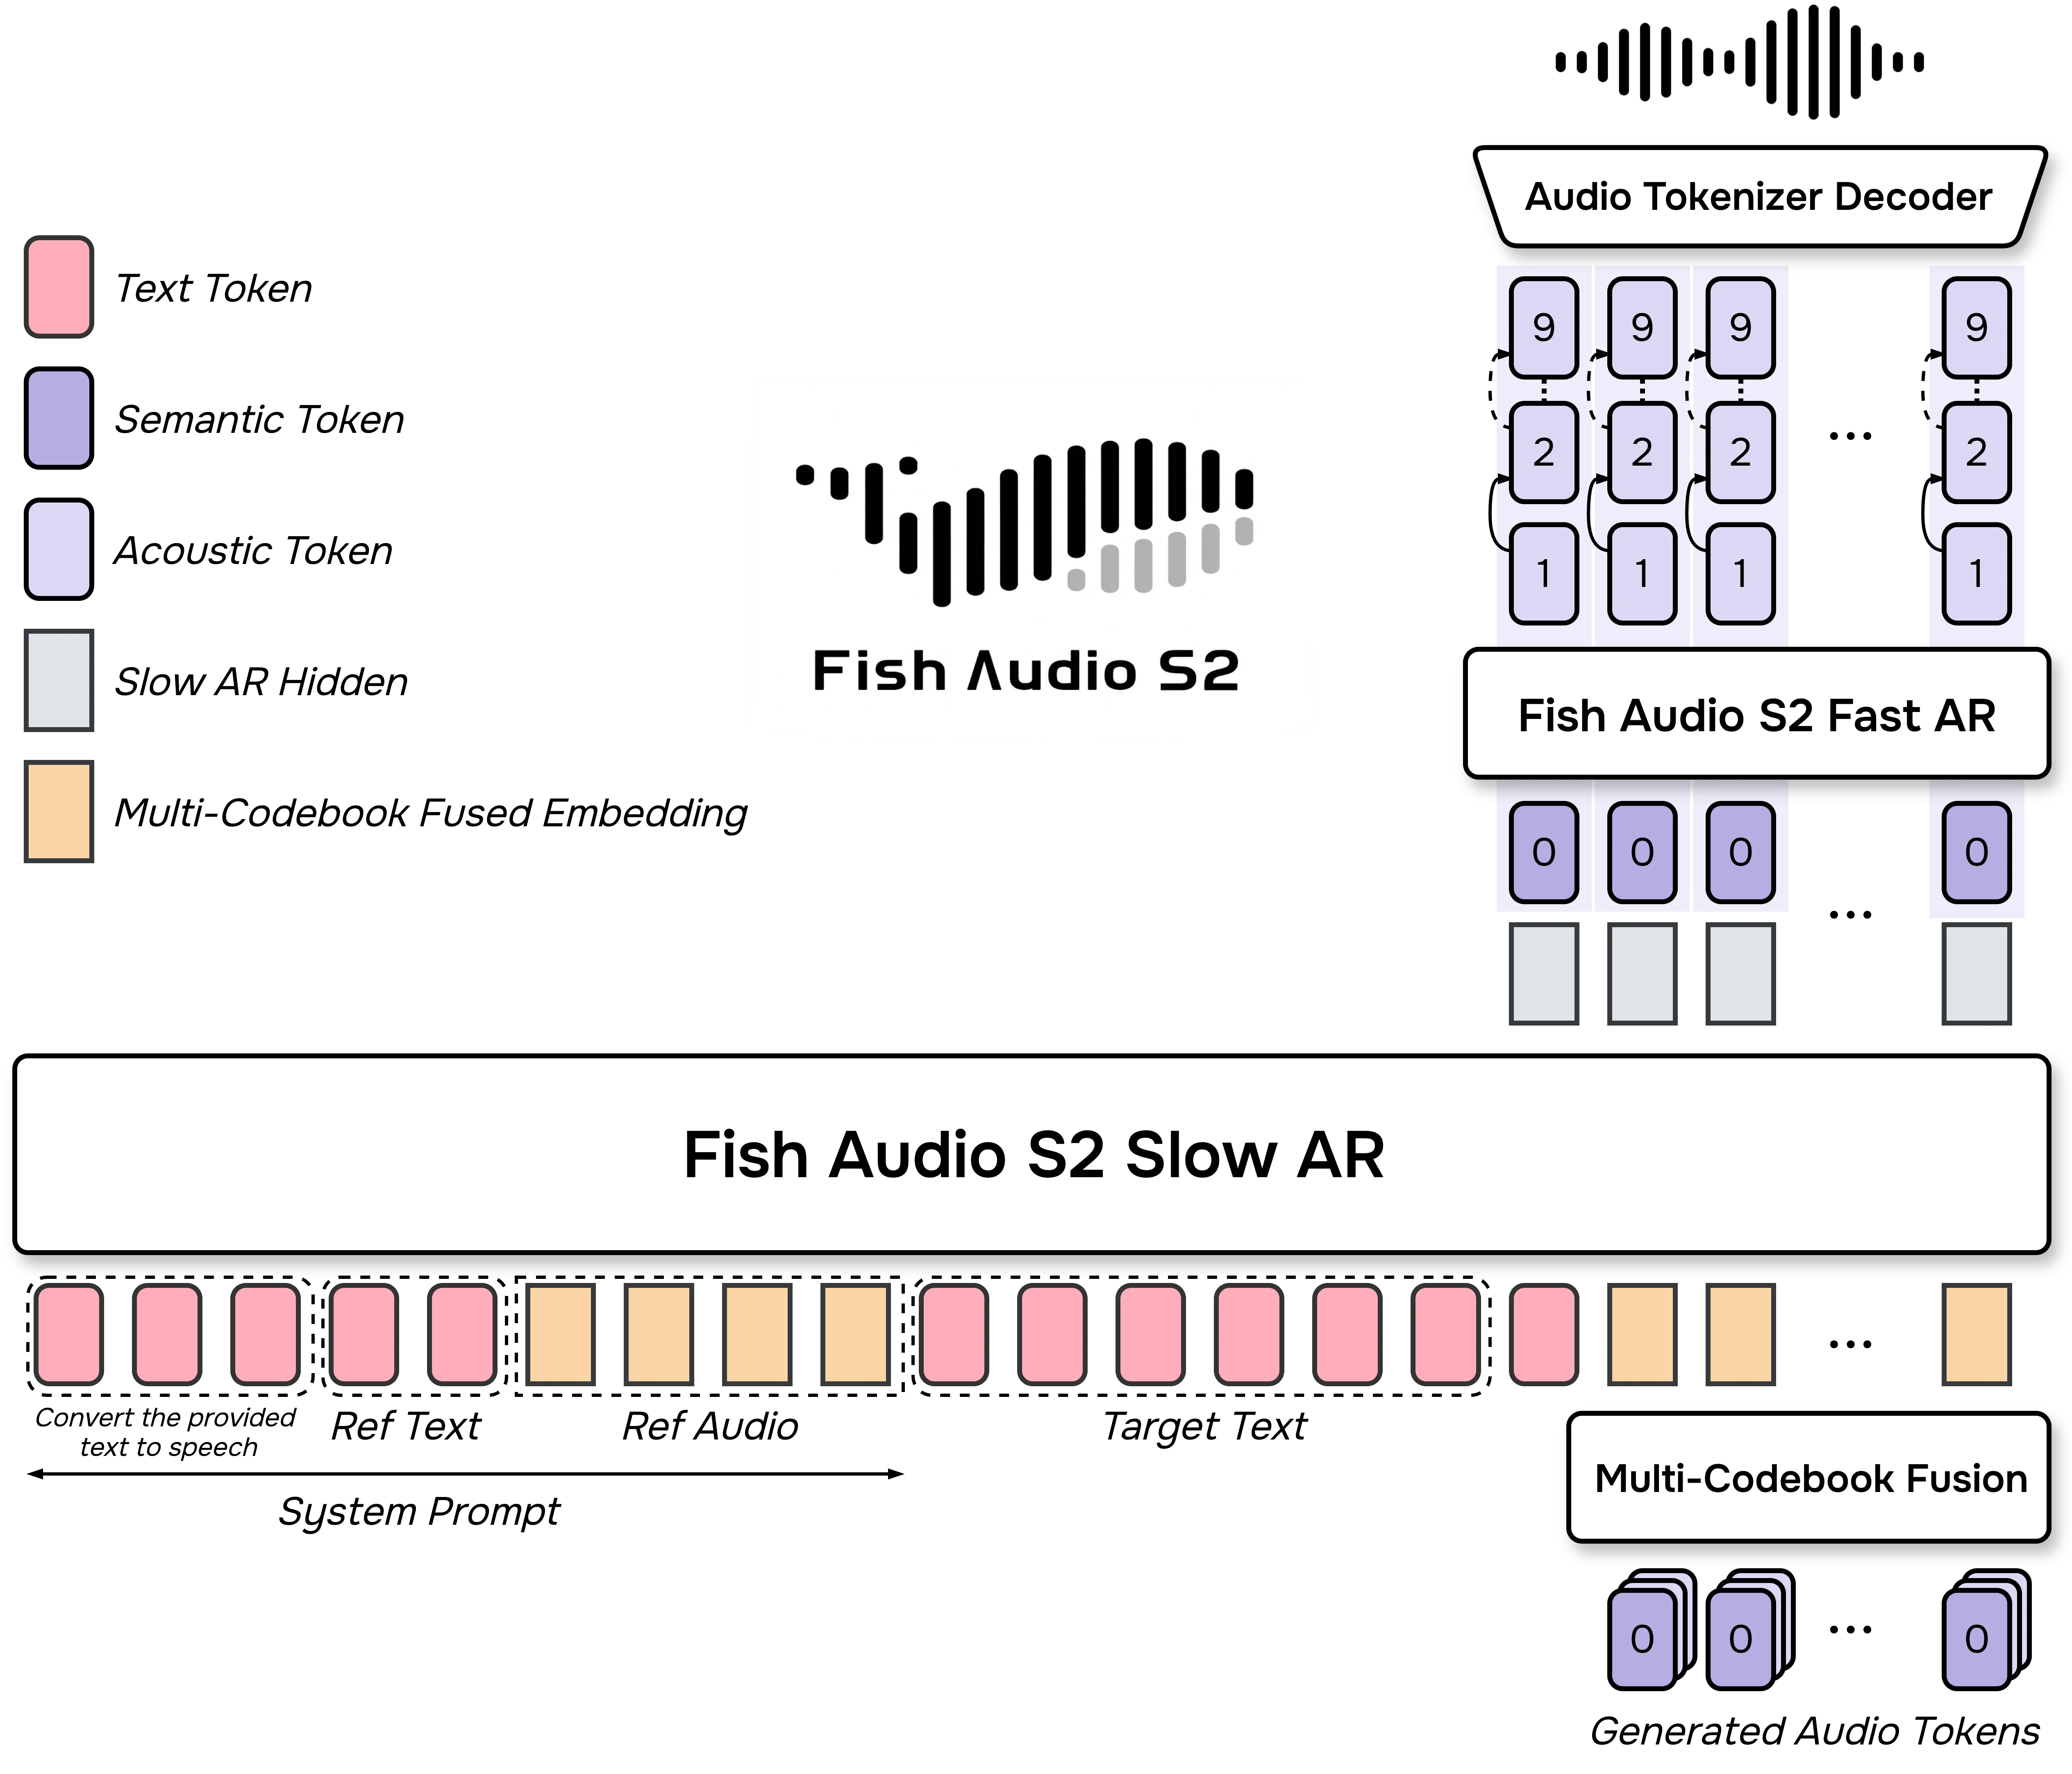
Figure 2: Fish Audio S2 架构
Audio Tokenizer
基于 Descript Audio Codec (DAC) 架构,针对高保真实时流式传输优化:
RVQ 策略:
- 采样率: 44.1 kHz
- 码本数量: N=10
- 第一个码本: 语义码本
- 剩余 9 个码本: 捕获渐进式细粒度声学细节
流式架构:
- 因果卷积: 使用掩码因果卷积替代标准卷积,确保严格因果性
- Transformer 瓶颈: 在 RVQ 层前后集成因果滑动窗口 Transformer 块
- 扩展下采样: 标准 DAC 编码器 (512x) + ConvNeXt V2 层 (4x) = 总下采样比 2048,帧率约 21 Hz
- EVA-GAN 解码器: 使用 EVA-GAN 结构替代原始 DAC 解码器
语义蒸馏:
- 辅助语义预测头联合优化,回归预训练 w2v-BERT 2.0 模型的第 16 层激活
- 确保第一个码本捕获丰富的语言和语音信息
模型参数: 446M 参数,训练约 1M 步
Dual-Autoregressive 生成
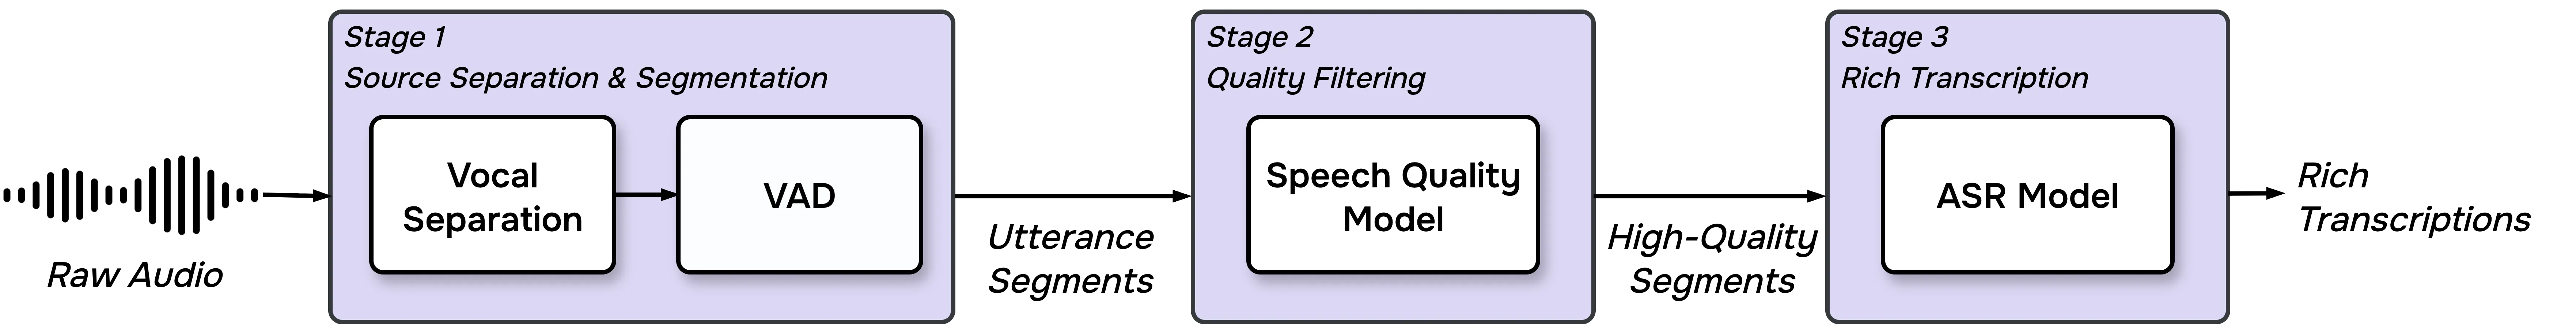
Figure 3: Fish Audio S2 数据管道
为解决直接展平 10 层 RVQ 码本的维度挑战,采用 Dual-AR 架构解耦时间语义建模和深度声学建模:
Slow AR(慢自回归):
- 骨干网络: 预训练 Qwen3-4B
- 操作: 在完整 token 序列上自回归
- 输出: 每个时间步 t 预测第一个 RVQ 码本的语义 token
Fast AR(快自回归):
- 结构: 4 层 Transformer,独立权重和嵌入表
- 输入: Slow AR 生成的语义 token
- 输出: 重建剩余的细粒度声学细节
Multi-Codebook Fusion (MCF):
- 在时间步 t 的所有 N 个码本 token 生成后
- 聚合为单个连续向量
- 作为 Slow AR 在时间步 t+1 的输入嵌入
核心公式
RVQ 量化:
其中 是第 n 层残差, 是第 n 个码本。
Dual-AR 生成:
Multi-Codebook Fusion:
四、数据管道
三阶段数据整理
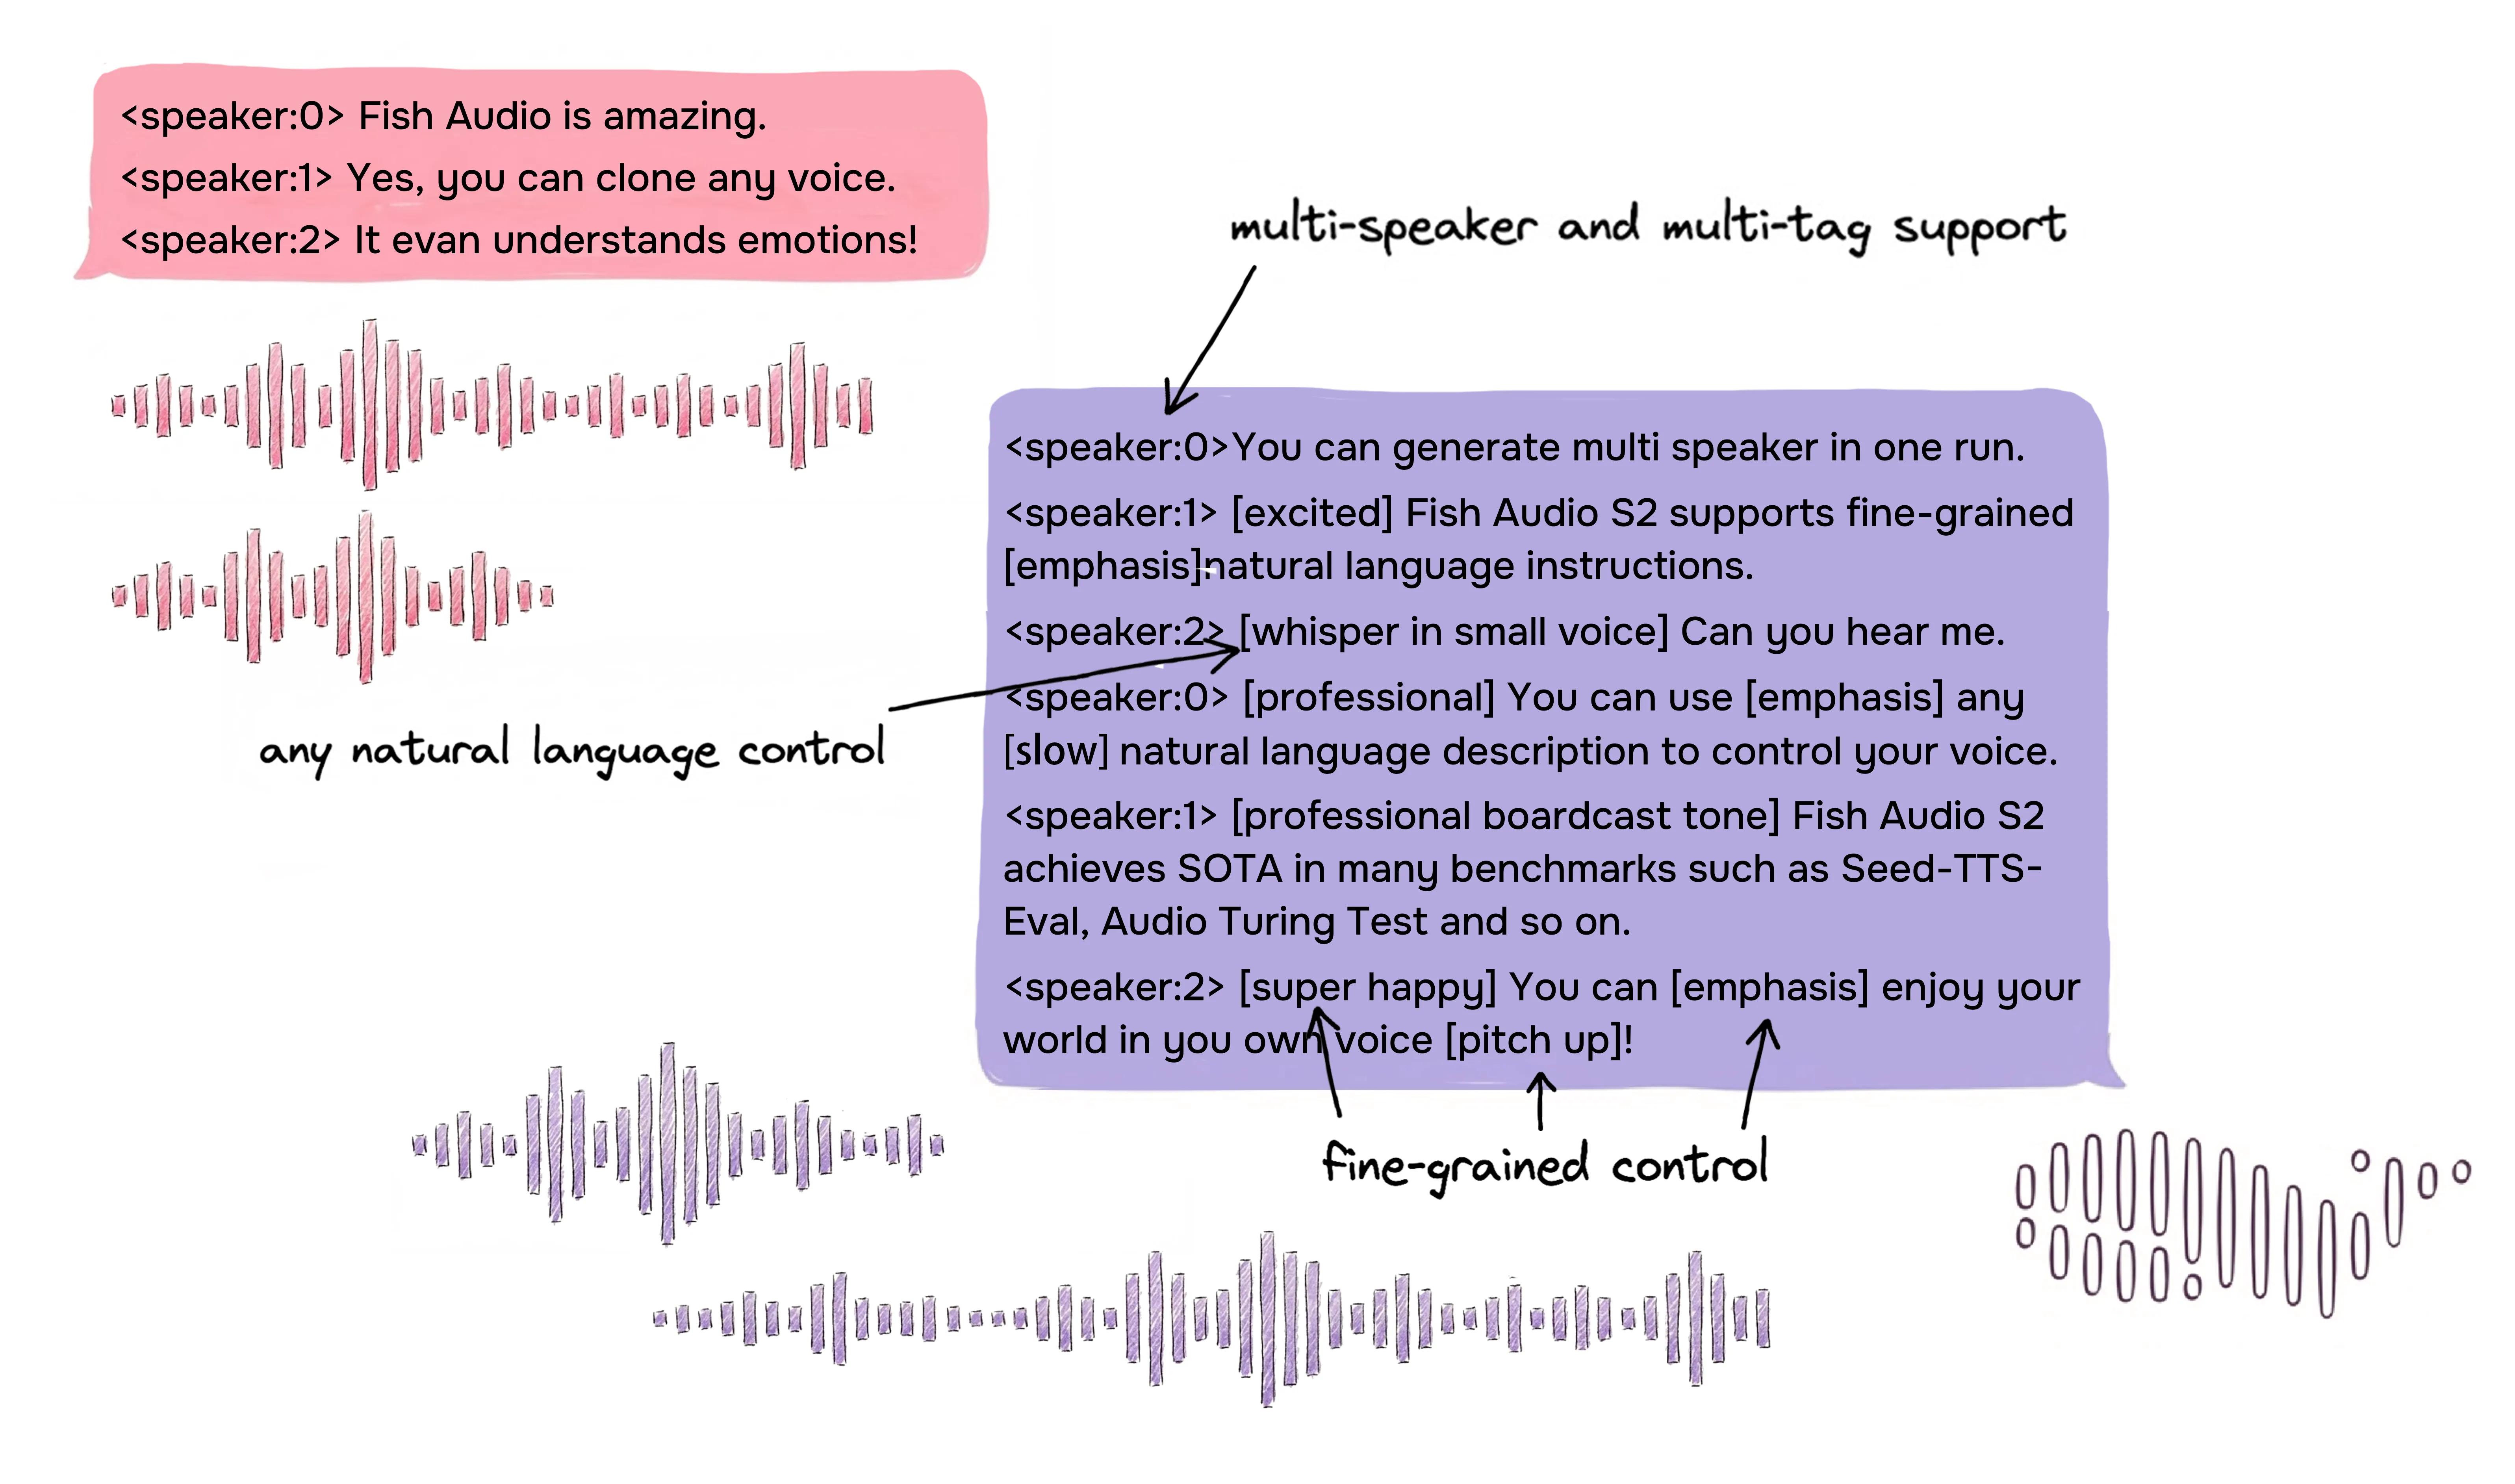
Figure 4: Fish Audio S2 支持细粒度自然语言控制的多说话人生成
阶段 1: 源分离和分段
- 人声分离模块从背景噪声中隔离干净语音
- 语音活动检测 (VAD) 将连续音频切分为话语级片段
阶段 2: 质量过滤
- 语音质量模型评估每个话语的多个维度
- 过滤低保真样本
阶段 3: 富转录
- 内部 ASR 模型生成高度准确的转录
- 包含说话人轮换和语音事件标注
语音质量模型
- 架构: 基于 Uni-VERSA 设计
- 骨干: 预训练 w2v-BERT 2.0
- 头部: MLP 用于声学评估
富转录 ASR 模型
- 基础模型: 微调 Qwen3-Omni-30B-A3B
- 功能: 联合转录语音内容、标注说话人轮换和语音事件
- 输出: 预测说话人轮换(如
<|speaker:0|>)并注入语音指令(如[prolonged laugh],[inhale],[angry],[emphasis],[in a hurry])
五、训练流程
四阶段训练
阶段 1: Audio Tokenizer 训练
- 参数: 446M
- 步数: ~1M 步
- 损失: 复合 GAN 损失框架,包含三个判别器
阶段 2: 预训练
- 对齐音频 token 与 Qwen3-4B 基础模型
- 两个渐进阶段
- 数据: 超过 1000 万小时原始音频,约 80 种语言和方言
- Token: 超过 5000 亿 tokens
- 词表扩展: 结构控制 token + 4096 语义 token
阶段 3: SFT
- 在内部策划的高质量标注数据上微调
阶段 4: RL 后训练
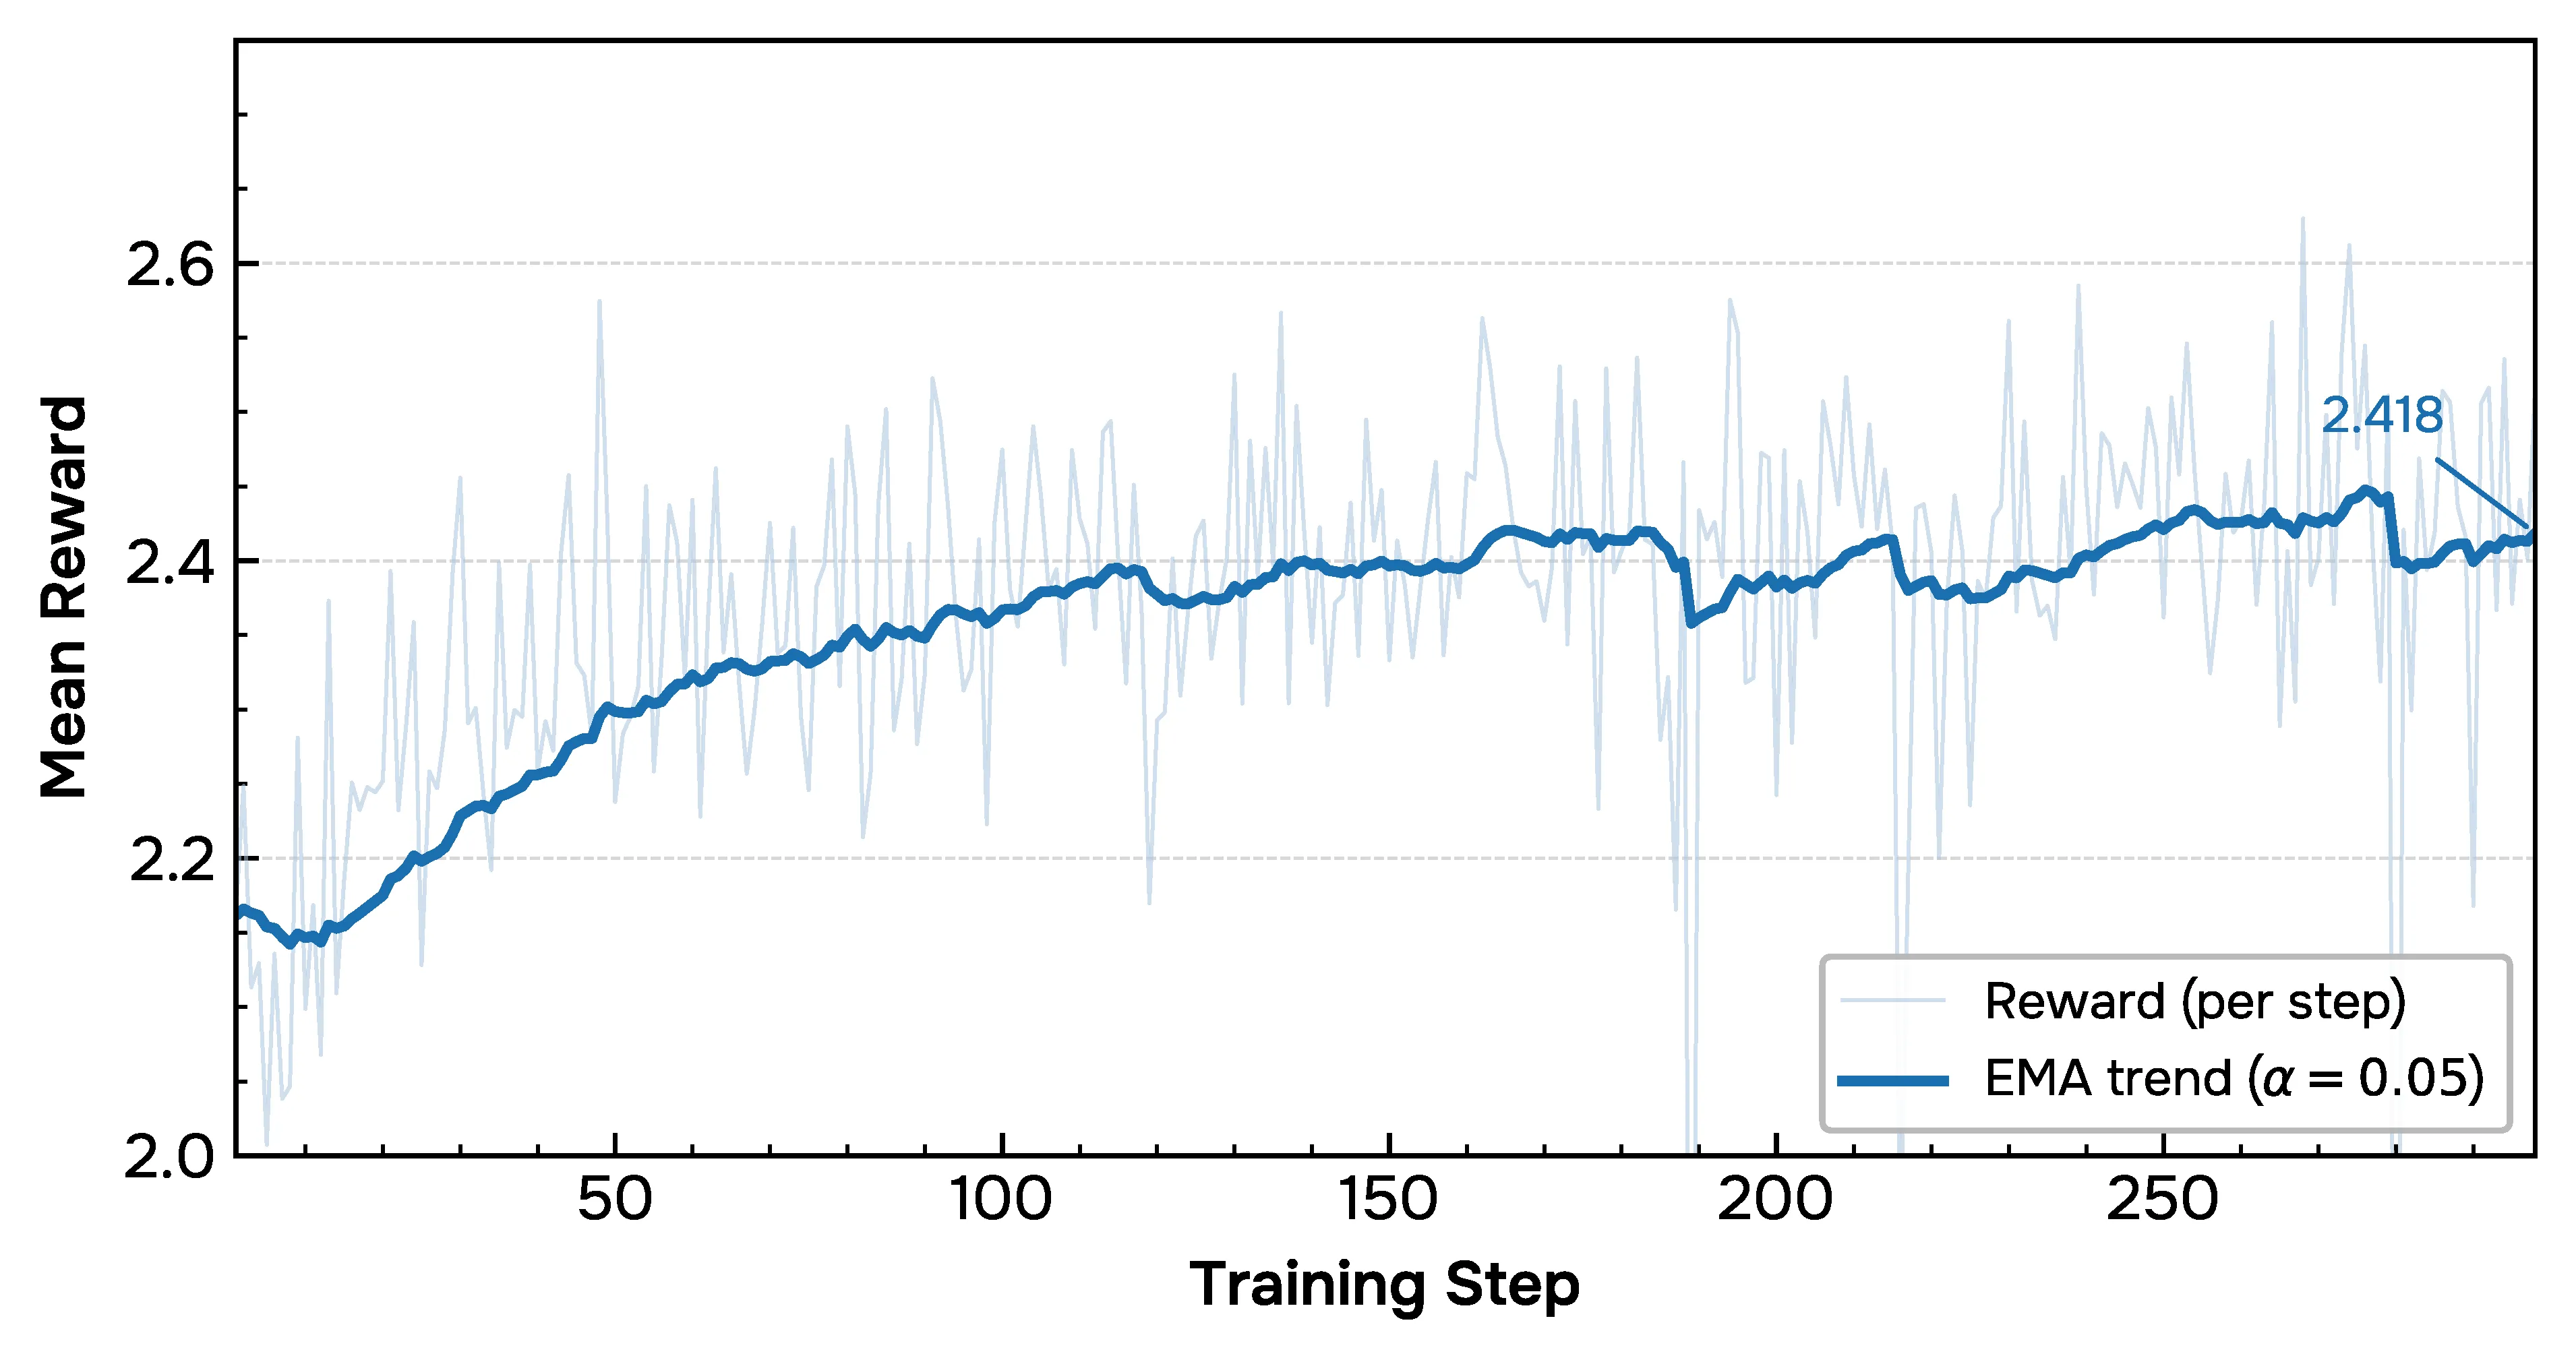
Figure 5: RL 后训练期间的训练奖励曲线
基于 GRPO 和 Dr.GRPO 的 RL 算法,目标是缓解幻觉、token 跳过和音色漂移。
多维度奖励系统:
| 奖励 | 模型 | 功能 |
|---|---|---|
| R_STT(语义准确性) | ASR 转录模型 | token 加权掩码用于说话人 ID 标签和语音指令 |
| R_Pref(声学偏好) | 语音质量模型 | 评估声学质量 |
| R_SIM(音色相似度) | 声纹模型 | 提取特征计算余弦相似度 |
关键创新: 数据管道中的语音质量模型和富转录 ASR 模型直接复用为 RL 奖励信号,消除两个阶段之间的分布偏移。
六、推理引擎
基于 SGLang 构建的生产级推理引擎:
特性:
- 连续批处理 (Continuous Batching)
- 分页 KV 缓存 (Paged KV Cache)
- CUDA 图重放 (CUDA Graph Replay)
- RadixAttention 高效前缀缓存
性能(NVIDIA H200 GPU):
| 指标 | 数值 |
|---|---|
| 实时因子 (RTF) | 0.195 |
| 首音时间 (TTFA) | <100 ms |
| 吞吐量 | 3000+ 声学 tokens/秒 |
七、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Dual-AR 架构 | 解耦时间语义建模和深度声学建模 | Slow AR (Qwen3-4B) + Fast AR (4层Transformer) |
| 多用途数据管道 | 同一模型用于预训练过滤和 RL 奖励 | 消除分布偏移 |
| 多维度 RL 对齐 | GRPO 联合优化三个维度 | 语义准确性 + 声学质量 + 音色相似度 |
| 语义蒸馏 | w2v-BERT 2.0 激活回归 | 确保第一个码本捕获语言信息 |
| 富转录 ASR | Qwen3-Omni-30B-A3B 微调 | 说话人轮换 + 语音事件标注 |
| 流式架构 | 因果卷积 + 滑动窗口 Transformer | 21 Hz 帧率,实时流式传输 |
八、实验结果
客观评估
Seed-TTS-Eval(WER %):
| 模型 | test-zh | test-en | zh-hard |
|---|---|---|---|
| Fish Audio S2 | 0.54 | 0.99 | 5.99 |
| Fish Audio S1 | 0.54 | 1.07 | 17.00 |
| CosyVoice 3-1.5B | 1.12 | 2.21 | 5.83 |
| Qwen3-TTS | 0.77 | 1.24 | - |
| Seed-TTS | 1.12 | 2.25 | 7.59 |
| MiniMax Speech-02 | 0.99 | 1.90 | - |
关键发现: Fish Audio S2 在中文和英文 WER 上均达到最优,中文硬案例 WER 从 S1 的 17.00% 大幅降低至 5.99%。
多语言评估(Minimax Testset - WER %)
| 语言 | MiniMax | ElevenLabs | Fish Audio S2 | Fish Audio S1 |
|---|---|---|---|---|
| 中文 | 2.252 | 16.026 | 0.730 | 0.980 |
| 英文 | 2.164 | 2.339 | 1.620 | 2.370 |
| 日语 | 3.519 | 10.646 | 2.760 | 3.450 |
| 韩语 | 1.747 | 1.865 | 1.180 | 1.990 |
| 德语 | 1.906 | 0.572 | 0.550 | 0.650 |
| 法语 | 4.099 | 5.216 | 3.050 | 5.700 |
| 西班牙语 | 1.029 | 1.084 | 0.910 | 1.780 |
关键发现: Fish Audio S2 在 7 种语言中的 6 种上超越所有基线,仅德语略逊于 ElevenLabs。
长音频基准
| 模型 | 英文 WER | 英文 SIM-Mean | 英文 SIM-Std | 中文 CER | 中文 SIM-Mean | 中文 SIM-Std |
|---|---|---|---|---|---|---|
| Fish Audio S2 | 4.38 | 0.523 | 0.0761 | 5.95 | 0.557 | 0.0923 |
| Fish Audio S1 | 6.26 | 0.436 | 0.108 | 6.44 | 0.505 | 0.108 |
| Qwen3-TTS | 7.69 | 0.390 | 0.0737 | 8.09 | 0.574 | 0.0614 |
关键发现: Fish Audio S2 在长音频合成中显著优于 S1 和 Qwen3-TTS,WER 降低 30%+,说话人相似度提升 20%+。
LLM-as-a-Judge 评估
Audio Turing Test(后验均值):
| 模型 | 均值 (标准差) | 95% HDI |
|---|---|---|
| Fish Audio S2 (w/ instruction) | 0.515 (0.061) | [0.510, 0.521] |
| Fish Audio S2 | 0.483 (0.068) | [0.477, 0.489] |
| Fish Audio S1 | 0.479 (0.087) | [0.471, 0.486] |
| Seed-TTS | 0.417 (0.011) | [0.398, 0.438] |
| MiniMax-Speech | 0.387 (0.011) | [0.368, 0.407] |
| GPT-4o | 0.138 (0.011) | [0.118, 0.158] |
关键发现: Fish Audio S2 带指令版本得分 0.515,超过人类基准(0.5),表明生成的语音几乎无法与真人区分。
Emergent TTS Eval(胜率 %):
| 模型 | WER | 胜率 |
|---|---|---|
| Fish Audio S2 (强提示) | 8.15 | 81.88% |
| Gemini-2.5-Flash-Preview-TTS | 6.35 | 79.10% |
| gpt-4o-audio-preview | 7.75 | 77.36% |
| Fish Audio S1 | 7.60 | 36.88% |
指令跟随基准
| 数据集 | 指标 | Fish Audio S2 | Fish Audio S1 |
|---|---|---|---|
| 中文 | TAR | 0.984 | 0.942 |
| 中文 | 自然度 | 4.40 | 4.15 |
| 中文 | 表现力 | 4.94 | 4.65 |
| 英文 | TAR | 0.881 | 0.626 |
| 英文 | 自然度 | 4.21 | 3.71 |
| 英文 | 表现力 | 4.50 | 3.93 |
关键发现: Fish Audio S2 在指令跟随准确率上大幅提升,英文 TAR 从 0.626 提升至 0.881(+40%)。
九、与现有方法对比
| 系统 | 架构 | RL 对齐 | 多说话人 | 指令控制 | 开源 |
|---|---|---|---|---|---|
| Fish Audio S2 | Dual-AR (Qwen3-4B) | GRPO 多维度 | 原生支持 | 自然语言 | 完全开源 |
| Fish Audio S1 | Dual-AR | 无 | 有限 | 有限 | 开源 |
| CosyVoice 3 | Flow Matching | 无 | 支持 | 有限 | 部分开源 |
| Qwen3-TTS | Transformer | 无 | 支持 | 有限 | 部分开源 |
| Seed-TTS | Transformer | DPO | 支持 | 有限 | 不开源 |
| MiniMax Speech-02 | 未知 | 未知 | 支持 | 支持 | 不开源 |
| GPT-4o TTS | 未知 | 未知 | 支持 | 支持 | 不开源 |
十、总结
核心贡献
- Dual-AR 架构: 解耦时间语义建模和深度声学建模,Slow AR (Qwen3-4B) 处理语义,Fast AR (4层Transformer) 处理声学细节
- 多用途数据管道: 语音质量模型和富转录 ASR 模型同时用于预训练过滤和 RL 奖励信号,消除分布偏移
- 多维度 RL 对齐: 基于 GRPO 联合优化语义准确性、声学质量和说话人相似度
- 生产级推理引擎: 基于 SGLang,RTF 0.195,TTFA <100ms,3000+ tokens/秒
- 完全开源: 模型权重、微调代码、推理引擎全部开源
技术影响
- TTS 领域: 首个在 Audio Turing Test 中超过人类基准的开源系统
- RL 对齐: 将 LLM 领域的 GRPO 成功应用于 TTS,为语音合成的 RL 对齐开辟新方向
- 数据工程: 多用途数据管道设计范式,消除预训练和 RL 阶段的分布偏移
- 开源生态: 为社区提供完整的 TTS 训练和推理基础设施
局限性
- 仅提供技术报告,缺少详细的消融实验
- RL 训练细节(如奖励权重、采样策略)未充分公开
- 长音频合成的稳定性仍需进一步验证
- 多说话人对话的自然度在复杂场景下可能下降
适用场景
- 有声书朗读和视频配音
- 个性化聊天机器人语音
- 多语言语音合成
- 实时流式语音生成
- 细粒度语音风格控制
十一、参考资源
- 论文: arXiv:2603.08823
- 代码: GitHub - fishaudio/fish-speech
- 模型: HuggingFace - fishaudio/s2-pro
- 演示: fish.audio
- 许可: CC BY 4.0