Scalable Training of Mixture-of-Experts Models with Megatron Core
NVIDIA提出基于Megatron Core的可扩展MoE模型训练方法,支持大规模混合专家模型的高效分布式训练。
Scalable Training of Mixture-of-Experts Models with Megatron Core
基本信息
| 项目 | 内容 |
|---|---|
| 论文标题 | Scalable Training of Mixture-of-Experts Models with Megatron Core |
| arXiv ID | 2603.07685 |
| 提交日期 | 2026年3月8日 |
| 作者 | Zijie Yan, Hongxiao Bai, Xin Yao 等 45 位作者(NVIDIA) |
| 类型 | 技术报告,88 页,42 张图 |
| 领域 | 分布式/并行/集群计算 (cs.DC), 计算语言学 (cs.CL), 机器学习 (cs.LG) |
摘要
扩展 Mixture-of-Experts (MoE) 训练引入了密集模型中不存在的系统挑战。由于每个 token 仅激活专家的子集,这种稀疏性使得总参数量可以比每 token 计算量增长快得多,从而在内存、通信和计算之间产生耦合约束。优化一个维度往往会将压力转移到另一个维度,需要在整个系统栈上进行协同设计。
本报告通过集成优化来解决这些挑战,涵盖:
- 内存优化: 细粒度重计算、卸载等
- 通信优化: 优化的分发器、重叠等
- 计算优化: Grouped GEMM、融合、CUDA Graphs 等
框架还提供 Parallel Folding 用于灵活的多维并行、FP8 和 NVFP4 低精度训练支持以及高效的长上下文训练。在 NVIDIA GB300 和 GB200 上,DeepSeek-V3-685B 达到 1,233/1,048 TFLOPS/GPU,Qwen3-235B 达到 974/919 TFLOPS/GPU。
一、核心思想与问题定义
1.1 MoE 的稀疏性本质
MoE 模型通过将每个 token 路由到专家子集而非激活所有参数,实现了计算量与参数量的解耦。给定输入 token 表示 ,路由器计算 个专家上的概率分布:
MoE 层的输出为:
其中 表示第 个专家网络。这种架构提供了三个关键优势:
- 可扩展容量: 通过添加更多专家,模型容量可以独立于计算成本增长
- 计算效率: 每个 token 仅激活部分参数,减少 FLOPs
- 专业化: 不同专家可以专门处理不同类型的输入
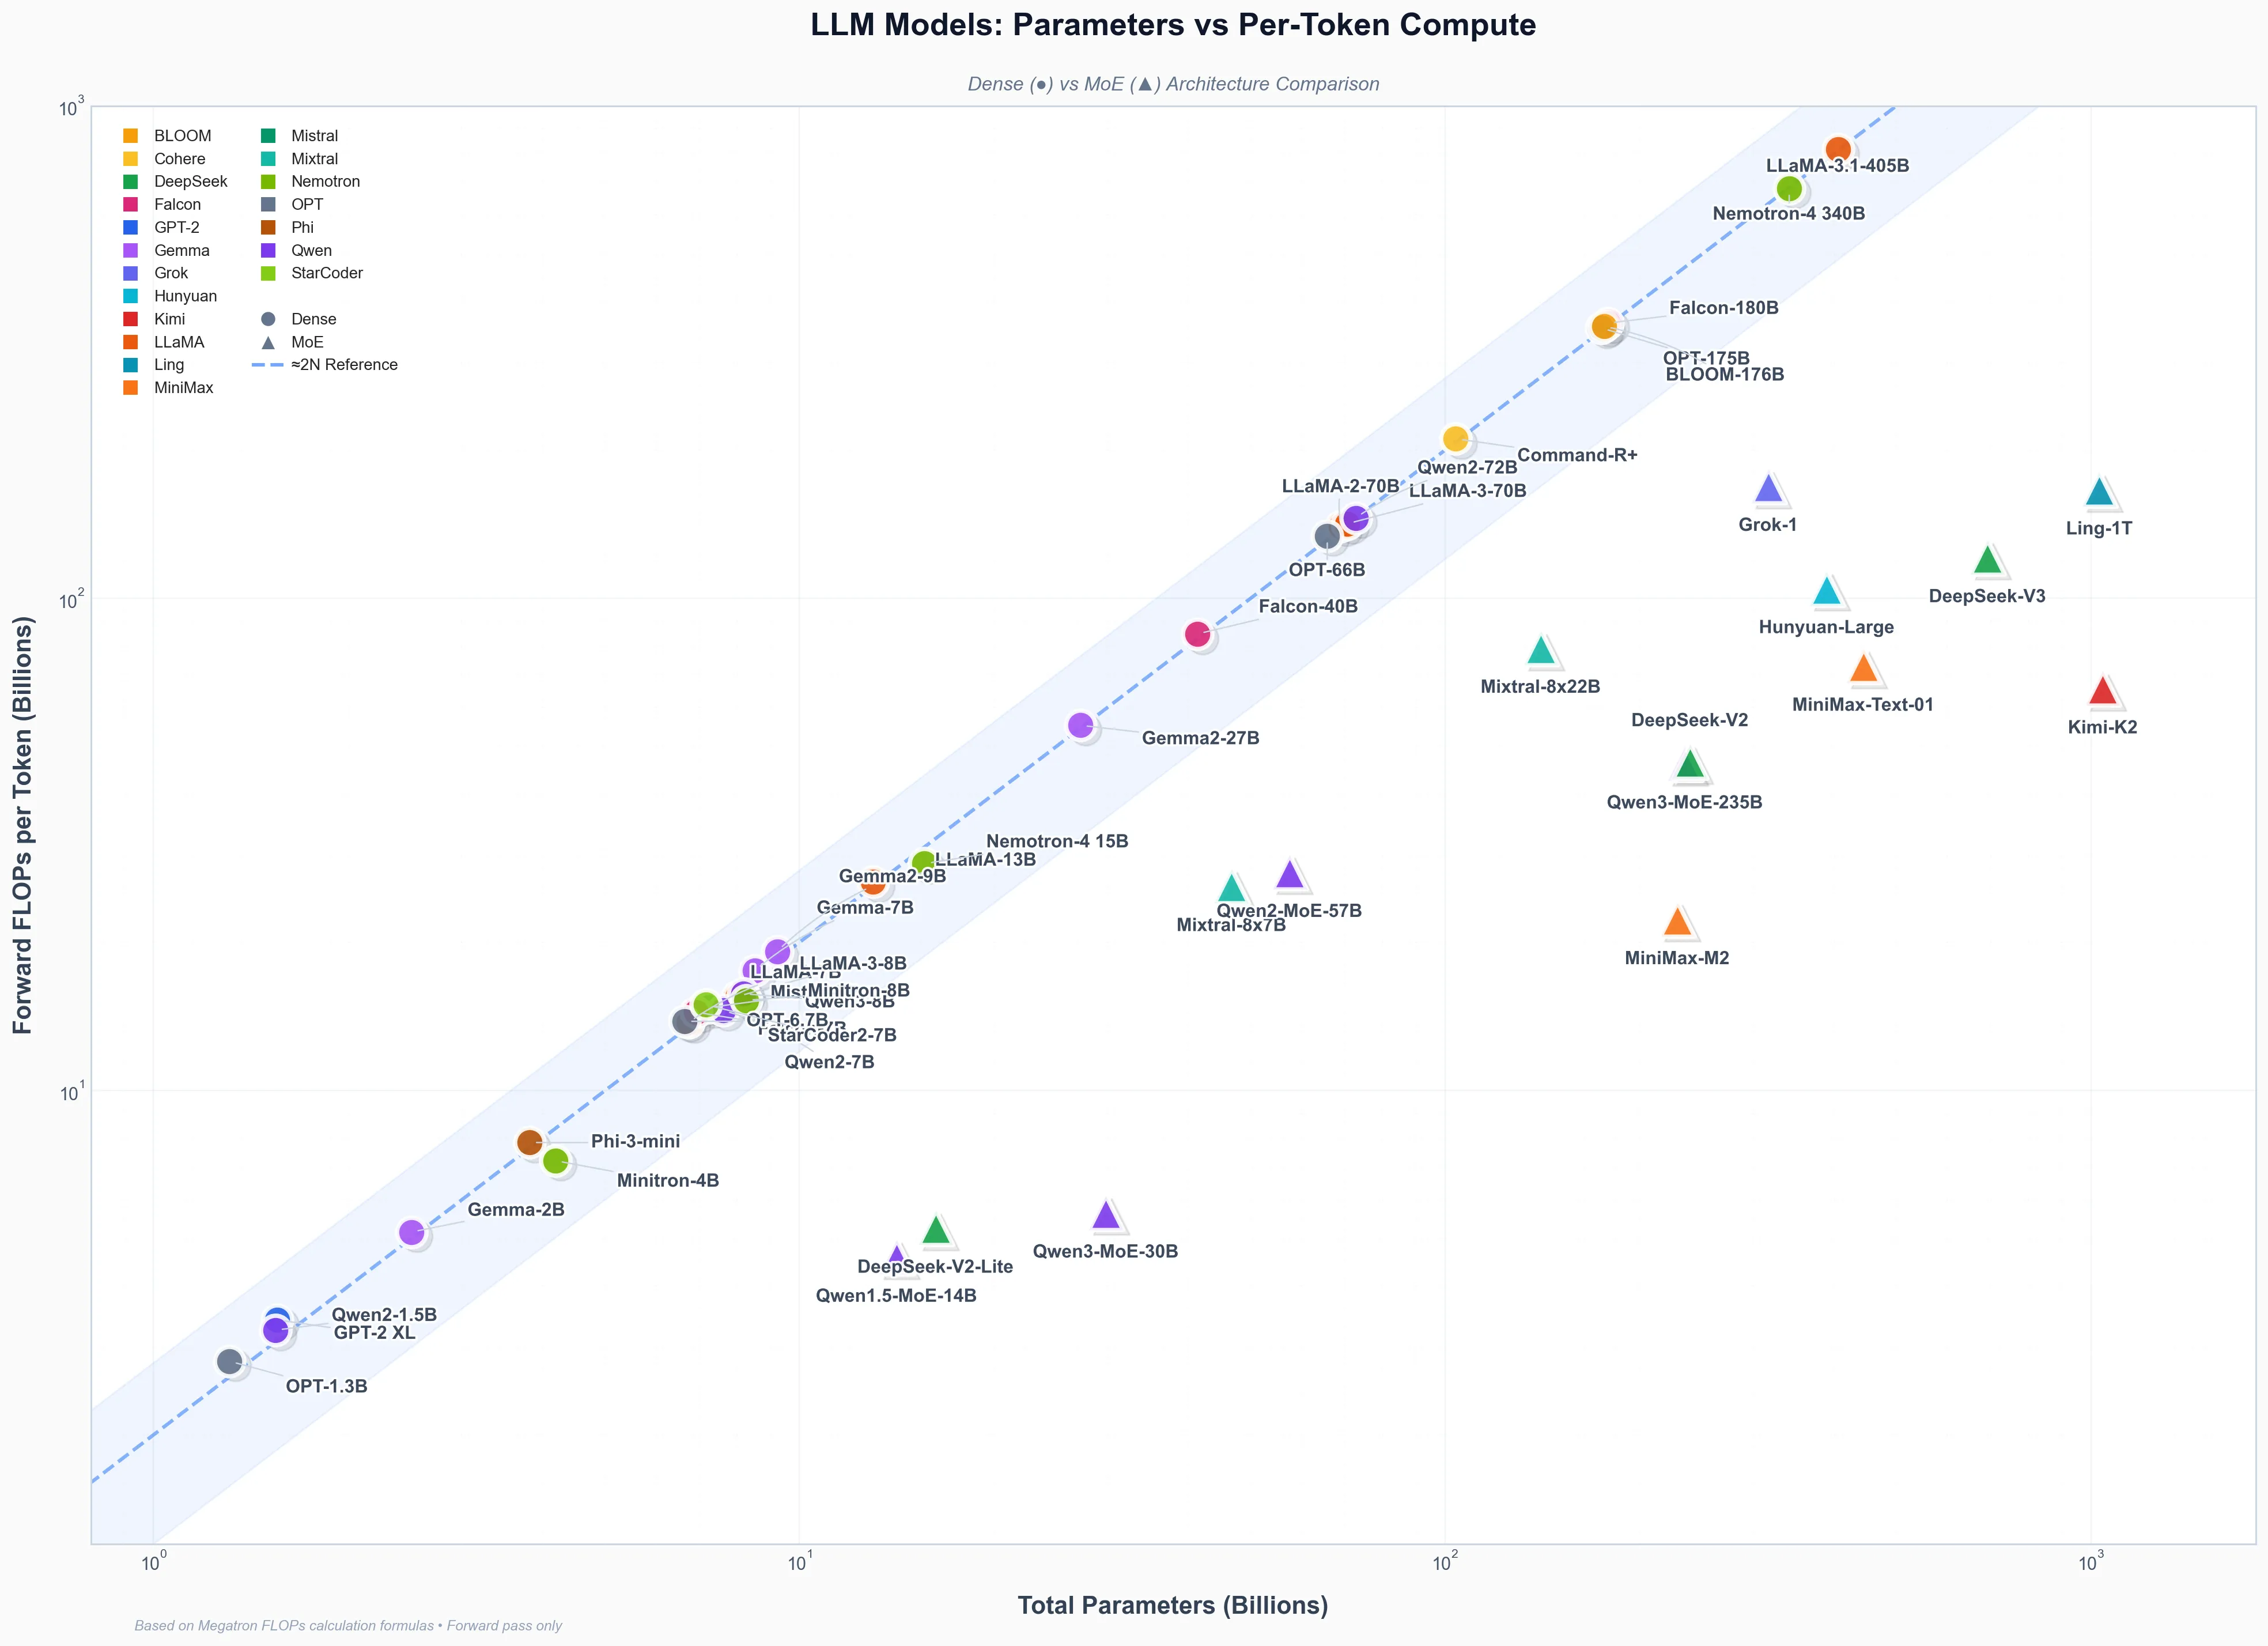
1.2 参数-计算失配(Parameter-Compute Mismatch)
MoE 稀疏性导致的根本不对称:
| 模型 | 总参数 | 激活参数 | 比例 |
|---|---|---|---|
| Llama-70B (密集) | 70B | 70B | 1:1 |
| DeepSeek-V3 (MoE) | 685B | 37B | 18:1 |
DeepSeek-V3 的总参数是其激活计算的 18 倍,这创造了复合效应:
- 内存增长快: 所有 个专家的参数、梯度和优化器状态必须驻留在内存中
- 通信更多: 通过 EP 分布专家引入 all-to-all 流量
- 计算保持低水平: 每 token FLOPs 仅随 缩放(),而非 ()
1.3 三面墙(The Three Walls)
MoE 训练的三个根本性障碍:
内存墙(Memory Wall)
所有 个专家的参数、梯度和优化器状态必须驻留在内存中,即使每 token 仅激活 个专家。以 DeepSeek-V3 BF16 训练为例(PP4 × VPP4 × EP64,256 GPU):
| 组件 | 每 GPU 内存 | 优化技术 |
|---|---|---|
| 权重和梯度 | 36.4 GB | PP、EP 或 TP 分片 |
| 主权重和优化器状态 | 32.1 GB | 分布式优化器、BF16 动量 |
| 激活值 | 131.0 GB | 低精度、重计算、卸载 |
| 总计 | 199.5 GB |
通信墙(Communication Wall)
EP 需要 all-to-all 集合通信来分发 token 并收集结果。每 GPU 发送量约为:
其中 是本地 token 数, 是 top-k, 是隐藏维度。在 DeepSeek-V3 这样的架构中,未优化的 all-to-all 可能消耗高达 60% 的总训练时间。
计算效率墙(Compute Efficiency Wall)
MoE 引入了密集模型中不存在的计算低效:
- 小 GEMM: 细粒度专家产生许多小型矩阵乘法,GPU 利用率低。在测量中,GEMM 占 Llama-3 405B 执行时间的约 70%,但在 DeepSeek-V3 中不到 50%
- 路由和排列开销: 即使优化后仍增加约 9% 的层执行时间
- 负载不均衡: 动态路由将不均匀的 token 数分配给专家
- 主机开销: MoE 因稀疏性和路由需要启动更多内核
二、技术架构
2.1 MoE 层架构与前向传播
Megatron-Core 的 MoE 实现由三个模块化组件组成,通过四阶段前向传播连接:
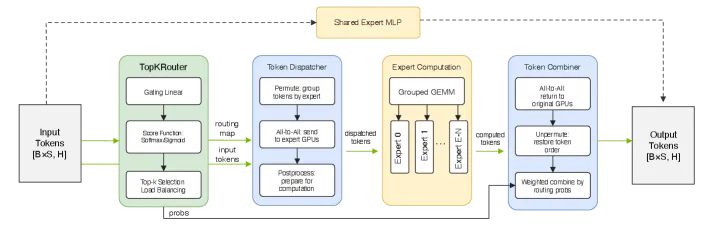
阶段 1: Route(路由)
TopKRouter 决定哪些专家处理每个 token:
- 学习的线性投影将每个 token 的隐藏状态映射到 个 logit
- 评分函数(softmax 或 sigmoid)将 logit 转换为概率
- top-k 选择识别每个 token 评分最高的专家
路由器输出两个张量:
probs: 包含路由权重routing_map: 布尔掩码,指示 token-专家分配
阶段 2: Dispatch(分发)
Token 分发器通过六阶段管道管理 token 在 GPU 间的移动:
三种通信后端:
- AllGather: 简单但内存密集;适合小 EP 规模
- All-To-All: 基于 NCCL 的标准点对点通信
- Flex: 统一设计,支持 DeepEP 和 HybridEP 优化后端
阶段 3: Expert Computation(专家计算)
每个 GPU 在接收的 token 上执行其本地专家。所有本地专家通过 TEGroupedMLP 在单次 Grouped GEMM 调用中运行,即使单个专家工作负载很小也能最大化 GPU 利用率。
阶段 4: Combine(合并)
逆通信将处理后的 token 返回其原始 GPU,然后进行反排列以恢复原始序列顺序。
2.2 路由器架构
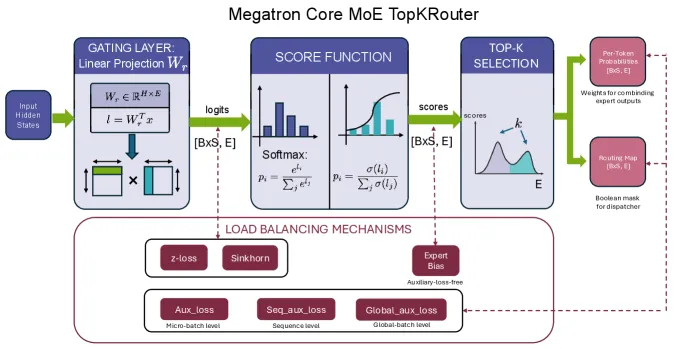
路由器通过两个操作将全局 token 批次转换为专家特定工作负载:
-
门控(Gating): 线性投影 将 token 隐藏状态映射到 logit
-
Top-k 选择: 评分函数转换 logit 为概率:
- Softmax:
- Sigmoid: (DeepSeek-V3 使用)
Megatron-Core 支持多种负载均衡策略:
- 辅助损失(Auxiliary Loss): 添加正则化项鼓励均匀路由
- 无辅助损失方法: 如 DeepSeek-V3 的无辅助损失负载均衡策略
- 强制均衡(Force-Balanced): 强制均匀 token 分布以确保稳定训练
三、核心创新:Parallel Folding
3.1 稠密-稀疏失配(Dense-Sparse Mismatch)
单个 Transformer 块包含两种根本不同的计算模式:
| 方面 | 注意力(稠密) | MoE(稀疏) |
|---|---|---|
| 计算 | 每个 token 关注所有其他 token | 每个 token 路由到 个/ 个专家 |
| TP | 大 QKV 矩阵受益于高 TP | 小专家维度使高 TP 适得其反 |
| CP | 长序列受益于高 CP | 无序列依赖;CP 无关紧要 |
| EP | 不适用(无专家) | 分布式多个专家必不可少 |
传统框架强制注意层和 MoE 层共享同一并行配置,但它们的最优配置直接冲突。
传统约束
这导致三个关键挑战:
- 乘法性 GPU 需求: 请求 EP=8 强制 DP ≥ 8
- 被迫次优并行: 注意力层和 MoE 层共享 TP 配置
- 跨节点通信: 高 EP 往往迫使 all-to-all 通信跨越节点边界
3.2 Parallel Folding 解决方案
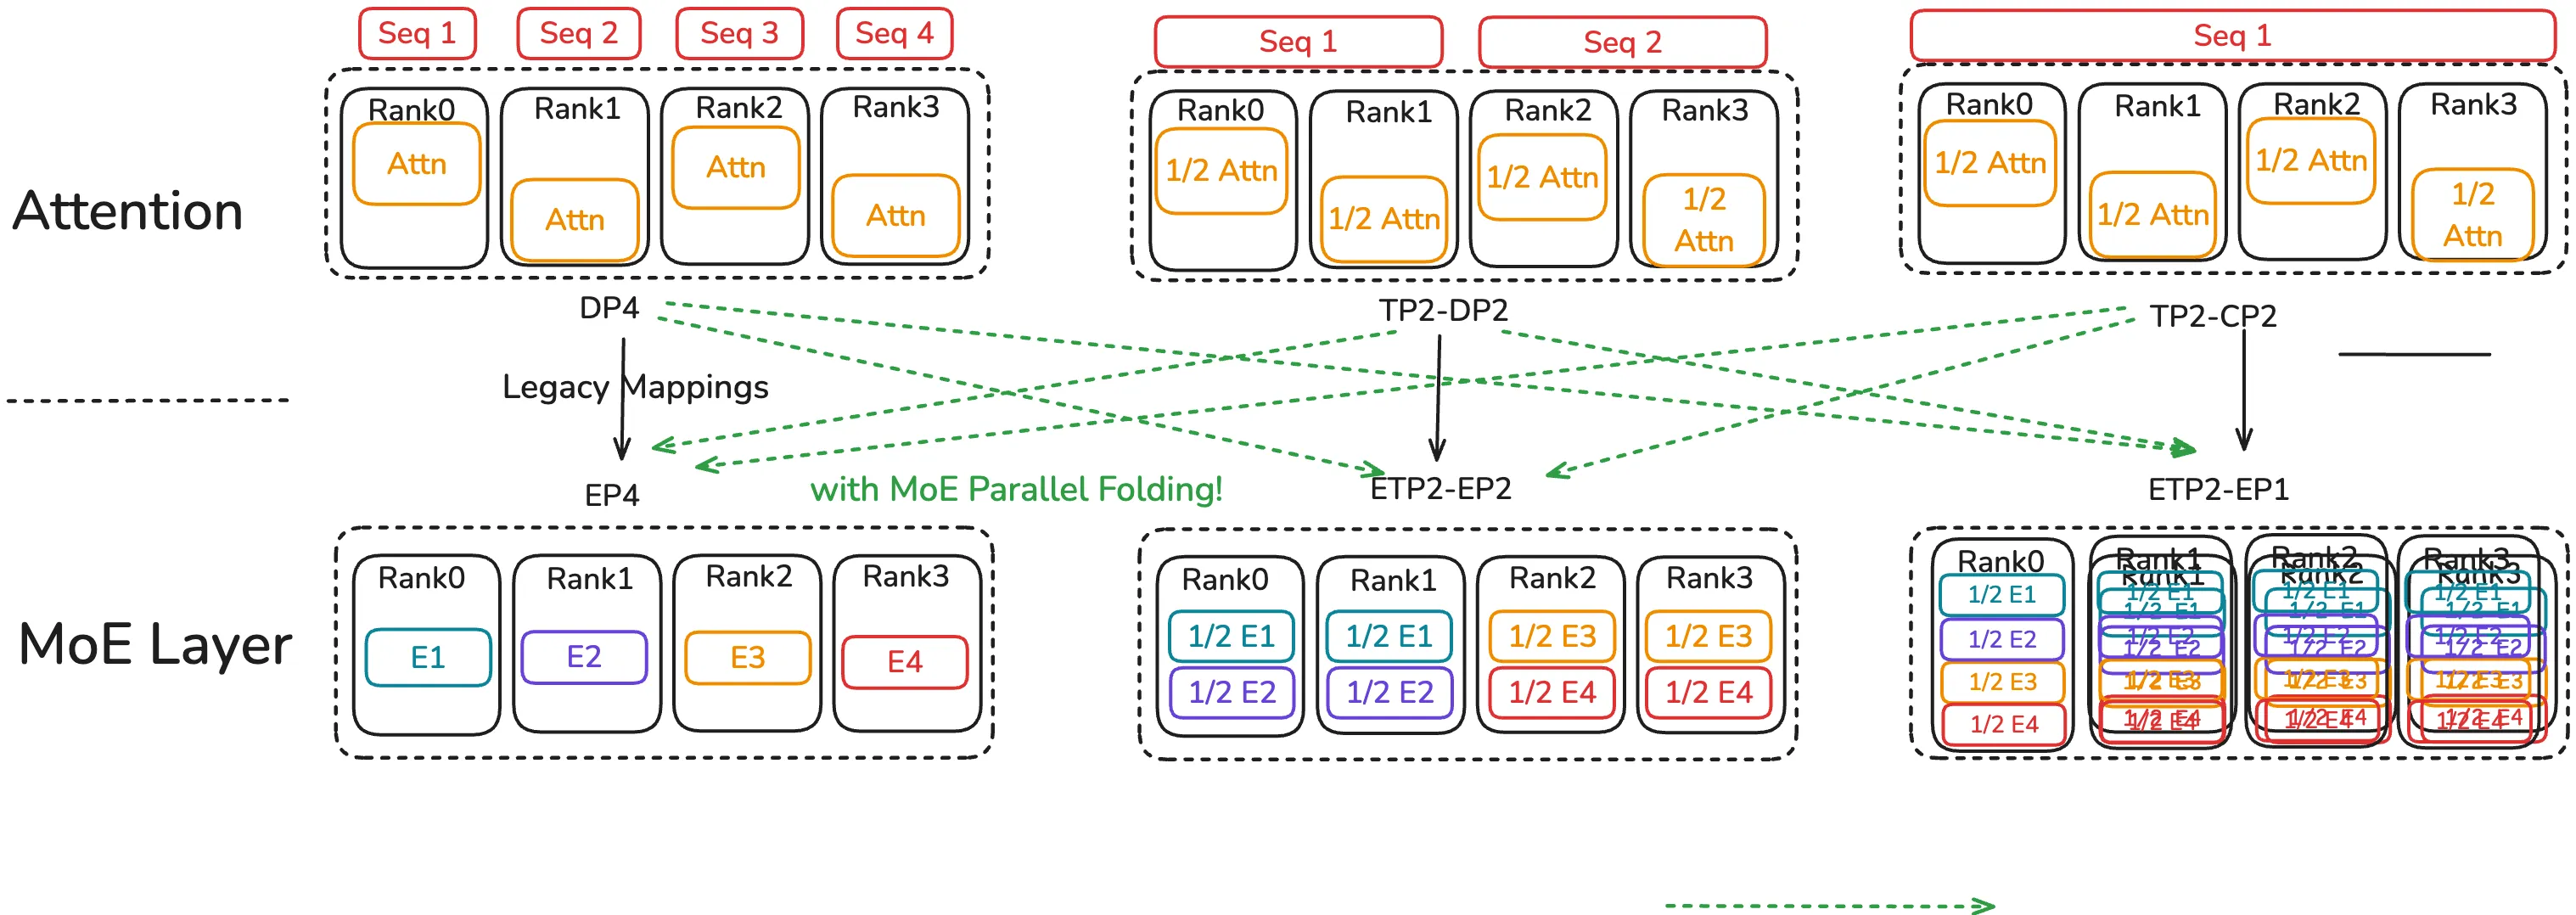
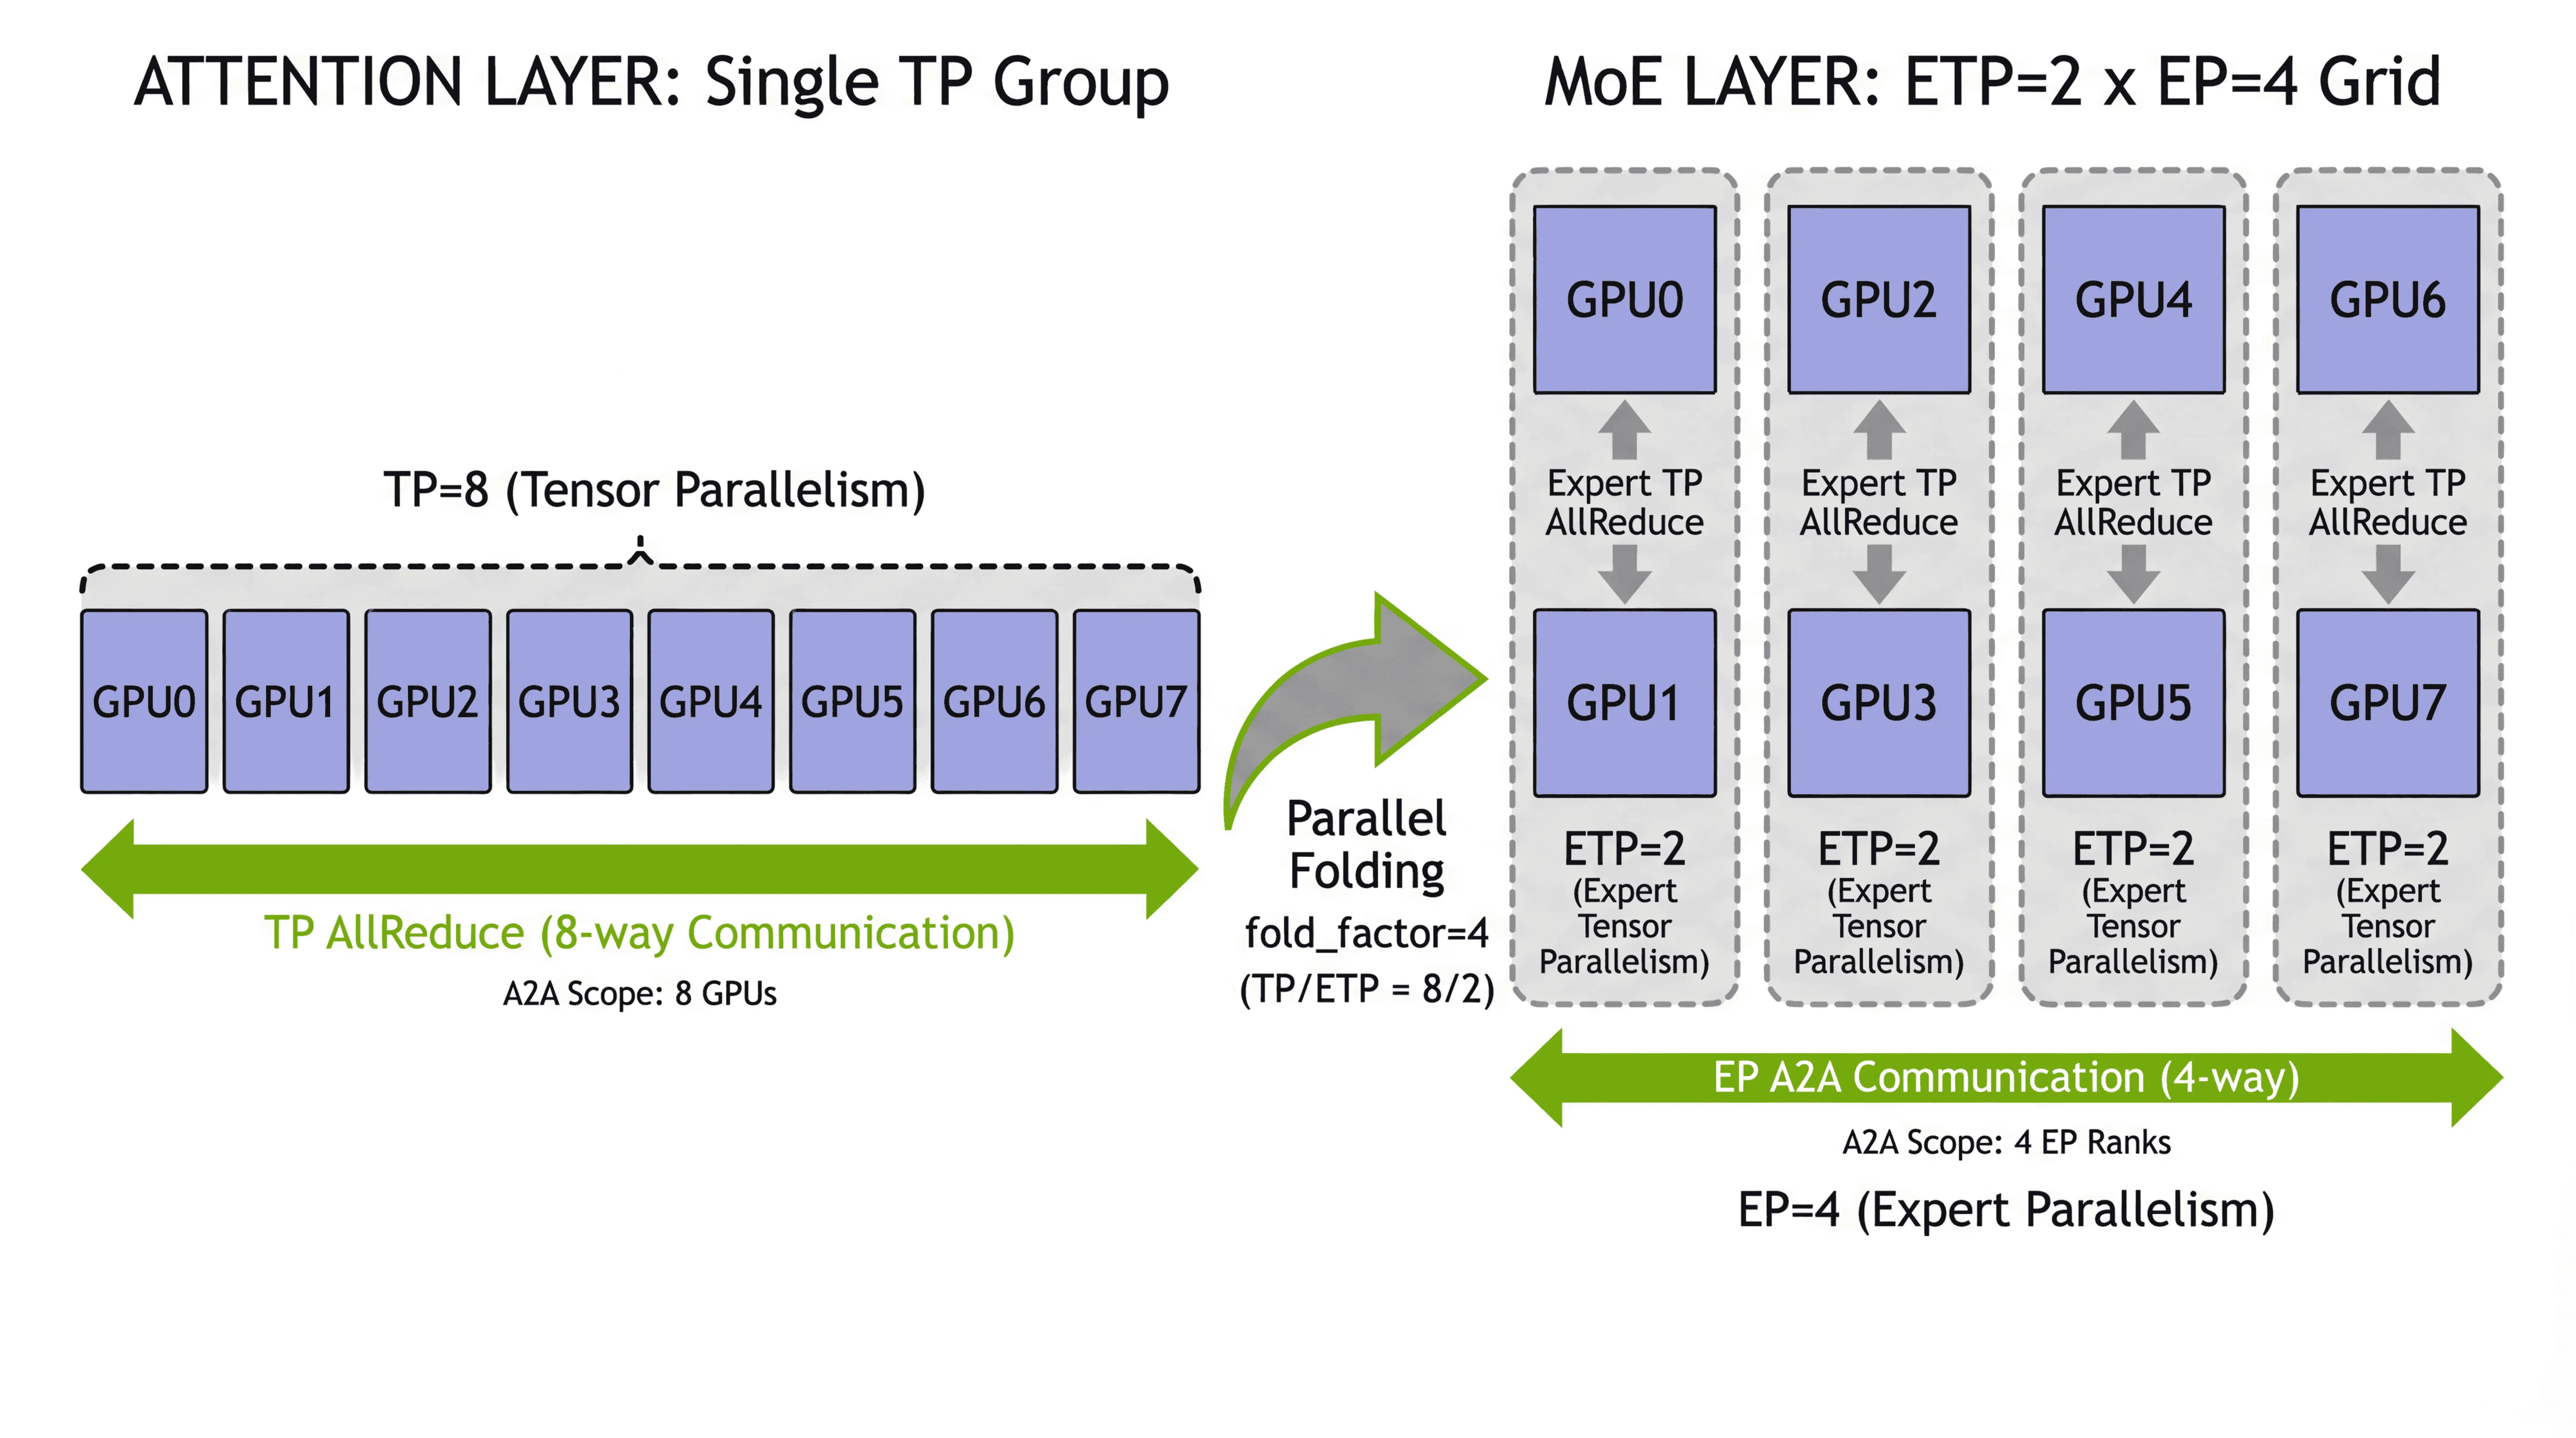
Parallel Folding 的核心思想:不要强制注意力和 MoE 共享并行性。让每种层类型独立使用其最优配置。
Parallel Folding 为注意力和 MoE 层引入独立的并行组:
- 注意力层: 在 TP × CP × DP × PP 上形成组,优化序列级稠密计算
- MoE 层: 在 ETP × EP × EDP × PP 上形成组,其中 ETP(专家张量并行)和 EDP(专家数据并行)是 MoE 特定维度
唯一约束:流水线并行(PP)必须在两种布局间保持一致,以确保正确的梯度流。
3.3 完整多维并行栈
| 维度 | 应用于 | 目的 |
|---|---|---|
| TP(张量) | 注意力 | 分片大 QKV/投影矩阵 |
| CP(上下文) | 注意力 | 分布长序列 |
| DP(数据) | 注意力 | 处理不同批次 |
| PP(流水线) | 两者 | 按层拆分模型(必须一致) |
| EP(专家) | MoE | 跨 GPU 分布专家 |
| ETP(专家张量) | MoE | 专家内分片(很少使用) |
| EDP(专家数据) | MoE | 复制专家以提高吞吐量 |
3.4 Parallel Folding 的优势
-
打破 EP ≤ DP 约束: EP 可以通过跨 TP × CP 组”折叠”来超过 DP。例如,注意力配置 TP=4, CP=2, DP=8, PP=4(共 256 GPU):
- 传统:EP ≤ DP = 8,最大 EP 为 8
- Parallel Folding:MoE 使用 ETP=1, EP=64, EDP=1。EP 跨 TP × CP × DP 组折叠,实现 8 倍更高的专家并行
-
降低最低 GPU 要求: 传统配置 CP=8, EP=8 至少需要 64 GPU。使用 Folding,CP 和 EP 共享同一 GPU 组,仅需 8 GPU
-
独立优化: 注意力可以使用高 TP 处理大矩阵,而 MoE 使用 ETP=1 以获得全专家宽度和更好的 GEMM 效率
-
保持高带宽通信在 NVLink 域: CP(注意力)和 EP(MoE)的 all-to-all 通信都可以保持在 NVLink 连接的 GPU 组内
四、突破三面墙
4.1 突破内存墙
4.1.1 内存高效排列:零开销激活减少
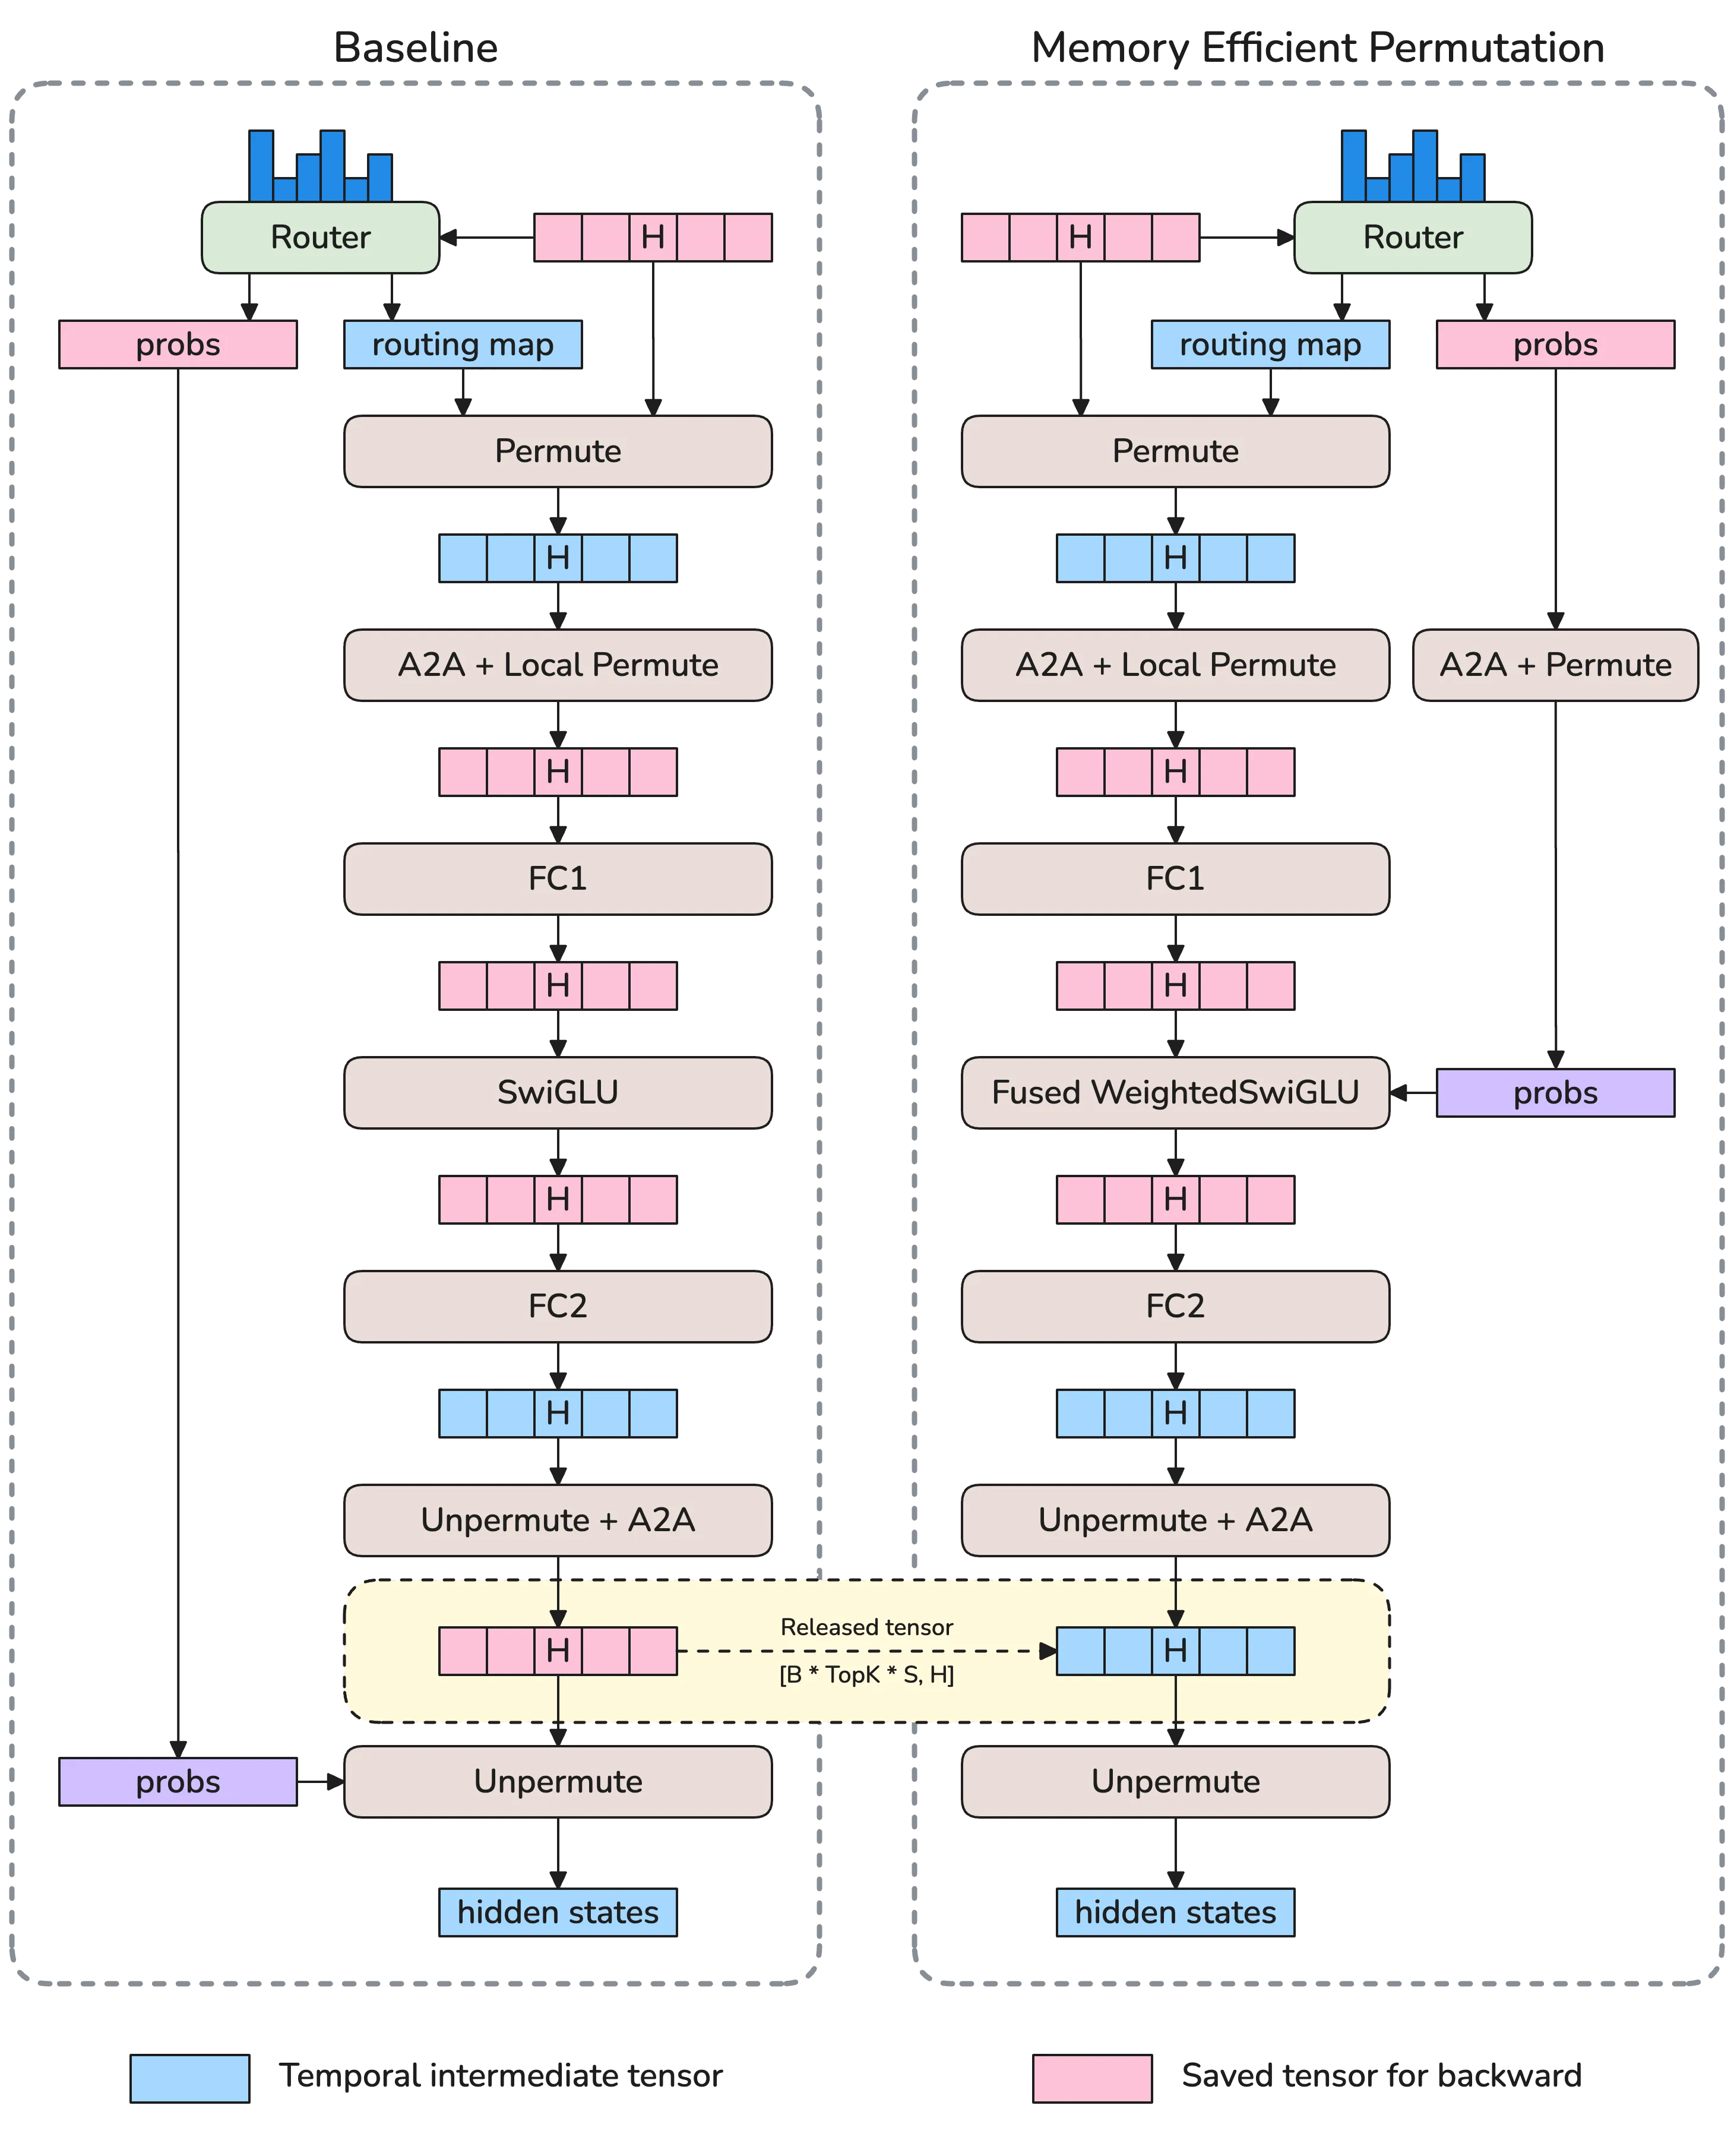
最理想的内存优化是那些没有计算开销的优化。内存高效排列通过简单的代数重排消除冗余中间张量,实现零开销。
标准公式中,路由权重在专家计算后应用:
内存高效排列将 吸收到激活中,在第二个线性层之前应用:
当专家没有偏置项时, 是纯线性映射,标量乘法可交换,两个公式在数学上等价。对于 DeepSeek-V3,内存高效排列每 GPU 节省约 26.3 GB 激活内存,零计算成本。
4.1.2 选择性重计算
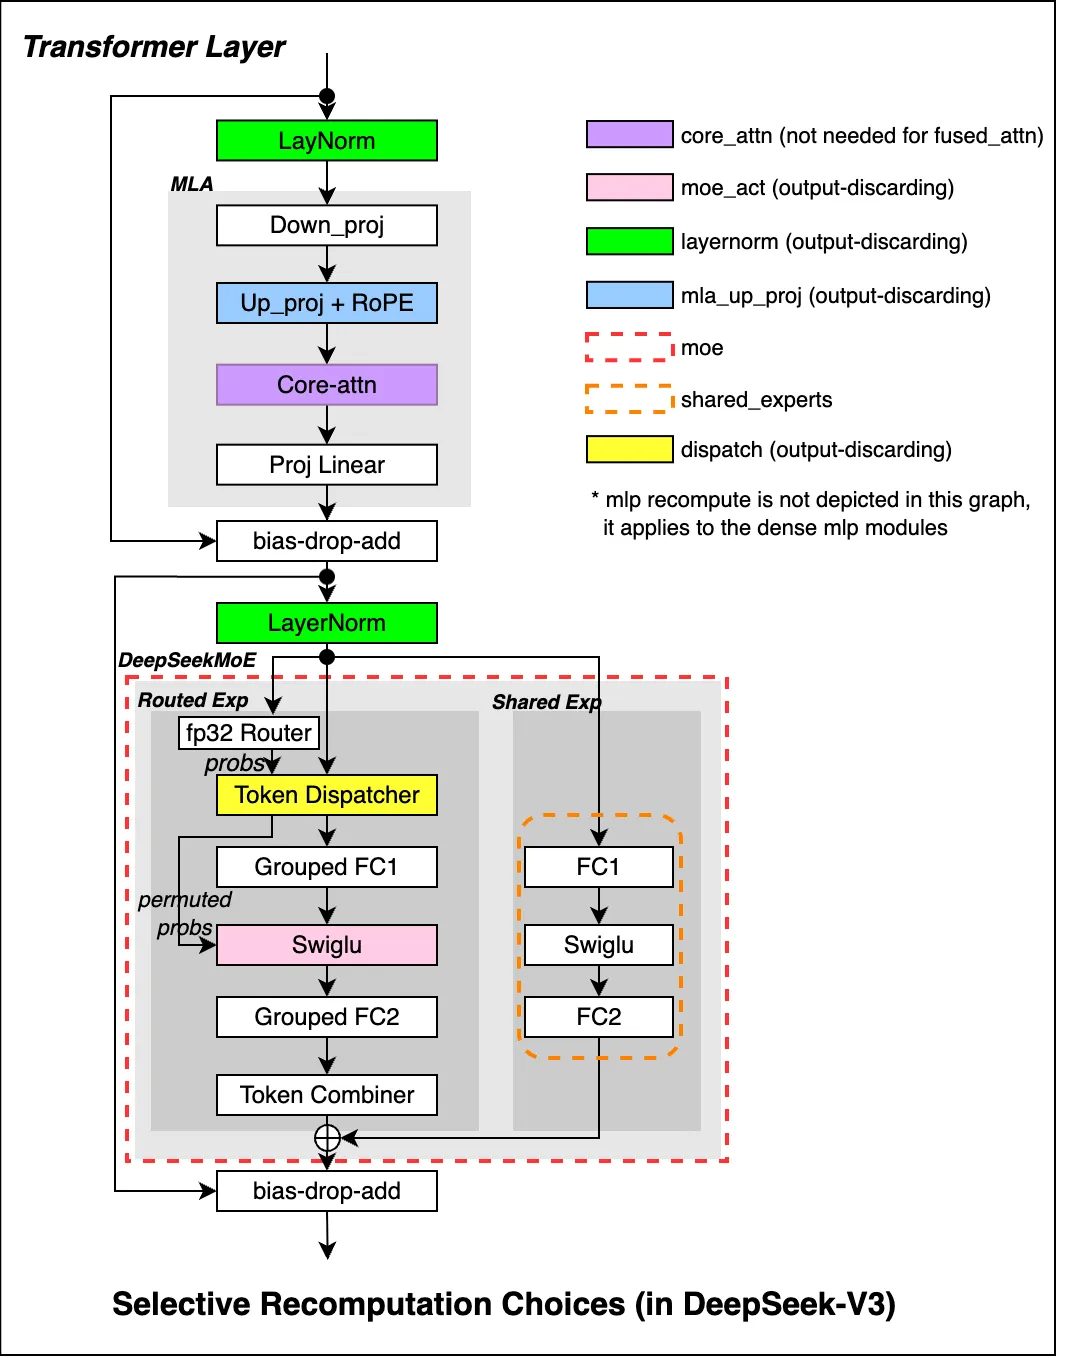
Megatron-Core 引入细粒度重计算,仅针对内存密集但计算廉价的操作:
- 粒度重计算: 用户指定在反向传播中重新计算哪些计算。例如,仅重计算专家 MLP 中的激活函数、LayerNorm 模块或 MLA 中的上投影
- 丢弃输出重计算: 检查点模块的输出在被后续层消耗后立即释放,在反向传播时从重计算结果中恢复
对于 DeepSeek-V3(PP4 × VPP4 × EP64,256 GPU):
| 重计算目标 | 每 GPU 节省内存 |
|---|---|
| MLA 上投影 | 30.4 GB |
| 激活函数 (SwiGLU) | 3.8 GB |
| LayerNorm | 8.2 GB |
| 总计 | 42.4 GB |
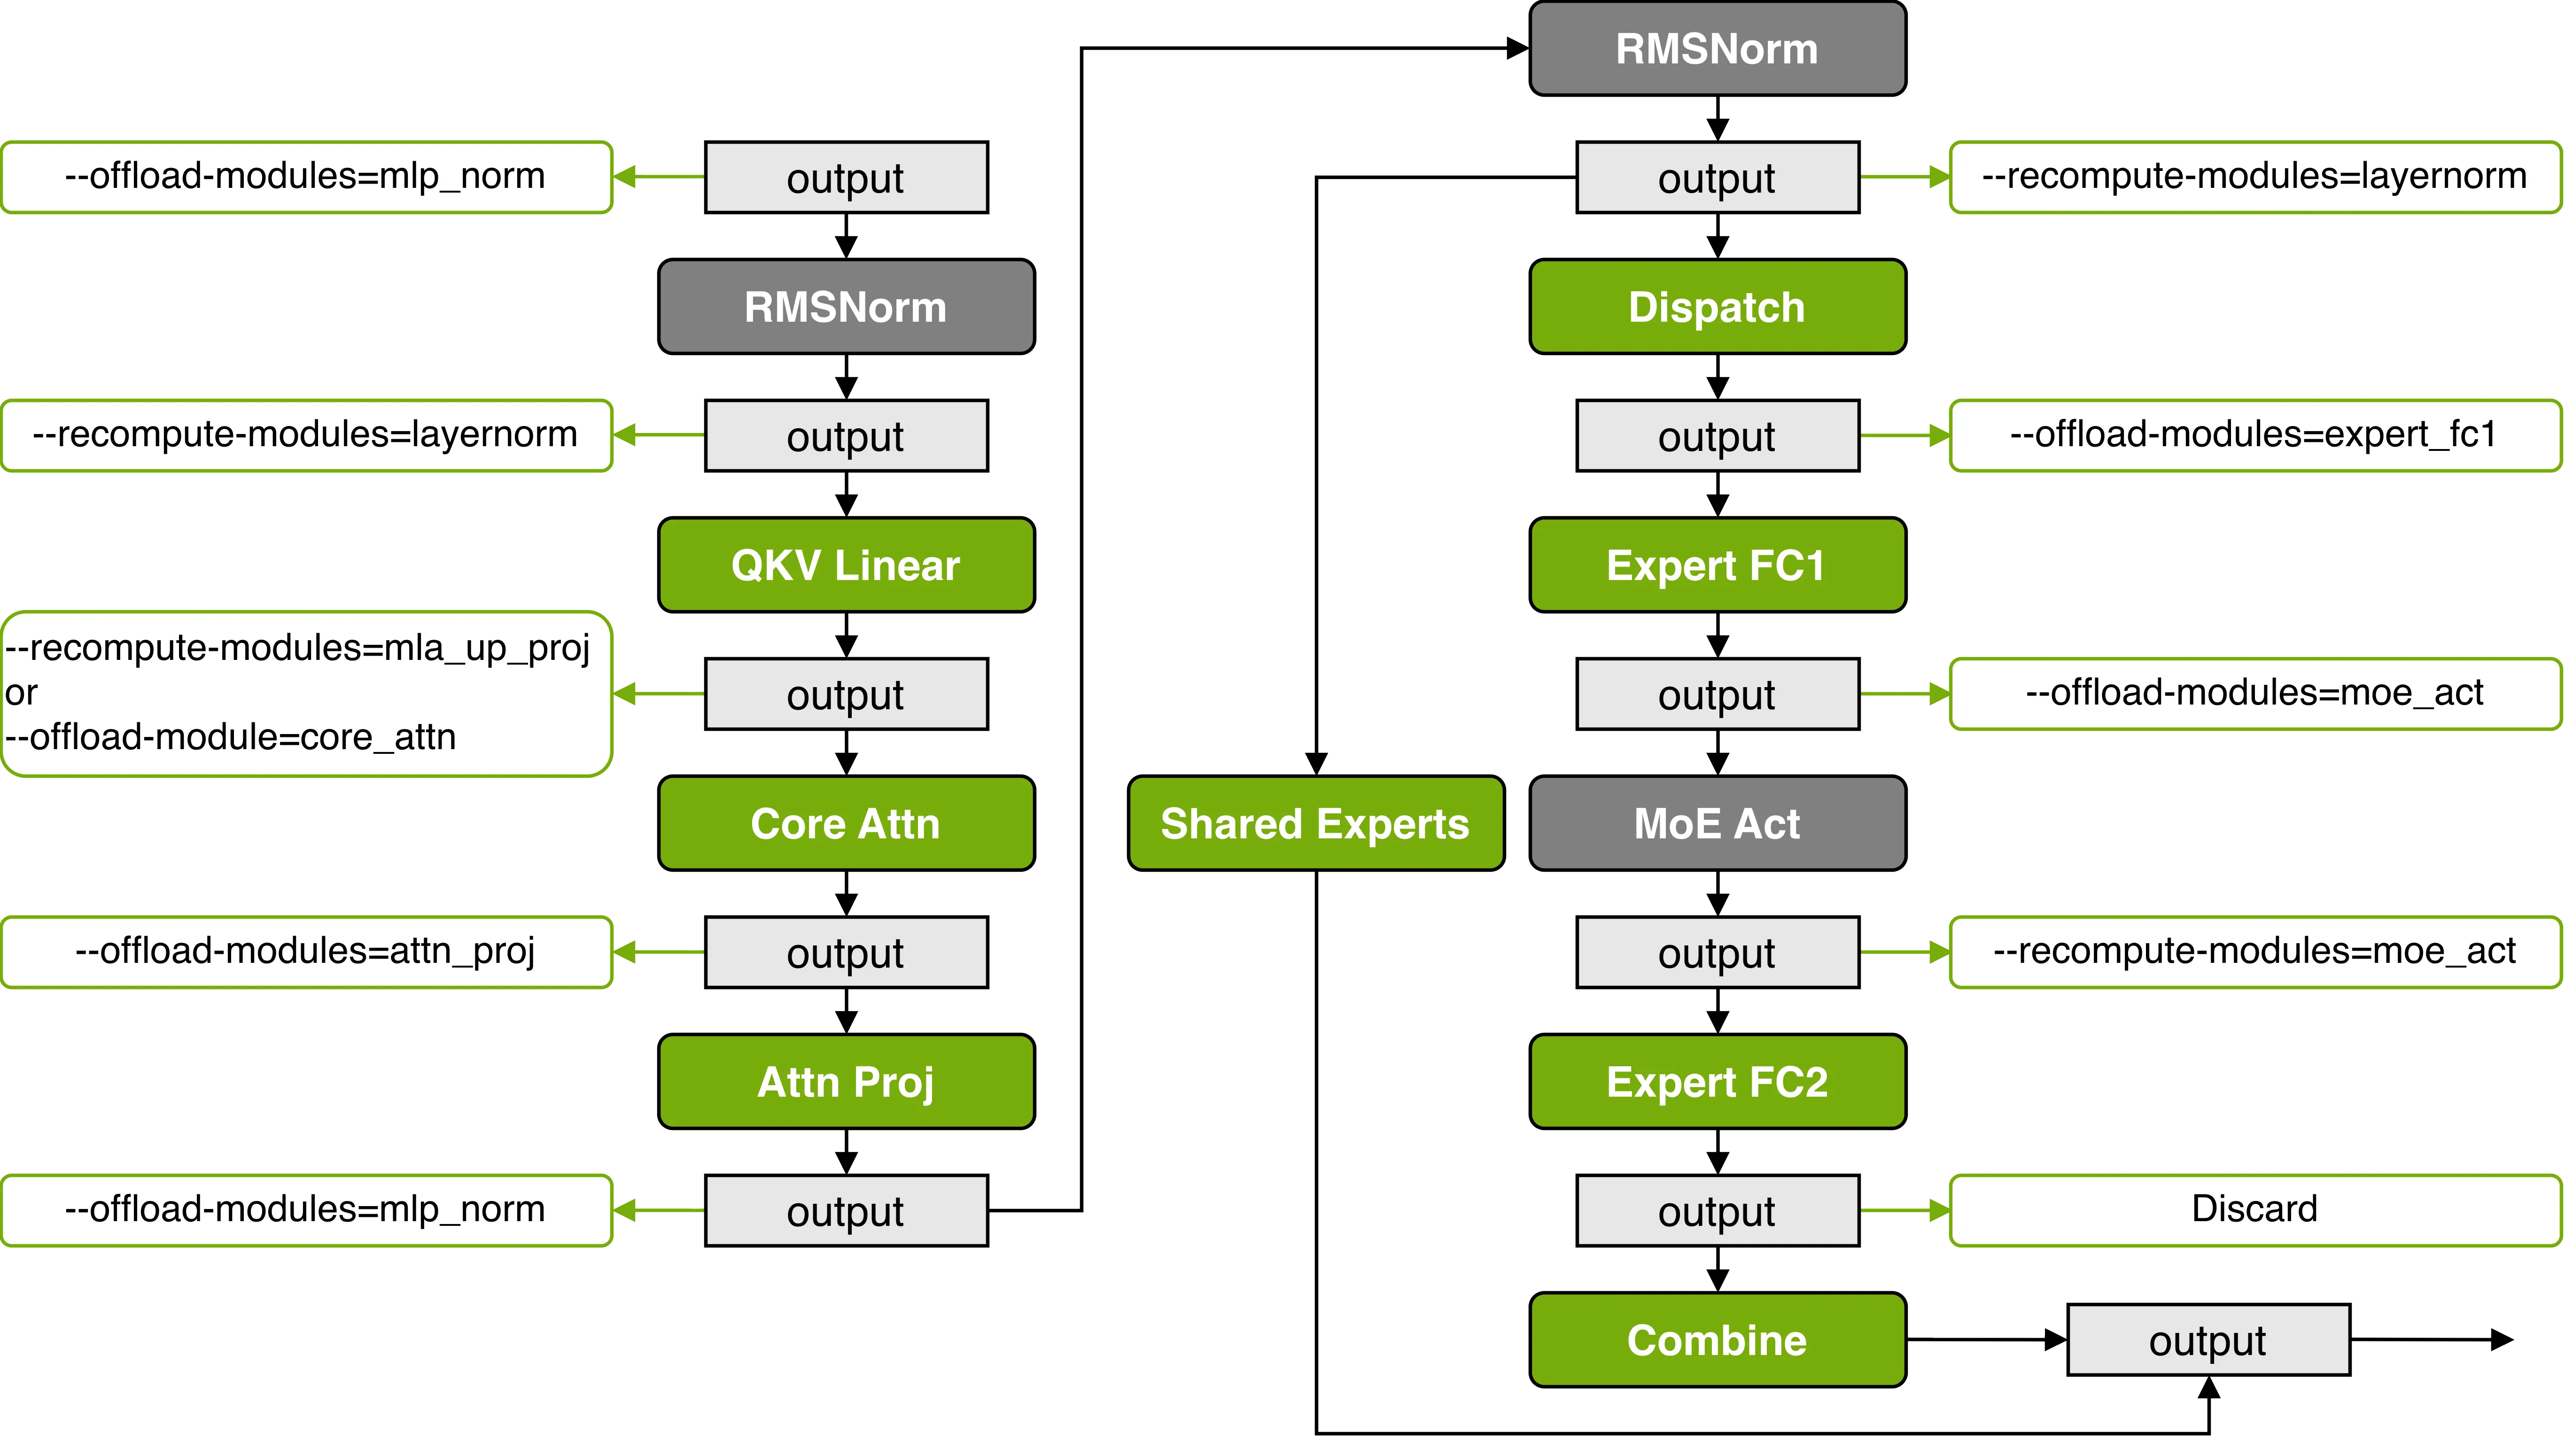
4.1.3 细粒度激活卸载
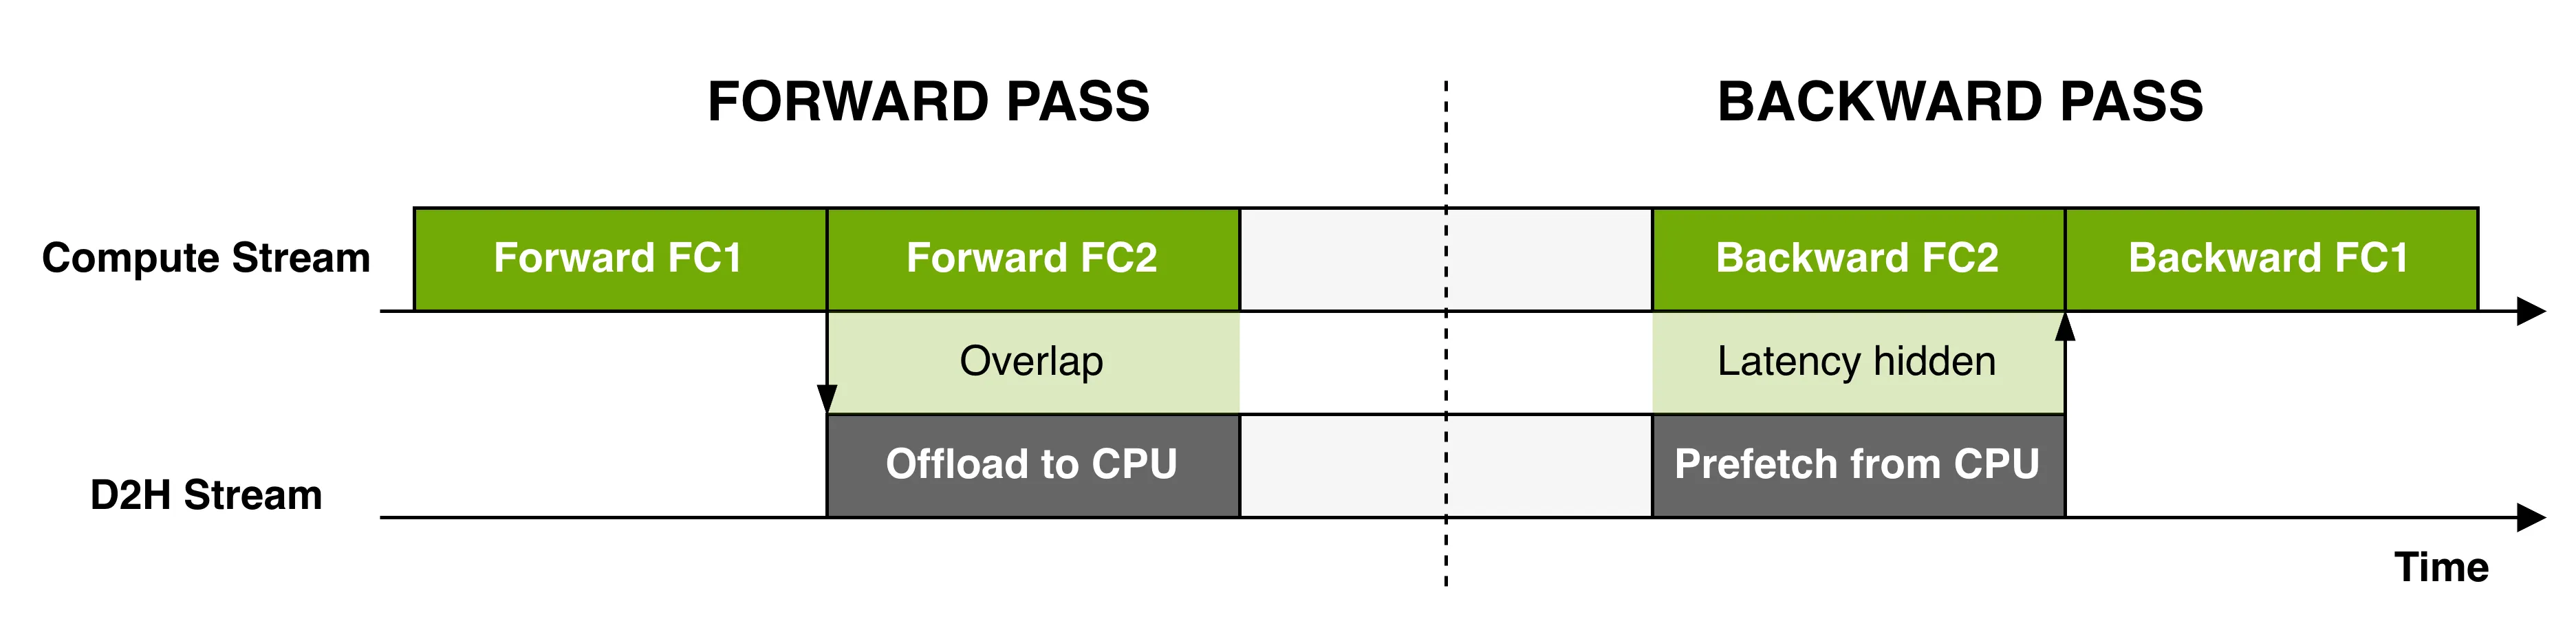
当 GPU 内存即使经过精度和重计算优化后仍然不足时,将激活卸载到 CPU 内存提供额外容量。
高级思路:重叠和预取。GPU 的复制引擎和计算引擎独立运行。当模块的计算时间超过其激活传输时间时,D2H 复制可以与后续计算并行运行,零成本。
关键特性:
- 模块级粒度: 用户通过
--offload-modules指定要卸载的模块 - 异步传输: 专用 D2H/H2D CUDA 流与计算并行运行传输
- 重计算集成: 与细粒度重计算结合,轻量操作(LayerNorm)使用重计算,昂贵模块(注意力、专家)使用卸载
- CUDA Graphs 兼容: 使用外部事件而非流同步
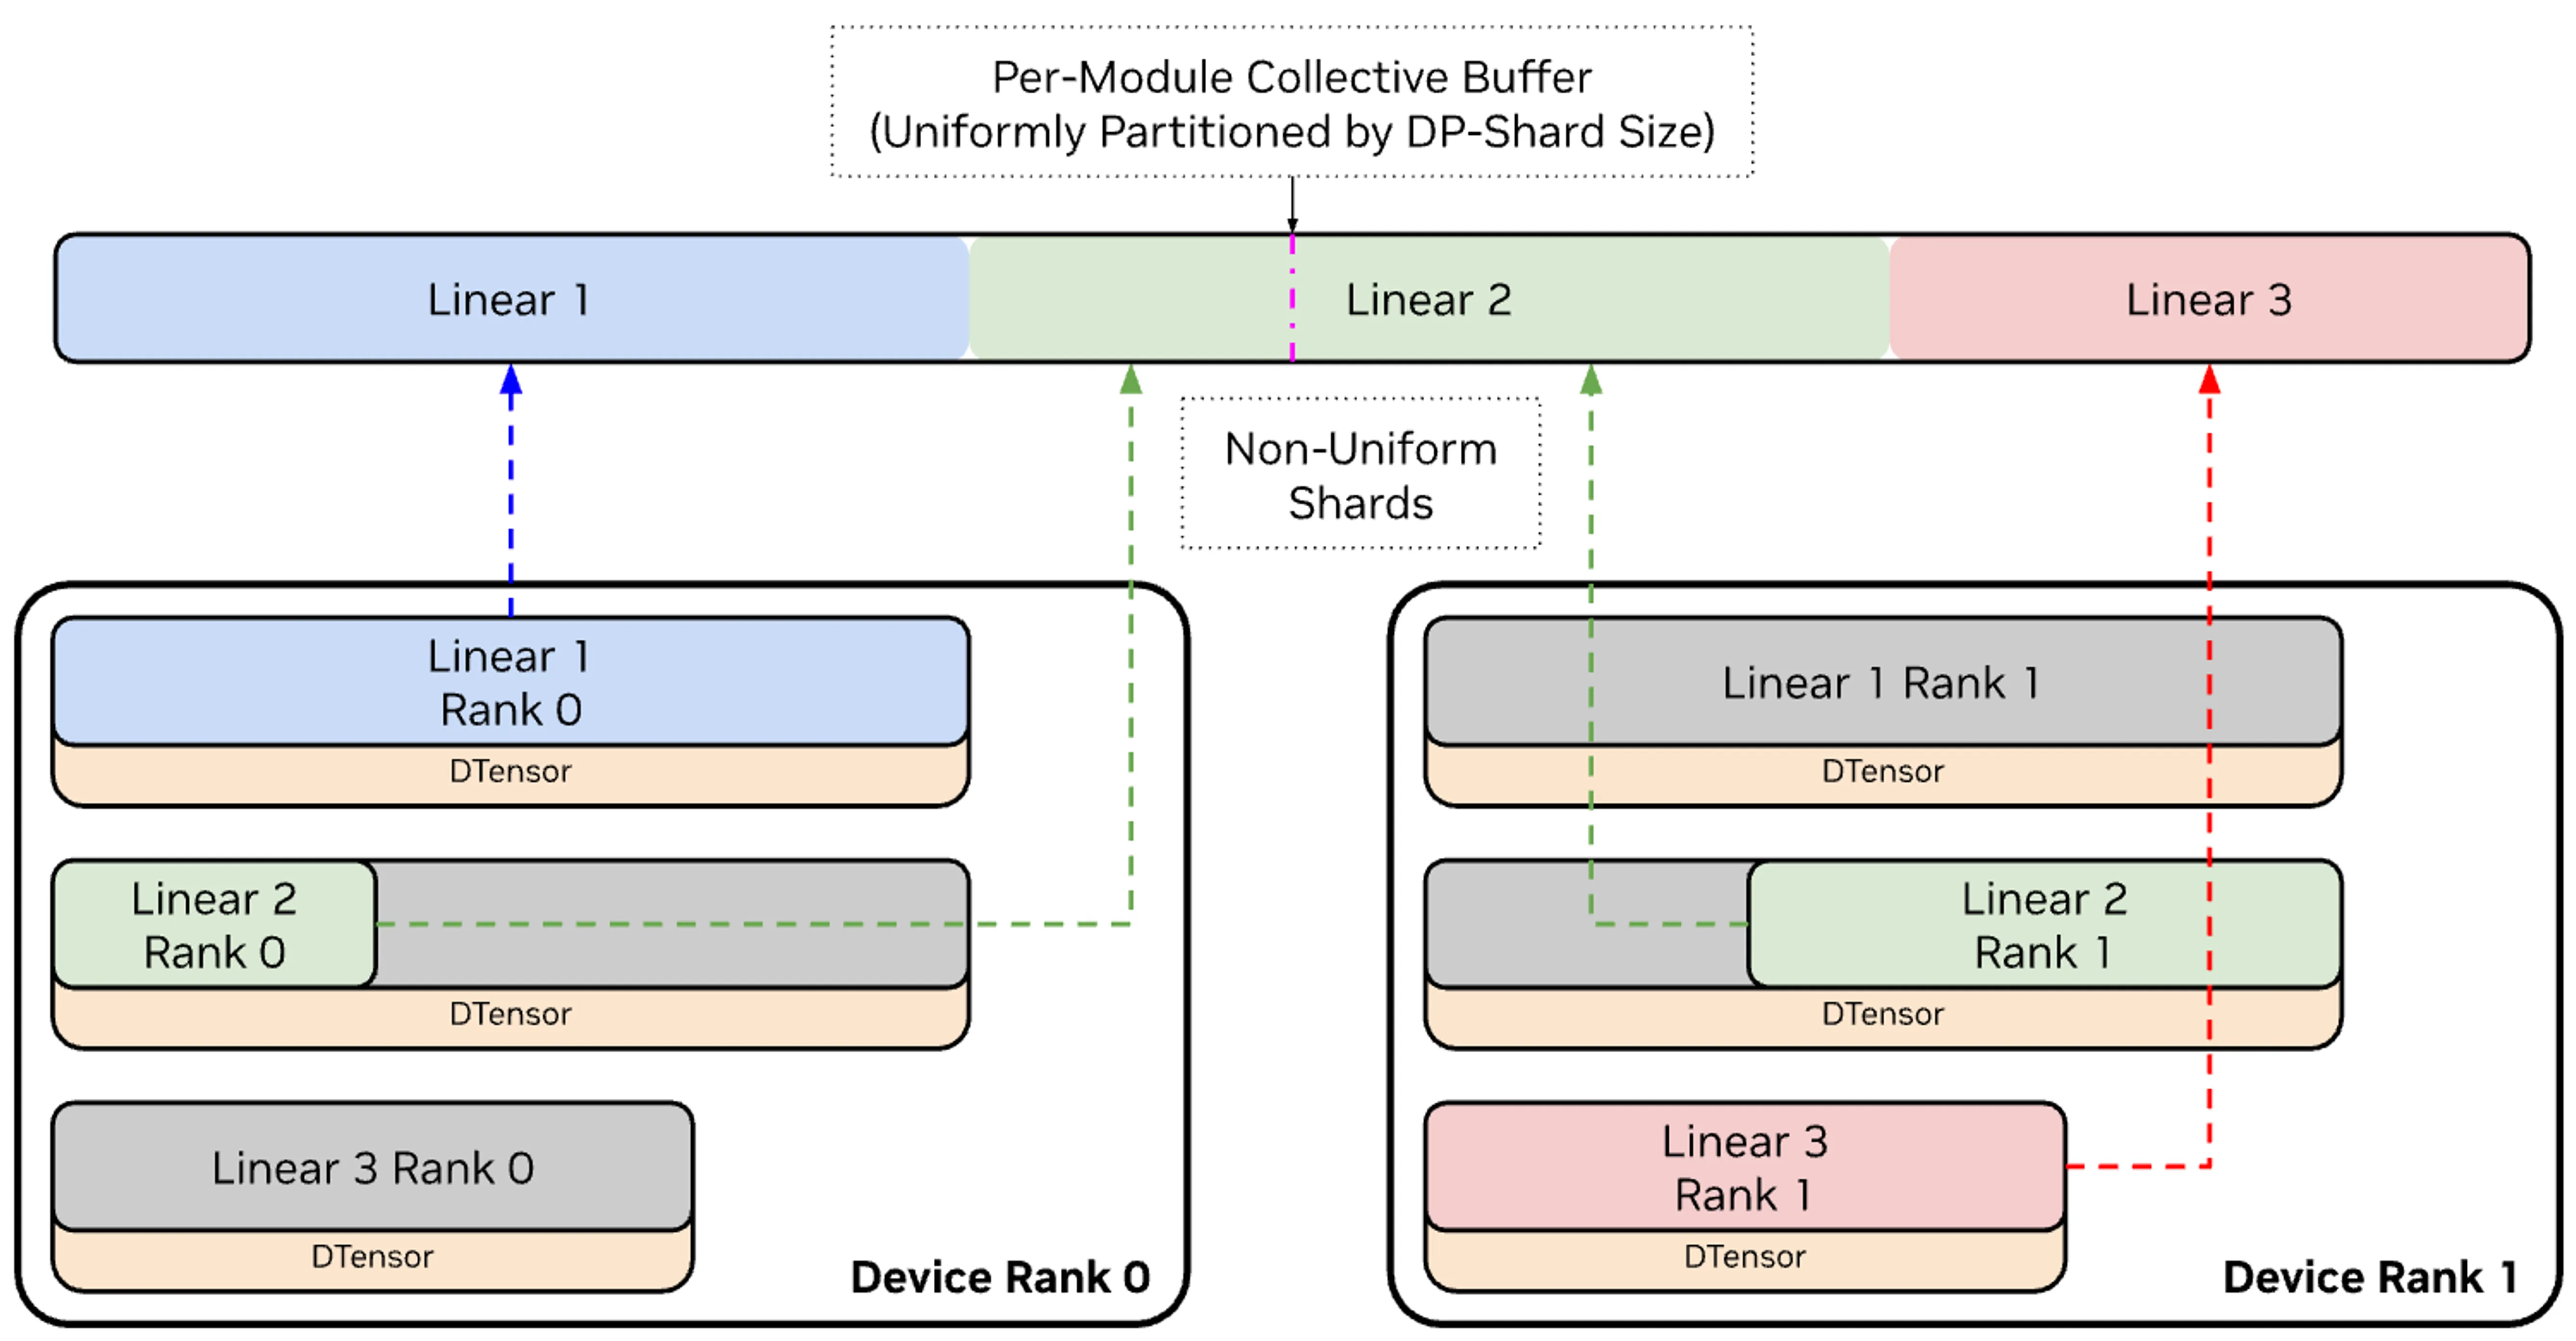
4.1.4 FSDP for MoE
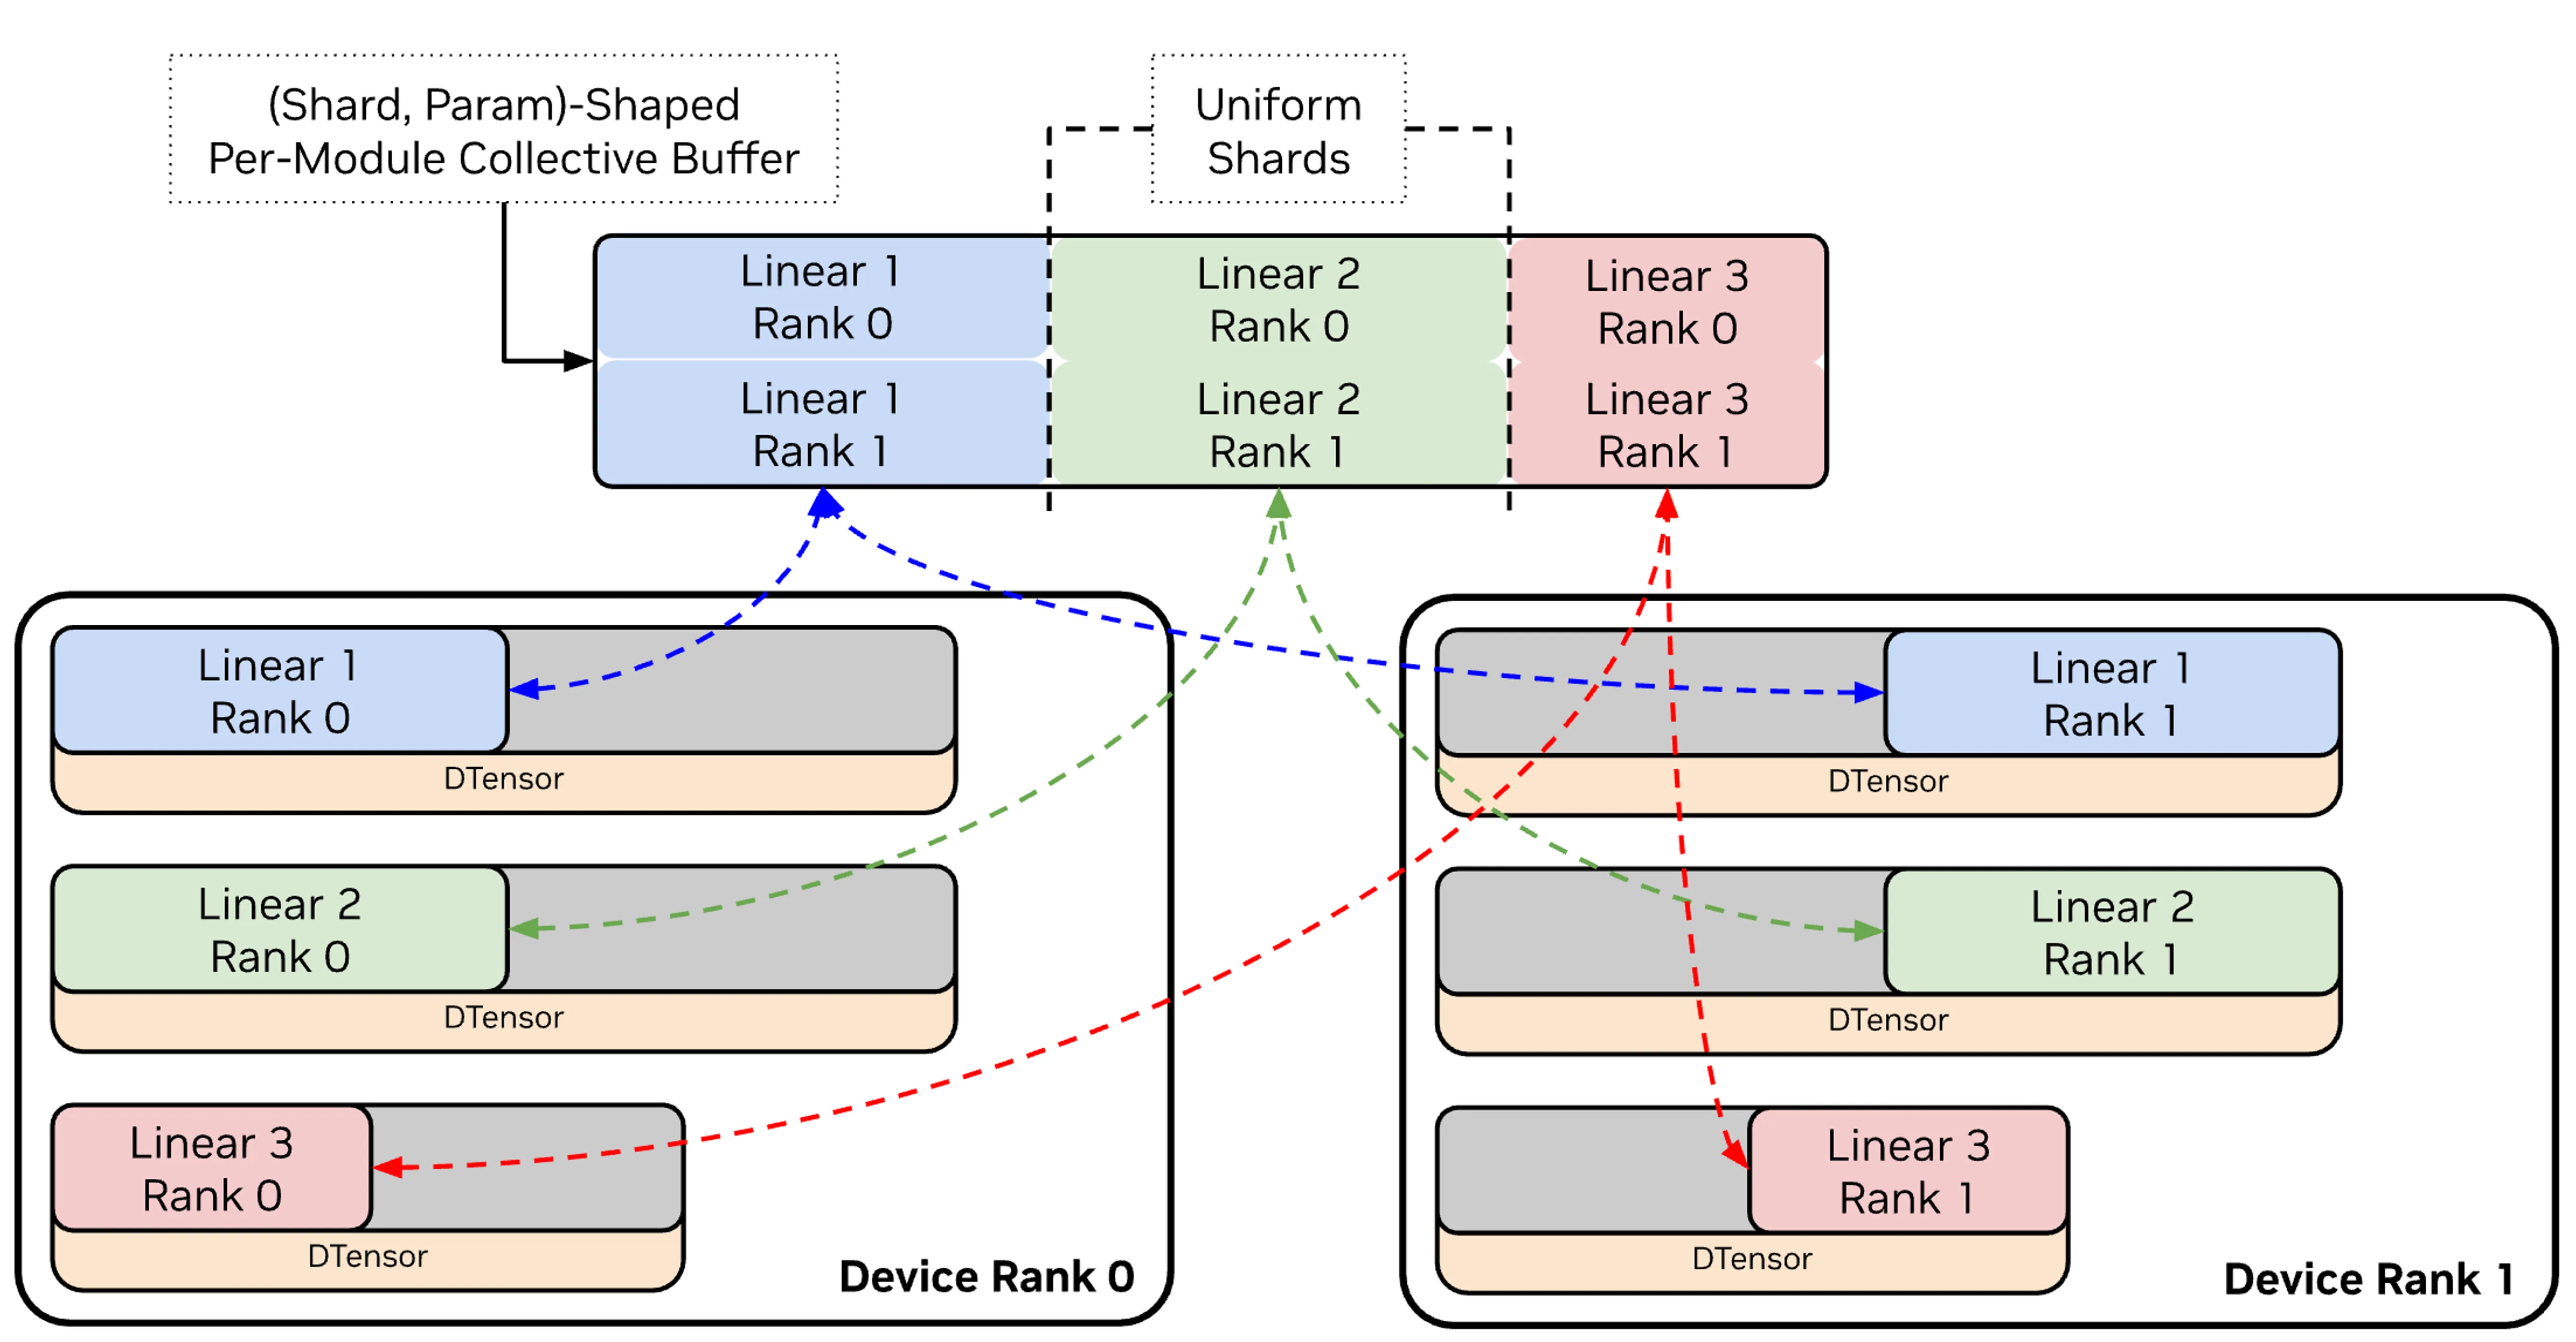
Megatron-Core 的自定义 FSDP(Megatron-FSDP)通过双 DeviceMesh 架构跨数据/专家组完全分片参数、梯度和优化器状态,同时将 AllGather 和 ReduceScatter 与计算重叠。
4.2 突破通信墙
4.2.1 EP 通信模式
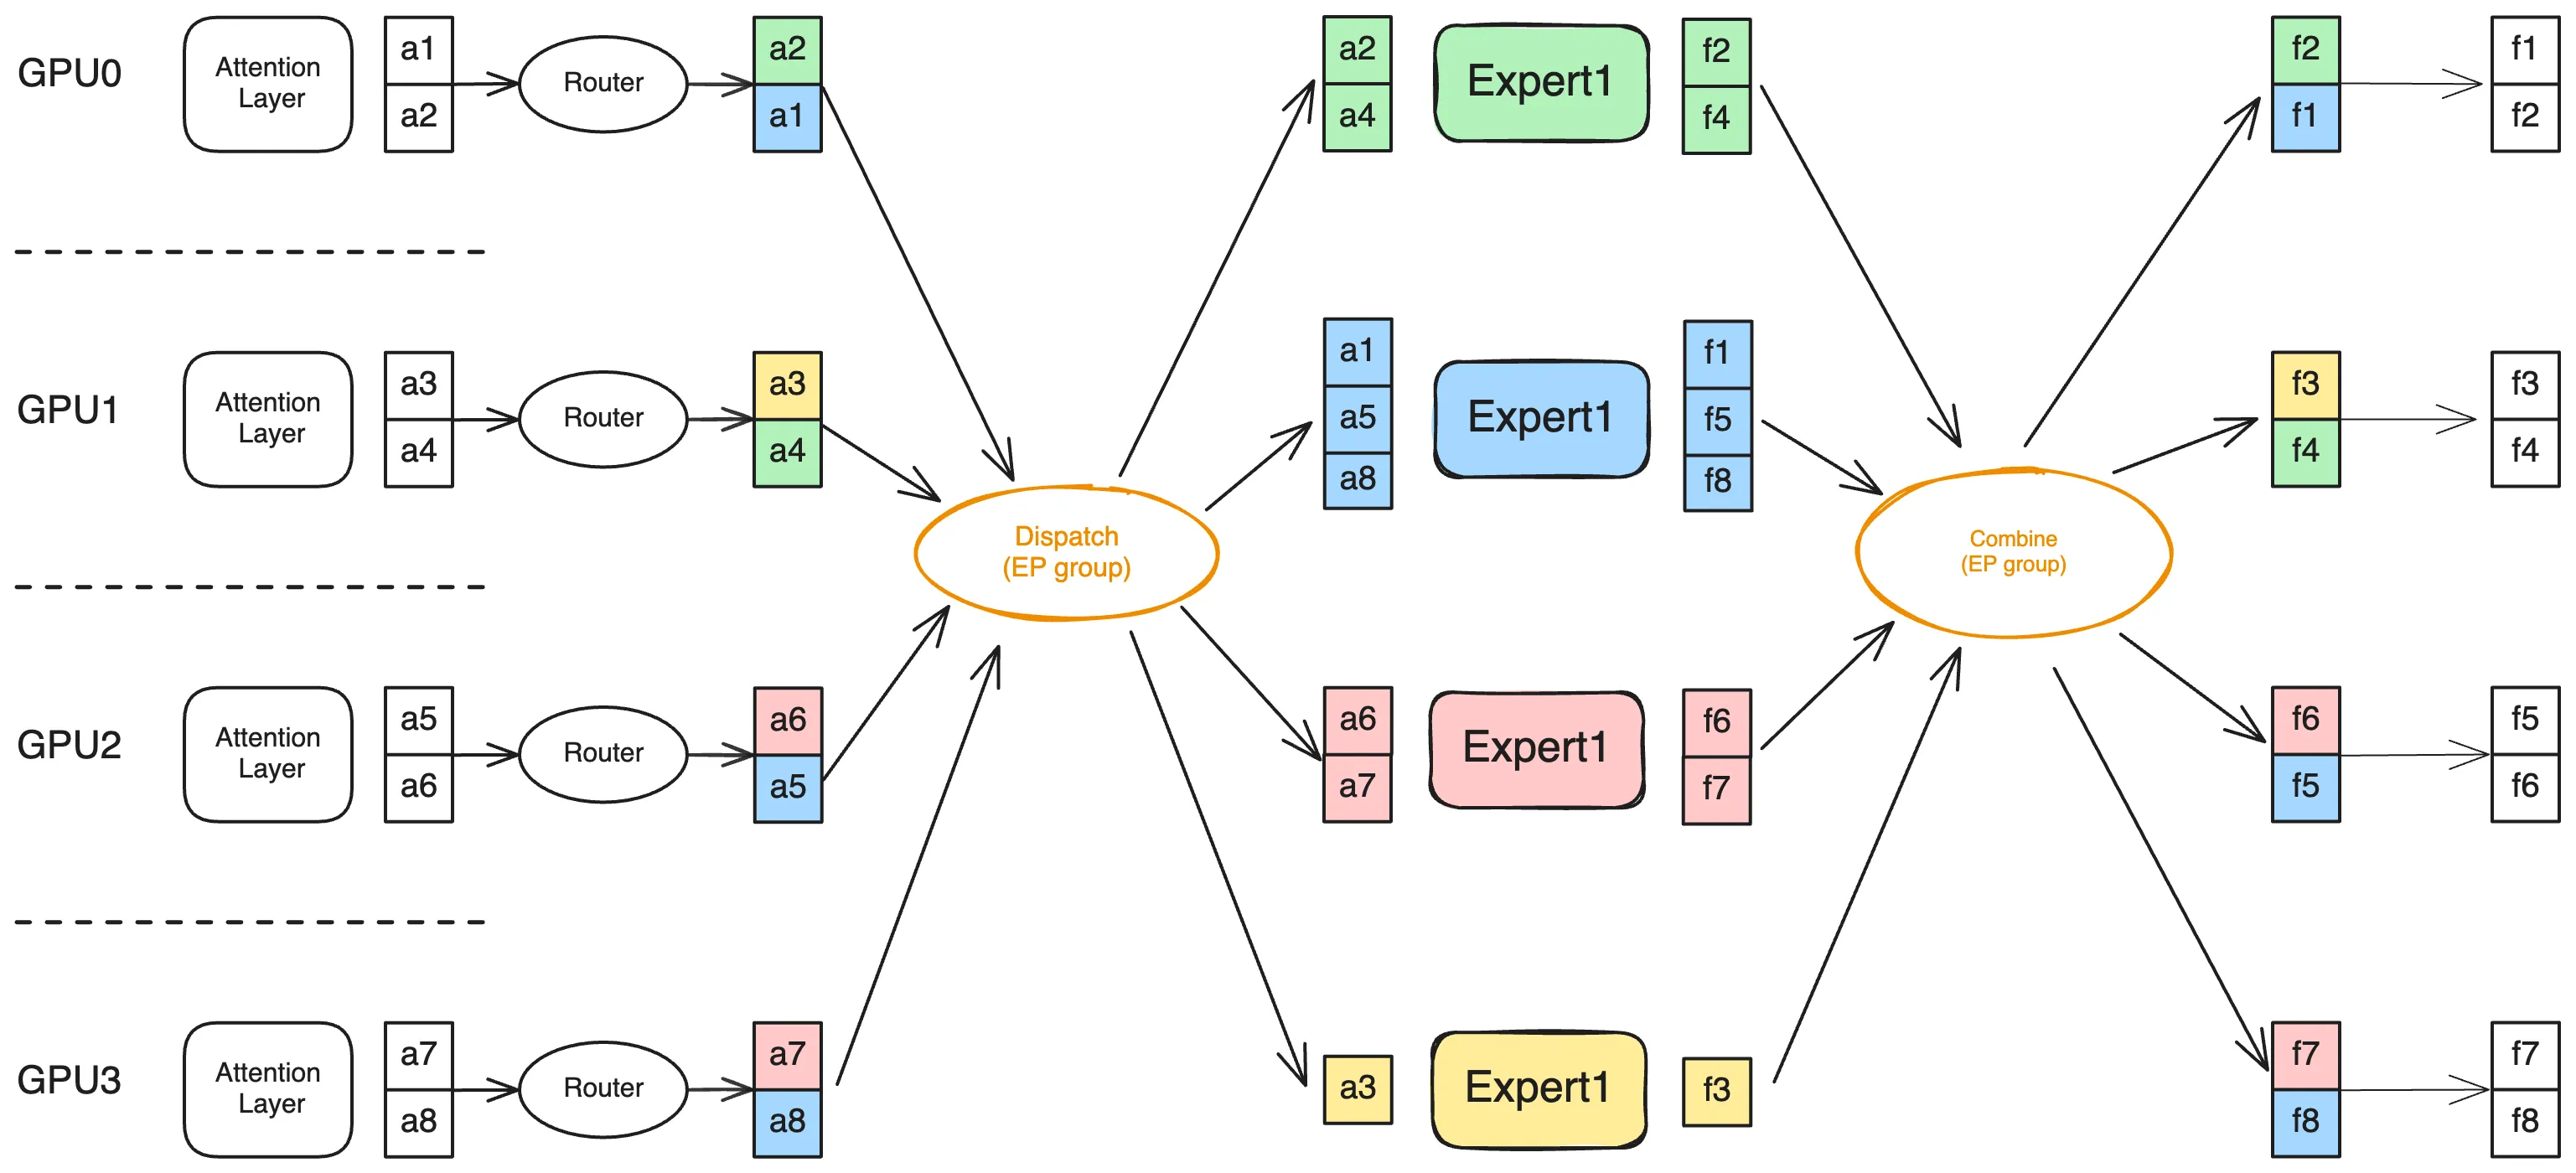
4.2.2 DeepEP 和 HybridEP
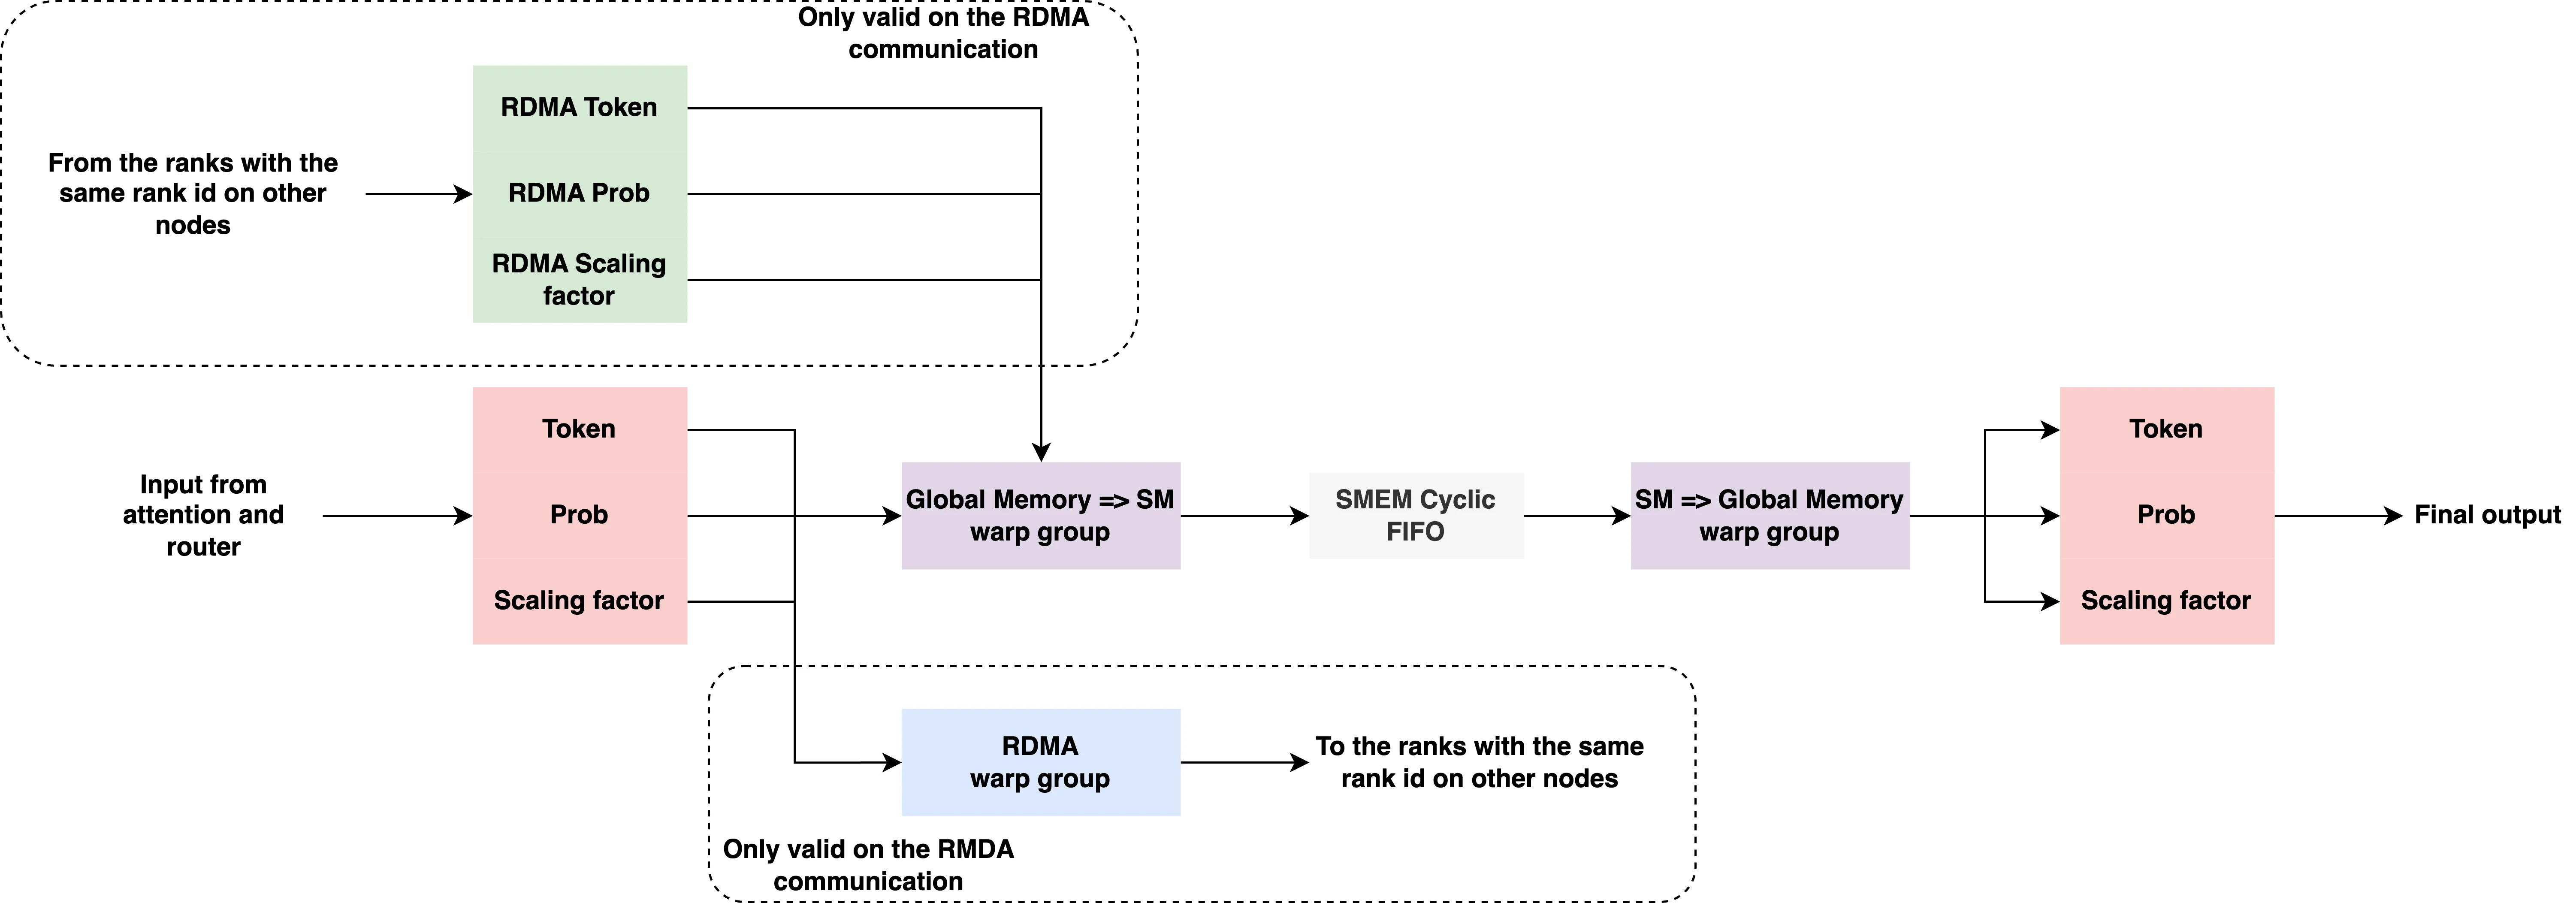
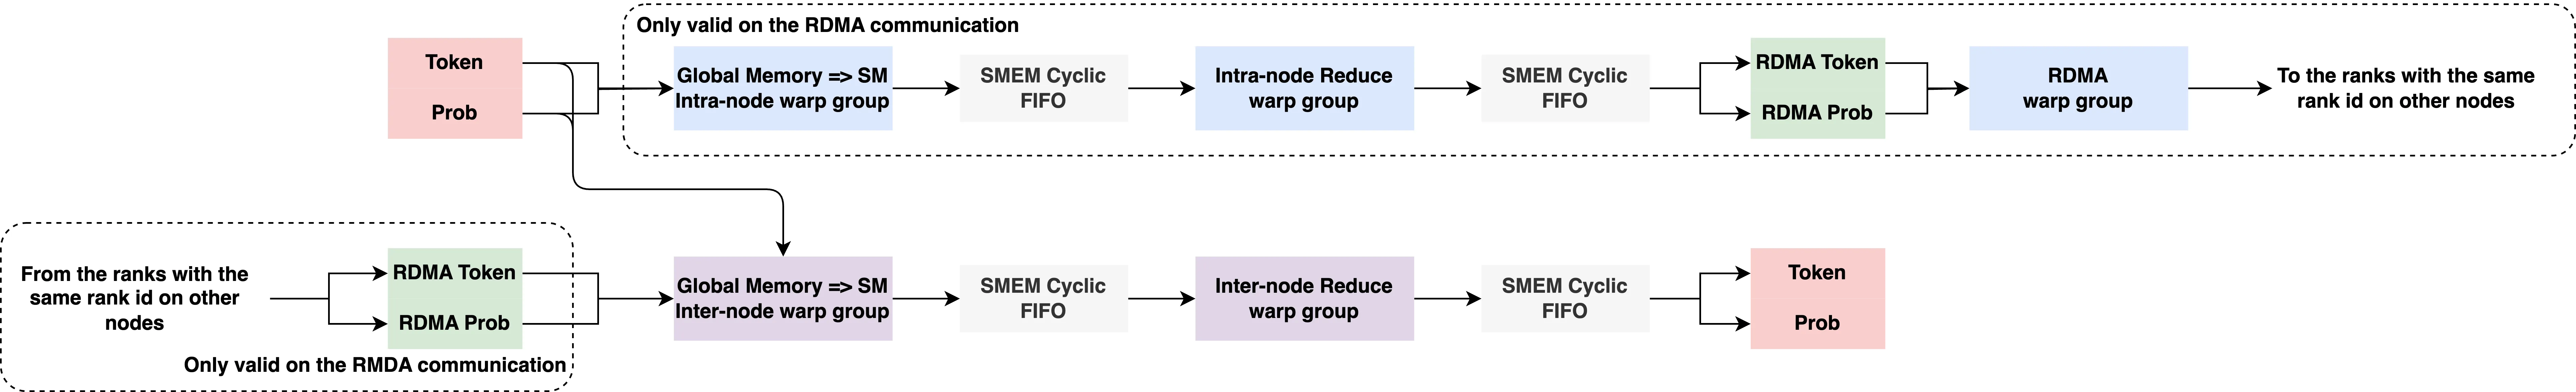
- DeepEP: 仅集成高吞吐内核,通过重叠隐藏 NVLink 通信延迟
- HybridEP: 在 GB200/GB300 NVL 系统上利用多节点 NVLink
4.2.3 EP 通信重叠
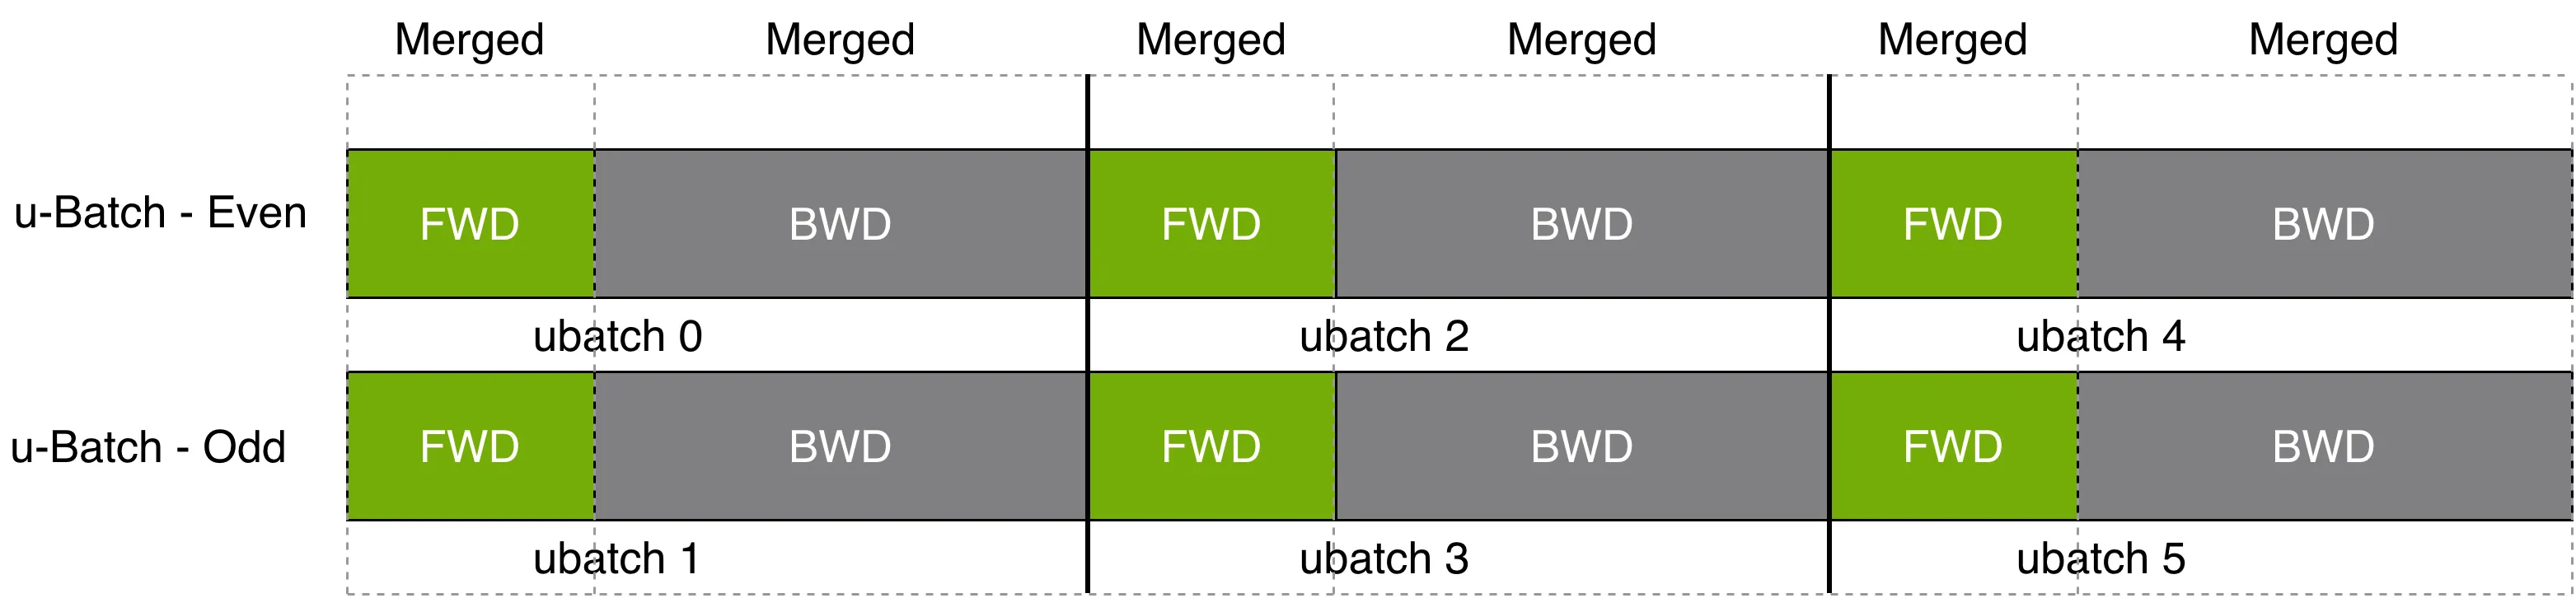
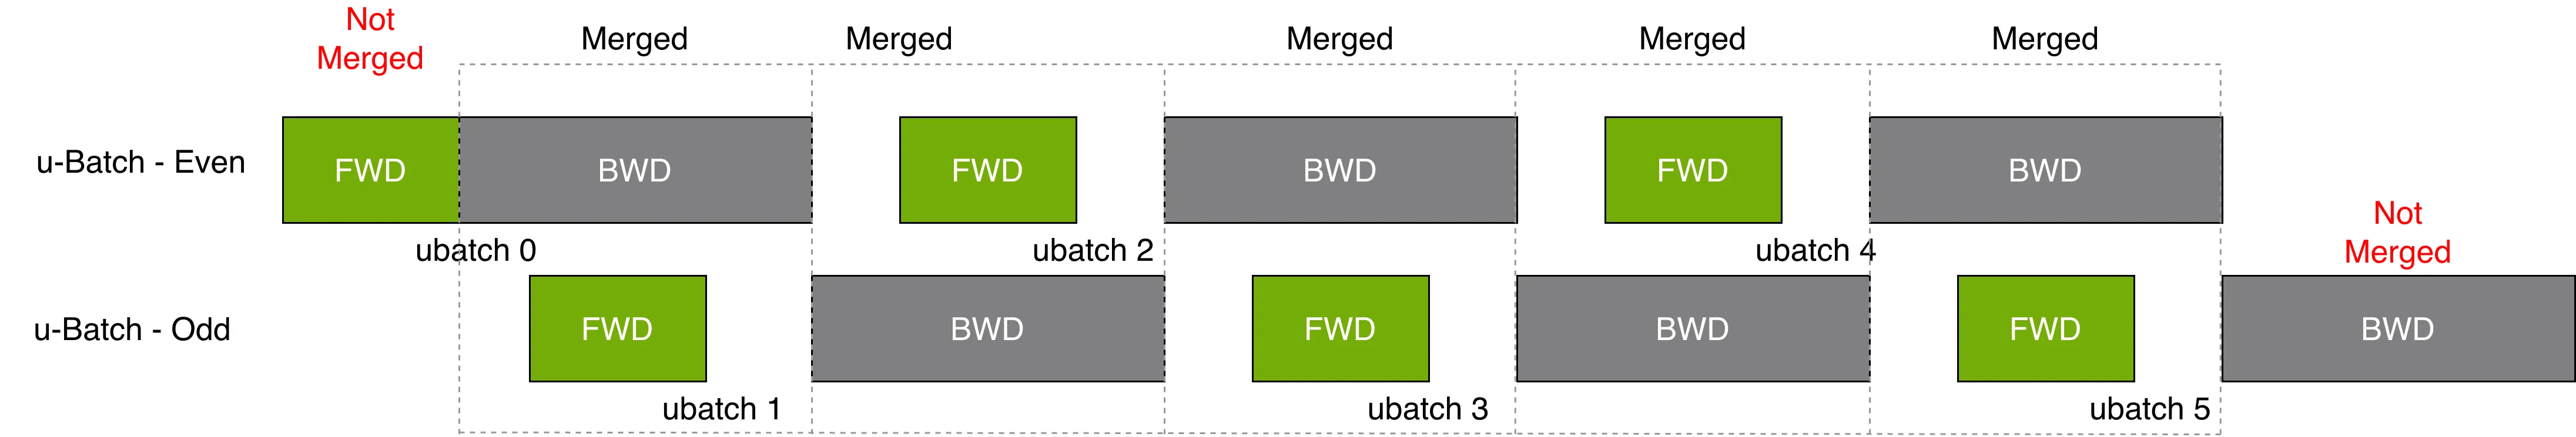
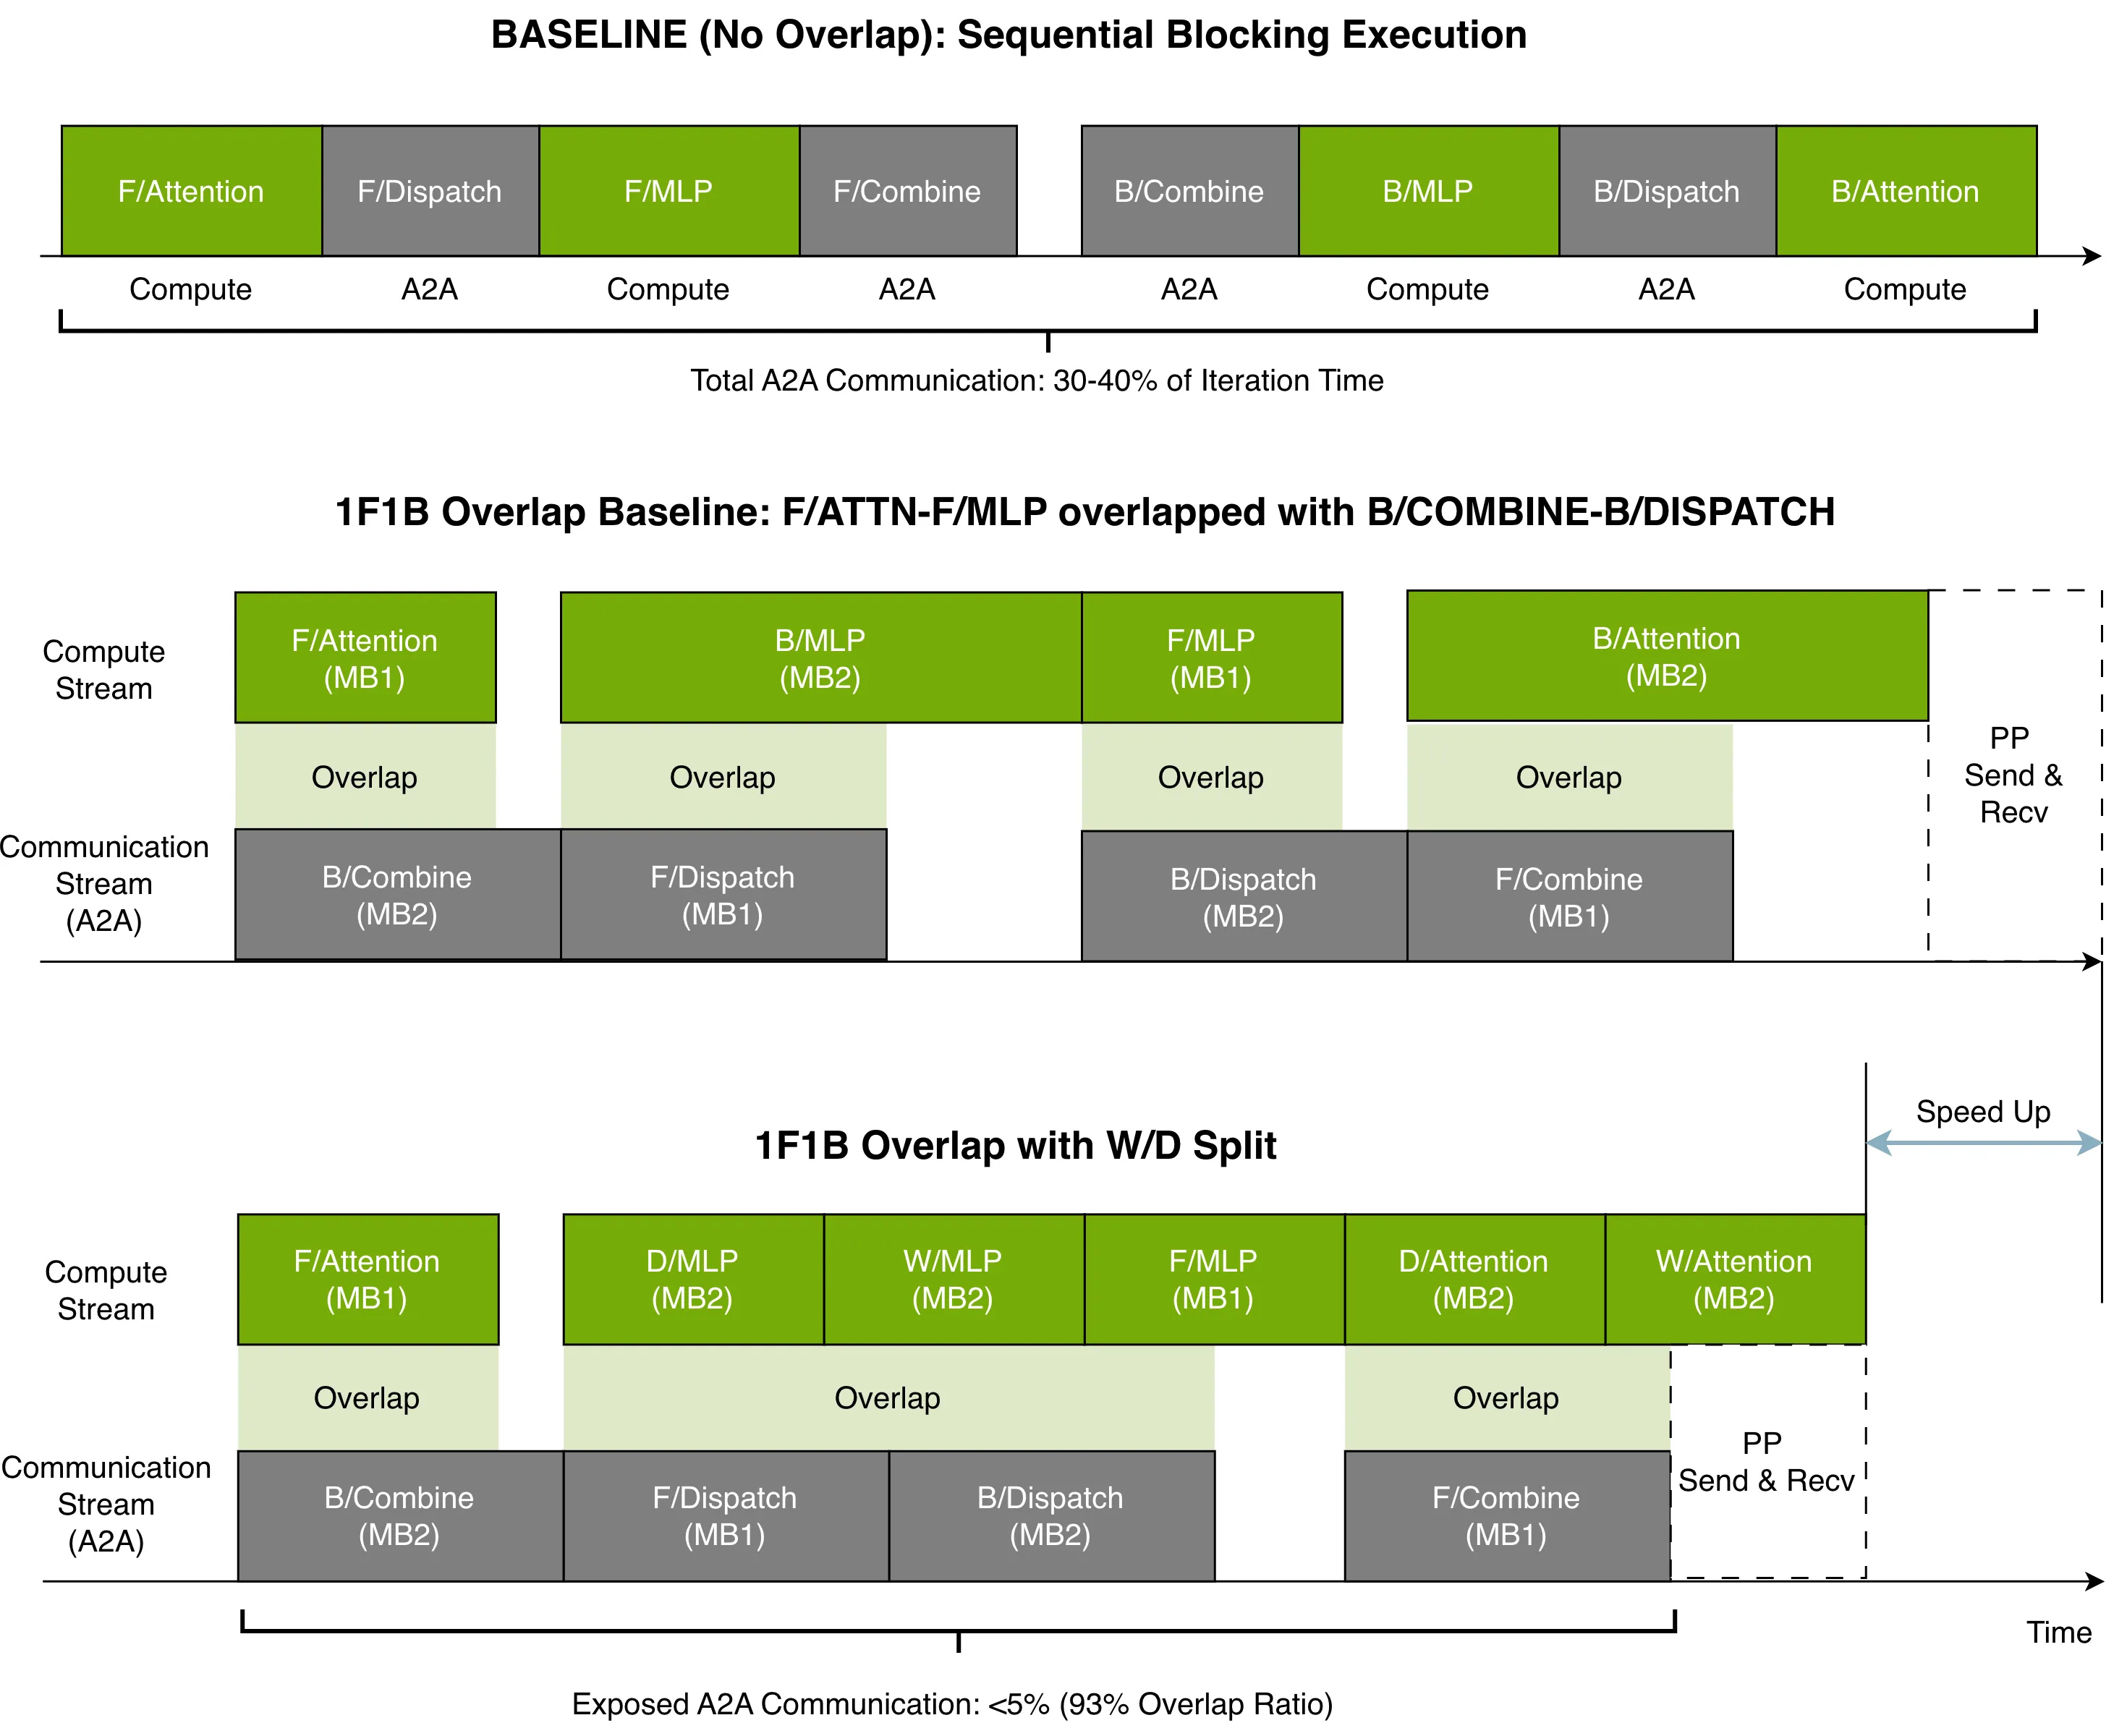
通信-计算重叠将 all-to-all 延迟隐藏在专家计算之后,将 all-to-all 从瓶颈转变为后台操作。
4.3 突破计算效率墙
4.3.1 Grouped GEMM 和内核融合
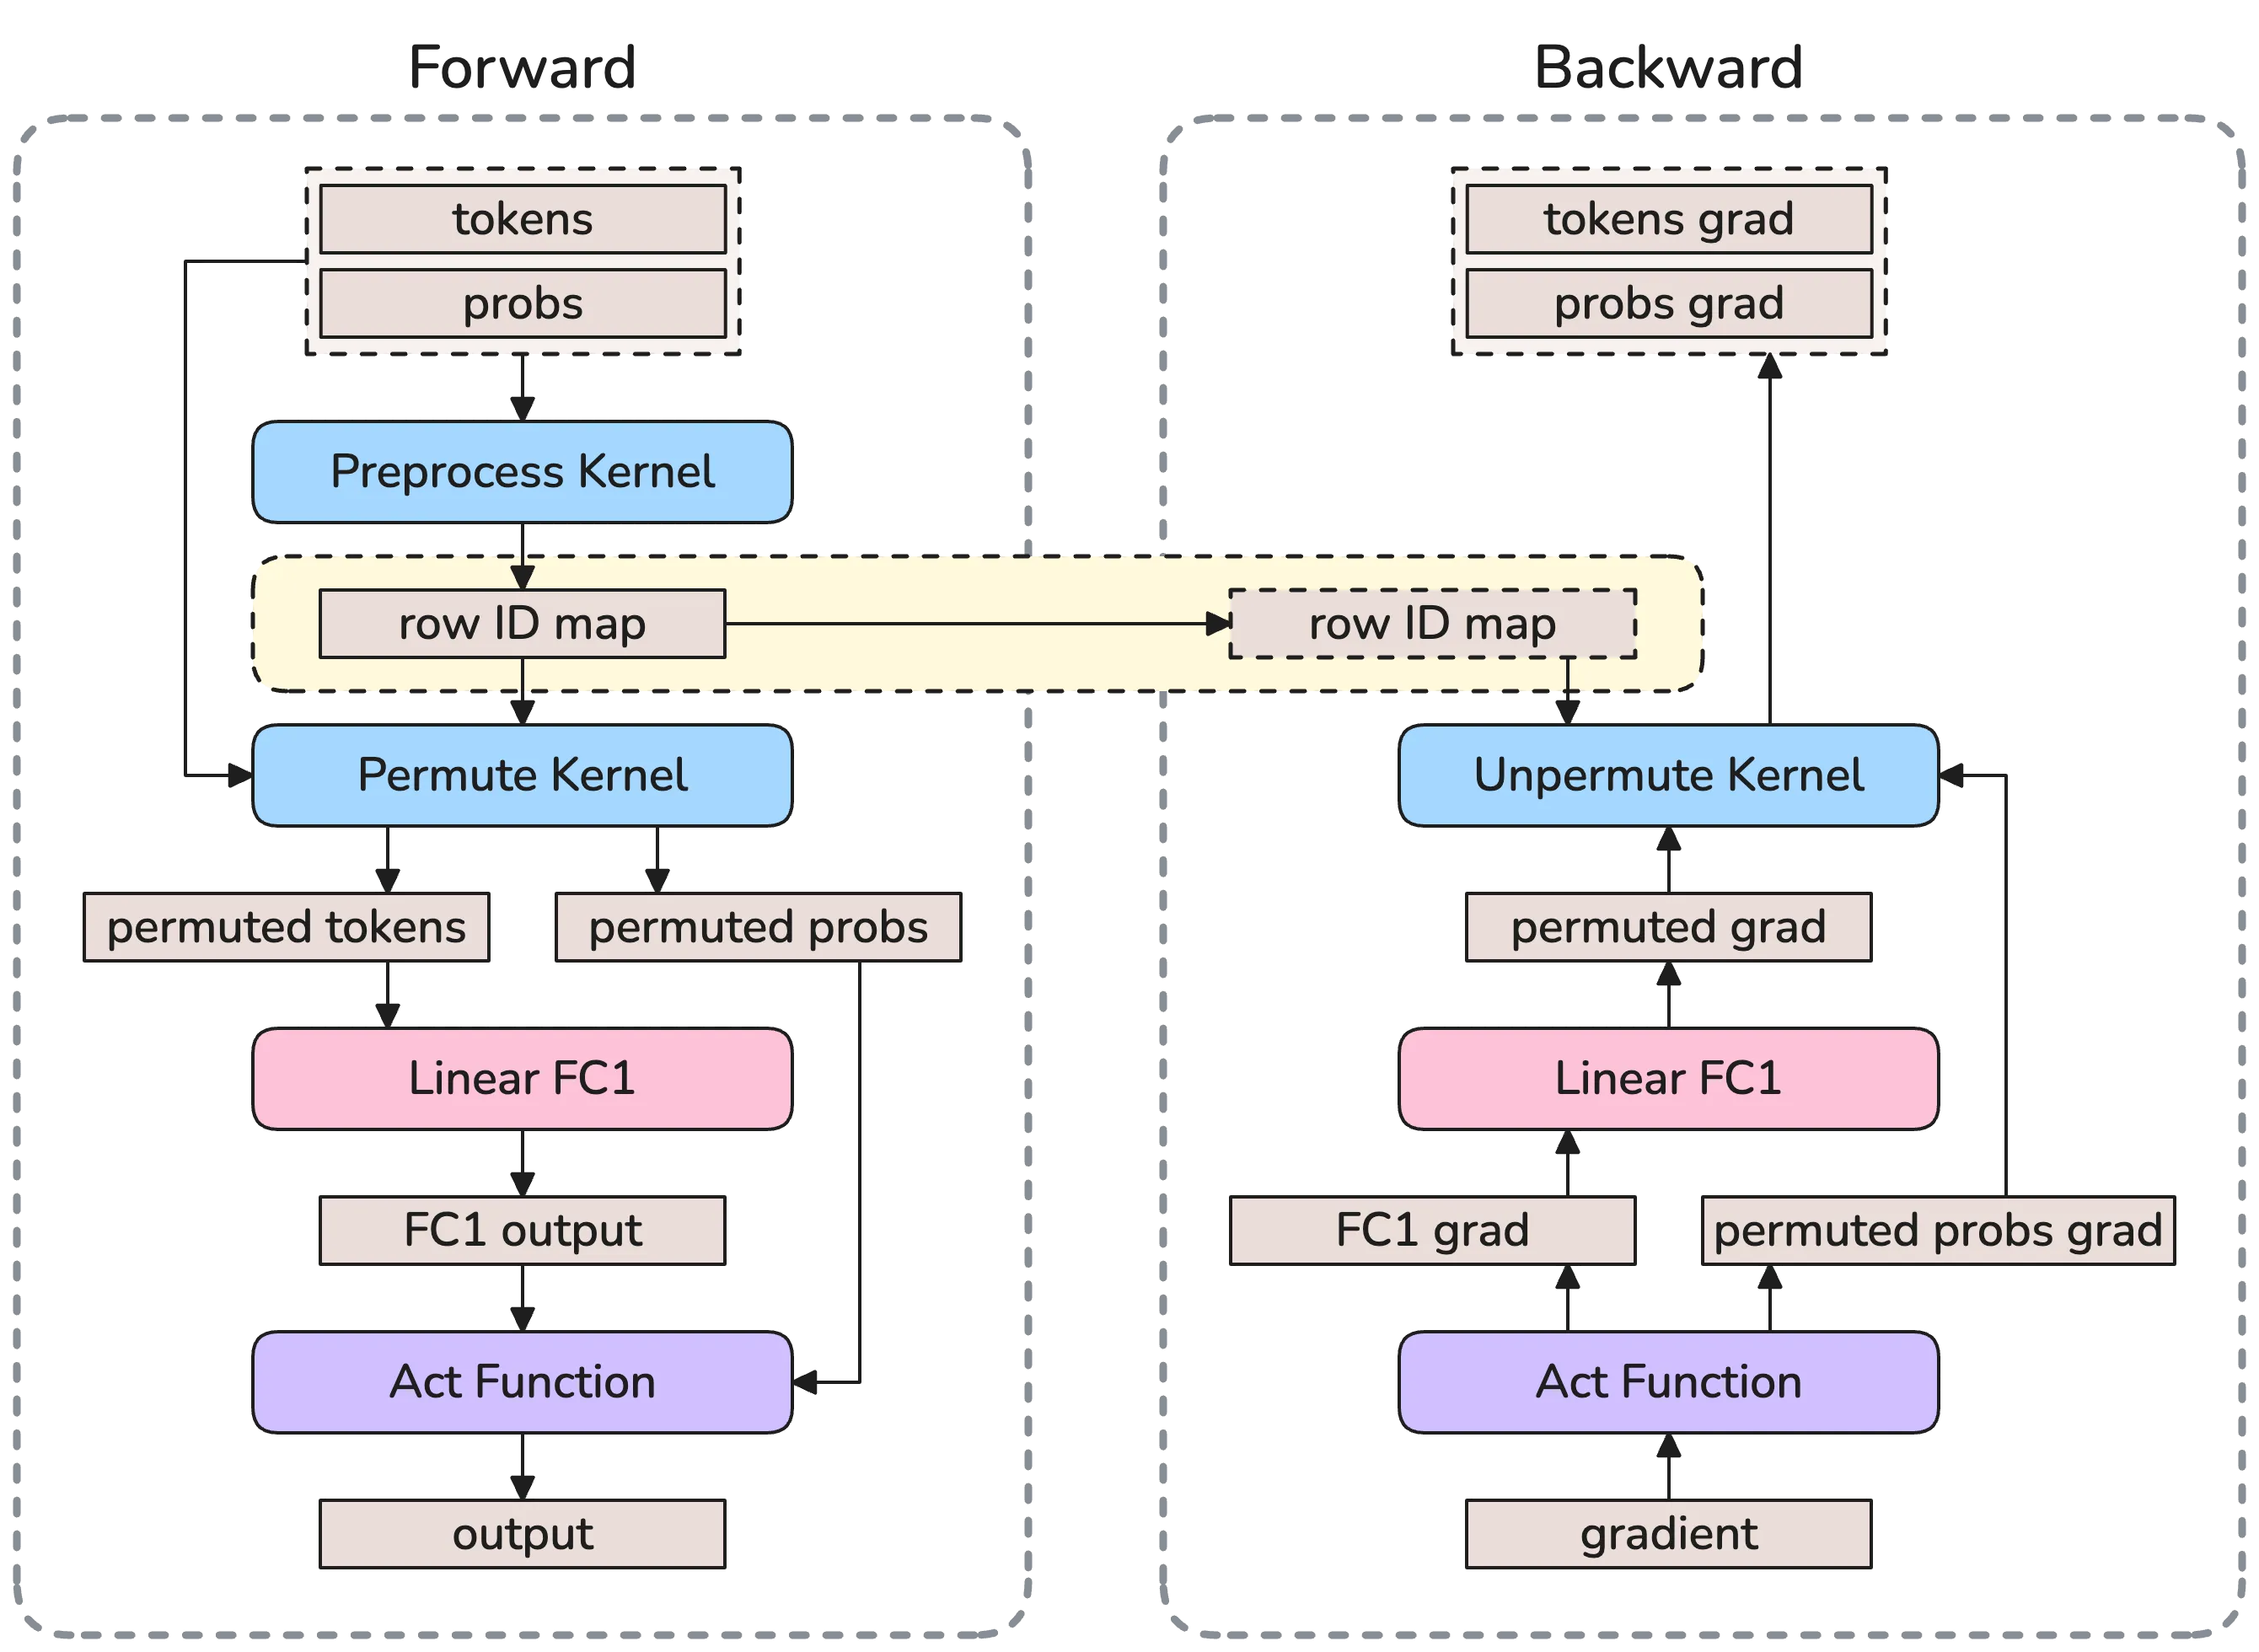
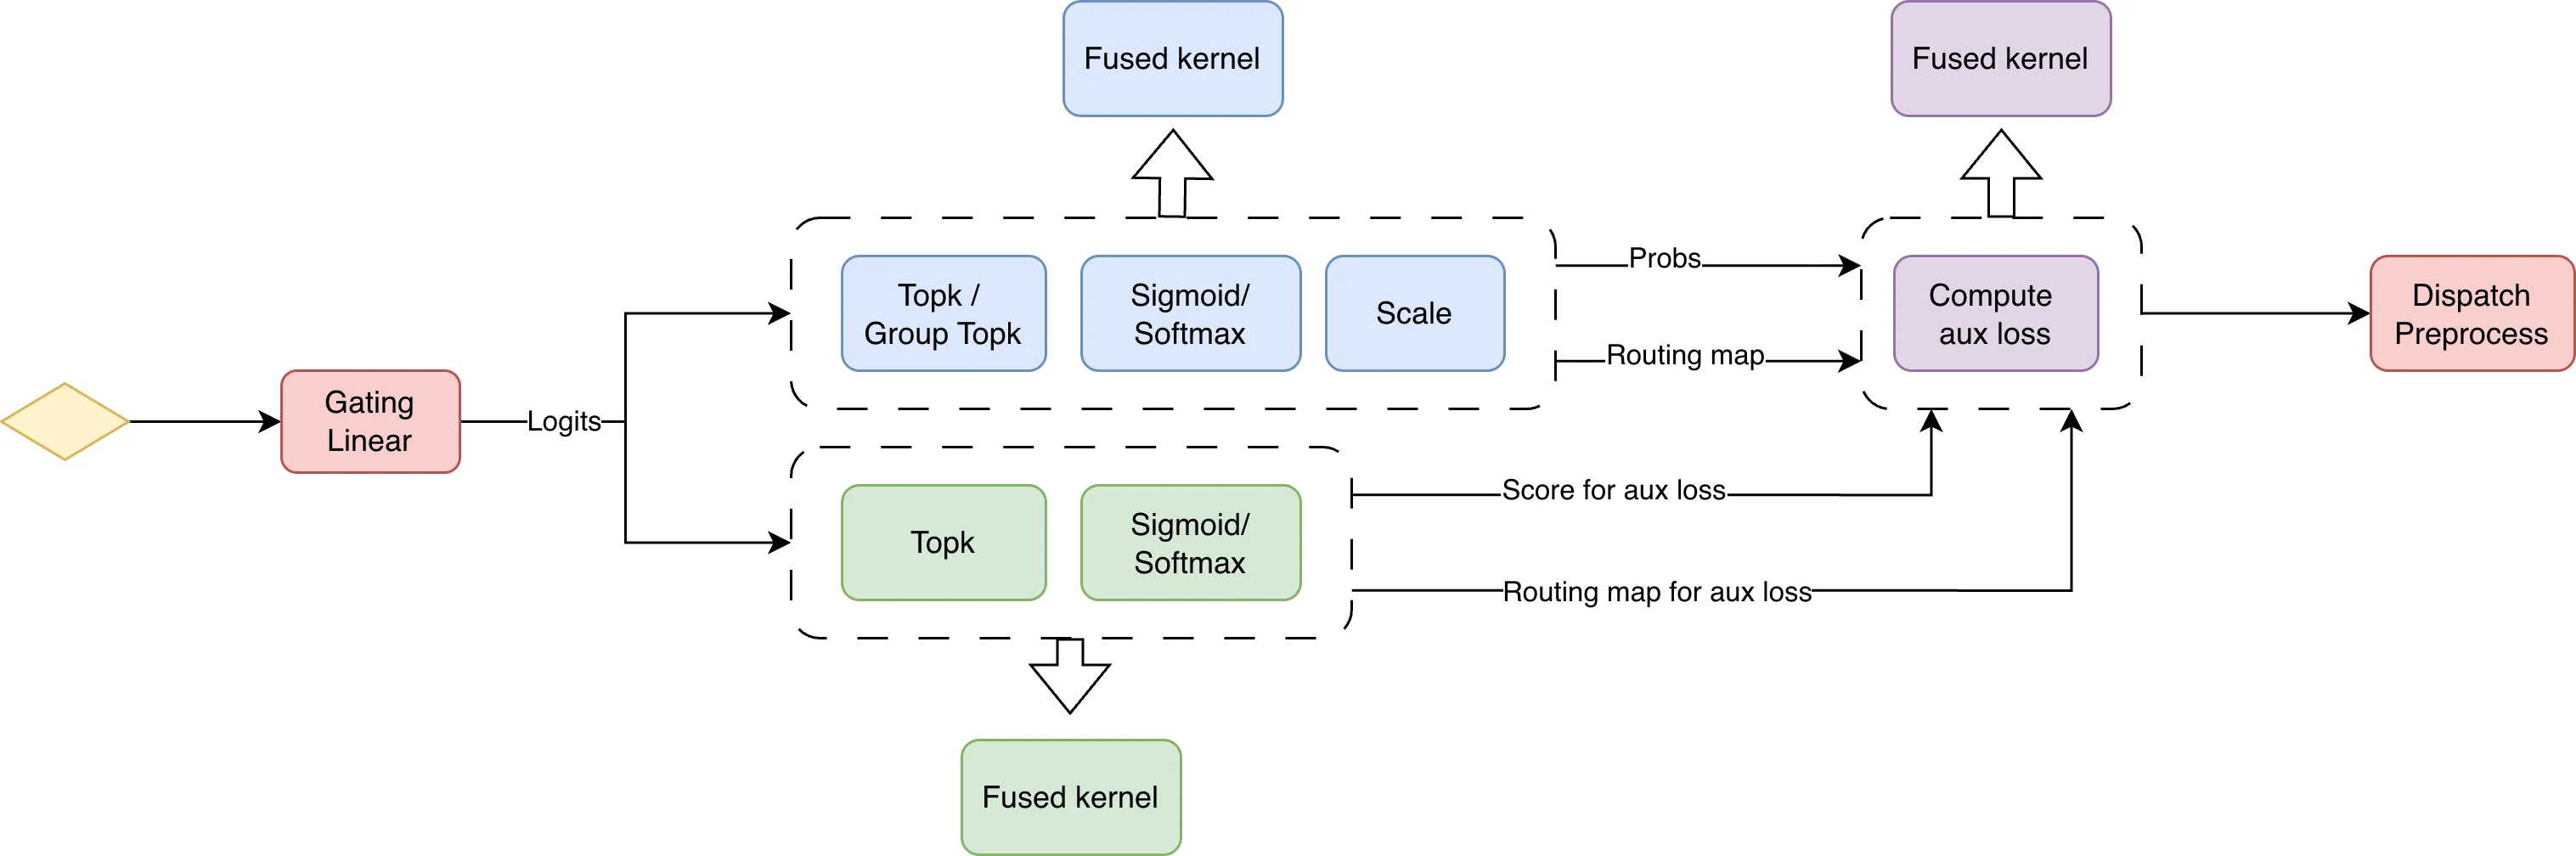
Grouped GEMM 内核将专家计算批量处理以获得更好的硬件利用率。内核融合整合路由和排列操作。
4.3.2 CUDA Graphs
CUDA Graphs 消除主机开销,但需要静态张量形状,与无丢弃路由的动态专家分配冲突。
4.3.3 无丢弃 MoE 的完整 CUDA Graphs 覆盖
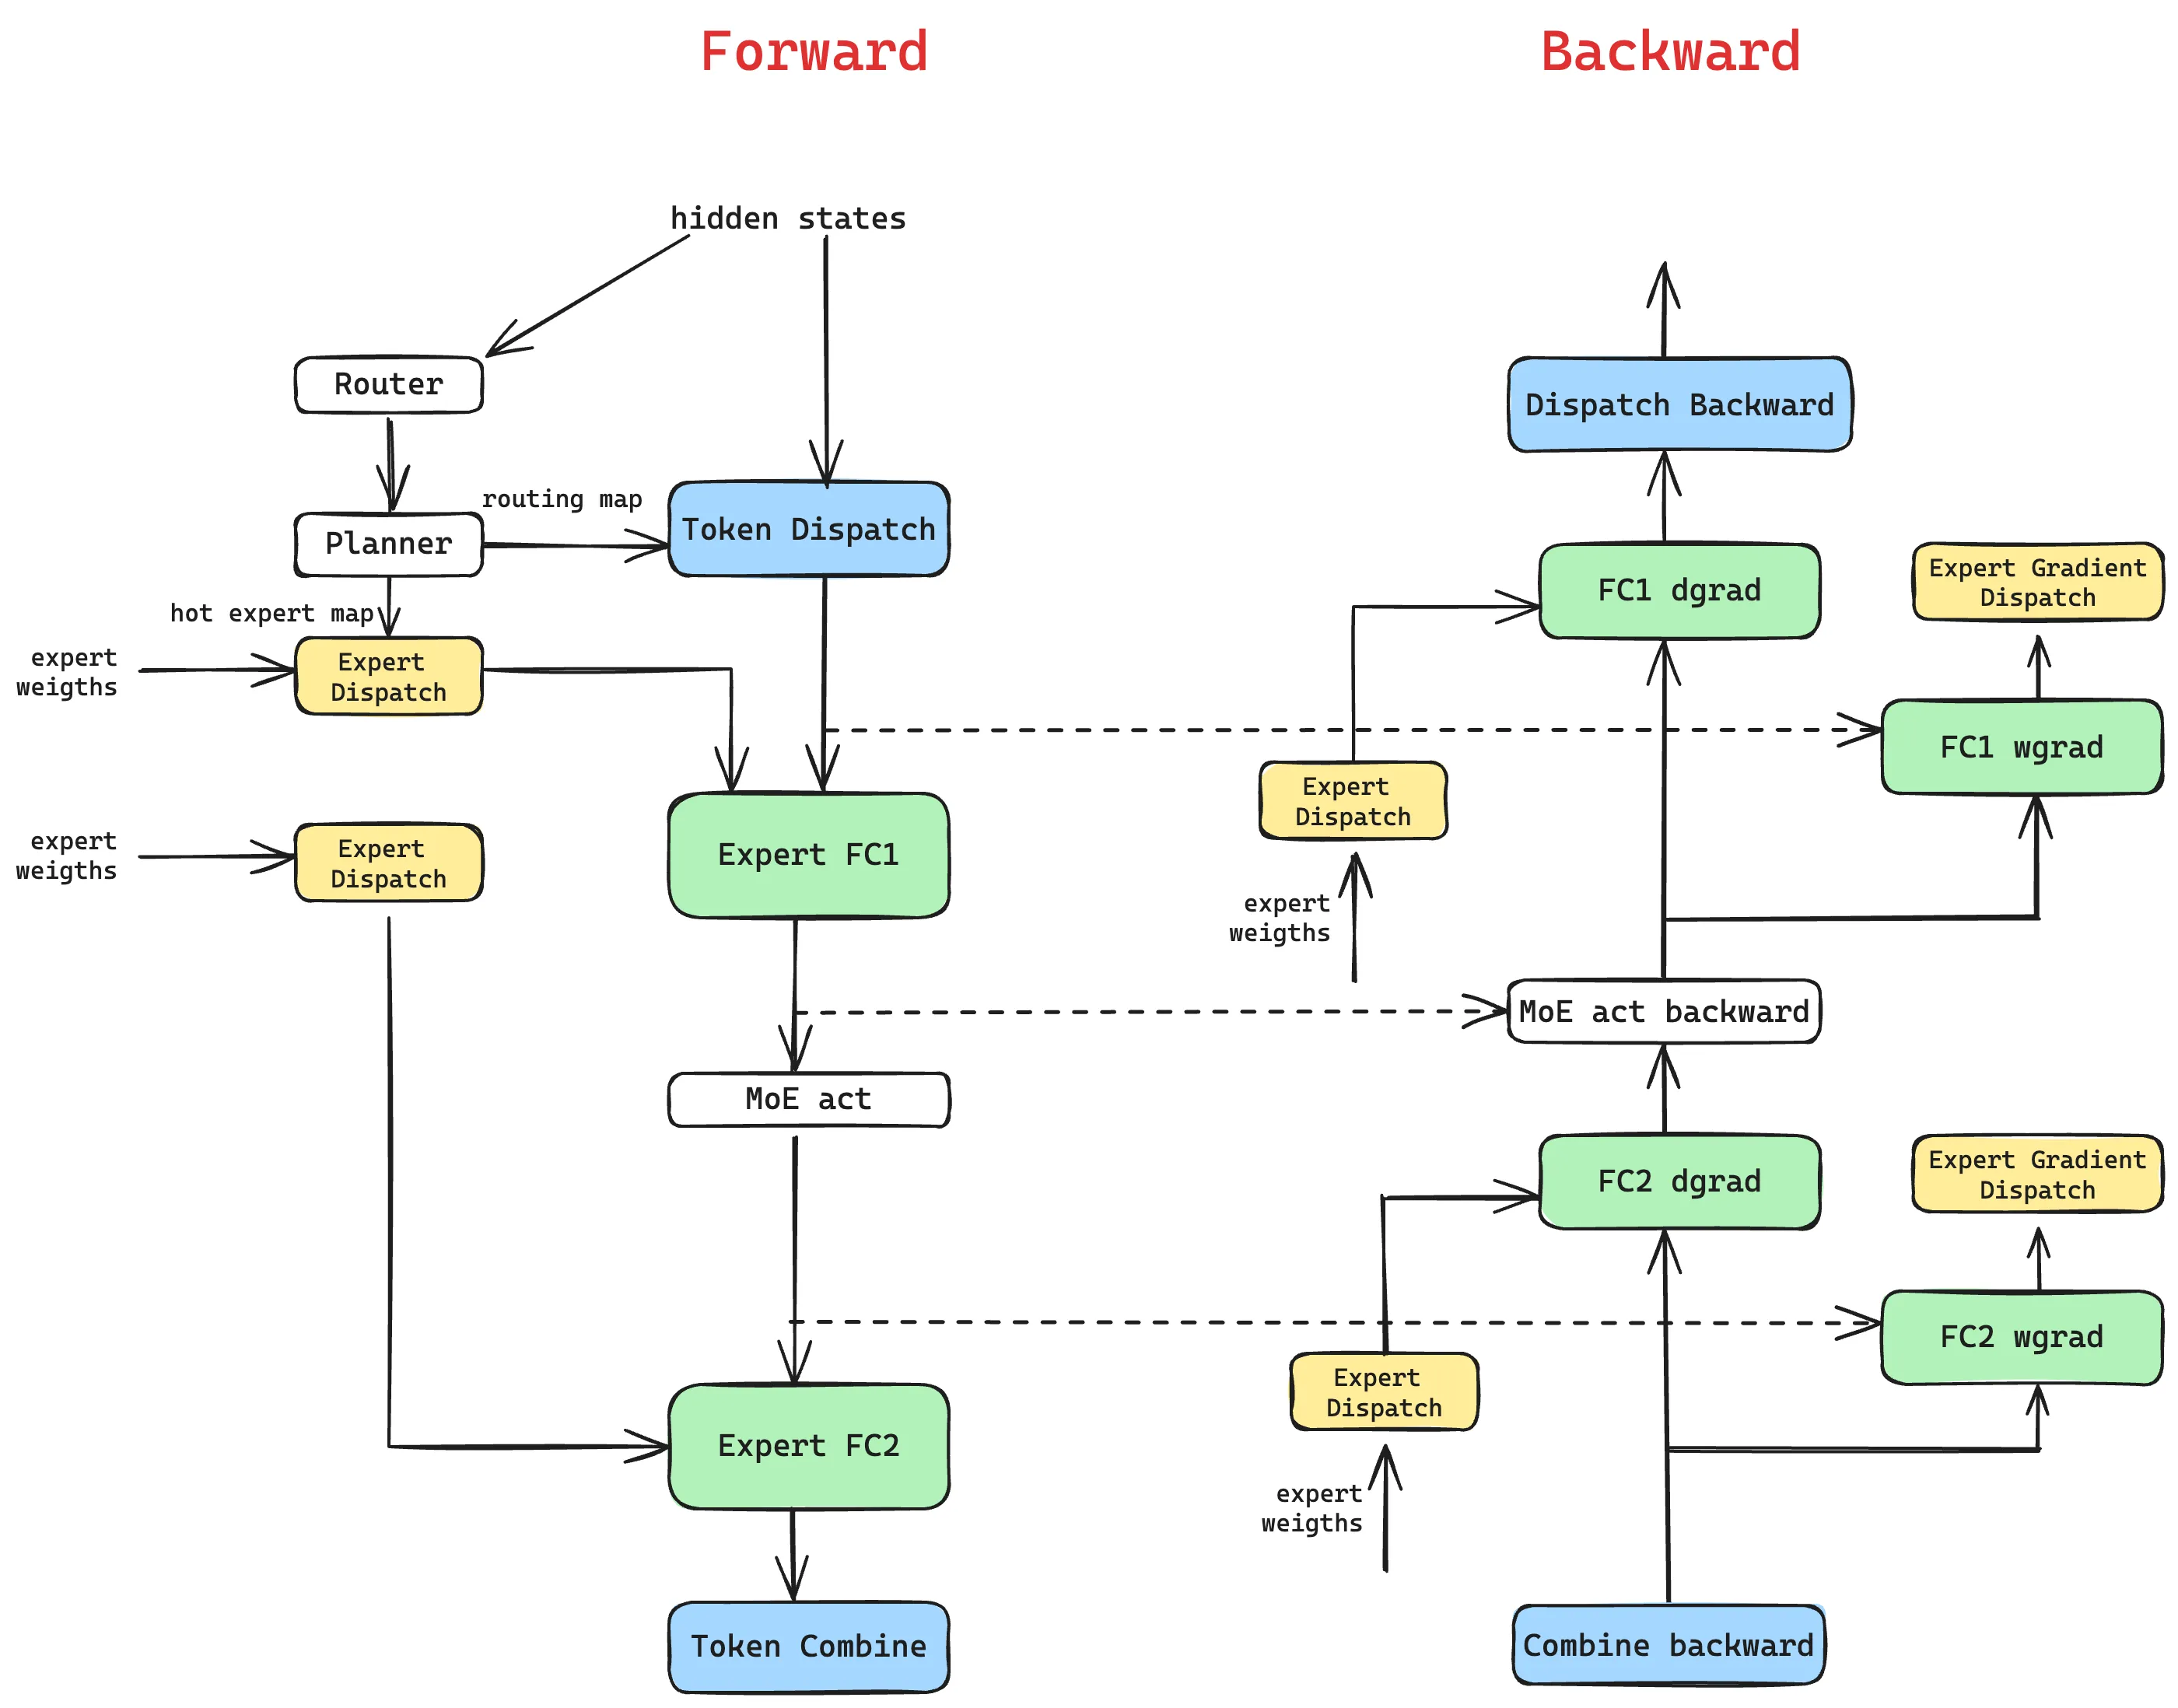
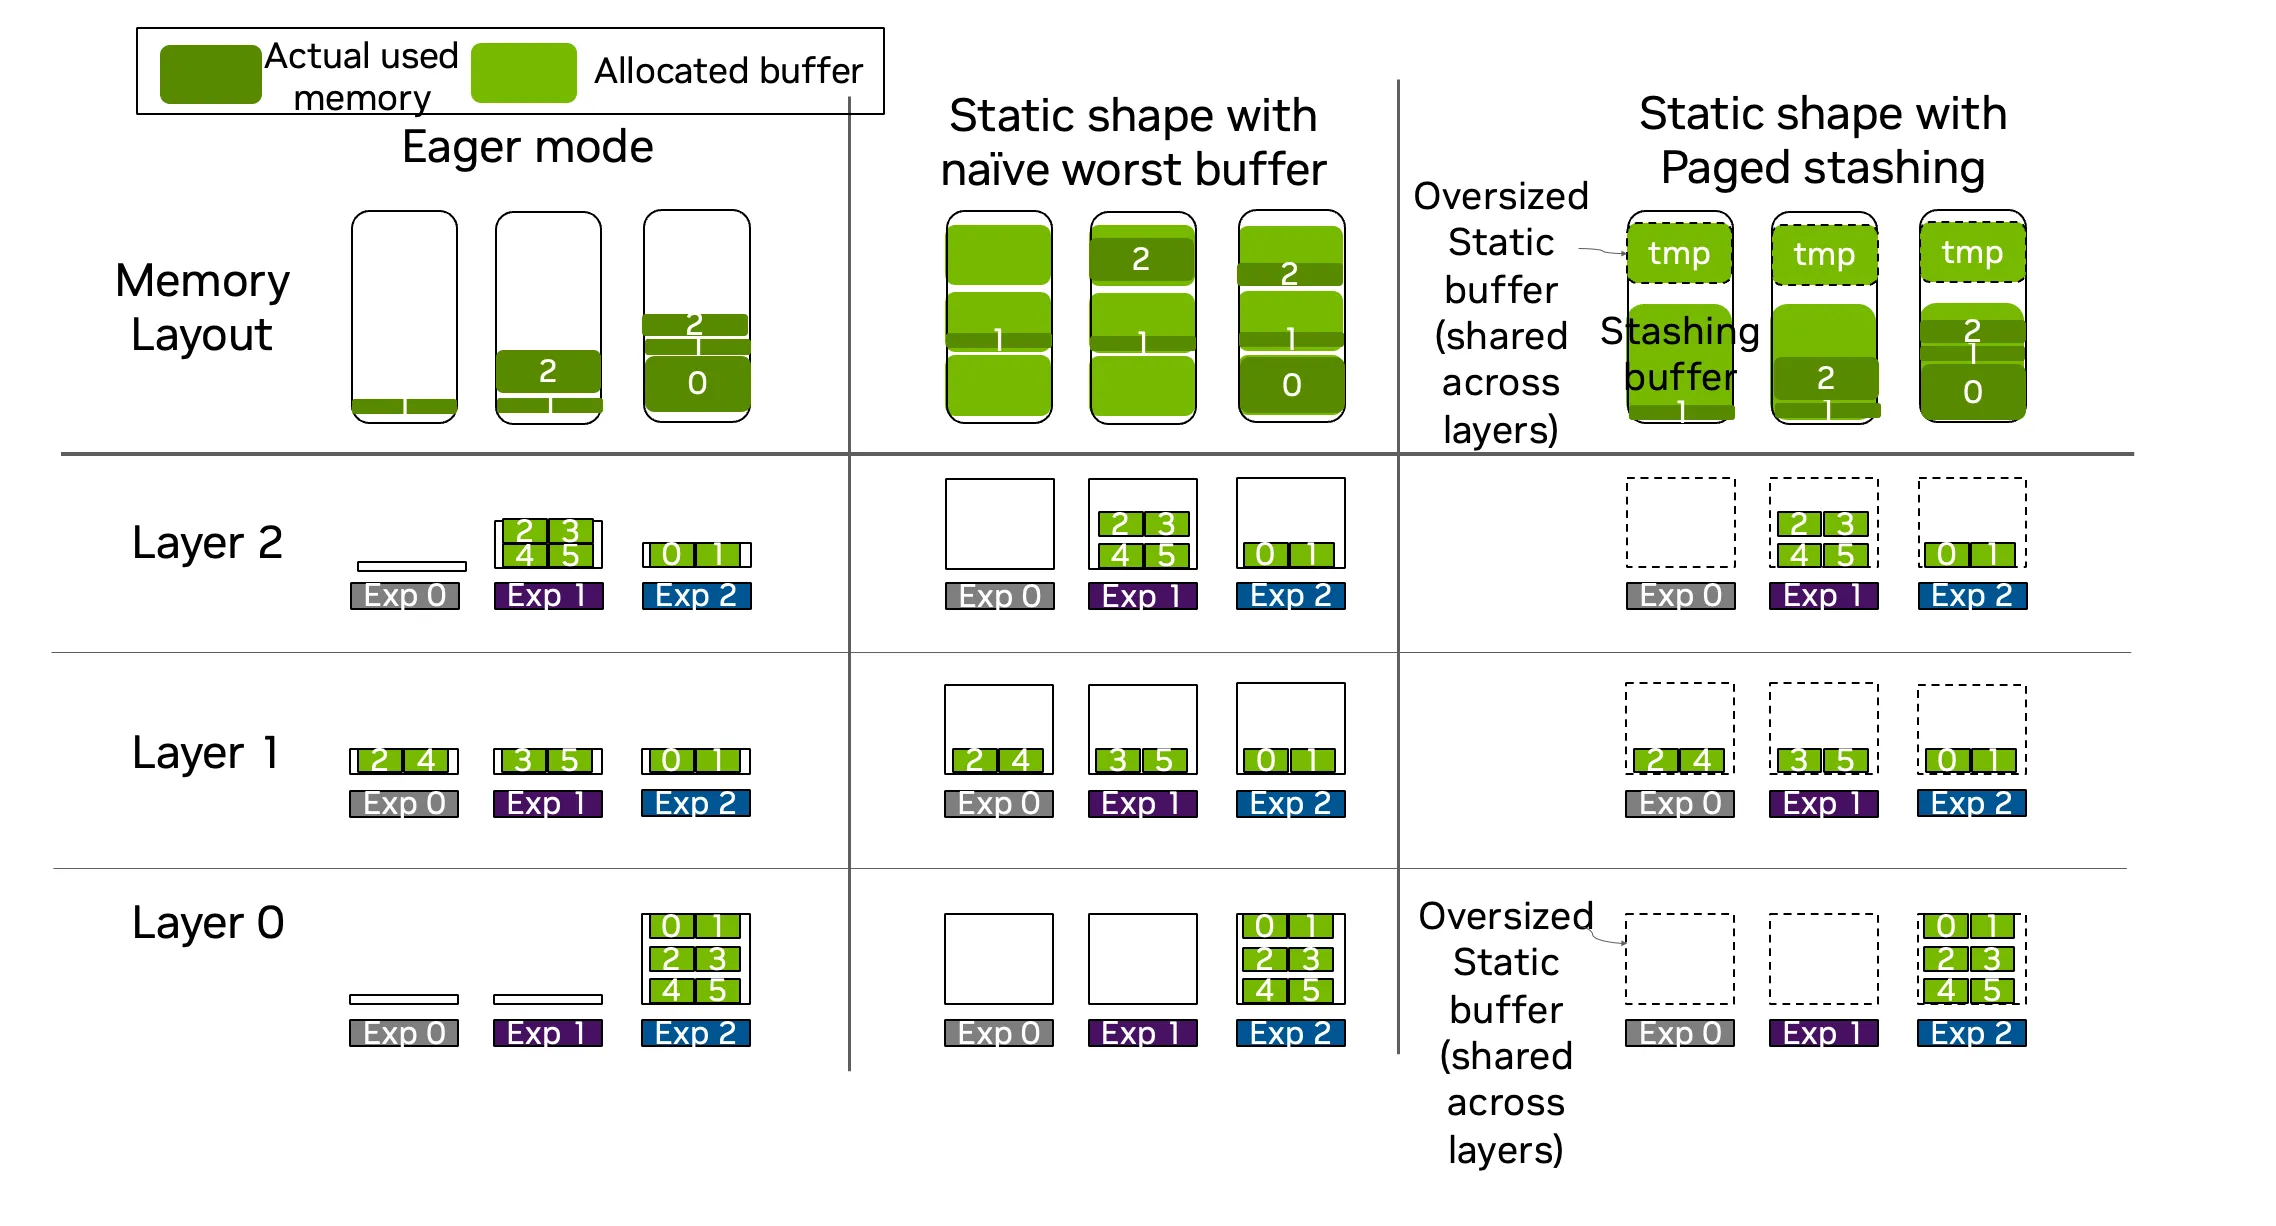
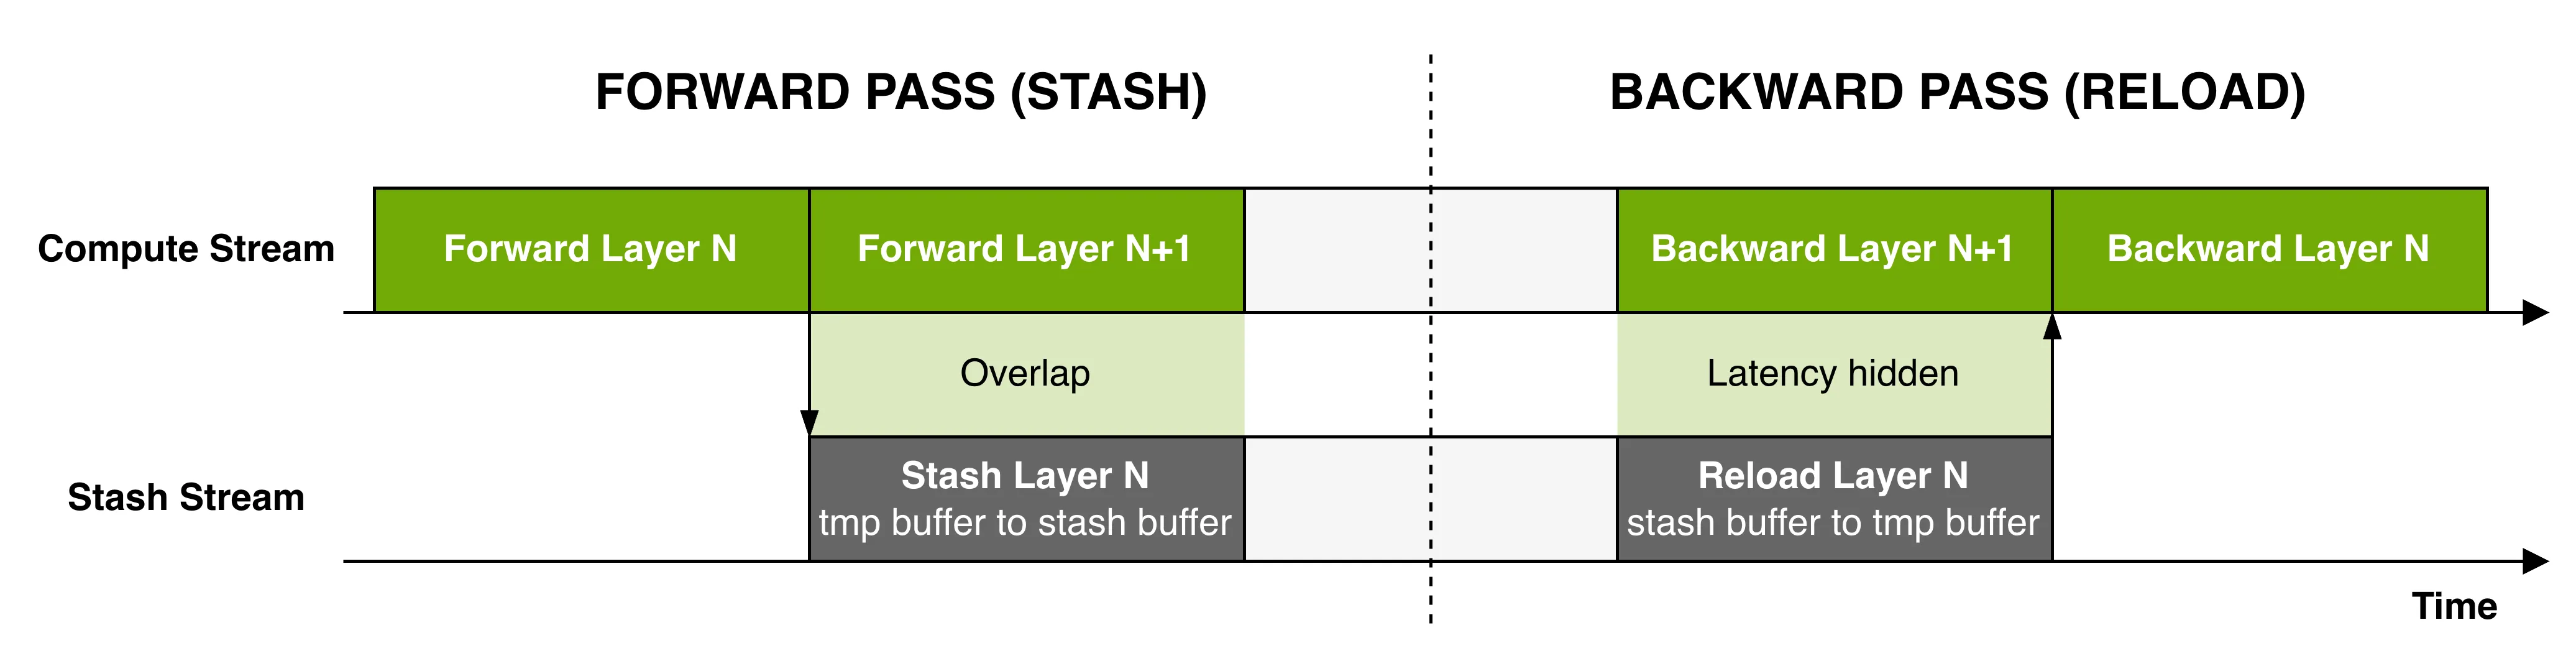
通过同步自由内核、ECHO(动态克隆热门专家以平衡 token 分布)和 Paged Stashing 实现无丢弃 MoE 的完整 CUDA Graphs 覆盖。
4.3.4 持久化双缓冲
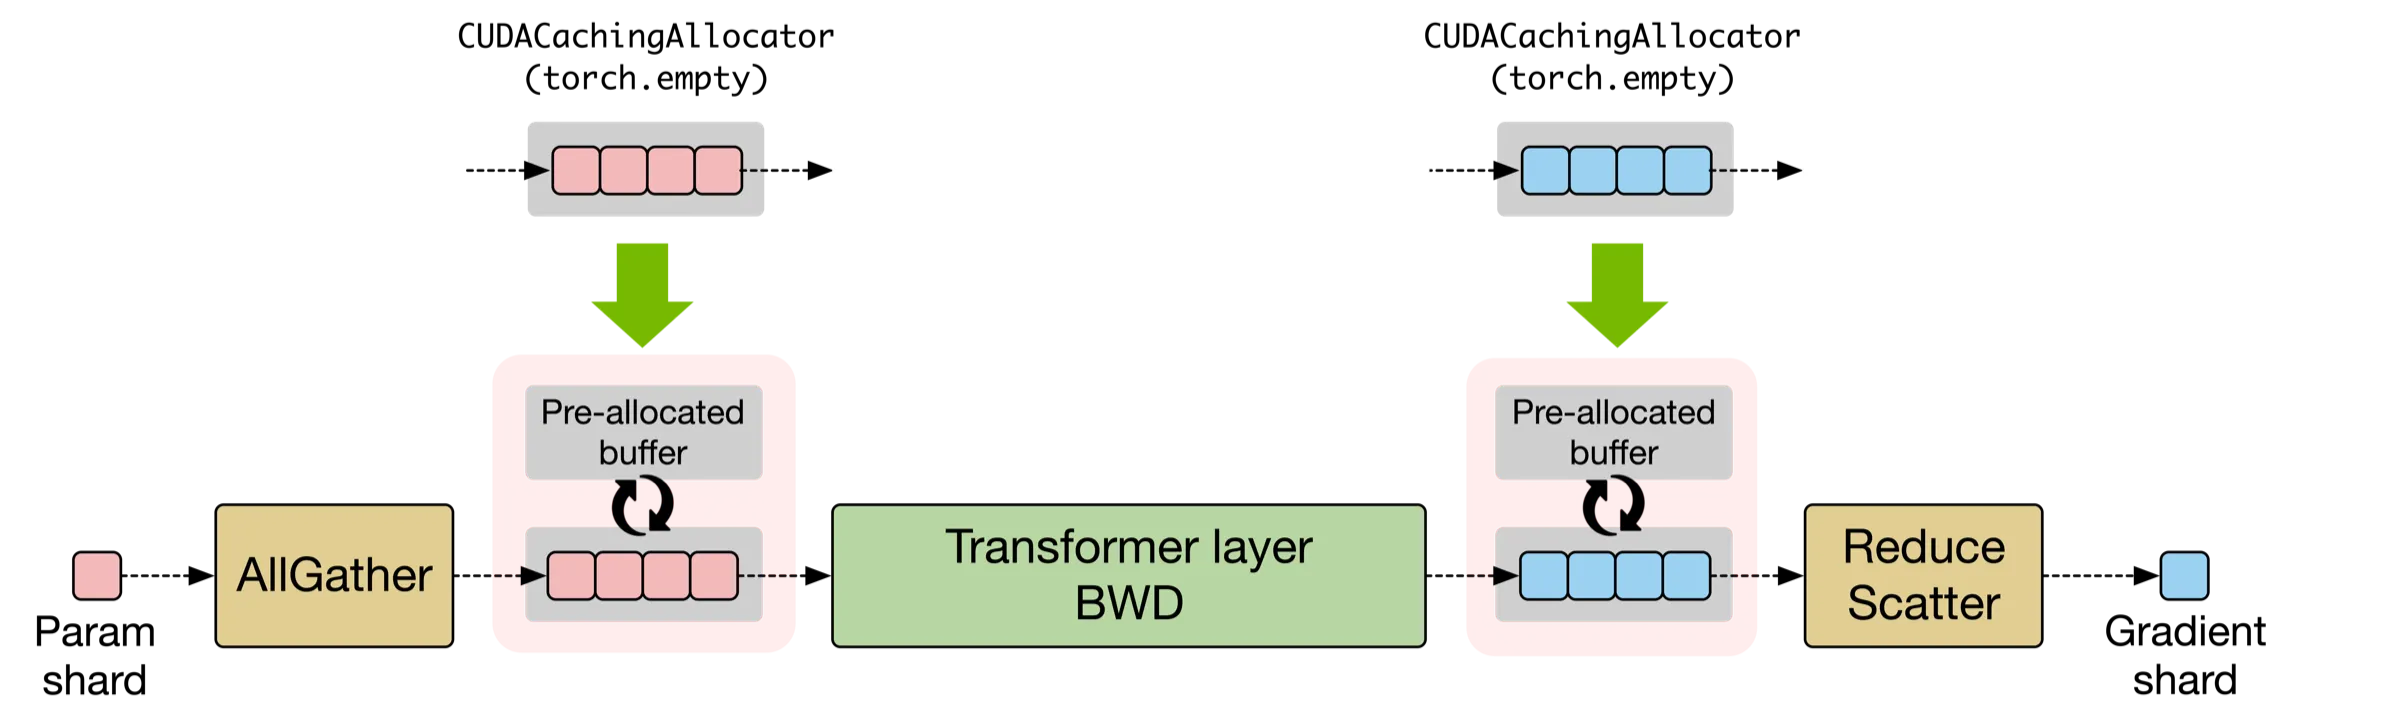
五、低精度训练:FP8/FP4
5.1 选择性精度策略
低精度训练对 MoE 的影响是放大了收益和风险:
放大收益: 数百个专家的激活内存按比例缩放,FP8/FP4 激活提供更大的绝对内存节省。
放大风险: 路由器决策依赖精确分数来分配 token,量化噪声可能破坏专家选择稳定性。
策略:选择性精度:
- 保护路由决策:路由器保持 FP32
- 为关键组件保留精度:嵌入、输出层、主梯度、主权重和优化器状态保持原始精度
- 量化批量计算:专家 GEMM 使用低精度训练
5.2 FP8/FP4 对三面墙的影响
| 墙 | 低精度训练收益 | 详情 |
|---|---|---|
| 内存 | 50%(FP8)/75%(FP4)激活减少 | 消除 BF16 权重副本 |
| 通信 | 50% 参数 AllGather | FP8/FP4 主权重 |
| 计算 | 更快的 Tensor Core GEMM | 量化内核开销 |
5.3 训练配方
5.3.1 Per-Tensor FP8
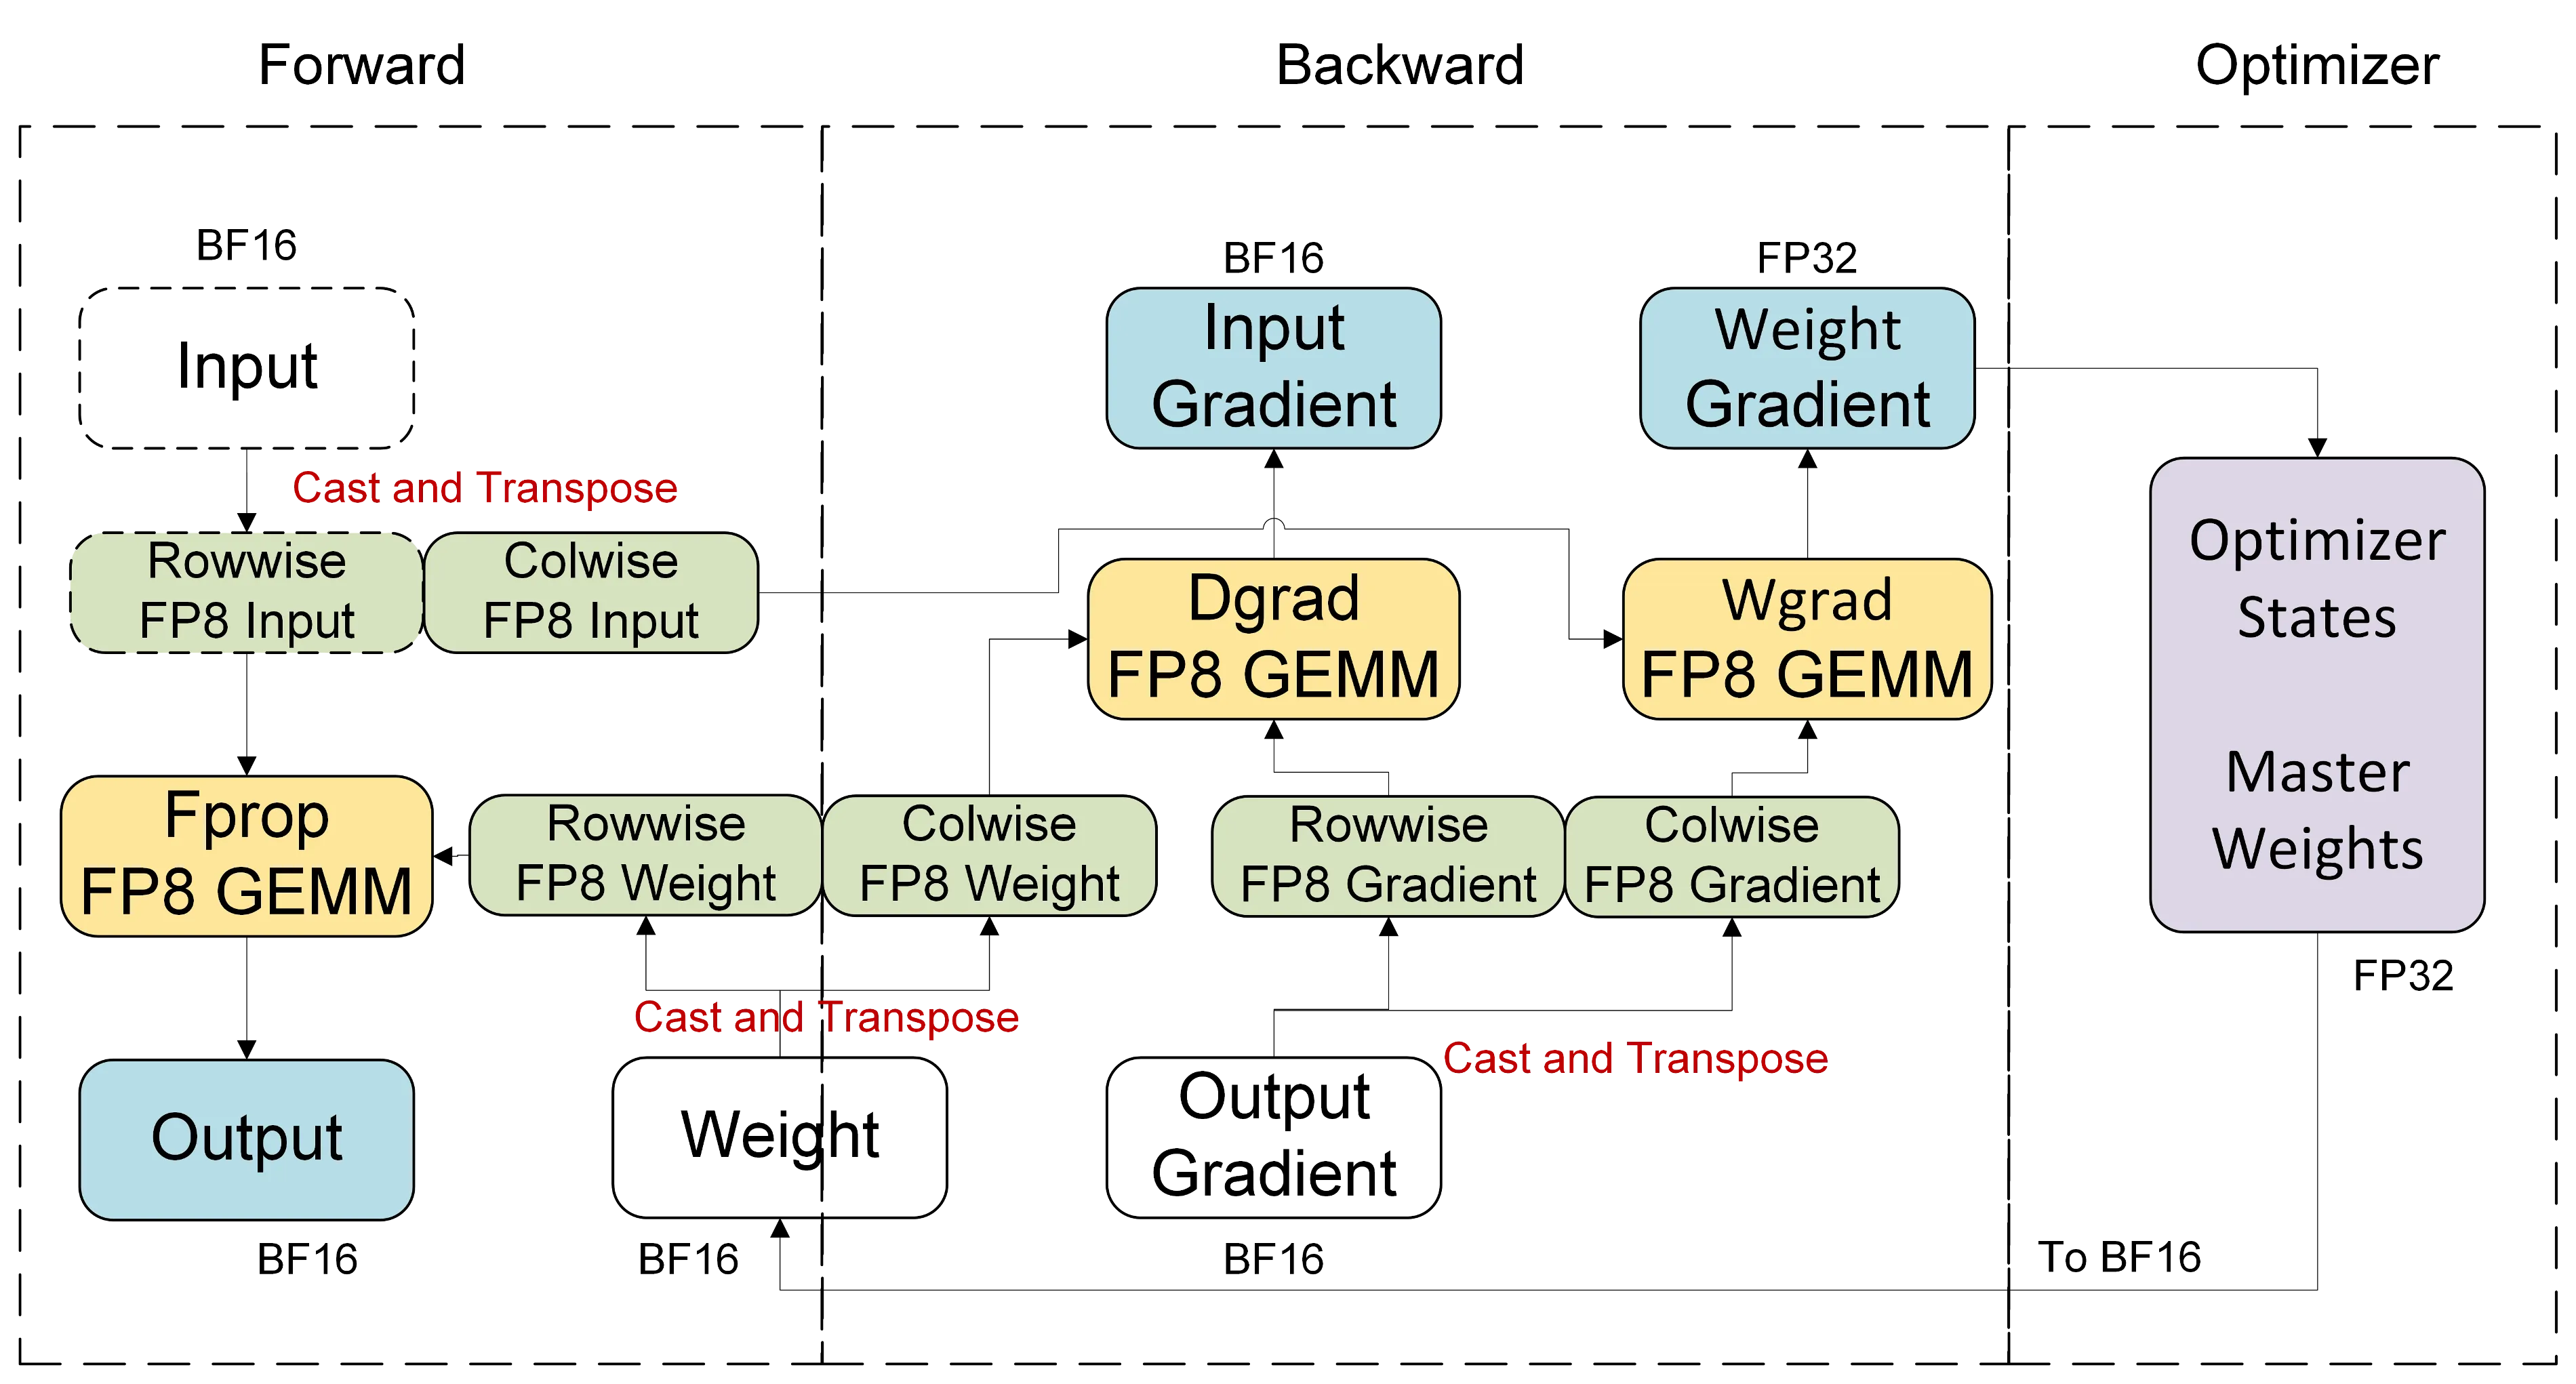
Per-Tensor Scaling 使用每个张量的单一缩放因子,简单但精度有限,适合实验。推荐使用当前(实时)缩放而非延迟缩放。
5.3.2 Blockwise FP8 (Hopper)
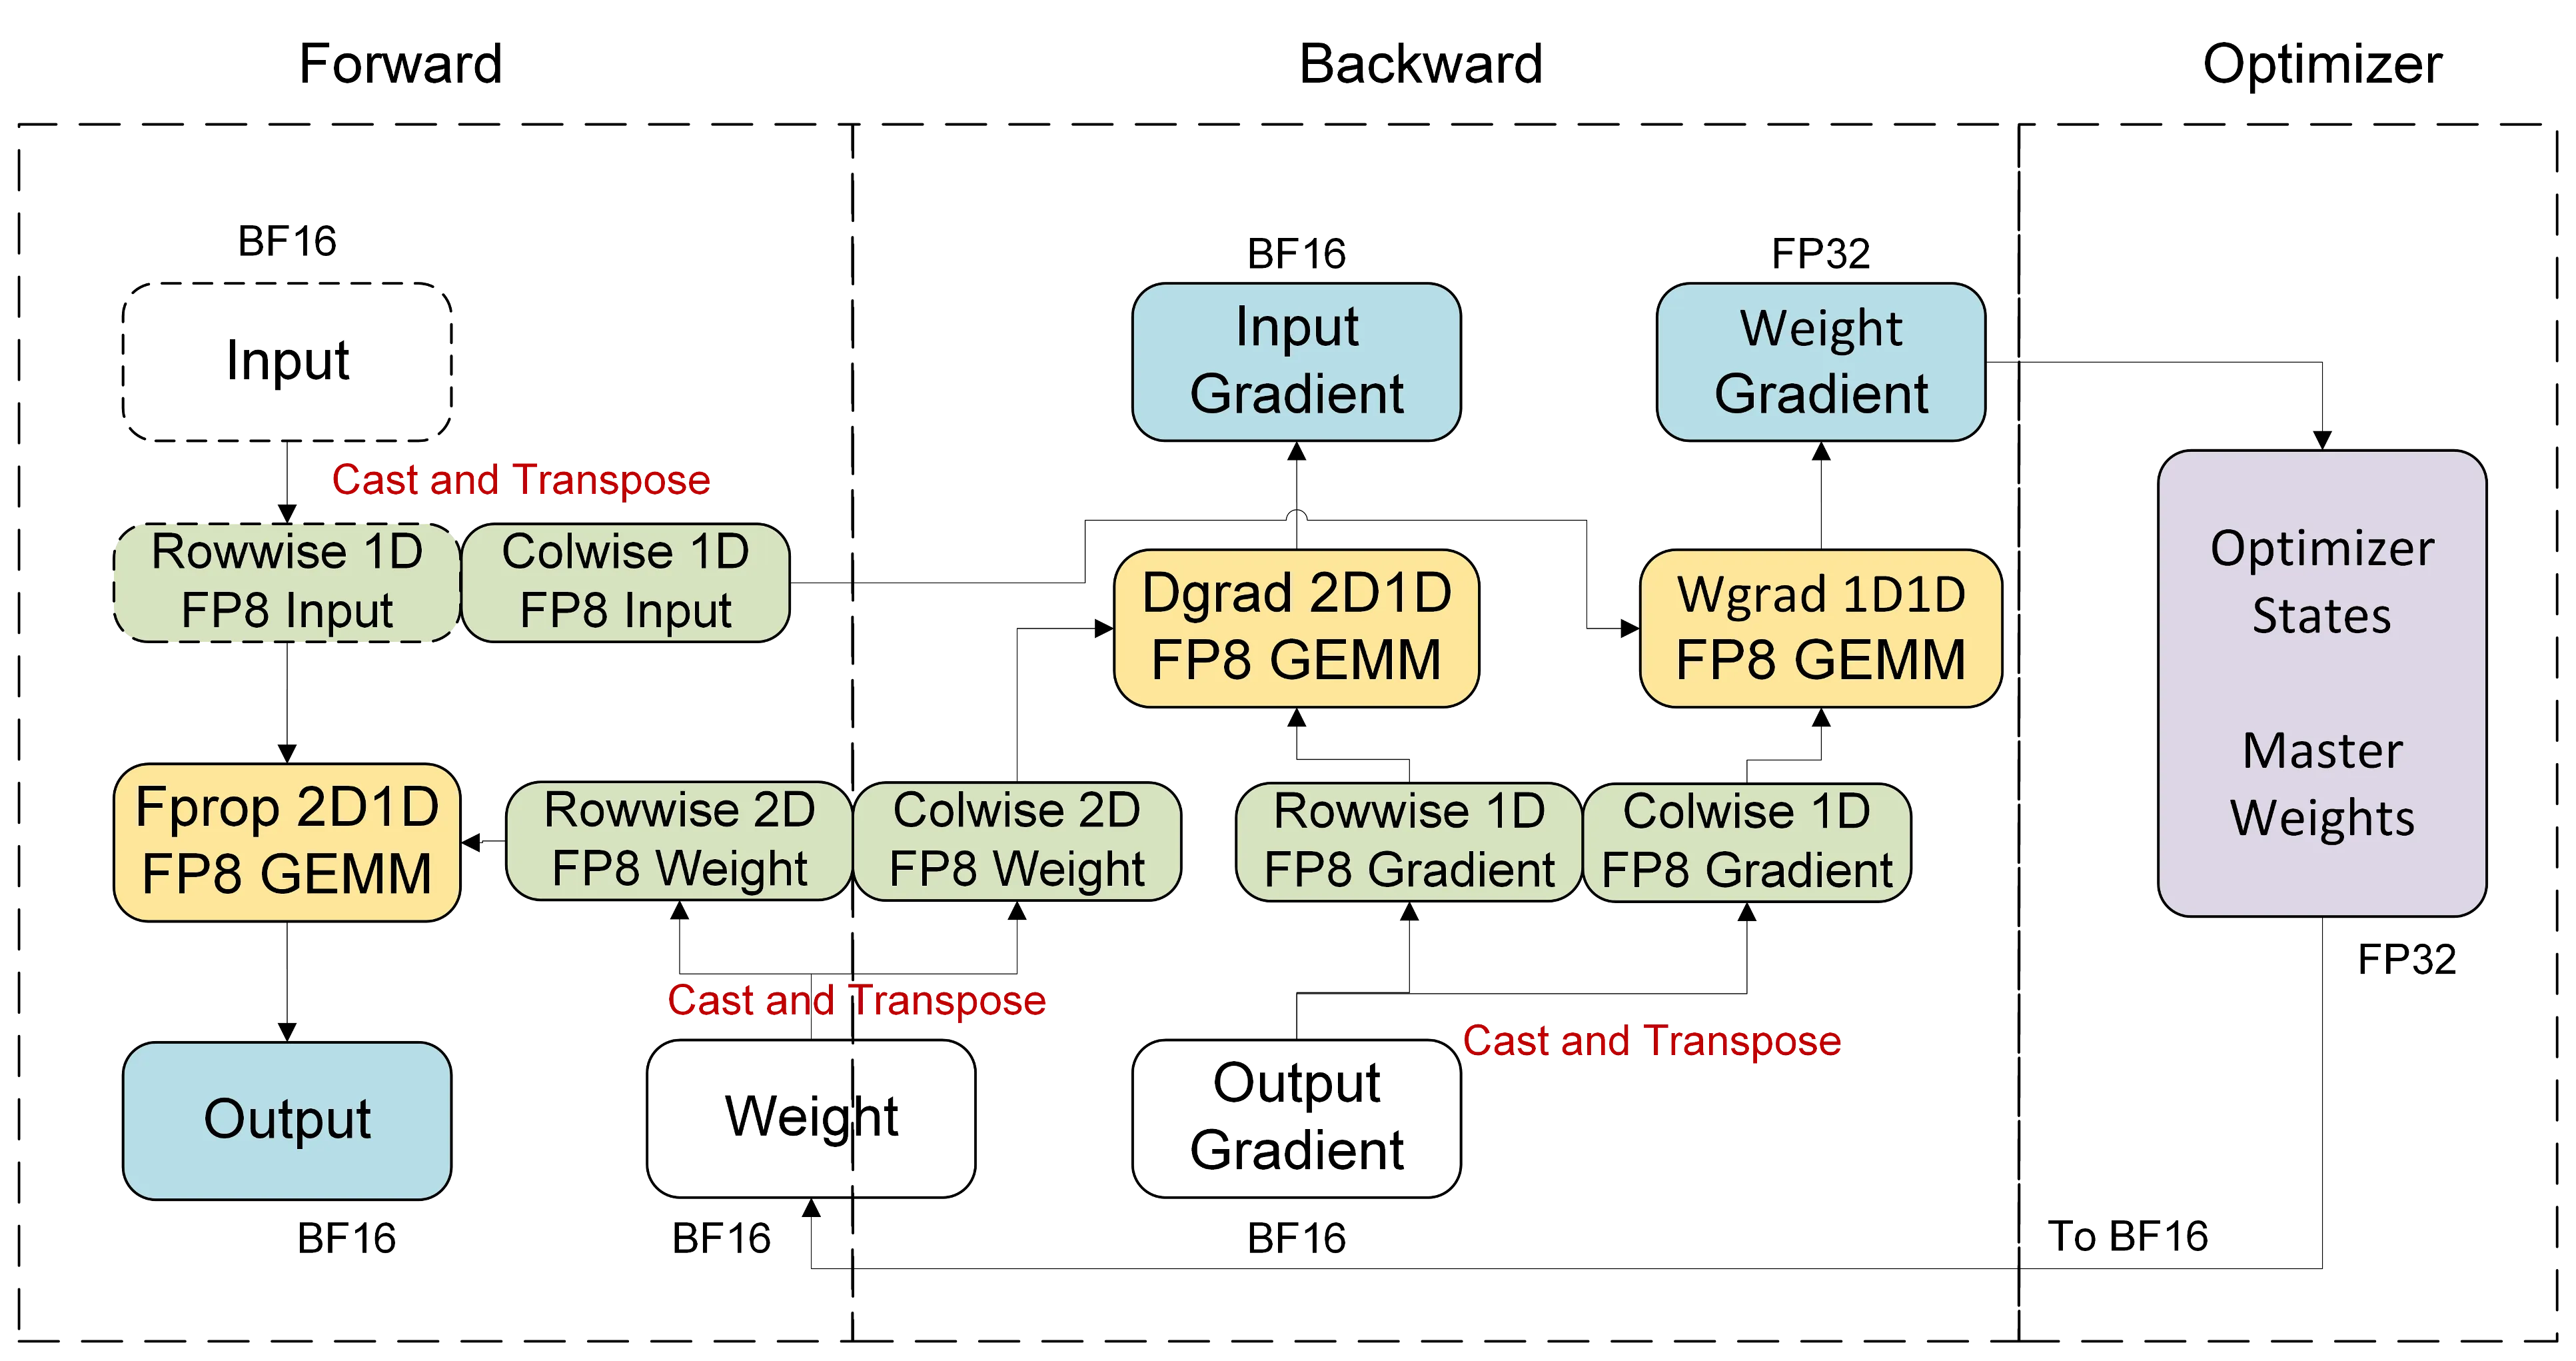
Blockwise FP8 配方采用 E4M3 格式,以 1×128 瓦片量化激活和梯度,128×128 块量化权重。已在 DeepSeek-V3、Minimax-M2、Ant Ling-2.0 等大规模 MoE 模型中验证成功。推荐用于 Hopper 平台。
5.3.3 MXFP8 (Blackwell)
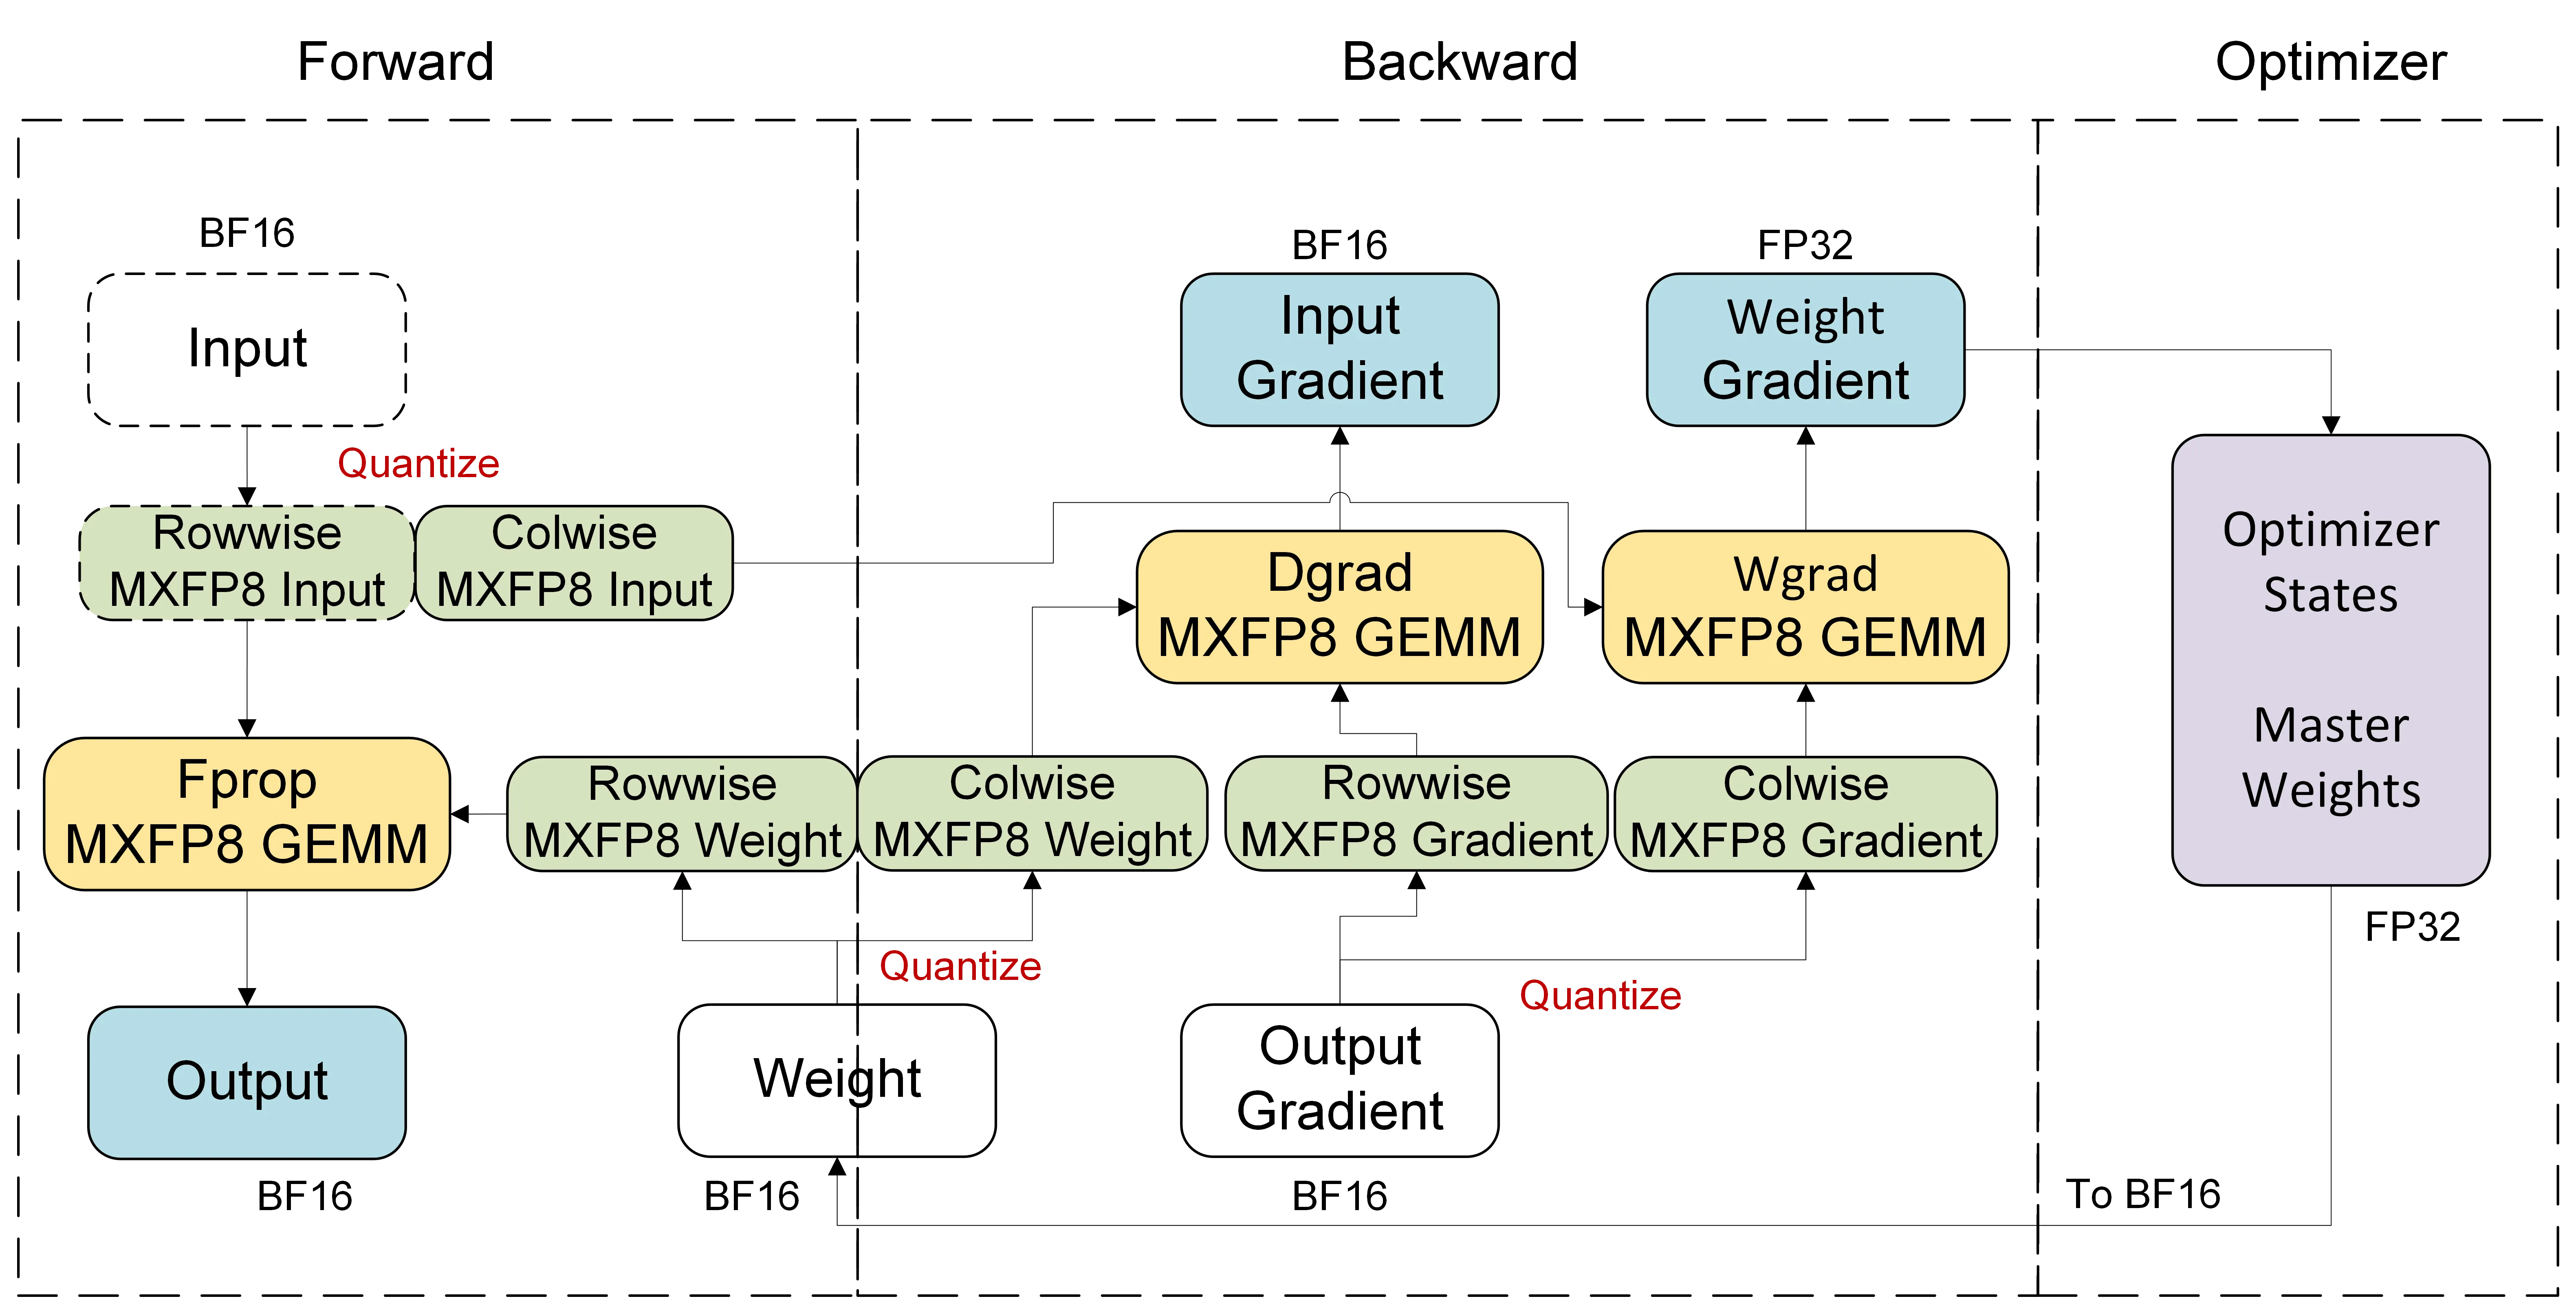
在 Blackwell 平台上,得益于原生第五代 Tensor Core 对 MXFP8 格式的支持,采用更细粒度的量化方案。激活和权重都以 1×32 粒度量化,使用 E8M0 缩放因子。推荐用于 Blackwell 平台。
5.3.4 NVFP4 (Blackwell)
NVFP4 使用 E2M1 格式的 FP4 元素,采用两级微缩放:
- 张量级 FP32 缩放
- 块级 8 位 E4M3 缩放
关键技术:
- 随机 Hadamard 变换 (RHT): 应用于权重梯度计算以减少离群值影响
- 2D 缩放: 16×16 权重块缩放,减少前向/后向量化不匹配
- 随机舍入: 用于梯度以减少 FP4 转换中的舍入偏差
5.3.5 FP8/FP4 主权重:消除冗余存储
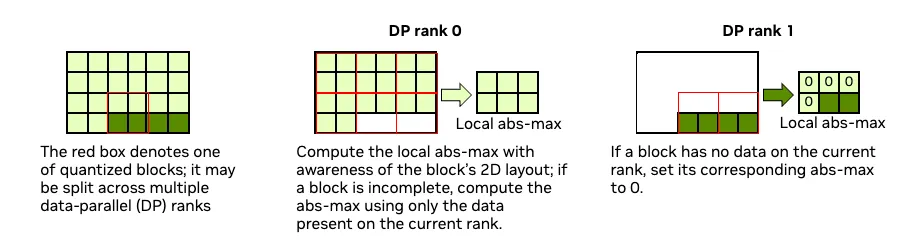
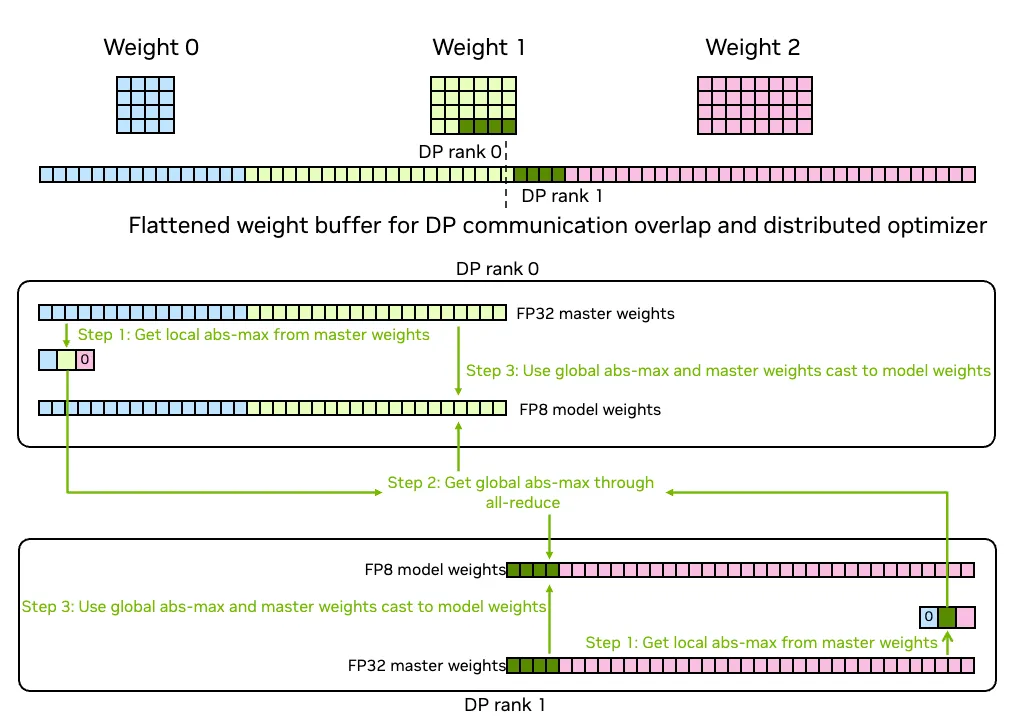
原生 FP8/FP4 通过建立从 FP32 主权重到 FP8/FP4 计算权重的直接转换路径,完全绕过 BF16 中间层,减少内存占用并加速参数 AllGather。
5.4 MoE 特定挑战
动态形状对齐
FP8 和 FP4 GEMM 要求张量维度对齐到特定倍数(per-tensor 和 blockwise 为 16,MXFP8 和 NVFP4 为 32)。解决方案:
- 路由图填充: 填充路由图而非接收的 token
- 将填充融合到排列中: 避免一次全局内存读写
分组量化
将多个张量的量化融合到单个内核中,大幅减少 CPU 开销,提高 GPU 利用率,并兼容 CUDA Graph。
六、长上下文 MoE 训练
6.1 计算转移:注意力主导
当序列长度增加到 16K-64K+ token 时,发生根本性转变:
- MLP 组件: 计算成本随序列长度线性缩放, 复杂度
- 注意力组件: SDPA 主导计算成本, 复杂度
在 64K token 时,SDPA 消耗 69% 的 FLOPs,而短序列场景中仅为 10-15%。
6.2 管理激活内存增长
上下文并行与张量并行
结合 CP 和 TP 将激活内存分布到设备上。关键原则:保持子序列长度(每 CP/TP 分片的序列长度)大致恒定,通常为 4096 或 8192。缩放 CP × TP 与序列长度使每设备内存接近基线水平。
CP vs TP 选择
- P2P CP: 通信与计算自然重叠,跨节点时更优
- TP: 减少密集参数内存,可提高 SDPA 效率,节点内更优
- 层级 CP: 节点内使用 all-to-all CP + TP,跨节点使用 P2P CP
6.3 打包序列(Packed Sequences)
打包序列支持
Megatron-LM 支持打包序列,将多个可变长度序列连接并在单个批次中处理,无需序列间填充。核心机制依赖于累积序列长度跟踪。
动态上下文并行(Dynamic-CP)
动态 CP 在每个微批次基础上自适应选择有效 CP 大小:
- 长序列接收更高 CP 度以保持内存安全
- 短序列以更低 CP 度执行以最大化算术强度并减少通信量
Dynamic-CP 在实际场景中(如多模态训练)产生 35-60% 的端到端性能提升。
七、生产特性
7.1 负载均衡与 Token 丢弃
- 辅助损失: 添加正则化项鼓励均匀路由
- 无辅助损失方法: 如 DeepSeek-V3 的无辅助损失策略
- 容量因子: 控制每个专家可处理的最大 token 数
7.2 分布式检查点
支持并行性无关的重碎片化,允许在不同并行配置间无缝恢复训练。
7.3 从密集检查点上循环(Upcycling)
支持从密集模型检查点初始化 MoE 模型,加速 MoE 训练启动。
7.4 多 Token 预测集成
支持 DeepSeek-V3 的多 Token 预测(MTP)训练目标。
7.5 流水线并行布局控制
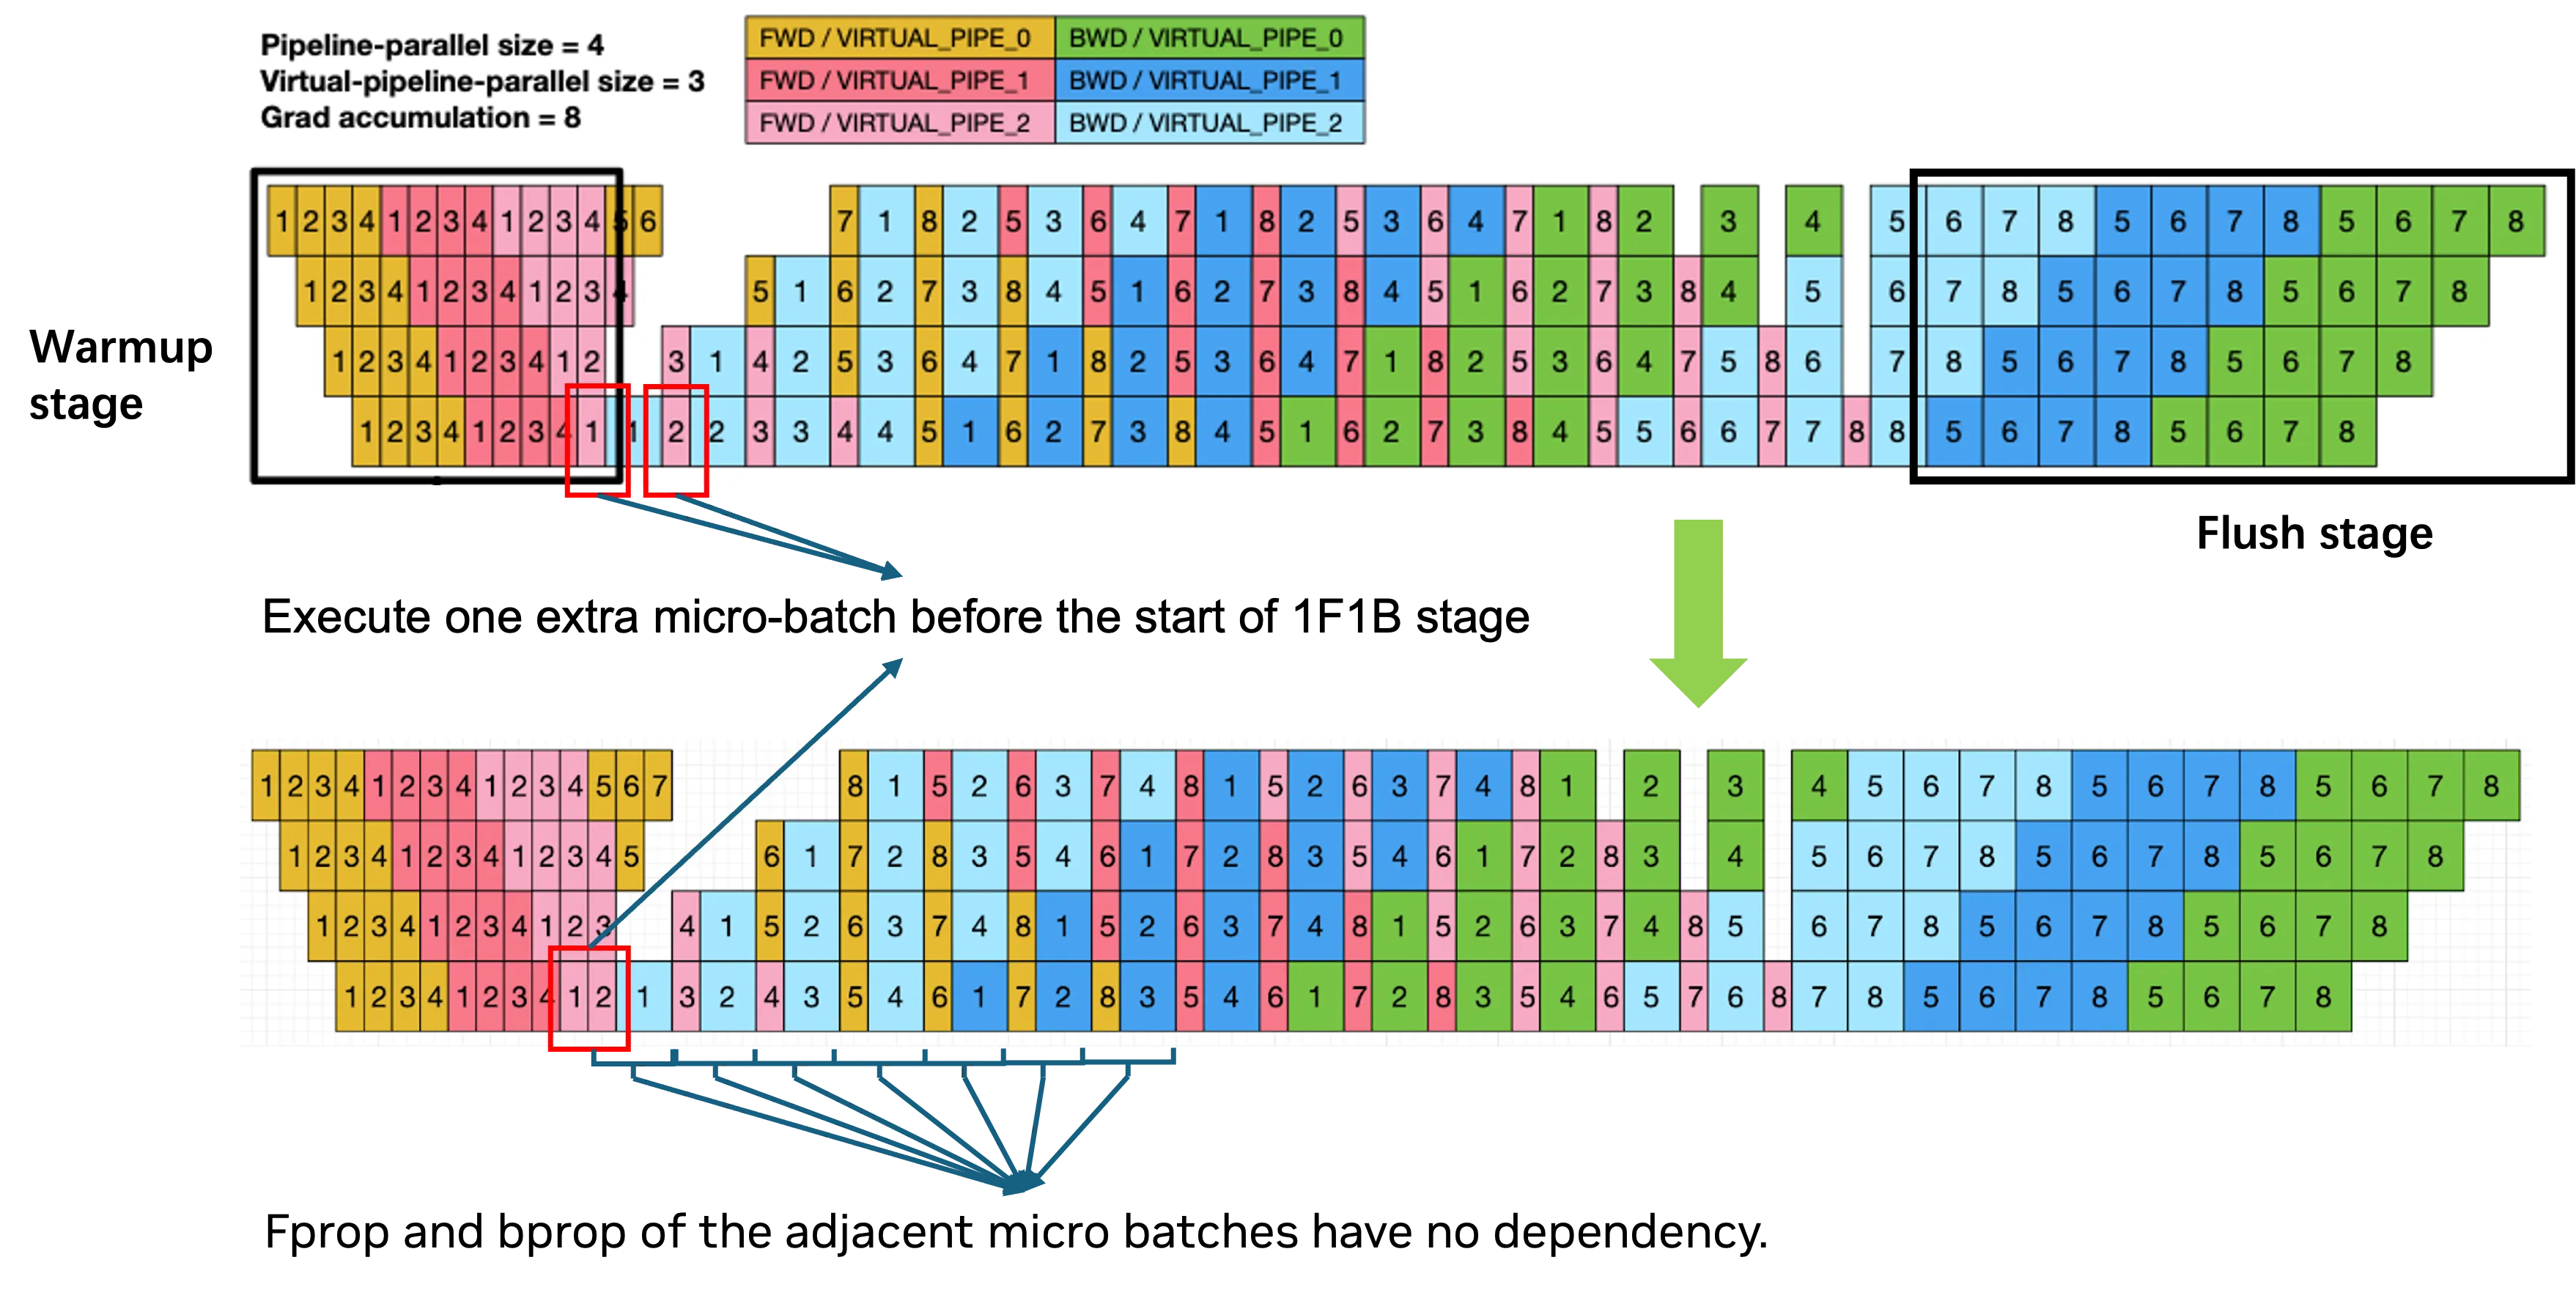
通过 --pipeline-model-parallel-layout 控制流水线并行设置。
八、实验评估
8.1 实验设置
基准模型: DeepSeek-V3-685B(256 专家)和 Qwen3-235B,两个最先进的细粒度 MoE 架构。
硬件和软件栈:
- NVIDIA GB200、GB300 和 H100 GPU
- Megatron-LM dev 分支 + 最新 TransformerEngine
- 完整优化栈:MXFP8/FP8-BLK、选择性重计算、HybridEP/DeepEP、通信重叠、Grouped GEMM、CUDA Graphs
8.2 关键性能结果
| 模型 | 系统 | GPU 数 | 序列长度 | 数据类型 | 每 GPU TF | Token/s/GPU |
|---|---|---|---|---|---|---|
| DeepSeek-V3 | GB300 | 256 | 4,096 | MXFP8 | 1,233 | 4,730 |
| DeepSeek-V3 | GB200 | 256 | 4,096 | MXFP8 | 1,048 | 4,020 |
| DeepSeek-V3 | GB200 | 256 | 4,096 | BF16 | 857 | 3,298 |
| DeepSeek-V3 | H100 | 1024 | 4,096 | FP8-BLK | 368 | 1,412 |
| Qwen3-235B | GB300 | 256 | 4,096 | MXFP8 | 974 | 6,583 |
| Qwen3-235B | GB200 | 256 | 4,096 | MXFP8 | 919 | 6,212 |
| Qwen3-235B | GB200 | 256 | 4,096 | BF16 | 750 | 5,100 |
| Qwen3-235B | H100 | 256 | 4,096 | BF16 | 320 | 2,132 |
| Qwen3-235B | GB300 | 128 | 131,072 | MXFP8 | 1,150 | 1,556 |
关键发现:
- GB200 和 GB300 平台相比 H100 提供约 3 倍更高的 token 吞吐量
- FP8 训练在 H100 上为 DeepSeek-V3 实现 368 TFLOPS/GPU
- 长上下文压力测试:Qwen3-235B 在 131,072 序列长度下仍维持 1,150 TFLOPS/GPU
九、性能最佳实践
9.1 系统化优化工作流
阶段 1:建立内存可行的并行
内存可行性是第一个约束。在优化吞吐量之前,配置必须适合 GPU 内存。
阶段 2:选择最优并行策略
准则 1: 最小化模型并行,最大化数据并行 准则 2: 保持 EP 和 TP 通信在 NVLink 域内 准则 3: 使用流水线并行(PP)进行多节点扩展 准则 4: 专家层优先使用 EP 而非 TP 准则 5: 长序列启用上下文并行(CP)
阶段 3:应用针对性优化
根据 profiling 结果,按瓶颈类型应用优化:
- 内存瓶颈 → 重计算、卸载、低精度
- 通信瓶颈 → 优化分发器、重叠
- 计算瓶颈 → Grouped GEMM、融合、CUDA Graphs
十、强化学习支持
10.1 RL 后训练挑战
- 可变长度序列: 最大可达 128K 甚至 1M token,平均仅为最大值的 1/2 到 1/4
- 内存卸载: 训练和推理引擎需要快速释放和恢复完整内存占用
- 在线权重导出: 训练后需快速导出权重供推理引擎加载
- 训练稳定性: 推理和训练引擎使用不同优化内核,产生略有不同的 token 概率
10.2 Megatron-Bridge
Megatron-Bridge 解决检查点互操作性层,实现快速 HF 到 Megatron 转换,用于初始化、训练和导出。
10.3 RL 优化
- 打包序列支持: 使用打包感知的动态批次大小,确保每批次有相似的有效 token 总数
- 动态上下文并行: 在每个微批次基础上自适应选择有效 CP 大小
- CPU 优化器卸载: 将优化器状态卸载到主机 DRAM
- FP16 训练支持: 提供完整的 FP16 路径,包括损失缩放和混合精度优化器内核
- 路由器重放: 捕获推理期间的路由决策并在后续训练阶段重放,提高收敛一致性
十一、总结与展望
核心贡献
-
多维并行和 Parallel Folding: EP 与 TP、PP、CP、DP 无缝集成。MoE Parallel Folding 解耦注意力和 MoE 层配置,打破 EP ≤ DP 约束
-
内存优化: 细粒度激活重计算、内存高效排列、精度感知优化器、CPU 激活卸载,将 DeepSeek-V3 的内存从 199.5 GB 降至 80 GB 以下
-
通信优化: 高性能 token 分发器(DeepEP、HybridEP)和通信-计算重叠,将 all-to-all 从瓶颈转变为隐藏在专家计算后的后台操作
-
计算效率: Grouped GEMM 内核、内核融合、CUDA Graphs 和同步自由执行
-
FP8 训练: 完整 FP8 支持与选择性精度,保护数值敏感组件同时积极量化批量计算
-
长上下文训练: CP 和 TP 缩放保持每设备恒定子序列长度
-
生产特性: 负载均衡策略、分布式检查点、从密集检查点上循环、多 token 预测集成
-
强化学习支持: 与流行 RL 框架无缝集成,打包序列支持、动态 CP 和路由器重放
关键性能指标
- DeepSeek-V3 (685B): 1,233/1,048 TFLOPS/GPU (GB300/GB200), 368 TFLOPS/GPU (H100)
- Qwen3-235B: 974/919 TFLOPS/GPU (GB300/GB200), 320 TFLOPS/GPU (H100)
- GB300/GB200 相比 H100 提供约 3 倍 token 吞吐量提升
意义
作为高性能、可扩展、生产就绪的开源解决方案,Megatron-Core MoE 已在学术界和工业界用于训练从数十亿到数万亿参数的 MoE 模型,集群规模可达数千 GPU。模块化架构支持快速原型设计,同时完整优化栈支持从研究原型到万亿参数生产模型的训练。
附录:关键符号表
| 符号 | 描述 |
|---|---|
| MoE | Mixture of Experts |
| EP | Expert Parallelism |
| TP | Tensor Parallelism |
| PP | Pipeline Parallelism |
| CP | Context Parallelism |
| DP | Data Parallelism |
| ETP | Expert Tensor Parallelism |
| EDP | Expert Data Parallelism |
| VPP | Virtual Pipeline Parallelism |
| 专家总数 | |
| top-k 选择的专家数 | |
| 总参数量 | |
| 每 token 激活的参数量 | |
| 路由器权重矩阵 | |
| 路由概率分布 | |
| GEMM | General Matrix Multiply |
| FSDP | Fully Sharded Data Parallel |
| SDPA | Scaled Dot-Product Attention |
| MLA | Multi-Latent Attention |
| ECHO | Expert Cloning for Heterogeneous Optimization |