KEEP: A KV-Cache-Centric Memory Management System for Efficient Embodied Planning
KV-Cache-centric memory management system for efficient embodied planning with static-dynamic memory construction, multi-hop recomputation, and layer-balanced loading
KEEP: A KV-Cache-Centric Memory Management System for Efficient Embodied Planning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | KEEP: A KV-Cache-Centric Memory Management System for Efficient Embodied Planning |
| 作者 | Zebin Yang, Tong Xie, Baotong Lu, Shaoshan Liu, Bo Yu, Meng Li |
| 机构 | Peking University (PKU-SEC-Lab) |
| 论文 | arXiv:2602.23592 |
| 代码 | GitHub: PKU-SEC-Lab/KEEP_Embodied_Memory |
| 发布 | 2026-02-27 (v1), 2026-03-17 (v2) |
| 会议 | DAC 2026 |
| 领域 | Robotics (cs.RO), Artificial Intelligence (cs.AI), Software Engineering (cs.SE) |
二、核心思想
问题定义
在具身规划(Embodied Planning)任务中,智能体需要在真实世界场景中预测一系列动作来完成长期目标。大语言模型(LLM)因其对世界知识和常识的广泛编码,为实现这种高级规划能力提供了有前景的路径。
然而,现有的记忆增强方法面临一个关键挑战:记忆管理效率低下。
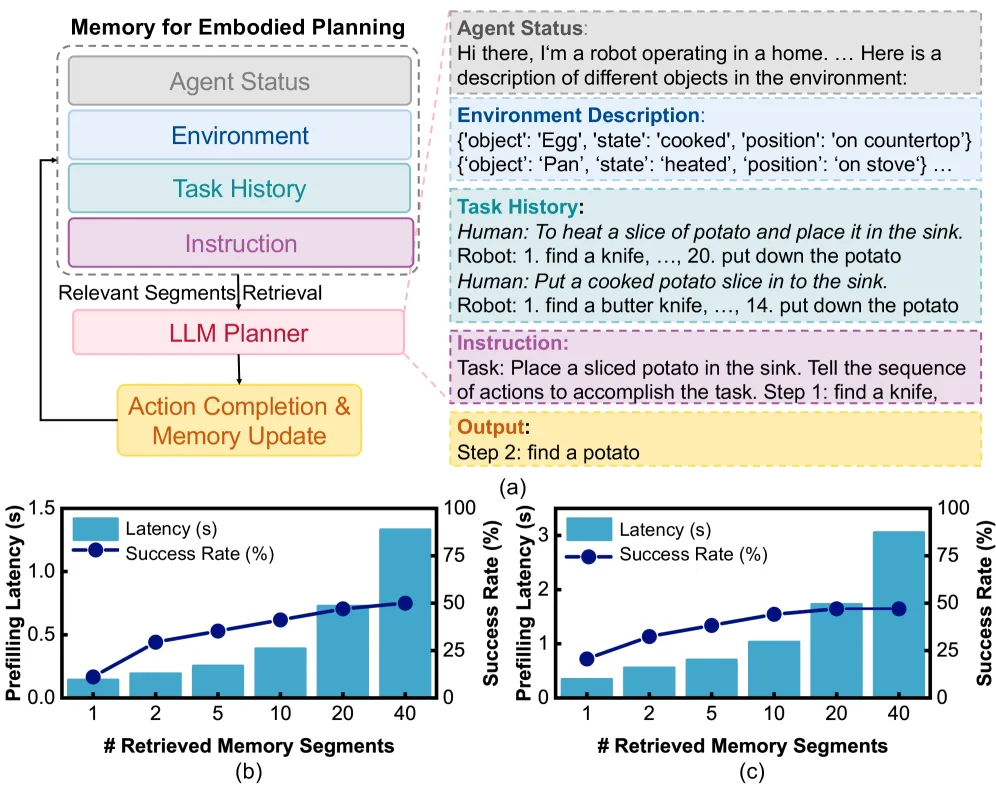
Figure 1: (a) LLM具身规划示例。每一步,由检索到的记忆和指令组成的提示被输入到LLM规划器。随着检索到的记忆段数量增加,(b) Qwen-14B和(c) Qwen-32B (INT4)在ALFRED数据集上的成功率和预填充延迟都随之增加。
核心问题:
- 文本记忆的低效性:现有方法通常将记忆存储为原始文本,导致提示过长和高预填充延迟
- KV缓存失效:虽然可以存储和复用KV缓存,但由于记忆频繁更新,缓存失效问题严重削弱了效率收益
- 粒度与精度的权衡:固定大小的块划分无法适应具身场景中细粒度、快速更新的记忆特性
解决方案概述
本文提出KEEP,一个以KV缓存为中心的记忆管理系统,包含三个关键创新:
- 静态-动态记忆构建算法(Static-Dynamic Memory Construction):通过混合粒度记忆组减少KV缓存重计算
- 多跳记忆重计算算法(Multi-hop Memory Re-computation):动态识别不同记忆组间的重要交叉注意力,并迭代重建记忆交互
- 层平衡记忆加载(Layer-balanced Memory Loading):消除不同层间不平衡的KV缓存加载和交叉注意力计算
三、技术架构
整体框架图
KEEP系统采用分层存储策略,将KV缓存存储在高容量内存(如CPU RAM)中,仅在每次推理时将相关记忆段的KV对加载到GPU。
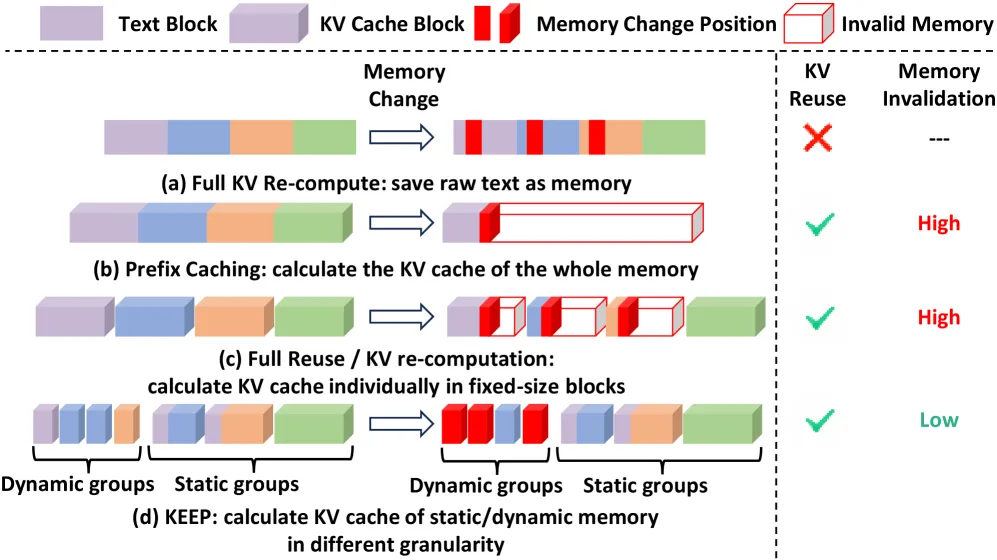
Figure 2: 与先前KV复用方法在记忆构建方面的对比。
核心公式与算法
3.1 静态-动态记忆构建
核心思想:根据记忆的更新频率进行分组管理
- 静态组(Static Group):如果一个组的所有记忆段在最近 步内保持不变,则该组被分类为静态
- KV缓存计算:组内段之间进行全交叉注意力计算,保留丰富的上下文关系
- 动态组(Dynamic Group):如果组内任何记忆在最近 步内被更新,则标记为动态
- KV缓存计算:按单个段独立计算,防止单次更新使整个组的缓存失效
状态转换:
- 静态组 → 动态组:当任何成员被更新时
- 动态组 → 静态组:当保持稳定 步时
实践参数:(典型任务长度)
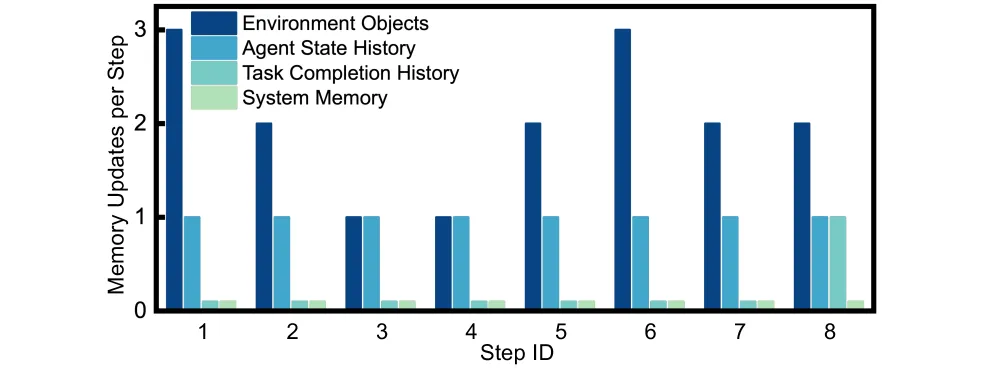
Figure 5: 不同记忆显示不同的更新频率。这里使用粗粒度记忆分类作为示例。
3.2 多跳记忆重计算
动机:在具身规划中,单个记忆段的重要性往往取决于查询和记忆上下文。例如,记忆段 {“object”:“key”, “position”:“on the table”} 对于任务”unlock the door”至关重要,但对于任务”find the door”仅略微相关。
重要性传播算法:
在获得第 层的注意力分数后:
-
初始化(Initialization):查询与所有待评估记忆之间的平均注意力分数作为记忆的初始重要性分数
-
重要性传播(Importance Propagation):
- 根据当前重要性分数选择前 比例的记忆作为相关集
- 通过平均当前相关记忆集的交叉注意力权重更新所有记忆的重要性分数
- 这一步有效地允许重要记忆将其重要性”传播”给对它们至关重要的其他记忆
-
收敛检查(Convergence Check):重复重要性传播步骤,直到相关记忆集的组成在迭代间稳定
-
选择性重计算(Selective Recomputation):在第 层,仅重计算最终稳定相关集中记忆的KV缓存
重计算比例:遵循CacheBlend,在第一层重计算所有记忆,并逐渐减少后续层的重计算比例 ,最终维持较低的平均重计算比例 。
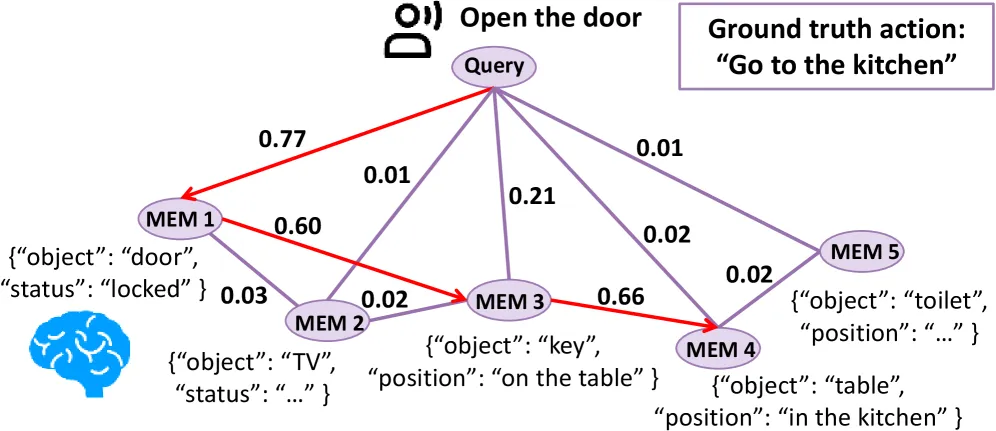
Figure 6: 记忆重要性评估以多跳方式工作。展示了五个记忆段的重要性传播示例。记忆连接上方的数字是两个记忆段之间的归一化交叉注意力分数。红色箭头显示以多跳方式找到重要记忆。
系统优势:
- 在记忆段粒度而非token粒度评估重要性和进行重计算
- 仅加载不需要重计算的连续KV块,减少I/O开销
- 传播过程可与同层的MLP并行计算,不引入显著延迟
3.3 层平衡记忆加载
问题发现:当与重计算机制结合时,各层工作负载高度不平衡:
- 早期层:重计算比例较高,KV数据加载量较少
- 后期层:重计算比例较低,需要加载大量KV缓存
这导致流水线中出现气泡(pipeline bubbles)。
关键观察:对于任何给定的记忆段,如果它在较早层未被重计算,则在后续任何层都不会被重计算。因为对应的记忆在未重计算决策后,其输入隐藏状态被丢弃,无法在后续层生成新的KV缓存。
解决方案:主动管理KV加载流水线
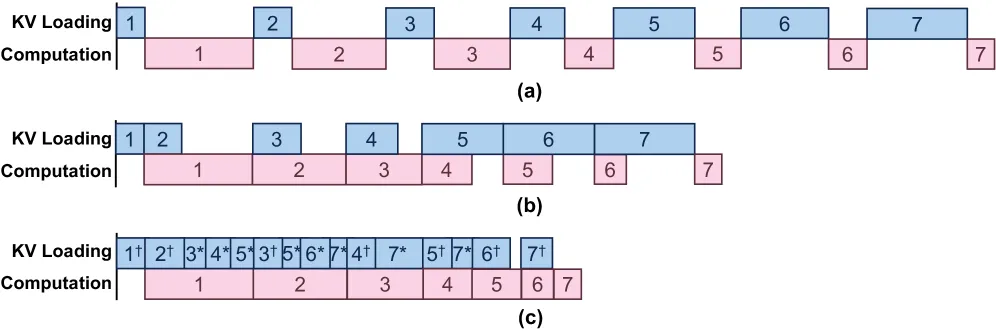
Figure 8: (a) 分离的KV加载和计算,(b) 当前层计算与下一层KV加载并行,(c) 层平衡记忆加载的流水线对比。使用7层模型作为示例。
- 在早期层,如果下一层的KV加载在当前层计算完成前完成,空闲的加载引擎立即开始预加载未来层保证不被重计算的记忆KV缓存
- 预加载持续到当前层计算完成
- 这种跨层、主动的预加载机制有效地将后期层的加载开销重新分配到未充分利用的早期层
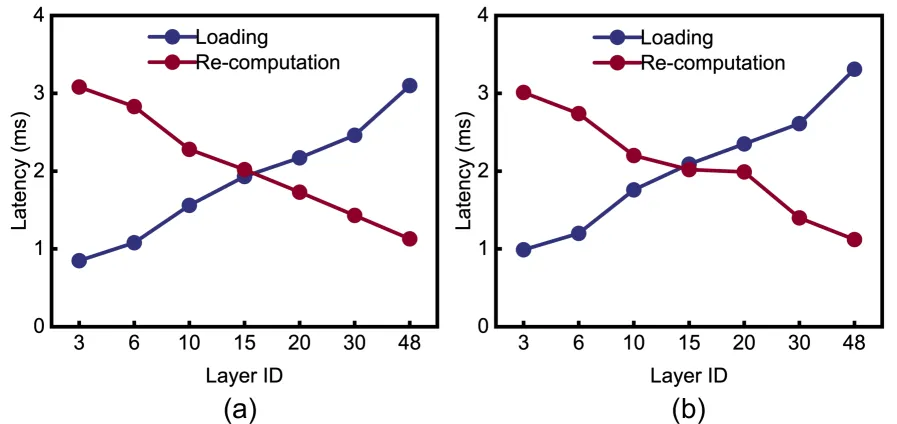
Figure 7: (a) Qwen-14B和(b) Qwen-32B (INT4)不同层的不平衡KV加载和计算开销。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 句子编码器 | 将记忆聚类为语义组 | sentence-transformers-mpnet-base-v2 |
| 记忆分组器 | 根据更新频率分类静态/动态组 | 步阈值 |
| 重要性评估器 | 多跳重要性传播 | 逐层递减的重计算比例 |
| KV加载管理器 | 层平衡流水线调度 | 3线程并行 |
训练流程与实现
实现基础:基于vLLM,使用PyTorch v2.0,约2.8K行Python代码
三个核心接口:
load_memory(memory_id, layer_id) -> KV Cache:加载指定层的KV缓存prefill_layer(input, layer_id, KV cache) -> output, updated KV cache:重计算重要记忆的KVimportance_evaluation(layer_id, memory_ids, attention) -> memory_ids:使用注意力分数识别重要记忆
存储策略:使用哈希表记录每个记忆的存储位置。如果所需记忆不在GPU中,使用torch.cuda()从CPU RAM加载。
流水线设计:使用三个线程流水线化:
- 第 层的计算(
prefill_layer) - 第 层的记忆重要性评估(
importance_evaluation) - 第 层及未来层不重计算记忆的KV缓存加载(
load_memory)
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 静态-动态记忆构建 | 根据更新频率分组管理,静态组保留全交叉注意力,动态组独立计算 | 消除此项导致SR下降6.94%,TTFT增加1.54x |
| 多跳记忆重计算 | 基于查询和上下文动态识别重要记忆,通过重要性传播迭代发现关键交互 | 消除此项导致SR下降2.52% |
| 层平衡记忆加载 | 跨层预加载不重计算的KV缓存,消除流水线气泡 | 消除此项导致TTFT增加1.20x |
关键发现
- 记忆更新频率差异:环境对象状态更新频率高,已完成任务记录变化少
- 固定粒度的局限性:现有KV复用方法使用固定大小块,在具身场景中要么重计算开销大,要么规划精度下降
- 动态重要性:记忆重要性高度依赖查询和上下文,静态重计算机制无法适应
- 层间不平衡:KV重计算导致各层工作负载差异大,标准流水线无法完全摊销加载开销
五、实验结果
实验设置
- 数据集:ALFRED、WAH-NL
- 模型:Qwen-2.5系列(14B、32B INT4量化)
- 评估指标:成功率(SR)、子目标成功率(Sub-SR)、首token时间(TTFT)
- 硬件:单块NVIDIA A6000 GPU
基准测试 - ALFRED数据集
| 方法 | 模型 | SR | TTFT |
|---|---|---|---|
| LLM-Planner | GPT-3 | 16.45% | - |
| FLARE | GPT-4 | 40.05% | - |
| KARMA | GPT-4o | 43.00% | - |
| LoTA (Full Recompute) | Qwen-2.5-14B | 44.63% | 0.410s |
| LoTA + Full Reuse | Qwen-2.5-14B | 34.41% | 0.210s |
| LoTA + CacheBlend | Qwen-2.5-14B | 39.36% | 0.363s |
| LoTA + KEEP | Qwen-2.5-14B | 44.30% | 0.236s |
| LoTA (Full Recompute) | Qwen-2.5-32B (INT4) | 45.81% | 1.213s |
| LoTA + Full Reuse | Qwen-2.5-32B (INT4) | 35.72% | 0.602s |
| LoTA + CacheBlend | Qwen-2.5-32B (INT4) | 41.37% | 1.209s |
| LoTA + KEEP | Qwen-2.5-32B (INT4) | 45.50% | 0.635s |
关键结果:
- 与文本记忆方法相比,KEEP实现2.68x加速,精度损失可忽略
- 与CacheBlend相比,KEEP在14B模型上SR提升4.94%,TTFT减少1.54x
- 与CacheBlend相比,KEEP在32B模型上SR提升4.13%,TTFT减少1.90x
基准测试 - WAH-NL数据集
| 方法 | 模型 | Sub-SR | TTFT |
|---|---|---|---|
| LoTA (Full Recompute) | Qwen-2.5-14B | 19.58% | 0.362s |
| LoTA + Full Reuse | Qwen-2.5-14B | 9.08% | 0.203s |
| LoTA + CacheBlend | Qwen-2.5-14B | 16.21% | 0.341s |
| LoTA + KEEP | Qwen-2.5-14B | 19.52% | 0.226s |
| LoTA (Full Recompute) | Qwen-2.5-32B (INT4) | 20.48% | 1.221s |
| LoTA + Full Reuse | Qwen-2.5-32B (INT4) | 12.74% | 0.578s |
| LoTA + CacheBlend | Qwen-2.5-32B (INT4) | 16.88% | 1.148s |
| LoTA + KEEP | Qwen-2.5-32B (INT4) | 20.25% | 0.601s |
WAH-NL结果:与CacheBlend相比,KEEP在14B和32B模型上分别实现3.31%和3.37%的Sub-SR提升,以及1.51x和1.91x的TTFT减少。
消融实验
| 方法 | SR | TTFT |
|---|---|---|
| KEEP (完整) | 44.30% | 0.230s |
| w/o 静态-动态记忆构建 | 37.36% | 0.355s |
| w/o 多跳记忆重计算 | 41.78% | 0.228s |
| w/o 层平衡记忆加载 | 44.30% | 0.273s |
消融分析:
- 静态-动态记忆构建:移除导致6.94%的SR下降(因忽略静态记忆段间的交叉注意力)和1.54x的TTFT增加(因固定大小块引入高KV失效)
- 多跳记忆重计算:移除导致2.52%的SR下降(因重要记忆间的交叉注意力无法完全恢复)
- 层平衡记忆加载:移除导致1.20x的TTFT增加(因早期层的加载气泡和后期层的计算气泡)
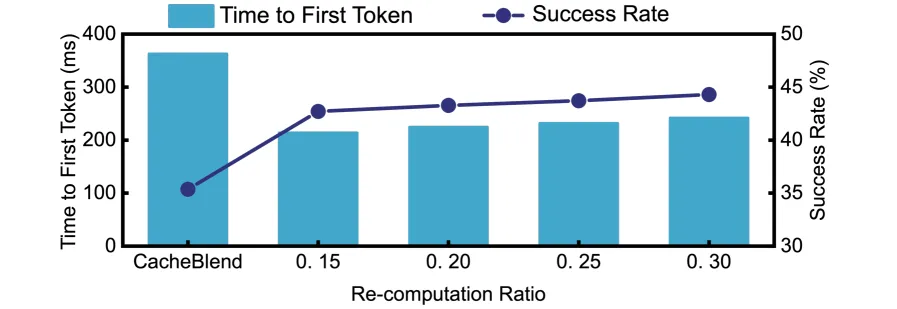
Figure 10: 不同重计算比例的消融研究。KEEP在不同重计算比例下表现稳健。
延迟扩展性分析
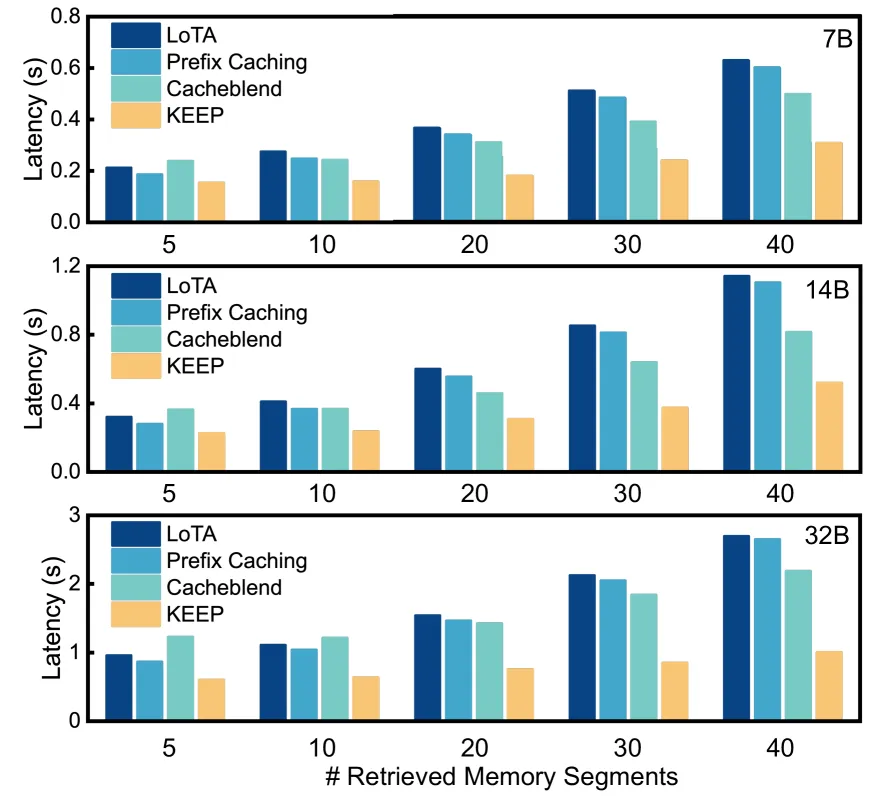
Figure 9: 不同检索记忆段数量下的延迟对比。
- 全计算和前缀缓存的延迟随段数增加而快速增长
- CacheBlend的延迟也随记忆更新增加而增长
- KEEP的TTFT增长最慢,因为静态-动态记忆构建减少了记忆失效
- 在40个段时,KEEP相对于全重计算实现2.19x(14B)和2.68x(32B)的TTFT减少
- 相对于CacheBlend实现1.56x(14B)和2.17x(32B)的TTFT减少
六、相关工作
记忆范式分类
| 范式 | 代表方法 | 优点 | 缺点 |
|---|---|---|---|
| 参数记忆 | Retroformer | 记忆嵌入模型权重 | 训练开销大,灾难性遗忘 |
| 上下文记忆 | RoboMemory, KARMA | 直接存储文本,免训练 | 长上下文导致计算冗余 |
| 潜在记忆 | MemGen, MemAgent | 压缩为固定大小状态 | 表示能力有限,细节丢失 |
| KV中心记忆(KEEP) | KEEP | 免训练,保持记忆完整性 | 需要高效的缓存管理 |
KV复用方法
- 前缀缓存(Prefix Caching):仅复用LLM输入相同前缀的KV缓存,保证输出质量但要求精确匹配
- 全KV复用(Full KV Reuse):将长上下文分割为固定长度块并单独计算KV状态,实现更灵活的复用
- KV重计算方法(KV Recomputation):识别少量重要token并选择性重计算其KV缓存,如CacheBlend、EPIC
具身规划基准
- ALFRED:家庭环境中的具身任务规划基准
- WAH-NL:自然语言指令的具身规划基准
- LoTA:语言导向任务规划器基准
七、总结
核心贡献
-
系统性分析:详细分析了具身规划与传统LLM推理在记忆构建和管理方面的根本差异
-
三大技术创新:
- 静态-动态记忆构建:最小化KV缓存失效
- 多跳记忆重计算:保持记忆间连接
- 层平衡加载调度器:优化硬件利用率
-
显著性能提升:
- 相比文本记忆方法实现2.68x加速
- 相比CacheBlend实现4.13% SR提升和1.90x TTFT减少
技术影响
- 具身AI效率:为具身智能体的实时规划提供了高效的内存管理方案
- KV缓存优化:为动态更新场景下的KV缓存管理提供了新思路
- 系统-算法协同设计:展示了算法创新与系统优化结合的重要性
局限性
- 当前实现基于特定模型架构(Qwen系列),泛化性有待验证
- 记忆聚类依赖句子编码器,可能引入额外延迟
- 在更复杂的具身场景(如多智能体协作)中的表现有待探索
未来方向
- 探索更高效的记忆压缩和检索策略
- 扩展到多模态具身智能体
- 优化跨设备分布式部署
八、参考资源
- 论文: arXiv:2602.23592
- 代码: GitHub: PKU-SEC-Lab/KEEP_Embodied_Memory
- 会议: DAC 2026
关键技术参考
- CacheBlend: Fast Large Language Model Serving for RAG with Cached Knowledge Fusion (EuroSys’25)
- LoTA-Bench: Benchmarking Language-Oriented Task Planners for Embodied Agents
- Prompt Cache: Modular Attention Reuse for Low-Latency Inference
- vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention