Efficient Scaling of LLM Training with Flexible Context Parallelism
FCP:面向异构长上下文数据的自适应上下文并行策略,支持非2幂并行度、毫秒级调度开销,训练吞吐提升1.46倍
Efficient Scaling of LLM Training with Flexible Context Parallelism
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Efficient Scaling of LLM Training with Flexible Context Parallelism |
| 作者 | Yifan Niu, Han Xiao, Dongyi Liu, Wei Zhou, Jia Li |
| 论文 | arXiv:2602.21788 |
| HTML | arXiv:2602.21788v2 HTML |
| 发布 | v1: 2026-02-25,v2: 2026-06-08 |
| 主题 | cs.DC(Distributed, Parallel, and Cluster Computing);cs.LG |
| DOI | 10.48550/arXiv.2602.21788 |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
大语言模型(LLM)在扩展到超长上下文时面临自注意力机制 O(L²) 的二次复杂度瓶颈。现实数据(文本与多模态视频)序列长度呈严重长尾分布:绝大多数样本较短,少数样本几倍于均值。现有静态并行策略(Megatron-LM 4D 并行、DeepSpeed-Ulysses)在这种异构数据下存在三大问题:
- 负载不均衡:处理超长序列的 rank 成为 straggler,其他 rank 空转
- 冗余通信:为短序列分配过高并行度导致通信开销浪费
- 硬件利用率低:静态分区无法适应 batch 内序列长度差异
现有动态并行工作 ByteScale(启发式贪心)与 FlexSP(每 batch 求解 5-15 秒的整数规划)也各有不足:FlexSP 基于 DeepSpeed-Ulysses,并行度受限于 2 的幂,压缩了可行解空间。
解决方案概述
作者提出 Flexible Context Parallelism (FCP),一种自适应的上下文并行调度框架,同时满足三个核心要求:
- Workload Balance:跨 CP 组的计算负载均衡,最小化同步等待
- Elastic Parallelism Degree:支持任意正整数并行度(非仅 2 的幂)
- Minimal Scheduling Overhead:毫秒级调度延迟,可与计算完全重叠
核心创新:
- 将 CP 组数、每组并行度、序列到组的映射三者联合优化
- 松弛并行度约束至任意正整数(借助 Ring-Attention 摆脱注意力头数整除约束)
- 两阶段多项式时间近似算法:Best-Fit Decreasing 打包 + 2D 动态规划分配
- CPU 端异步调度:调度下一 batch 时 NPU 计算当前 batch,隐藏调度延迟
三、技术架构
整体框架图
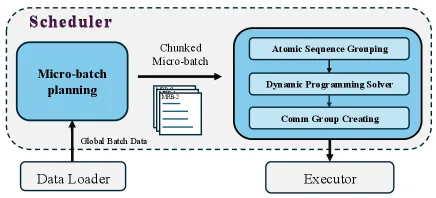
Figure 2: FCP 的整体工作流:Micro-batch Planner → Scheduler(BFD + 2D-DP)→ Executor 动态重配 CP 通信组
数据异构性观察
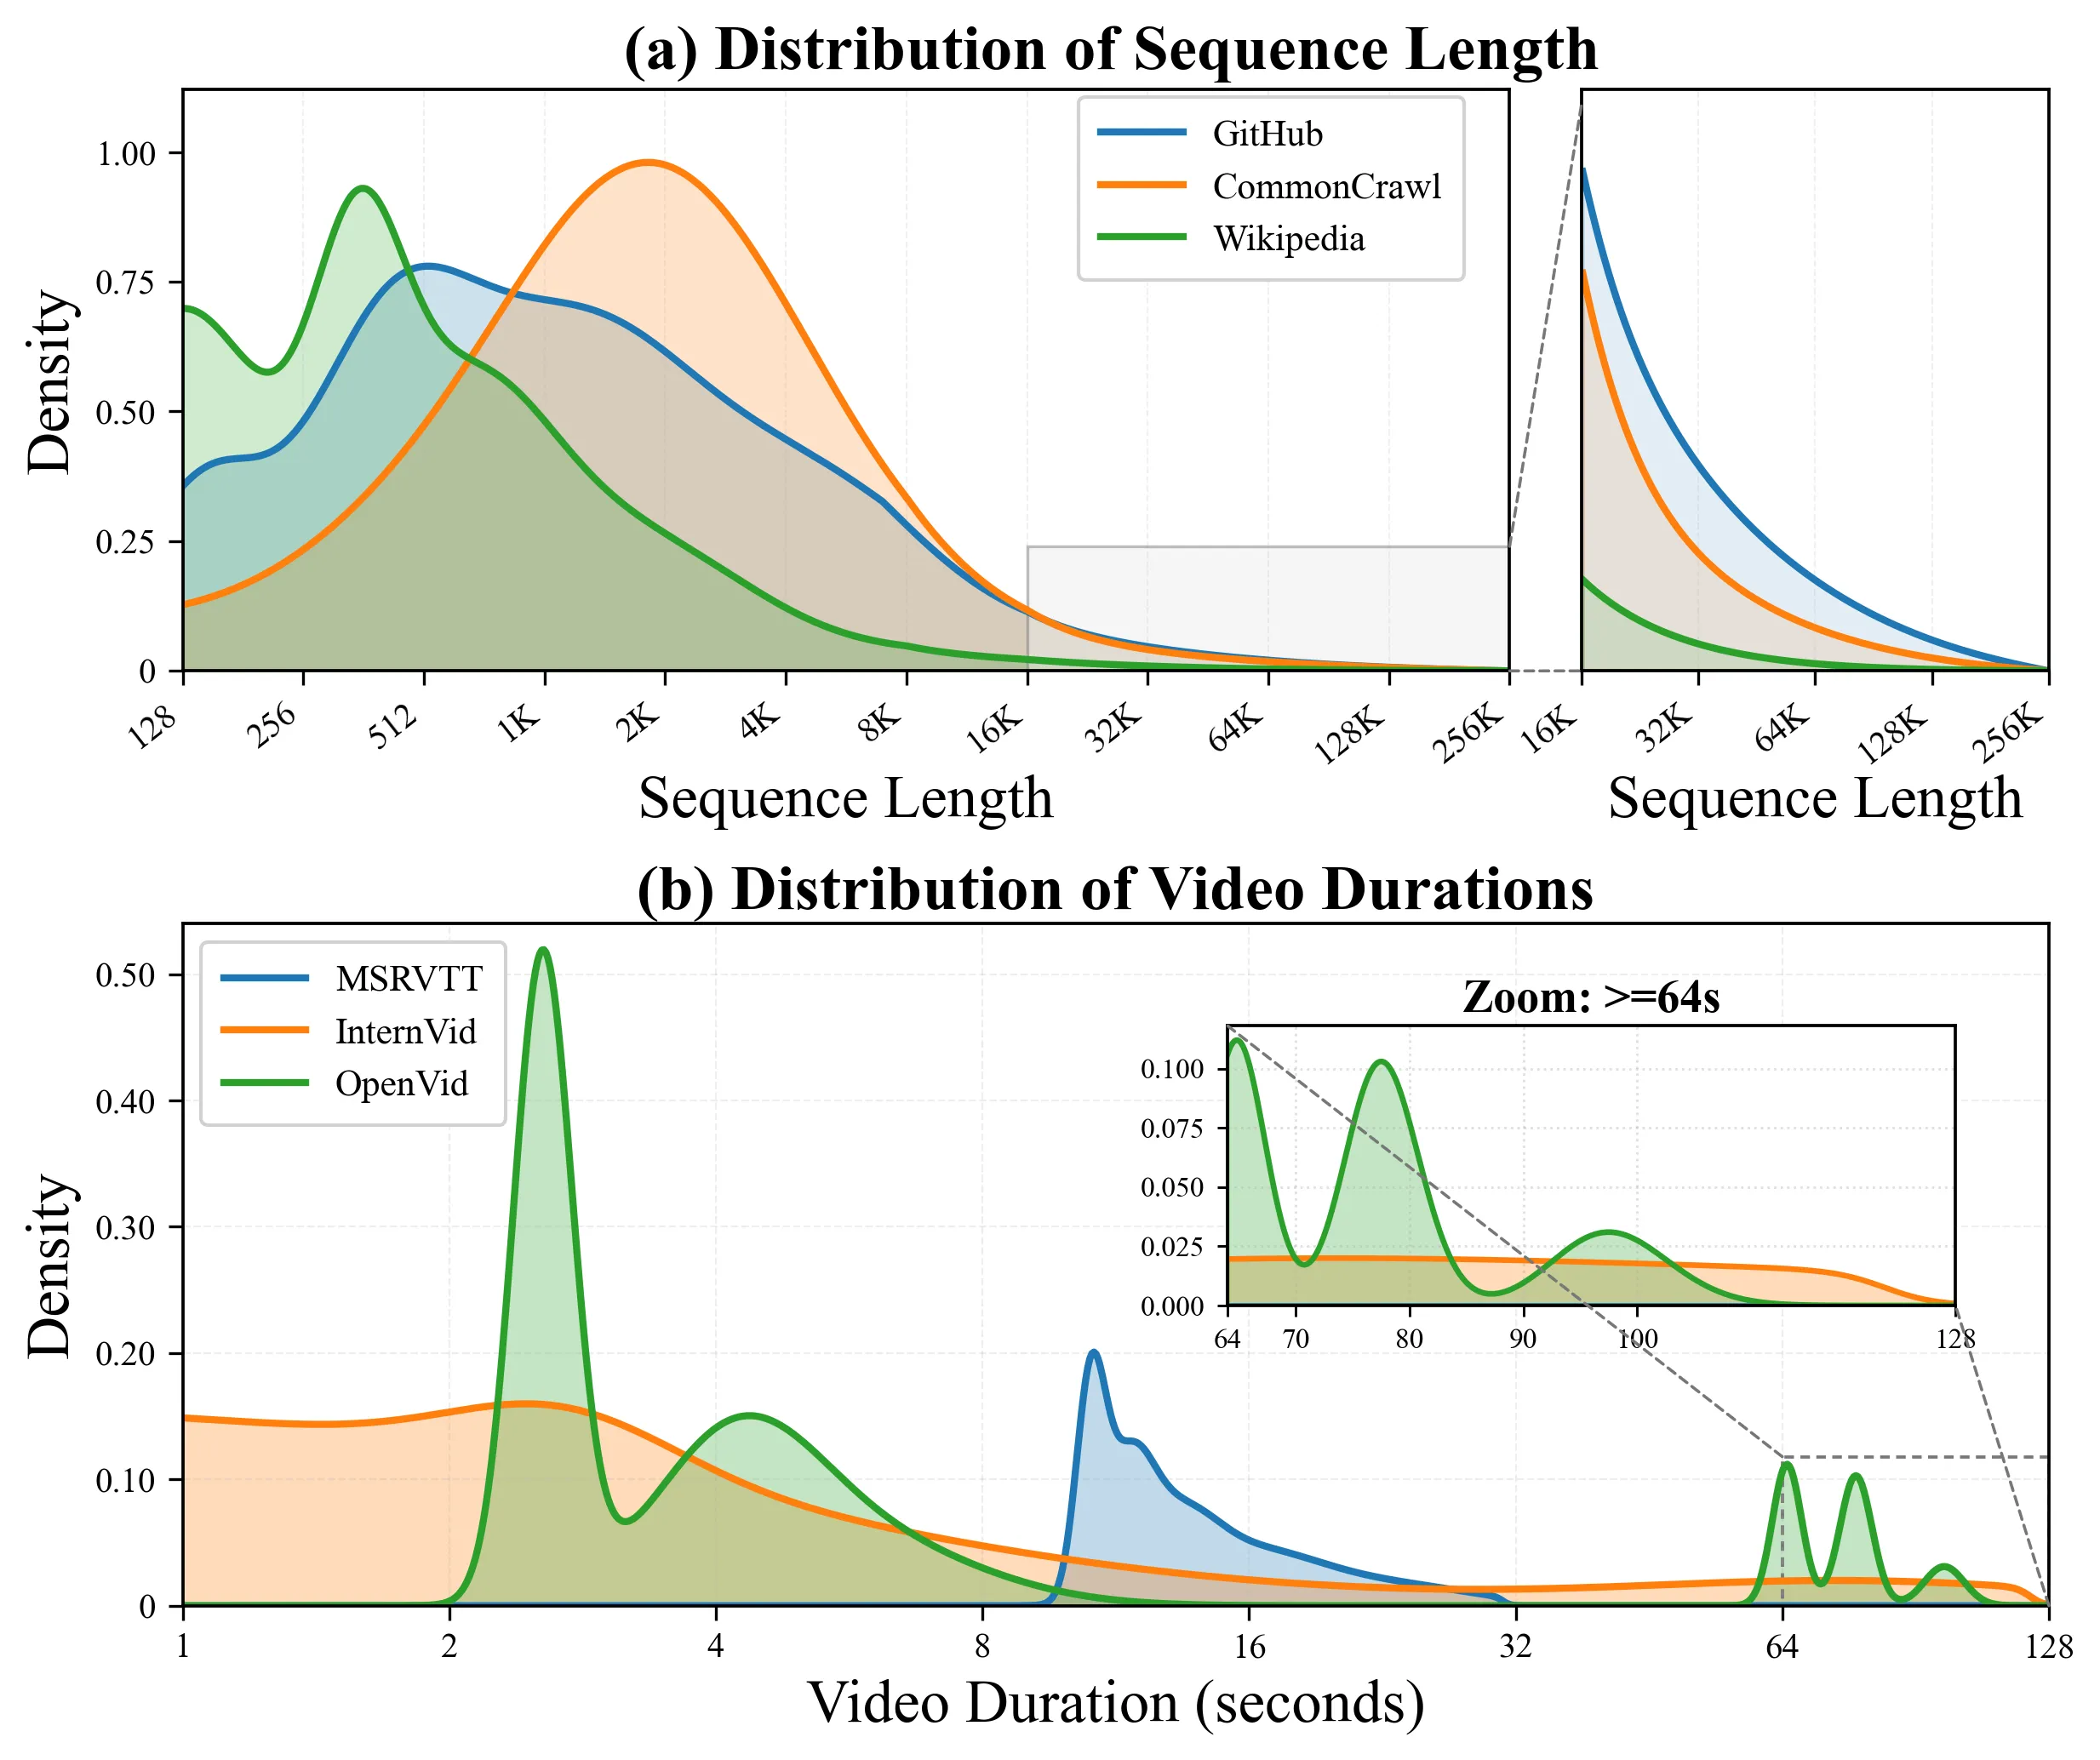
Figure 1(a): 文本(GitHub、CommonCrawl、Wikipedia)与多模态(MSRVTT、InternVid、OpenVid)数据集的长度分布,均呈显著长尾
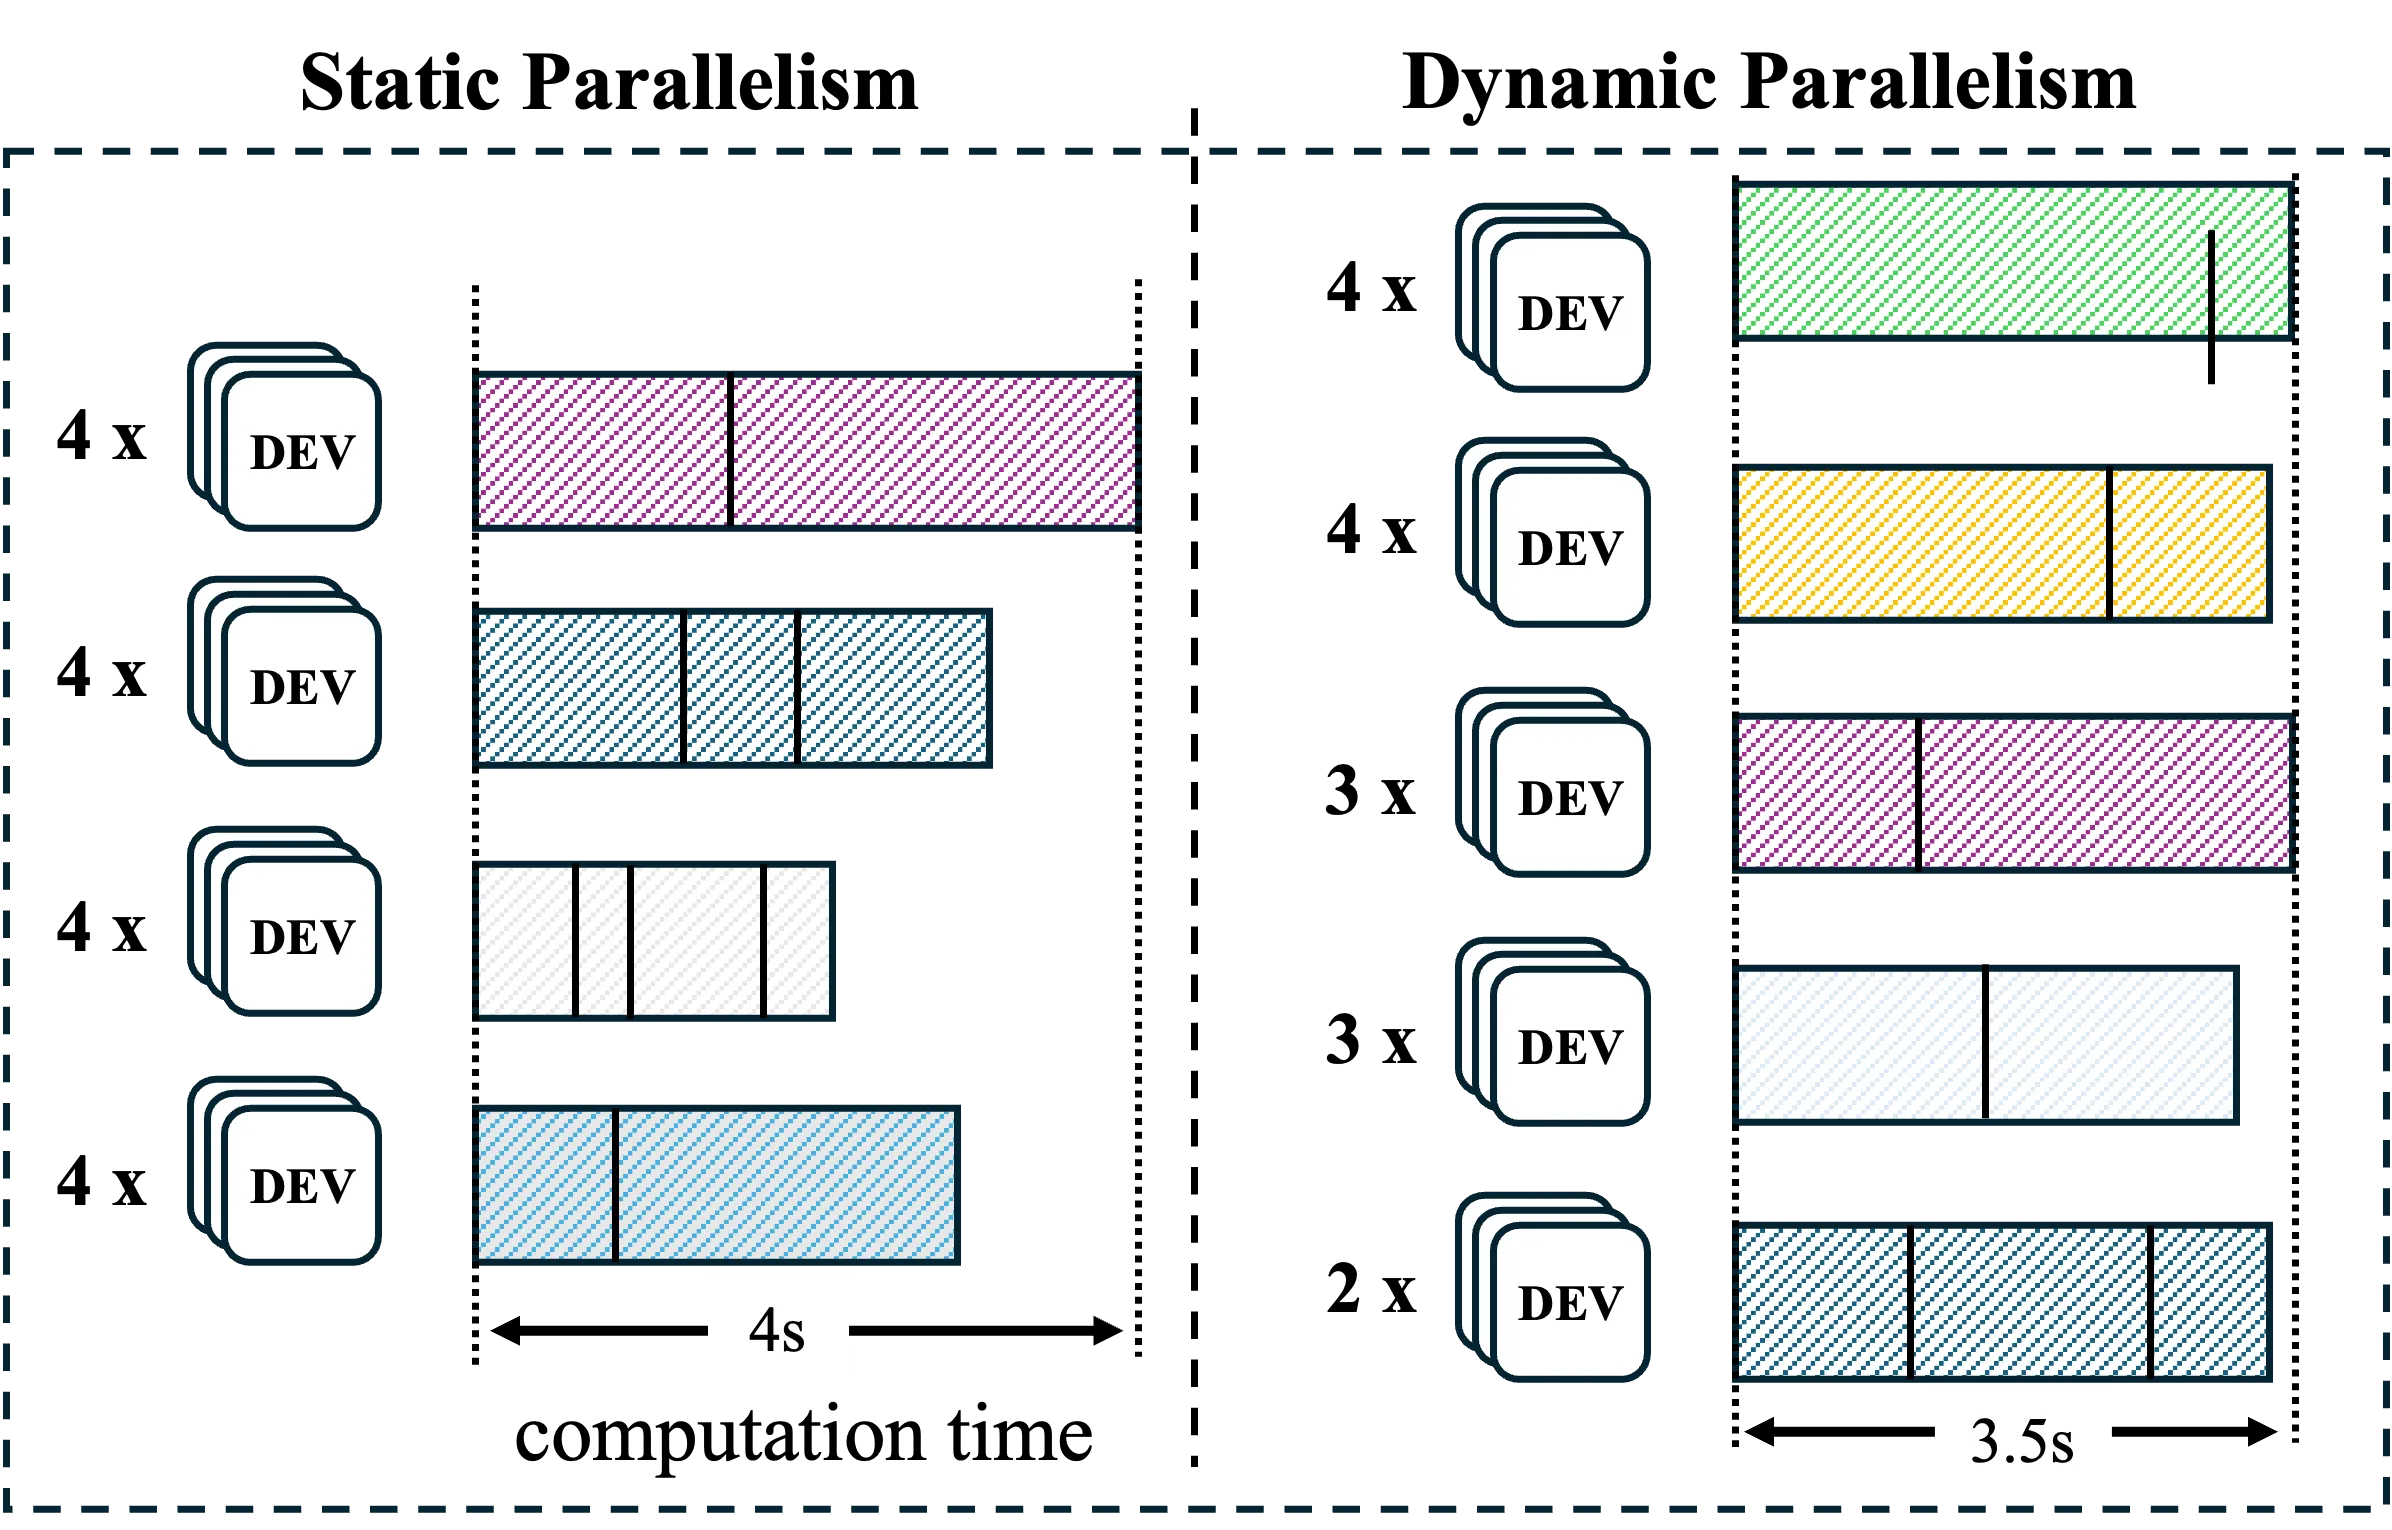
Figure 1(b): 静态并行下长序列 rank 成为 straggler;动态并行按需分配并行度,缓解负载不均
系统组件
┌──────────────────────────────────────────────────────────────┐
│                    FCP 系统架构                                │
├──────────────────────────────────────────────────────────────┤
│  Global Batch                                                │
│       ↓                                                      │
│  Micro-batch Planner  (拆分为多个 micro-batch B)              │
│       ↓                                                      │
│  ┌────────────────────────────────────────────┐              │
│  │  Scheduler (CPU 异步)                       │              │
│  │  ┌─────────────────────────────────────┐   │              │
│  │  │ Stage 1: BFD 序列打包                 │   │              │
│  │  │  K 条异构序列 → K' 个 atomic group    │   │              │
│  │  └─────────────────────────────────────┘   │              │
│  │  ┌─────────────────────────────────────┐   │              │
│  │  │ Stage 2: 2D-DP 资源分配              │   │              │
│  │  │  确定 P、{d_p}、赋值矩阵 A           │   │              │
│  │  └─────────────────────────────────────┘   │              │
│  └────────────────────────────────────────────┘              │
│       ↓                                                      │
│  Profiler(离线拟合,训练时预测代价)                          │
│       ↓                                                      │
│  Executor:更新 Megatron MPU 的 CP 通信组,分发数据            │
└──────────────────────────────────────────────────────────────┘
关键实现细节
- Decoupling Scheduling and Training:CPU 在当前 batch 计算的同时求解下一 batch 的最优策略,隐藏调度延迟
- Profiler Integration:训练前离线采集不同序列长度与 CP 度组合的执行时间,拟合成本模型系数
- Integration with Megatron Parallel Utilities:仅动态更新 MPU 中的 CP 通信组,TP/PP/DP 保持静态;实现为 add-on 模块,不修改 Megatron 核心代码
四、方法细节
4.1 前置约定
- 排除 TP/PP 动态重配(权重重排代价过高),仅动态构建 CP 组,DP 隐含在 CP 分组之中
- 一个 “rank” r_n 表示一个完整模型副本(TP × PP 物理设备),集群共 N 个副本
- 采用 Ring-Attention 风格 CP:环形 P2P 交换 KV 块,通信与计算可重叠
4.2 问题形式化
给定 micro-batch 中 K 条异构长度序列 {s_k}、每 rank 显存预算 E,求:
- CP 组数 P
- 每组并行度 d_p(任意正整数)
- 赋值矩阵 A ∈ {0,1}^{K×P}
优化目标:最小化 makespan(各 CP 组执行时间的最大值):
约束:
即:每组显存不超限;每条序列被分配到且仅分配到一个 CP 组;总并行度不超过集群规模 N。该问题为 NP-hard。
相较 FlexSP(要求 d_p 为 2 的幂并只支持 SP),本工作松弛到任意正整数并行度,可行空间显著扩大。
4.3 代价估计
显存估计:
其中 M_ms 为常数模型状态显存,M_token 为每 token 激活显存(CP 沿序列维等分为 d_p 份)。
计算代价(统一涵盖 causal / full attention,通过 mask 效率因子 η_k):
- η_k = 0 对应标准 causal attention;对 full attention 反映额外计算开销
- α_1、α_2、β_1 通过 Profiler 离线拟合
通信代价(Ring-Attention P2P KV 交换):
v_p 为 CP 组内 P2P 带宽。
总执行时间(Ring-Attention 的注意力计算与通信可重叠,减去二者中的较小者):
4.4 多项式时间求解
Stage 1:BFD 原子序列分组
按序列显存需求降序排列,对每条长序列计算其最小 CP 度:
以 d_{min,k’}·E 作为一个”bin”容量,采用 Best-Fit Decreasing(BFD)将短序列贪心装入长序列的剩余显存 headroom 内,把 K 条序列压缩为 K’ ≤ K 个 atomic group {G_1, …, G_{K’}},每组作为独立调度单元。这样既减少决策变量数,又避免因大量打包短序列导致的冗余通信。
Stage 2:2D-DP 资源分配
令 DP[i][j] 为前 i 个 atomic group 使用 j 个 rank 的最小 makespan:
其中 保证给前 i-1 组预留足够的 rank。
- 内层 max:识别当前组 G_i 与已分配的前 i-1 组之间的执行瓶颈
- 外层 min:在合法 CP 度 d 中搜索最小 makespan
- 反向回溯:从 DP[K’][N] 出发得到最优赋值矩阵 A 与并行度序列 {d_p}
- 总时间复杂度:O(K’·N²),实测毫秒级;可用 CPU 与当前 batch 计算完全重叠
Algorithm 1(Appendix B):2D-Dynamic Programming
输入: Groups G, 最小并行度 {d_{min,k'}}, 总 rank 数 N
输出: CP 并行度序列 {d_p}

1  初始化 K' ← |G|, DP[K'+1][N+1], Path[K'+1][N+1]
2  DP[0][0] ← 0
3  for k = 1 to K' do
4      R_remain ← Σ_{z=k+1}^{K'} d_{min,z}
5      for j = (Σ_{i=1}^k d_{min,i}) to (N - R_remain) do
6          for d = d_{min,k} to (j - Σ_{i=1}^{k-1} d_{min,i}) do
7              cost ← max(DP[k-1][j-d], T(G_k, d))
8              if cost < DP[k][j]:
9                  DP[k][j] ← cost
10                 Path[k][j] ← d
11 p ← K'+1; q ← N+1
12 while p, q > 0:
13     d_p ← Path[p][q]
14     p ← p-1; q ← q - d_p
15 return {d_1, ..., d_P}
五、实验设计
5.1 硬件与设置
| 项目 | 配置 |
|---|---|
| 集群 | 4 节点 × 16 Ascend 910C NPU / 节点(共 64 NPU) |
| 显存 | 每 NPU 64GB |
| 节点内互联 | HCCS |
| 最大序列长度 | 128k |
| Global Batch Size | 512(固定,公平对比) |
| 预热 / 记录 | 5 步 warmup + 记录后续 10 步平均 |
5.2 基线
- DeepSpeed(Ulysses 风格 SP):并行度受限于 2 的幂
- Megatron-LM:4D 并行(TP+PP+DP+CP),支持 Ring-Attention
对每个基线均调优并行超参并选最优配置;FCP 无需手动指定 CP。
5.3 数据集
文本(LLM):
- GitHub(The Stack)—— 代码,长尾突出
- CommonCrawl(C4)—— Web 大规模文本
- Wikipedia —— 密集较短
多模态(MLLM):
- MSRVTT(10K 视频 / 200K 描述)
- InternVid(10M 视频 / 生成字幕)
- OpenVid(≥512×512 高美学视频)
5.4 模型
LLM 配置(Table 7)
| Model | #Layers | #Heads | #Groups | Hidden | FFN Hidden |
|---|---|---|---|---|---|
| Qwen3-1.7B | 28 | 16 | 8 | 2048 | 6144 |
| Qwen3-4B | 36 | 32 | 8 | 2560 | 9728 |
| Qwen3-8B | 36 | 32 | 8 | 4096 | 12288 |
| Llama3.2-1B | 16 | 32 | 8 | 2048 | 8192 |
| Llama3.2-3B | 28 | 24 | 8 | 3072 | 8192 |
| Llama3-8B | 32 | 32 | 8 | 4096 | 14336 |
MLLM 配置(Table 8)
| Model | #Layers | #Heads | #Groups | Hidden | Vision Hidden |
|---|---|---|---|---|---|
| InternVL3-2B | 28 | 12 | 2 | 1536 | 1024 |
| InternVL2.5-4B | 36 | 16 | 2 | 2048 | 1024 |
| InternVL3-8B | 28 | 28 | 4 | 3584 | 1024 |
| Qwen3-VL-2B | 28 | 16 | 8 | 2048 | 1024 |
| Qwen3-VL-4B | 36 | 32 | 8 | 2560 | 1024 |
| Qwen3-VL-8B | 36 | 32 | 8 | 4096 | 1152 |
六、实验结果
6.1 文本 LLM 训练性能
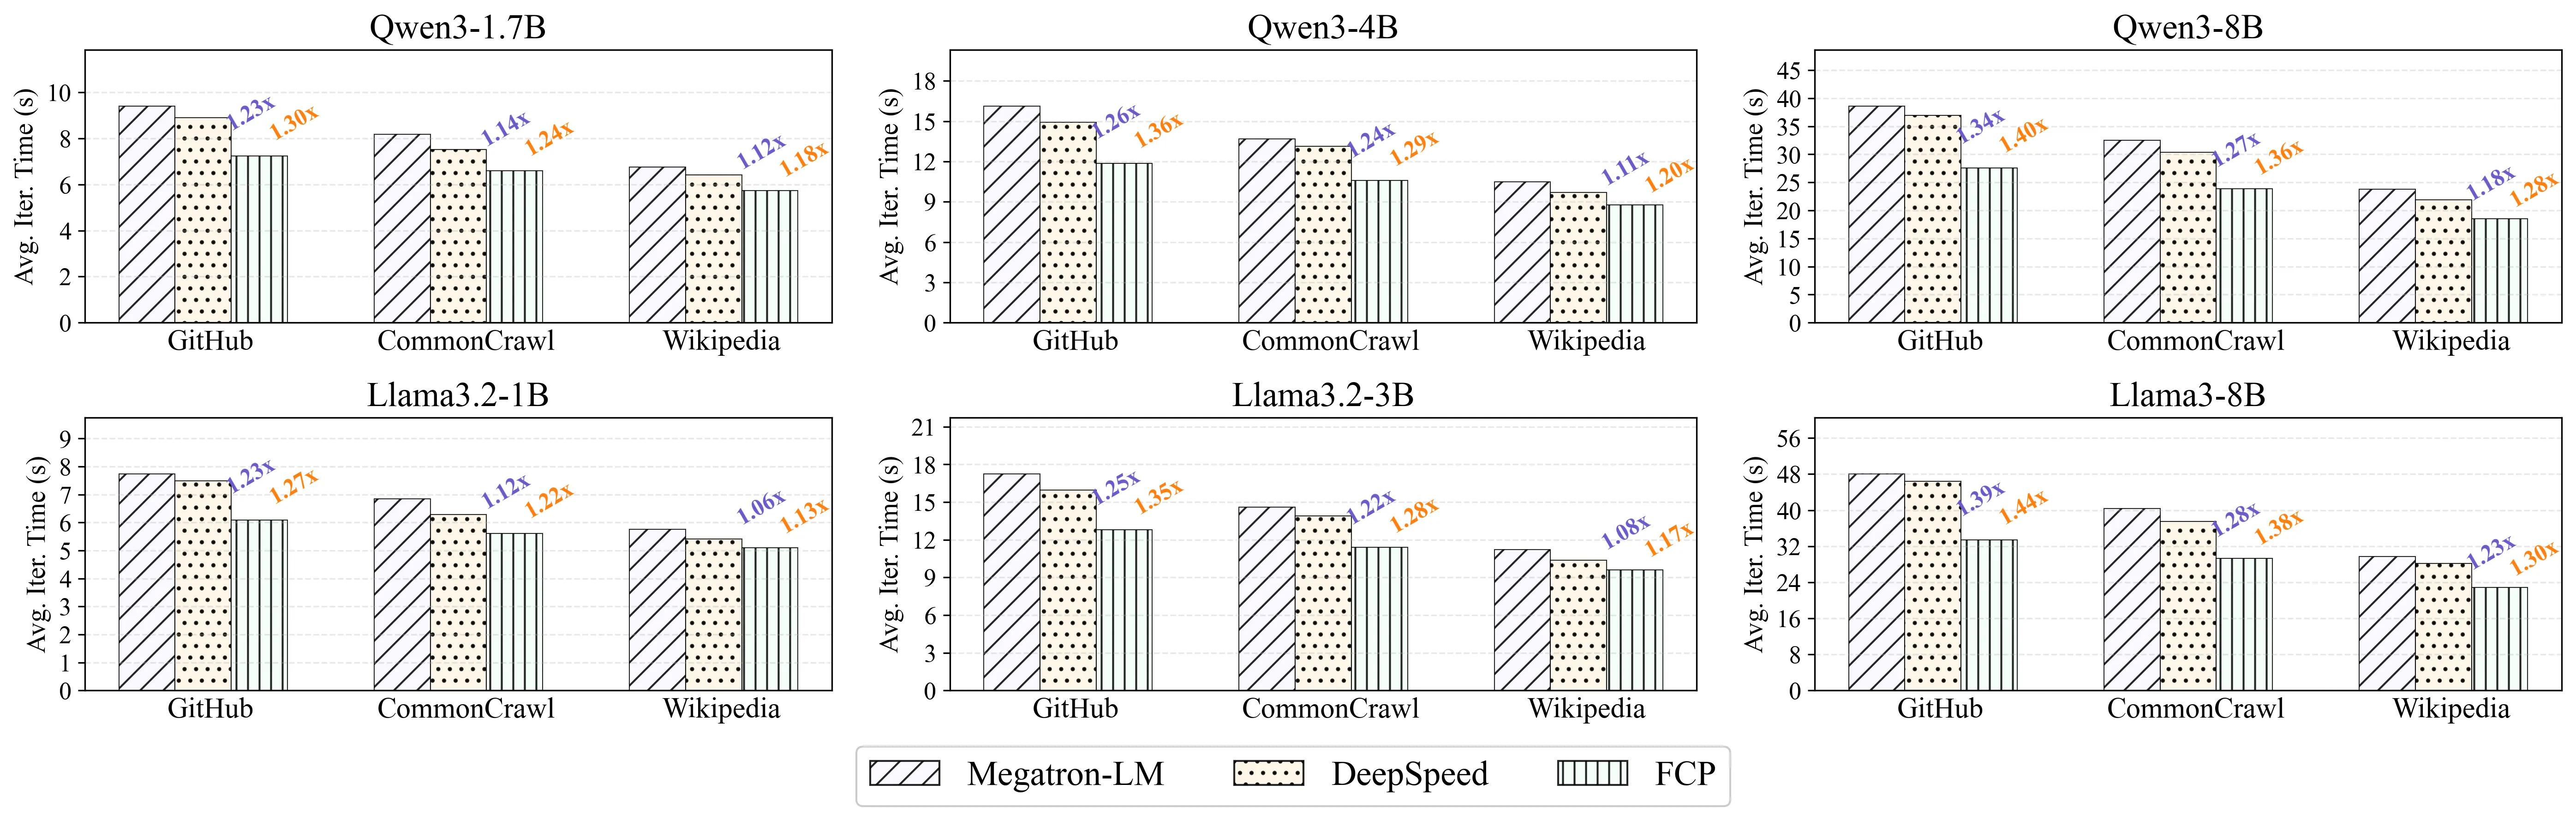
Figure 3: 在 GitHub、CommonCrawl、Wikipedia 上 Qwen3/Llama 系列(1B-8B)平均迭代时间对比
- FCP 全部 18 种配置均优于 DeepSpeed / Megatron-LM
- 加速比范围:1.05× (Llama3.2-1B / Wikipedia) → 1.37× (Qwen3-8B / GitHub)
- 长尾语料收益最明显:GitHub 上 Qwen3-8B 与 Llama3-8B 分别 1.37× 与 1.36×
- CommonCrawl 上 Qwen3-8B 1.30×,Llama3-8B 1.29×
- 8 / 18 配置加速 > 1.2×,长尾越显著、模型越大,收益越高
6.2 未冻结 MLLM 训练性能
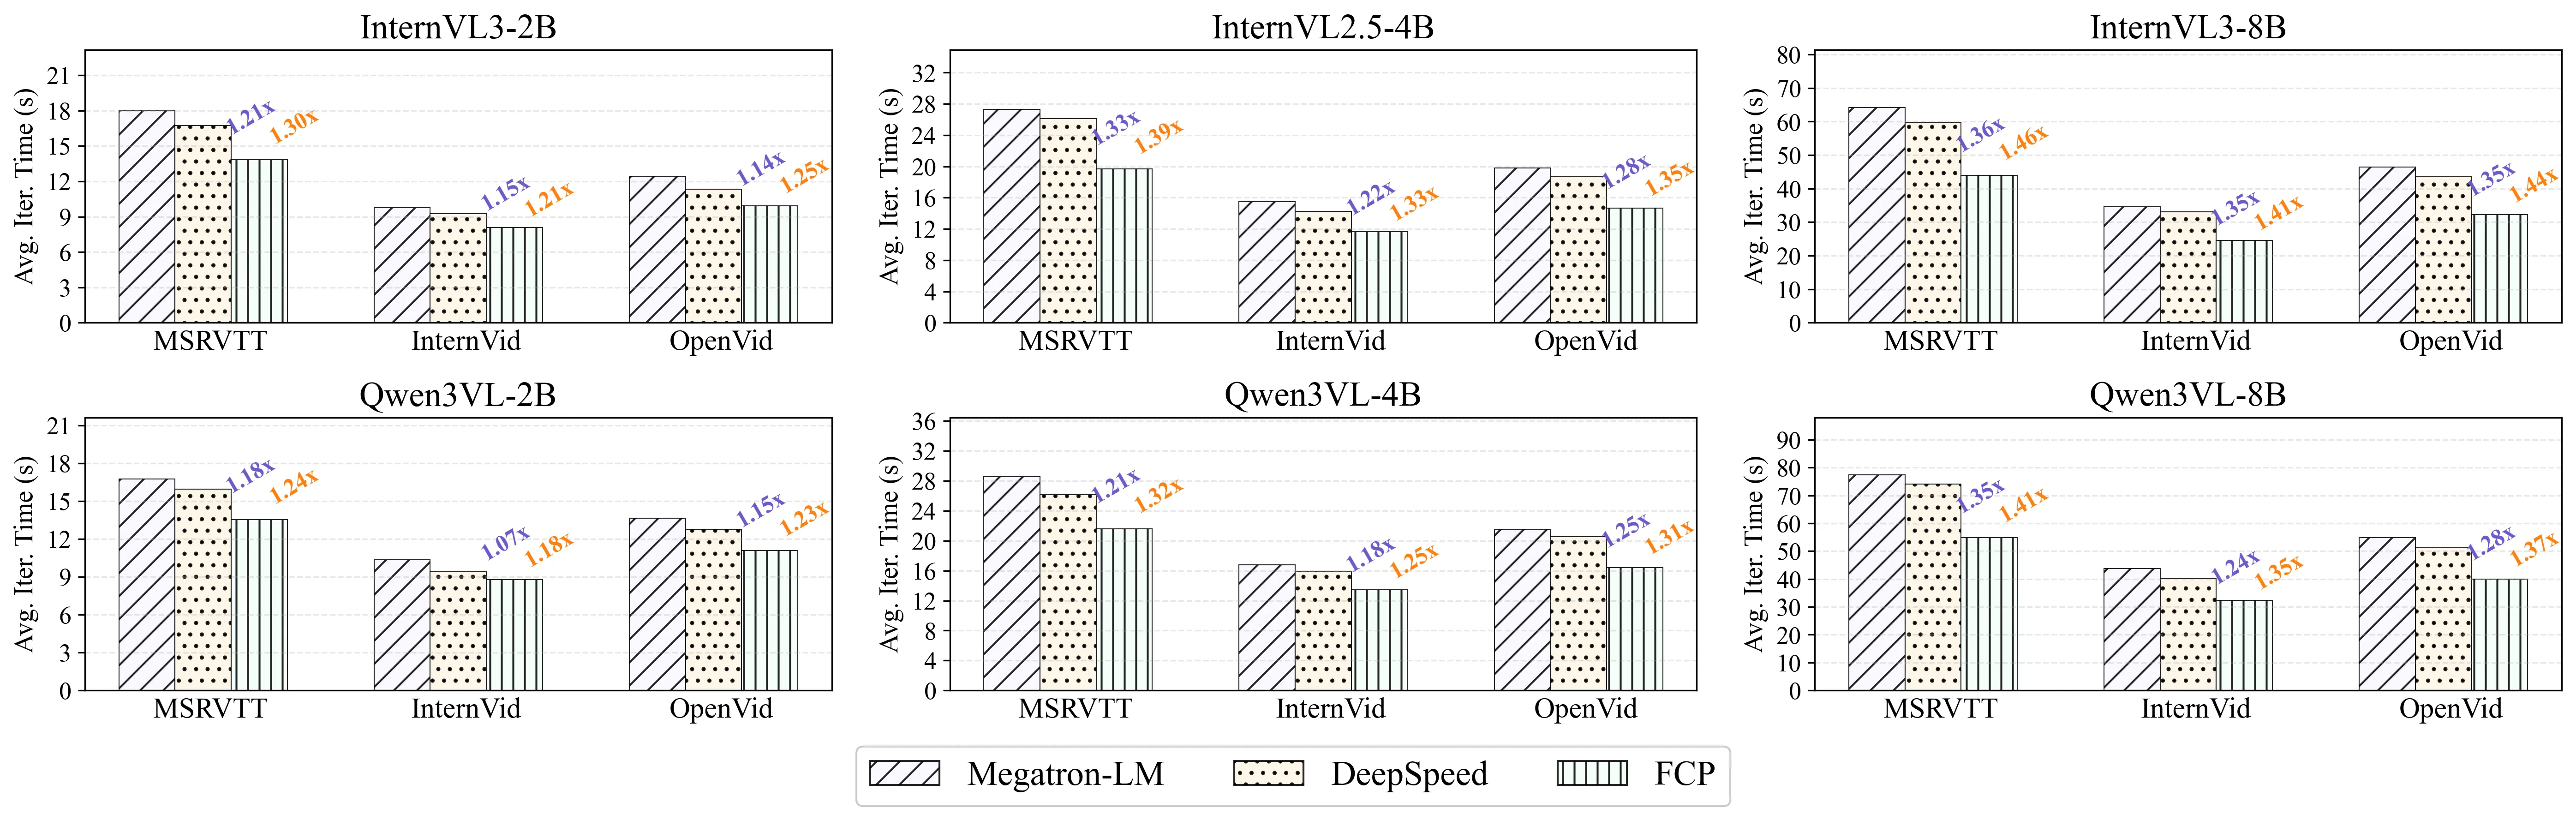
Figure 4: 未冻结 MLLM(vision encoder + projector + LLM 联合训练)迭代时间对比
- 加速比范围:1.14× (InternVL3-2B / InternVid) → 1.38× (InternVL3-8B / MSRVTT)
- 8B 模型强收益:Qwen3VL-8B on MSRVTT 1.37×,on OpenVid 1.34×
- 15 / 18 配置加速 > 1.2×
6.3 可扩展性分析
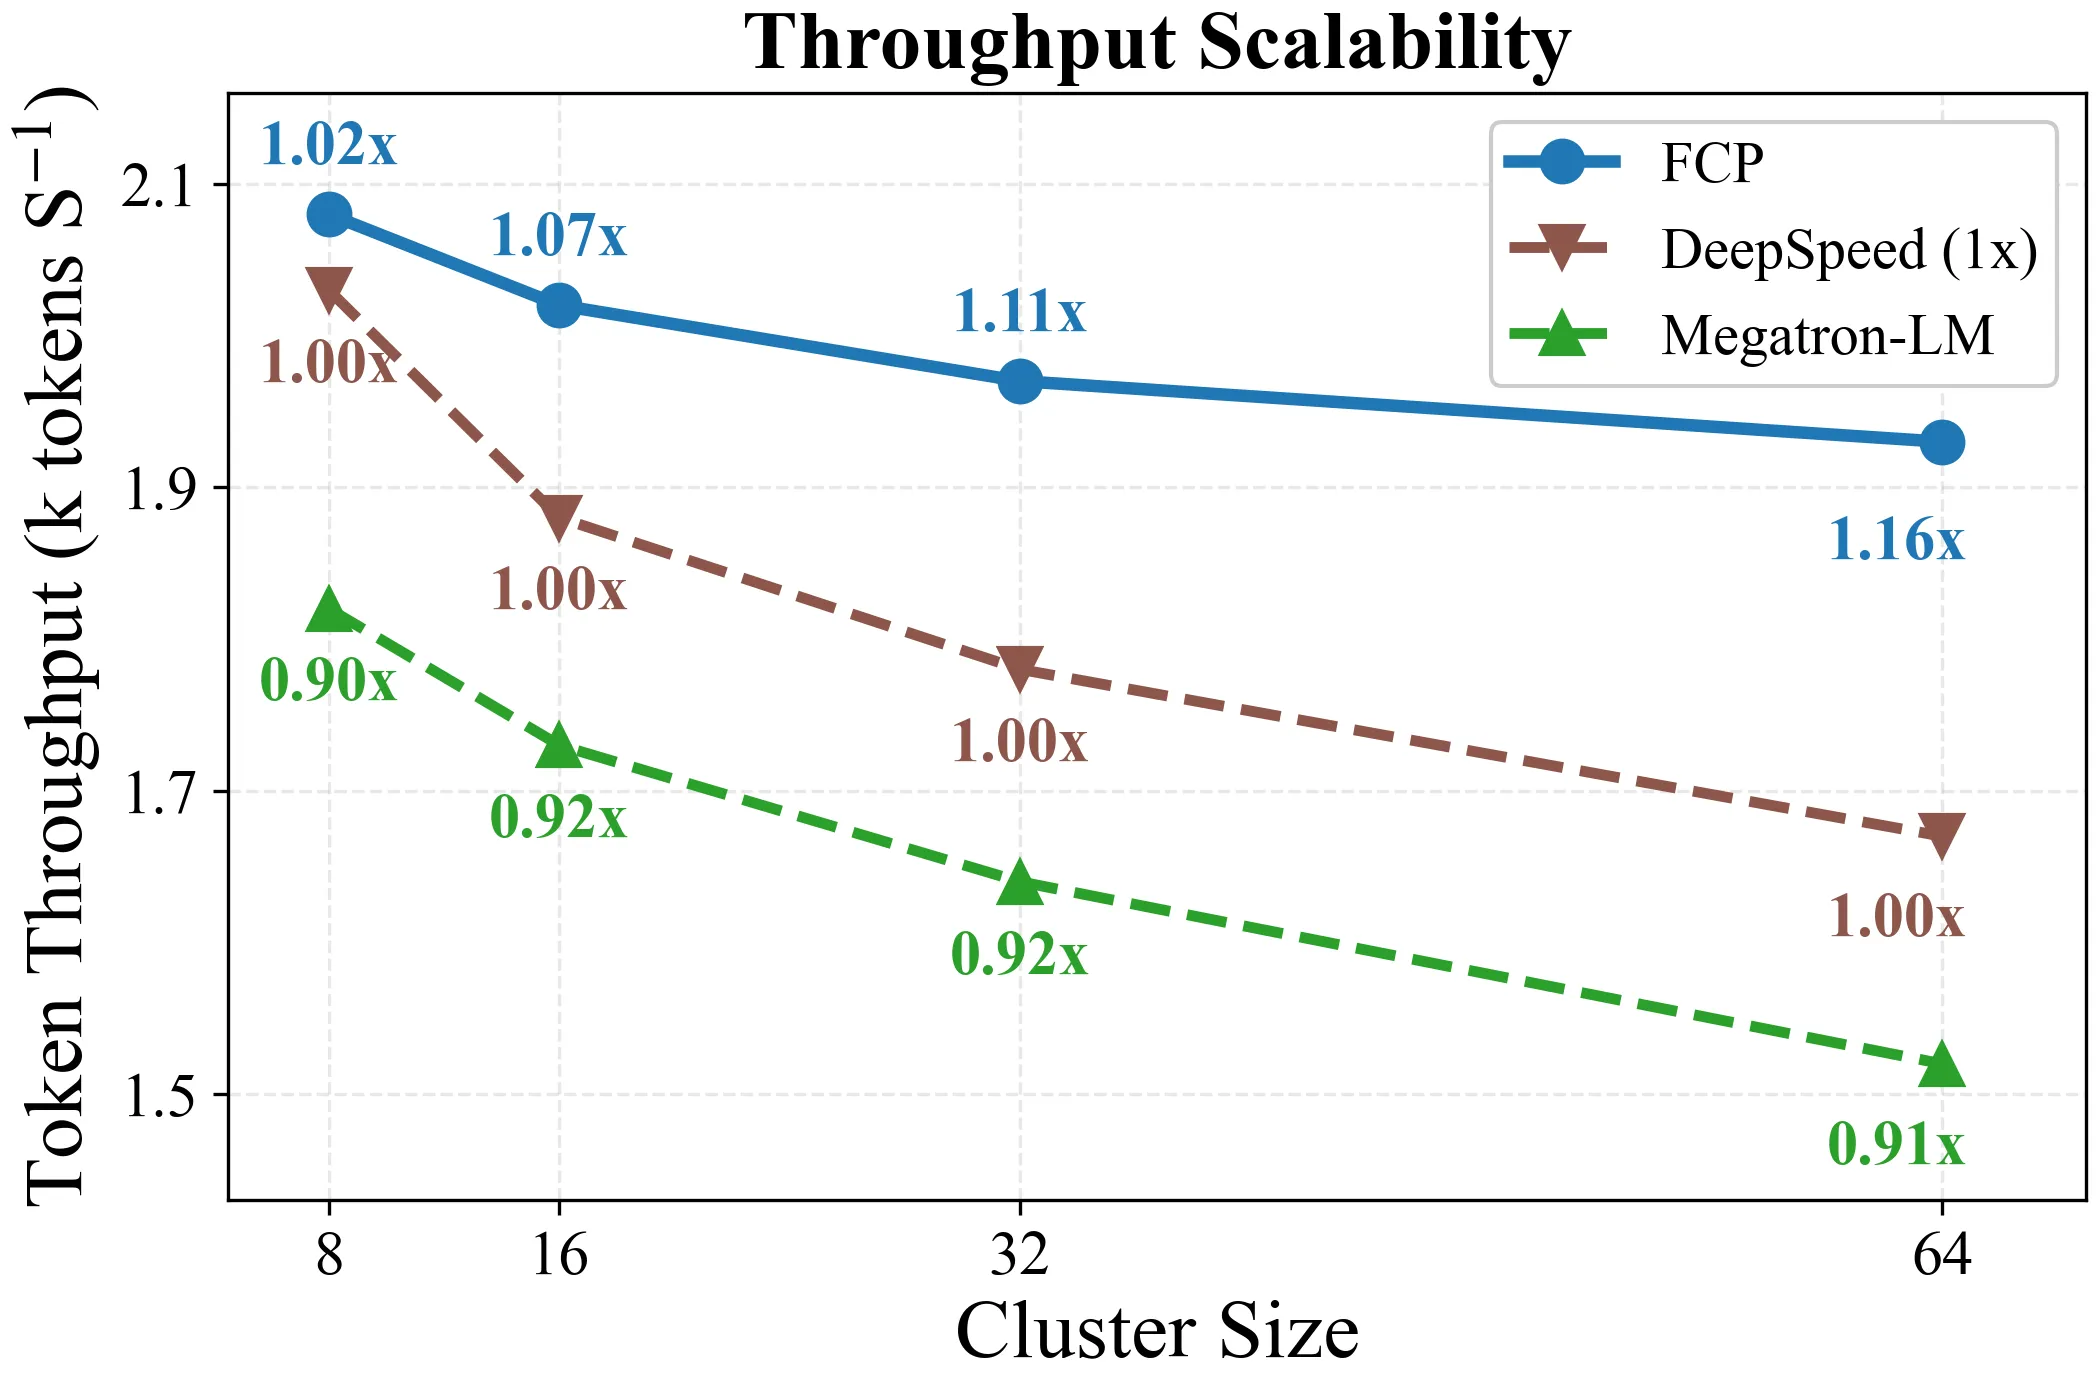
Figure 5: 8 / 16 / 32 / 64 卡时的 token 吞吐量(k tokens/s)
- 从 8 卡扩展到 64 卡:FCP 相对 DeepSpeed 的比值从 1.02× 提升至 1.16×
- DeepSpeed 绝对吞吐从 ~2.0 降至 1.7 k tok/s;Megatron-LM 从 1.8 降至 1.52 k tok/s
- FCP 具有近线性扩展效率,随集群增大更能抵御通信开销
6.4 时间开销分析
Table 1:变化 Global Batch Size(Qwen3VL-2B)
| GBS | Compute (s) | Schedule (ms) | Solver (ms) |
|---|---|---|---|
| 128 | 6.34 | 448 | 23 |
| 256 | 7.58 | 696 | 45 |
| 512 | 11.65 | 905 | 86 |
Table 2:变化设备数
| #Device | Compute (s) | Schedule (ms) | Solver (ms) |
|---|---|---|---|
| 16 | 34.45 | 282 | 20 |
| 32 | 18.26 | 537 | 44 |
| 64 | 11.65 | 905 | 86 |
- Solver 最坏 86 ms,总调度 ≤ 905 ms,远小于单 GBS 的计算时间(11.65 s)
- 调度可与计算完全重叠
- 通信组创建/销毁开销 ≈ 1 ms,可忽略
6.5 Profiler 误差分析
Table 3:代价估计误差 (%)
| Model | 2B | 4B | 8B |
|---|---|---|---|
| Qwen3VL | 7.93 | 6.71 | 4.27 |
| InternVL2.5/3 | 7.48 | 6.54 | 4.12 |
- 误差 < 8%,FCP 依赖候选策略的相对排序而非绝对预测
Table 4/5:Profiler 噪声鲁棒性(32/64 卡)
| Noise (%) | 32 卡 Time/Step | 32 卡 CP Match | 64 卡 Time/Step | 64 卡 CP Match |
|---|---|---|---|---|
| 0 | – | 100.0 | – | 100.0 |
| 5 | +0.00% | 100.0 | +0.00% | 100.0 |
| 10 | +0.00% | 100.0 | +0.00% | 100.0 |
| 20 | +0.00% | 100.0 | +0.00% | 100.0 |
| 30 | +3.27% | 92.7 | +5.73% | 90.4 |
| 50 | +4.84% | 91.3 | +6.16% | 88.8 |
- 20% 以内噪声不改变调度策略
- 50% 大噪声下 CP match ≈ 90%,代价仅 +4.84% (32 卡) / +6.16% (64 卡)
- 鲁棒性源于代价模型:二次项主导长序列,线性项主导线性层与通信;系数扰动很少改变候选顺序
6.6 案例分析(Table 6)
| 配置 | Case 1 (OpenVid) | Case 2 (MSRVTT) |
|---|---|---|
| DeepSpeed | ⟨8⟩×4 | ⟨4⟩×8 |
| Megatron-LM | ⟨8⟩×4 | ⟨4⟩×8 |
| FCP | ⟨8⟩×1, ⟨6⟩×2, ⟨4⟩×1, ⟨2⟩×2, ⟨1⟩×4 | ⟨4⟩×2, ⟨3⟩×4, ⟨2⟩×6 |
- FCP 在同一 global batch 内为不同序列使用异构 CP 度(如 8、6、4、3、2、1 混用),充分利用非 2 幂并行度
- Case 1 加速 1.27×,Case 2 加速 1.19×
- 极端异构数据(1 条 128k + 多条 2-8k 短序列)加速可达 2.24×
6.7 冻结 MLLM 训练(Appendix C)
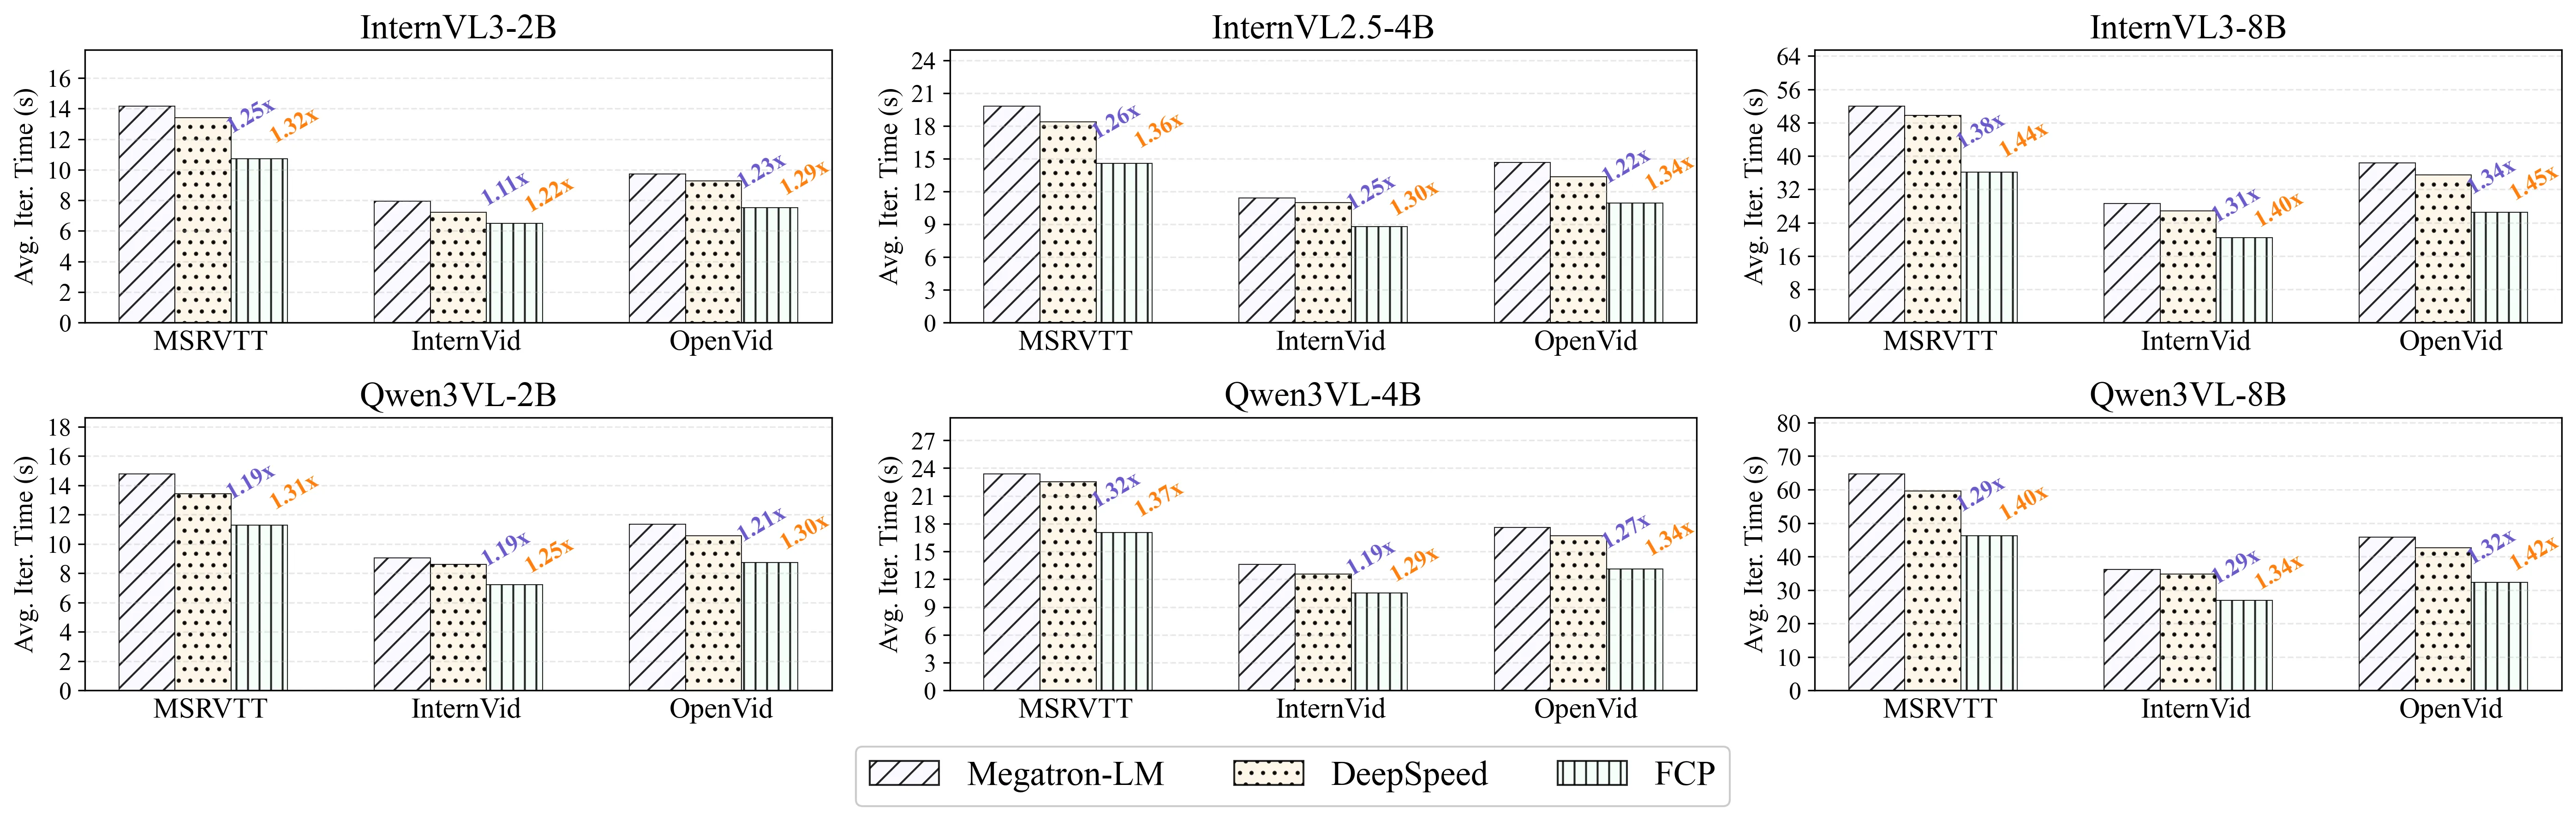
Figure 6: 冻结 vision encoder 的 MLLM 训练迭代时间
- 冻结后总墙钟时间显著下降,FCP 仍全面领先
- 加速范围:1.16× (InternVL3-2B / InternVid) → 1.40× (InternVL3-8B / MSRVTT)
- Qwen3VL-8B on MSRVTT 1.39×,on OpenVid 1.35×
- 15 / 18 配置 > 1.2×
七、创新点与贡献
- 首次将 CP 并行度松弛到任意正整数:利用 Ring-Attention 摆脱 head 数整除约束,突破 FlexSP / DeepSpeed-Ulysses 的 2 幂限制,可行解空间显著扩大
- 两阶段多项式时间近似算法:BFD 打包 + O(K’·N²) 的 2D-DP,将 NP-hard 问题以毫秒级开销近似求解
- 统一 LLM 与 MLLM 代价模型:通过 mask 效率因子 η_k 兼容 causal 与 full attention,覆盖多模态视觉 token 的额外计算
- CPU 异步调度隐藏延迟:调度耗时可完全被下一 batch 计算重叠
- Megatron-LM 无侵入集成:以 Scheduler + Profiler add-on 形式接入 MPU,仅动态更新 CP 通信组
- 通信组管理 ≈ 1 ms:动态重配开销可忽略
- 系统实测:4 × 16 Ascend 910C NPU 集群上,端到端加速 up to 1.46×(平均吞吐),极端数据下 2.24×
八、相关工作对比
| 方法 | 类别 | 并行度限制 | 求解开销 | 关键不足 |
|---|---|---|---|---|
| Megatron-LM | 静态 4D 并行 | – | 无 | 异构数据负载不均、冗余通信 |
| DeepSpeed-Ulysses | 静态 SP | 需整除 head 数(通常 2 幂) | 无 | 短序列冗余通信 |
| ByteScale | 动态(启发式) | – | 低 | 贪心近似易次优 |
| FlexSP | 动态(整数规划) | 必须 2 幂 | 5-15 s / batch | 求解慢、空间受限 |
| FCP(本文) | 动态(BFD + 2D-DP) | 任意正整数 | < 86 ms Solver / < 905 ms 总调度 | – |
九、局限性与讨论
- 数据分布均衡时收益减弱:作者明确指出,当 batch 内序列长度较均衡时,FCP 相较静态并行的优势会减小
- TP/PP 保持静态:动态重配 TP/PP 涉及权重重排代价过高,未纳入优化空间
- Profiler 需离线预采集:对新型硬件或模型架构,需重新拟合 α_1、α_2、α_3、β_1、β_2 等系数
- 依赖 Ring-Attention:CP 通信-计算重叠假设成立
- 实验限于 Ascend 910C:未在 NVIDIA / AMD GPU 上验证
十、总结
FCP 是面向异构长上下文 LLM/MLLM 训练的自适应上下文并行策略。通过:
- 松弛并行度到任意正整数
- BFD 打包 + 2D-DP 双阶段多项式时间求解
- CPU 异步调度与代价模型鲁棒设计
- Megatron-LM 无侵入集成
在 4 节点 64 NPU 集群上,FCP 在文本 LLM 与多模态 MLLM 训练中均以毫秒级调度开销取得对 Megatron-LM / DeepSpeed 最高 1.46× 平均吞吐加速、极端数据 2.24× 加速,并展现出近线性扩展效率。该工作为长上下文时代的大规模异构训练调度提供了新范式:动态并行不仅可行,而且几乎无代价。
引用格式
@article{niu2026fcp,
  title   = {Efficient Scaling of LLM Training with Flexible Context Parallelism},
  author  = {Niu, Yifan and Xiao, Han and Liu, Dongyi and Zhou, Wei and Li, Jia},
  journal = {arXiv preprint arXiv:2602.21788},
  year    = {2026},
  doi     = {10.48550/arXiv.2602.21788}
}