Sparsity Induction for Accurate Post-Training Pruning of Large Language Models
通过稀疏性诱导提升 LLM 后训练剪枝精度
Sparsity Induction for Accurate Post-Training Pruning of Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Sparsity Induction for Accurate Post-Training Pruning of Large Language Models |
| 作者 | Minhao Jiang, Zhikai Li, Xuewen Liu, Jing Zhang, Mengjuan Chen, Qingyi Gu |
| 机构 | 未明确标注 |
| 论文 | arXiv:2602.21652 |
| 代码 | 未公开 |
| 发布 | 2026年2月 |
| 领域 | 计算语言学 (cs.CL), 人工智能 (cs.AI) |
二、核心思想
问题定义
后训练剪枝 (Post-Training Sparsity, PTS) 通过从密集网络中移除权重来降低模型成本。然而,原始密集矩阵缺乏高稀疏性,现有方法直接移除权重会破坏模型状态,即使经过后调优也难以获得满意的性能恢复。
根本问题在于:现有方法主要聚焦于设计更好的重要性评分来决定移除哪些权重,但这存在收益递减——这些评分通常基于局部近似或有限校准数据,改进越来越只能带来边际重排序,无法在大规模和高稀疏下转化为稳定的精度提升。
解决方案概述
本文提出稀疏性诱导 (Sparsity Induction, SI):在剪枝之前,主动将模型推向更高的稀疏性(在分布和特征层面),从而突破 PTS 的极限。
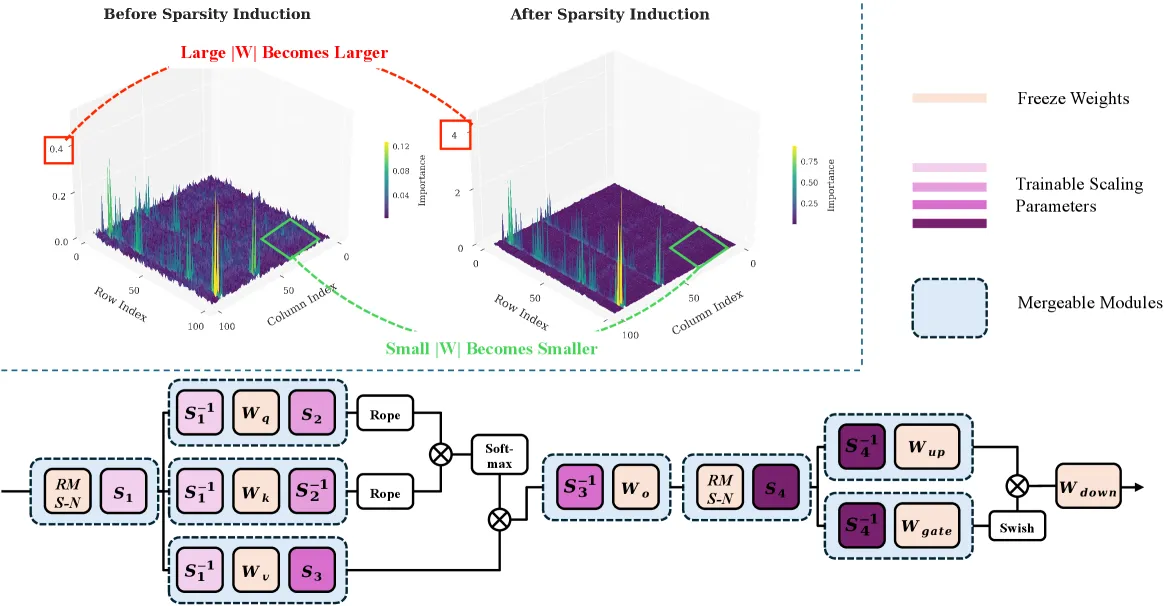
核心思路:不是在剪枝时决定”移除什么”,而是在剪枝前让模型”更容易被剪枝”。
两个互补维度
| 维度 | 方法 | 效果 |
|---|---|---|
| 分布层面 | 数学等价的缩放变换,重塑权重分布 | 增强重要/不重要参数的可分离性 |
| 特征层面 | 谱范数损失 (Spectral Norm Loss) | 从低秩视角促进特征稀疏性 |
三、技术架构
核心公式
剪枝基础
设 为密集权重矩阵, 为剪枝掩码:
对于输入向量 ,剪枝引起的输出失真为:
分布层面稀疏性诱导
线性层重参数化:引入逐通道缩放 和逐通道偏移 ,保持功能等价:
其中 ,,。
注意力层重参数化:对 Q/K 施加逆缩放以保持注意力 logits 不变:
则 。
轻量目标:仅在校准数据上学习少量变换参数 :
特征层面稀疏性诱导
鲁棒通道初始化:基于校准数据的通道统计构造初始化:
谱范数损失:结合输出匹配损失和谱正则化:
其中 表示谱范数的 -范数。
快速 Hessian 更新
对角 Hessian 代理:
当分布缩放折叠到参数中时,代理变换为:
快速 Wanda 指标:
复杂度: 刷新,通过缓存对角线实现 22.65× 加速。
关键特性
全吸收性 (Fully Absorbable)
SI 的辅助参数(缩放因子、偏移量)可以完全折叠到权重矩阵中:
- 无额外参数
- 无推理时开销
- 完全兼容 N:M 稀疏硬件加速
即插即用
SI 作为预处理步骤,可与任何现有 PTS 方法(Magnitude、Wanda、SparseGPT)兼容使用。
四、实验结果
实验配置
| 参数 | 值 |
|---|---|
| 模型 | OPT-125M/350M/1.3B/2.7B, LLaMA-1/2-7B/13B |
| 校准数据 | 128 个激活样本 (C4 训练集, 2048-token 片段) |
| 评估 | WikiText-2 PPL, C4 PPL, 6 个零样本 benchmark |
| 剪枝方法 | Magnitude, Wanda, SparseGPT |
| 稀疏模式 | 50% 非结构化, 2:4, 4:8 |
困惑度结果 (WikiText-2)
| 稀疏性 | 方法 | OPT-125M | OPT-350M | OPT-1.3B | OPT-2.7B | LLaMA-7B | LLaMA-13B |
|---|---|---|---|---|---|---|---|
| 0% | Dense | 27.65 | 22.00 | 14.62 | 12.47 | 5.68 | 5.09 |
| 50% | Magnitude | 193.36 | 97.78 | 1712.82 | 265.21 | 17.28 | 20.21 |
| +SI | 52.85 | 49.55 | 26.39 | 18.86 | 12.08 | 18.45 | |
| Wanda | 38.99 | 36.19 | 18.40 | 14.22 | 7.26 | 6.15 | |
| +SI | 38.00 | 34.78 | 18.27 | 14.19 | 7.04 | 6.04 | |
| SparseGPT | 36.97 | 31.40 | 17.40 | 13.46 | 7.17 | 6.22 | |
| +SI | 35.79 | 31.30 | 17.45 | 13.45 | 7.13 | 6.12 | |
| 2:4 | Wanda | 79.89 | 112.57 | 28.16 | 21.25 | 11.53 | 9.60 |
| +SI | 79.11 | 94.80 | 27.54 | 20.23 | 10.51 | 8.32 | |
| SparseGPT | 61.44 | 49.55 | 23.87 | 17.10 | 11.00 | 9.05 | |
| +SI | 60.66 | 49.51 | 23.85 | 17.07 | 10.65 | 8.78 |
关键发现:SI 在激进稀疏性下改善最显著——这正是基线稀疏模型质量严重退化或几乎不可用的情况。
零样本准确率 (6 个 Benchmark 平均)
| 稀疏性 | 方法 | LLaMA-1-7B | LLaMA-1-13B | LLaMA-2-7B | LLaMA-2-13B |
|---|---|---|---|---|---|
| 0% | Dense | 54.79 | 57.82 | 55.95 | 58.25 |
| 50% | Wanda | 51.47 | 55.45 | 53.63 | 56.10 |
| +SI | 52.50 | 55.32 | 53.91 | 56.08 | |
| 2:4 | Wanda | 45.75 | 48.73 | 45.95 | 50.06 |
| +SI | 45.71 | 49.54 | 46.32 | 50.98 | |
| SparseGPT | 46.07 | 49.31 | 47.23 | 52.14 | |
| +SI | 46.30 | 50.05 | 47.04 | 52.59 | |
| 4:8 | Magnitude | 46.18 | 48.46 | 48.77 | 52.10 |
| +SI | 46.07 | 49.87 | 49.17 | 54.49 | |
| Wanda | 48.58 | 52.22 | 50.02 | 54.59 | |
| +SI | 48.89 | 52.61 | 50.37 | 54.79 |
效率分析
快速 Hessian 更新
| 方法 | 更新时间 (s) | 平均时间/迭代 (s) | 加速比 |
|---|---|---|---|
| 经典重计算 | 345.91 | 2.70 | 1.00× |
| 快速更新 (SI) | 15.27 | 0.12 | 22.65× |
端到端延迟 (LLaMA-7B, 2:4 稀疏)
| 模式 | E2E 延迟 (ms) | 加速比 |
|---|---|---|
| Dense | 312 | 1.00× |
| 2:4 (Wanda) | 251 | 1.24× |
| 2:4 (Wanda+SI) | 251 | 1.24× |
SI 引入零运行时开销——与 Wanda 延迟完全相同。
五、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 稀疏性诱导概念 | 在剪枝前主动塑造模型权重分布和特征结构,使其更”稀疏友好” | 在所有 PTS 方法上一致改善 |
| 分布层面重参数化 | 数学等价的逐通道缩放/偏移,完全可吸收 | 无额外参数,无推理开销 |
| 谱范数损失 | 从低秩视角促进特征稀疏性 | 稳定收敛方向,少量可训练参数 |
| 快速 Hessian 更新 | 对角代理 + 缓存对角线实现 刷新 | 22.65× 加速 |
| 即插即用设计 | 与 Magnitude/Wanda/SparseGPT 兼容 | 跨模型架构和任务一致有效 |
六、总结
核心贡献
- 稀疏性诱导概念:首次提出在剪枝前主动诱导稀疏性的框架,从”剪什么”转向”让模型更容易被剪”
- 双维度方法:分布层面(等价缩放变换)+ 特征层面(谱范数损失)
- 全吸收设计:辅助参数可完全折叠到权重中,零推理开销
- 快速算法:Hessian 更新 22.65× 加速
- 广泛验证:跨 OPT 和 LLaMA 系列、多种稀疏模式和 PTS 方法
技术影响
- 为后训练剪枝提供了新范式:预处理模型而非改进剪枝准则
- 全吸收设计使 SI 可直接部署,无额外开销
- 与 N:M 稀疏硬件加速完全兼容
- 在激进稀疏性下效果最显著,解决了 PTS 的关键痛点
局限性
- 代码未公开
- 仅在 decoder-only 架构上验证
- 谱范数损失的超参数(λ, α, p)需要调优
- 未与训练时稀疏方法(如 Lottery Ticket)对比
- 未来方向:更丰富的等价变换、结构感知变体、与量化集成
七、参考资源
- 论文: arXiv:2602.21652
- 关键参考:
- Wanda (Sun et al., 2024): 基于权重×激活的剪枝指标
- SparseGPT (Frantar & Alistarh, 2023): 基于 Hessian 的剪枝
- Magnitude Pruning: 经典基线
分析日期: 2026-06-04