Xiaomi-Robotics-0: An Open-Sourced Vision-Language-Action Model with Real-Time Execution
小米机器人团队发布的先进VLA模型,通过精心设计的训练方案和部署策略实现高性能实时执行
Xiaomi-Robotics-0: An Open-Sourced Vision-Language-Action Model with Real-Time Execution’---
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Xiaomi-Robotics-0: An Open-Sourced Vision-Language-Action Model with Real-Time Execution |
| 作者 | Rui Cai, Jun Guo, Xinze He, Piaopiao Jin, Jie Li, Bingxuan Lin, Futeng Liu, Wei Liu, Fei Ma, Kun Ma, Feng Qiu, Heng Qu, Yifei Su, Qiao Sun, Dong Wang, Donghao Wang, Yunhong Wang, Rujie Wu, Diyun Xiang, Yu Yang, Hangjun Ye, Yuan Zhang, Quanyun Zhou |
| 机构 | Xiaomi Robotics (小米机器人) |
| 论文 | arXiv:2602.12684 |
| 代码 | https://xiaomi-robotics-0.github.io |
| 发布 | 2026-02-13 (v1), 2026-03-25 (v2) |
| 领域 | Robotics (cs.RO); Machine Learning (cs.LG) |
二、核心思想
问题定义
视觉-语言-动作(VLA)模型已成为机器人策略学习的新范式,但其大规模参数(通常达数十亿)导致的高推理延迟在真实机器人部署中造成严重问题。具体而言:
- 同步执行时,机器人需等待推理完成才能继续动作,导致运动暂停和不连续
- 异步执行时,连续推理的动作块之间若不一致,会引发抖动运动并将机器人推入分布外状态
解决方案概述
Xiaomi-Robotics-0 提出了一个完整的训练-部署方案:
- 两阶段预训练:第一阶段在大规模跨具身机器人轨迹和视觉-语言数据上联合训练VLM,赋予其动作生成能力同时保留视觉语义知识;第二阶段冻结VLM,训练扩散变换器(DiT)通过流匹配生成动作
- 异步执行后训练:提出 Lambda 形状注意力掩码技术,防止模型过度依赖动作前缀而忽视视觉和语言条件
- 精确时间对齐部署:在部署时仔细对齐连续预测动作块的时间步,确保无缝实时执行
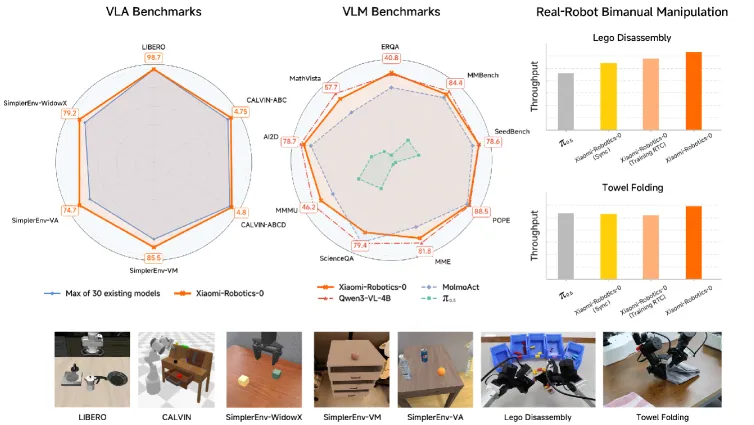
Figure 1: Overview. Xiaomi-Robotics-0 在三个广泛使用的仿真基准测试中实现了最先进的性能,在两个真实机器人双臂灵巧操作任务中实现了高吞吐量,并且在多个VLM基准测试中匹配了底层预训练VLM的性能。
三、技术架构
整体框架图
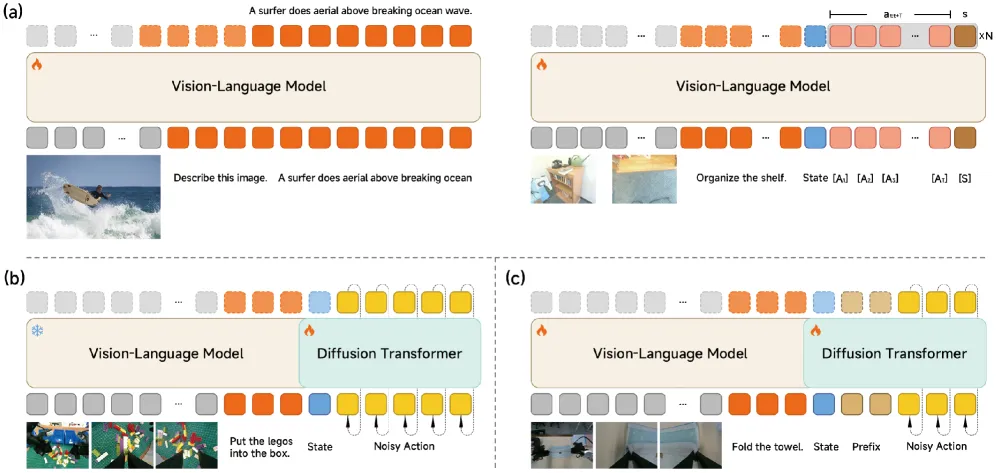
Figure 3: Model & Training. (a) 预训练第一阶段:在视觉-语言数据(左)和机器人轨迹数据(右)上训练VLM。视觉-语言数据通过下一个token预测目标训练,机器人轨迹数据采用Choice Policies范式进行动作预测。 (b) 预训练第二阶段:冻结VLM,训练扩散变换器通过流匹配生成动作。 (c) 异步执行后训练:将干净的动作前缀添加到带噪动作token前。
模型架构
Xiaomi-Robotics-0 采用混合变换器(Mixture-of-Transformers, MoT)架构,包含两个核心组件:
| 组件 | 说明 | 关键参数 |
|---|---|---|
| VLM | Qwen3-VL-4B-Instruct 预训练视觉语言模型 | 4B参数,处理观测图像 和语言指令 |
| DiT | 16层扩散变换器 | 条件化于VLM最后16层的KV cache,生成 步动作块 |
| 总参数 | 端到端VLA模型 | 4.7B参数 |
输入输出流程:
- 输入:观测图像 、语言指令 、机器人本体感知状态
- 输出: 步动作块 通过流匹配生成
核心公式
流匹配损失函数 (Flow-Matching Loss):
其中:
- 是流匹配时间步
- 是带噪动作
- 从 Beta 分布采样,在训练期间对更嘈杂的时间步赋予更大权重
DiT输入token序列:
其中 对应带噪动作。使用因果注意力机制,通过自适应归一化层(adaLN)注入流匹配时间步条件。
VLM输入token序列(第一阶段预训练):
其中 是可学习的动作预测token, 是分数预测token。
训练流程
预训练阶段
第一阶段:VLM动作能力赋予
- 目标:赋予VLM动作生成能力
- 方法:采用 Choice Policies 范式,同时预测 个动作块候选及其分数
- 监督:计算每个候选与真值的 距离作为分数监督目标,采用赢家通吃(winner-takes-all)策略,仅更新 距离最小的候选
- 数据:机器人轨迹数据与视觉-语言数据以 1:6 比例采样
- 视觉-语言数据任务:视觉定位(visual grounding)、VQA、图像描述、具身推理与规划
第二阶段:DiT流匹配训练
- 冻结VLM,仅训练DiT
- 在全部机器人轨迹数据上训练
- 使用流匹配损失
- DiT条件化于VLM最后16层的KV cache
- 添加可学习的注意力池化token(SINK token)稳定训练
数据
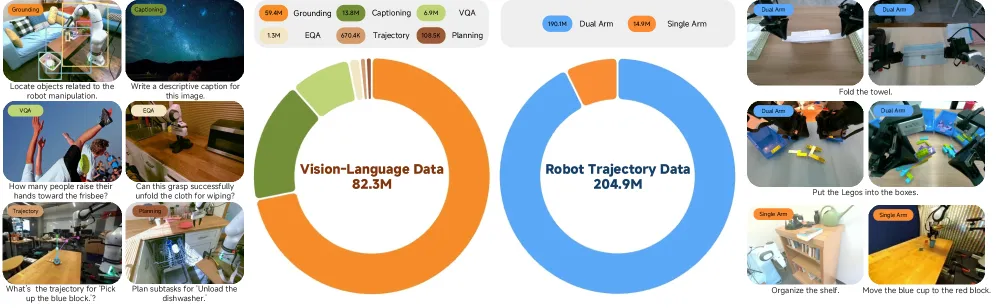
Figure 2: Data. Xiaomi-Robotics-0 在预训练期间利用机器人轨迹数据和视觉-语言数据。
| 数据类型 | 来源 | 规模 |
|---|---|---|
| 机器人轨迹 | DROID、MolmoAct等开源数据集 + 自采数据 | 约200M时间步 |
| 自采数据 | Lego拆解(338小时)、毛巾折叠(400小时) | 738小时 |
| 视觉-语言数据 | 通用VL数据集 + 机器人VL数据 | 80M+样本 |
视觉-语言数据包含四类任务:
- 视觉定位:使用Grounded SAM、Grounding DINO 1.5、LLMDet的交叉验证共识机制
- VQA:使用SOTA预训练VLM重新标注
- 图像描述:使用SOTA预训练VLM重新标注
- 具身推理与规划:具身问答(EQA)、高层任务规划、点轨迹预测
后训练与部署
异步执行后训练
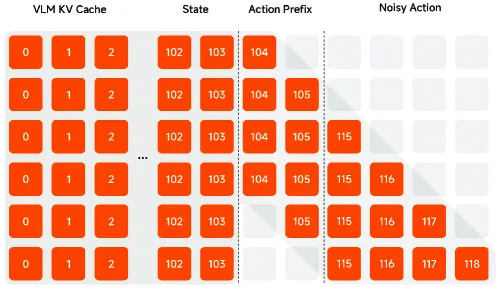
Figure 4: The -Shape Attention Mask for Post-Training. 带噪动作token只能通过VLM KV cache、sink token、state token和前 个时间步的动作token来关注视觉和语言token。每个token中的数字表示该token的RoPE位置索引。注意,我们为带噪动作token的位置索引添加了10的偏移量,以使模型能够区分它们与干净动作前缀token。
核心技术:
-
动作前缀条件化:将前一推理的已提交动作前缀到DiT中的带噪动作token前
- 输入序列变为:
-
RoPE位置偏移:为带噪动作token的位置索引添加偏移量(+10),使模型能区分带噪动作与干净动作前缀
-
形状注意力掩码:
- 紧跟动作前缀后的带噪动作token可以关注前缀,确保平滑过渡
- 后续时间步的带噪动作token不能关注动作前缀,迫使它们关注视觉和语言信号,保证策略的反应性
-
动态损失重加权:当 时,基于在线预测动作与真值动作之间的 误差动态重加权流匹配损失,优先处理偏差较大的样本
训练参数:
- 从集合 中采样
- 预训练:40k步,batch size 32,768
- 后训练:batch size 2,048,Lego拆解40k步,毛巾折叠80k步
- 优化器:AdamW,DeepSpeed ZeRO-2
- 动作块长度:(对应1秒动作)
部署策略
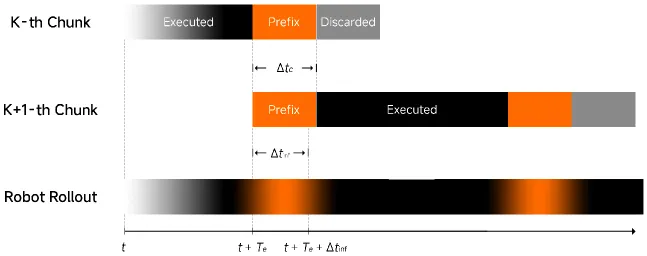
Figure 5: Asynchronous Execution. 展示了两个连续的动作块以及在机器人执行期间如何将它们拼接在一起。
同步执行:
- 执行预测动作块的前 步
- 执行完成后立即开始下一次推理
- 机器人在推理期间保持空闲
异步执行:
- 执行前 步后触发下一次推理
- 机器人在推理期间继续执行当前块的剩余动作
- 使用从步骤 到 的动作作为下一次推理的前缀
- 设置 确保动作前缀覆盖整个推理窗口
- 新生成的块从步骤 开始执行
推理细节:
- 初始化:从标准高斯分布采样
- 执行5步流匹配,积分 从0到1
- 部署于NVIDIA GeForce RTX 4090 GPU
- 推理延迟:
- 所有输入模态重采样到统一的30Hz时间线
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 两阶段预训练 | 第一阶段联合训练VLM+动作预测,第二阶段冻结VLM训练DiT | 避免灾难性遗忘,保留视觉语义知识 |
| Choice Policies动作预测 | 同时预测N个动作块候选+分数,赢家通吃训练 | 处理轨迹数据的多模态性 |
| 形状注意力掩码 | 替代因果注意力掩码,限制后续时间步对动作前缀的注意力 | 防止策略学习走捷径,保证视觉/语言反应性 |
| RoPE位置偏移 | 为带噪动作token添加位置偏移 | 帮助模型区分带噪动作与干净动作前缀 |
| 动态损失重加权 | 基于预测误差重加权流匹配损失 | 优先纠正较大执行偏差 |
| 精确时间对齐部署 | 对齐连续动作块时间步,确保 | 实现无缝实时执行,避免运动暂停 |
五、实验结果
基准测试
LIBERO 基准
| 方法 | Libero-Spatial | Libero-Object | Libero-Goal | Libero-Long | Average |
|---|---|---|---|---|---|
| OpenVLA | 84.7% | 88.4% | 79.2% | 53.7% | 76.5% |
| OpenVLA-OFT | 97.6% | 98.4% | 97.9% | 94.5% | 97.1% |
| 96.8% | 98.8% | 95.8% | 85.2% | 94.2% | |
| -FAST | 96.4% | 96.8% | 88.6% | 60.2% | 85.5% |
| 98.8% | 98.2% | 98.0% | 92.4% | 96.9% | |
| GR00T-N1 | 94.4% | 97.6% | 93.0% | 90.6% | 93.9% |
| UniVLA | 95.4% | 98.8% | 93.6% | 94.0% | 95.5% |
| EO-1 | 99.7% | 99.8% | 99.2% | 94.8% | 98.2% |
| Xiaomi-Robotics-0 | 98.8% | 100.0% | 98.8% | 97.2% | 98.7% |
CALVIN 基准
| 方法 | 设置 | 1 | 2 | 3 | 4 | 5 | Avg. Len. |
|---|---|---|---|---|---|---|---|
| FLOWER | ABCD->D | 99.2% | 96.9% | 96.9% | 92.3% | 88.3% | 4.67 |
| Xiaomi-Robotics-0 | ABCD->D | 99.7% | 98.0% | 96.7% | 94.2% | 91.8% | 4.80 |
| FLOWER | ABC->D | 99.4% | 95.8% | 90.7% | 84.9% | 77.8% | 4.53 |
| Xiaomi-Robotics-0 | ABC->D | 100.0% | 98.3% | 96.0% | 92.6% | 88.1% | 4.75 |
SimplerEnv 基准
WidowX 评估:
| 方法 | Put Spoon on Towel | Put Carrot on Plate | Stack Blocks | Put Eggplant in Basket | Overall |
|---|---|---|---|---|---|
| 83.8% | 52.5% | 52.5% | 87.9% | 69.2% | |
| EO-1 | 63.6% | 54.5% | 81.8% | 90.9% | 72.7% |
| Xiaomi-Robotics-0 | 95.8% | 62.5% | 75.0% | 83.3% | 79.2% |
Google Robot 评估(Visual Matching):
| 方法 | Pick Coke Can | Move Near | Open/Close Drawer | Drawer Apple | Overall |
|---|---|---|---|---|---|
| 97.9% | 78.7% | 62.3% | 46.6% | 71.4% | |
| EO-1 | 98.0% | 83.8% | 71.3% | 52.8% | 76.5% |
| Xiaomi-Robotics-0 | 98.7% | 88.8% | 79.6% | 75.0% | 85.5% |
Google Robot 评估(Visual Aggregation):
| 方法 | Pick Coke Can | Move Near | Open/Close Drawer | Drawer Apple | Overall |
|---|---|---|---|---|---|
| 90.1% | 80.7% | 27.6% | 20.5% | 54.7% | |
| EO-1 | 91.6% | 81.7% | 55.0% | 23.8% | 63.0% |
| Xiaomi-Robotics-0 | 88.2% | 76.8% | 67.2% | 66.7% | 74.7% |
真实机器人实验
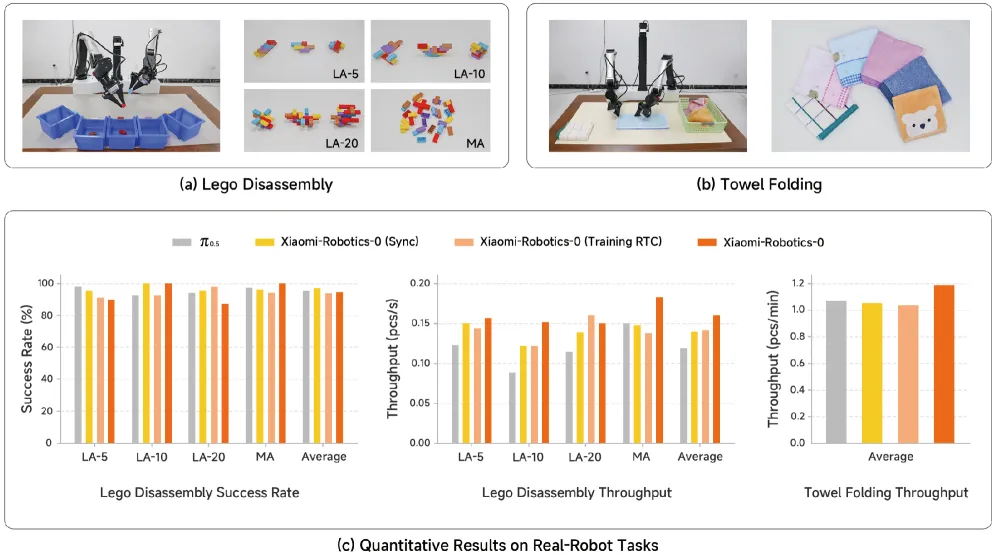
Figure 6: Real-Robot Experiments. (a) Lego拆解评估设置。 (b) 毛巾折叠评估设置及评估中使用的所有毛巾。 (c) 定量结果。
实验设置:
- 平台:双臂机器人,两个6-DoF机械臂
- 相机:3个相机(2个腕部相机 + 1个外部全局相机)
- GPU:NVIDIA GeForce RTX 4090
任务:
-
Lego拆解:拆解Lego结构并按颜色分类放置到对应收纳盒
- 大组件(LA):LA-5、LA-10、LA-20(5/10/20块砖)
- 多组件(MA):34块砖,含单块和2-3块组装体
- 评估指标:平均成功率(正确分类砖块比例)、吞吐量(正确分类砖块/总时间)
-
毛巾折叠:从托盘取出毛巾、展平、对折两次、放置到暂存区
- 6种不同毛巾,每种方法连续30分钟执行
- 单次折叠超过2分钟视为失败
- 评估指标:吞吐量(成功折叠毛巾数/执行时长)
对比方法:
- :SOTA VLA基线,使用OpenPi官方微调协议
- Xiaomi-Robotics-0(同步):同步执行变体
- Xiaomi-Robotics-0(Training RTC):使用训练时RTC的异步基线
结果:
- Lego拆解:所有方法成功率相当,异步方法吞吐量显著更高
- 毛巾折叠:Xiaomi-Robotics-0在吞吐量上显著优于所有基线,实现平滑实时执行
视觉-语言能力保持
| 模型 | ERQA | SEED | POPE | AI2D | MMBench | MME | MMMU | TextVQA | SciQA | ChartQA |
|---|---|---|---|---|---|---|---|---|---|---|
| 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.1 | 0.1 | 1.4 | 0.0 | 0.0 | |
| 0.0 | 21.5 | 0.0 | 14.4 | 22.1 | 0.0 | 19.9 | 0.0 | 28.0 | 0.5 | |
| MolmoAct | 33.5 | 72.7 | 86.6 | 72.0 | 80.1 | 69.5 | 38.0 | 67.3 | 91.1 | 57.1 |
| Xiaomi-Robotics-0 (w/o VL) | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| Xiaomi-Robotics-0 | 40.8 | 78.6 | 88.5 | 78.7 | 84.4 | 81.8 | 46.2 | 72.0 | 79.4 | 59.2 |
| Qwen3-VL-4B-Instruct | 40.0 | 78.8 | 89.7 | 81.6 | 88.7 | 87.1 | 51.7 | 78.0 | 92.7 | 76.8 |
关键发现:
- Xiaomi-Robotics-0 在几乎所有VL基准上优于所有对比的VLA基线
- 在具身推理基准ERQA上甚至略微超越底层VLM(40.8 vs 40.0)
- 不使用VL数据训练的变体在所有VL任务上性能归零,表明严重的灾难性遗忘
- 在物体幻觉评估(POPE系列)和OCR相关任务上表现突出
六、相关工作
VLA模型
近年来,VLA模型已成为机器人策略学习的新范式。典型方法包括:
- 动作token化:将动作转换为离散token,通过下一个token预测目标训练VLM(如RT-2、OpenVLA),但会引入量化误差
- 流匹配/扩散建模:利用流匹配或扩散模型的表达能力建模复杂轨迹分布(如、、GR00T-N1)
知识保留
- 联合训练视觉-语言数据和机器人轨迹(如MolmoAct、)
- 将流匹配目标与VLM骨干解耦,防止梯度反向传播
异步执行
- 同步执行:机器人等待推理完成,导致动作暂停
- 推理加速:实现实时性能
- 异步执行:机器人在推理期间继续执行
- Real-Time Chunking (RTC):无训练的修复算法
- Training RTC:在训练期间引入前缀动作
- Xiaomi-Robotics-0: 形状注意力掩码 + RoPE位置偏移
七、总结
核心贡献
- 提出Xiaomi-Robotics-0,一个4.7B参数的端到端VLA模型,在所有仿真基准上达到SOTA
- 设计两阶段预训练方案,有效保留VLM的视觉-语言能力同时赋予动作生成能力
- 提出形状注意力掩码和RoPE位置偏移技术,解决异步执行中策略学习走捷径的问题
- 实现精确的时间对齐部署策略,在消费级GPU上实现80ms推理延迟的平滑实时执行
- 开源预训练和后训练检查点及推理代码
技术影响
- 为VLA模型的实时部署提供了实用的解决方案
- 两阶段预训练方案可推广到其他VLA架构
- 形状注意力掩码技术可应用于需要动作前缀条件化的场景
- 在真实机器人双臂灵巧操作任务上验证了方法的有效性
局限性
- 模型规模(4.7B参数)在资源受限场景下可能仍然过大
- 异步执行的性能略低于同步执行(在Lego拆解任务中观察到)
- 真实机器人实验仅在两种任务上验证,泛化性有待进一步验证
- 视觉-语言能力相比底层VLM仍有轻微下降
八、参考资源
- 论文: arXiv:2602.12684
- 项目主页: https://xiaomi-robotics-0.github.io
- 底层VLM: Qwen3-VL-4B-Instruct
- 关键参考文献:
- / (Physical Intelligence)
- Choice Policies
- Flow Matching
- Diffusion Transformer (DiT)
- Real-Time Chunking (RTC)