Compute Only Once: UG-Separation for Efficient Large Recommendation Models
UG-Sep 在 TokenMixer 架构中解耦用户侧和物品侧信息流,实现用户侧计算复用,推理延迟降低 20%,已部署于字节跳动多个业务场景
Compute Only Once: UG-Separation for Efficient Large Recommendation Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Compute Only Once: UG-Separation for Efficient Large Recommendation Models |
| 作者 | Hui Lu, Zheng Chai, Shipeng Bai, Hao Zhang, Zhifang Fan, Kunmin Bai, Ke Sun, Yingwen Wu, Bingzheng Wei, Xiang Sun, Ziyan Gong, Tianyi Liu, Hua Chen, Deping Xie |
| 机构 | ByteDance (字节跳动) |
| 论文 | arXiv:2602.10455 |
| 发布 | 2026-02-11 (v1), 2026-05-20 (v2) |
| 许可 | 未明确 |
二、核心思想
问题定义
推荐系统通过 scaling law 持续扩大模型规模,但面临推理成本瓶颈:
| 方向 | 方法 | 计算复用问题 |
|---|---|---|
| 长序列建模 | HSTU, LONGER, M-Falcon | 用户侧 KV-Cache 可复用 |
| 大稠密特征交互 | TokenMixer | 用户-物品信息深度纠缠,无法复用 |
核心矛盾:TokenMixer 架构中用户侧和物品侧信息在每一层混合,导致每次候选物品变化时所有计算需重新执行。
解决方案概述
UG-Sep (User-Group Separation) 首次实现 TokenMixer 架构中的用户侧计算复用:
- UG Token 分离:将输入 token 明确分为纯用户侧 (U-tokens) 和混合侧 (G-tokens)
- UG 交互分离:通过分离 mask 防止 G 侧信息污染 U 侧
- 信息补偿:自适应重建被 mask 抑制的用户-物品交互
- W8A16 量化:8-bit 权重量化缓解 UG-Sep 暴露的内存瓶颈
三、技术架构
整体框架图
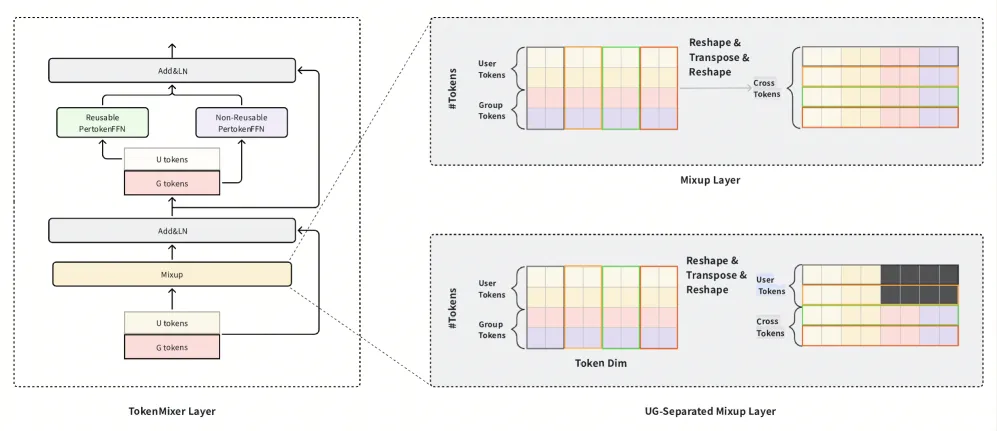
UG-Sep Framework
├── Stage 1: Feature Extraction (Bottom Layers)
│   ├── U-side Branch: SENet, DCN → Pure user features
│   ├── G-side Branch: Complex modules → Mixed features
│   └── Output: U-tokens (pure user) + G-tokens (user+group)
├── Stage 2: TokenMixer with UG-Sep (Middle/Upper Layers)
│   ├── Mixup Operation (with UG mask)
│   │   ├── U→U: allowed (user self-interaction)
│   │   ├── U→G: allowed (user influences group)
│   │   ├── G→U: BLOCKED (group cannot affect user)
│   │   └── G→G: allowed (group self-interaction)
│   ├── PertokenFFN
│   ├── Information Compensation (optional)
│   └── Separated Residual Connection
├── Stage 3: Inference (KV-Cache for U-side)
│   ├── Compute U-side representations ONCE
│   ├── Cache U-side KV for all candidates
│   ├── For each candidate: only compute G-side
│   └── Theoretical speedup: c_u / (c_u + c_g)
└── Stage 4: W8A16 Quantization
    ├── 8-bit weights (FP8)
    ├── 16-bit activations (BF16)
    └── 4x memory reduction, negligible dequant cost
核心公式
TokenMixer 架构:
UG 分离后的 token 表示:
其中 是 U-side token, 是 G-side token, 是 U token 数量, 是 G token 数量。
分离 mask:
信息补偿:
推理加速比:
分离 mask 可视化
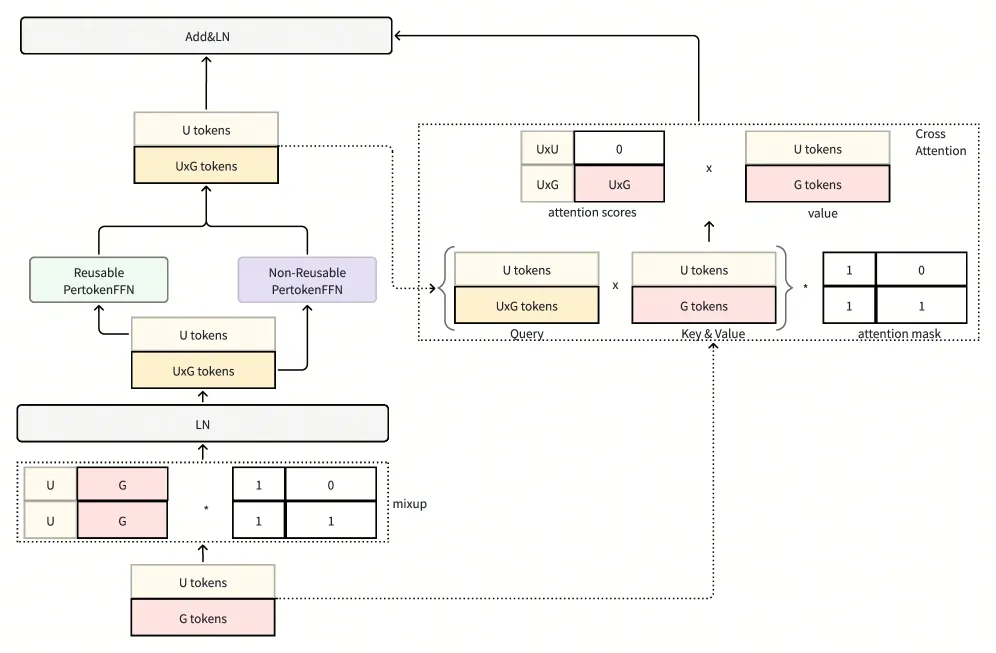
Mixup Attention Mask (H heads × D' dims)
         U-tokens    G-tokens
U-tokens  [✓ ✓ ✓]    [✓ ✓ ✓]    ← U can attend to all
G-tokens  [✗ ✗ ✗]    [✓ ✓ ✓]    ← G cannot attend to U
信息补偿机制
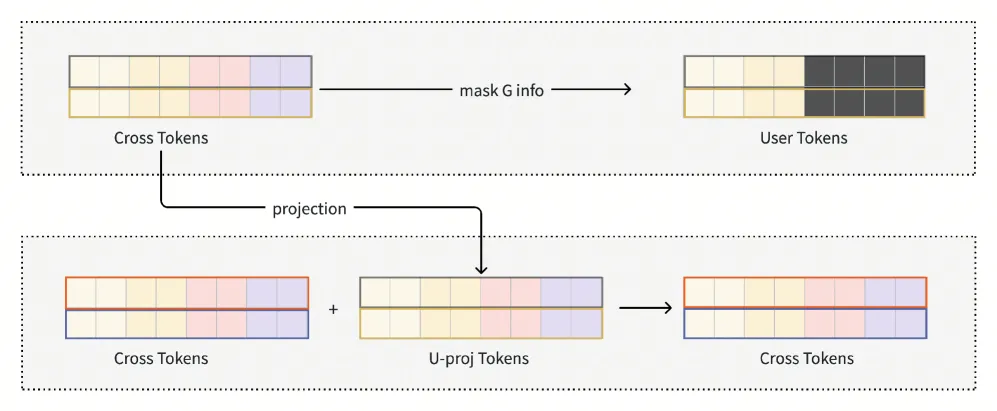
问题:UG mask 会移除 G-side token 中与 U-side 相关的维度信息
解决方案:将 U-side 信息显式注入 G-side 表示
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| UG Token 分离 | 将输入明确分为 U-tokens 和 G-tokens | 图 1 |
| UG 交互分离 | 通过 mask 阻止 G→U 信息流 | 图 2,公式 5-6 |
| Separated Residual | 跨 attention 处理金字塔结构 | 图 2 |
| Information Compensation | 自适应重建被 mask 的信息 | 图 3,表 3 |
| W8A16 量化 | 8-bit 权重缓解内存瓶颈 | 表 4 |
| 工业部署 | 字节跳动多个业务场景 A/B 测试 | 表 5-6 |
五、实验结果
离线评估 - AUC
| 场景 | U:G | ΔAUC | ΔLatency |
|---|---|---|---|
| Douyin Feed Rec | base | – | – |
| 1:2 | +0.002% | – | |
| 1:1 | -0.004% | -20.0% | |
| 3:1 | -0.013% | – | |
| Hongguo Feed Rec | base | – | – |
| 1:1 | -0.018% | -11.5% | |
| 5:3 | -0.015% | – | |
| Chuanshanjia Ads | base | – | – |
| 1:1 | -0.016% | -12.7% | |
| 5:3 | -0.026% | – | |
| Qianchuan Ads | base | – | – |
| 1:1 | -0.024% | -22.0% |
关键发现:
- AUC 变化在 ±0.03% 以内,经 A/B 测试验证对在线性能无显著影响
- 1:1 比例在精度和效率间取得最佳平衡
- 延迟降低 11.5%-22.0%,模型越大收益越明显
训练加速
| 模型 | U:G | Training Speedup |
|---|---|---|
| TokenMixer | – | 0.0% |
| + UG-Sep | 1:2 | +5.50% |
| + UG-Sep | 1:1 | +8.60% |
| + UG-Sep | 3:1 | +14.8% |
消融实验 - Information Compensation
| U:G | Info Compensation | ΔAUC |
|---|---|---|
| 1:2 | N | +0.00% |
| 1:1 | N | -0.01% |
| 2:1 | N | -0.04% |
| 3:1 | N | -0.06% |
| 3:1 | Y | -0.02% |
| 5:1 | Y | -0.04% |
发现:当 U:G 比例增大时,信息补偿模块的关键作用显现,AUC 从 -0.06% 恢复到 -0.02%。
W8A16 量化效果
| 配置 | Latency 降低 |
|---|---|
| (1,16, 1280, 2560) | -50.2% |
| (1,16, 1280, 640) | -40.0% |
| (1,8, 1280, 2560) | -46.8% |
| (1,8, 1280, 640) | -55.0% |
在线 A/B 测试
Douyin 推荐系统:
| 指标 | 变化 | pp-value |
|---|---|---|
| Active Days | -0.002% | 0.46 |
| Duration | +0.006% | 0.45 |
| Like | -0.051% | 0.34 |
| HLT | -0.000% | 0.95 |
| Comment | -0.092% | 0.18 |
| Latency | -20.0% | – |
穿山甲广告:
| 指标 | 变化 | pp-value |
|---|---|---|
| Cost | -0.114% | 0.45 |
| Rank Advv | -0.132% | 0.42 |
| Advv (Overall) | -0.204% | 0.32 |
| Latency | -12.7% | – |
发现:所有指标的 pp-value 均 > 0.18,无统计显著差异,同时延迟降低 12.7%-20.0%。
六、模型配置
实验环境
| 参数 | 值 |
|---|---|
| 业务场景 | Douyin Feed Rec, Hongguo Feed Rec, Chuanshanjia Ads, Qianchuan Ads |
| 特征规模 | 数百到数千特征字段 |
| 用户规模 | 数十亿用户 ID |
| 物品规模 | 数亿视频/广告 ID |
| 嵌入方式 | 稀疏嵌入 |
| 评估指标 | AUC (相对变化) |
| 基线模型 | TokenMixer 架构 |
TokenMixer 配置
| 参数 | 值 |
|---|---|
| 架构 | Multi-Head Token Mixing + PertokenFFN |
| 层归一化 | LayerNorm |
| 残差连接 | Separated Residual |
| 分离 mask | U→U ✓, U→G ✓, G→U ✗, G→G ✓ |
W8A16 配置
| 参数 | 值 |
|---|---|
| 权重精度 | FP8 (8-bit) |
| 激活精度 | BF16 (16-bit) |
| 内存节省 | 4x (vs FP32), 2x (vs BF16) |
| 反量化开销 | 可忽略 |
七、相关工作
| 工作 | 方法 | 与 UG-Sep 的差异 |
|---|---|---|
| HSTU | 高效自注意力 + KV-Cache | 仅适用于序列模型 |
| LONGER | 全局 token + 系统优化 | 长序列场景 |
| M-Falcon | 微批次并行 + KV-Cache | 检索阶段优化 |
| TokenMixer | 全 token 交叉交互 | 无 UG 分离 |
| UniRec | 统一序列推荐框架 | 任务级复用 |
八、总结
核心贡献
- 首次实现:在 TokenMixer 架构中实现用户侧计算复用
- UG 分离框架:通过 token 分离和交互 mask 解耦用户-物品信息流
- 信息补偿:自适应重建被 mask 抑制的用户-物品交互
- W8A16 量化:8-bit 权重量化进一步降低内存瓶颈
- 工业验证:字节跳动 4 个业务场景大规模 A/B 测试
- 显著加速:推理延迟降低 11.5%-22.0%,在线指标无显著变化
技术影响
- 推荐系统效率:为 TokenMixer 架构提供通用加速方案
- Scaling Law 支持:使更大规模的稠密交互模型可部署
- 跨平台适用:适用于推荐、广告等多个业务场景
- 计算复用范式:从序列级扩展到特征交互级
局限性
- 架构依赖:仅适用于 TokenMixer 风格架构
- U:G 比例敏感:过高比例需要信息补偿,可能引入额外复杂度
- 训练加速有限:仅在用户级聚合训练中有效
- 量化精度:W8A16 可能在某些场景引入微小精度损失
- 评估范围:主要在字节跳动内部验证
九、参考资源
- 论文: arXiv:2602.10455
- 相关工作:
- HSTU - 高效自注意力推荐
- LONGER - 长序列建模
- TokenMixer - 稠密特征交互
- M-Falcon - 微批次推理
- 应用场景:
- Douyin (抖音) 推荐系统
- Hongguo (红果) 推荐系统
- 穿山甲广告平台
- 巨量千川广告平台