Execution-Centric Characterization of FP8 Matrix Cores, Asynchronous Execution, and Structured Sparsity on AMD MI300A
AMD MI300A 上 FP8 矩阵核心、异步执行和结构化稀疏的执行特征分析
Execution-Centric Characterization of FP8 Matrix Cores, Asynchronous Execution, and Structured Sparsity on AMD MI300A
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Execution-Centric Characterization of FP8 Matrix Cores, Asynchronous Execution, and Structured Sparsity on AMD MI300A |
| 作者 | 未在摘要中明确列出 |
| 机构 | AMD 相关研究团队 |
| 论文 | arXiv:2602.10262 |
| 代码 | 未开源 |
| 发布 | 2026年2月 |
| 许可 | 未明确 |
| 硬件平台 | AMD MI300A APU (CDNA3, gfx942) |
二、核心思想
问题定义
AMD MI300A APU 集成了 CDNA3 GPU、高带宽内存和先进的加速器特性:FP8 矩阵核心、异步计算引擎(ACE)和 2:4 结构化稀疏。这些特性被现代 HPC 和 HPC-AI 工作负载越来越依赖,但其执行特性和系统级影响仍未被充分理解。
解决方案概述
本文采用以执行为中心的特征分析方法,使用针对性微基准测试来表征 MI300A 上的三大关键特性:
- FP8 矩阵核心: 占用率阈值、形状依赖、并发执行行为
- 异步计算引擎 (ACE): 并发效率、公平性、资源竞争
- 结构化稀疏: 开销摊销、上下文相关收益
核心发现
- FP8 需要高占用率: FP8 达到峰值吞吐量需要 256+ wavefronts(高于 FP16 的 192 和 FP32 的 128)
- 并发执行效率: 4 个流时效率 43-46%,8 个流时 64-65%
- 稀疏收益有限: 编码开销 3.5-5.8 µs 无法摊销,加速比接近 1.0×
三、技术架构
MI300A 架构
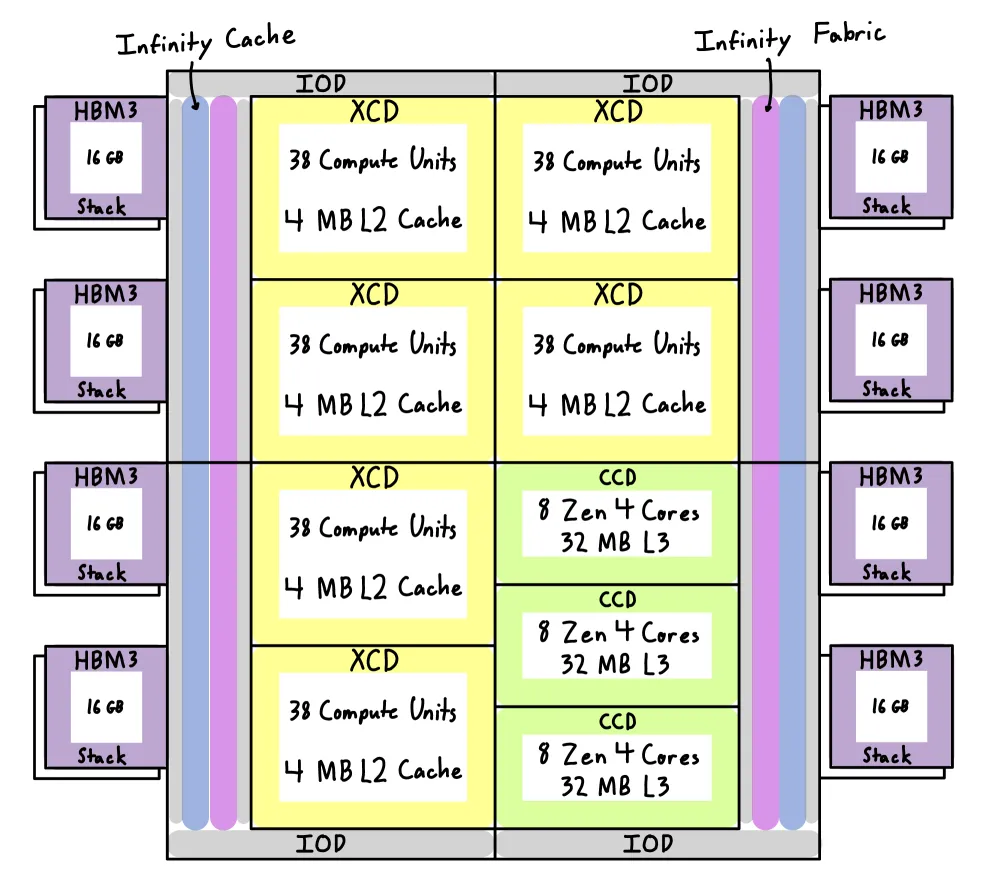
Figure 1: MI300A 架构:FP8 矩阵核心和 ACE
MI300A 配置:
- 24 个 Zen4 CPU 核心
- 6 个 CDNA3 GPU 计算芯片 (XCD)
- 128 GB 共享 HBM3 内存
- 每个 XCD 包含多个计算单元 (CU)
- 每个 CU 包含矩阵核心 (MFMA 单元)、向量 ALU、LDS 内存
MFMA 指令
| 精度 | Tile 大小 | 说明 |
|---|---|---|
| FP64 | 16×16×4 | 双精度矩阵乘累加 |
| FP32 | 32×32×1 | 单精度矩阵乘累加 |
| FP16/BF16 | 16×16×4 | 半精度矩阵乘累加 |
| FP8 | 16×16×32 | FP8×FP8,FP32 累加 |
核心公式
MFMA 操作:
其中 , ,
算术强度:
四、FP8 矩阵核心特征
占用率与吞吐量
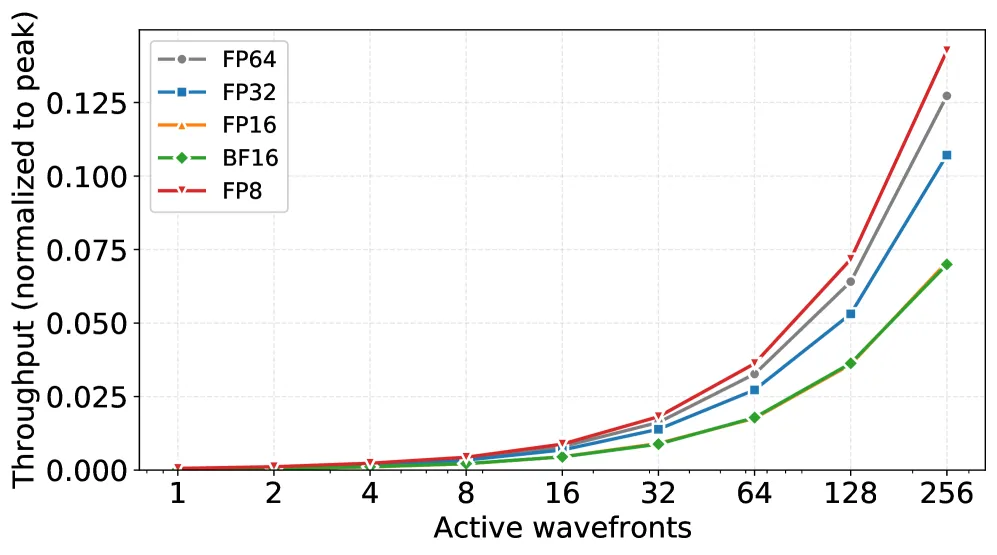
Figure 2: 吞吐量与活跃 wavefronts 数量的关系(归一化到峰值)
关键发现:
| 精度 | 峰值占用率阈值 | 说明 |
|---|---|---|
| FP32 | 128 wavefronts | 较低占用率即可达峰值 |
| FP16/BF16 | 192 wavefronts | 中等占用率需求 |
| FP8 | 256+ wavefronts | 最高占用率需求 |
反直觉结果: FP8 虽然算术强度是 FP16 的 2×,但需要更高占用率才能达峰值。原因:
- 矩阵核心退役 FP8 操作的速度快于内存供应数据
- 需要更多在飞 wavefronts 来隐藏延迟
矩阵形状敏感性
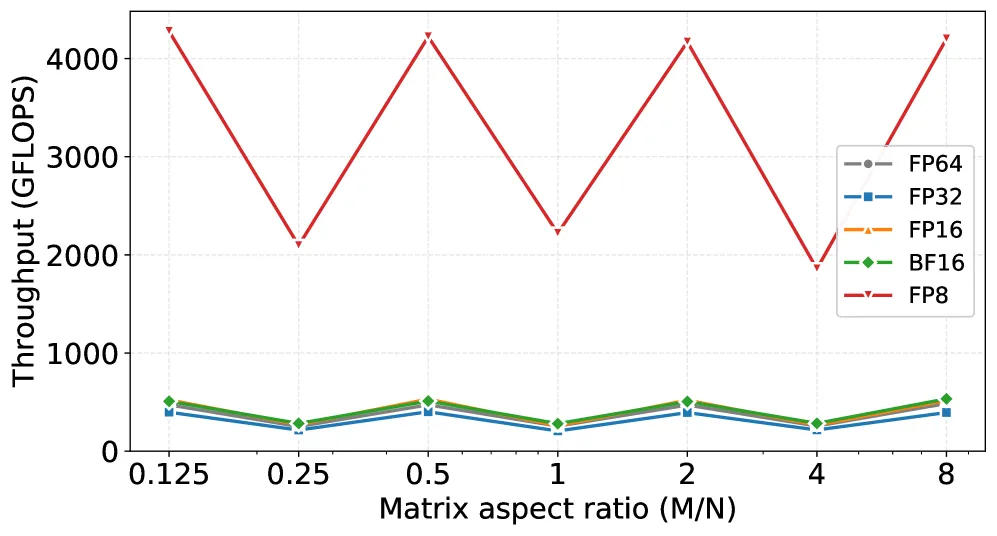
Figure 3: 绝对吞吐量 (GFLOPS) 与矩阵纵横比的关系
- 小问题尺寸下 FP8 矩阵核心利用率不足
- 中等维度时吞吐量达到峰值
- 纵横比影响跨精度可比
五、异步计算引擎 (ACE) 特征
并发扩展
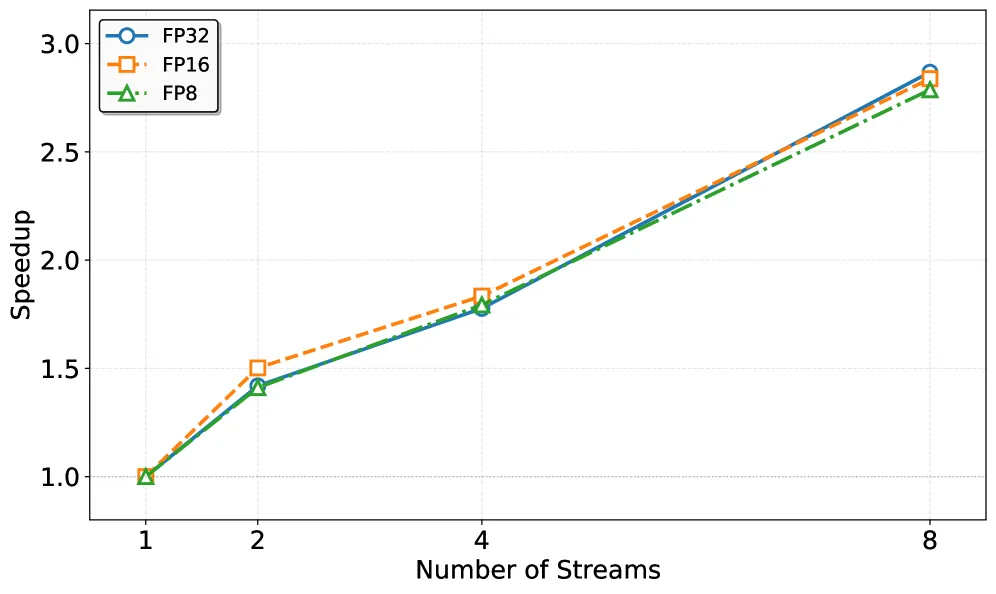
Figure 4: 加速比与并发流数量的关系(FP32, FP16, FP8 GEMM 512³)
| 并发流数 | 重叠效率 | 加速比 |
|---|---|---|
| 4 | 43-46% | 1.78-1.83× |
| 8 | 64-65% | 2.79-2.87× |
公平性与竞争
关键观察:
- 并发执行提高聚合吞吐量
- 但单个流可能经历不平衡执行
- 资源竞争导致公平性下降
资源竞争效应
| 资源 | 竞争影响 |
|---|---|
| L2 缓存 | 并发流数增加导致缺失率上升 |
| LDS | 占用率和流数共同影响利用率 |
| 共享内存 | 高并发下成为瓶颈 |
六、结构化稀疏特征
编码开销
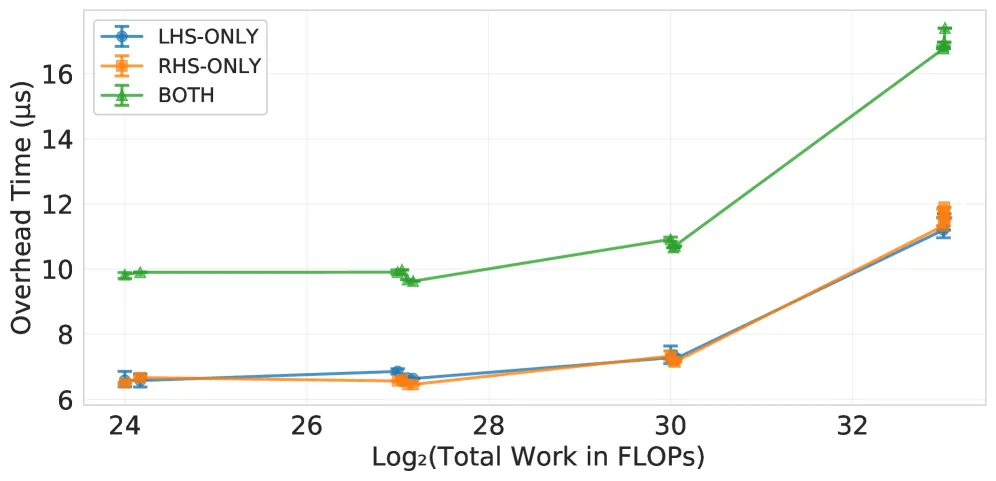
Figure 10: 稀疏编码开销与矩阵大小的关系
关键发现:
- 编码开销恒定在 3.5-5.8 µs
- 无法通过增大问题尺寸摊销
- 计算节省被开销抵消
稀疏加速比
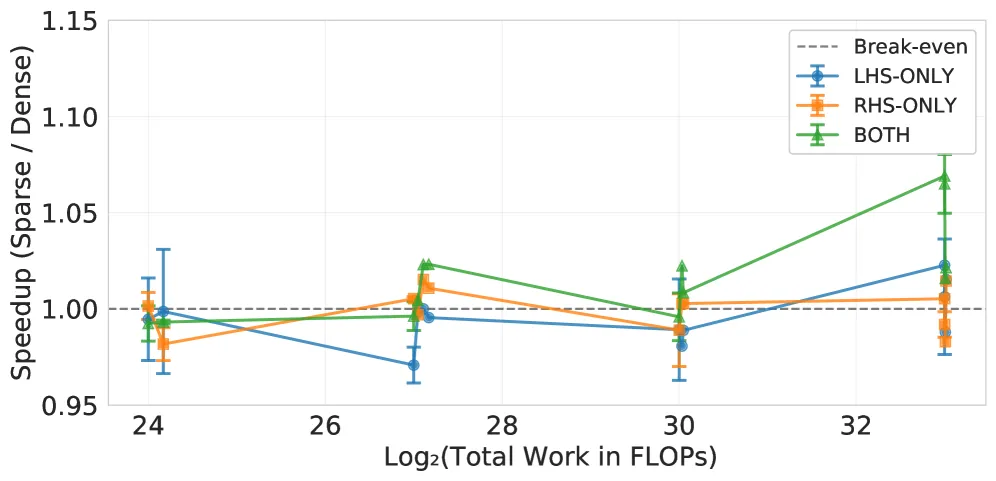
Figure 11: 稀疏加速比与矩阵大小的关系
| 配置 | 加速比 | 说明 |
|---|---|---|
| 所有尺寸 | ~1.0× | 接近盈亏平衡 |
| 60 种配置 | 绿色 (1.0×) | 确认盈亏性能 |
2:4 稀疏模式:
- 每 4 个连续元素中 2 个为零
- 减少 50% 计算
- 保持规则内存访问模式
稀疏在资源竞争下的表现
并发场景下的稀疏:
- 公平性随并发流数变化
- 聚合吞吐量受竞争影响
- 单流加速比接近 1.0×
七、应用内核案例
Transformer 风格推理
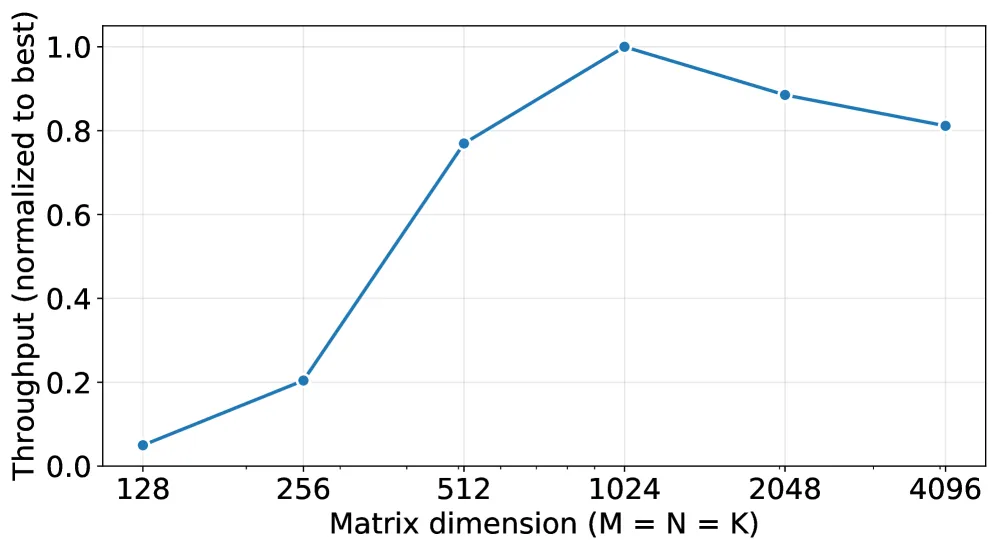
Figure 14: Transformer 风格 FP8 GEMM 内核的归一化吞吐量
关键观察:
- 小问题尺寸下 FP8 矩阵核心利用率不足
- 中等维度时吞吐量峰值
- 稀疏执行在小尺寸下改善性能
并发 FP8 工作负载
- 两个 FP8 工作负载并发执行
- 聚合吞吐量提升
- 单流执行时间分布
混合精度执行
- FP32 → FP16 → FP8 序列执行
- 每操作执行时间按精度变化
- 精度切换开销
八、核心洞察与实践指导
关键洞察
| 洞察 | 说明 | 实践影响 |
|---|---|---|
| FP8 需要高占用率 | 256+ wavefronts 才能达峰值 | batch size 32 仅 128 wavefronts,FP8 利用率仅 7% |
| 并发效率有限 | 4 流 43-65% 效率 | 不要假设线性扩展 |
| 稀疏收益有限 | 编码开销无法摊销 | 当前实现下稀疏加速接近 1.0× |
| 公平性问题 | 并发流可能不平衡 | 需要调度感知 |
实践指导
占用率感知调度
FP8 峰值需要 256+ wavefronts
MI300A 110 CUs × 2 wavefronts/CU = 220 wavefronts(理论最大)
实际需要更大 batch size 或更多并发流
并发决策
- 4 个并发流:1.78-1.83× 加速
- 8 个并发流:2.79-2.87× 加速
- 考虑公平性和资源竞争
稀疏启用
- 当前实现下稀疏加速接近 1.0×
- 编码开销 3.5-5.8 µs 无法摊销
- 需要硬件或软件优化来改善
九、总结
核心贡献
- 执行特征分析: 首次系统性分析 MI300A 上 FP8 矩核、ACE、稀疏的执行特性
- 占用率阈值: 发现 FP8 需要 256+ wavefronts 的反直觉结果
- 并发效率: 量化 ACE 的重叠效率和公平性权衡
- 稀疏收益: 揭示结构化稀疏在 MI300A 上的有限收益
- 实践指导: 提供调度、并发、稀疏启用的实用建议
技术影响
- 调度优化: 占用率感知调度对 FP8 性能至关重要
- 并发策略: 合理设置并发流数以平衡效率和公平性
- 稀疏评估: 需要重新评估结构化稀疏在 AMD 平台上的价值
- 应用设计: 小 batch size 场景下 FP8 优势有限
局限性
- 仅关注单 GCD 执行
- 微基准测试隔离特定行为
- 结果特定于 MI300A
十、参考资源
- 论文: arXiv:2602.10262
- PDF: arXiv PDF
- HTML: arXiv HTML
- 硬件: AMD MI300A APU (CDNA3, gfx942)
- 软件: ROCm 7.2.0, hipcc, rocBLAS, rocSPARSE