RL-VLA³: A Flexible and Asynchronous Reinforcement Learning Framework for VLA Training
面向VLA训练的灵活异步强化学习框架
RL-VLA³: A Flexible and Asynchronous Reinforcement Learning Framework for VLA Training
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | RL-VLA³: A Flexible and Asynchronous Reinforcement Learning Framework for VLA Training |
| 作者 | Haoran Sun, Yongjian Guo, Zhong Guan, Shuai Di, Xiaodong Bai, Jing Long, Tianyun Zhao, Mingxi Luo, Hongke Zhao, Likang Wu, Xiaotie Deng, Xu Chu, Xi Xiao, Sheng Wen, Yicheng Gong, Junwu Xiong |
| 论文 | https://arxiv.org/abs/2602.05765 |
| 发布 | 2026-02-05 (v1), 2026-04-07 (v2) |
| 类别 | cs.AI |
核心亮点
- 首个面向VLA训练的全异步分布式RL框架
- 85.2%吞吐量提升:相比同步基线,保持相同的样本效率
- 8到256 GPU可扩展性:已验证
- 动态批处理调度器:智能聚合请求,消除Generator流水线气泡
- 灵活环境分片:细粒度环境批次分片,适配不同仿真器特性
- 支持多种VLA架构:π₀、π₀.₅、GR00T N1.5、OpenVLA-OFT
- 支持多种RL算法:PPO、GRPO
二、核心思想
问题定义
VLA训练与传统LLM RL训练有本质区别:
- 仿真器延迟高且可变:物理仿真器(如ManiSkill)引入高度可变、资源密集的延迟。例如π₀.₅模型生成640个动作需要99秒,而仿真器计算下一状态需要222秒
- 仿真器资源模式多样:有些GPU加速(ManiSkill),有些CPU密集(LIBERO/Meta-World),有些混合(RoboCasa)
- 同步框架效率低:现有RL框架(RLinf、SimpleVLA)继承LLM同步设计,将整个rollout作为不可分割单元,导致严重的同步开销
同步rollout的问题:
- 等待所有Simulator完成环境步进后才收集observations形成统一推理批次
- 长尾延迟被放大(最慢的环境批次拖慢整体)
- Generator和Trainer严格交替执行,无法重叠
解决方案概述
RL-VLA³提出全异步分布式RL框架,将架构明确分离为三个资源组:
- Simulator:运行物理仿真环境,生成observations
- Generator:加载VLA模型,执行动作推理
- Trainer:执行策略梯度计算和参数更新
核心创新:
- 三个资源组完全异步独立运行
- 动态批处理调度器智能聚合请求
- 细粒度环境分片策略
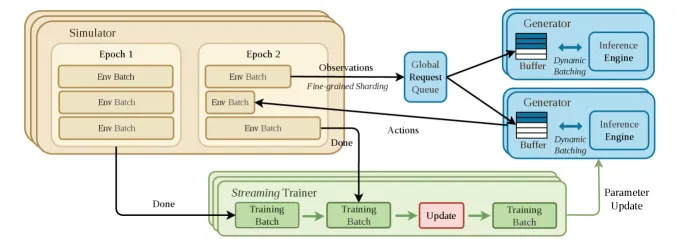
Figure 1: RL-VLA³整体架构。Generator、Simulator和Trainer完全异步交互;黑色箭头表示数据流。使用细粒度环境批次分片和动态批处理的Generator推理来适配异步交互和rollout,提升吞吐量。
三、技术架构
3.1 整体框架
三资源组定义:
| 资源组 | 功能 | 配置 |
|---|---|---|
| Simulator | 运行物理仿真环境,生成observations | 用户可配置并行环境数量和分组 |
| Generator | 加载VLA模型,执行动作推理 | 独立推理引擎,支持动态批处理 |
| Trainer | 策略梯度计算和参数更新 | 专注于策略优化 |
执行流程:
pipeline (Left):
  初始化rollouts
  循环收集完成的轨迹进行优化
  管理模型版本同步

collect_rollout (Right):
  启动Simulator处理(生成observations)
  通过动态批处理调度器触发Generator推理
  异步交互减少阻塞时间
3.2 异步Rollout
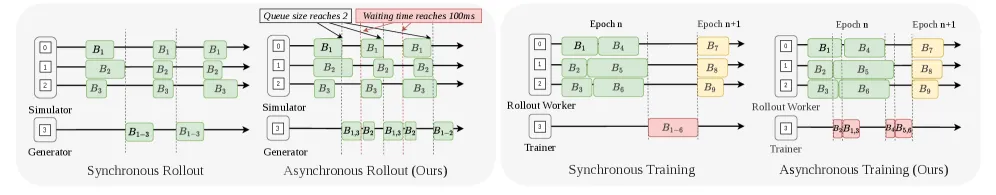
Figure 3: 异步Rollout(左)和异步Training(右)演示。引入动态批处理调度器将请求聚合并触发Generator推理。
同步 vs 异步Rollout:
| 特性 | 同步 | 异步 |
|---|---|---|
| Simulator完成 | 全部完成后统一收集 | 单个完成后立即发送到请求队列 |
| Generator触发 | 等待统一批次 | 动态批处理调度器独立触发 |
| 长尾延迟 | 放大(最慢拖慢整体) | 吸收(快的先处理) |
| GPU利用 | 低(频繁等待) | 高(持续工作) |
3.3 动态批处理调度器
两个正交约束:
- 最大批大小:队列大小达到阈值时触发推理
- 最大等待延迟:最旧请求超过延迟限制时触发推理
设计目标:
- 消除Generator流水线气泡
- 通过优化推理批大小提升吞吐量
- 适配不同仿真器的延迟特性
3.4 细粒度环境分片
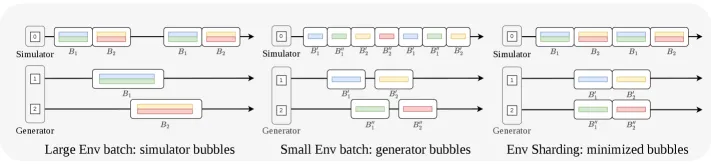
Figure 4: 细粒度环境分片实现并行交互。将并行环境批次分片为多个slot,分配到不同Generator。保持大批量的高吞吐量同时减少Simulator等待时间。
分片策略:
- 用户可配置分片策略
- 默认请求队列按slot到达时间排序(优先队列)
- 支持自定义排序函数
- 将环境批次分片为多个slot,分配到不同Generator
3.5 异步Training
异步训练机制:
- 完成的轨迹异步传输到Trainer
- Trainer持续进行策略优化,不等待rollout完成
- 模型版本同步在更新epoch满足全局条件时管理
Table 1: 不同异步级别的消融研究
| 配置 | LIBERO (8GPU) | LIBERO (16GPU) | LIBERO (32GPU) | RoboCasa (8GPU) | MetaWorld (8GPU) |
|---|---|---|---|---|---|
| Baseline (同步) | 162.75 | 307.84 | 457.23 | 379.25 | 92.29 |
| + Rollout Async | 229.68 (+41%) | 441.49 (+43%) | 737.46 (+61%) | 437.60 (+15%) | 113.62 (+23%) |
| + Rollout & Train Async | 383.40 (+136%) | 713.38 (+132%) | 1120.91 (+145%) | 505.68 (+33%) | 166.94 (+81%) |
3.6 GPU放置策略
| 策略 | 说明 | 适用场景 |
|---|---|---|
| Colocated | 单GPU时间共享Simulator、Generator、Trainer | 资源有限 |
| Hybrid | 每GPU托管Trainer + Simulator或Generator | 充足资源 |
四、实验结果
4.1 实验设置
VLA模型:
| 模型 | 类型 | 说明 |
|---|---|---|
| π₀ | 扩散模型 | Physical Intelligence |
| π₀.₅ | 扩散模型 | Physical Intelligence |
| GR00T N1.5 | 扩散模型 | NVIDIA |
| OpenVLA-OFT | 自回归模型 | 动作块预测 |
仿真环境:
| 环境 | 物理引擎 | GPU利用 | 特点 |
|---|---|---|---|
| LIBERO | MuJoCo (CPU) | 无 | CPU密集 |
| ManiSkill | GPU光线追踪 | 高 | GPU加速 |
| Meta-World | MuJoCo (CPU) | 无 | CPU密集 |
| RoboCasa | Robosuite | 混合 | CPU+GPU混合 |
RL算法:PPO、GRPO
4.2 单节点吞吐量
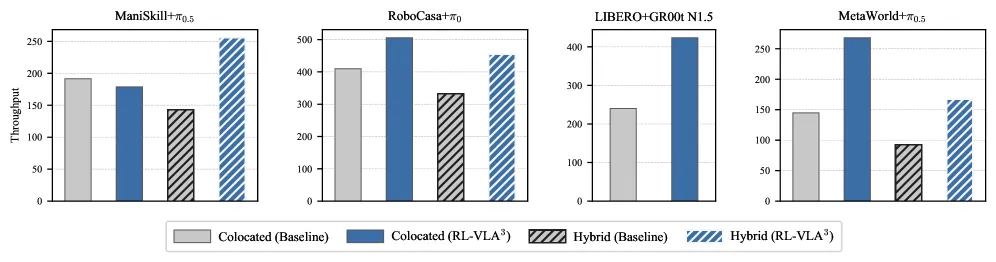
Figure 5: 单节点(8-GPU)RL-VLA³与同步基线在不同骨干模型、环境和放置策略下的吞吐量。RL-VLA³在所有设置中均达到最高吞吐量。
Hybrid放置下的吞吐量提升:
| 环境 | 提升 |
|---|---|
| ManiSkill | +78.6% |
| RoboCasa | +36.7% |
| Meta-World | +80.9% |
4.3 成功率曲线
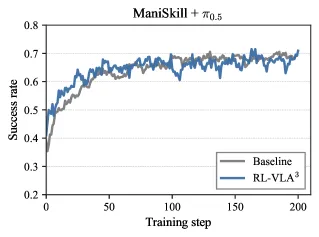
Figure 6: ManiSkill+π₀.₅、LIBERO+OpenVLA-OFT和Meta-World+π₀.₅在同步基线vs RL-VLA³下的成功率曲线。轨迹在环境步数上对齐,确认相当的样本效率,而RL-VLA³的更高吞吐量显著减少了达到相当成功率的墙上时间。
关键发现:
- RL-VLA³与同步基线的样本效率完全相同
- 达到相同成功率的墙上时间大幅减少
- 最高85.2%吞吐量提升
4.4 可扩展性
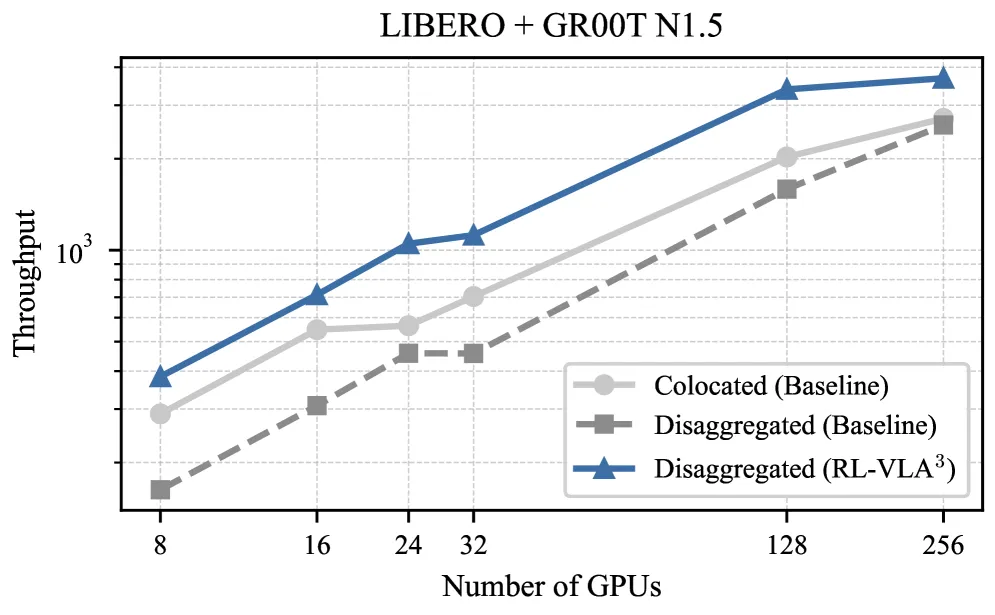
Figure 7: LIBERO+GR00T N1.5在多种放置模式下的吞吐量vs GPU数量的扩展行为。
扩展结果:
- 从8到256 GPU线性扩展
- Hybrid放置模式在大规模下表现更优
- 通信开销在极端规模下成为瓶颈
4.5 调度器参数影响
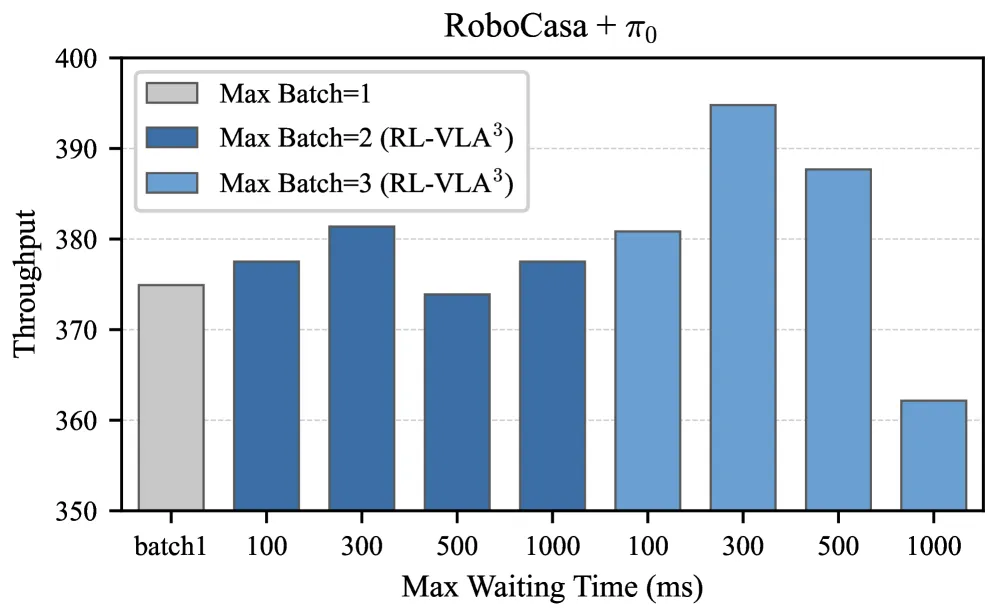
Figure 8: RoboCasa+π₀在Hybrid放置下改变动态批处理调度器的最大批数和延迟阈值时的吞吐量。
参数调优:
- 最大批大小:影响推理效率和延迟
- 最大等待延迟:影响响应性和吞吐量
- 需要根据具体环境特性调优
五、核心创新总结
| 创新点 | 说明 | 效果 |
|---|---|---|
| 全异步架构 | Simulator、Generator、Trainer完全异步独立运行 | 消除同步阻塞,吞吐量提升最高85.2% |
| 动态批处理调度器 | 最大批大小+最大等待延迟双约束 | 消除Generator流水线气泡 |
| 细粒度环境分片 | 环境批次分片为slot,分配到不同Generator | 减少Simulator等待时间 |
| 灵活配置接口 | 用户可配置分片策略、排序函数、批处理参数 | 适配不同仿真器特性 |
| VLA特有设计 | 针对物理仿真器的高延迟和资源异构性 | 解决LLM RL框架无法处理的仿真器瓶颈 |
六、与现有方法对比
| 框架 | 异步Rollout | 异步Training | 环境分片 | 动态批处理 | VLA专用 |
|---|---|---|---|---|---|
| SimpleVLA | × | × | × | × | ✓ |
| RLinf | × | × | 部分 | × | ✓ |
| VeRL (LLM) | ✓ | ✓ | × | × | × |
| AReaL (LLM) | ✓ | ✓ | × | × | × |
| RL-VLA³ | ✓ | ✓ | ✓ | ✓ | ✓ |
七、总结
核心贡献
- 首个面向VLA训练的全异步分布式RL框架
- 动态批处理调度器:智能聚合请求,消除流水线气泡
- 细粒度环境分片:灵活适配不同仿真器特性
- 全面评估:4个仿真环境、4个VLA模型、2个RL算法、8-256 GPU
- 85.2%吞吐量提升:保持相同样本效率
- 8到256 GPU可扩展性验证
技术影响
- VLA训练加速:显著减少RL后训练的墙上时间
- 仿真器适配:灵活接口适配不同物理仿真器特性
- 资源利用优化:异步设计最大化GPU利用率
- 具身AI民主化:降低VLA RL训练的资源门槛
局限性
- 通信开销:极端规模(256+ GPU)下通信成为瓶颈
- 参数调优:动态批处理调度器参数需要根据环境特性手动调优
- 代码未开源:论文提到代码将很快发布
- 单一训练算法:主要验证PPO和GRPO,其他RL算法待验证
- 仿真器兼容性:仅验证4个仿真环境,更多仿真器待测试
八、参考资源
- 论文: https://arxiv.org/abs/2602.05765
- RLinf: 基础代码框架(Zang et al., 2025)
- ManiSkill: GPU加速仿真环境
- LIBERO: CPU密集仿真环境
- RoboCasa: 混合计算仿真环境
- Meta-World: CPU密集仿真环境