Double-P: Hierarchical Top-P Sparse Attention for Long-Context LLMs
基于分层 Top-p 的稀疏注意力框架,通过聚类级估计 + Token 级自适应分配优化长上下文 LLM 推理
Double-P: Hierarchical Top-P Sparse Attention for Long-Context LLMs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Double-P: Hierarchical Top-P Sparse Attention for Long-Context LLMs |
| 作者 | Wentao Ni, Kangqi Zhang, Zhongming Yu, Oren Nelson, Mingu Lee, Hong Cai, Fatih Porikli, Jongryool Kim, Zhijian Liu, Jishen Zhao |
| 机构 | PRISM Center (SRC JUMP 2.0), UC Berkeley / Intel / NEC Research |
| 论文 | arXiv:2602.05191 |
| 代码 | — (未开源) |
| 发布 | 2026-02-05 (ICML 2026) |
核心贡献:
- 发现固定预算的 token-level Top-p 方法(如 Twilight)存在两大根本局限——估计不可靠且开销高
- 提出 Double-P 分层 Top-p 框架:Stage 1 在聚类级别进行粗粒度注意力质量估计,Stage 2 自适应分配 token 级注意力
- 设计高效 GPU kernel:融合 Top-p 选择、Token & 聚类收集、以及基于 RetroInfer 加权 FlashAttention 的稀疏注意力计算
- 在 LLaMA3.1-8B 和 Qwen3-8B 上验证,注意力级加速最高 1.78×,端到端解码加速最高 1.26×,精度损失接近零
二、核心思想
问题定义
长上下文 LLM 在自回归解码阶段,注意力计算受限于不断增长的 KV cache。现有稀疏注意力方法面临以下挑战:
- Top-k 固定预算的固有缺陷:不同 attention head、layer 和解码步骤的注意力分布差异巨大。固定预算无法同时适应聚焦型(peaked)和弥散型(flat)分布,导致 over-selection 或 under-selection。
- Token-level Top-p 的估计开销:Twilight 等 token-level top-p 方法需要对所有 token 计算注意力分数(通过 SpGEMV),该估计开销占总解码时间的很大比例,即使后续大幅剪枝也无法消除。
- 固定预算 Top-p 的不可靠性:即使在 top-p 框架下使用固定候选预算, empirical 数据显示 91.9% 的样本无法达到目标注意力质量 p=0.95。
解决方案概述
Double-P 采用双层分层 Top-p 架构:
- Stage 1(聚类级 Top-p):对 KV cache 执行 k-means 聚类,使用聚类质心 + 大小加权的注意力质量估计,通过 Top-p 选择关键聚类集合。该步骤将复杂度从 O(N) 降至 O(K),K 为聚类数(通常远小于 N)。
- Stage 2(Token 级自适应 Top-p):对 Stage 1 选中的聚类,根据近似误差的长尾分布特性,自适应地分配 token 级精确注意力。高影响聚类使用精确 token 级计算,低影响聚类使用质心近似。
三大技术洞察
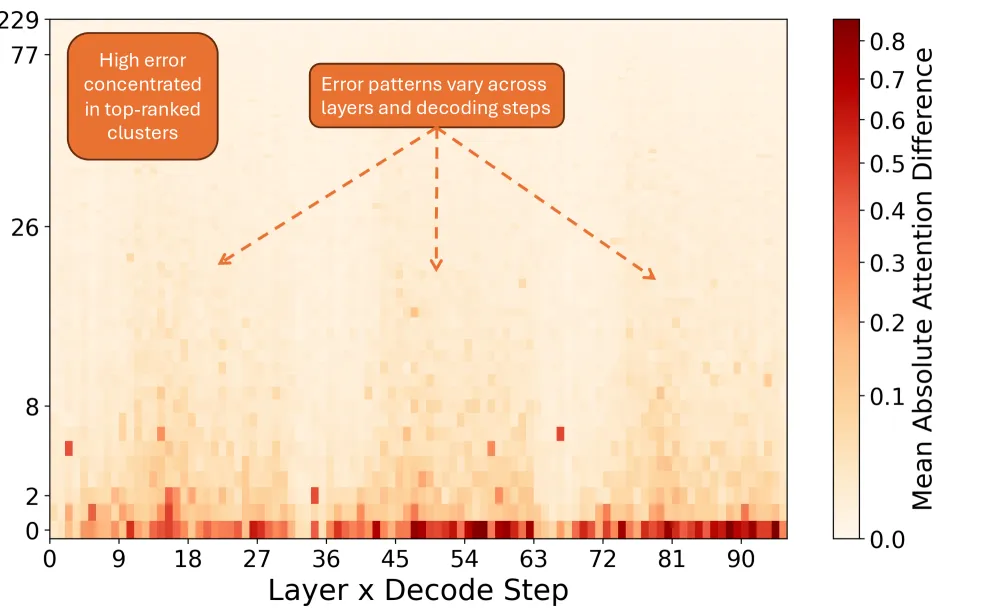
- 洞察 1:聚类级注意力估计的误差呈强长尾分布——少数聚类贡献了大部分近似误差,大多数聚类的质心近似足够精确(Fig. 6)。
- 洞察 2:满足固定误差阈值所需的最小聚类数在不同 layer 和解码步骤间波动显著,固定预算无法适配这种动态变化(Fig. 7)。
- 洞察 3:Stage 1 的聚类级估计开销极小(仅需 K 个质心的点积),相比 Stage 2 的 token 级节省,整体获得净加速。
三、技术架构
整体框架
Double-P 包含三个阶段:
- Prefilling:对输入 prompt 的 KV cache 执行 k-means 聚类,构建聚类质心和值聚合
- Stage 1:解码时基于聚类质心进行粗粒度 Top-p 估计,选择关键聚类
- Stage 2:对选中聚类进行自适应 token 预算分配,混合精确 token 级和质心近似计算
核心公式
Prefilling — 聚类构建(Eq. 2)
给定 KV 矩阵 ,对 key 向量 执行 k-means 聚类。对每个聚类 :
其中 是聚类 中的 token 集合, 是聚类大小, 是第 个 token 的值向量。
聚类表示包括:质心 、大小 、值求和 、值均值 。
Stage 1 — 聚类级注意力质量估计(Eq. 3-7)
给定查询向量 ,聚类 的注意力 logit:
其中 是精确 token 级 logit, 是基于质心的近似。
精确聚类质量:
使用质心 logit 缩放聚类大小的近似:
归一化得到聚类级注意力分布估计:
对聚类应用 Top-p 选择(按 降序排列):
Stage 2 — 自适应 Token 预算分配(Eq. 8-9)
对 Stage 1 选中的聚类,进一步分为两个不相交集合:
- :分配精确 token 级注意力的聚类
- :使用质心近似的聚类
共享注意力质量归一化:
最终注意力输出为精确和近似贡献的混合:
两种 Top-p 阈值
Double-P 有两个独立的 top-p 阈值:
- :Stage 1 聚类级 Top-p 阈值,控制保留的聚类注意力质量
- :Stage 2 Token 级 Top-p 阈值,控制精确 token 级计算的聚类比例
量化位宽与聚类配置
| 组件 | 说明 | 关键参数 |
|---|---|---|
| k-means 聚类 | 对 KV cache 的 Key 向量聚类 | 聚类数 K(由模型决定) |
| Stage 1 Top-p | 聚类级注意力质量选择 | (LLaMA), (Qwen3) |
| Stage 2 Top-p | 精确 token vs 质心近似选择 | (LLaMA), (Qwen3) |
| Sink tokens | 永久保留的起始 token | 4 tokens |
| Sliding window | 最近 token 窗口 | 64 tokens |
运行时开销分析
- :O(K) 复杂度,远低于 Twilight 的 O(N) token-level SpGEMV
- :仅对选中聚类执行,远小于全量 token 级 Top-p
- :混合精确+近似计算,通过自适应预算减少不必要的 token 级注意力
相比 Twilight,Double-P 将 token-level 估计开销(占解码时间 >60%)替换为 cluster-level 近似(O(K)),并在此基础上实现自适应 token 预算分配。
与 Serving System 集成
Double-P 天然适配 PagedAttention 架构,可集成到 vLLM、SGLang 等推理系统。k-means 聚类在 prefill 阶段一次性完成,decode 阶段仅需 O(K) 的聚类级估计。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 分层 Top-p 框架 | 首次将 Top-p 引入聚类级 + Token 级的双层架构 | Fig. 5:Double-P 框架总览 |
| 大小加权聚类质心估计 | 使用 近似聚类质量,无需 token 级计算 | Eq.(5)-(6):将 O(N) 降至 O(K) |
| 自适应精确/近似混合计算 | Stage 2 根据误差长尾分布自适应分配精确 token 级注意力 | Fig. 6-7:误差长尾性和自适应聚类选择 |
| 融合 GPU Kernel | 融合 Top-p 选择、Token&聚类收集、加权 FlashAttention 到统一 kernel | Sec. 4.4:最小化 selection overhead |
| 双阈值灵活控制 | 控制聚类覆盖率, 控制精确计算比例 | Fig. 10:清晰的 accuracy-efficiency trade-off |
五、代码实现分析
实现技术栈:
- PyTorch + CUDA 实现 Double-P kernel
- 基于 FlashAttention 的 tiling 策略
- 集成 RetroInfer 的加权 FlashAttention 变体处理精确 token 和聚类质心
- 自定义 Top-p kernel:直接操作已排序张量,前缀和累加 + early stopping
Note: 代码未开源。
关键实现细节:
- Efficient Top-p:两个阶段的 Top-p 都作用于已排序的注意力分数,使用 prefix-sum accumulation + early stopping 识别满足阈值的最小元素集
- Efficient Token & Cluster Gathering:Stage 2 后融合收集 selected tokens 和 cluster centroids 到一个 kernel,拷贝到连续内存缓冲区,实现 coalesced reads
- Efficient Sparse Attention:使用 RetroInfer 提出的加权 FlashAttention 变体,在 fused buffers 上统一处理精确 token 和近似聚类摘要,避免分离 kernel
六、实验结果
评估设置
模型:LLaMA3.1-8B(32 layers, 32 heads, GQA group size=4, 最长 128K)、Qwen3-8B
硬件:NVIDIA H100 PCIe (80GB), CUDA 12.8, PyTorch 2.8
基线:
- Quest(page-level,page size=16,检索 25% token)
- RetroInfer(cluster-based,固定 top-k clusters)
- Quest + Twilight(Twilight 应用于 Quest 的 token 级 top-p)
Benchmarks:RULER(13 tasks, 4K-128K)、LongBench(21 tasks, 5K-15K avg)
公平比较设置:所有方法保留 sink tokens(4 tokens)和 sliding-window tokens(64 tokens),稀疏注意力仅应用于剩余 middle tokens。
精度评估 — RULER
LLaMA3.1-8B(Table 2):
| 方法 | 16K | 32K | 64K | Avg. |
|---|---|---|---|---|
| Full Attention | 93.25 | 90.00 | 85.36 | 89.54 |
| Quest | 89.24 | 85.95 | 83.61 | 86.27 |
| RetroInfer | 91.56 | 88.12 | 83.77 | 87.82 |
| Quest + Twilight | 86.73 | 86.50 | 81.87 | 85.03 |
| Double-P | 92.87 | 89.91 | 84.55 | 89.08 |
| Δ vs Full | +1.31 | +1.79 | +0.78 | +1.26 |
Double-P 在所有上下文长度上 consistently 最高精度,与 full attention 差距仅 ~0.5%。
Qwen3-8B(Table 3):
| 方法 | 16K | 32K | 64K | Avg. |
|---|---|---|---|---|
| Full Attention | 91.25 | 90.59 | 80.40 | 87.41 |
| Quest | 77.12 | 79.80 | 60.12 | 72.35 |
| RetroInfer | 91.16 | 90.65 | 80.09 | 87.30 |
| Quest + Twilight | 76.69 | 79.50 | 58.59 | 71.59 |
| Double-P | 91.02 | 90.36 | 79.26 | 86.88 |
Qwen3-8B 上使用 ,精度几乎无损。
LongBench(Table 7 附录):
| 方法 | Avg. |
|---|---|
| LLaMA-3.1-8B Full | 39.33 |
| Quest | 38.76 |
| RetroInfer | 39.03 |
| Quest + Twilight | 38.96 |
| Double-P | 39.06 |
Double-P 在所有 LongBench 子任务上保持接近 full attention 的表现。
效率评估
注意力级加速(Fig. 9):
- 现有 top-p 方法中,token-level 估计占总注意力延迟 >60%
- Double-P 通过 cluster-level 近似消除该开销
- 较 Quest-Twilight 最高 1.74× 加速,较 RetroInfer 最高 1.78× 加速
端到端解码加速(Fig. 8):
- 较 Quest 最高 1.11× 加速
- 较 RetroInfer 最高 1.26× 加速
- 较 full attention 最高 2.23× 加速
消融研究
双阈值敏感性分析(Fig. 10):
在 RULER 32K CWE 任务上测试不同 配置:
- 增大 和 → 保留更多注意力质量 → 精度提升但效率下降
- 减小 和 → 更高效率但精度损失
- LLaMA3.1-8B 最佳配置:
- Qwen3-8B 最佳配置:
误差长尾性分析(Fig. 6-7):
- Fig. 6:聚类质心近似的绝对误差呈强长尾分布,少量 top-ranked 聚类贡献大部分误差
- Fig. 7:满足固定误差阈值所需的最小聚类数在不同 layer 和解码步骤间波动显著
- Double-P 的 Stage 2 自适应选择曲线紧密跟踪最小所需聚类数,证明 near-optimal 分配
RULER 详细结果(附录 Tables 4-6)
在 NIAH(Needle-in-a-Haystack)相关任务上,Double-P 表现接近 full attention:
| Task | LLaMA Full | Quest | RetroInfer | Quest+Twi | Double-P |
|---|---|---|---|---|---|
| s1_niah (16K) | 100 | 99 | 100 | 99 | 100 |
| s3_niah (16K) | 100 | 87 | 99.5 | 80.5 | 100 |
| mk3_niah (16K) | 100 | 70 | 96.5 | 69.5 | 98 |
| qa_2 (16K) | 64 | 58 | 55.5 | 54.5 | 54 |
在长上下文(64K)NIAH 任务上,Double-P 同样保持领先。
七、与 Twilight 的对比
| 维度 | Twilight | Double-P |
|---|---|---|
| 估计粒度 | Token-level O(N) | Cluster-level O(K) |
| 预算分配 | 固定候选预算 + Top-p 剪枝 | 双层自适应 Top-p |
| 估计开销 | 高(SpGEMV over all tokens) | 低(仅 K 个质心点积) |
| 精度保证 | 近似 top-p | 严格分层 top-p |
| 加速比(注意力级) | 最高 15.4× vs FA2 | 最高 1.78× vs RetroInfer |
| 加速比(端到端) | 最高 3.9× | 最高 1.26× vs RetroInfer |
| 适用场景 | 通用稀疏注意力框架 | 针对 top-p 优化的专用框架 |
Double-P 的核心优势在于:Twilight 的 token-level 估计开销占总解码时间 >60%,而 Double-P 用 O(K) 的 cluster-level 估计替代,从根本上消除了这一瓶颈。
八、总结
核心贡献
- 分层 Top-p 稀疏注意力:Double-P 首次将 Top-p 引入双层架构,Stage 1 聚类级粗粒度估计 + Stage 2 Token 级自适应分配
- 大小加权聚类质心估计:使用 近似聚类注意力质量,将复杂度从 O(N) 降至 O(K)
- 自适应精确/近似混合计算:基于误差长尾分布,Stage 2 自适应分配精确 token 级和质心近似计算
- 高效 GPU Kernel:融合 Top-p 选择、Token&聚类收集、加权 FlashAttention,最小化 selection overhead
- 全面实验验证:在 LLaMA3.1-8B 和 Qwen3-8B 上验证,RULER 精度提升 +1.26,注意力级加速 1.78×,端到端加速 1.26×
局限性
- 需要预先生成聚类(k-means),增加了 prefill 阶段的少量开销
- 两个超参数 需针对不同模型调整(LLaMA: 0.95/0.7, Qwen3: 0.99/0.8)
- 代码未开源
- 仅在 H100 上评估,未在其他 GPU 架构上验证
未来方向
- 探索自适应聚类数 K 的选择策略
- 将 Double-P 集成到 vLLM/SGLang 等主流推理系统中
- 探索与其他 KV cache 优化方法(量化、PagedAttention)的组合
九、参考资源
- arXiv: 2602.05191
- 相关论文: Twilight (2025), Quest (NeurIPS 2024), RetroInfer (2025), FlashAttention, H2O, SnapKV
- ICML 2026
附图索引
| 编号 | 文件名 | 说明 |
|---|---|---|
| Figure 1 | figure-1-Average_accuracy_and_decode_latency_on_RULER.png | RULER 32K 上不同方法的 accuracy-latency Pareto 前沿 |
| Figure 2 | figure-2-Adaptive_vs_fixed_token_budgets.png | (a) 自适应 vs 固定 token 预算 (b) 固定预算的注意力质量违反率 |
| Figure 3 | figure-3-Violation_rates_across_sparse_attention_budgets.png | 固定预算的注意力质量违反率 |
| Figure 4 | figure-4-Failure_of_fixed_budget_token_level_TopP_estimation.png | 固定预算 token-level Top-p 估计失败案例 |
| Figure 5 | figure-5-Latency_breakdown_of_token_level_top_p_sparse_attention.png | Token-level Top-p 注意力估计的延迟分解 |
| Figure 6 | figure-6-Double_P_framework_overview.png | Double-P 分层框架总览 |
| Figure 7 | figure-7-Heatmap_of_absolute_error_exact_vs_cluster_centroid.png | 精确 token 级与聚类质心近似的绝对误差热力图 |
| Figure 8 | figure-8-Adaptive_cluster_selection_for_bounded_attention_error.png | 自适应聚类选择满足有界注意力误差 |
| Figure 9 | figure-9-Accuracy_drop_and_end_to_end_decoding_latency_on_RULER.png | RULER 上精度损失与端到端解码延迟 |
| Figure 10 | figure-10-Attention_latency_breakdown.png | 注意力延迟分解(Double-P 最小化 estimation overhead) |
| Table 1 | 论文中 Table 1 | Top-p 精度和开销对比表 |
| Table 2 | 论文中 Table 2 | LLaMA3.1-8B 的 RULER + LongBench 精度对比 |
| Table 3 | 论文中 Table 3 | Qwen3-8B 的 RULER + LongBench 精度对比 |
| Table 4 | 论文中 Table 4 | RULER 16K 详细任务结果 |
| Table 5 | 论文中 Table 5 | RULER 32K 详细任务结果 |
| Table 6 | 论文中 Table 6 | RULER 64K 详细任务结果 |
| Table 7 | 论文中 Table 7 | LongBench 详细任务结果 |