Video Understanding: Through A Temporal Lens(面向时间维度的视频理解)
Thong Thanh Nguyen 的博士论文,从时间维度系统性地推进视频理解,围绕三大研究目标(推进边界 / 高效捕获时间 / 有效捕获时间)提出五项贡献:(1) MAMA 用减性角度间隔对比 + 元优化样本加权自动标注海量视频;(2) READ 在轻量适配器瓶颈内嵌 RNN,仅微调适配器即在低资源时间定位/视频摘要上超越全量微调;(3) GSMT 用门控状态空间模型(SSM)对密集采样帧建全局语义,配套 Ego-QA/MAD-QA 长视频问答基准;(4) MCL 用运动感知对比学习 + 强运动 tube 选择做时间全景场景图;(5) MSCL 多尺度跨尺度对比 + 特征金字塔做时间定位;并给出面向时间的 LVLM 训练配方(QueryFormer 接口 + 时间训练方案 + 记忆库 + MoE 四步扩展)。
Video Understanding: Through A Temporal Lens(面向时间维度的视频理解)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Video Understanding: Through A Temporal Lens |
| 作者 | Thong Thanh Nguyen(博士学位论文,单作者) |
| 类型 | PhD Thesis(9 章) |
| 论文 | arXiv:2602.00683(v2, 2026-04-03) |
| 主题 | 视频理解、时间建模、视觉-语言、对比学习、参数高效微调、状态空间模型、LVLM |
一句话总结:本论文以”时间”为主线贯穿视频理解的模型架构、训练策略与数据三个层面,提出从自动数据标注(MAMA)、参数高效时间建模(READ)、三种时间归纳偏置(全局语义 SSM / 运动感知对比 / 多尺度对比),到大型视觉-语言模型(LVLM)面向时间的训练配方,形成一套完整的”如何有效且高效地为视频注入时间理解能力”的方法学。
二、核心思想
问题定义
视频理解应用广泛(娱乐、安防等),但学界缺乏对”模型架构、训练策略、数据”三方面的系统性、贯通性研究。作者归纳出三大共性挑战:(1) 模态内与跨模态交互、(2) 跨域适配、(3) 数据准备。据此在第 2 章构建了从三大挑战出发的清晰分类法(架构 / 训练 / 数据视角)。
三大研究目标(Research Objectives)
| 目标 | 含义 | 对应章节 |
|---|---|---|
| RO1:推进边界 | 用更大规模数据把视频理解性能推向 SOTA | Ch3 MAMA、Ch8 LVLM 配方 |
| RO2:高效捕获时间 | 在低资源/受限算力下高效学习时间表征 | Ch4 READ |
| RO3:有效捕获时间 | 设计有效的时间归纳偏置提升表现力 | Ch5 GSMT、Ch6 MCL、Ch7 MSCL |
五项贡献总览
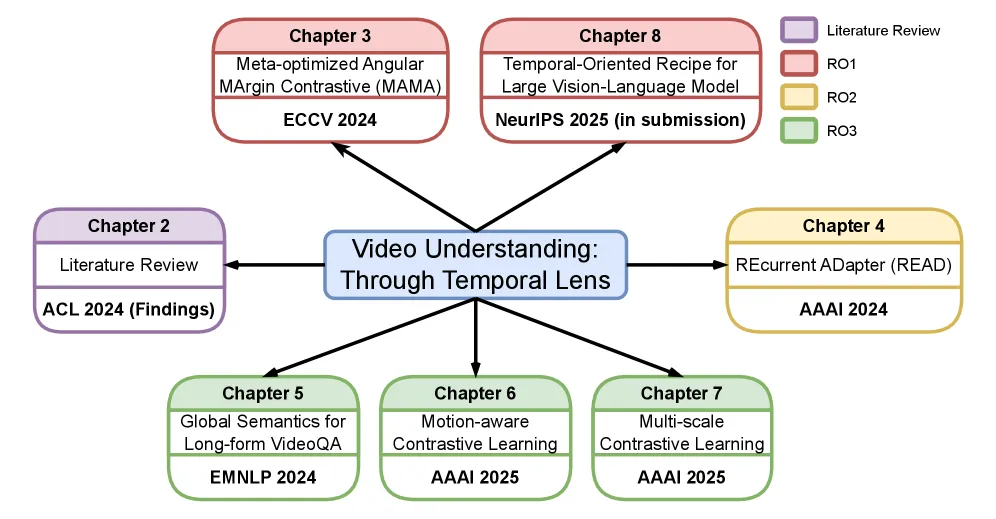
- MAMA(Ch3):减性角度间隔对比学习 + 元优化样本加权,自动标注海量视频,缓解噪声标注影响。
- READ(Ch4):在轻量适配器瓶颈内嵌循环计算(RNN),仅微调适配器,低资源下超越全量微调。
- GSMT(Ch5):门控状态空间模型建模密集采样帧的全局语义,解决长视频下采样丢信息问题。
- MCL(Ch6):运动感知对比学习 + 强运动 tube 选择,做时间全景场景图生成。
- MSCL(Ch7):多尺度跨尺度对比 + 特征金字塔,做视频时间定位(temporal grounding)。
- LVLM 时间配方(Ch8):四步扩展出色时间理解能力的大型视觉-语言模型。
三、Ch3 — MAMA:自动视频标注(RO1 推进边界)
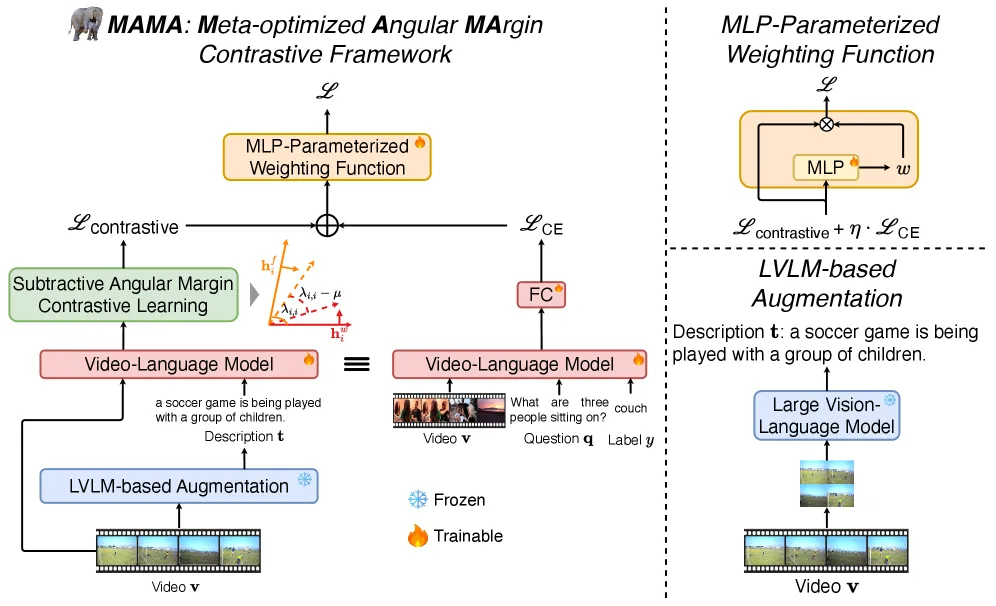
动机:自动标注可扩大训练数据规模,但会引入噪声样本,需在训练时动态抑制其负面影响。
核心方法:
- 减性角度间隔对比学习(Subtractive Angular Margin):在视频-文本对比目标的角度空间中引入间隔 ,收紧正样本对的角度分布,增强判别性。
- 元优化样本加权(Meta-Optimized Sample Weighting):用一个 MLP 学习为每个(可能带噪的)训练样本分配权重;通过元学习(Algorithm 1)在干净元数据 上优化该加权网络,使模型对噪声标注具备动态正则化能力。
效果:在标准视频问答与文本-视频检索基准上超越此前 SOTA。
四、Ch4 — READ:参数高效时间建模(RO2 高效捕获时间)
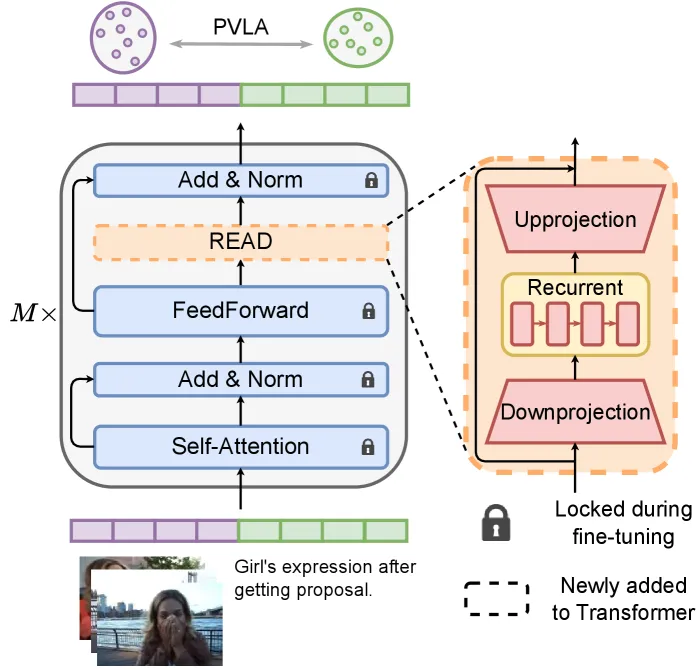
动机:实际中(如隐私/安全敏感领域)常难以获得大规模视频训练数据,需要在低资源下高效微调。
核心方法(Recurrent Adapter):在冻结主干上插入轻量适配器,并在其瓶颈中嵌入循环计算层(RNN),仅在微调时更新适配器:
- 降维到瓶颈 → RNN 沿时间递归 → GELU → 升维回残差流。RNN 让适配器天然携带时序建模能力。
- PVLA(Partial Video-Language Alignment):通过视频-语言对齐目标,驱动任务相关信息流经适配器模块。
效果:在低资源设置的时间定位(temporal grounding)与视频摘要(video summarization)任务上显著超越现有微调策略。
五、Ch5 — GSMT:全局语义状态空间模型(RO3 有效捕获时间)
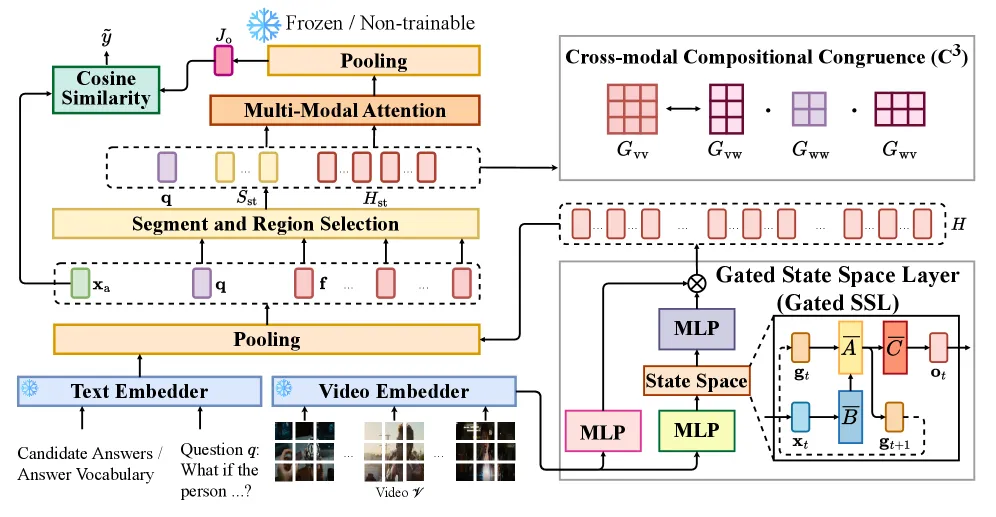
动机:长视频问答近来因把视频帧下采样以适配高算力成本而丢失信息。GSMT 主张对密集采样帧建模全局语义。
核心方法(Gated State Space Model):
- 门控 SSL:以状态空间矩阵 描述序列演化;离散卷积核 经 FFT 高效计算,使长序列建模的显存/算力可控。
- 视频片段与区域选择:对片段与区域做 top- 选择,聚焦信息量高的时空单元。
- C3 训练目标:配套的对比式训练目标。
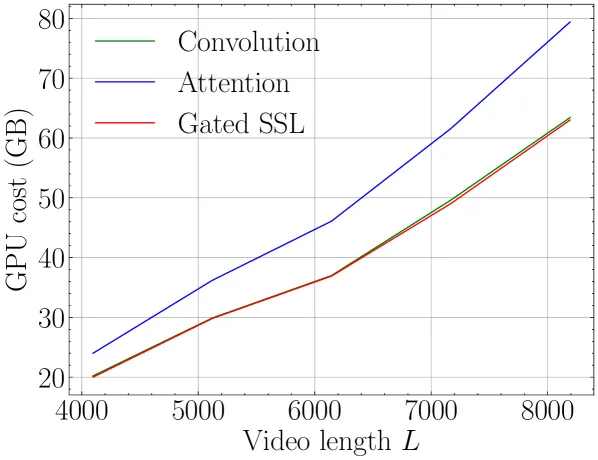
长视频问答基准:作者构建 Ego-QA 与 MAD-QA 两个长视频问答数据集,验证密集帧全局语义对长视频的显著收益。
六、Ch6 — MCL:运动感知对比学习(RO3 有效捕获时间)
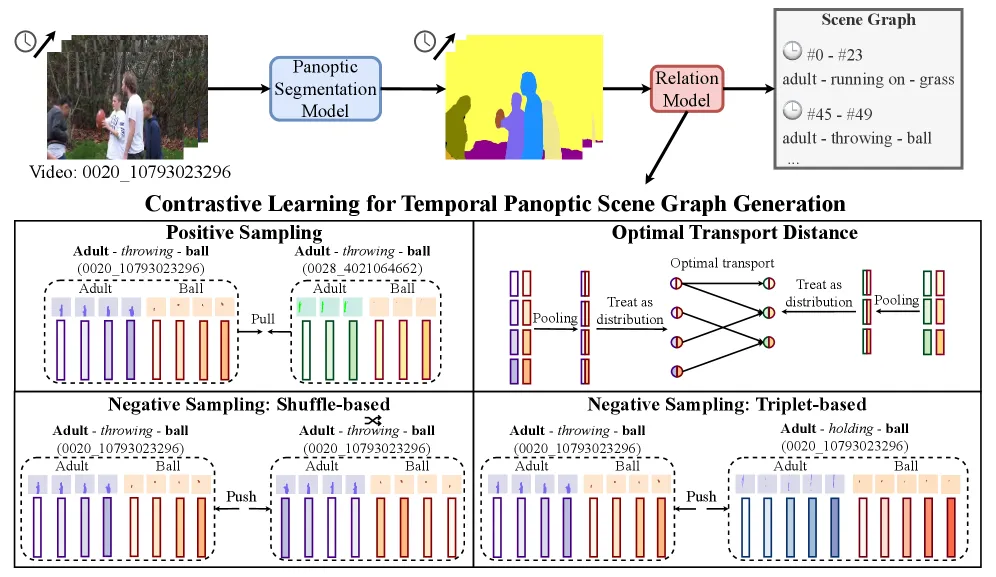
任务:时间全景场景图生成(Temporal Panoptic Scene Graph Generation),需在视频中同时理解全景分割与元素间关系随时间的演化。
核心方法:
- IPS+T vs VPS:对比图像级全景分割 + 时间关联(IPS+T)与视频级全景分割(VPS)两条路线。
- 强运动 tube 选择(Strong-Motion Tubes):优先选择运动显著的 mask tube,聚焦真正携带动态语义的元素。
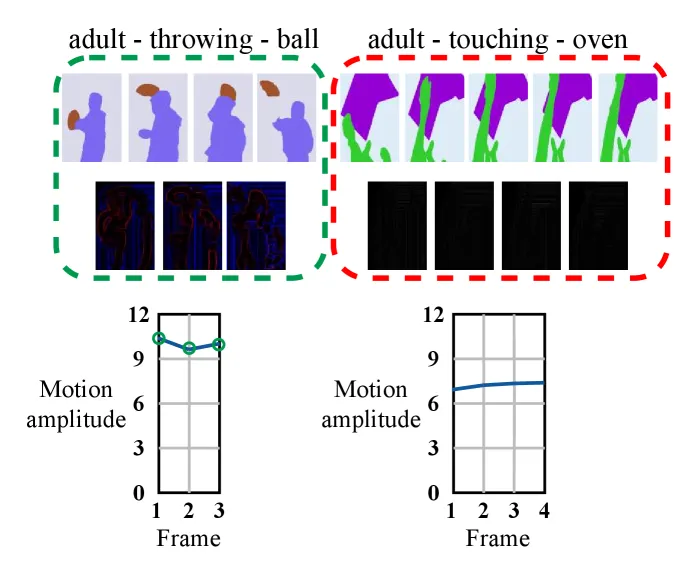
- 最优传输(Optimal Transport):用 OT 建立 mask tube 之间的关系匹配。
- 对比学习:在时间全景场景图上做对比学习,激发视频元素间的互关联语义,提升时间表现力。
七、Ch7 — MSCL:多尺度对比时间定位(RO3 有效捕获时间)
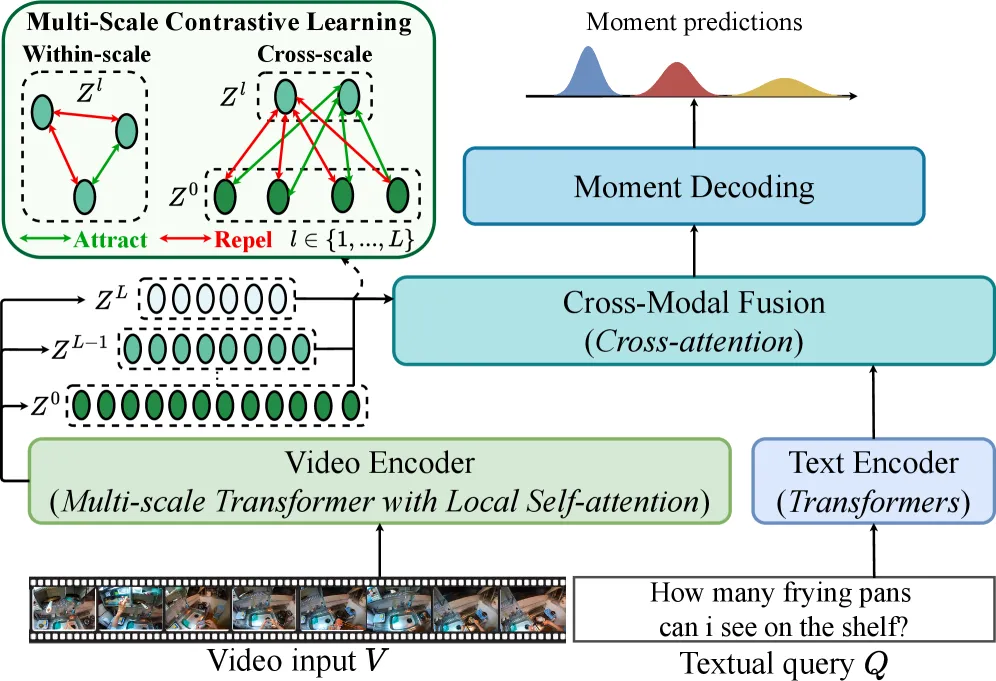
任务:视频时间定位(Video Temporal Grounding)——给定句子查询 ,在视频 中定位时刻 。
核心方法:
- 多尺度视频编码器:卷积投影编码局部上下文后,堆叠 层 Transformer;每层用局部多头自注意力(LocalMSA,窗口 ) + MLP,并用步长深度可分 1D 卷积做下采样 ,逐层生成更长时刻的表征(构成特征金字塔的多尺度性质):
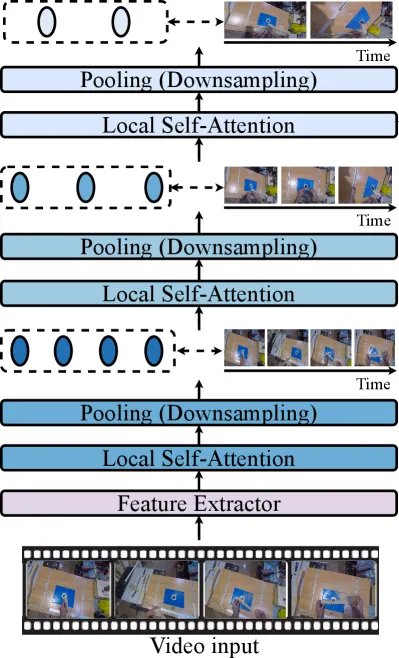
- 跨模态融合:以查询词表征 通过 Softmax 注意力调制各尺度视频表征 。
- 时刻解码:每个时间步经 1D 卷积分类头预测分数 ,回归头预测到边界的归一化距离 ;测试时用 Soft-NMS 合并重叠预测。
- 跨尺度对比学习(Cross-scale Contrastive Learning):查询中心采样(Query-centric Sampling)——从同一视频抽取查询 及其时间上分离的多尺度视频时刻,避免随机采样导致的表征冲突(两查询 grounding 重叠时)。
八、Ch8 — 面向时间的 LVLM 训练配方(RO1 推进边界)
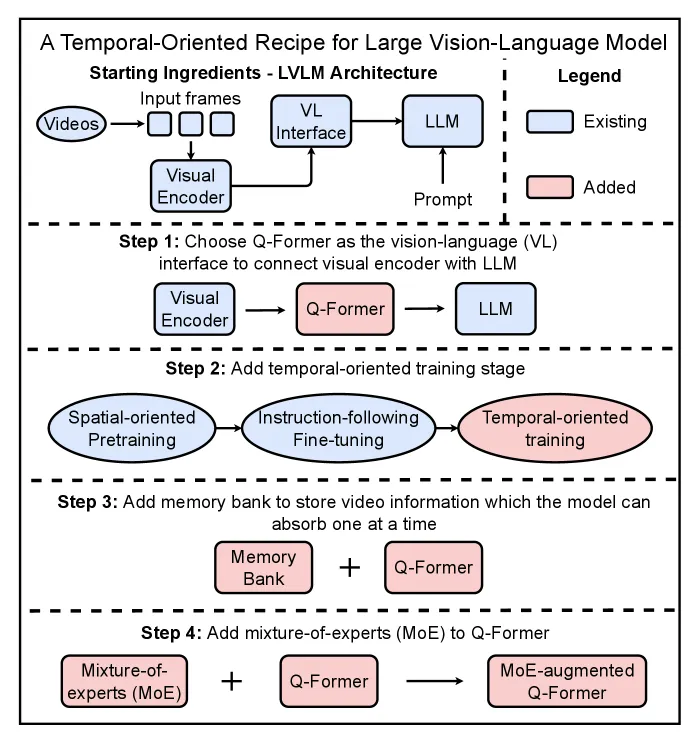
动机:许多视频理解基准存在空间偏置,LVLM 的真实时间理解能力被高估。本章做百科式实证研究,揭示关键组件并给出渐进式扩展配方。
起点(Step 0):ViT-G/14(EVA-CLIP)视觉编码器 + Vicuna-7B/13B LLM,继承图像域预训练与指令微调权重。在 MSRVTT / MSVD / ActivityNet-QA / Breakfast / COIN / LVU 上评测 VideoQA 准确率。
四步渐进扩展(按计算成本从低到高排序):
| 步骤 | 组件 | 关键发现 |
|---|---|---|
| Step 1 | 视觉-语言接口 | Q-Former(QueryFormer)+ ESA 优于线性投影与均值/自适应池化,是编码时间归纳偏置的基础 |
| Step 2 | 时间导向训练方案 | 视频字幕(VC)/ 时刻字幕(MC)/ 时刻定位(MG)/ 视频摘要多方案,彼此互补 |
| Step 3 | 时间记忆库(Memory Bank) | 序列化处理帧并存入记忆库,一致优于池化;7B 最优 、13B 最优 (ActivityNet-QA 从 51.4→52.6,MSRVTT 从 54.5→60.8) |
| Step 4 | Q-Former 上的 MoE | 稀疏 MoE(top-)加在 Q-Former 上比加在 LLM 上更有效;专家数 最佳(MSRVTT 65.0 / LVU 74.5),在保持算力可控下扩展接口容量 |
核心洞见:连接视觉编码器与 LLM 的视觉-语言接口在编码时间归纳偏置中起根本作用,据此提出”QueryFormer 接口 → 时间训练方案 → 记忆库 → MoE 扩接口”的四步配方。
九、核心创新与贡献
| 创新点 | 所属 | 说明 |
|---|---|---|
| MAMA 自动标注 | Ch3 / RO1 | 减性角度间隔对比 + 元优化样本加权,动态正则抑制噪声标注 |
| READ 循环适配器 | Ch4 / RO2 | 瓶颈内嵌 RNN,仅微调适配器即在低资源超越全量微调 |
| GSMT 全局语义 SSM | Ch5 / RO3 | 门控 SSM + FFT 卷积核,密集帧长视频问答;新建 Ego-QA/MAD-QA |
| MCL 运动感知对比 | Ch6 / RO3 | 强运动 tube + 最优传输 + 对比学习,时间全景场景图 |
| MSCL 多尺度对比 | Ch7 / RO3 | 特征金字塔 + 查询中心采样跨尺度对比,时间定位 |
| LVLM 时间配方 | Ch8 / RO1 | QueryFormer 接口 + 时间训练 + 记忆库 + MoE 四步扩展 |
十、局限性与未来方向
- 各方法多在特定任务/基准验证,跨任务统一框架仍待整合;
- LVLM 配方因算力约束无法消融各步骤的顺序(顺序按计算成本从低到高固定);
- 长视频记忆库容量与 MoE 专家数存在收益饱和点,需按模型规模调参;
- 未来方向包括更统一的时间归纳偏置、更强的长时序记忆机制与多模态融合。
十一、参考资源
- 论文:Video Understanding: Through A Temporal Lens (arXiv:2602.00683)
- 关键引用/组件:EVA-CLIP(ViT-G/14)、Vicuna-7B/13B、Q-Former(BLIP-2/VideoChat)、SnAG(多尺度时间定位)、状态空间模型(SSM)、最优传输、Soft-NMS、Latent Dirichlet(MSRVTT 主题分析);数据集 MSRVTT / MSVD / ActivityNet-QA / Breakfast / COIN / LVU / VIDAL-10M / InternVid,及作者自建 Ego-QA / MAD-QA。
- 相关文档:
- Waver: 面向逼真视频生成的统一基础模型(视频生成方向,VideoLLaMA3 质量模型思路可对照)
- LTX-Video: 实时视频潜在扩散模型(视频生成的高效路线)
- HunyuanVideo: 大规模视频生成框架
- Movie Gen: 媒体基础模型全家桶