Advancing Open-source World Models
LingBot-World, an open-sourced world simulator stemming from video generation, featuring minute-level horizon, real-time interactivity, emergent memory, and three-stage evolutionary training pipeline
Advancing Open-source World Models: LingBot-World
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Advancing Open-source World Models |
| 模型名 | LingBot-World |
| 作者 | Zelin Gao*, Qiuyu Wang*, Yanhong Zeng*, Jiapeng Zhu*, Ka Leong Cheng*, Yixuan Li, Hanlin Wang, Yinghao Xu, Shuailei Ma, Yihang Chen, Jie Liu, Yansong Cheng, Yao Yao, Jiayi Zhu, Yihao Meng, Kecheng Zheng, Qingyan Bai, Jingye Chen, Zehong Shen, Yue Yu, Xing Zhu, Yujun Shen, Hao Ouyang* |
| 机构 | Robbyant Team |
| 论文 | https://arxiv.org/abs/2601.20540 |
| 代码 | https://github.com/robbyant/lingbot-world (4055+ stars) |
| 发布 | arXiv:2601.20540, January 28, 2026 |
| 许可 | Apache 2.0 |
| 项目页 | https://technology.robbyant.com/lingbot-world |
| HuggingFace | https://huggingface.co/collections/robbyant/lingbot-world |
| ModelScope | https://www.modelscope.cn/models/Robbyant/lingbot-world-base-cam |
二、核心思想
问题定义
从被动视频生成到主动世界模拟存在根本性差距。当前最先进的视频生成模型虽然能在视觉上呈现高质量的短片段,但本质上仍是”梦想家”而非”模拟器”——它们基于统计相关性幻觉化像素转换,缺乏对因果关系、物体恒常性和交互后果的接地理解。具体挑战包括:
- 高质量交互数据稀缺:与被动网络视频不同,捕捉智能体决策与环境反应之间复杂相互作用的数据极难规模化
- 长horizon一致性:标准扩散架构在分钟级轨迹上维持叙事和结构一致性面临”灾难性遗忘”
- 计算成本高昂:传统扩散采样使实时控制不可能,大多数现有模型仅限于离线渲染
- 闭源壁垒:最先进方案均为专有,阻碍社区创新
解决方案概述
本文提出 LingBot-World —— 一个开源的世界模拟器,从视频生成模型演化而来。基于三大战略支柱:
- 可扩展的数据引擎(分层语义):混合数据源(真实 footage、游戏引擎录制、Unreal Engine 合成数据)+ 分层标注策略(叙事/场景静态/密集时间描述),解耦运动控制与场景生成
- 多阶段进化训练管线:Pre-training(建立通用视频先验)→ Middle-training(MoE 注入世界知识与长期动态)→ Post-training(因果注意力适配 + 少步蒸馏实现实时推理)
- 具身 AI 多样化应用:可提示世界事件、动作代理训练、3D 重建验证几何一致性
核心特性
| 特性 | 说明 |
|---|---|
| 分钟级 horizon | 生成连贯视频序列长达 10 分钟 |
| 实时交互 | 单 GPU 节点 480p 下达到 16 fps,延迟 < 1 秒 |
| 涌现记忆 | 地标即使离开视野 60 秒仍保持结构完整性;能推理未观测状态 |
| 动作条件动态 | 混合动作输入(连续相机位姿 + 离散键盘命令) |
| 开源 | 代码 + 模型权重完全公开(Apache 2.0) |
三、技术架构
整体训练管线
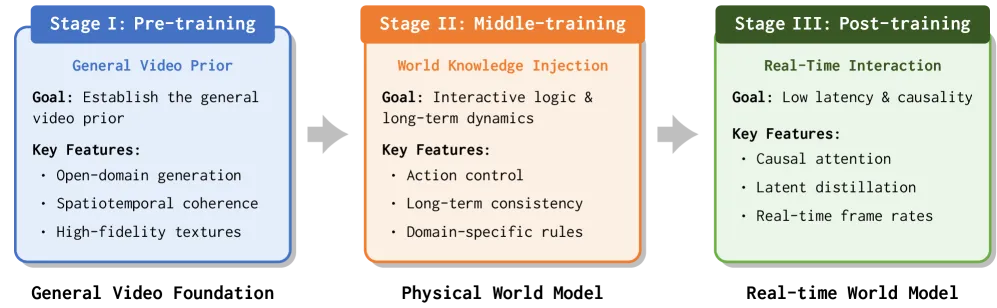
三阶段进化策略:预训练(通用视频先验)→ 中训练(世界知识注入)→ 后训练(因果适配 + 少步蒸馏)
模型架构
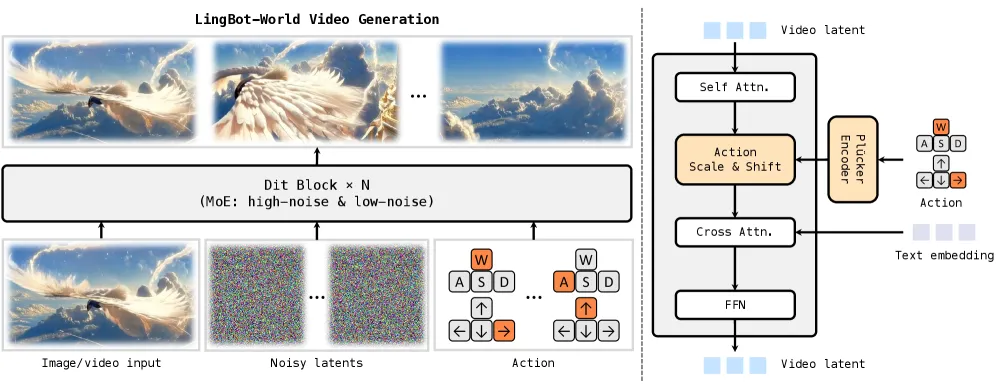
基础模型:14B 参数 Wan2.2 图像-视频扩散模型(DiT-based)
最终模型规模:28B 总参数,使用 Mixture-of-Experts (MoE):
- 两个顺序专家:高噪声专家 (~14B) 和低噪声专家 (~14B)
- 每个去噪 timestep 仅激活一个专家,推理成本和内存与稠密 14B 模型相当
- 高噪声专家:建模全局结构和粗略布局
- 低噪声专家:打磨细粒度空间和时间细节
每个 DiT 块组件:
- 自注意力层 — 实现时空连贯性和涌现的空间记忆
- Plücker Encoder — 动作信号投影为 Plücker 嵌入,通过自适应归一化 (AdaLN) 调节视频隐变量
- 交叉注意力层 — 将视频隐变量条件化于文本嵌入
动作表示(混合方式)
- 相机旋转:通过 Plücker 嵌入编码(连续 3D 变换表示)
- 离散键盘输入:WASD 编码为 multi-hot 向量
- 融合:沿通道维度拼接
核心公式
公式 (1) — 世界模型表述:
其中 V = {x_1, …, x_T} 是视频帧序列,A = {a_1, …, a_T} 是动作序列,L ≥ 1 是预测 horizon。
公式 (2) — 因果训练损失:
其中 G_θ 是学生网络,p(x) 是视频数据分布,a 是动作条件。
公式 (3) — DMD 梯度:
公式 (4) — DMD 目标函数:
公式 (5)-(6) — 对抗目标:
- Generator loss:
- Discriminator loss:
其中 f(·) 是 softplus 函数;判别头 D 附加到 fake score network 特征上。
三阶段训练详解
Stage I: Pre-Training — 建立通用视频先验
- 使用预训练的 Wan2.2 14B 图像-视频扩散模型作为初始化
- 提供强时空连贯性和开放域语义理解
- 实现高保真物体纹理和连贯场景结构
Stage II: Middle-Training — 注入世界知识和长期动态
将生成器转变为双向世界模型:
关键技术:
- 渐进课程训练:从 5 秒序列开始,逐步扩展到 60 秒;flow shift 随持续时间成比例缩放
- 多任务训练:联合优化 image-to-video 和 video-to-video(续写)目标
- 参数高效微调动作控制:冻结主 DiT 块,仅微调新增的动作适配器层
- 并行基础设施:FSDP2 + Context Parallel (Ulysses)
Stage III: Post-Training — 因果架构适配与少步蒸馏
将双向模型转变为高效自回归系统:
-
因果架构适配:
- 学生模型仅从高噪声专家初始化
- 全双向注意力替换为块因果注意力:块内双向,块间因果
- 混合 timestep 训练协议(包含 clean frame 监督在 timestep 0)
- 支持 KV caching 实现高效流式生成
-
少步蒸馏 + 长horizon训练:
- Self-rollout 扩展 horizon 训练(self-forcing 范式)
- Distribution Matching Distillation (DMD) + 对抗优化
- 随机梯度截断:仅回传最近 K 步梯度,同时保持完整上下文
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 分层语义数据引擎 | 三种层次标注解耦运动控制与场景生成 | 叙事/场景静态/密集时间 caption,VBench 动态度 +0.1245 |
| MoE 双向世界模型 | 28B 参数但推理开销等同 14B 稠密模型 | 高低噪声专家分工,渐进课程训练至 60 秒 |
| 块因果注意力适配 | 局部双向 + 全局因果的混合注意力模式 | 支持 KV caching 流式生成,16 fps @ 480p |
| DMD + 对抗蒸馏 | 分布匹配蒸馏结合真实数据对抗监督 | 弥合师生差距,避免教师偏差继承 |
| 涌现空间记忆 | 地标离开视野 60 秒后仍保持结构 | Figure 12 定性展示 Stonehenge 等案例 |
| 完全开源 | 唯一同时具备高动态度、长 horizon、实时、开源的顶级世界模型 | Table 1 对比 Genie 3/Mirage 2 等闭源模型 |
五、数据引擎
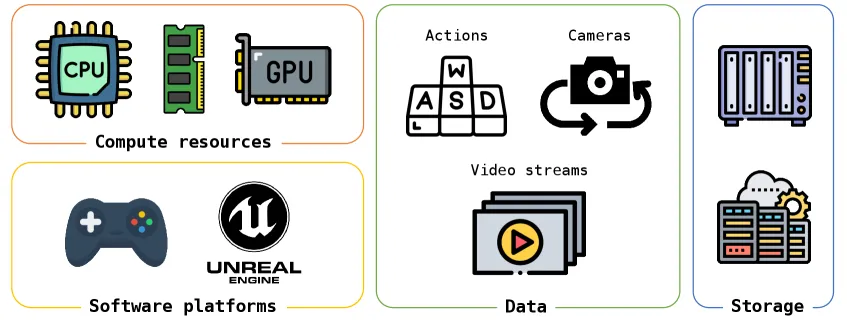
数据采集(三部分混合)
- 通用视频策展:第一人称和第三人称视角的人类/动物/车辆视频,优先”世界探索”类别
- 游戏数据采集:RGB 帧与用户控制输入 (WASD) 和相机参数严格对齐
- 合成渲染管线:Unreal Engine 自动生成碰撞检测的随机相机轨迹
数据画像引擎
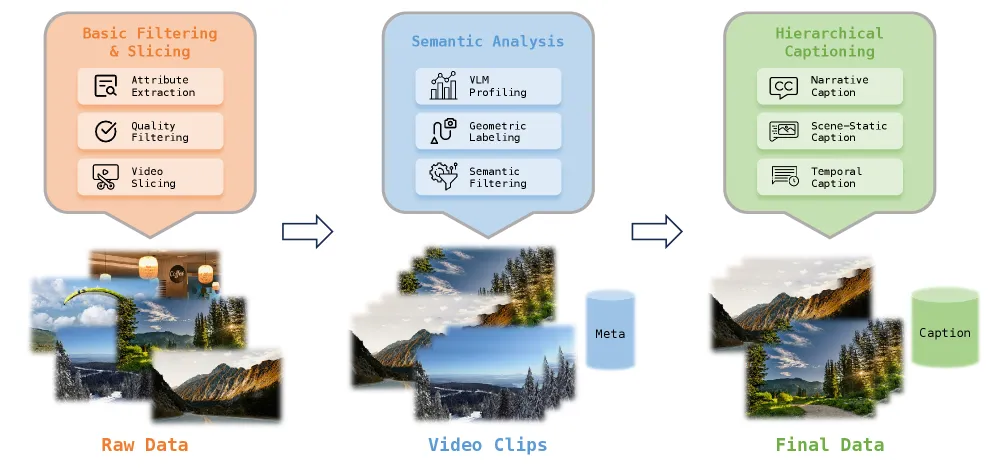
三层分析:基本属性过滤 → 语义分析(VLM 评估视觉质量/运动幅度/场景类型)→ MegaSAM 相机姿态标注
分层标注策略
| 类型 | 描述 | 示例 |
|---|---|---|
| 综合叙事 caption | 全局语义提示,交织环境与相机轨迹 | 完整游览过程的连贯描述 |
| 场景静态 caption | 仅描述环境,刻意忽略相机运动 | 静态场景细节描述 |
| 密集时间 caption | 按时间区间分段的事件描述 | JSON 格式,每 5 秒一段 |
六、实验结果
定性结果
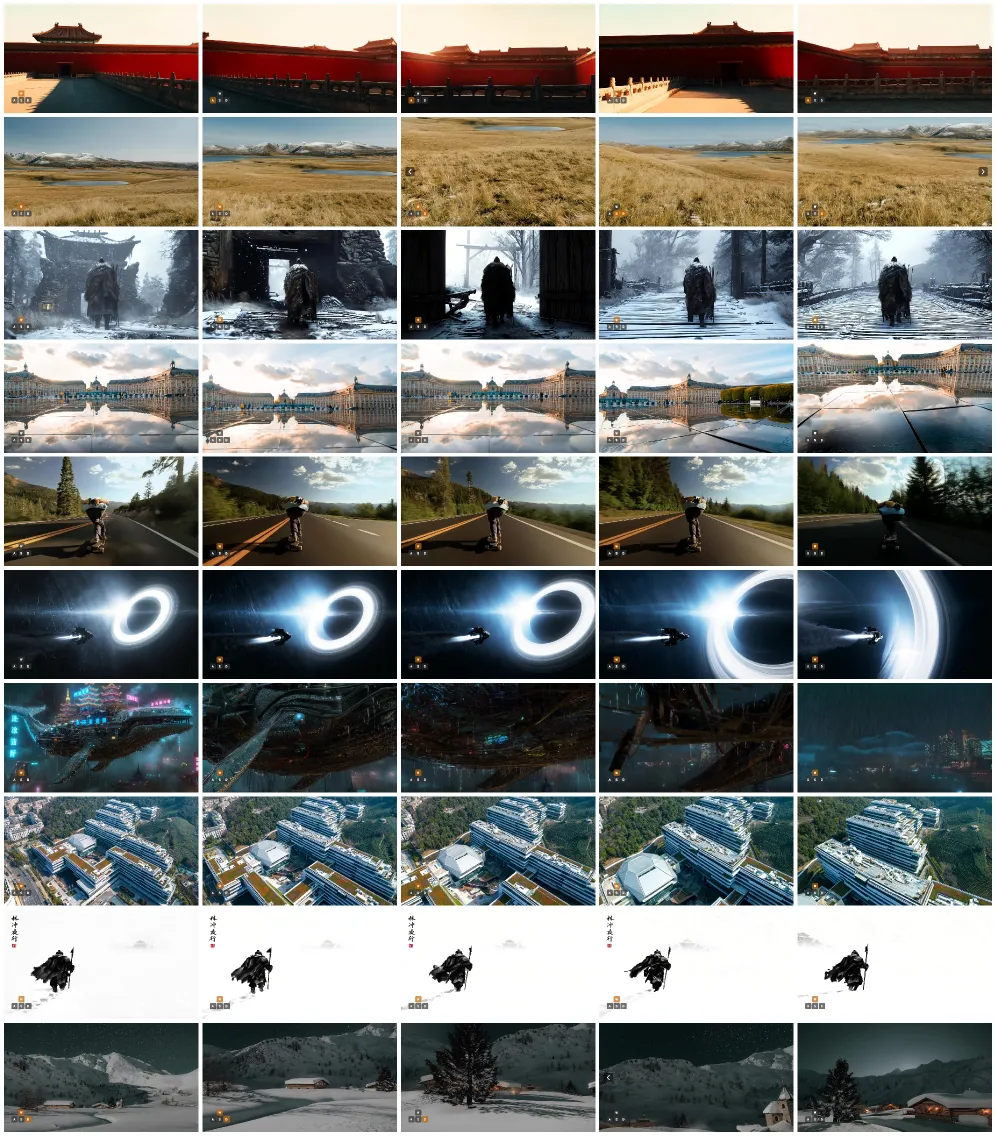
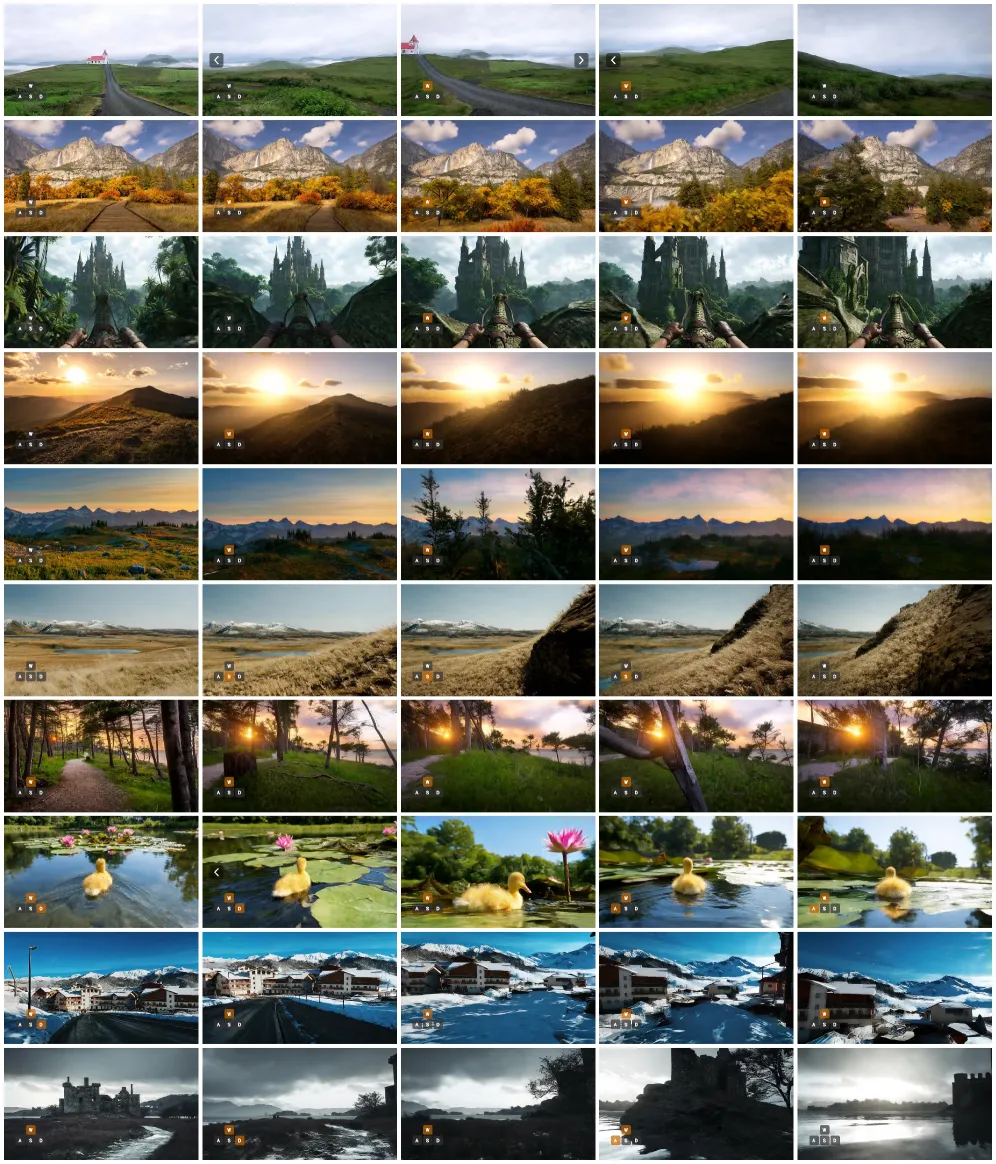
- LingBot-World-Base(中训练版):展示高保真度和复杂空间配置处理能力
- LingBot-World-Fast(后训练版):单 GPU 节点 480p 下 16 fps,视觉降级感知上可忽略
涌现记忆能力
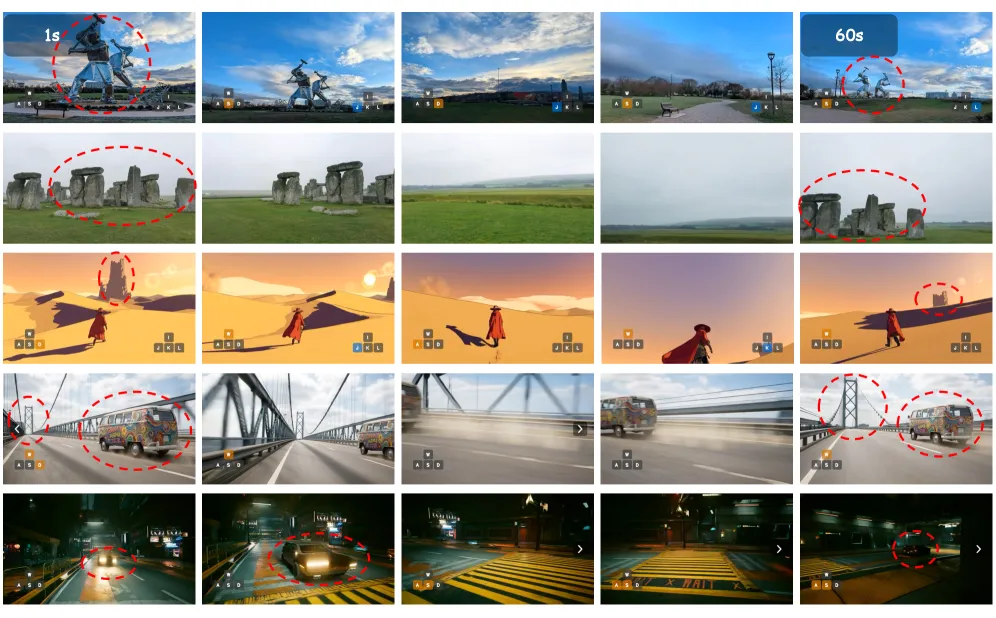
- Stonehenge 等地标即使离开视野 60 秒仍保持结构完整性
- 模型能推理未观测区域:相机回到正面时远处的桥显得更近;汽车在视野外继续行驶
超长视频生成
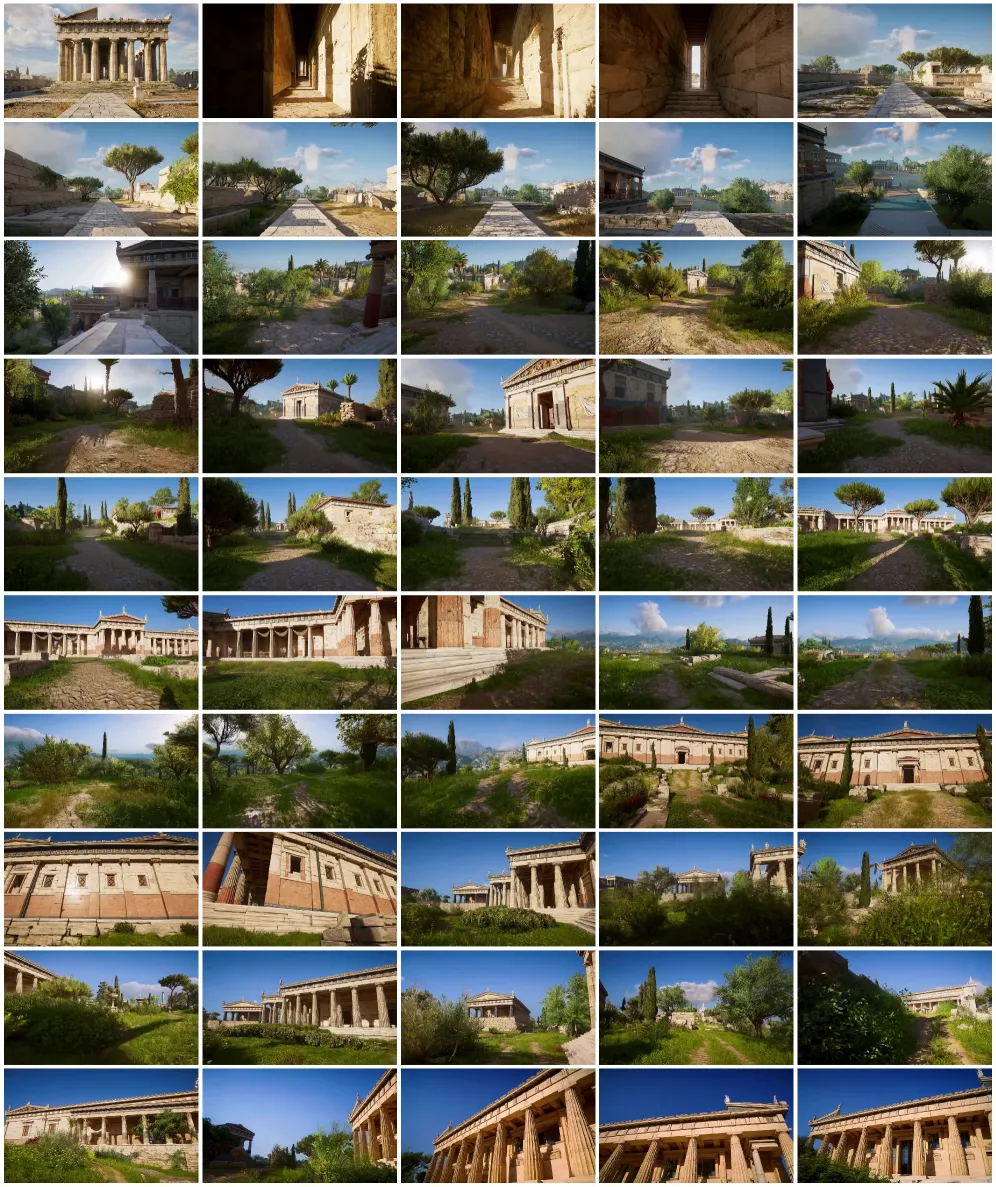
支持长达 10 分钟的连贯视频生成。
定量结果(VBench 对比)
| 指标 | Yume-1.5 | HY-World 1.5 | Ours |
|---|---|---|---|
| Imaging Quality | 0.5838 | 0.6512 | 0.6683 |
| Aesthetic Quality | 0.5185 | 0.5487 | 0.5660 |
| Dynamic Degree | 0.7612 | 0.7217 | 0.8857 |
| Motion Smooth | 0.9709 | 0.9897 | 0.9895 |
| Temporal Flickering | 0.9545 | 0.9773 | 0.9648 |
| Overall Consistency | 0.1994 | 0.2016 | 0.2178 |
评估基于 100 个生成视频(每个 > 30 秒)。关键发现:在 Imaging Quality、Aesthetic Quality、Dynamic Degree (+0.1245 vs 最佳竞品)、Overall Consistency 上领先,同时保持竞争力的 Motion Smoothness 和 Temporal Flickering。
与其他世界模型对比(Table 1)
| 模型 | 领域 | Horizon | 动态度 | 分辨率 | 实时 | 开源 |
|---|---|---|---|---|---|---|
| Matrix-Game 2.0 | 游戏 | 短 | 低 | 480p | ✓ | ✓ |
| Yume-1.5 | 通用 | 短 | 低 | 480p | ✗ | ✓ |
| HY-World 1.5 | 通用 | 中 | 低 | 720p | ✓ | ✓ |
| Mirage 2 | 通用 | 长 | 中 | 480p | ✓ | ✗ |
| Genie 3 | 通用 | 长 | 中 | 720p | ✓ | ✗ |
| LingBot-World | 通用 | 长 | 高 | 720p | ✓ | ✓ |
七、应用
7.1 可提示世界事件
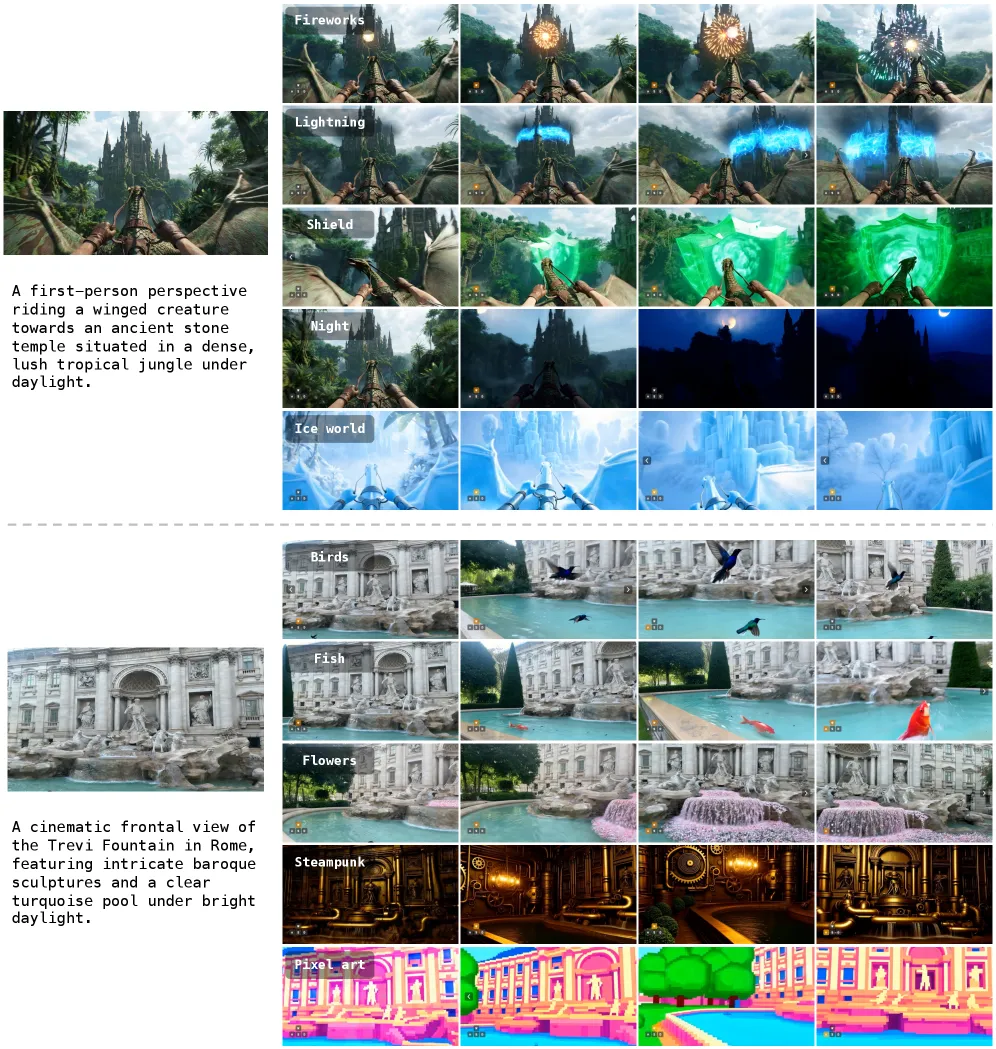
- 全局事件:语义引导如 “winter”、“pixel art”
- 局部事件:如 “fireworks”、“fish”
7.2 动作代理
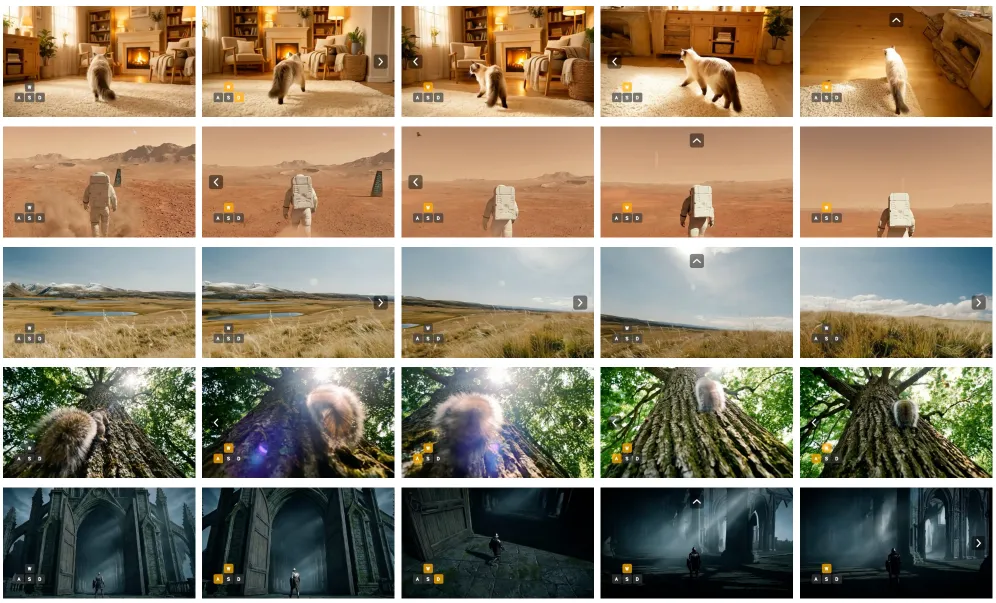
Qwen3-VL-2B 微调以从视觉观测预测动作序列。
7.3 3D 重建
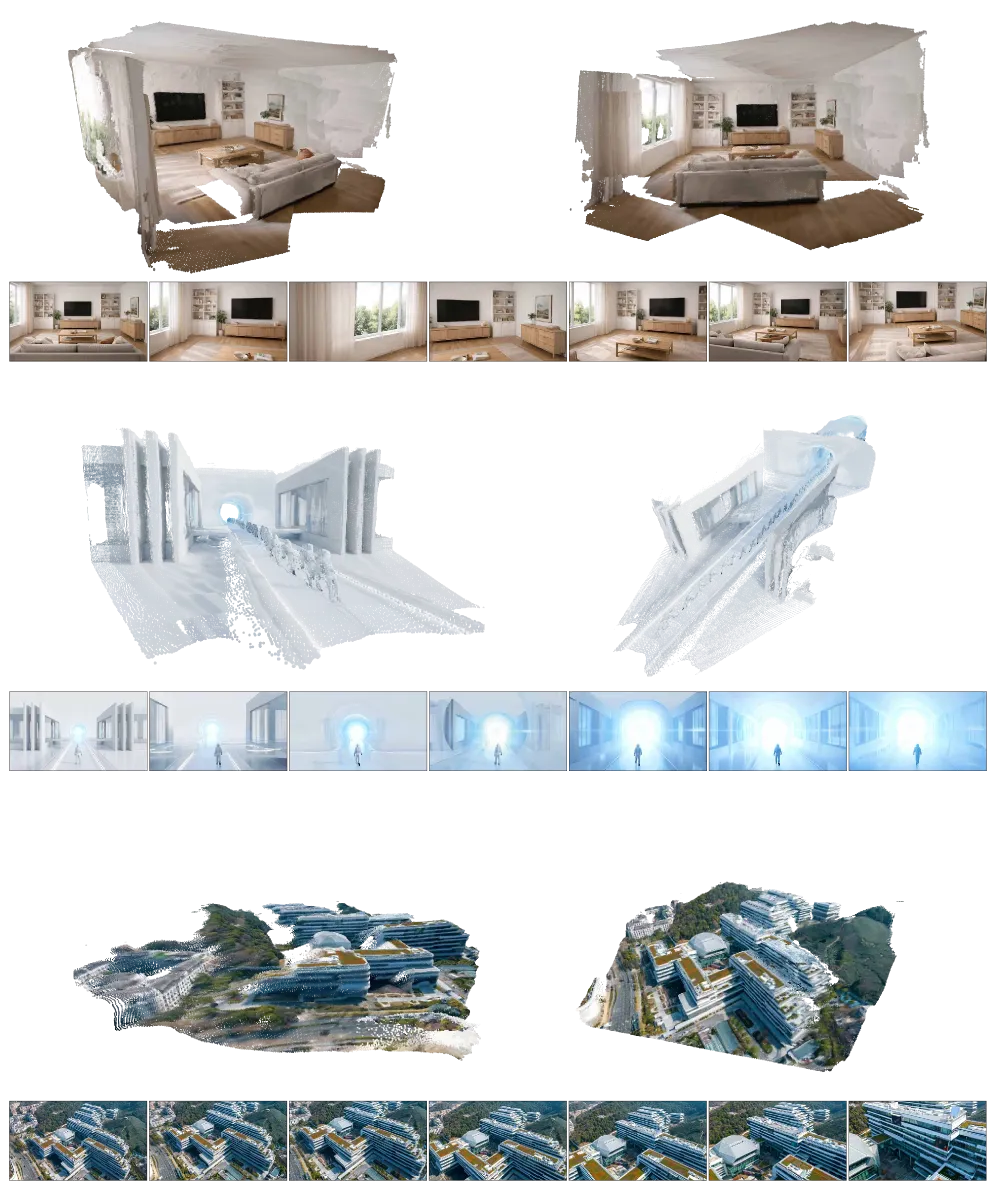
从生成视频进行点云生成,验证几何一致性。
八、相关工作
| 工作 | 关系 |
|---|---|
| Genie 3 | 闭源世界模型,中等动态度,LingBot-World 在开源+高动态上超越 |
| Mirage 2 | 闭源,中等动态度,480p 分辨率 |
| Yume-1.5 | 开源但短 horizon、低动态度、非实时 |
| HY-World 1.5 | 开源实时但低动态度、中等 horizon |
| Matrix-Game 2.0 | 仅限游戏领域、短 horizon、低动态度 |
| V-JEPA 2 / VLA-JEPA | 隐空间 JEPA 方法,不直接生成视频 |
| Cosmos Policy | 视频生成策略,非交互式世界模型 |
九、总结
核心贡献
- 首个开源顶级世界模型:唯一同时具备高动态度、长 horizon、实时交互、720p 分辨率且完全开源的世界模型
- 三阶段进化训练管线:从通用视频先验 → 双向世界模型 → 因果自回归系统的系统性方法
- MoE 设计保持效率:28B 总参数但推理开销等同 14B 稠密模型
- 分层数据引擎:三种层次 caption 解耦运动控制与场景生成
- DMD + 对抗蒸馏:解决少步蒸馏中的师生分布差距和累积漂移
- 涌现记忆验证:定性展示空间记忆的涌现能力
技术影响
- 开源世界模型新前沿:缩小闭源与开源技术差距
- 分钟级 horizon:为内容创作、游戏、机器人学习提供实用平台
- 实时交互:16 fps @ 480p 单 GPU 实现真正的交互式模拟
局限性
- 记忆稳定性:涌现式,非显式存储模块
- 高计算成本:需要企业级 GPU
- 动作空间有限:主要为导航/基本移动
- 交互精度:细粒度物体级控制仍然具有挑战性
- 生成长度与漂移:超长时间视频场景结构会丢失
- 单智能体模拟:不支持多智能体交互
未来方向
- 显式记忆存储模块
- 扩展动作空间(细粒度操作)
- 多智能体交互
- 更大分辨率和更长 horizon 的扩展
十、参考资源
- arXiv: https://arxiv.org/abs/2601.20540
- GitHub: https://github.com/robbyant/lingbot-world
- Project Page: https://technology.robbyant.com/lingbot-world
- HuggingFace: https://huggingface.co/collections/robbyant/lingbot-world
- ModelScope: https://www.modelscope.cn/models/Robbyant/lingbot-world-base-cam
- Base Model: Wan2.2 14B image-to-video diffusion (DiT)
- Parallelism: FSDP2 + Ulysses Context Parallel
- Distillation: DMD (Distribution Matching Distillation) + APT discriminator