SwiftFusion: Scalable Sequence Parallelism for Distributed Inference of Diffusion Transformers on GPUs
面向扩散Transformer分布式推理的可扩展序列并行引擎
SwiftFusion: Scalable Sequence Parallelism for Distributed Inference of Diffusion Transformers on GPUs
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SwiftFusion: Scalable Sequence Parallelism for Distributed Inference of Diffusion Transformers on GPUs |
| 作者 | Jiacheng Yang, Jun Wu, Yaoyao Ding, Zhiying Xu, Yida Wang, Gennady Pekhimenko |
| 机构 | University of Toronto & Vector Institute, Amazon, NVIDIA |
| 会议 | ACM CAIS ‘26 (Conference on AI and Agentic Systems) |
| 论文 | arXiv:2601.20273 |
| 领域 | cs.DC, cs.CV |
二、核心思想
问题定义
Diffusion Transformers (DiTs) 在高质量图像和视频生成中广泛应用。随着分辨率和视频时长增加,单GPU推理变得低效。
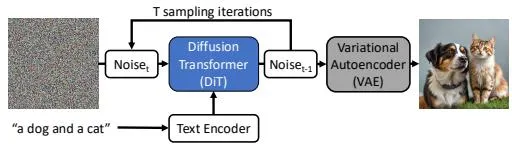
内存瓶颈:CogVideoX模型权重仅12 GiB,但生成10秒768×1360视频会导致单A100 GPU (40 GiB) OOM。
现有序列并行技术的局限:
| 技术 | 通信模式 | 问题 |
|---|---|---|
| Ring Attention | 环形KV传输 | 通信量不随GPU数增加而减少 |
| Ulysses Attention | All-to-All | 不支持与计算重叠,受头数限制 |
| USP (统一SP) | Ring (机间) + Ulysses (机内) | 机间通信开销大,可扩展性差 |
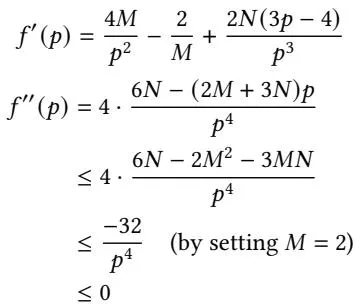
三大挑战
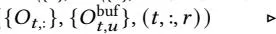
| 挑战 | 说明 | 影响 |
|---|---|---|
| 机间/机内带宽差异 | NVSwitch带宽远高于InfiniBand/EFA | USP使用Ring进行机间通信,通信量不减少 |
| All-to-All不可重叠 | 现有实现将All-to-All视为原子操作 | 机间通信成为瓶颈 |
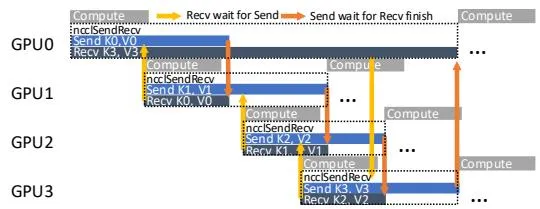
| 双侧通信开销 | NCCL等库需要严格同步 | 同步和计算开销随GPU数增加 |
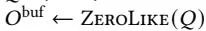
解决方案概述
SwiftFusion提出三个关键创新:
| 创新 | 说明 | 效果 |
|---|---|---|
| 拓扑感知序列并行 | Ulysses用于机间,Ring用于机内 | 减少机间通信量 |
| Torus Attention | 分块All-to-All与计算重叠 | 隐藏机间通信延迟 |
| 单侧通信实现 | 使用NVSHMEM替代NCCL | 减少同步和计算开销 |
三、技术架构
拓扑感知通信调度
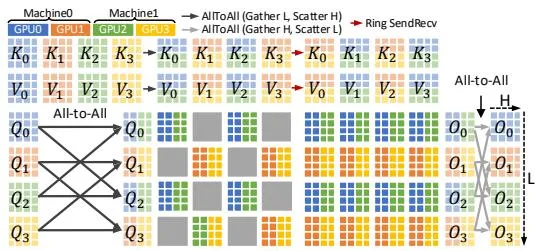
核心思想:将N×M个GPU组织为2D设备网格,形状为。
- Ulysses Attention ():用于机间通信,通信量随机器数增加而减少
- Ring Attention ():用于机内通信,利用NVSwitch高带宽
并行度计算:
- 当时:,
- 当时:,
与USP对比:SwiftFusion在大多数情况下产生更少的机间通信量(详见Appendix D证明)。
Torus Attention
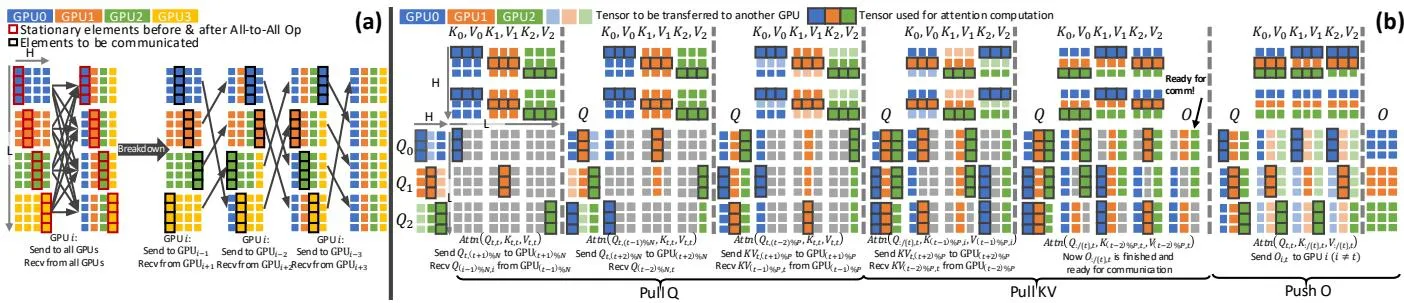
核心观察:All-to-All操作前后存在静态元素(当前rank的head索引元素),可直接用于计算。
分阶段执行:
1. Pull Q阶段 (个阶段):
- 阶段:GPU 使用计算注意力,同时发送
- 通信与计算重叠
2. Pull KV阶段 (个阶段):
- 阶段:GPU 使用接收到的和、计算注意力
- 同时发送下一轮需要的KV
3. Push O阶段 (个阶段):
- 计算时,同时发送到其他GPU
- 输出张量通信与计算重叠
单侧通信实现
Algorithm 1:SwiftFusion单侧通信伪代码
function SwiftFusion(Q, K, V, T, t, U, u, R, r):
    # 1. Ulysses Attention: 机内All-to-All
    ScatterPush({Q_t,:, K_t,:, V_t,:}, ..., (t, :, r))
    BarrierAll()

    # 2. 预取所有Pull操作
    for k = 1 to N-1:
        E_k^Q = GatherPull(Q_t':, ..., (t', :, r))
        E_k^KV = GatherPull(K_t':, V_t':, ..., (t', :, r))

    # 3. Pull Q阶段: 重叠通信与计算
    RingAttn(Q_t,:, K_t,:, V_t,:)
    for k = 1 to N-1:
        Wait(E_k^Q)
        RingAttn(Q_t':, K_t,:, V_t,:)

    # 4. Pull KV阶段
    for k = 1 to N-1:
        Wait(E_k^KV); Barrier(R)
        RingAttn(Q:{\t},:, K_t':, V_t':)

    # 5. Push O阶段
    for k = 1 to N-1:
        ScatterPush(O_t':, ..., (t', :, r))
    RingAttn(Q_t,:, K:{\t},:, V:{\t},:)

return O关键优化:
- 预取所有Pull操作,最大化重叠
- 仅需机内同步+两次机间同步(层开始和结束)
- 最多一个、、、的缓冲副本
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 拓扑感知调度 | Ulysses机间 + Ring机内 | 机间通信量减少近倍 |
| Torus Attention | 分块All-to-All重叠 | 隐藏机间通信延迟 |
| 单侧通信 | NVSHMEM替代NCCL | 消除每传输同步开销 |
| 静态元素利用 | All-to-All前后不变元素 | 直接开始计算 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 硬件 | 4× AWS p4de.24xlarge, 每台8× A100 (40GB), NVSwitch互联 |
| 网络 | AWS EFA 400 Gbps |
| 软件 | CUDA 12.8.0, PyTorch 2.8.0, NCCL 2.27.3, NVSHMEM 3.4.5 |
| 模型 | Flux (12B, 图像), CogVideoX (5B, 视频) |
| 工作负载 | 3072×3072/4096×4096图像, 20s/40s 768×1360视频 |
| 基线 | USP (Unified Sequence Parallelism) |
端到端性能
最优分布式配置:
| 对比 | 加速比 | 说明 |
|---|---|---|
| SwiftFusion vs USP | 1.35× 平均 (最高1.77×) | 所有关键创新协同工作 |
| TAS vs USP | 1.27× 平均 (最高1.64×) | 仅拓扑感知调度 |
关键发现:
- 2台机器时TAS性能不如USP(通信量相同但不可重叠)
- 3-4台机器时SwiftFusion优势明显
- 内存消耗无额外开销
其他分布式配置
| 方法 | 平均加速比 | 最高加速比 |
|---|---|---|
| TAS vs USP | 1.47× | 2.54× |
| SFU vs USP | 1.61× | 3.11× |
观察:
- 增加Ulysses度数通常可获得更好加速
- TAS中优于(避免过大All-to-All开销)
逐层性能分析
不同头维度 ():
| 头维度 | 平均加速比 |
|---|---|
| 1.12× | |
| 1.28× | |
| 1.32× |
不同序列长度:
| 序列长度 | 平均加速比 |
|---|---|
| 96K | 1.59× |
| 128K | 1.27× |
| 160K | 1.07× |
| 192K | 1.14× |
不同批量大小:
| 批量大小 | 平均加速比 |
|---|---|
| 所有 | 1.13× - 1.27× |
趋势:序列越长,计算量二次增长,通信优化收益相对减少。
六、相关工作
| 方法类别 | 代表方法 | 特点 | 与SwiftFusion的区别 |
|---|---|---|---|
| 分布式DiT推理 | USP, DistriFusion, PipeFusion | Ring/Ulysses组合或有损通信隐藏 | 未优化拓扑感知和重叠 |
| 通信-计算重叠 | FLUX, DeepEP, Comet, ScaleFusion | 手动或编译器优化 | 针对LLM或特定架构,非通用DiT |
| 编译器方法 | TileLink, Triton-Distributed, Mercury | 自动重叠 | 难以发现Torus Attention等专用技术 |
七、总结
核心贡献
- 拓扑感知序列并行:首次提出Ulysses机间 + Ring机内的调度策略
- Torus Attention:新型分布式注意力算法,实现All-to-All与计算重叠
- 单侧通信统一实现:使用NVSHMEM统一Torus/Ulysses/Ring Attention
- 显著性能提升:平均1.35×加速(最高1.77×)
技术影响
- 可扩展性:支持多机多卡高效扩展
- 内存效率:无额外内存开销
- 通用性:适用于图像和视频生成任务
- 生产就绪:基于PyTorch和NVSHMEM实现
局限性
- 2机器场景:拓扑感知调度在2机器时无优势
- 头数限制:Ulysses Attention需要可被整除
- 序列长度:超长序列(>160K)时计算主导,收益减少
- 硬件依赖:需要NVSwitch和NVSHMEM支持
八、参考资源
- 论文:arXiv:2601.20273
- 会议:ACM CAIS ‘26
- 相关项目:USP, FlashAttention, NVSHMEM
- 代码库:未公开