LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts
面向最优每 FLOP 和每参数精度的 MoE 架构设计
LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts |
| 作者 | NVIDIA 研究团队 |
| 机构 | NVIDIA |
| 论文 | arXiv:2601.18089 |
| 代码 | 未开源 |
| 发布 | 2026年1月 |
| 许可 | 未明确 |
| 应用 | Nemotron-3 Super 和 Ultra 模型 |
二、核心思想
问题定义
Mixture-of-Experts (MoE) 架构已成为许多最先进开源和专有大语言模型的核心组件。然而,现有 MoE 架构在推理成本(以每浮点运算精度和每参数精度衡量)方面的最优性仍不清楚。
关键挑战:
- 现有 MoE 主要针对离线、高吞吐量场景优化
- 对在线部署(严格延迟、内存带宽、通信约束)考虑不足
- 缺乏从硬件-软件协同设计角度的系统性设计探索
解决方案概述
LatentMoE 从硬件-软件协同设计角度重新审视 MoE 设计,基于实证和理论考虑,引入新的模型架构:
核心创新:将输入 token 投影到低维潜在空间 ,在潜在空间中执行专家计算
设计目标:最大化每单位计算的精度(accuracy per FLOP 和 per parameter)
核心性能
- 精度提升: 在等 FLOP 和等参数约束下,持续优于标准 MoE 架构
- 规模验证: 在 95B 参数规模和 1T token 训练上验证
- 实际应用: 已被 NVIDIA Nemotron-3 Super 和 Ultra 模型采用
- 万亿参数投影: Kimi-K2-1T-LatentMoE 在精度-效率 Pareto 前沿上表现优异
三、技术架构
LatentMoE 架构
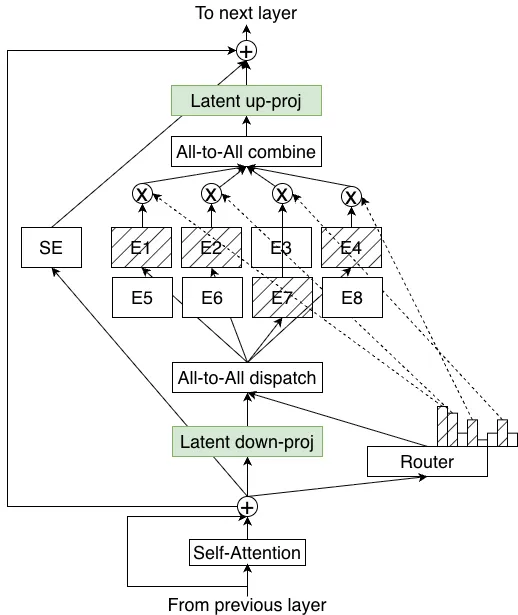
Figure 1(b): LatentMoE 架构
与标准 MoE 对比:
- 标准 MoE: 输入直接路由到专家,专家在原始维度 上操作
- LatentMoE: 输入先投影到低维潜在空间 ,专家在潜在空间操作
核心公式
LatentMoE 前向传播:
-
下投影:
-
路由: ,选择 top-K 专家
-
专家计算: ,每个专家在潜在空间操作
-
聚合:
-
上投影:
压缩比:
设计原则
原则 I: 内存带宽瓶颈
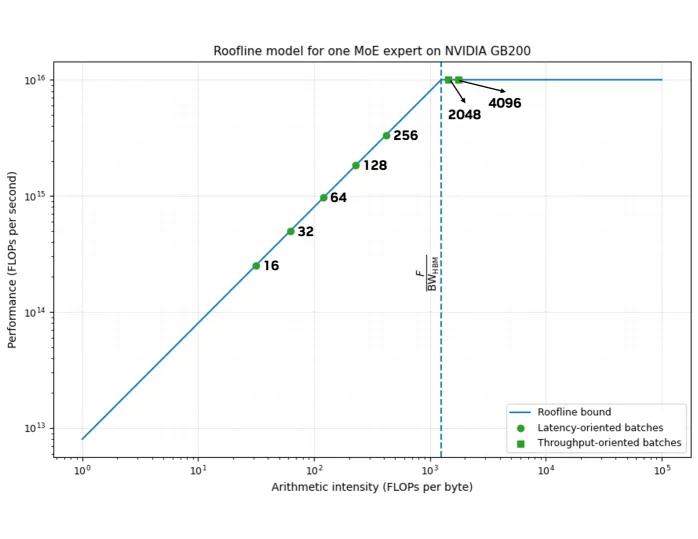
Figure 2: Qwen3-235B-A22B 的 Roofline 分析
在延迟敏感的小批量场景下,MoE 计算主要受内存带宽瓶颈制约:
- 算术强度:
- 低 值时,操作点位于带宽受限区域
关键洞察: 减少专家权重大小(压缩 到 )可直接减少内存带宽需求
原则 II: 通信瓶颈
MoE 路由需要 all-to-all 通信,将 token 发送到对应的专家 GPU:
- 通信量: 与 token 维度 成正比
- LatentMoE 优势: 在潜在空间 中通信,减少 倍通信量
原则 III: 有效非线性预算
其中 是专家数, 是中间维度。压缩 到 但保持 不变,有效非线性预算不变。
原则 IV: 专家缩放
为补偿压缩带来的精度损失,增加专家数量:
实验验证:
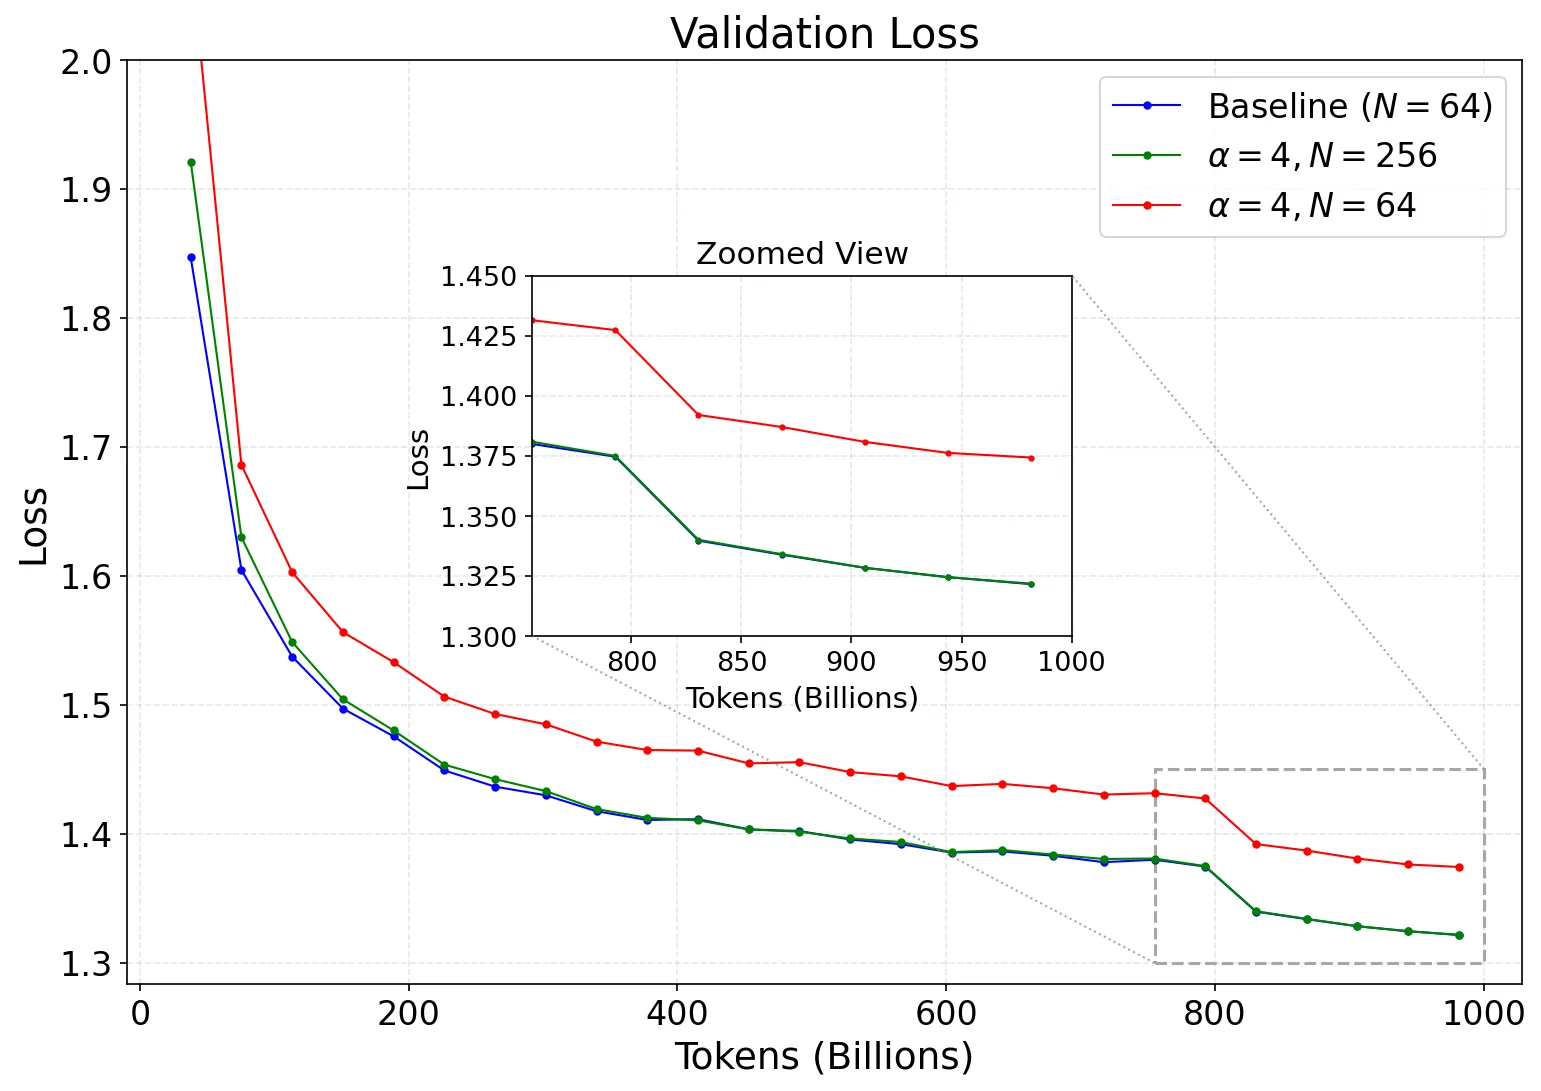
Figure 4: 专家缩放对模型质量的影响
- 绿色曲线(使用专家缩放):精度损失被有效补偿
- 红色曲线(不使用专家缩放):精度显著下降
压缩比选择
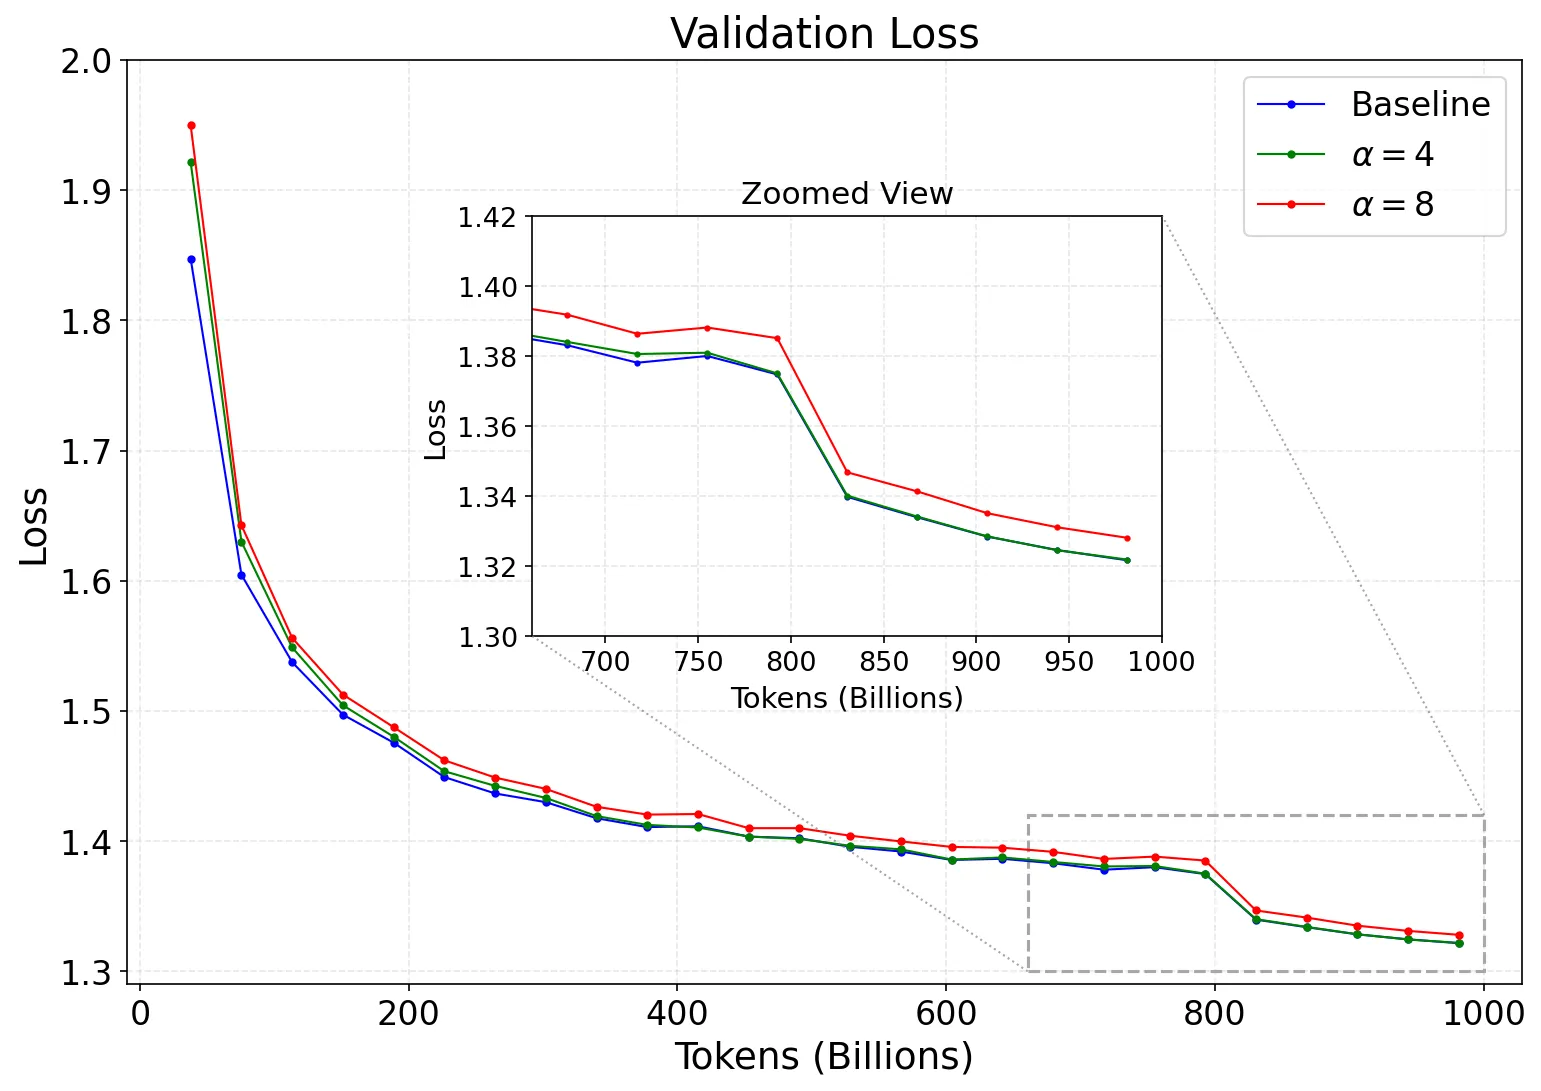
Figure 3: 压缩比 对模型质量的影响
关键发现:
- (4× 压缩)在精度和效率之间取得最佳平衡
- 更高压缩比进一步减少计算但精度下降
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 潜在空间投影 | 将 token 投影到低维空间再路由 | 减少带宽和通信开销 |
| 专家缩放 | 压缩后增加专家数量补偿精度 | 有效消除压缩导致的精度损失 |
| 硬件-软件协同设计 | 从系统瓶颈角度设计架构 | 针对实际部署约束优化 |
| 双维度优化 | 同时优化 per-FLOP 和 per-参数精度 | 全面覆盖推理成本 |
LatentMoE 变体
| 变体 | 目标 | 特点 |
|---|---|---|
| -MoE | 效率优先 | 匹配基线收敛,减少计算 |
| -MoE | 精度优先 | 超越基线精度,相同计算 |
五、实验结果
训练收敛
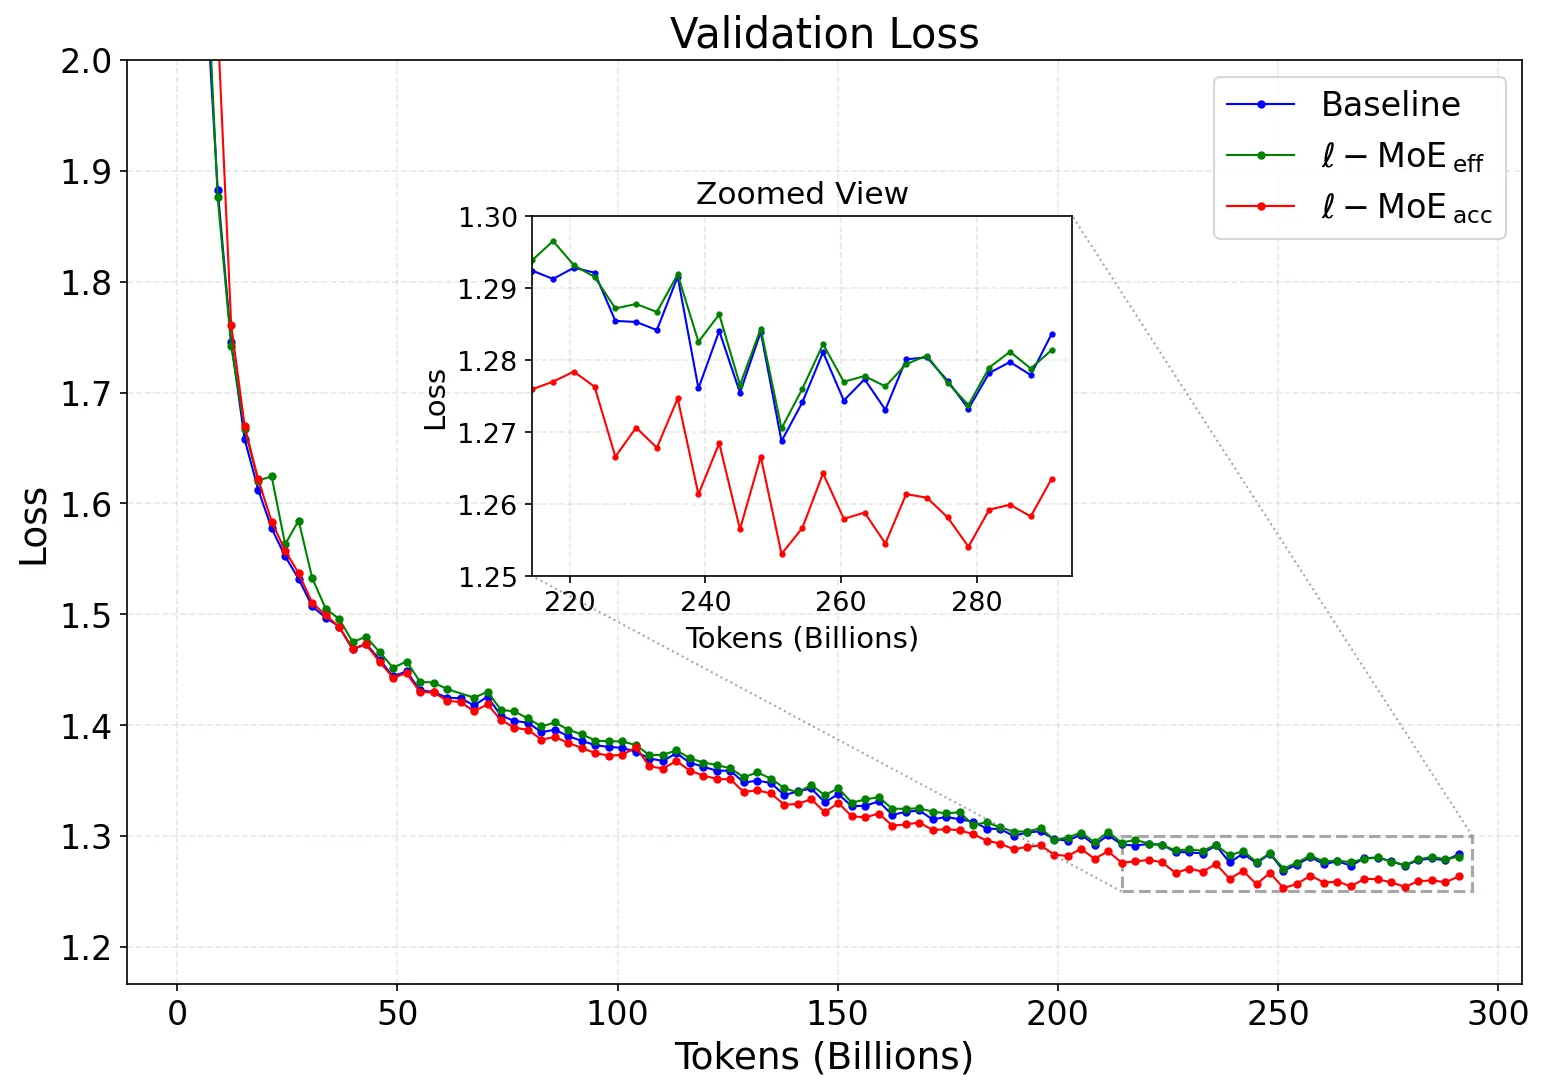
Figure 6: 95B 模型训练收敛曲线
配置:
- 基线: 95BT-8BA(95B 总参数,8B 激活参数)
- -MoE:
- -MoE:
结果:
- -MoE 匹配基线收敛
- -MoE 超越基线精度
16B 消融实验
| 配置 | 验证损失 | 相对基线 |
|---|---|---|
| 基线 (16BT-2BA) | 基准 | - |
| -MoE () | 匹配 | 0% |
| -MoE () | 更低 | +改进 |
万亿参数投影
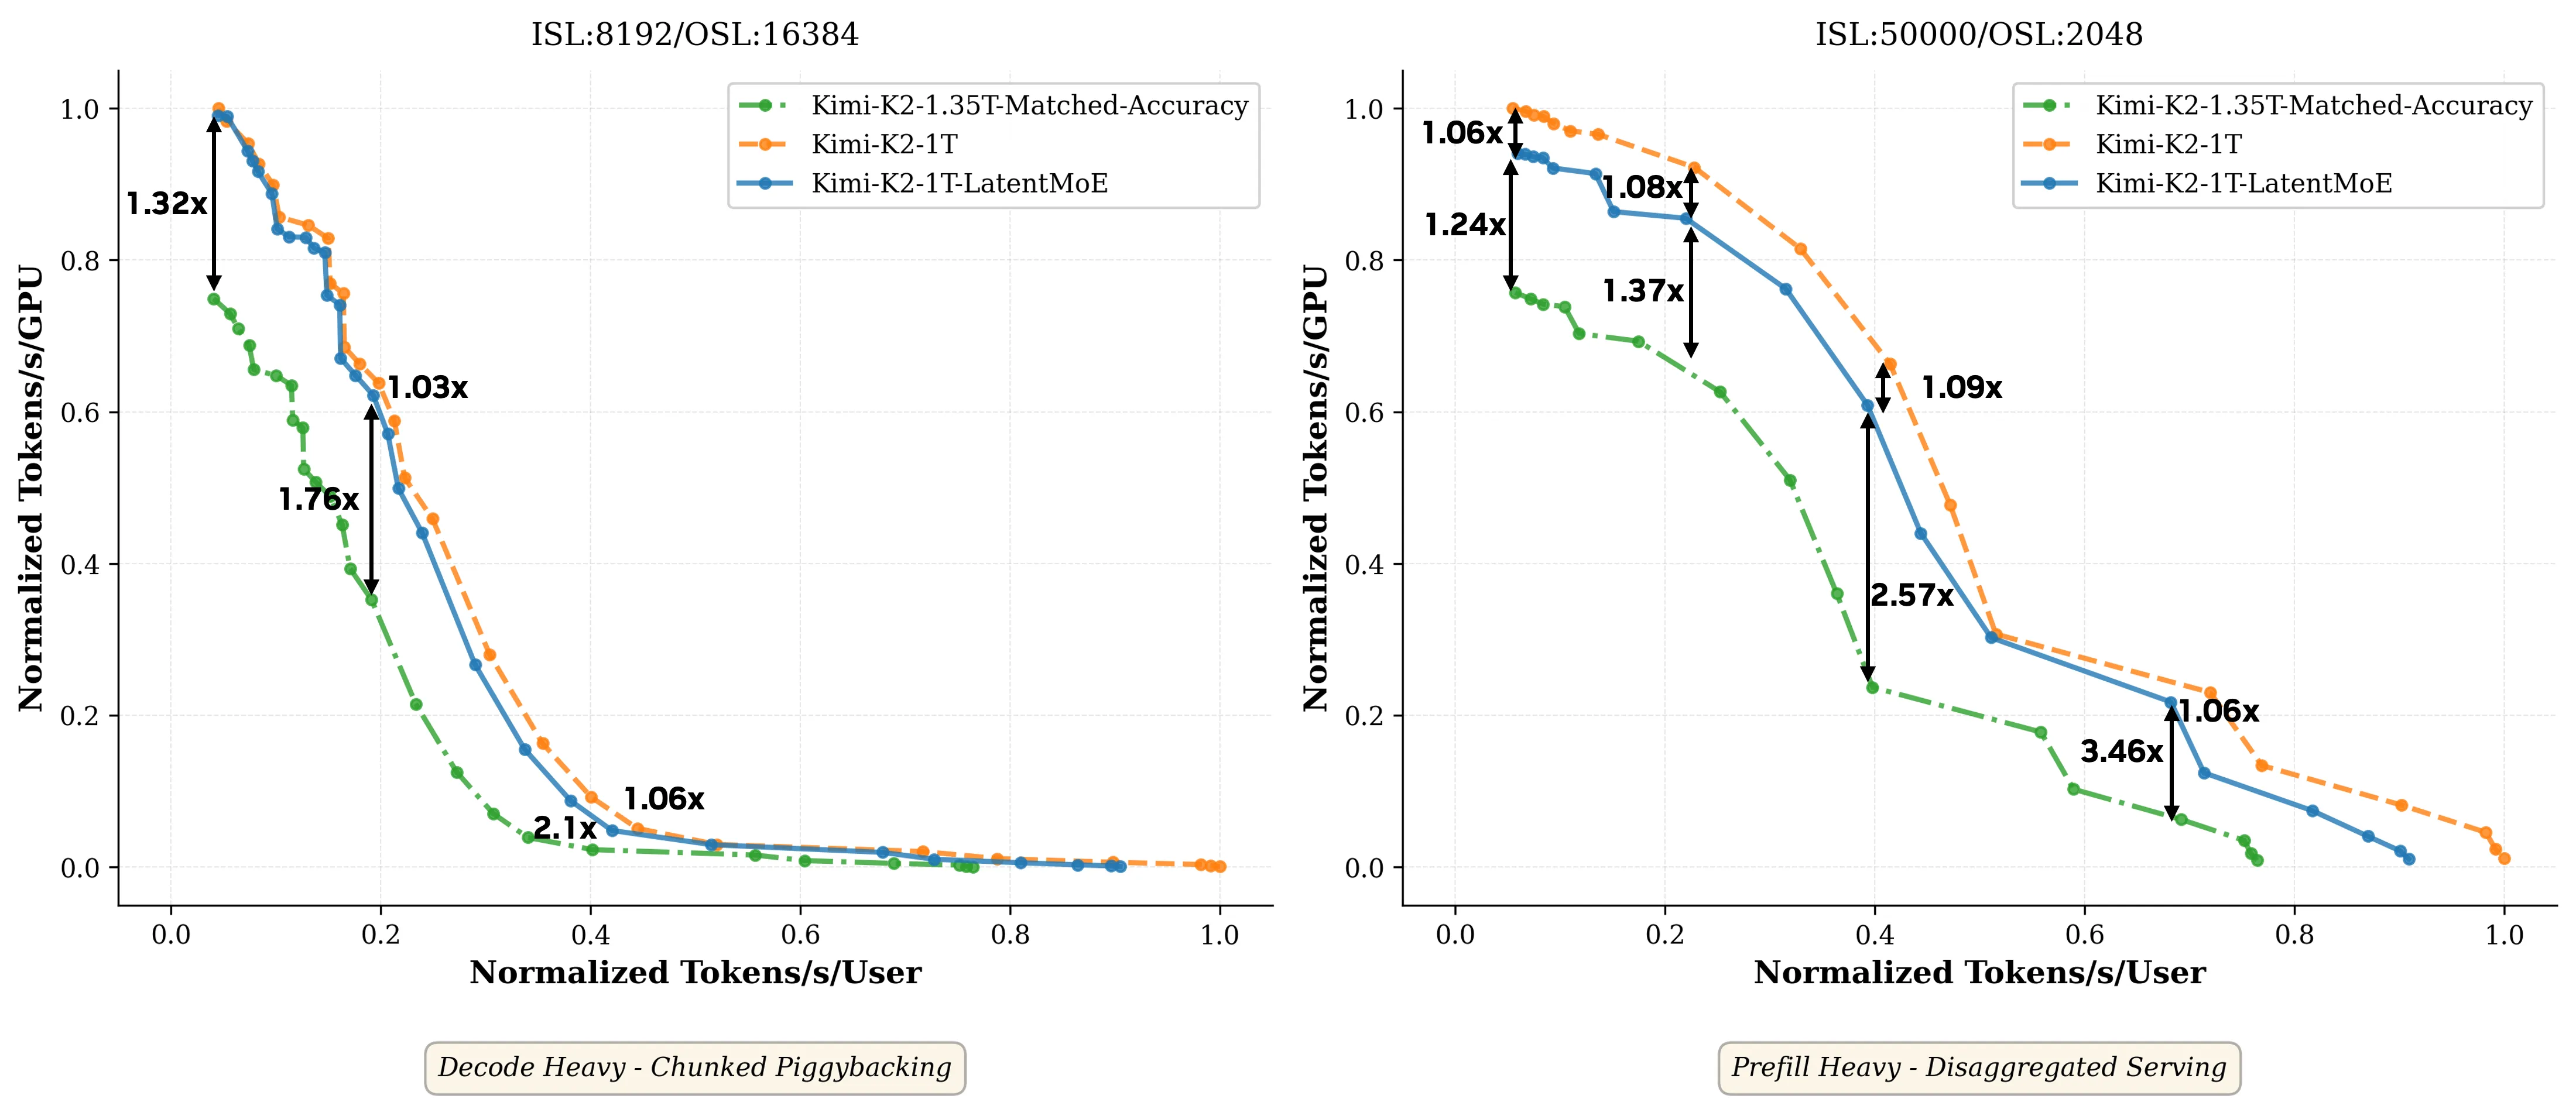
Figure 7: 万亿参数规模的吞吐量-延迟 Pareto 前沿投影
场景:
- 左: Decode 密集流量(chunked piggybacking 服务)
- 右: Prefill 密集流量(分离式服务)
关键结果:
- Kimi-K2-1T-LatentMoE 实现精度高效的运营点
- 匹配其精度需要标准 MoE 额外约 350B 参数
- 在前沿上实现 1.24× - 3.46× 投影加速
混合架构验证
LatentMoE 在混合 Mamba-Attention MoE 架构上也验证了有效性:
| 架构 | 模型规模 | 结果 |
|---|---|---|
| Transformer MoE | 16B/95B | 有效 |
| Hybrid Mamba-Attention MoE | 95B | 有效 |
六、与现有方法对比
| 方法 | 类型 | 优化目标 | 精度-效率权衡 |
|---|---|---|---|
| LatentMoE | 训练时架构 | per-FLOP + per-参数 | 最优 Pareto 前沿 |
| Standard MoE | 基线 | per-FLOP | 基准 |
| MoLAE | 后训练压缩 | per-参数 | 有限改进 |
| 专家剪枝 | 后训练压缩 | per-参数 | 精度损失 |
| 专家合并 | 后训练压缩 | per-参数 | 精度损失 |
LatentMoE 优势:
- 训练时优化而非后训练压缩
- 同时优化两个维度(per-FLOP 和 per-参数)
- 通过专家缩放补偿压缩损失
七、总结
核心贡献
- 系统性设计探索: 从硬件-软件协同设计角度分析 MoE 瓶颈
- LatentMoE 架构: 将 token 投影到低维潜在空间,减少带宽和通信开销
- 专家缩放策略: 压缩后增加专家数量补偿精度损失
- 大规模验证: 在 95B 参数和 1T token 上验证有效性
- 实际应用: 已被 NVIDIA Nemotron-3 模型采用
技术影响
- 架构设计: 为 MoE 设计提供新的范式(潜在空间投影)
- 部署效率: 显著减少推理成本(内存带宽、通信)
- 扩展性: 支持万亿参数规模的高效部署
- 通用性: 适用于 Transformer 和混合架构
局限性
- 需要从头训练(非后训练方法)
- 最优压缩比 可能因模型规模而异
- 潜在空间投影引入额外的下投影/上投影计算
未来方向
- 更长的 token horizon
- 更大的模型规模
- 与其他压缩技术(量化、剪枝)组合
八、参考资源
- 论文: arXiv:2601.18089
- PDF: arXiv PDF
- HTML: arXiv HTML
- 相关模型: Nemotron-3 Super/Ultra (arXiv:2512.20856)
- 相关工作: MoLAE, DeepSeek-v2, Qwen3-235B-A22B