Stable-DiffCoder: Pushing the Frontier of Code Diffusion Large Language Model
基于扩散的代码大语言模型,通过Block Diffusion持续预训练超越自回归基线
Stable-DiffCoder: Pushing the Frontier of Code Diffusion Large Language Model
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Stable-DiffCoder: Pushing the Frontier of Code Diffusion Large Language Model |
| 作者 | Chenghao Fan, Wen Heng, Bo Li, Sichen Liu, Yuxuan Song, Jing Su, Xiaoye Qu, Kai Shen, Wei Wei |
| 机构 | 华中科技大学、ByteDance Seed |
| 论文 | https://arxiv.org/abs/2601.15892 |
| 代码 | https://github.com/ByteDance-Seed/Stable-DiffCoder |
| 模型 | https://huggingface.co/collections/ByteDance-Seed/stable-diffcoder |
| 发布 | 2026年1月22日 |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
自回归(AR)语言模型在代码生成中取得了强大成果,但其严格顺序解码无法充分利用代码固有的非自回归特性。扩散语言模型(DLLMs)提供了一种互补视角,通过迭代去噪实现非顺序、块级解码和更丰富的数据重用。然而,现有代码DLLMs在可比预算下仍落后于强大的AR基线。
核心问题:在固定数据和计算预算下,扩散引入的额外训练模式能否实际提升模型能力?
解决方案概述
Stable-DiffCoder通过以下关键创新解决这一问题:
- Block Diffusion持续预训练(CPT):从Seed-Coder的预退火检查点开始,使用小块扩散(块大小4)进行1.3T token的CPT
- 定制化Warmup:通过渐进式腐败度warmup解决AR→DLLM训练不稳定性
- 块级裁剪噪声调度:确保每个训练块都有非平凡的学习信号
核心发现:在相同数据和架构下,Stable-DiffCoder在广泛代码基准上总体优于其AR对应模型Seed-Coder。
三、技术架构
整体框架图
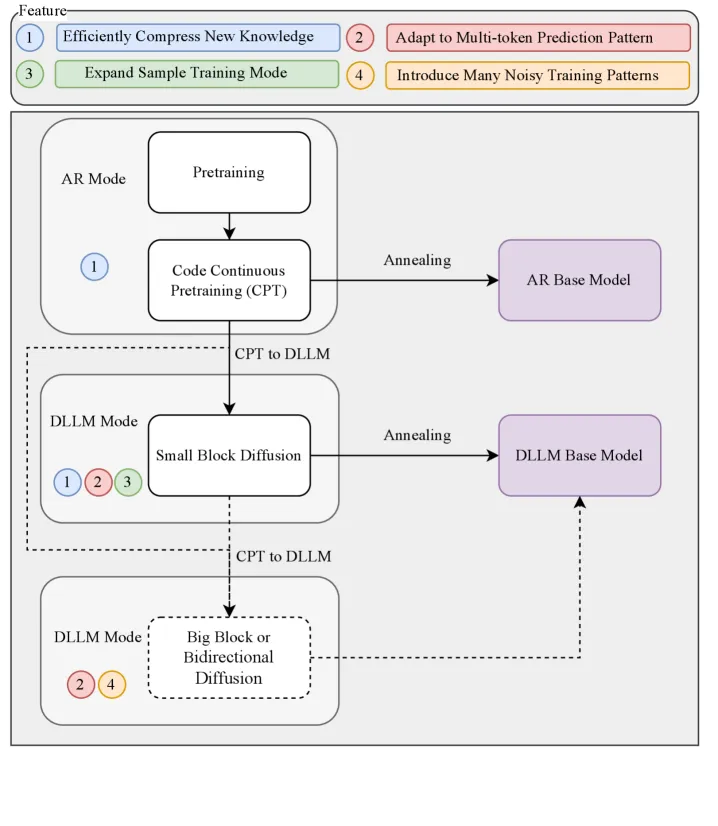
训练流程:从Seed-Coder的预退火检查点出发,使用小块DLLM进行持续预训练,得到Stable-DiffCoder-Base。
核心公式
AR语言模型目标函数:
DLLM目标函数:
其中 是基于腐败程度的权重系数。
Token推理知识(Definition 3.1):
给定上下文 ,定义候选集:
三种知识学习机制制:
- 推理机制: 小,映射近乎确定性,梯度高度对齐
- 相关机制: 中等,梯度部分抵消,主要拟合噪声共现
- 噪声机制: 极大,上下文几乎无信息,模型只能记忆特异对
块级裁剪噪声调度:
确保每个块的预期掩码token数 。
训练流程
- Warmup阶段:从AR检查点开始,渐进增加最大腐败度
- 去除权重 ,优化简化目标
- 主训练阶段:使用标准DLLM目标,
- 块大小选择:采用块大小4,平衡数据增强效果和训练效率
训练稳定性
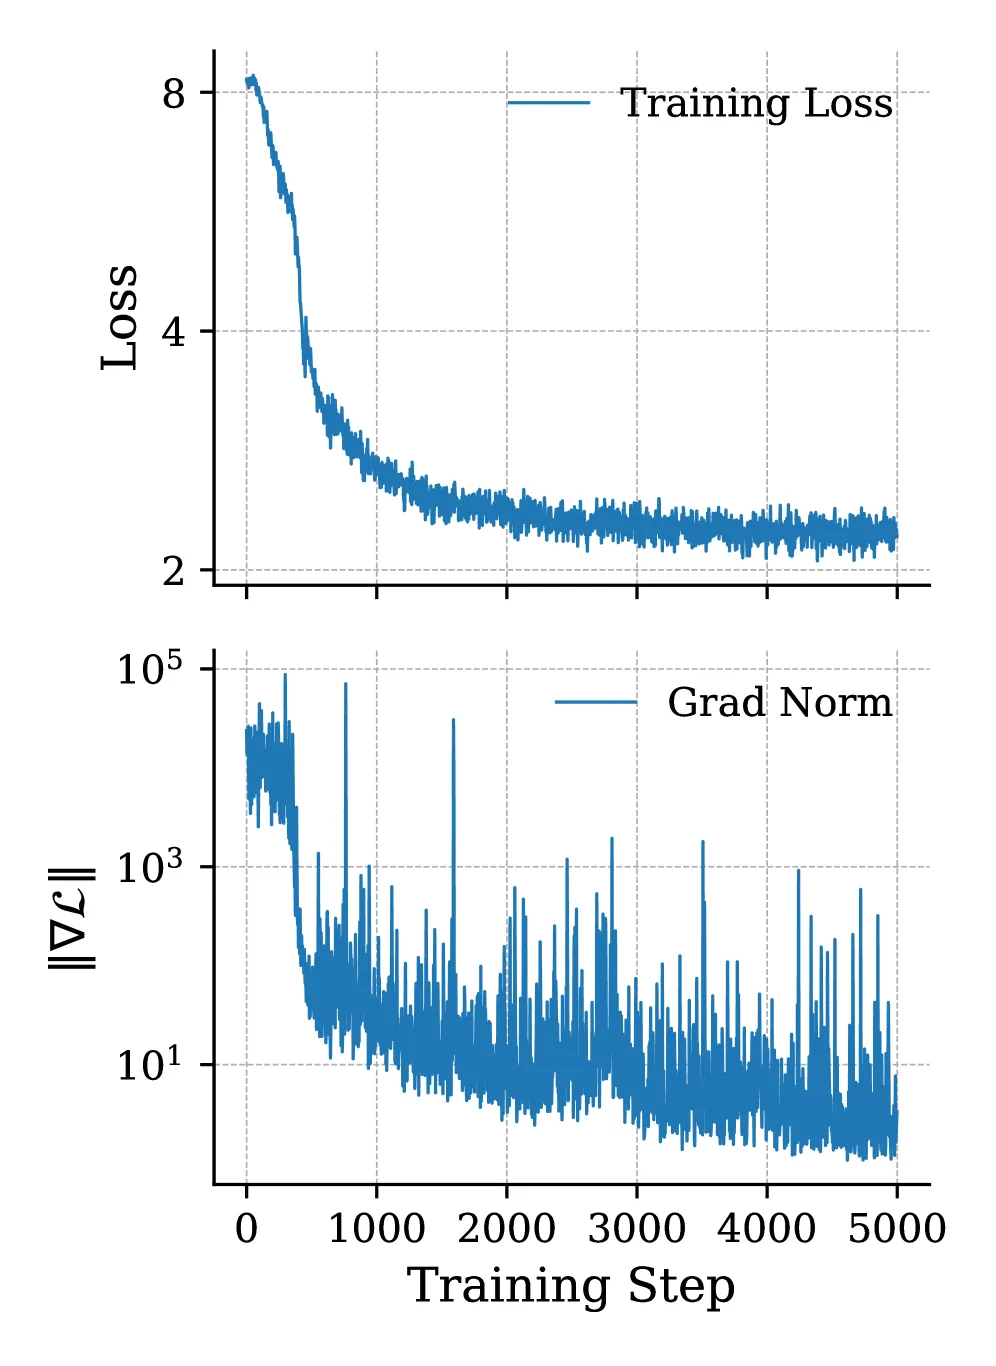
Warmup显著改善训练稳定性:
- 梯度范数峰值大幅降低
- 损失曲线呈”V形”(先降后升再降)
- 最终损失与AR CPT相当
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Token推理知识分析 | 形式化分析随机掩码下的知识学习效率 | 区分推理/相关/噪声三种机制制 |
| AR→DLLM训练课程 | 先AR高效压缩知识,再小块DLLM增强 | 2.5B规模实验验证 |
| 块级裁剪噪声调度 | 确保每个块有非平凡学习信号 | $\Pr[m=0 |
| 渐进式Warmup | 从低腐败度渐进增加,去除损失权重 | 消除AR→DLLM边界梯度峰值 |
五、实验结果
基准测试
Base模型性能
| 模型 | 类型 | HumanEval | HumanEval+ | MBPP | MBPP+ |
|---|---|---|---|---|---|
| Seed-Coder-8B-Base | AR | 77.4 | 68.3 | 82.0 | 69.0 |
| Stable-DiffCoder-8B-Base | DLLM | 79.3 | 73.8 | 83.6 | 67.7 |
| WeDLM-8B-Base | DLLM | 75.0 | 68.9 | 67.0 | - |
| Dream-7B-Base | DLLM | 56.7 | 50.0 | 68.7 | 57.4 |
Instruct模型性能
| 模型 | HumanEval | HumanEval+ | MBPP | MBPP+ |
|---|---|---|---|---|
| Seed-Coder-8B-Instruct | 84.8 | 78.7 | 85.2 | 71.2 |
| Stable-DiffCoder-8B-Instruct | 86.6 | 82.3 | 85.7 | 72.8 |
| Qwen2.5-Coder-7B-Instruct | 88.4 | 84.1 | 83.5 | 71.7 |
| Dream-Coder-7B-Instruct | 82.9 | - | 79.6 | - |
多语言代码生成 (MBXP平均)
| 模型 | 平均 |
|---|---|
| Seed-Coder-8B-Instruct | 75.3 |
| Stable-DiffCoder-8B-Instruct | 75.3 |
| Qwen2.5-Coder-7B-Instruct | 72.9 |
| Yi-Coder-9B-Chat | 71.8 |
更难基准
| 模型 | MHPP | BigCodeBench-Full | BigCodeBench-Hard | LiveCodeBench |
|---|---|---|---|---|
| Seed-Coder-8B-Instruct | 36.2 | 53.3 | 26.4 | 24.7 |
| Stable-DiffCoder-8B-Instruct | 42.4 | 54.8 | 31.8 | 23.5 |
| Qwen3-8B | 32.8 | 51.7 | 23.0 | 23.5 |
关键发现
-
多语言增益:在C#、PHP等低资源语言上获得显著提升,扩散的随机采样有效放大稀缺数据的学习信号
-
代码推理能力:在CRUXEval上,Stable-DiffCoder-8B-Base的Output-CoT达到60.0%,超过Seed-Coder的54.8%
-
代码编辑优势:在CanItEdit上达到60.0%,大幅超过所有其他模型,得益于去噪训练天然适合编辑/填充模式
-
代码生成平衡:在Aider上略弱于Seed-Coder(54.9 vs 57.1),可能因长上下文超出训练窗口
与DLLM基线对比
| DLLM模型 | 规模 | HumanEval | MBPP |
|---|---|---|---|
| LLaDA-8B-Instruct | 8B | 49.4 | 41.0 |
| Dream-7B-Instruct | 7B | 63.4 | 68.3 |
| DiffuCoder-7B-Instruct | 7B | 72.0 | 75.1 |
| Stable-DiffCoder-8B-Instruct | 8B | 86.6 | 85.7 |
| Mercury Coder | - | 90.0 | 77.1 |
| Gemini Diffusion | - | 89.6 | 76.0 |
六、核心贡献
- 理论分析:提出Token推理知识框架,形式化分析DLLM的知识学习效率
- 训练课程:设计AR→小块DLLM的高效训练流程
- 训练稳定性:通过Warmup和块级裁剪噪声调度解决DLLM CPT不稳定性
- SOTA结果:在~8B规模代码模型中达到最佳性能
七、相关工作
| 论文 | 方法 | 与Stable-DiffCoder的区别 |
|---|---|---|
| LLaDA | 全序列掩码扩散 | 块大小=1,更适合AR式解码 |
| Dream | 扩散语言模型 | 未使用块扩散,性能较低 |
| DiffuCoder | 扩散代码模型 | 未解决AR→DLLM训练不稳定性 |
| SDAR | 半自回归扩散 | 混合AR/扩散,不同训练策略 |
| Seed-Coder | AR基线 | 相同架构和数据,用于公平对比 |
八、总结
核心贡献
- 首次系统研究DLLM中的高效知识获取
- 设计稳定的AR→DLLM持续预训练流程
- 在相同数据和架构下超越AR基线
技术影响
- 证明扩散训练可作为有效的数据增强手段
- 为代码DLLM提供实用的训练最佳实践
- 启发后续扩散语言模型研究
局限性
- 主要聚焦代码领域,数学推理和通用文本任务可能受限
- 长上下文任务(如Aider)性能略降
- 未探索更大规模模型的扩展性