Improving MoE Compute Efficiency by Composing Weight and Data Sparsity
通过组合权重稀疏性和数据稀疏性提升 MoE 计算效率
Improving MoE Compute Efficiency by Composing Weight and Data Sparsity
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Improving MoE Compute Efficiency by Composing Weight and Data Sparsity |
| 作者 | Maciej Kilian, Oleg Mkrtchyan, Luke Zettlemoyer, Akshat Shrivastava, Armen Aghajanyan |
| 机构 | Meta AI (FAIR) |
| 论文 | arXiv:2601.15370 |
| 代码 | 未公开 |
| 发布 | 2026年1月 |
| 领域 | 机器学习 (cs.LG), 人工智能 (cs.AI) |
二、核心思想
问题定义
MoE 层通过权重稀疏性 (weight sparsity) 实现计算效率:每个 token 仅激活专家的子集。但这忽略了数据本身的异质性——许多输入包含大量低信息区域(空白区域、重复纹理、无信息背景),而另一些 token 信息密度很高。
数据稀疏性 (data sparsity) 提供了互补的优化轴:每个专家仅处理 token 的子集。然而,Expert-choice routing 直接实现数据稀疏性但违反自回归模型的因果性,造成训练-推理不匹配。
解决方案概述
本文通过在 token-choice MoE 的路由池中引入零计算空专家 (null experts) 来恢复数据稀疏性:
- 当 token 路由到 null expert 时,该槽位不消耗计算
- 标准负载均衡目标训练模型均匀使用所有专家(包括 real 和 null),从而在期望上创建数据稀疏性
- 无需违反因果性,保持 token-choice 的因果特性
核心观察
权重稀疏性和数据稀疏性是正交的效率轴:
- 权重稀疏性约束路由矩阵的列:每个 token 最多激活 个专家
- 数据稀疏性约束路由矩阵的行:每个专家处理不超过 个 token
- 组合两者约束总预算
三、技术架构
核心公式
Token-Choice MoE (基线)
标准 MoE 层包含 个专家网络 ,共享专家 ,路由器 激活每个 token 的 top-K 专家:
Null Expert 机制
扩展路由器输出 个 logits,第 个对应 null expert(输出为零):
关键修改:在 top-K 选择前复制 null logit 次:
路由权重仅在选中的 real expert 上重新归一化,输出幅度不受 null routing 影响。
期望活跃专家数
设 为每个 token 激活的 real expert 数量的随机变量,其中 是 top-K 值, 是目标数据稀疏性:
例如, 表示 top-8 routing + 50% 数据稀疏性,期望激活 4 个 real expert。
阈值解释
复制 null logit 实现了阈值机制:要让 token 激活 个 real expert,路由器学习设置 null logit 使得恰好 个 real expert logit 超过它。剩余 个槽位分配给 null copies。
负载均衡损失
其中 是路由到槽位 的 token 比例, 是平均路由概率。在包含 个 null copies 的扩展池上强制均匀负载,激励目标数据稀疏性。
Z-Loss
防止路由器过度自信,在 null expert 存在时尤为重要(load balancing 和 task loss 冲突更大)。
关键特性
解决方案空间保持
高稀疏配置可以恢复低稀疏解决方案。考虑 vs (都有 ):
- 如果最优方案恰好使用 2 个 expert/token, 的路由器可以学习总是选择 2 个 real expert + 2 个 null expert
- 重新归一化后完全恢复 的输出
- 数据稀疏性只会有帮助:解决方案空间是超集
为什么用零专家而非复制专家
| 特性 | Null Expert (输出=0) | Copy Expert (输出=x) |
|---|---|---|
| 解决方案空间保持 | 保持 | 不保持 |
| MoE 输出 | ||
| 路由行为 | 自然选择性 | 倾向极化(全 real 或全 copy) |
| 残差稀释 | 无 | 输入主导输出 |
实现
Null expert 的实现是对标准 token-choice MoE 的最小修改:
- 扩展路由器 logit 维度
argsort将 null expert 索引()排到末尾- 截断排序后的 token 列表后调用相同的
grouped_mm内核 - 内核本身不变,null expert 几乎零开销
四、实验结果
训练配置
| 参数 | 值 |
|---|---|
| 基础模型 | Qwen3 dense (0.6B, 1.7B) |
| 专家数 | 64 experts, 4× granularity |
| Warmup | 20k steps dense warmup |
| 优化器 | AdamW, lr=2e-5, β=(0.9, 0.95) |
| 学习率调度 | WSD, 500-step warmup |
| Load balancing weight | 2e-2 |
| Z-loss weight | 1e-3 |
| 短期训练 | 50k steps, batch 512, seq 2048 (~52B tokens) |
| 长期训练 | 200k steps, batch 128, seq 8192 (~209B tokens) |
数据稀疏性缩放
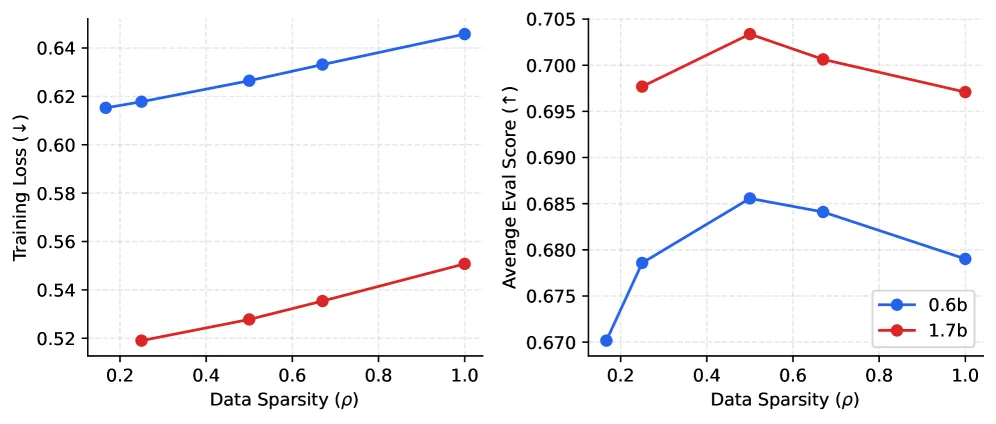
在 的 9 个配置上测试:
三个关键发现:
- 训练损失单调改善:数据稀疏性在两个模型规模上一致改善训练损失,验证解决方案空间保持
- 评估在 达到峰值:高稀疏时评估下降( 低于基线)
- 最优稀疏区域跨尺度一致: 在 0.6B 和 1.7B 上一致,可从小规模调优后迁移
计算效率前沿
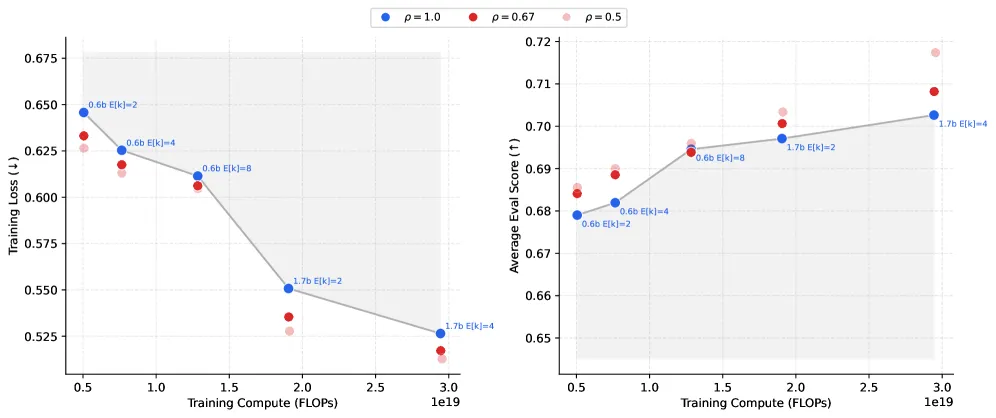
在多个 top-K 值和两个基模型规模上比较三种数据稀疏性(1.0, 0.67, 0.5):
- 数据稀疏性揭示了更高效的计算前沿
- 在匹配的期望 FLOPs 下,数据稀疏配置一致优于密集基线
- 增益在更大计算规模上更明显
Hero Run: 长期训练验证
在 200k steps (209B tokens) 上验证:
| 任务 | 1.7B | 1.7B | Isaac 0.2 (Dense) | InternVL3.5-20B-A4B |
|---|---|---|---|---|
| Pointing | ||||
| Aerial Grounding | 80.7 | 82.2 | 73.1 | – |
| Perceptron Grounding | 58.8 | 59.2 | 51.5 | – |
| RefCOCO | 87.6 | 87.8 | 87.4 | 91.9 |
| Overall | 75.7 | 76.4 | 70.7 | – |
| OCR | ||||
| ChartQA | 79.0 | 80.3 | 75.1 | 86.6 |
| DocVQA | 92.9 | 93.8 | 92.1 | 92.9 |
| A-OKVQA | 89.4 | 91.8 | 87.2 | – |
| TextVQA | 80.8 | 82.0 | 78.1 | 78.5 |
| OCRBench | 873 | 880 | 857 | 870 |
| Overall | 85.9 | 87.2 | 83.6 | – |
| Counting | ||||
| Aerial Counting | 53.0 | 57.0 | 52.0 | – |
| CVBench | 72.1 | 73.8 | 72.5 | – |
| PixMoCount | 68.6 | 69.4 | 66.7 | – |
| CountBench | 85.5 | 87.5 | 84.6 | – |
| Overall | 69.8 | 71.9 | 69.0 | – |
| General | ||||
| VSR | 79.6 | 80.6 | 78.6 | – |
| VQA v2 | 82.6 | 82.4 | 80.8 | – |
| RealWorldQA | 74.1 | 75.1 | 77.9 | 71.2 |
| SEED-Bench | 76.8 | 75.8 | 74.2 | – |
| M3Exam | 54.8 | 58.6 | 55.8 | – |
| NLVR2 | 82.6 | 83.2 | 76.4 | – |
| BLINK | 53.8 | 55.6 | 55.0 | 59.0 |
| MathVista | 73.2 | 73.9 | 69.6 | 78.0 |
| MME | 2221 | 2237 | 2092 | 2318 |
| AI2D | 79.1 | 78.9 | 74.5 | 85.9 |
| ERQA | 40.6 | 39.4 | 36.8 | 41.6 |
| Overall | 70.6 | 71.2 | 68.6 | – |
关键结果:18B-A3B 数据稀疏 MoE 一致优于 2B dense 基线,在大多数任务上接近或超过 20B-A4B InternVL3.5。
五、模态感知计算分配
核心发现
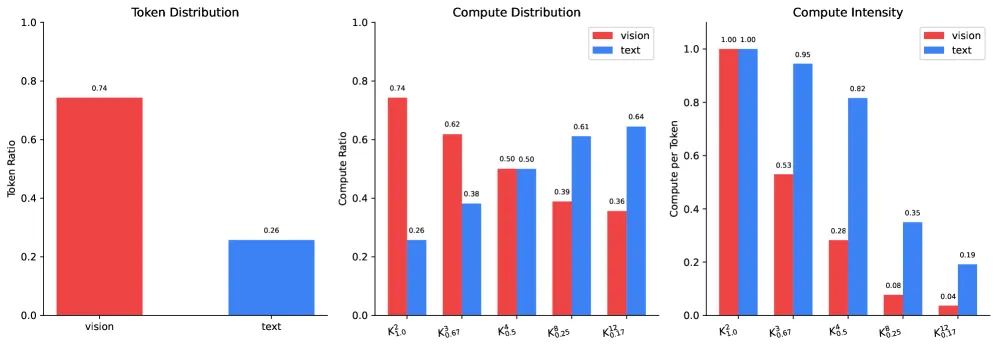
Null expert 反转了模态间的计算分布:
| 配置 | Vision Token 占比 | Vision 计算占比 | Text 计算占比 |
|---|---|---|---|
| (Dense) | 78% | 78% | 22% |
| 78% | ~60% | ~40% | |
| 78% | ~30% | ~70% | |
| 78% | ~15% | ~85% |
- 在密集配置中,计算分布镜像 token 分布(78% vision)
- 随着数据稀疏性增加,vision token 更激进地路由到 null expert
- 在 ,vision 计算强度降至 4%,text 为 22%
- 文本消耗 60% 的总计算,尽管仅占 22% 的 token
任务依赖的计算分配
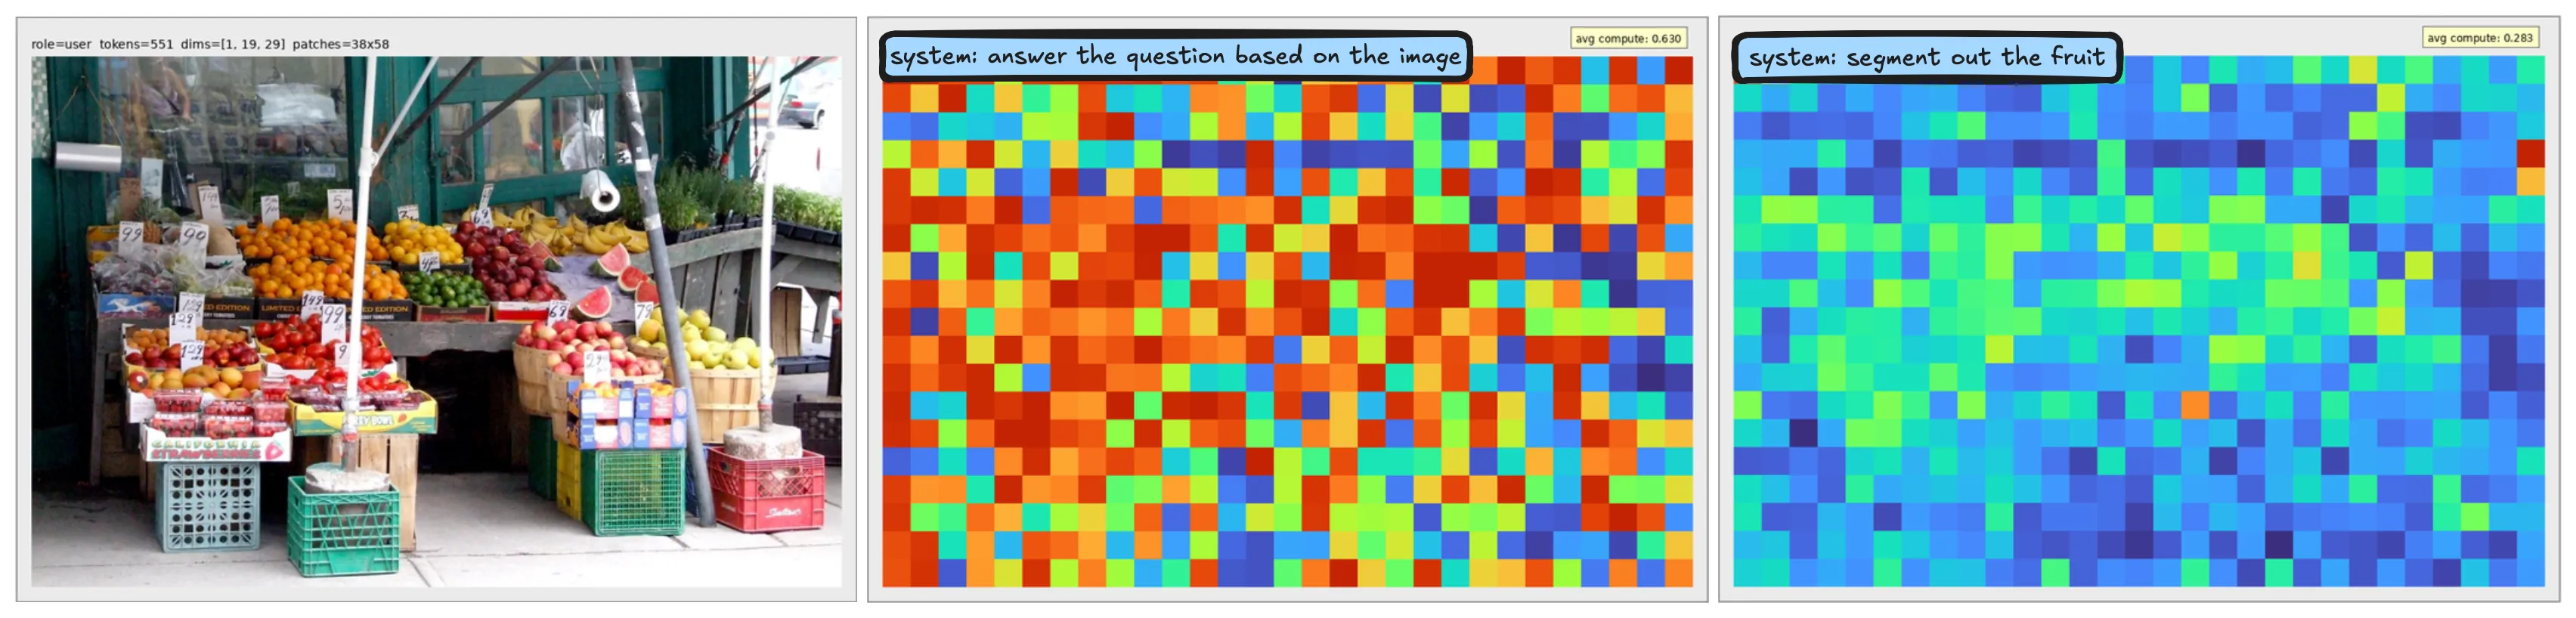
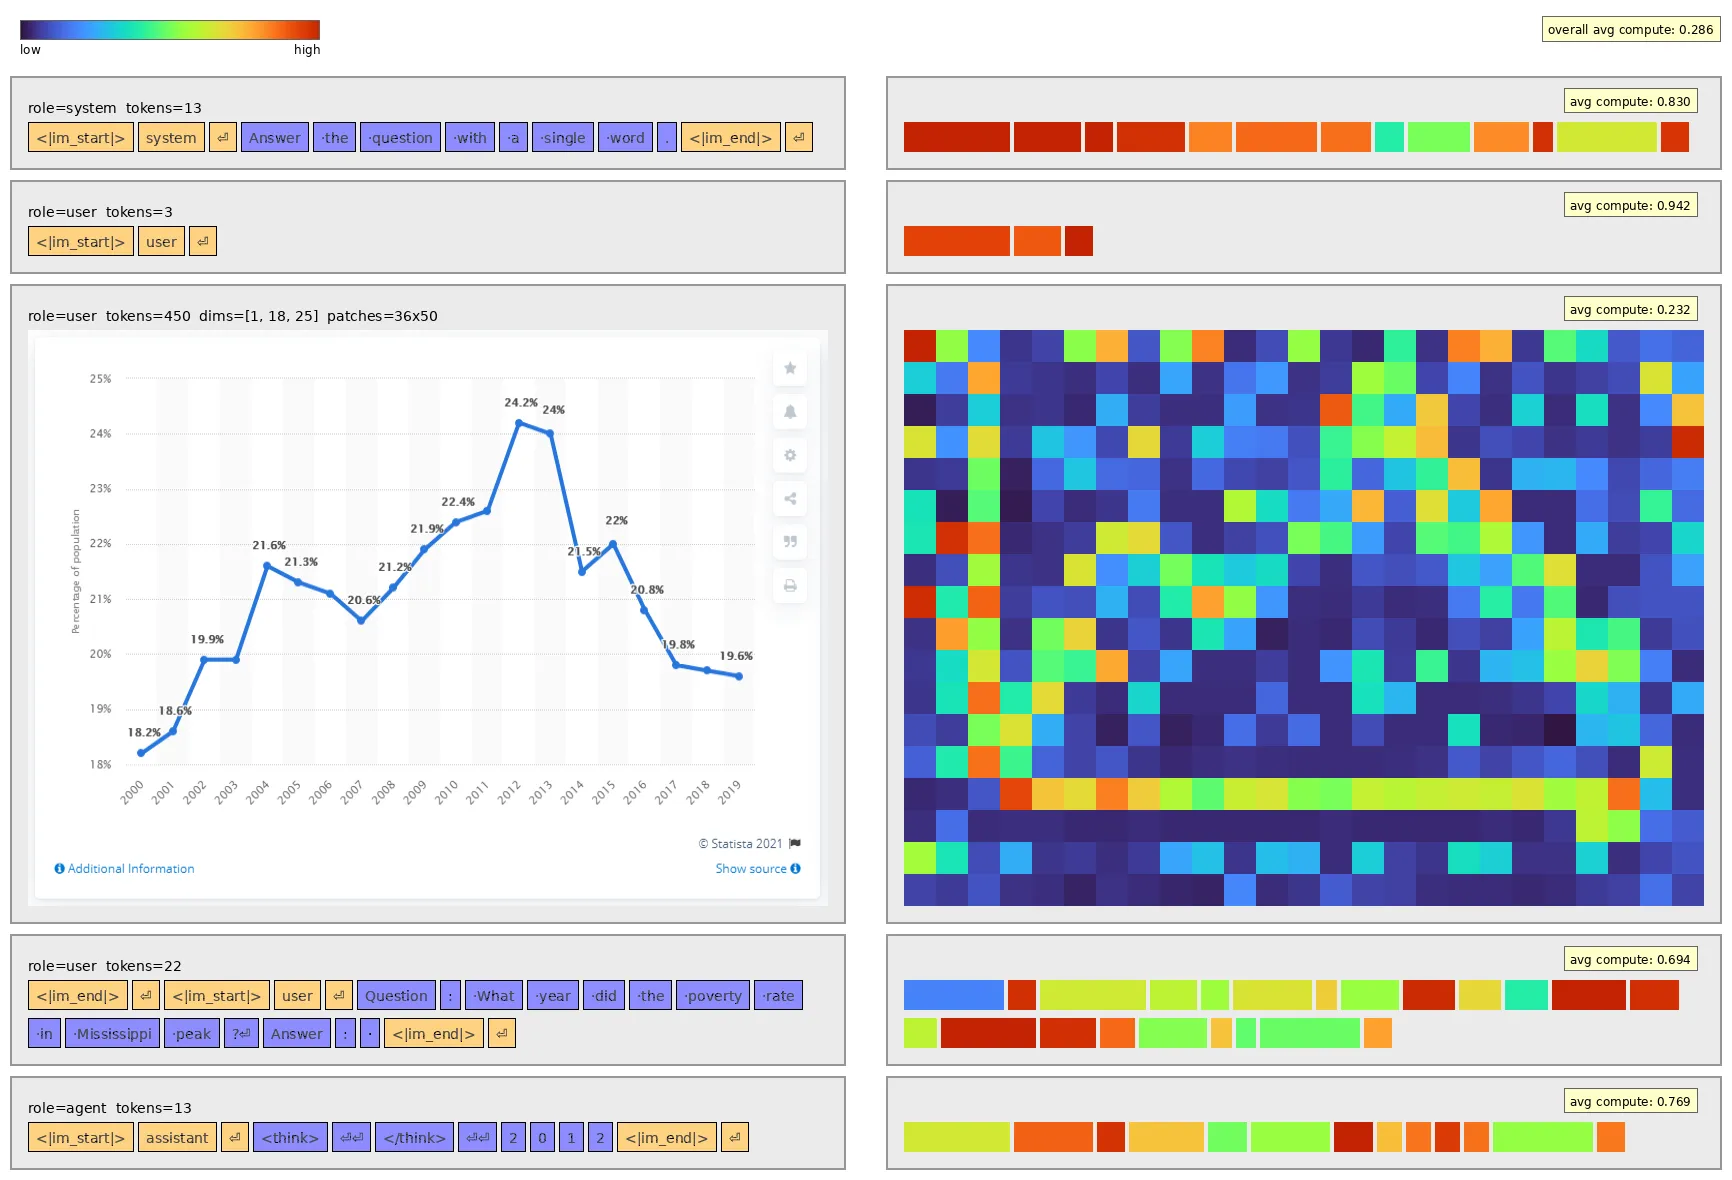
同一图像在不同 prompt 下获得不同计算图:
- 通用 QA prompt:计算广泛分布
- 定向分割 prompt:计算集中在任务相关区域
- 无需显式模态路由,从训练中涌现
模态内变异
计算不仅在模态间变化,模态内也有显著变异:
- Vision tokens:显著区域获得比背景更多计算
- Text tokens:可预测延续、标点、控制序列更激进地路由到 null expert
- 信息密集 token 保留更多计算
六、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 正交稀疏性组合 | 权重稀疏性和数据稀疏性是正交效率轴,组合产生更优前沿 | 匹配 FLOPs 下一致优于仅权重稀疏基线 |
| Null Expert 机制 | 在 token-choice MoE 中通过零计算专家实现数据稀疏性 | 最小代码修改,内核不变,几乎零开销 |
| 因果性保持 | 不同于 expert-choice,null expert 方案保持因果性 | 无训练-推理不匹配 |
| 解决方案空间保持 | 高稀疏配置可恢复低稀疏解决方案 | 理论证明 + 实验验证 |
| 涌现模态感知 | 模型自动学习按信息内容分配计算,无需显式模态路由 | Vision 计算强度降至 4%,Text 为 22% |
七、高稀疏性失效分析
训练损失在高稀疏性下持续改善,但评估在 后退化。三个交互效应:
- Softmax 分辨率降低:大量 null copies 在同一 softmax 中竞争,压缩 real expert 间的相对差异
- 阈值不稳定性:null 阈值必须高于大多数 real logit,使中间分配对微小扰动敏感,模型倾向全有或全无策略
- 负载均衡失配:平衡项隐式要求在语义专家和”什么都不做”区域间均匀分配 token
根因:计算决策(多少 real expert)和身份决策(哪些 real expert)耦合在单个归一化路由分布中。
八、总结
核心贡献
- 正交稀疏性框架:形式化权重稀疏性和数据稀疏性为路由矩阵的正交约束
- Null Expert 机制:最小修改 token-choice MoE 实现因果数据稀疏性
- 计算控制实验:在匹配 FLOPs 下验证组合稀疏性的优势
- 涌现模态感知:模型自动学习按信息内容分配计算
- 解决方案空间分析:证明高稀疏配置包含低稀疏解决方案
技术影响
- 为 MoE 架构设计开辟了数据稀疏性这一新优化维度
- 在 VLM 训练中特别有效(vision token 冗余性高)
- 实现简单,可直接集成到现有 MoE 框架
- 为自适应计算提供了无需显式模态路由的优雅方案
局限性
- 评估在高稀疏性 () 下退化,需要更好的路由机制
- 单 softmax 耦合计算决策和身份决策是瓶颈
- 仅在 VLM 训练上验证,其他模态/任务的泛化性待验证
- 代码未公开
九、参考资源
- 论文: arXiv:2601.15370
- 关键依赖:
- Switch Transformer (Fedus et al., 2022): Token-choice MoE
- Expert-Choice MoE (Zhou et al., 2022): 数据稀疏性基线
- MoE++ (Jin et al., 2024): Null expert 先驱
- LongCat-Flash (Team et al., 2025): 560B 参数零计算专家
分析日期: 2026-06-04