Jet-RL: Enabling On-Policy FP8 Reinforcement Learning with Unified Training and Rollout Precision Flow
统一FP8精度流的强化学习训练框架,实现16%端到端加速
Jet-RL: Enabling On-Policy FP8 Reinforcement Learning with Unified Training and Rollout Precision Flow
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Jet-RL: Enabling On-Policy FP8 Reinforcement Learning with Unified Training and Rollout Precision Flow |
| 作者 | Haocheng Xi, Charlie Ruan, Peiyuan Liao, Yujun Lin, Han Cai, Yilong Zhao, Shuo Yang, Kurt Keutzer, Song Han, Ligeng Zhu |
| 机构 | NVIDIA, MIT, UC Berkeley, Independent Researcher |
| 论文 | arXiv:2601.14243 |
| 发布 | 2026年1月20日 (v1), 2026年1月24日 (v2) |
| 领域 | cs.LG, cs.CL |
二、核心思想
问题定义
强化学习(RL)是增强大语言模型(LLM)复杂推理能力的关键技术。然而,现有RL训练流程存在严重的计算效率问题:
-
Rollout阶段瓶颈:Rollout阶段占总训练时间的70%以上
- 有效推理通常需要生成超过6000个token的长序列
- LLM的自回归特性导致rollout阶段耗时巨大
-
BF16-train-FP8-rollout策略的局限性:
- 长序列生成失败:当rollout长度超过8K时,性能急剧下降
- 困难任务失败:当模型缺乏强任务先验时,训练曲线快速发散
- 根本原因:训练和推理之间的数值不匹配导致off-policy问题
解决方案概述
本文提出Jet-RL,一种支持on-policy FP8强化学习训练的框架:
核心思想:采用统一的FP8精度流(unified FP8 precision flow)用于训练和rollout,消除训练-推理数值不匹配,确保RL训练的on-policy特性。
关键创新:
- 统一精度流:训练前向传播和推理rollout使用相同的FP8量化方案
- 细粒度量化:权重使用128×128 per-block量化,激活和梯度使用1×128 per-group量化
- 无需校准:避免了昂贵的PTQ校准步骤
核心成果:
- Rollout阶段加速 33%
- 训练阶段加速 41%
- 端到端加速 16%
- 性能损失小于 1%
三、技术架构
整体框架图
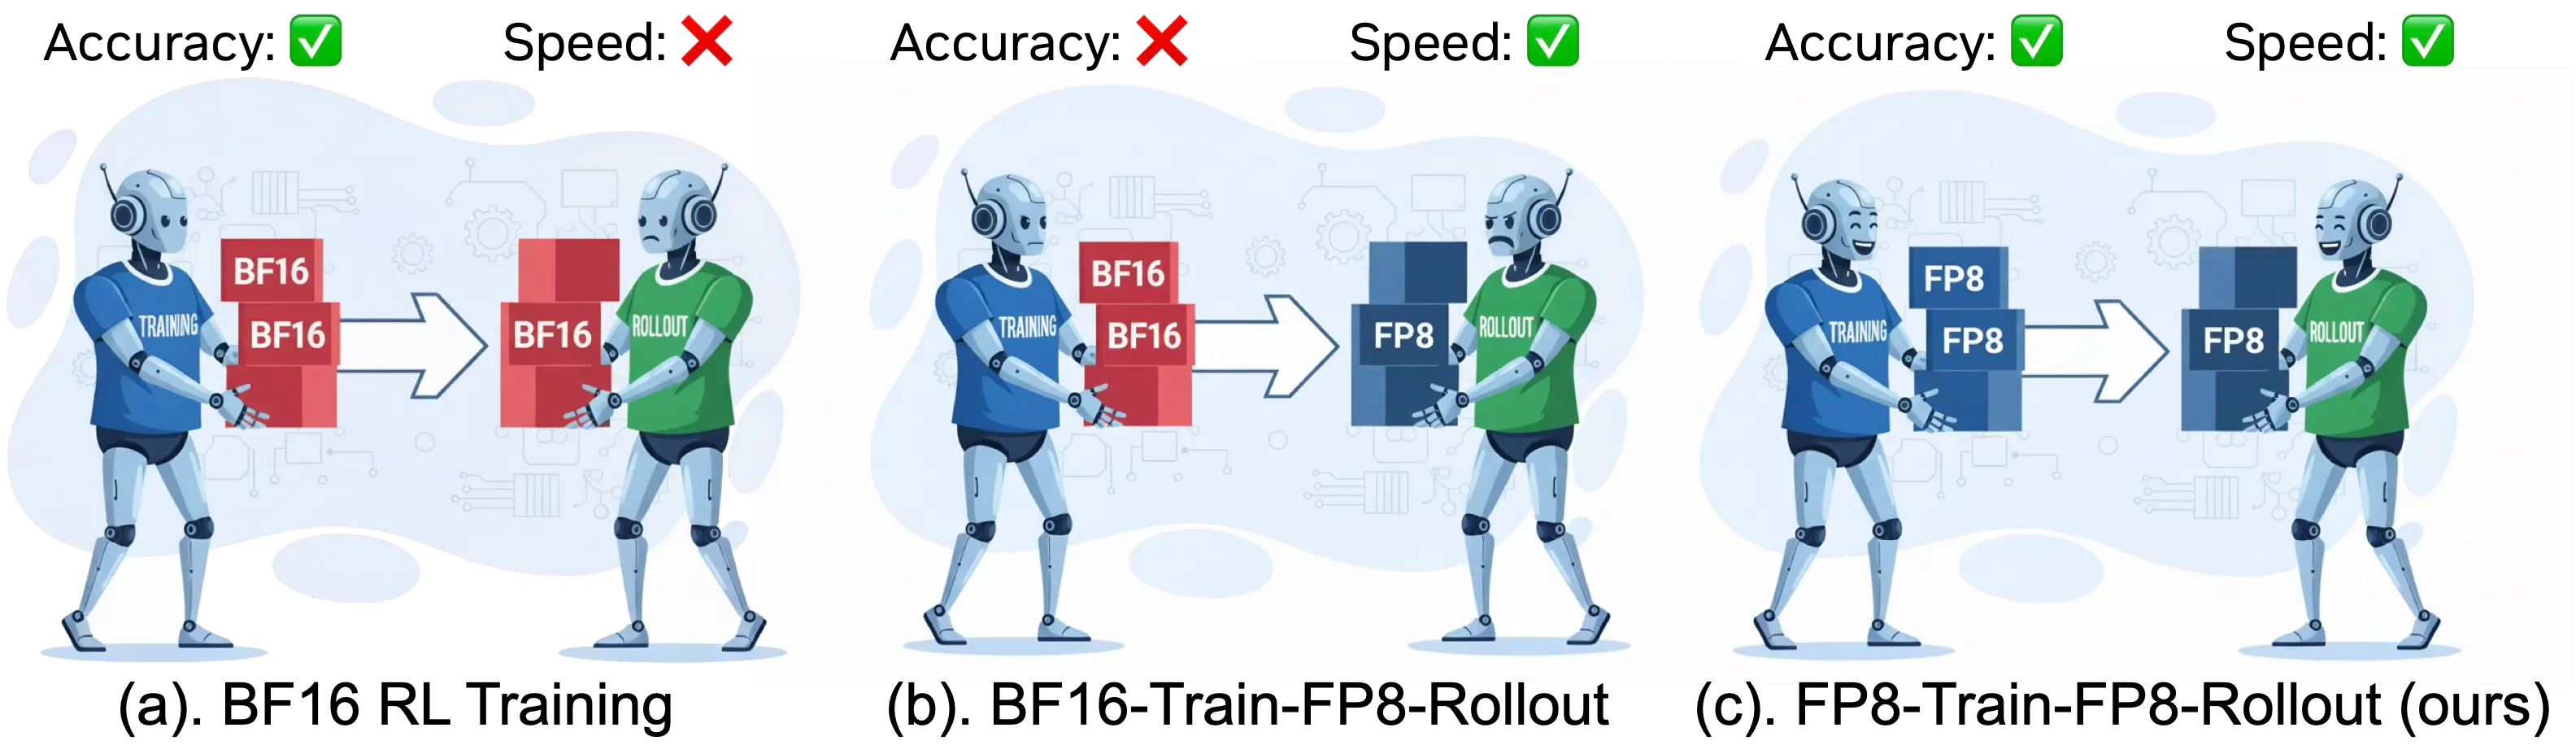
Figure 1: JetRL与其他方法的RL训练流程对比。JetRL提出统一精度流用于FP8 RL训练,兼顾性能和吞吐量。
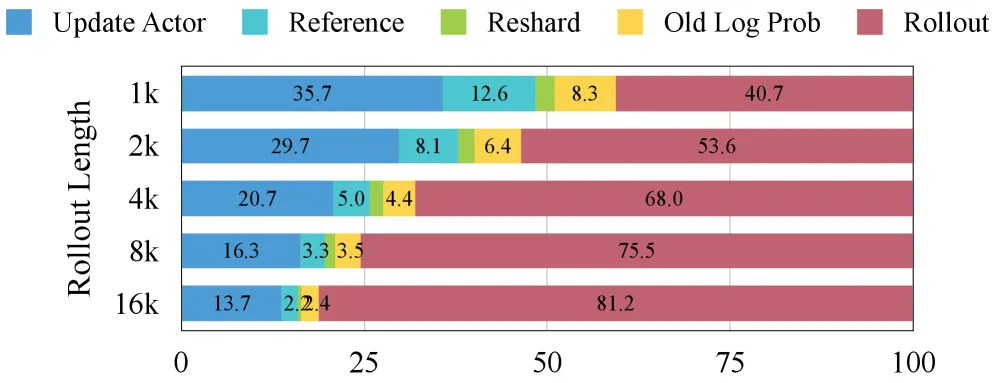
Figure 2: Rollout生成主导RL训练延迟。当rollout长度大于8k时,rollout将占用超过75%的总延迟。
核心公式
量化基础
FP8量化公式:
其中 是量化后的低精度张量, 是缩放因子, (E4M3格式)。
线性层的三个GEMM
前向传播 (FProp):
权重梯度 (WGrad):
激活梯度 (DGrad):
GEMM布局要求
| GEMM | 第一个操作数 | 第二个操作数 | 表达式 |
|---|---|---|---|
| FProp | Row | Row | |
| WGrad | Col | Col | |
| DGrad | Col | Row |
精度流图模型
训练图:
- 节点 :算子或权重
- 边 :张量传播,表示精度和量化粒度
推理图:
- BF16-train-FP8-rollout的问题:
- Jet-RL的解决方案:
量化方案
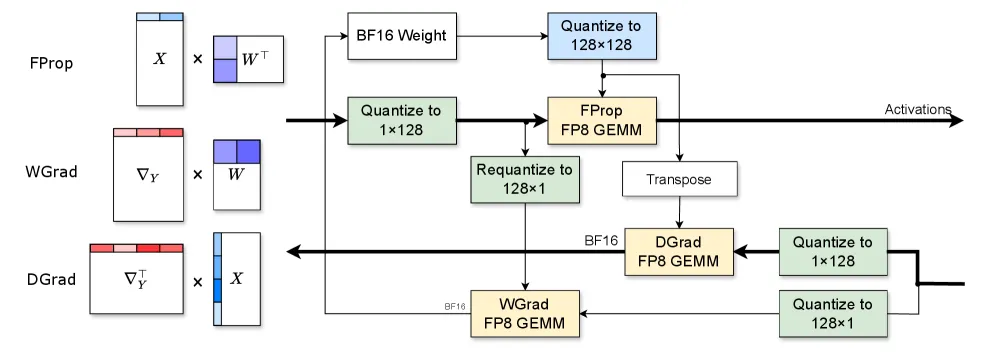
Figure 6: 线性层的量化方案。FProp和WGrad GEMM使用(1×128)×(128×128) FP8矩阵乘法核,DGrad GEMM使用(1×128)×(128×1) FP8矩阵乘法核。
| 组件 | 量化粒度 | 说明 |
|---|---|---|
| 权重 | 128×128 per-block | 稳定训练 |
| 激活 | 1×128 per-group | 前向传播 |
| 梯度 | 1×128 per-group | 反向传播 |
| FProp | (1×128) × (128×128) | 前向GEMM |
| WGrad | (1×128) × (128×1) | 权重梯度GEMM |
| DGrad | (1×128) × (128×128) | 激活梯度GEMM |
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| Actor模型 | 主要训练的LLM | FP8精度 |
| Reference模型 | 计算KL散度 | FP8精度 |
| Reward模型 | 提供奖励信号 | BF16精度 |
| Critic模型 | 估计价值函数 | BF16精度 |
| DeepGEMM | FP8 GEMM内核 | 来自DeepSeek-V3 |
训练流程
Jet-RL训练流程:
-
Rollout阶段:
- Actor模型使用FP8精度自回归生成响应
- 使用vLLM推理引擎
- 统一的FP8量化方案
-
评估阶段:
- Reference、Reward、Critic模型执行前向传播
- 计算KL散度、奖励、价值估计
-
更新阶段:
- 使用GAE(Generalized Advantage Estimation)计算优势
- Actor模型执行FP8训练步骤
- 权重在BF16主副本上更新
-
同步阶段:
- 将更新后的权重从训练框架传输到推理引擎
- 保持on-policy一致性
算法流程
Algorithm 1: Jet-RL训练算法
输入: 模型参数 θ, 训练数据 D, 学习率 η
输出: 训练后的模型参数 θ*

初始化:
  θ_bf16 ← θ (BF16主副本)
  θ_fp8 ← quantize(θ_bf16) (FP8副本用于推理)

for each batch in D do
    // Rollout阶段 (FP8)
    responses ← Actor.generate(prompts, θ_fp8)  // FP8推理

    // 评估阶段
    ref_scores ← Reference.forward(responses, θ_fp8)
    rewards ← Reward.forward(responses)
    values ← Critic.forward(responses)

    // 计算优势
    advantages ← GAE(rewards, values)

    // 更新阶段 (FP8训练)
    loss ← PPO_Loss(responses, advantages, θ_fp8)
    θ_bf16 ← θ_bf16 - η * ∇loss  // BF16更新

    // 同步阶段
    θ_fp8 ← quantize(θ_bf16)  // 重新量化
end for
BF16-train-FP8-rollout失败分析
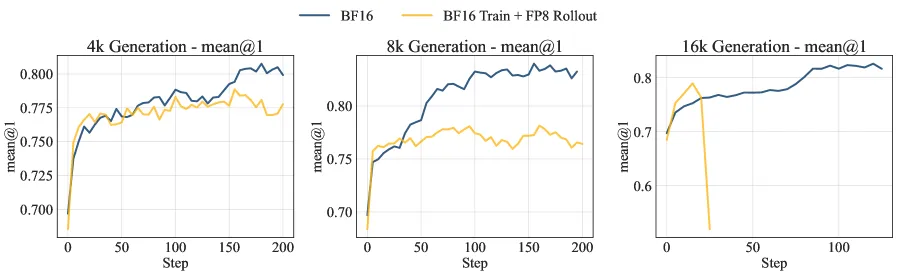
Figure 3: 朴素BF16训练+FP8 Rollout在rollout上下文长度增加时失败。
失败场景1:长序列生成
- 4K rollout:BF16和FP8性能相当
- 8K rollout:FP8开始发散
- 16K rollout:FP8在20步后崩溃
失败原因:
- 小的数值差异在长链推理中逐渐累积
- 训练和rollout精度之间的不匹配随着rollout长度增加而放大
- 累积误差放大了off-policy训练的影响
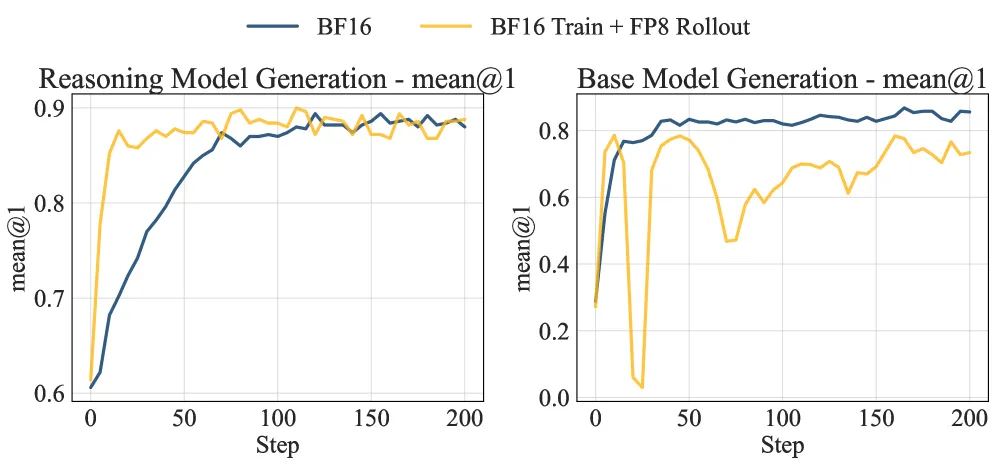
Figure 4: 在困难任务上,BF16-Train-FP8-Rollout容易退化。
失败场景2:困难任务
- 简单任务(GSM8K + Qwen3-8B):FP8性能相当
- 困难任务(MATH + Qwen3-8B-Base):FP8快速发散
失败原因:
- 模型对任务有强先验时,对FP8量化误差不敏感
- 任务难度增加、模型置信度降低时,量化误差显著扭曲rollout轨迹
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 统一FP8精度流 | 训练和推理使用相同的量化方案 | 消除on-policy不一致性 |
| 细粒度量化 | 权重128×128,激活1×128 | 比per-tensor更稳定 |
| 无校准设计 | 避免昂贵的PTQ校准 | 兼容tensor parallelism |
| 精度流图模型 | 形式化描述量化精度传播 | 理论保证推理是训练的子图 |
| DeepGEMM集成 | 使用高效的FP8 GEMM内核 | 来自DeepSeek-V3 |
与现有方法对比
| 方法 | 训练精度 | Rollout精度 | 稳定性 | 性能损失 |
|---|---|---|---|---|
| BF16基线 | BF16 | BF16 | 稳定 | 0% |
| BF16-train-FP8-rollout | BF16 | FP8 | 不稳定 | 5-10% |
| Jet-RL | FP8 | FP8 | 稳定 | ~1% |
精度流图对比
BF16-train-FP8-rollout:
- :所有边为BF16
- :线性层输入边为FP8
- 问题:,导致off-policy
Jet-RL:
- :线性层输入边为FP8
- 优势:推理图是训练图的子图,保证on-policy
五、实验结果
基准测试
实验环境:
- GPU:NVIDIA H100
- 模型:Llama3.1-8B, Qwen2.5-7B, Qwen3-8B-Base
- 数据集:GSM8K + MATH, DeepMATH
- Rollout长度:4K, 8K, 16K
- RL算法:GRPO
超参数:
- 学习率:
- Batch size:256
- KL损失系数:
- 评估间隔:每5步
准确性评估 (8K Rollout)
| 模型 | 方法 | GSM8K | MATH500 | GPQA | SuperGPQA | 平均 |
|---|---|---|---|---|---|---|
| Llama3.1-8B | BF16 | 49.0 | 12.1 | 15.7 | 15.9 | 23.2 |
| BF16-train-FP8-rollout | 20.6 ↓28.4 | 5.4 ↓6.7 | 11.2 ↓4.5 | 14.7 ↓1.2 | 13.0 ↓10.2 | |
| Jet-RL | 47.2 ↓1.8 | 11.3 ↓0.8 | 22.3 ↑6.6 | 19.9 ↑4.0 | 25.2 ↑2.0 | |
| Qwen2.5-7B | BF16 | 91.8 | 71.0 | 36.0 | 28.6 | 56.9 |
| BF16-train-FP8-rollout | 未收敛 | - | - | - | - | |
| Jet-RL | 89.9 ↓1.9 | 69.5 ↓1.5 | 35.5 ↓0.5 | 28.5 ↓0.1 | 55.9 ↓1.0 | |
| Qwen3-8B-Base | BF16 | 92.9 | 83.3 | 43.7 | 35.1 | 63.8 |
| BF16-train-FP8-rollout | 92.1 ↓0.8 | 77.0 ↓6.3 | 44.2 ↑0.5 | 30.3 ↓4.8 | 60.9 ↓2.9 | |
| Jet-RL | 93.1 ↑1.0 | 81.3 ↓2.0 | 42.1 ↓1.6 | 35.2 ↑0.1 | 62.7 ↓1.1 |
准确性评估 (16K Rollout / DeepMATH)
| 模型 | 方法 | GSM8K | MATH500 | GPQA | SuperGPQA | 平均 |
|---|---|---|---|---|---|---|
| Qwen2.5-7B (16K) | BF16 | 91.5 | 72.8 | 28.4 | 42.2 | 58.7 |
| BF16-train-FP8-rollout | 90.7 ↓0.8 | 68.1 ↓4.7 | 28.9 ↑0.5 | 26.9 ↓15.3 | 53.7 ↓5.0 | |
| Jet-RL | 89.3 ↓2.2 | 69.2 ↓3.6 | 36.5 ↑8.1 | 27.8 ↓14.4 | 55.7 ↓3.0 | |
| Qwen3-8B-Base (16K) | BF16 | 94.7 | 81.7 | 46.2 | 33.5 | 64.0 |
| BF16-train-FP8-rollout | 未收敛 | - | - | - | - | |
| Jet-RL | 92.1 ↓2.6 | 76.7 ↓5.0 | 43.3 ↓2.9 | 33.2 ↓0.3 | 61.3 ↓2.7 | |
| Qwen3-8B-Base (DeepMATH) | BF16 | - | 83.4 | 44.2 | 36.1 | 54.6 |
| BF16-train-FP8-rollout | - | 57.8 ↓25.6 | 42.6 ↓1.6 | 32.6 ↓3.5 | 44.3 ↓10.3 | |
| Jet-RL | - | 80.2 ↓3.2 | 47.2 ↑3.0 | 33.8 ↓2.3 | 53.7 ↓0.9 |
效率评估
Rollout阶段加速
| 模型 & TP | 4K | 8K | 16K |
|---|---|---|---|
| 8B (TP=1) | 1.12× | 1.10× | 1.12× |
| 14B (TP=1) | 1.26× | 1.28× | 1.29× |
| 14B (TP=2) | 1.08× | 1.12× | 1.10× |
| 32B (TP=2) | 1.29× | 1.33× | 1.30× |
| 32B (TP=4) | 1.08× | 1.07× | 1.10× |
趋势分析:
- 模型规模:更大模型获得更多加速(32B > 14B > 8B)
- Tensor Parallelism:更高TP降低加速比(通信开销增加)
端到端加速 (Qwen3-8B, 8K Rollout)
| 阶段 | 加速比 |
|---|---|
| Actor更新 | 1.54× |
| Reference模型推理 | 1.80× |
| 训练阶段整体 | 1.41× |
| Rollout阶段 | 1.33× |
| 端到端 | 1.16× |
关键发现
-
BF16-train-FP8-rollout的脆弱性:
- 在Llama3.1-8B上平均下降10.2%
- 在Qwen2.5-7B上完全不收敛
- 在16K rollout或DeepMATH上进一步恶化
-
Jet-RL的鲁棒性:
- 所有设置下均收敛
- 性能损失通常小于1%
- 在某些情况下甚至优于BF16基线
-
效率收益:
- 大模型(32B) rollout加速1.33×
- 训练阶段加速1.41×
- 端到端加速1.16×
六、相关工作
低精度训练和推理
- SmoothQuant:解决激活异常值问题
- GPTQ:3-4位PTQ量化
- AWQ:激活感知的权重量化
- Jetfire:INT8训练
- Transformer Engine:NVIDIA FP8训练
- COAT:扩展FP8到优化器状态和激活
LLM强化学习
- RLHF/PPO:基于人类反馈的强化学习
- DPO:直接偏好优化
- GRPO:无评论家的RL算法(DeepSeek-R1)
- DAPO:避免熵崩溃的Clip-Higher技术
高效推理
- AReaL:异步RL框架
- ReaLHF:自动化并行化搜索
- NoThinking:剪枝冗余推理轨迹
- QeRL:NVFP4 + LoRA高效RL
- TIS:截断重要性采样
七、总结
核心贡献
-
识别BF16-train-FP8-rollout的根本缺陷:
- 在长rollout和困难任务上导致训练不稳定
- 数值不匹配导致off-policy问题
-
提出Jet-RL框架:
- 统一FP8精度流用于训练和rollout
- 消除训练-推理数值不匹配
- 确保on-policy RL训练
-
验证有效性:
- Rollout加速33%,训练加速41%,端到端加速16%
- 性能损失小于1%
- 在所有设置下稳定收敛
技术影响
- RL训练效率:显著降低RL训练的计算成本
- FP8可靠性:证明FP8在RL训练中的可行性
- 系统设计:统一精度流的设计范式
- 工程实践:可直接集成到现有RL框架(veRL, vLLM)
局限性
- 模型规模:主要在7B-8B模型上验证,32B的端到端加速未完整测试
- RL算法:主要使用GRPO,其他RL算法的适用性待验证
- 硬件依赖:需要支持FP8的GPU(如H100)
- 通信开销:高TP设置下加速比降低
未来工作
- 更大规模模型(14B-32B)的完整scaling study
- 其他RL算法(PPO, DPO)的适配
- 异步RL框架的集成
- 与QeRL等其他加速技术的结合
八、参考资源
- 论文: arXiv:2601.14243
- PDF: arxiv.org/pdf/2601.14243
- HTML版本: arxiv.org/html/2601.14243v2
引用
@article{xi2026jetrl,
  title={Jet-RL: Enabling On-Policy FP8 Reinforcement Learning with Unified Training and Rollout Precision Flow},
  author={Xi, Haocheng and Ruan, Charlie and Liao, Peiyuan and Lin, Yujun and Cai, Han and Zhao, Yilong and Yang, Shuo and Keutzer, Kurt and Han, Song and Zhu, Ligeng},
  journal={arXiv preprint arXiv:2601.14243},
  year={2026}
}