MOD-DiT: Mixture of Distributions for Dynamic Sparse Attention in Video Diffusion Transformers
训练自由、无采样的动态稀疏注意力框架,通过线性近似模型预测三种核心注意力模式(块对角、平行对角、垂直)的强度演化,在 HunyuanVideo 上实现 2.05× 加速,在 Wan2.1 上实现 1.75× 加速。
MOD-DiT: 视频扩散 Transformer 的动态稀疏注意力
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Mixture of Distributions Matters: Dynamic Sparse Attention for Efficient Video Diffusion Transformers |
| 作者 | Yuxi Liu, Yipeng Hu (北京大学), Zekun Zhang (UESTC), Kunze Jiang (USTC), Kun Yuan (北京大学) |
| 机构 | 北京大学、电子科技大学、中国科学技术大学 |
| 论文 | arXiv:2601.11641 |
| 版本 | v3 (2026-07-01) |
| 学科 | cs.CV, cs.LG |
| 许可 | arXiv 永久非独占许可 |
二、核心思想
问题定义
视频扩散 Transformer(vDiT)通过 3D 全注意力机制联合建模时空动态,推动了 CogVideoX、HunyuanVideo、Wan2.1 等 SOTA 模型的发展。然而,自注意力的二次计算复杂度仍然是长序列视频生成实际部署的关键瓶颈。
现有稀疏注意力方法存在两大缺陷:
- 静态模式:依赖简化的固定稀疏模式(如固定垂直网格或全局指数衰减),无法捕捉 vDiT 中注意力分布的动态混合特性
- 采样开销:动态稀疏方法依赖计算昂贵的采样操作,反而抵消了效率收益,且忽略了去噪步对稀疏注意力的影响
解决方案概述
MOD-DiT(Mixture-Of-Distribution DiT)是一种训练自由、无采样的动态稀疏注意力框架,通过两阶段过程精确建模演化的注意力模式:
- 线性近似模型:利用早期去噪步的先验信息,通过分布式混合方法建模高效的线性近似模型,预测特定去噪区间的 mask 模式
- 在线块掩码策略:动态应用预测的 mask,同时保留历史稀疏信息,无需重复采样操作
关键指标:HunyuanVideo 2.05× 加速,Wan2.1 1.75× 加速,同时在 VBench 上保持顶级质量。
三、技术架构
整体框架
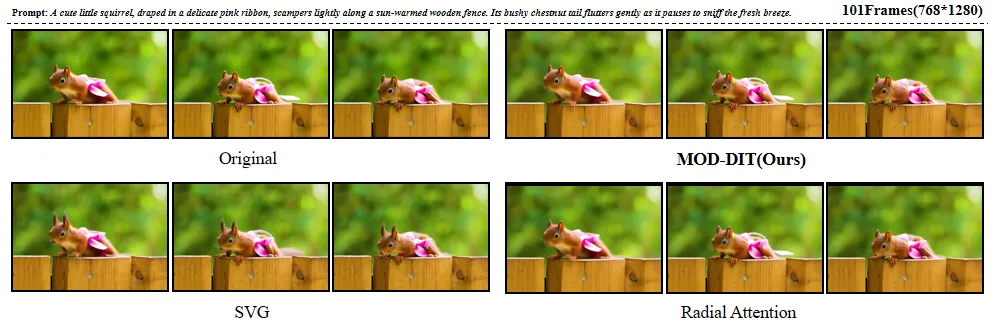
图 1. MOD-DiT 在 HunyuanVideo 上的可视化对比:始终实现 2.05× 加速,且保持与原始视频几乎相同的生成质量。
核心公式
稀疏注意力定义:
其中 为缩放注意力分数, 为二元 mask( 表示丢弃交互)。
注意力稀疏图构建:
其中 为稀疏阈值, 为指示函数。 越小表示该块包含的信息越丰富。
广义线性近似模型:
其中 为每维块数。三项基矩阵分别对应:
- 平行对角模式 :建模帧间空间相关性,偏移量
- 垂直模式 :通过列状结构捕获跨 token 全局依赖
- 块对角模式 :维持帧内时间相干性, 为有效块索引集
系数求解(最小二乘):
其中 为设计矩阵。归一化近似误差 随序列长度增大而减小。
代理密集注意力重建:
线性预测(中段-末段去噪步):
动态 Mask 生成:
其中 为 Top-K 动态模式集, 为块对角支撑集(通过静态阈值 条件保留)。
稀疏掩码保真度分数(SMFS):
值越低表示稀疏 mask 以更少的计算保留了更多关键注意力信息。
注意力模式可视化
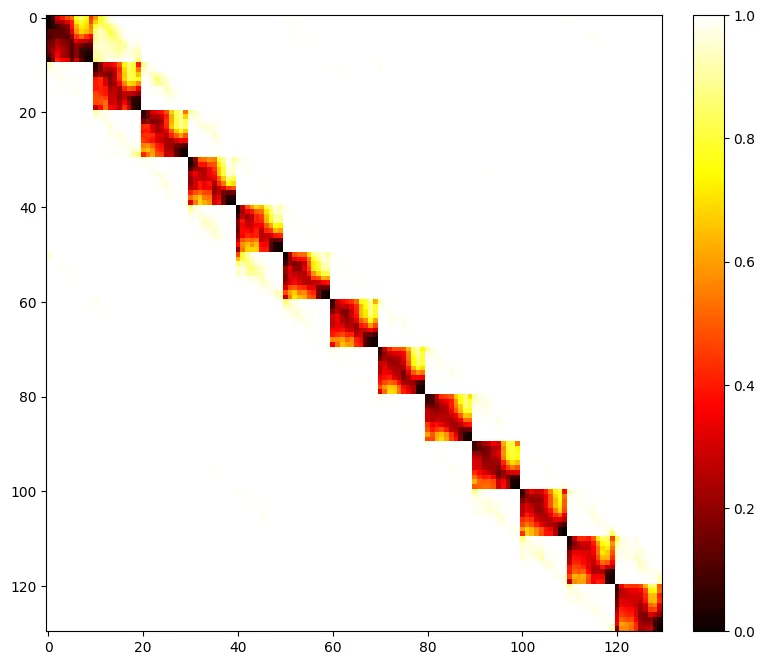
图 2. CogVideoX-v1.5 中的四种注意力模式可视化:(a) 块对角、(b) 平行对角、(c) 垂直、(d) 混合。
稀疏图演化
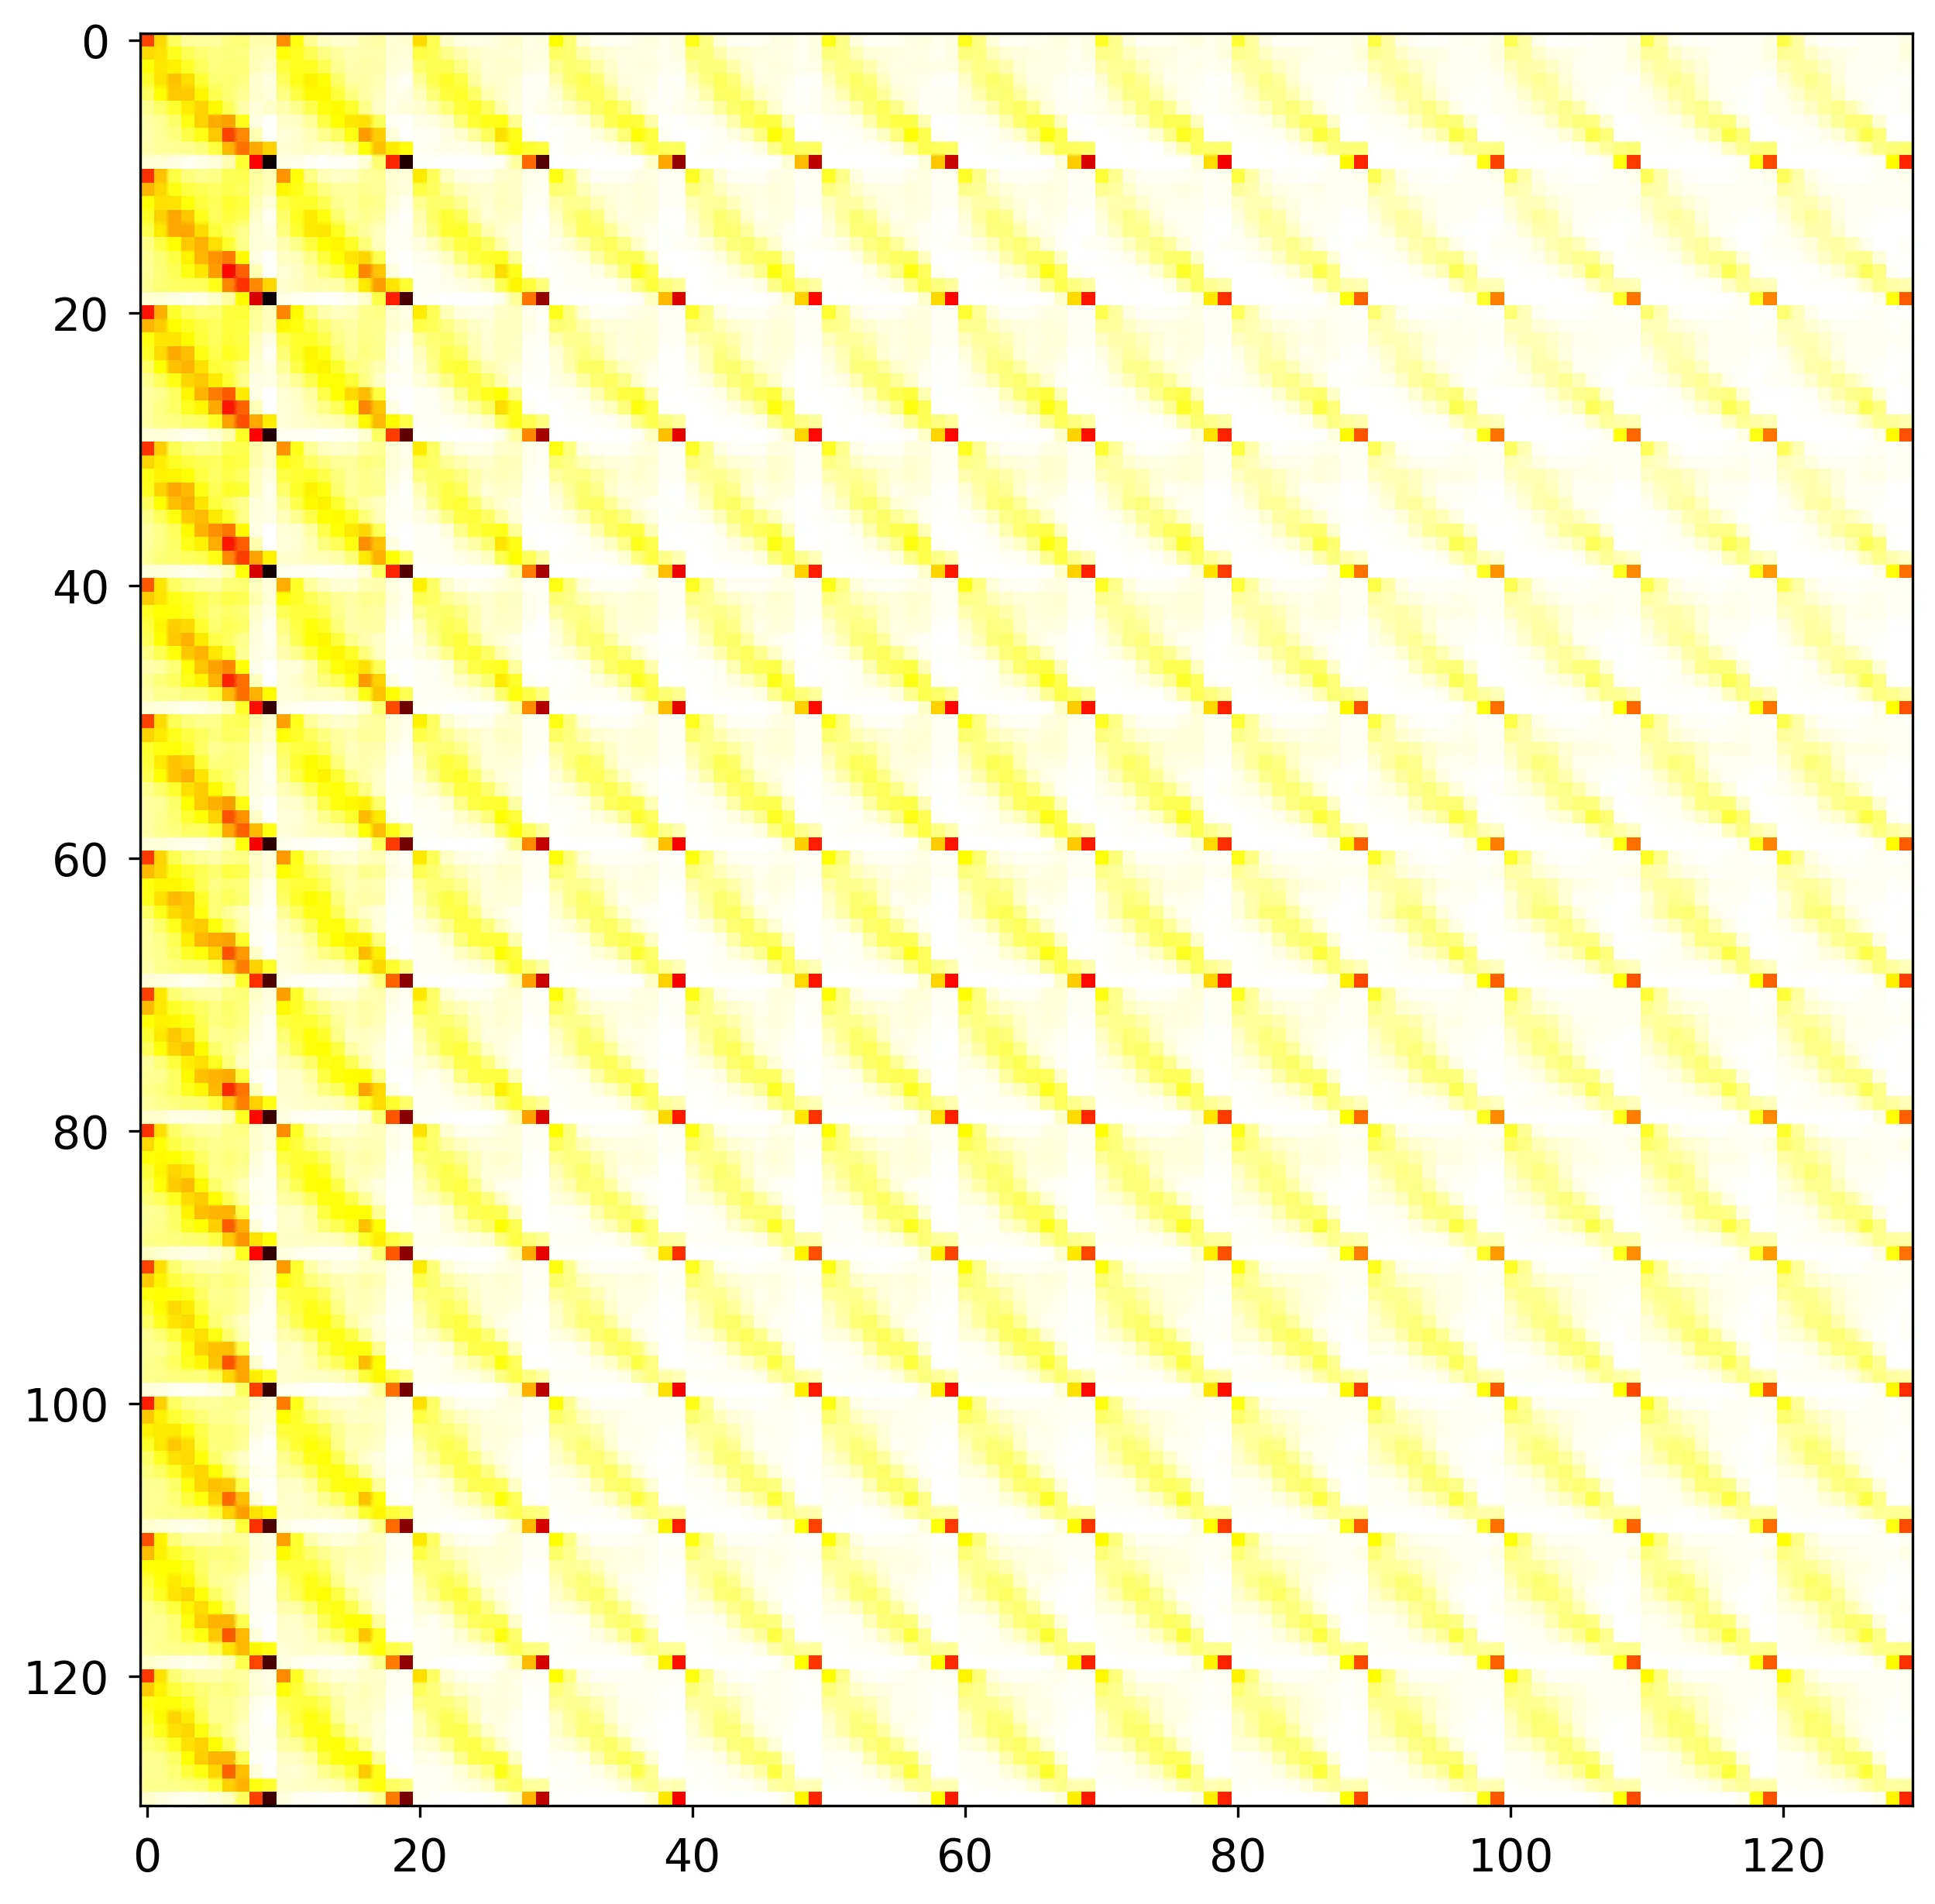
图 3. CogVideoX-v1.5 中层 0、头 9 的稀疏图在去噪步 12→21→31→41 的演化过程,展示了注意力稀疏模式在不同去噪步间的显著差异。
线性近似误差验证
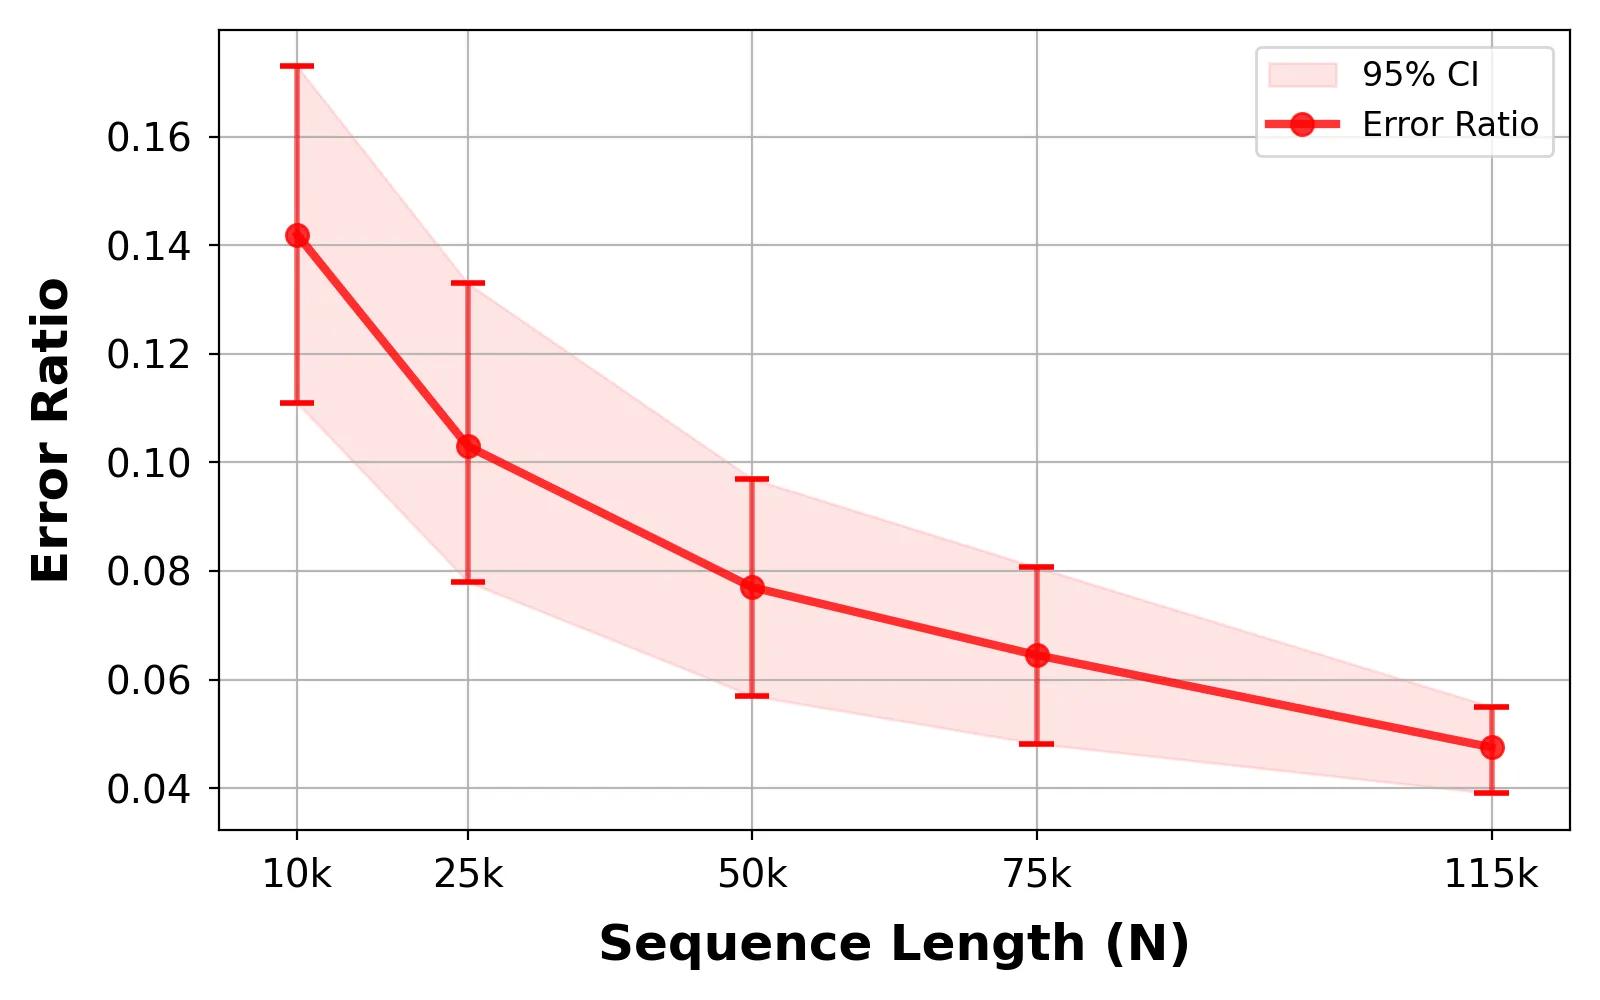
图 4. 线性近似模型(式3)在不同序列长度上的归一化近似误差(NAE),每条曲线包含均值和 95% 置信区间。误差随序列长度增加而降低。
模式强度演化
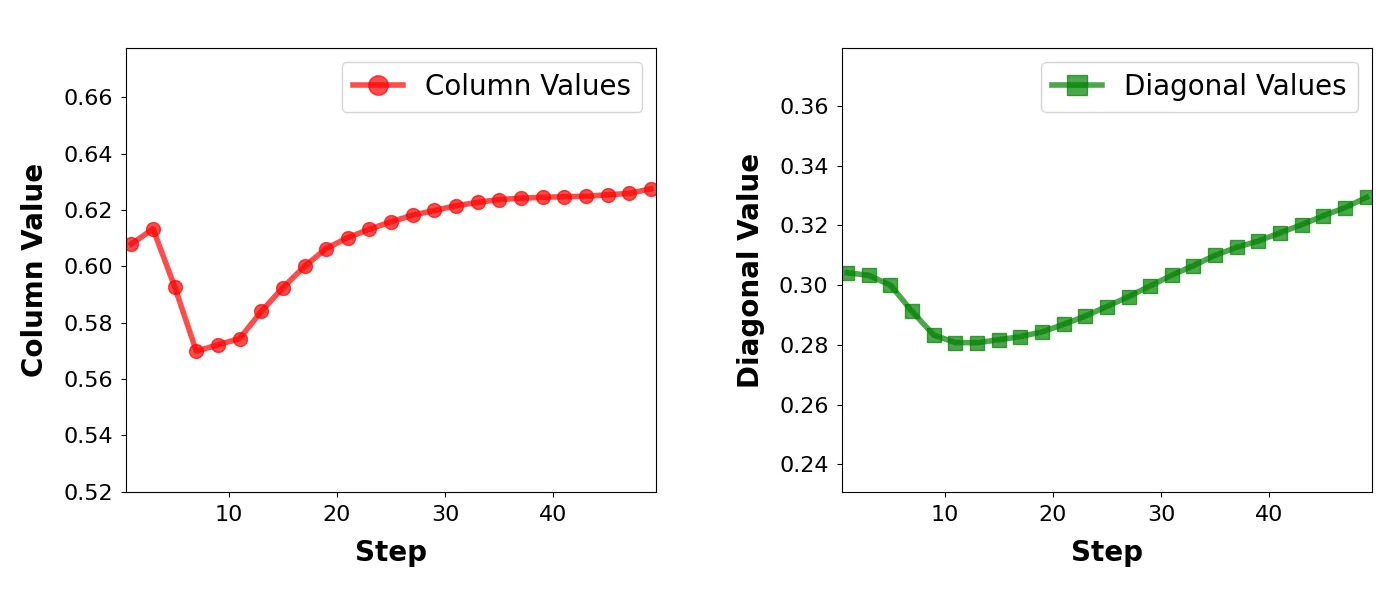
图 5. 垂直和平行对角模式强度随去噪步的演化,显示中段-末段去噪阶段收敛到分段线性趋势。
推理时间对比
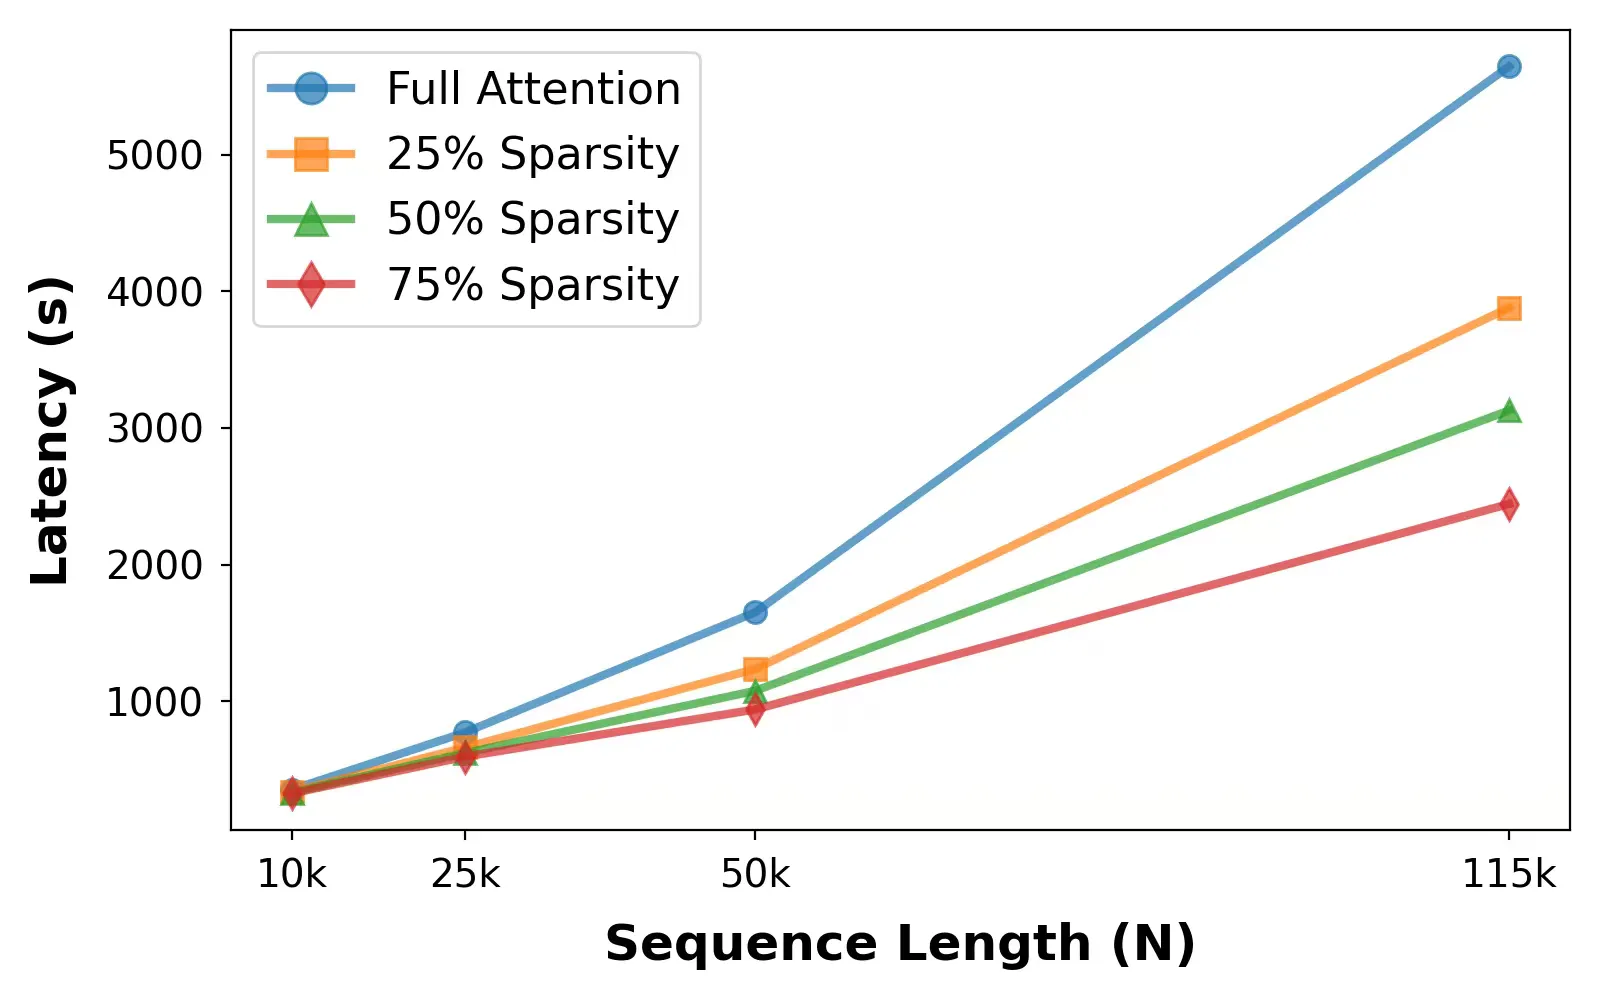
图 6. Full Attention 与 MOD-DiT 在不同序列长度下的推理时间对比,MOD-DiT 加速效果随序列长度增加而更显著。
超参数消融
Top-K 消融:
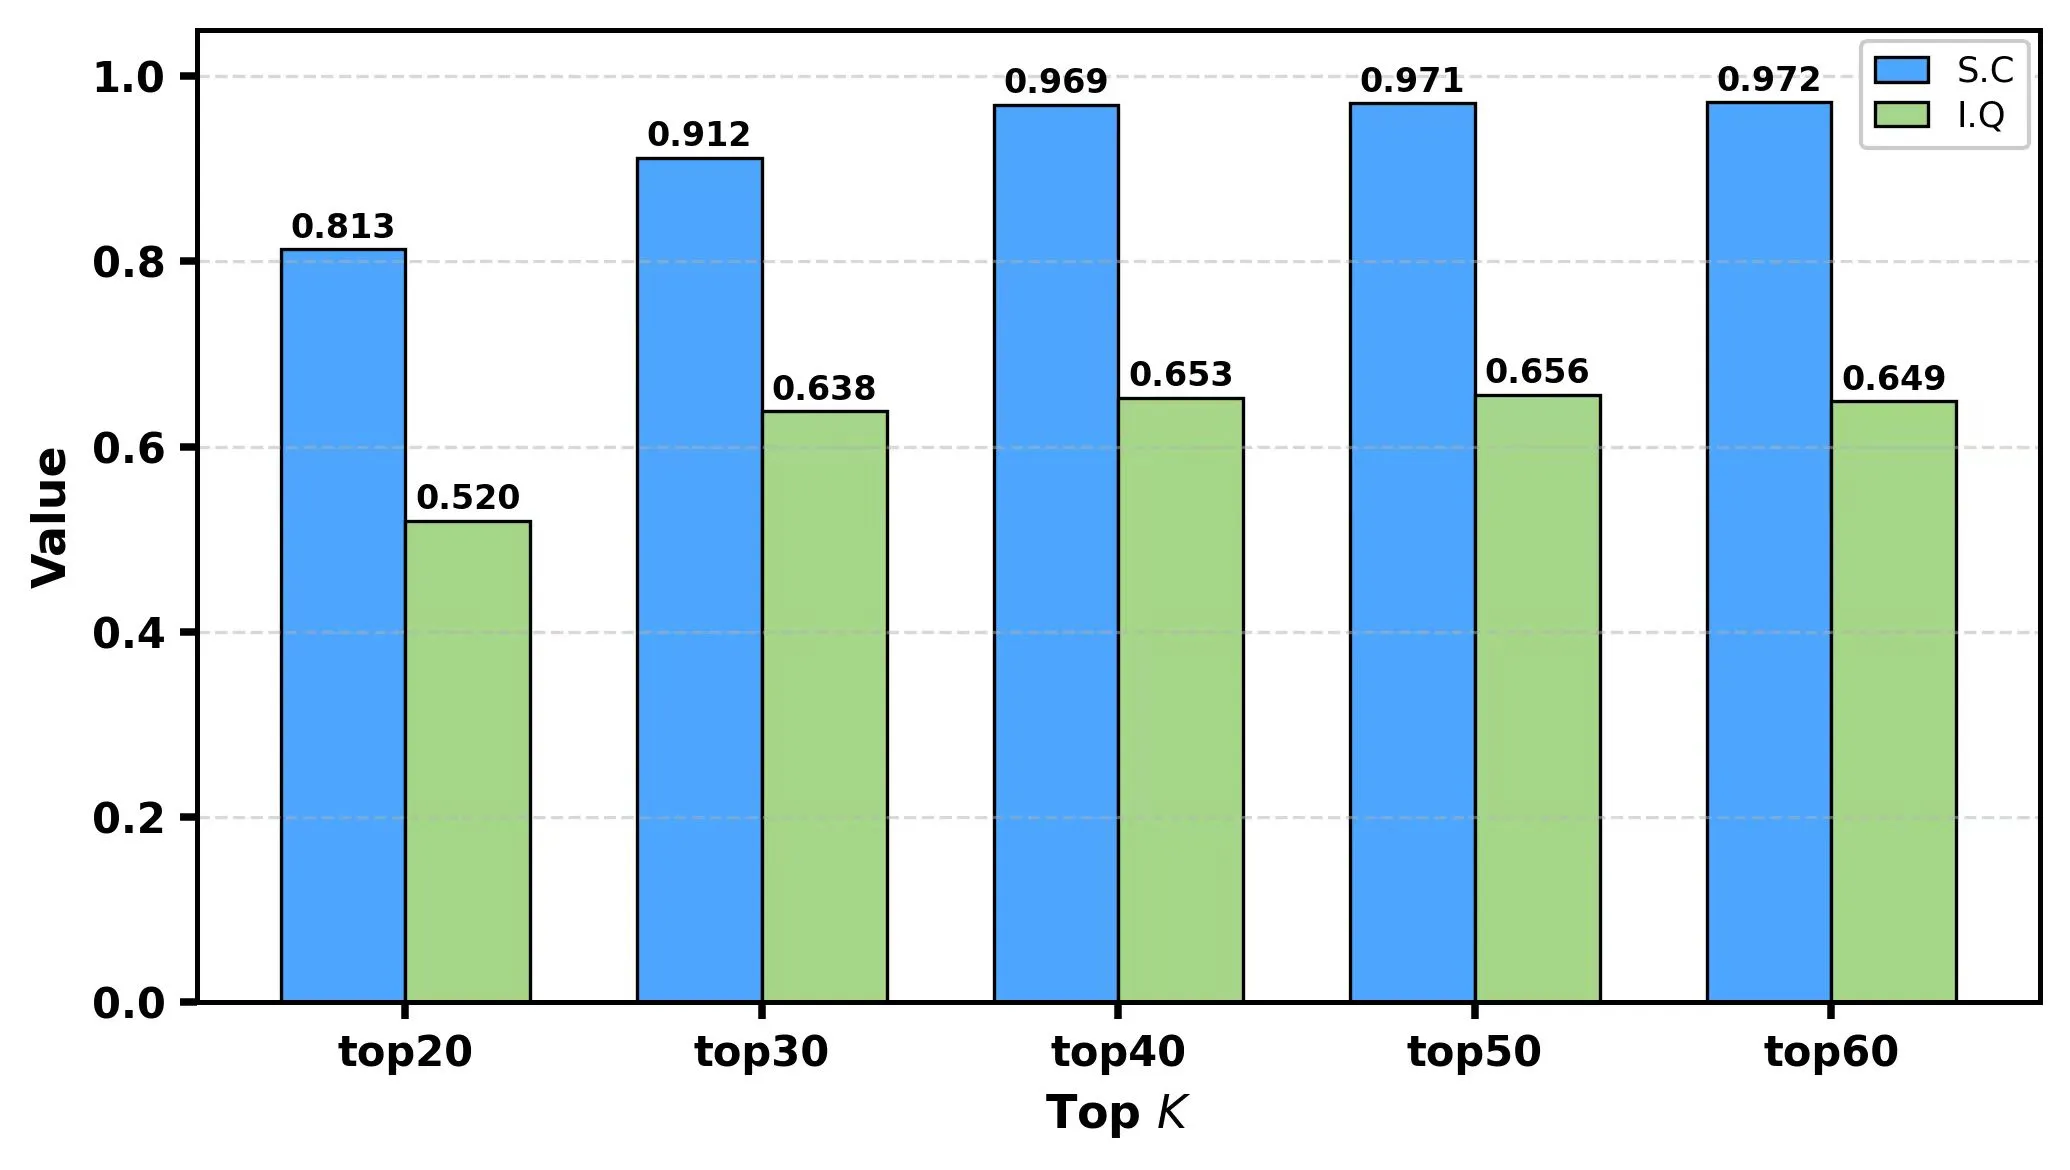
图 7. Hunyuan 模型上 Top-K 超参数的消融实验:Subject Consistency (S.C.) 和 Imaging Quality (I.Q.) 随 K 增大先升后稳。
稀疏阈值消融:
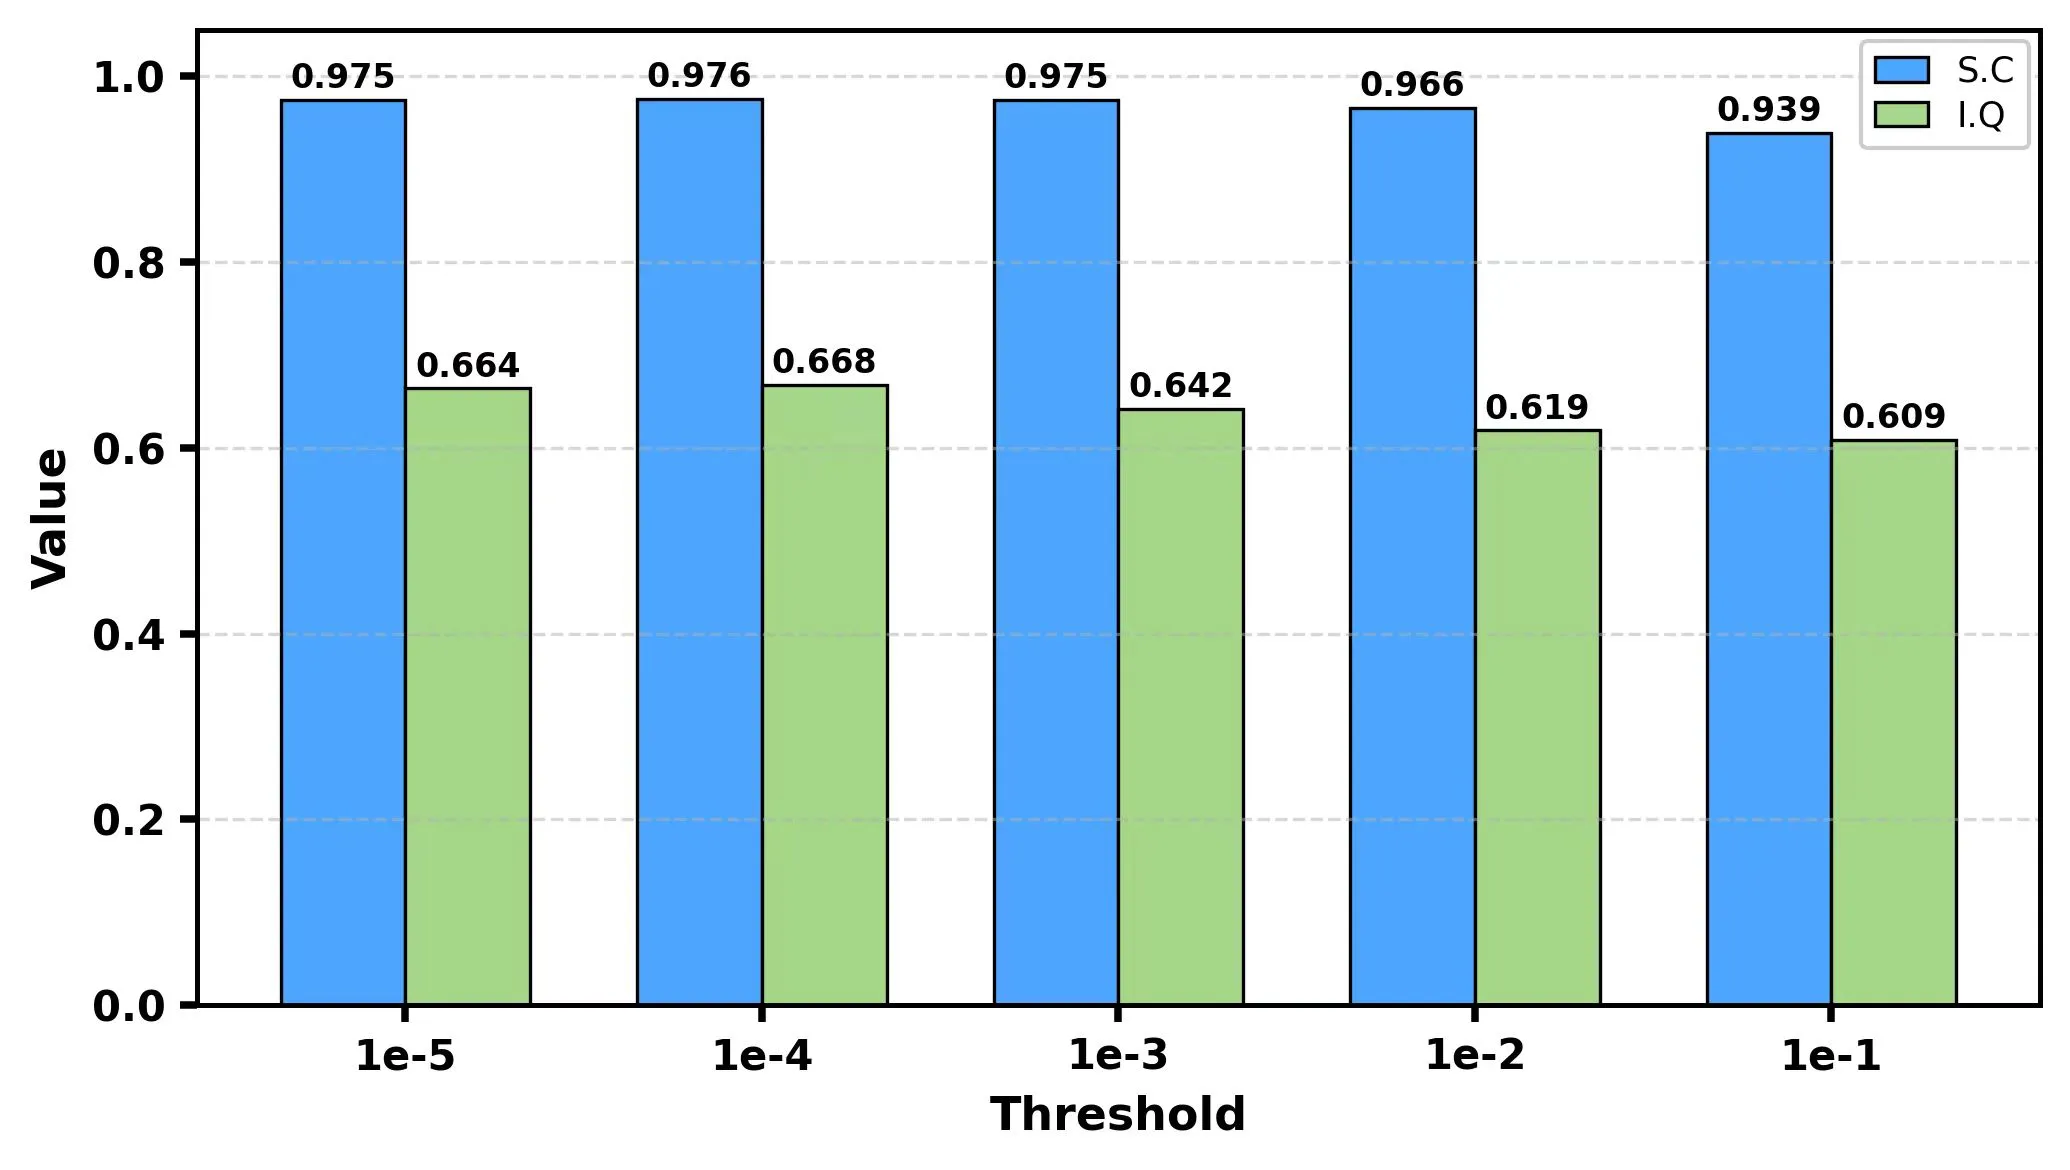
图 8. 稀疏计算阈值 (式2)的消融:阈值对性能影响微弱,仅在极端大值时略有退化;默认选择 。
重建误差分析:
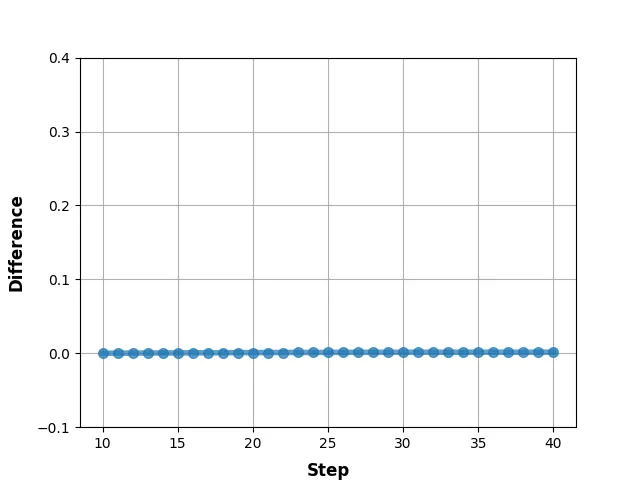
图 9. CogVideoX-v1.5 上 6 个随机采样注意力头的归一化重建误差(NRE)在各去噪步的分布,确认 MOD-DiT 重建引入的误差极小。
Warm-up 步骤消融:
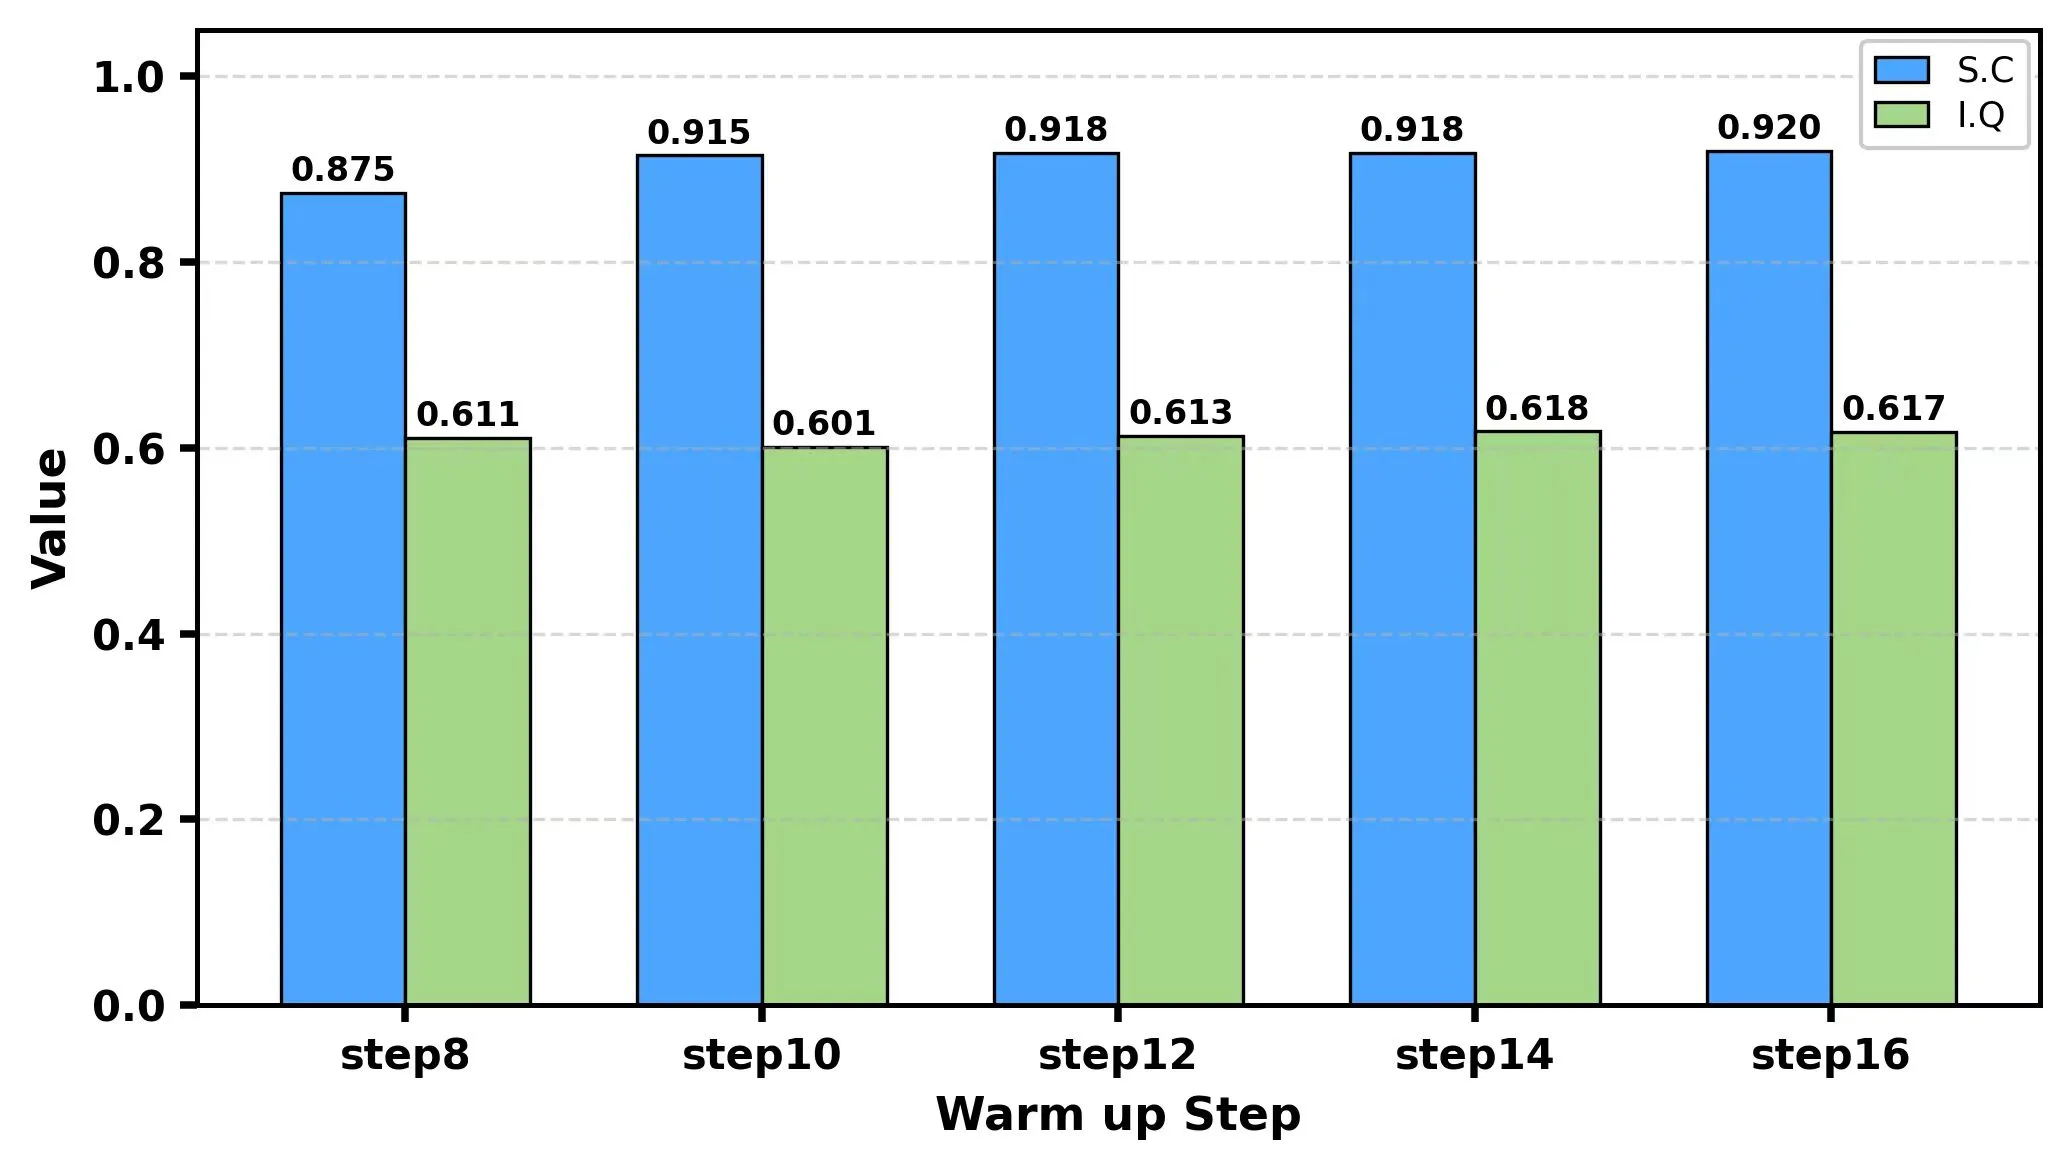
图 10. CogVideoX-v1.5 上 warm-up 步数 的消融: 在避免冗余全注意力成本的同时实现近最优的 S.C. 和 I.Q.
SMFS 对比:
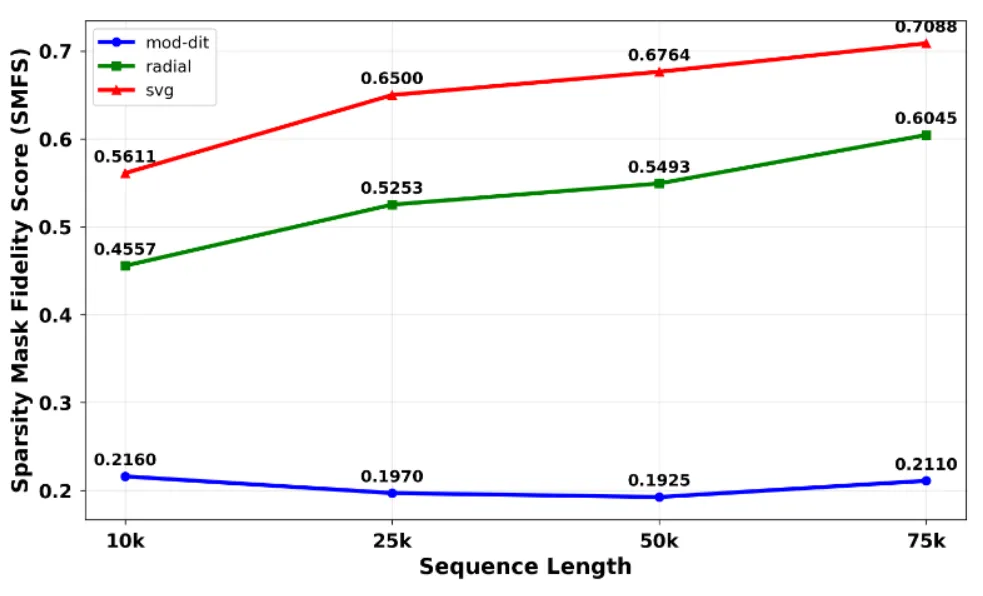
图 11. HunyuanVideo 上不同方法的 SMFS 对比:MOD-DiT 在所有序列长度下均显著低于 SVG 和 Radial。
NRE 直方图:
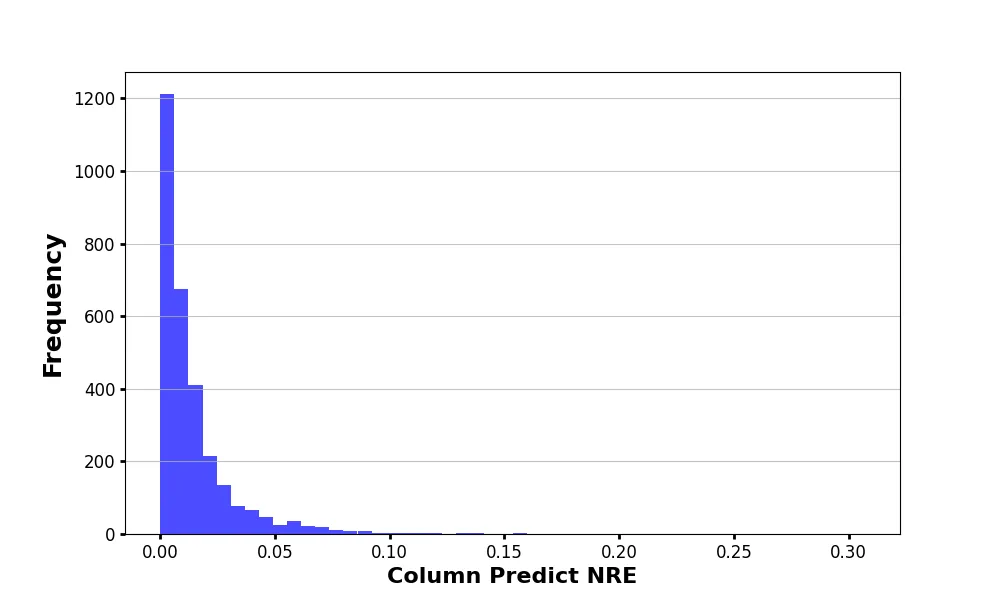
图 14. 垂直(a)和平行对角(b)模式的 NRE 直方图,基于 300 个数据点(5 prompts × 10 layers × 6 heads),确认分段线性是普遍属性。
Mask 视觉对比:
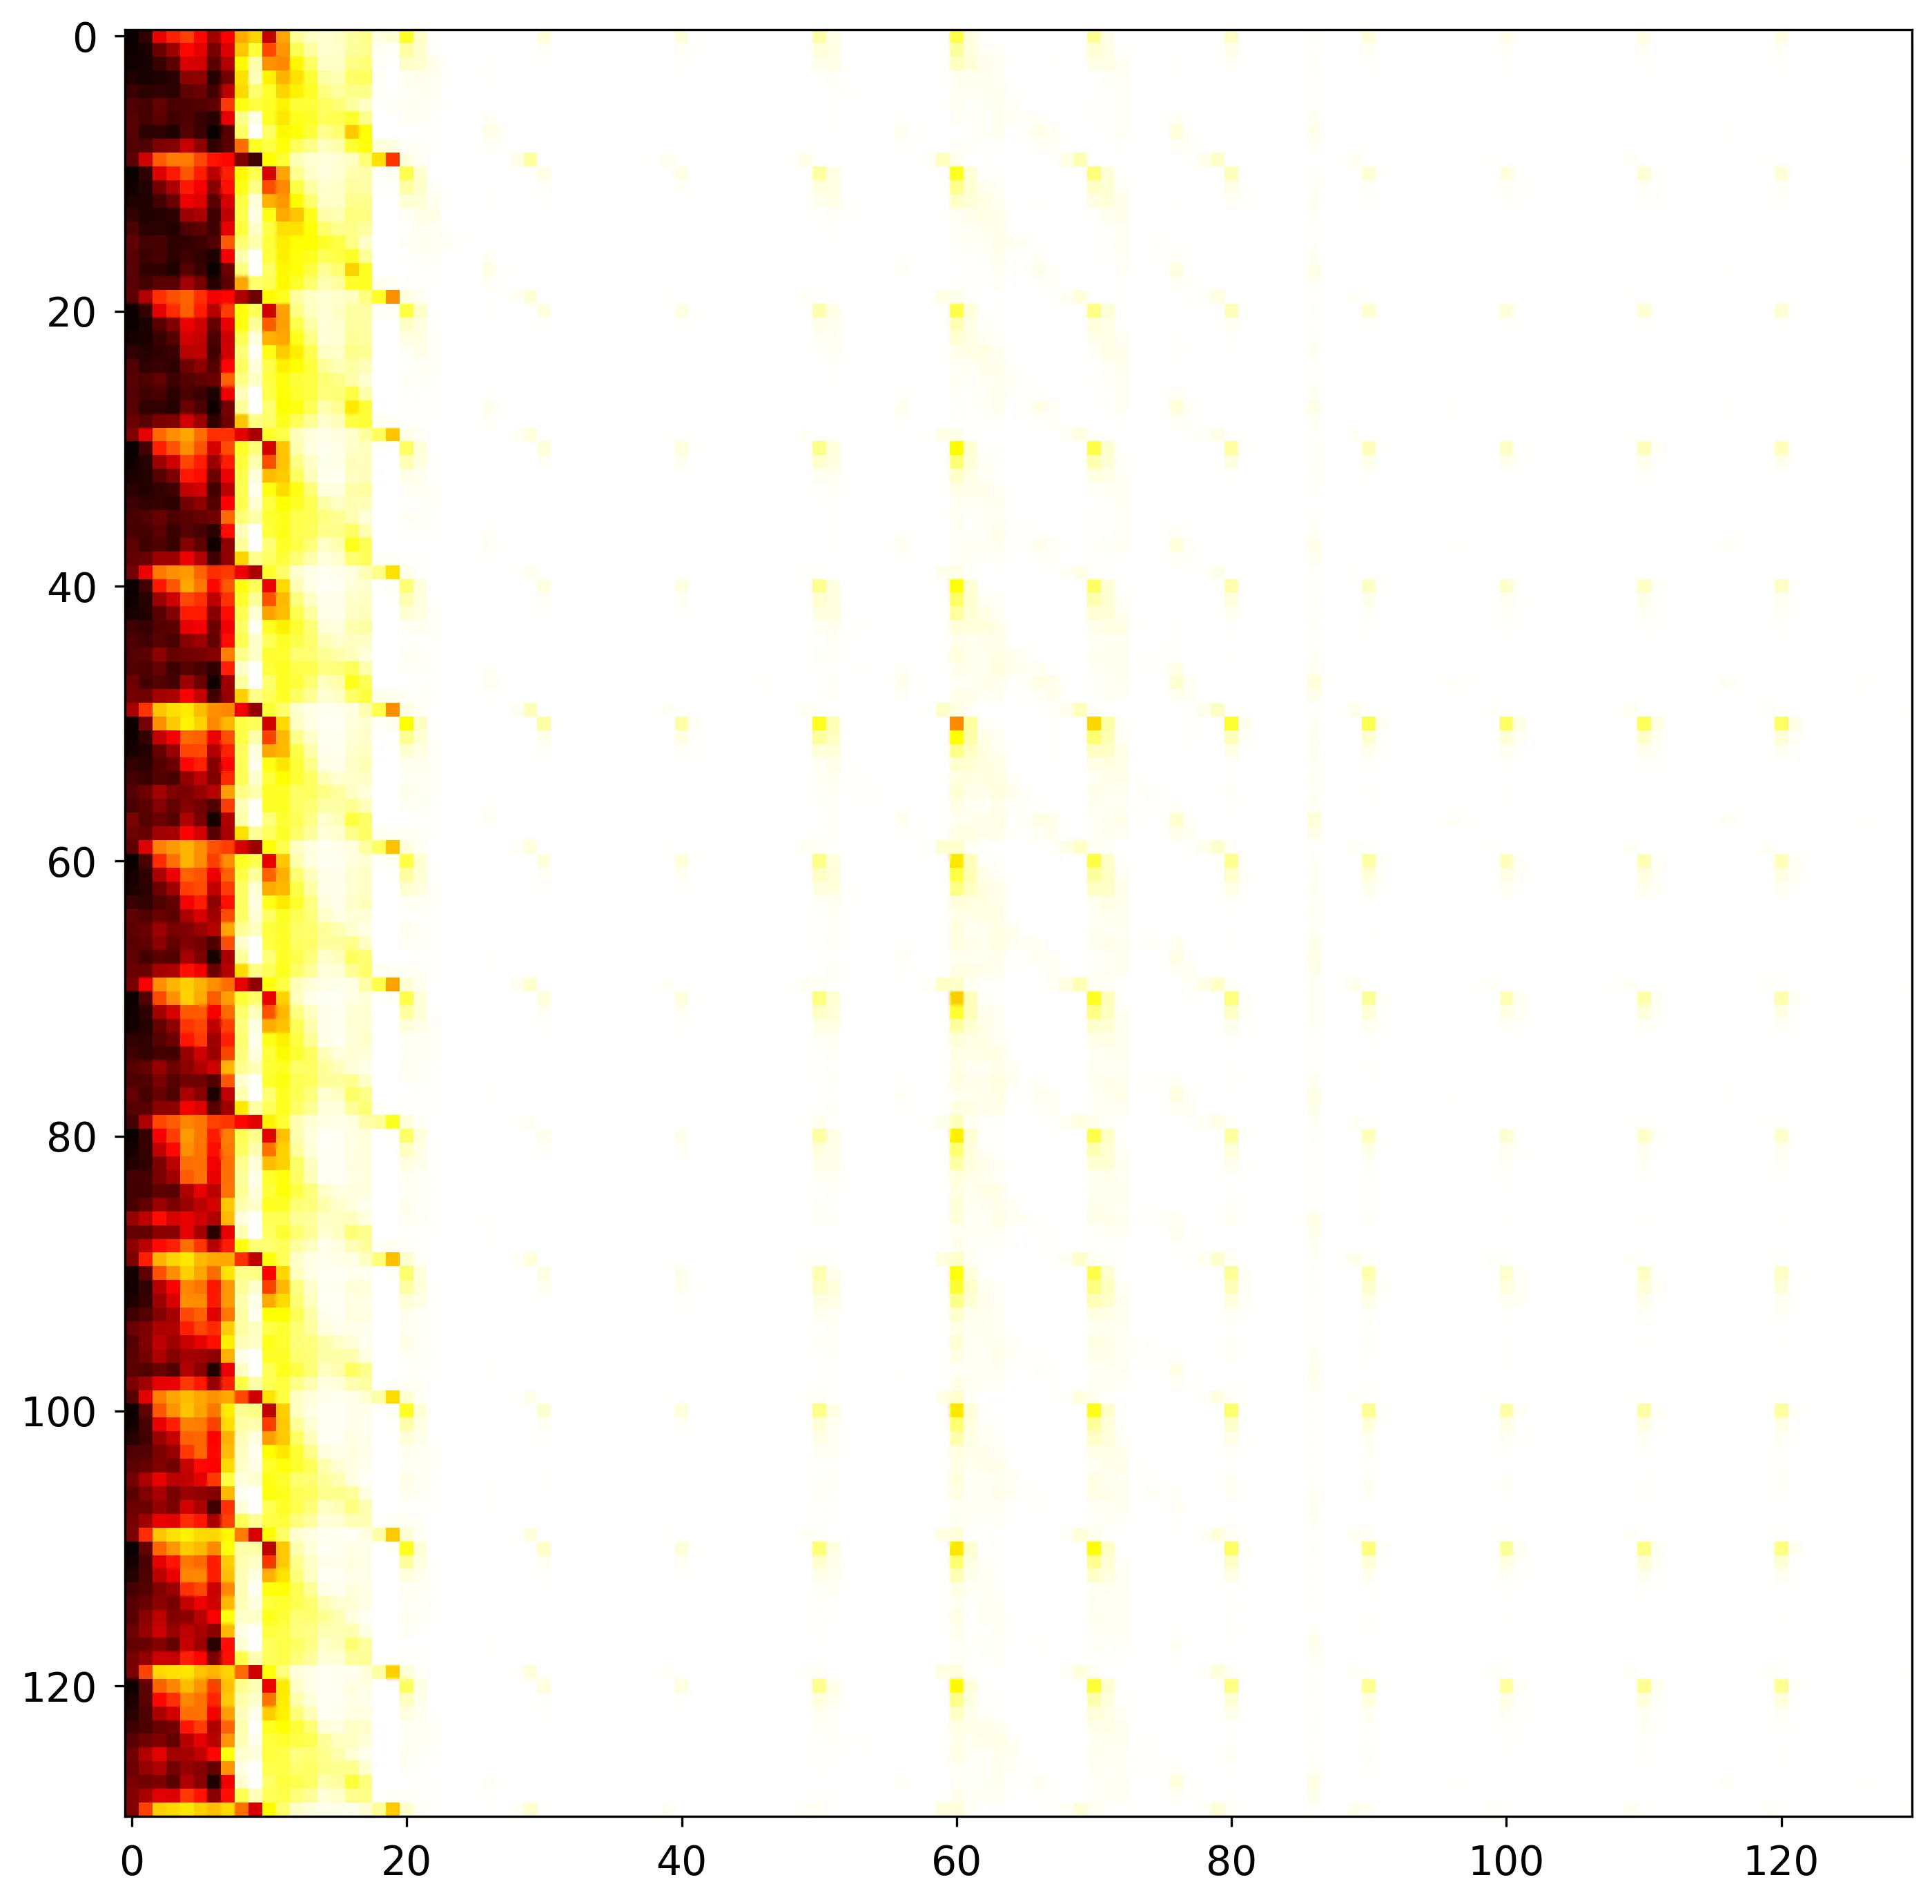
图 13. 各稀疏注意力方法在 CogVideo 推理中为特定注意力头生成的 mask 视觉对比:MOD-DiT 的 mask 更忠实地保留了真实注意力图的结构特征。
FastWan 加速对比:
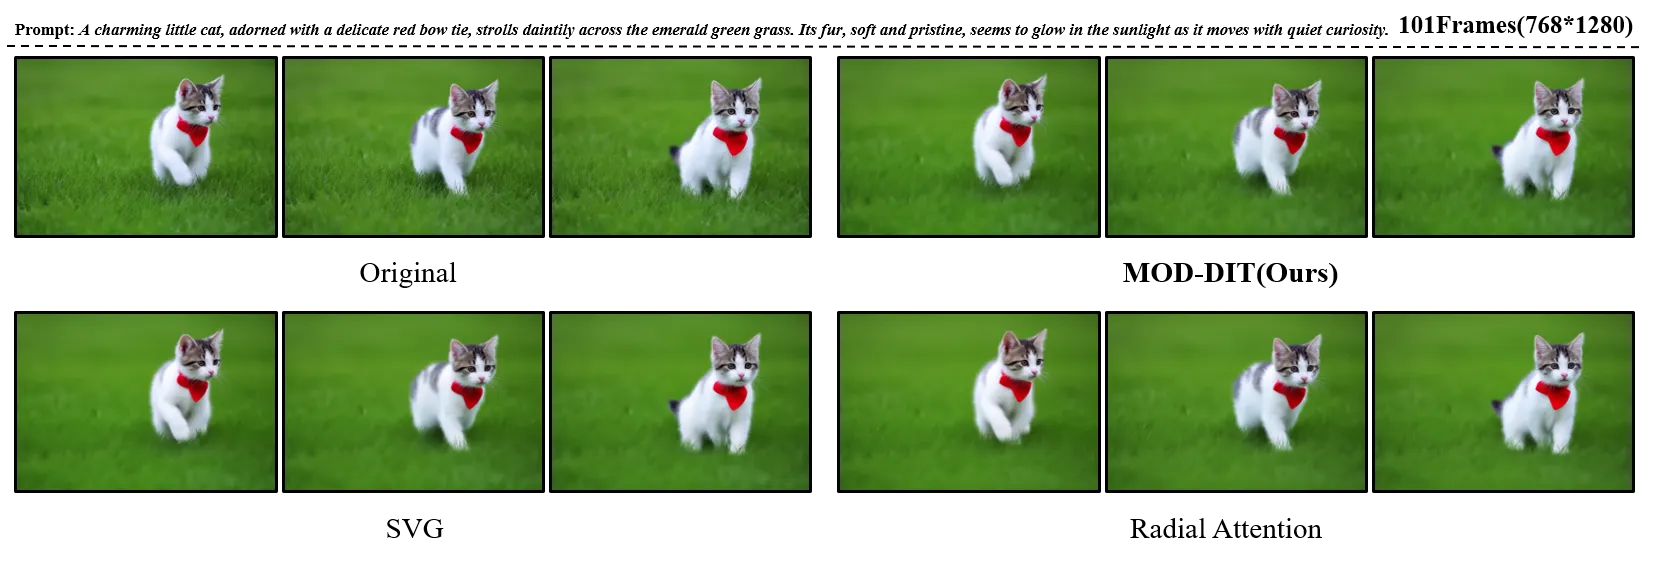
图 18. HunyuanVideo 上不同稀疏注意力方法的生成可视化对比:MOD-DiT 实现 2.05× 加速且质量与原始视频几乎一致。
Wan2.1 加速对比:
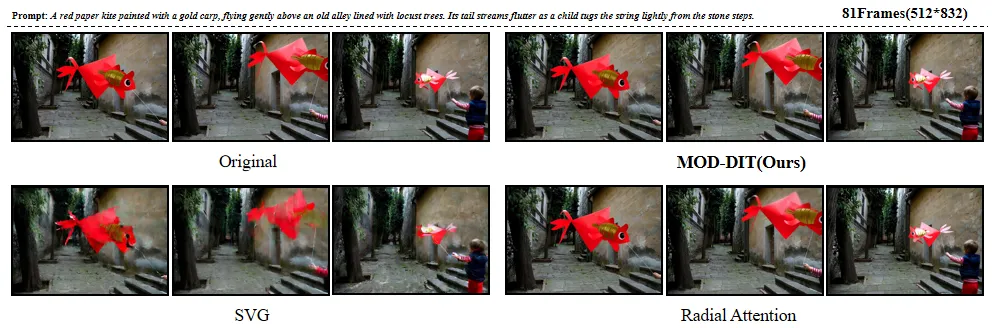
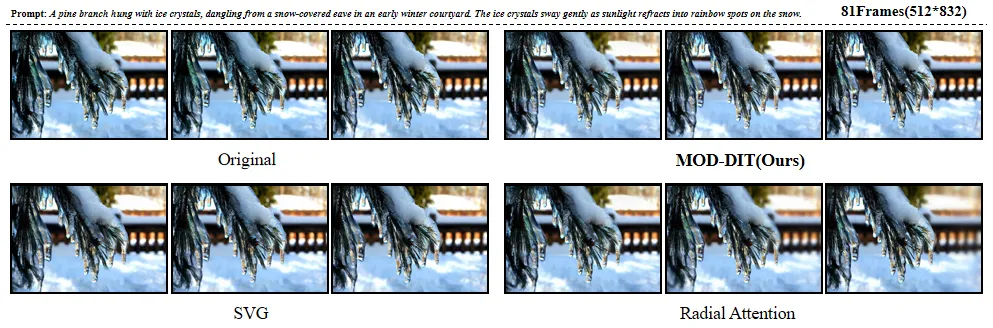
图 19-20. Wan2.1 上不同稀疏方法的生成对比:MOD-DiT 实现 1.75× 加速,保持全注意力水平的主题一致性和场景真实感。
硬件加速策略
- 优化最小二乘核:基于 CUDA 的优化核,相比 PyTorch 原生
torch.lstsq加速 100× - 混合注意力执行:Warm-up 阶段用 FlashAttention-2,稀疏阶段切换到 SageAttention
- 块级注意力计算:将 Q/K 张量划分为 128×128 非重叠块,利用 GPU warp 级并行
MOD-DiT 引入的计算开销仅占全注意力延迟的 1-2%。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 三模式混合假设 | 揭示 vDiT 注意力图呈现块对角、平行对角、垂直三种结构的动态混合 | 图2-3 可视化;式(3) 线性近似;NAE < 0.14 |
| 训练自由、无采样动态稀疏 | 完全在线推理,无需训练成本,消除采样开销 | 式(5)-(6) 在线预测-校正流水线 |
| 三级动态路由 | 输入级、头级、去噪步级同时优化 mask 模式和稀疏比 | Algorithm 1 三阶段流程 |
| 硬件优化核 | CUDA 加速最小二乘求解,减少 100× 计算时间 | Remark 1;Appendix B |
| 分段线性预测 | 中段-末段去噪步模式强度呈稳定分段线性,可线性外推 | 图5;图14 300数据点验证 |
五、实验结果
主基准测试(Table 1)
HunyuanVideo (13B, 117帧, 768×1280, A100):
| 方法 | 稀疏度 | PSNR↑ | SSIM↑ | LPIPS↓ | S.C.↑ | B.C.↑ | M.S.↑ | T.F.↑ | I.Q.↑ | A.Q.↑ | D.D.↑ | 延迟 | 加速 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Full | 0% | - | - | - | 0.9582 | 0.9478 | 0.9766 | 0.9723 | 0.6693 | 0.6381 | 0.9215 | 6978s | 1.00× |
| MInference | 67.1% | 18.21 | 0.638 | 0.490 | 0.9300 | 0.9180 | 0.9580 | 0.9500 | 0.6450 | 0.5650 | 0.9080 | 5286s | 1.32× |
| Radial | 75.55% | 26.72 | 0.885 | 0.125 | 0.9312 | 0.9290 | 0.9715 | 0.9322 | 0.6467 | 0.5715 | 0.8423 | 3731s | 1.87× |
| SVG | 71.22% | 26.44 | 0.861 | 0.170 | 0.8301 | 0.8711 | 0.9544 | 0.9018 | 0.5928 | 0.5330 | 0.9011 | 3834s | 1.82× |
| Sparge | 68.00% | 25.43 | 0.842 | 0.195 | 0.9339 | 0.9156 | 0.9528 | 0.9510 | 0.6432 | 0.5603 | 0.9120 | 4105s | 1.70× |
| MOD-DiT | 83.23% | 27.73 | 0.879 | 0.119 | 0.9398 | 0.9320 | 0.9687 | 0.9527 | 0.6587 | 0.5899 | 0.9104 | 3405s | 2.05× |
Wan2.1 (14B, 69帧, 768×1280, A100):
| 方法 | 稀疏度 | PSNR↑ | SSIM↑ | LPIPS↓ | S.C.↑ | B.C.↑ | M.S.↑ | T.F.↑ | I.Q.↑ | A.Q.↑ | D.D.↑ | 延迟 | 加速 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Full | 0% | - | - | - | 0.9623 | 0.9655 | 0.9844 | 0.9789 | 0.6722 | 0.6012 | 0.9378 | 3375s | 1.00× |
| MInference | 60.5% | 15.81 | 0.675 | 0.343 | 0.9100 | 0.9200 | 0.9750 | 0.9650 | 0.6550 | 0.5700 | 0.9150 | 2557s | 1.32× |
| Radial | 71.33% | 21.57 | 0.818 | 0.167 | 0.9152 | 0.9339 | 0.9860 | 0.9750 | 0.6620 | 0.5783 | 0.8500 | 2021s | 1.67× |
| SVG | 69.08% | 20.93 | 0.795 | 0.222 | 0.7986 | 0.8859 | 0.9556 | 0.9347 | 0.6133 | 0.5292 | 0.9167 | 2109s | 1.60× |
| Sparge | 50.10% | 18.67 | 0.735 | 0.198 | 0.9033 | 0.9275 | 0.9798 | 0.9632 | 0.6645 | 0.5610 | 0.9043 | 2296s | 1.47× |
| MOD-DiT | 81.37% | 22.75 | 0.821 | 0.152 | 0.9427 | 0.9488 | 0.9823 | 0.9752 | 0.6674 | 0.5827 | 0.9289 | 1929s | 1.75× |
CogVideoX-v1.5 结果(Table 5)
| 方法 | 稀疏度 | PSNR↑ | SSIM↑ | LPIPS↓ | S.C.↑ | I.Q.↑ | 延迟 | 加速 |
|---|---|---|---|---|---|---|---|---|
| Full | 0% | - | - | - | 0.9230 | 0.6255 | 987s | 1× |
| MInference | 64.9% | 15.01 | 0.601 | 0.334 | 0.8679 | 0.5580 | 696s | 1.42× |
| Radial | 70.7% | 22.89 | 0.866 | 0.172 | 0.9214 | 0.6167 | 611s | 1.62× |
| SVG | 75.0% | 21.15 | 0.818 | 0.183 | 0.9158 | 0.5948 | 596s | 1.65× |
| Sparge | 67.3% | 20.34 | 0.773 | 0.255 | 0.9043 | 0.5966 | 661s | 1.49× |
| MOD-DiT | 80.1% | 25.77 | 0.868 | 0.133 | 0.9266 | 0.6239 | 542s | 1.82× |
公平对比(等稀疏度)
| 方法 | S.C.↑ | B.C.↑ | M.S.↑ | T.F.↑ | I.Q.↑ | A.Q.↑ | D.D.↑ | 延迟 |
|---|---|---|---|---|---|---|---|---|
| Radial (匹配稀疏度) | 0.9152 | 0.9339 | 0.9860 | 0.9750 | 0.6620 | 0.5783 | 0.8500 | 1224s |
| MOD-DiT | 0.9518 | 0.9594 | 0.9867 | 0.9776 | 0.6630 | 0.6070 | 0.9789 | 1265s |
SVG-2 对比
| 方法 | S.C.↑ | B.C.↑ | M.S.↑ | T.F.↑ | I.Q.↑ | A.Q.↑ | D.D.↑ | 延迟 |
|---|---|---|---|---|---|---|---|---|
| SVG-2 | 0.9325 | 0.9369 | 0.9636 | 0.9518 | 0.6431 | 0.5901 | 0.9076 | 1056s |
| MOD-DiT | 0.9398 | 0.9320 | 0.9687 | 0.9527 | 0.6587 | 0.5899 | 0.9104 | 1044s |
蒸馏模型适配(FastWan 8-step)
| 方法 | S.C.↑ | B.C.↑ | M.S.↑ | T.F.↑ | I.Q.↑ | A.Q.↑ | D.D.↑ | 延迟 |
|---|---|---|---|---|---|---|---|---|
| FastWan | 0.9317 | 0.9489 | 0.9766 | 0.9658 | 0.6531 | 0.5910 | 0.9201 | 327s |
| FastWan + MOD-DiT | 0.9287 | 0.9470 | 0.9692 | 0.9543 | 0.6502 | 0.5904 | 0.9176 | 210s |
MOD-DiT 在蒸馏模型上额外获得 1.56× 加速,VBench 质量指标几乎无损。
消融实验摘要
| 实验 | 发现 |
|---|---|
| 重建间隔 Δt | 所有测试值(1,2,3,5,10)表现几乎相同;“None” 方案显著下降 |
| 块大小 | 64→128 降低延迟但质量几乎不变,128 为最优选择 |
| Warm-up 步数 m | m=12 达到近优质量且避免冗余全注意力成本 |
| Top-K | 性能随 K 先增后稳,存在最优平衡点 |
| 稀疏阈值 η | 对性能影响微弱,默认 η=10⁻⁴ 稳定有效 |
六、关键设计洞察
6.1 注意力流形的三基分解
在任何帧优先的 token 布局下,高能量注意力流形可严格分解为三个正交互点子空间:
- 块对角 ():帧内空间相干性
- 平行对角 ():帧间时间连续性
- 垂直全局 ():跨帧语义锚定
这三个子空间的并集构成视频生成主高交互流形的理论完备基。
6.2 预测-校正流水线
通过短期区间()线性外推 + 周期性全局重构(式5)的双重机制:
- 早期高度非线性动态由全注意力 warm-up 安全处理
- 中段-末段稳定 regime 下激活线性预测
- 周期性重构防止长期外推误差累积
6.3 块对角模式的静态阈值化
由于块对角模式编码跨去噪步的结构不变性帧内空间交互,其存在可通过静态阈值高效验证,避免了持续线性预测的需求。
七、相关工作
视频稀疏注意力:Sparse-vDiT(静态垂直+块对角)、SVG/SVG-2(时空分类)、Radial(指数衰减)、MInference(LLM迁移)、SpargeAttn(交叉模态)、LiteAttention(时序连贯跳过)、DFSAttn(动态细粒度)
高效扩散:TeaCache/FasterCache/AdaCache(时序缓存)、蒸馏方法(减少步数)、高比率 VAE(潜空间压缩)
稀疏注意力:Longformer(滑动窗口)、Swin Transformer(层次 shifted windows)、FlexPrefill(上下文感知)
八、总结
核心贡献
- 三模式混合假设:首次系统揭示 vDiT 注意力图呈现块对角、平行对角、垂直三种结构的动态混合
- 训练自由动态稀疏:插件式算法,完全在线推理,无训练成本和采样开销
- 三级动态路由:输入级、头级、去噪步级同时优化 mask 模式和稀疏比
- 硬件优化核:CUDA 最小二乘核加速 100×,计算开销仅 1-2%
- 广泛实验验证:HunyuanVideo 2.05×、Wan2.1 1.75×、CogVideoX 1.82× 加速,VBench 顶级质量
- 蒸馏模型兼容:FastWan 8-step 额外 1.56× 加速
局限性
- 全注意力 warm-up 阶段在短序列场景可能引入额外计算开销
- 块对角模式通过静态阈值而非动态预测,可能遗漏少数变化场景
参考资源
- 论文: https://arxiv.org/abs/2601.11641
- VBench: https://github.com/Vchitect/VBench
- HunyuanVideo: https://github.com/Tencent/HunyuanVideo
- Wan2.1: https://github.com/Wan-Video/Wan2.1
- CogVideoX: https://github.com/THUDM/CogVideo