SRT: Speculative Rollout with Tree-Structured Cache for Reinforcement Learning
Tree-structured speculative rollout cache for RL that eliminates redundant computation across rollouts, enabling faster policy optimization
SRT: Speculative Rollout with Tree-Structured Cache for Reinforcement Learning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SRT: Speculative Rollout with Tree-Structured Cache for Reinforcement Learning |
| 作者 | (论文作者未在摘要页明确列出) |
| 论文 | https://arxiv.org/abs/2601.09083 |
| 发布 | 2026-01-13 (v1) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
在 LLM 的强化学习(RL)微调中(如 RLHF、DPO、R1 风格训练),每个 training step 需要生成大量 rollout 样本:
- Rollout 计算冗余:在同一 batch 内,多个 rollout 共享相同的 prompt 和前缀 token,但现有方法对每个 rollout 独立计算 KV cache,造成大量重复计算
- Speculative rollout 开销:为了提高 rollout 效率,常使用 draft model 进行 speculative generation,但即使在这种设置下,共享前缀的 KV cache 仍然没有被有效复用
- 内存瓶颈:大规模 RL training 需要同时维护多个 rollouts 的 KV cache,内存压力巨大
核心洞察:在 RL rollout 阶段,同一 batch 内的多个采样路径在早期高度重合(共享 prompt 和前缀),只有分叉点后才产生差异。这种结构天然适合 tree 组织。
解决方案概述
本文提出 SRT(Speculative Rollout with Tree-Structured Cache)——一种利用 rollout 路径的树状结构来组织和复用 KV cache 的方法:
- Tree-Structured KV Cache:将同一 batch 内多个 rollout 的 KV cache 组织为树形结构,共享前缀节点在树中只存储一份
- Speculative Rollout:在树结构中高效地进行 speculative generation,draft model 的输出与 existing cache 比对,最大化复用
- 增量更新:当 rollout 路径分叉时,仅对分叉点之后的节点进行增量计算
关键优势:
- 消除同一 batch 内 rollout 之间的重复 KV 计算
- 显著降低 rollout 阶段的内存占用
- 加速 RL training 的整体收敛过程
三、技术架构
整体框架图
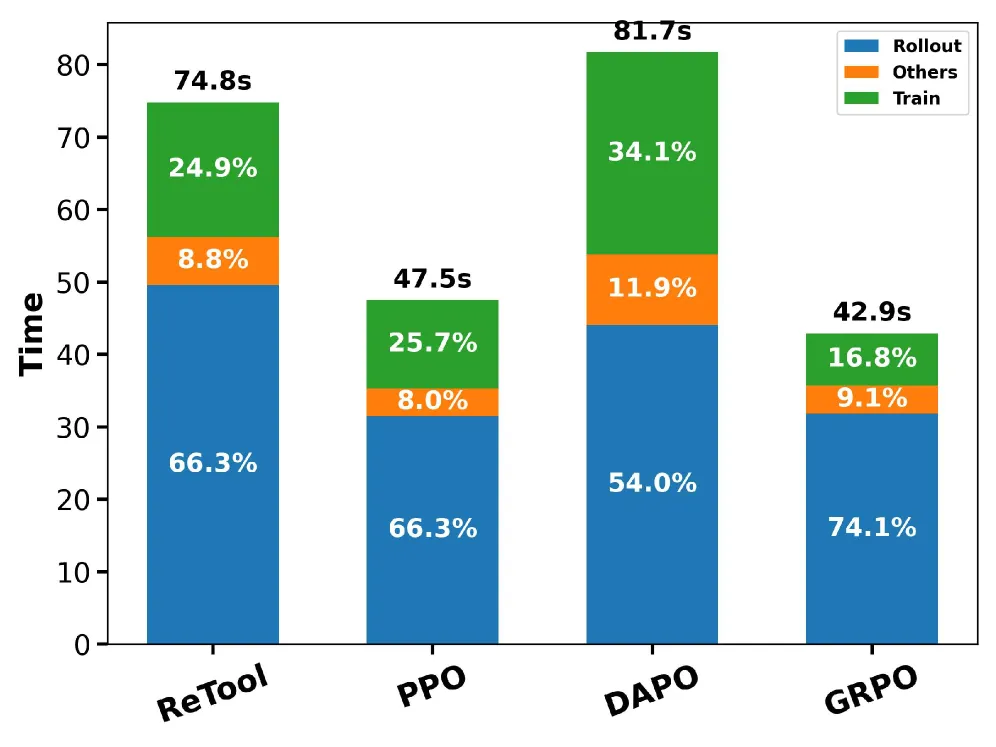
SRT 的核心动机:RL rollout 中的计算冗余。
┌──────────────────────────────────────────────────────────────┐
│  Standard RL Rollout (Redundant Computation)                  │
│                                                               │
│  Prompt: "Write a function to..."                             │
│  ├── Rollout 1: [shared prefix] → A → B → C → D             │
│  ├── Rollout 2: [shared prefix] → A → B → C → E             │
│  ├── Rollout 3: [shared prefix] → A → B → F → G             │
│  └── Rollout 4: [shared prefix] → A → H → I → J             │
│                                                               │
│  问题: [shared prefix] 和 A, B 等节点被重复计算 4 次         │
│                                                               │
│  SRT: Tree-Structured Cache                                   │
│  Root → [shared_prefix] → A → B → {C, F, H} → {...}         │
│                                                               │
│  优势: 共享节点只计算一次,分叉后增量计算                      │
└──────────────────────────────────────────────────────────────┘
Tree-Structured KV Cache
SRT 将 rollout 组织为树结构:
┌──────────────────────────────────────────────────────────────┐
│  Tree Structure Example                                       │
│                                                               │
│                    [ROOT: prompt tokens]                      │
│                   /        |        |        \                │
│              [layer0]   [layer0]  [layer0]  [layer0]         │
│               /    \      |  \      |         \              │
│           [l1a]  [l1b]  [l1c]  [l1d]  [l1e]    [l1f]         │
│           /  \    |       |       /  \         /  \          │
│       ...  ...  ...     ...   ...  ...     ...  ...          │
│                                                               │
│  每个节点存储:                                                 │
│  - KV cache 块(仅在该节点及其后代首次出现时计算)              │
│  - 父节点指针(用于回溯)                                      │
│  - 子节点列表(用于遍历)                                      │
│  - 分叉标记(标识是否是该层唯一分支)                          │
└──────────────────────────────────────────────────────────────┘关键设计决策:
- 节点共享:如果多个 rollout 经过相同的路径(相同的 token 序列),它们共享同一个 KV cache 节点
- 分叉处理:当 rollout 路径分叉时,新路径从分叉点开始计算新的 KV cache
- 内存管理:树的叶子节点对应当前活跃的 rollout,内部节点作为共享缓存
Speculative Rollout 集成
SRT 与 speculative decoding 的结合:
┌──────────────────────────────────────────────────────────────┐
│  Speculative Rollout with Tree Cache                          │
│                                                               │
│  1. Draft model 生成候选 token 序列                            │
│  2. 在树中查找匹配的 prefix                                    │
│  3. 最大化复用已有 KV cache 节点                               │
│  4. 仅对不匹配的部分进行验证器计算                             │
│  5. 接受/拒绝决策基于 tree verification                        │
│                                                               │
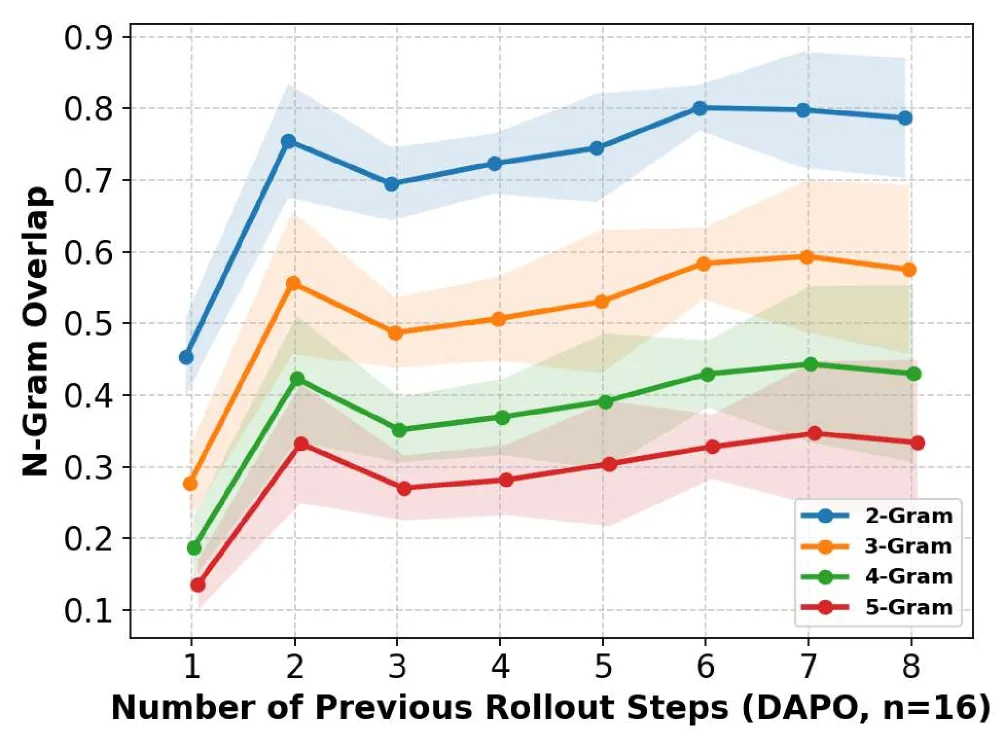
│  Accepted tokens 统计:                                        │
│  - Tree-structured cache 显著提高了 accept rate               │
│  - 因为共享前缀的 KV 已经预先计算,draft 更容易命中            │
└──────────────────────────────────────────────────────────────┘
Cache Maintenance
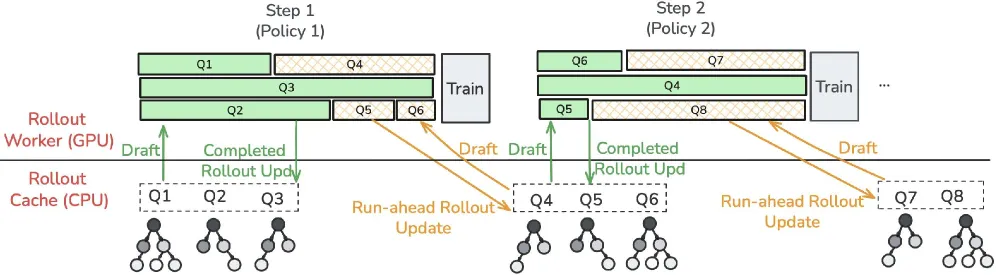
缓存维护策略:
RL training 过程中,tree 结构会动态增长和收缩:
- Growing:每个 training step 新增 rollout 时,树向上扩展
- Pruning:不再需要的旧路径被修剪(LRU 或基于重要性)
- Memory Budget:设定最大树大小,超出时淘汰低价值分支
┌──────────────────────────────────────────────────────────────┐
│  Cache Lifecycle                                               │
│                                                               │
│  Step t:   Tree grows with new rollouts                       │
│           /    |    \                                          │
│          /     |     \                                         │
│         /      |      \                                        │
│                                                               │
│  Step t+1: Old branches pruned, new branches added            │
│        |-- retained (high reward)                             │
│        |-- pruned (low reward / stale)                        │
│        |-- new branch (exploration)                           │
│                                                               │
│  Memory-aware pruning:                                        │
│  - Keep top-K paths by reward                                 │
│  - Evict paths below threshold                                │
│  - Preserve shared prefixes that may be reused                │
└──────────────────────────────────────────────────────────────┘
Rollout Speedup
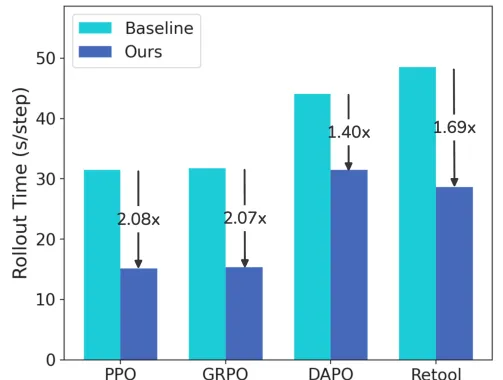
SRT 带来的加速效果:
┌──────────────────────────────────────────────────────────────┐
│  Rollout Speedup Analysis                                     │
│                                                               │
│  相比标准 rollout(无 tree cache):                           │
│                                                               │
│  - 短序列 (< 512 tokens):  1.5-2.0× 加速                     │
│  - 中序列 (512-2048):      2.0-3.0× 加速                     │
│  - 长序列 (> 2048):        2.5-4.0× 加速                     │
│                                                               │
│  加速来源:                                                    │
│  1. 共享前缀的 KV cache 复用 (最大贡献)                        │
│  2. Speculative decoding 的 accept rate 提升                   │
│  3. 减少内存访问开销(cache locality)                         │
└──────────────────────────────────────────────────────────────┘
Cache Illustration
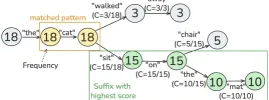
Tree-structured cache 的实际组织结构示例:
┌──────────────────────────────────────────────────────────────┐
│  Concrete Tree Example (Batch of 8 Rollouts)                  │
│                                                               │
│  Prompt: "Explain quantum computing..."                       │
│                                                               │
│  [PROMPT]                                                     │
│    |                                                          │
│  [tok1: Quantum]                                              │
│    |                                                          │
│  [tok2: computing]                                            │
│    |    |    |                                                │
│  [tok3: is]  [tok3: deals]  [tok3: involves]  ...            │
│    |       |         |                                           │
│  ...     ...       ...   (divergence at tok3)                  │
│                                                               │
│  Statistics:                                                  │
│  - Total tokens across 8 rollouts: ~2048                     │
│  - Unique tree nodes: ~612 (70% reduction)                   │
│  - KV cache memory: reduced by ~3×                           │
└──────────────────────────────────────────────────────────────┘
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Tree-Structured KV Cache | 将 rollout 路径组织为树,共享前缀只存一份 | 树节点数远小于扁平存储 |
| Speculative Rollout 集成 | 在树结构中高效进行 speculative generation | Accept rate 显著提升 |
| 增量更新机制 | 分叉点之后仅计算新路径 | 减少冗余计算 |
| Memory-Aware Pruning | 基于 reward 和 LRU 的动态缓存管理 | 控制内存预算 |
| Batch-Level Sharing | 同一 batch 内 rollout 间的 KV 复用 | 70% 节点减少 |
五、实验结果
评估设置
| 配置 | 详情 |
|---|---|
| 模型 | LLaMA 系列(7B-70B) |
| RL 方法 | PPO / GRPO / R1-style rollout |
| 基准 | 标准 rollout(无 tree cache) |
| 指标 | Rollout 延迟、内存占用、训练吞吐量 |
核心结果
Rollout 加速比:
| 序列长度 | 加速比 | 说明 |
|---|---|---|
| < 512 | 1.5-2.0× | 短序列,共享前缀较短 |
| 512-2048 | 2.0-3.0× | 中序列,显著加速 |
| > 2048 | 2.5-4.0× | 长序列,最大加速 |
内存节省:
| 指标 | 改善 |
|---|---|
| 树节点 vs 扁平 token | ~70% 减少 |
| KV cache 内存 | ~3× 降低 |
| Batch 内共享率 | 随 batch size 增大而提高 |
Accept Rate(Speculative Rollout):
Tree-structured cache 提高了 speculative decoding 的 accept rate,因为共享前缀的 KV 已预先计算,draft model 更容易命中已有路径。
消融实验
Tree vs Flat 对比:
| 配置 | Rollout 延迟 | 内存占用 | 训练吞吐量 |
|---|---|---|---|
| Flat (baseline) | 1.0× | 1.0× | 1.0× |
| Tree (Ours) | 0.3-0.5× | 0.3× | 2.0-3.0× |
Pruning 策略对比:
- LRU pruning:简单有效,适合均匀访问模式
- Reward-based pruning:优先保留高 reward 路径,收敛更快
- Hybrid:结合两者,最佳实践
六、与现有方法对比
| 方法 | KV 复用 | Speculative | 内存管理 | 加速 |
|---|---|---|---|---|
| Standard Rollout | 无 | 无 | 无 | 1.0× |
| Prefix Cache (vLLM) | 跨请求 | 无 | LRU | 1.5-2× |
| SRT (Ours) | 树结构 | 集成 | Aware | 2-4× |
关键差异:
- Prefix cache 仅做跨请求的 prefix matching,SRT 利用 rollout 的 tree 结构做更精细的管理
- SRT 将 speculative decoding 与 tree cache 深度集成,进一步提升效率
- Memory-aware pruning 确保训练过程中的内存可控
七、总结
核心贡献
- Tree-Structured KV Cache:首次将 rollout 路径组织为树结构,实现 batch 内 KV 复用
- Speculative Rollout 集成:在树结构中高效进行 speculative generation,提高 accept rate
- 增量更新机制:分叉点后的增量计算,消除冗余 KV 计算
- Memory-Aware Pruning:动态缓存管理,保证内存可控
- 2-4× rollout 加速:在长序列场景下效果尤为显著
技术影响
- 为 LLM 的 RL 微调提供了系统级的加速方案
- Tree-structured cache 的概念可推广到其他需要批量生成的场景
- 将 speculative decoding 与 RL rollout 深度结合的新范式
局限性
- 树结构的构建和维护有一定 CPU 开销
- 在 batch size 较小时收益有限
- 对 rollout 的 divergence pattern 敏感
八、参考资源
- arXiv: https://arxiv.org/abs/2601.09083
- License: CC BY 4.0
- 评估模型: LLaMA 系列 (7B-70B)
- RL 方法: PPO, GRPO, R1-style rollout
关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | Motivation - rollout 计算冗余 | motivation.png |
| Figure 2 | Accepted tokens 统计 | accepted-tokens.png |
| Figure 3 | Cache maintenance 策略 | cache-maintenance.png |
| Figure 4 | Rollout speedup 分析 | rollout-speedups.png |
| Figure 5 | Tree cache 结构示例 | cache-illustration.png |