Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models
DeepSeek提出的Engram模块,将条件记忆作为与MoE条件计算互补的新稀疏轴,通过O(1) N-gram查找实现静态知识检索,揭示U型缩放定律
Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models |
| 作者 | Xin Cheng, Wangding Zeng, Damai Dai, Qinyu Chen, Bingxuan Wang, Zhenda Xie, Kezhao Huang, Xingkai Yu, Zhewen Hao, Yukun Li, Han Zhang, Huishuai Zhang, Dongyan Zhao, Wenfeng Liang |
| 机构 | 北京大学 (PKU) / DeepSeek-AI |
| 论文 | arXiv:2601.07372 |
| 代码 | github.com/deepseek-ai/Engram |
| 发布 | 2026-01-12 |
| 许可 | CC BY 4.0 |
| 领域 | Computation and Language (cs.CL); Artificial Intelligence (cs.AI) |
二、核心思想
问题定义
当前LLM通过**Mixture-of-Experts (MoE)**实现条件计算来扩展容量,但Transformer缺乏原生的知识查找原语,被迫通过计算来模拟检索。具体而言:
- 语言建模包含两种本质不同的子任务:组合推理(compositional reasoning)和知识检索(knowledge retrieval)
- 前者需要深层动态计算,后者(如命名实体、公式化模式)是局部的、静态的、高度刻板化的
- 标准Transformer没有专门的查找原语,导致解析一个常见多词实体需要消耗多层注意力+FFN,本质上是在昂贵地重建一个静态查找表
核心洞察
条件计算(MoE)稀疏地激活参数来处理动态逻辑;**条件记忆(Engram)**则通过稀疏查找操作检索固定知识的静态嵌入。
二者是互补的稀疏轴:
- MoE:条件计算 → 处理动态、上下文依赖的逻辑
- Engram:条件记忆 → 处理静态、局部的知识模式
解决方案概述
Engram将经典N-gram嵌入现代化,通过哈希实现O(1)常数时间查找,作为Transformer的补充模块:
传统方法:  通过计算模拟检索 → 浪费深度层于静态模式重建
Engram:    通过N-gram哈希查找 → O(1)检索静态嵌入,释放计算深度
三、技术架构
整体框架
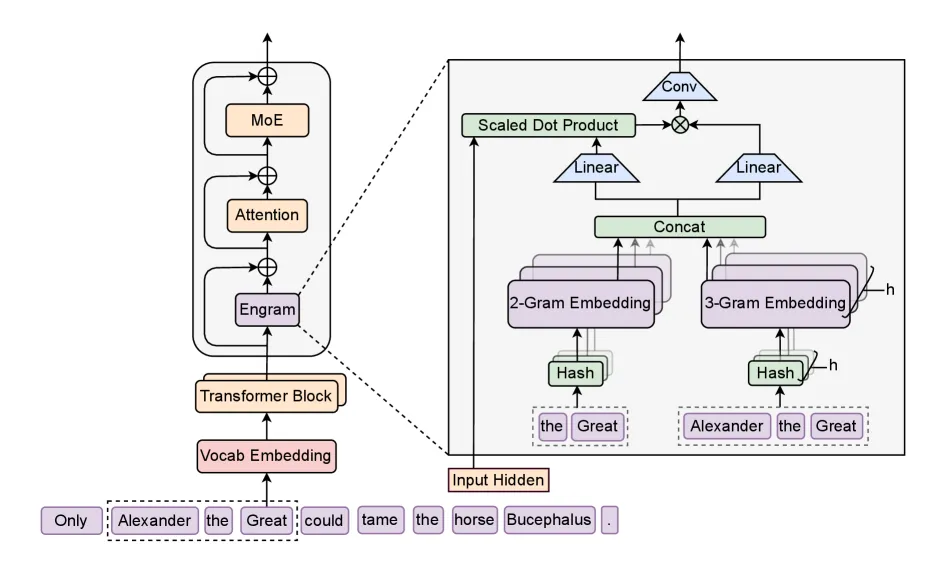
Engram在每个指定层执行两个阶段:检索(retrieval)和融合(fusion)。
输入: 序列 X = (x₁, ..., xₜ), 隐藏状态 H⁽ˡ⁾ ∈ R^(T×d)
        ↓
    ┌─────────────────────────────────────┐
    │         检索阶段 (Retrieval)         │
    │  1. Tokenizer压缩 → 规范ID映射       │
    │  2. 多哈希头 → 确定性N-gram索引      │
    │  3. 拼接所有嵌入 → eₜ ∈ R^(d_mem)   │
    └─────────────────────────────────────┘
        ↓
    ┌─────────────────────────────────────┐
    │         融合阶段 (Fusion)            │
    │  1. 上下文感知门控: αₜ = σ(Q·K/√d) │
    │  2. 门控值: ṽₜ = αₜ · W_V eₜ      │
    │  3. 因果卷积 + SiLU激活             │
    │  4. 残差连接: H⁽ˡ⁾ ← H⁽ˡ⁾ + Y      │
    └─────────────────────────────────────┘
        ↓
    标准Attention → MoE
核心公式与设计要点
1. Tokenizer压缩
标准子词tokenizer优先考虑无损重建,常将语义等价项分配不同ID(如Apple vs ␣apple)。Engram实现词汇投影层:
P: V → V'  (满射函数)
x'_t = P(x_t) (基于NFKC规范化、小写化等)实现23%的有效词汇表缩减(128k tokenizer)。
2. 多哈希N-gram检索
z_{t,n,k} = φ_{n,k}(g_{t,n})  (乘法-XOR哈希)
e_{t,n,k} = E_{n,k}[z_{t,n,k}]  (查表)
e_t = ‖_{n=2}^N ‖_{k=1}^K e_{t,n,k} (拼接所有嵌入)- 使用K个不同的哈希头缓解碰撞
- 嵌入表大小M_{n,k}为质数
- φ_{n,k}实现为轻量级乘法-XOR哈希
3. 上下文感知门控
k_t = W^K e_t,  v_t = W^V e_t
α_t = σ(RMSNorm(h_t)^T · RMSNorm(k_t) / √d)  ∈ (0,1)
ṽ_t = α_t · v_t
Y = SiLU(Conv1D(RMSNorm(Ṽ))) + Ṽ (深度可分离因果卷积)关键设计:当前隐藏状态h_t(已通过前置注意力聚合全局上下文)作为Query,检索的静态嵌入e_t同时作为Key和Value。如果检索的记忆与当前上下文矛盾,门控α_t趋向0,抑制噪声。
4. 多分支架构集成
采用Manifold-Constrained Hyper-Connections (mHC, M=4):
- 单个稀疏嵌入表和Value投影矩阵W_V跨所有M个分支共享
- M个独立的Key投影矩阵{W^{K(m)}}实现分支特异性门控
- 线性投影可融合为单次密集FP8矩阵乘法
5. 系统效率:计算与存储解耦
训练阶段:
- 大规模嵌入表在GPU间sharding
- All-to-All通信收集活跃嵌入行
推理阶段:
- Engram表卸载到主机内存(DRAM)
- 确定性地址 → 异步预取 → 重叠通信与计算
- 100B参数表卸载仅增加**<3%**延迟
模型配置
| 模型 | 总参数 | 激活参数 | 专家数 | Engram参数 | 训练Token |
|---|---|---|---|---|---|
| Dense-4B | 4.1B | 3.8B | - | - | 262B |
| MoE-27B | 26.7B | 3.8B | 72+2 (top-6) | - | 262B |
| Engram-27B | 26.7B | 3.8B | 55+2 (top-6) | 5.7B | 262B |
| Engram-40B | 39.5B | 3.8B | 55+2 (top-6) | 18.5B | 262B |
四、核心创新
| 创新点 | 说明 | 价值 |
|---|---|---|
| 条件记忆作为新稀疏轴 | 与MoE条件计算互补,专门处理静态知识检索 | 解决Transformer缺乏原生查找原语的问题 |
| U型缩放定律 | 发现MoE与Engram之间的最优分配比例≈75-80% | 纯MoE次优,约20-25%稀疏预算分配给Engram最佳 |
| N-gram嵌入现代化 | 结合tokenizer压缩、多哈希头、上下文门控、多分支集成 | 经典N-gram在现代架构中焕发新生 |
| 基础设施感知效率 | 确定性地址支持主机内存卸载,推理开销<3% | 突破GPU HBM限制,实现参数激进扩展 |
| 机制解释:有效加深网络 | LogitLens+CKA证明Engram使浅层等价于MoE深层 | 释放早期层用于推理,而非静态模式重建 |
五、缩放定律与稀疏分配
U型缩放定律(Figure 3)
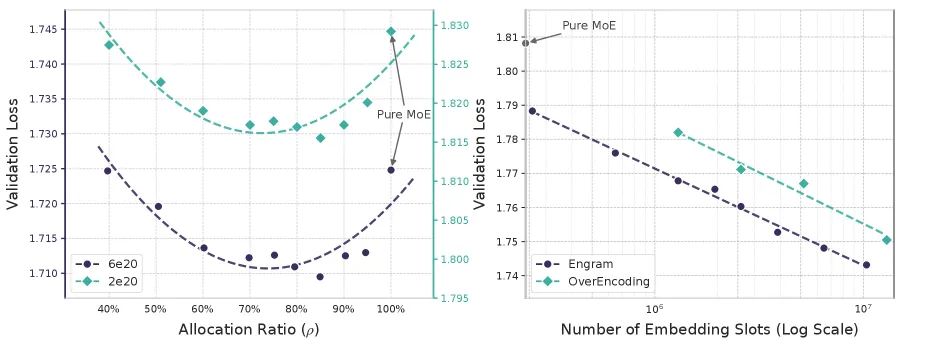
稀疏分配问题:给定固定总参数预算,如何在MoE专家和Engram嵌入之间分配稀疏容量?
定义分配比例 ρ = P_MoE / P_sparse,其中 P_sparse = P_tot - P_act 为非激活参数预算。
关键发现:
| 计算预算 | 最优ρ | 说明 |
|---|---|---|
| C = 2×10²⁰ FLOPs | ≈75-80% | 5.7B参数模型,46个专家 |
| C = 6×10²⁰ FLOPs | ≈75-80% | 9.9B参数模型,43个专家 |
U型解释:
- ρ → 100%(纯MoE):缺乏静态模式专用内存,被迫通过深度和计算低效重建
- ρ → 0%(纯Engram):丧失条件计算容量,损害需要动态推理的任务
- ρ ≈ 75-80%:最优平衡点,跨规模稳定
验证:即使在ρ ≈ 40%(仅46/106专家)时,Engram模型仍能达到与纯MoE可比的性能。
无限内存 regime
固定MoE骨干,扩展Engram表大小从 2.58×10⁵ 到 1.0×10⁷ 槽(增加最多~13B参数):
- 验证损失随内存规模严格遵循幂律下降
- 比OverEncoding(直接平均N-gram嵌入)解锁更大的缩放潜力
- 证明条件记忆是可预测的独立缩放维度
六、大规模预训练结果
主要基准对比(Table 1)
| 基准 | Dense-4B | MoE-27B | Engram-27B | Engram-40B |
|---|---|---|---|---|
| Pile Val Loss | 1.768 | 1.634 | 1.622 | 1.610 |
| MMLU | 48.6 | 57.4 | 60.4 (+3.0) | 60.6 |
| MMLU-Redux | 50.7 | 60.6 | 64.0 (+3.4) | 64.5 |
| MMLU-Pro | 21.1 | 28.3 | 30.1 (+1.8) | 31.3 |
| CMMLU | 47.9 | 57.9 | 61.9 (+4.0) | 63.4 |
| C-Eval | 46.9 | 58.0 | 62.7 (+4.7) | 63.3 |
| AGIEval | 29.1 | 38.6 | 41.8 (+3.2) | 45.9 |
| ARC-Challenge | 59.3 | 70.1 | 73.8 (+3.7) | 76.4 |
| BBH | 42.8 | 50.9 | 55.9 (+5.0) | 57.5 |
| HumanEval | 26.8 | 37.8 | 40.8 (+3.0) | 38.4 |
| MATH | 15.2 | 28.3 | 30.7 (+2.4) | 30.6 |
| GSM8K | 35.5 | 58.4 | 60.6 (+2.2) | 62.6 |
关键发现:增益不仅在知识密集型任务(MMLU +3.4, CMMLU +4.0),在通用推理(BBH +5.0, ARC +3.7)和代码/数学(HumanEval +3.0, MATH +2.4)领域提升更显著。
长上下文训练(Table 2)
| 设置 | Multi-Query NIAH | Variable Tracking |
|---|---|---|
| MoE-27B (50k) | 84.2 | 77.0 |
| Engram-27B (50k) | 97.0 | 89.0 |
| Engram-27B (46k, iso-loss) | 97.0 | 87.2 |
| Engram-27B (41k, 82% compute) | 89.5 | 83.2 |
Engram在长上下文检索任务上实现压倒性优势:
- Multi-Query NIAH: 84.2 → 97.0 (+12.8)
- Variable Tracking: 77.0 → 89.0 (+12.0)
预训练轨迹(Appendix B)
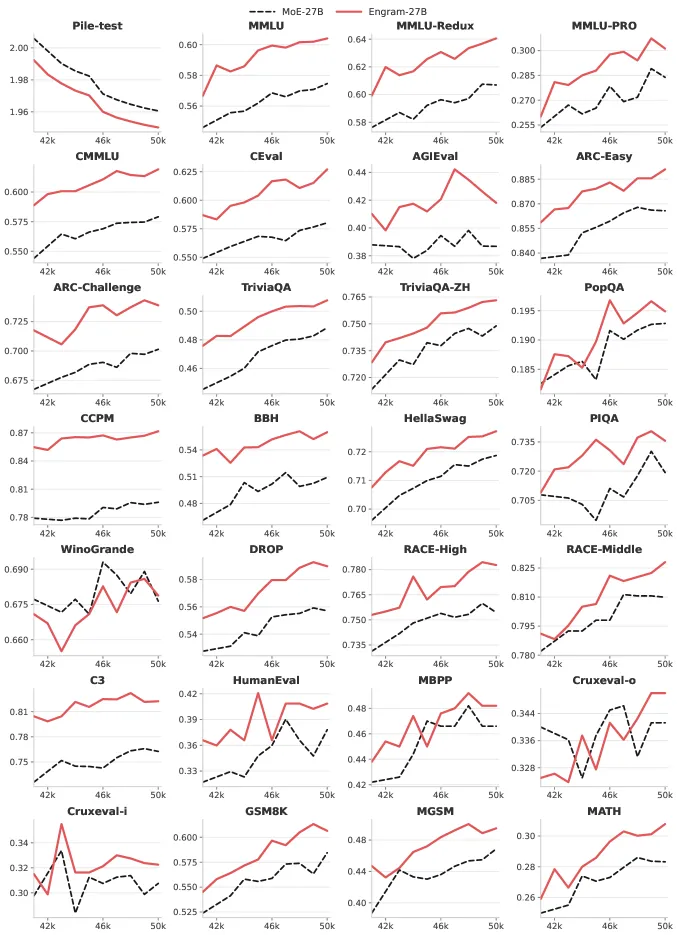
Engram-40B在训练后期持续缩小与Engram-27B的差距,表明扩展的内存容量在当前token预算下尚未完全饱和。
七、机制分析
7.1 Engram是否等效于增加模型深度?
LogitLens分析(Figure 4a):
- Engram变体在各层呈现系统性地更小的KL散度
- 早期层的增益最显著,表明Engram加速了预测收敛
CKA表示对齐(Figure 4b-c):
- 高相似度的对角线明显上移
- Engram-27B的第5层 ≈ MoE-27B的第12层
- 证明Engram功能上等效于增加有效深度
7.2 结构消融(Figure 5)
参考配置:3B MoE + 1.6B Engram (Layers 2, 6) → Val Loss = 1.768 (Δ = -0.04 vs 基线1.808)
| 消融变体 | Val Loss | Δ vs 参考 |
|---|---|---|
| w/o multi branch | 1.773 | +0.005 |
| w/o token compress | 1.775 | +0.007 |
| w/o gating | 1.780 | +0.012 |
| w/o short conv | 1.769 | +0.001 |
| + 4-gram | 1.769 | +0.001 |
三个最关键组件:多分支集成、tokenizer压缩、上下文感知门控。
7.3 敏感性分析(Figure 6)
完全抑制Engram输出后的性能保留率:
| 任务类型 | 保留率 | 说明 |
|---|---|---|
| 事实知识 (TriviaQA) | 29% | 灾难性崩溃,Engram是参数知识主仓库 |
| 事实知识 (MMLU) | 44% | 严重依赖 |
| 常识推理 (HellaSwag) | 68% | 中度依赖 |
| 阅读理解 (C3) | 93% | 几乎不受影响 |
| 阅读理解 (RACE-Middle) | 89% | 主要由backbone注意力处理 |
功能二分法:事实知识严重依赖Engram,而上下文 grounding 任务主要由backbone处理。
7.4 门控可视化(Figure 7)
门控机制在完成局部静态模式时一致激活:
- 英文:“Alexander the Great”, “the Milky Way”, “By the way”, “Princess of Wales”
- 中文:“四大发明”, “张仲景”
7.5 系统效率(Table 4)
| 配置 | 吞吐量 (tok/s) | 开销 |
|---|---|---|
| Dense-4B 基线 | 9,031.62 | - |
| + 100B Engram (CPU卸载) | 8,858.28 | 1.9% |
| Dense-8B 基线 | 6,315.52 | - |
| + 100B Engram (CPU卸载) | 6,140.02 | 2.8% |
100B参数表完全卸载到主机DRAM,推理开销<3%。
八、相关工作
| 方向 | 代表工作 | 与Engram的区别 |
|---|---|---|
| N-gram嵌入扩展 | Per-Layer Embeddings, DeepEmbed | Engram提供上下文门控和多哈希,扩展潜力更大 |
| SCONE | Yu et al. (2025) | 侧重推理,需要额外模块和训练FLOPs |
| OverEncoding | Huang et al. (2025) | 直接平均N-gram嵌入,无上下文调制 |
| 条件计算 | MoE (Shazeer et al., 2017) | MoE处理动态逻辑,Engram处理静态知识,二者互补 |
九、总结
核心贡献
- 提出条件记忆作为新稀疏轴:与MoE条件计算互补,解决Transformer缺乏原生知识查找原语的问题
- Engram模块:将经典N-gram嵌入现代化,通过tokenizer压缩、多哈希头、上下文门控、多分支集成实现高效O(1)查找
- U型缩放定律:发现MoE与Engram间的最优分配比例≈75-80%,纯MoE次优
- 27B/40B模型验证:在知识、推理、代码、数学、长上下文等全方位超越iso-parameter/iso-FLOPs MoE基线
- 机制解释:LogitLens+CKA证明Engram功能上等效于加深网络,释放早期层用于复杂推理
- 基础设施感知效率:确定性地址支持主机内存卸载,100B参数表推理开销<3%
技术影响
- 为下一代稀疏模型确立了条件记忆作为基本建模范式
- 证明静态知识检索和动态推理应通过不同稀疏轴分别处理
- 为LLM架构设计开辟了MoE之外的第四维度(条件计算、条件记忆、注意力、嵌入)
局限性
- Engram对事实知识的依赖性也意味着其可能放大训练数据中的偏见/错误事实
- 4-gram在固定预算下略逊于2/3-gram,更大规模下可能不同
- 门控机制并非所有分支都编码可解释的激活模式
- 当前系统效率实验在dense backbone上做保守测试,MoE场景下收益可能更大
十、参考资源
- 论文:https://arxiv.org/abs/2601.07372
- 代码:https://github.com/deepseek-ai/Engram
- 许可证:CC BY 4.0
- 相关模型:DeepSeek-V3, Per-Layer Embeddings (Team, 2025), DeepEmbed (RWKV Team, 2025)