Hummingbird: SLO-Oriented GPU Preemption at Microsecond-scale
面向 SLO 的微秒级 GPU 抢占调度系统
Hummingbird: SLO-Oriented GPU Preemption at Microsecond-scale
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Hummingbird: SLO-Oriented GPU Preemption at Microsecond-scale |
| 作者 | Zikun Li, Yifan Yuan, Yihao Zhang, Zhenheng Tang, Xiaowen Gong, Shaohuai Shi, Yanghua Peng, Haibin Lin, Xiang Wang, Yuxin Peng, Xiaoyong Du |
| 机构 | Peking University, ByteDance |
| 论文 | arXiv:2601.04071 |
| 代码 | 未公开 |
| 发布 | 2026年1月7日 |
| 主题 | cs.OS, cs.DC, cs.PF |
二、核心思想
问题定义
GPU 集群中,粗粒度的 GPU 分配导致极低的利用率(Microsoft 52%,Alibaba <25%)。现有的 GPU 共享技术(空间共享和时间共享)无法同时保证 SLO 遵从和最大化利用率,因为闭源 GPU(如 NVIDIA)缺乏细粒度的任务调度能力。
核心挑战:
- 空间共享(如 Orion):干扰严重,无法保证高优先级任务的 SLO
- 时间共享(如 REEF):抢占延迟高(毫秒级),低优先级任务吞吐量低
解决方案概述
Hummingbird 是一个面向 SLO 的 GPU 调度系统,通过微秒级抢占实现高优先级任务的 SLO 保证,同时最大化 GPU 利用率:
- 内核分割(Kernel Splitting): 将低优先级任务的内核分割为微秒级子内核,创建抢占点
- 运行时调度器: 动态检测 GPU 空闲时间片(bubbles),智能调度低优先级任务
- NVLink 扩展内存管理: 支持层次化内存卸载,解决内存密集型场景的共享问题
核心性能
| 指标 | 数值 |
|---|---|
| SLO 达成率提升 | 比空间共享提升 9.7×,比时间共享提升 3.5× |
| 高优先级 SLO 降级 | 与独占执行相比仅下降 <1% |
| 低优先级吞吐量 | 比时间共享提升 2.4× |
| 抢占延迟 | 平均 139µs(比 REEF 快 4.3-6.6×) |
三、技术架构
整体框架图
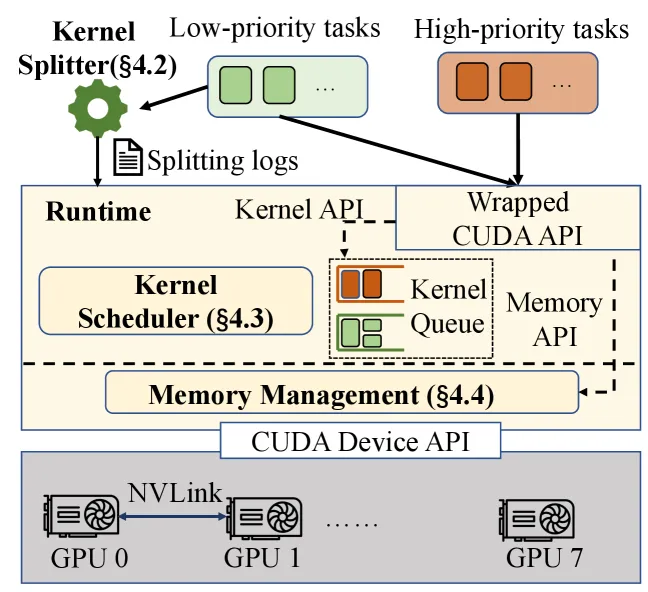
Figure 6: Hummingbird 设计概览。包含三个组件:(1) 内核分割器分析低优先级任务的内核执行时间并计算最优分割大小;(2) 运行时调度器动态分割和合并内核以平衡抢占延迟和 GPU 利用率;(3) NVLink 扩展内存管理系统支持层次化内存卸载。
关键观察
GPU 空闲时间片(Bubbles)分析
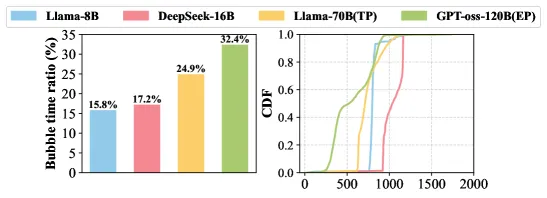
Figure 2: (a) 处理请求时小时间片的比例;(b) 小时间片时间分布(µs)。
三类小时间片:
| 类型 | 来源 | 持续时间 | 占比 |
|---|---|---|---|
| 内存操作与同步 | CPU-GPU 同步、流式响应传输 | 500µs-6ms | 10-20% |
| GPU 间通信 | NCCL AllReduce、Send/Recv | 150µs-20ms | 20-30% |
| CPU 端开销 | 模块加载、锁竞争、调度开销 | 5-8% GPU 时间 | 5-8% |
线程块执行时间分析
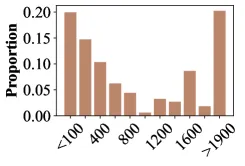
Figure 3: (a) 内核执行时间分布(µs);(b) 线程块执行时间 CDF(µs)。
关键发现:
- 内核执行时间跨度大:从几微秒到几十毫秒
- 99.999% 的线程块在 400µs 内完成
- 线程块执行时间高度可预测(DNN 迭代特性)
核心公式
最优分割大小计算
分割后内核应包含的最大线程块数:
其中:
- : SM 数量(硬件参数)
- : 每个 SM 的最大线程数
- : 程序员指定的每块线程数
- : 内核占用率(取决于共享内存和寄存器使用)
两步分析方法
- 计算最大块数: 基于 SM 容量计算,确保充分利用计算资源
- 逐步减少块数: 观察执行时间,找到最短执行时间点
- 若减少块数导致执行时间缩短 → 内存密集型(减少带宽竞争)
- 若执行时间稳定 → 达到最优分割大小
PTX 内核转换
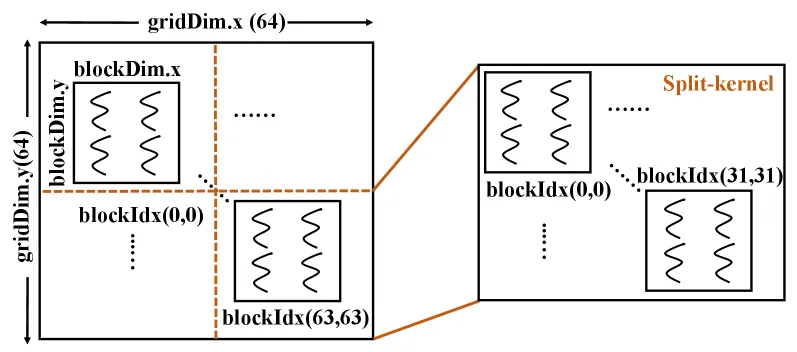
Figure 8: 内核分割示例。
通过 PTX 注入技术实现运行时内核分割:
// 原始内核参数
.visible .entry mulmat(
  .param .u64 mulmat_param_0,
  .param .u64 mulmat_param_1, ...,
  .param .u32 mulmat_param_offset_x, ..y, ..z){
  // 注入偏移量加载
  ld.param.u32 %r1, [mulmat_param_offset_x];
  ld.param.u32 %r2, [mulmat_param_offset_y];
  // 重新对齐 blockIdx
  mov.u32 %r3, %ctaid.x;
  add.s32 %r3, %r3, %r1;  // 应用偏移
  ...
}
运行时调度算法
Algorithm 1: 内核调度逻辑(简化)
Function KERNELSCHEDULING(Q_lp, Q_hp):
  while True:
    if !Q_hp.is_empty():
      P_flag ← True  // 抢占标志
      Launchkernel(Q_hp)
    else:
      Bubble_flag ← DETECTBUBBLES()
      if Bubble_flag == False:
        Continue  // 未检测到时间片
      if Is_large(Bubble_flag) == True:
        CONSOLIDATE(Q_lp)  // 合并分割内核
      GPU_sync()  // 等待高优先级完成
      P_flag ← False
      // 异步线程启动低优先级内核
Call KERNEL_TICK(Q_lp, P_flag) thread调度策略:
- 高优先级调度: 检测到高优先级内核时立即抢占,平均抢占延迟 139µs
- 低优先级调度: 仅在检测到空闲时间片时启动,使用 kernel-tick 策略控制启动时序
- 时间片检测: 基于主机端提示(hint-based)的检测机制,通过 CUDA API 模式识别
NVLink 扩展内存管理
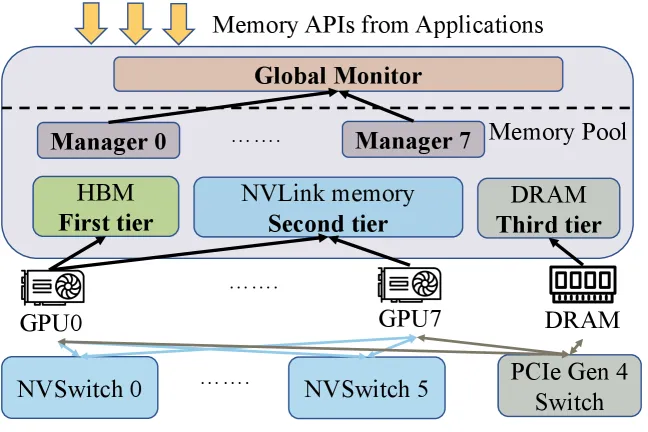
Figure 9: NVLink 扩展统一内存。
设计原则: 高优先级任务保留完整的 GPU 内存访问,低优先级任务利用剩余内存。
优化策略:
- 优先级隔离: 使用 CUDA Driver API 的放置偏好优先分配高优先级任务内存
- 干扰感知驱逐: 仅驱逐低优先级任务页面,避免干扰高优先级任务
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 微秒级抢占 | 通过内核分割实现 400µs 级抢占延迟 | 99.999% 线程块在 400µs 内完成 |
| 基于提示的时间片检测 | 利用 CUDA API 模式检测空闲时间片 | 覆盖 6 种框架、6 种模型的生产环境 |
| PTX 内核转换 | 运行时修改 PTX 实现内核分割 | 支持 CUTLASS、Triton 等复杂内核 |
| Kernel-Tick 调度 | 利用内核执行可预测性减少同步开销 | 仅 1.3% 性能损耗 |
| NVLink 扩展内存 | 层次化内存卸载支持内存密集型场景 | 支持 47% 内存卸载 |
五、实验结果
实验设置
| 项目 | 配置 |
|---|---|
| 硬件 | 8× A100 80GB SXM4, 2× Xeon 8358P, 1TB 内存 |
| 软件 | Ubuntu 22.04, CUDA 12.6 |
| 高优先级任务 | Llama-8B, Yi-34B (llama.cpp, 8-bit 量化) |
| 低优先级任务 | Mistral-7B, DeepSeekMoE-16B, ResNet-101, GPT-2 |
| 负载 | BurstGPT 真实流量追踪 |
| SLO 定义 | 独占执行时 P99 延迟 |
单 GPU 性能
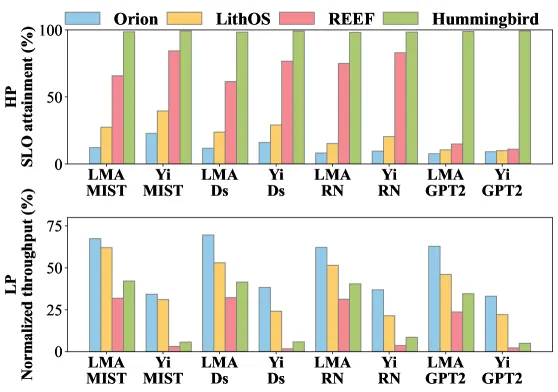
Figure 10: (a) 高优先级任务 SLO 达成率;(b) 低优先级任务吞吐量(归一化到独占执行)。
SLO 达成率:
| 方法 | Llama-8B | Yi-34B | 平均 |
|---|---|---|---|
| Orion (空间共享) | <22.8% | <22.8% | <22.8% |
| LithOS (空间共享) | 改善 1.8× | - | - |
| REEF (时间共享) | 较好 | 较好 | 2.7× 优于 Orion |
| Hummingbird | ~99% | ~99% | 5.6× 优于 LithOS, 3.0× 优于 REEF |
关键发现:
- Hummingbird 在所有场景下达到近 99% SLO 达成率
- 抢占延迟限制在 400µs 以内,高优先级任务仅 <1% 性能损耗
- 低优先级吞吐量比 REEF 提升 2.4×
内存密集型场景
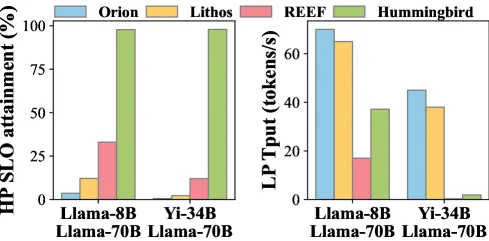
Figure 11: (a) 高优先级任务 SLO 达成率;(b) 低优先级任务吞吐量。
设置: Llama-8B/Yi-34B 作为高优先级,Llama-70B 作为低优先级(需要 90-115GB 内存)
| 方法 | SLO 达成率 | 低优先级吞吐量 |
|---|---|---|
| Orion/LithOS | ≤12% | - |
| REEF + HUVM | 基线 | 基线 |
| Hummingbird | 5.6× 优于 REEF | 4.2× 优于 REEF |
优化分解
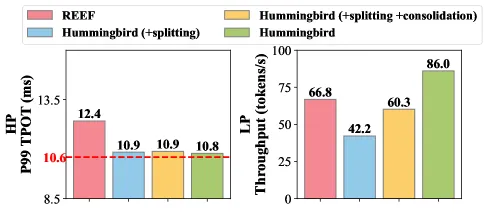
Figure 12: Hummingbird 优化分解。(a) 高优先级任务 P99 TPOT;(b) 低优先级任务吞吐量。
高优先级任务:
- REEF P99 TPOT: 12.5ms
- Hummingbird 内核分割后: 10.9ms
- 独占执行: 10.6ms
- 内核合并对 SLO 影响: <0.7%
低优先级任务:
- 内核分割初始损耗: 37%
- 内核合并恢复: 1.5× 提升
- Kernel-Tick 调度: 1.43× 提升
- 最终仅 1.3% 损耗(相比无分割基线)
抢占延迟与多 GPU 扩展
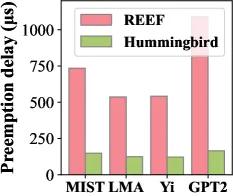
Figure 13: (a) 平均抢占延迟比较;(b) 多 GPU 场景性能比较。
抢占延迟:
| 方法 | 平均抢占延迟 | 相对 REEF |
|---|---|---|
| REEF | ~600-900µs | 基线 |
| Hummingbird | 121-165µs | 4.3-6.6× 更快 |
多 GPU 场景 (16× A100, Llama-405B TP+PP):
| 指标 | REEF | Hummingbird | 提升 |
|---|---|---|---|
| SLO 达成率 | 基线 | - | 9.7× |
| 低优先级吞吐量 | 基线 | - | 3.3× |
跨 GPU 泛化
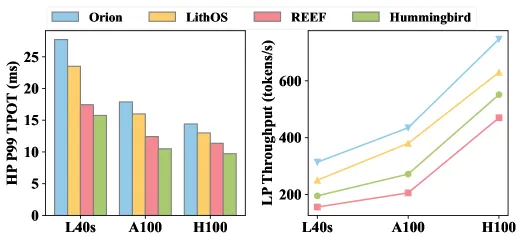
Figure 14: (a) 不同 GPU 上的 P99 TPOT;(b) 不同 GPU 上的低优先级吞吐量。
在 L40s 和 H100 上验证:
- P99 TPOT 比 Orion 降低 39.0%,比 REEF 降低 31%
- 低优先级吞吐量比 REEF 提升 1.25×
六、与现有方法对比
| 方面 | Orion | LithOS | REEF | Hummingbird |
|---|---|---|---|---|
| 共享类型 | 空间共享 | 空间共享 | 时间共享 | 时间共享 |
| 调度粒度 | 内核级 | TPC 级 | 内核级 | 线程块级 |
| 抢占延迟 | 无抢占 | 无抢占 | 毫秒级 | 微秒级 (139µs) |
| SLO 保证 | 差 | 中等 | 较好 | 近 99% |
| GPU 利用率 | 高 | 高 | 低 | 高 |
| 干扰控制 | 有限 | 计算隔离 | 消除 | 消除 |
| 内存管理 | 无 | 无 | 统一内存 | NVLink 扩展 |
七、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| Orion | 空间共享基线,Hummingbird 在 SLO 达成率上提升 9.7× |
| LithOS | 空间共享改进,TPC 级计算隔离,但仍有带宽干扰 |
| REEF | 时间共享基线,Hummingbird 在抢占延迟上快 4.3-6.6× |
| MIG/MPS | NVIDIA 原生共享机制,缺乏动态资源回收 |
| TGS | 容器化工作负载共享,Hummingbird 提供更细粒度控制 |
| NEUTRINO | PTX 转换基础设施,Hummingbird 构建于其上 |
八、总结
核心贡献
- 微秒级抢占机制: 通过内核分割实现 400µs 级抢占延迟,在闭源 GPU 上保证 SLO
- 基于提示的时间片检测: 利用 CUDA API 模式检测空闲时间片,覆盖生产环境常见模式
- PTX 内核转换: 运行时修改 PTX 实现内核分割,支持 CUTLASS、Triton 等复杂内核
- Kernel-Tick 调度策略: 利用内核执行可预测性减少同步开销,仅 1.3% 性能损耗
- NVLink 扩展内存管理: 层次化内存卸载支持内存密集型场景
技术影响
- GPU 利用率提升: 在保证 SLO 的前提下,低优先级任务吞吐量提升 2.4×
- 实际部署就绪: 在 3000+ GPU 集群上验证,支持多种 GPU 架构(A100, L40s, H100)
- 通用性: 支持推理和训练任务,覆盖 CNN、LLM、MLLM 等多种模型
- 透明性: 通过 CUDA API Hook 实现,无需修改应用程序
局限性
- 仅在 NVIDIA GPU 上验证,未覆盖 AMD 等其他厂商
- 内核分割依赖 PTX 转换,闭源库(如 cuBLAS)需要替代方案
- 时间片检测基于特定框架的 API 模式,新框架需要额外适配
- 未探索与模型服务框架(如 vLLM、SGLang)的深度集成
九、参考资源
- 论文: arXiv:2601.04071
- 主题: cs.OS, cs.DC, cs.PF
- 页数: 约 16 页, 14 图, 13 表