MiMo-V2-Flash Technical Report
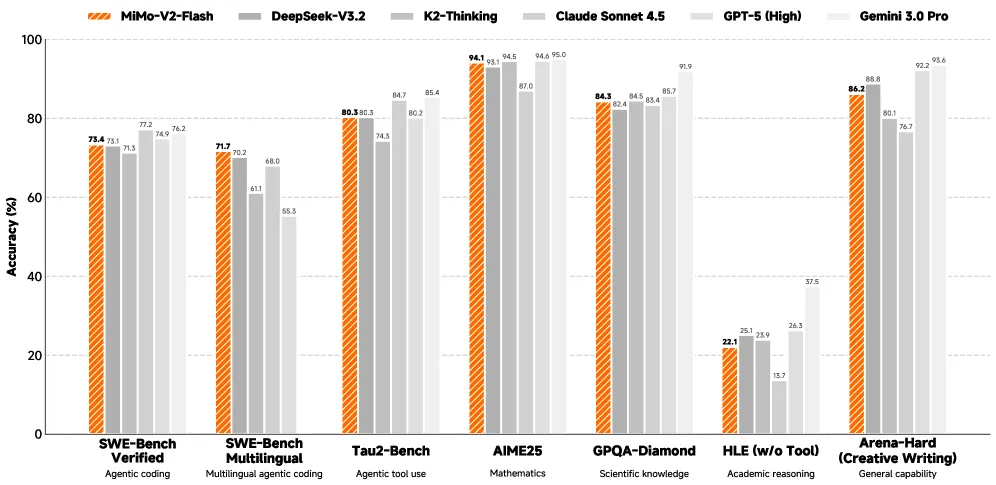
小米 309B 总参 / 15B 激活的 MoE 推理与 Agent 大模型。混合注意力(5:1 SWA:GA,128 窗口 + 可学习 attention sink,KV/算力近 6× 缩减),27T token 预训练 + MTP,原生 32K 扩展到 256K。提出 Multi-Teacher On-Policy Distillation (MOPD):多领域 RL 教师提供 token 级 KL 稠密奖励 + ORM 结果奖励,学生在自身分布上蒸馏多专家。以 1/2、1/3 的参数比肩 DeepSeek-V3.2 与 Kimi-K2;SWE-Bench Verified 73.4%。三层 MTP 做自投机解码,接受长度达 3.6、解码提速 2.6×。
MiMo-V2-Flash Technical Report
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MiMo-V2-Flash Technical Report |
| 作者 | Xiaomi LLM-Core Team(Bangjun Xiao 等百余人,Fuli Luo† 等通讯) |
| 机构 | 小米 LLM-Core 团队 |
| 提交时间 | 2026-01-06(v1),2026-01-08(v2) |
| arXiv | 2601.02780 |
| 代码/权重 | https://github.com/XiaomiMiMo/MiMo-V2-Flash(含 3 层 MTP 权重,开源) |
| 分类 | cs.CL / cs.AI |
| 规模 | MoE,309B 总参 / 15B 激活;27T token 预训练;原生 32K→256K |
二、核心思想
问题定义:迈向 AGI 的推理链与自主 Agent 工作流都受限于同一个瓶颈——长上下文建模必须又快又强。同时,现代后训练管线面临两大顽疾:能力不平衡(提升一项能力导致其他退化的「跷跷板效应」)与学习低效(合并多专家知识时训练信号利用不充分)。
解决方案:MiMo-V2-Flash 从三个层面应对:
- 架构层(快):混合 SWA/GA 注意力(5:1,128 窗口 + 可学习 attention sink),长上下文 KV 缓存与注意力算力近 6× 缩减;配合轻量 MTP。
- 后训练层(强):提出 Multi-Teacher On-Policy Distillation (MOPD) 新范式——多领域 RL 专家教师提供 token 级稠密 KL 奖励,学生在自身演化分布上做 on-policy 蒸馏,融合多专家而不牺牲各自峰值能力。
- 推理层(快):把 MTP 复用为自投机解码 draft,3 层 MTP 接受长度达 3.6、解码提速 2.6×。
结果:以 DeepSeek-V3.2 的 1/2、Kimi-K2 的 1/3 参数量比肩两者,SWE-Bench Verified 73.4% 领先所有开源模型。
三、模型架构(§2)
3.1 整体结构
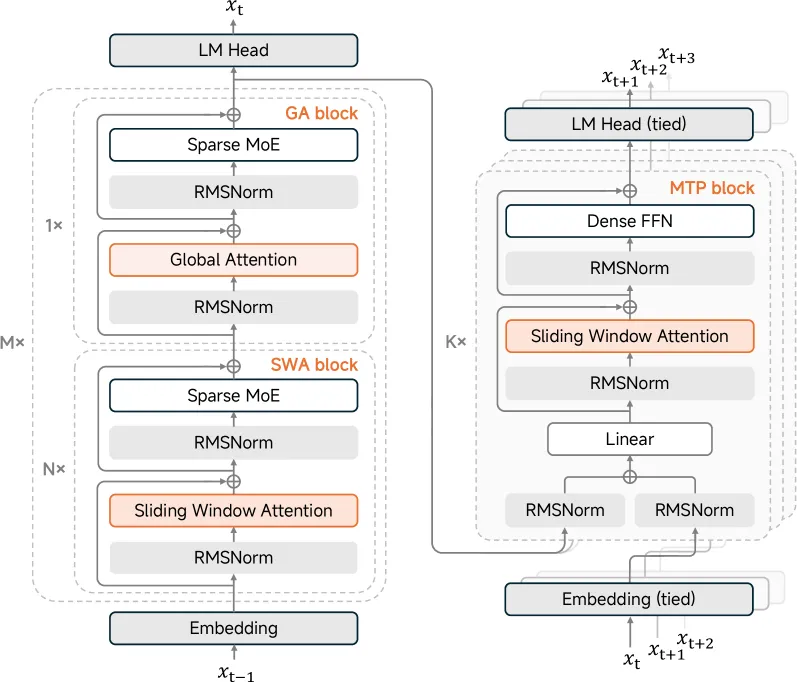
- 标准 Transformer + MoE + 混合注意力骨干。
- 堆叠 M=8 个 Hybrid Block,每块 = N=5 个 SWA 块 + 1 个 GA 块;唯一例外是第 1 个 Transformer 块用 GA + dense FFN 稳定早期表征。
- 共 48 层 = 39 SWA + 9 GA;hidden dim 4096。
- 每个 MoE 层 256 专家 / 激活 8 / 无共享专家,专家中间维 2048;dense 层 FFN 中间维 16384。
- 滑窗大小 W=128。GQA:SWA 64 query / 8 KV 头,GA 64 query / 4 KV 头;per-head 维度 Q/K=192、V=128。RoPE 部分应用于前 64 维。
- FP8 混合精度(类 DeepSeek-V3):注意力输出投影、embedding/输出头保 BF16,MoE router 参数保 FP32。
3.2 混合 SWA 架构(关键发现)
采用 gpt-oss 式可学习 attention sink 偏置 ,加到每个注意力头 softmax 分母上,让模型在需要时可对 token「不给注意力」。
在 32B dense 模型上的对照实验(4 变体:All-GA / SWA-128 无 sink / SWA-128+sink / SWA-512+sink)发现:
- 无 sink 的 SWA-128 在通用基准明显退化,加 sink 后恢复甚至超过 All-GA → 默认加 sink。
- 通用基准上 SWA-128 与 SWA-512 相当,但长上下文扩展 + 长上下文 SFT 后,SWA-128 超过 All-GA,而 SWA-512 显著退化。
- SWA-128 在复杂推理(AIME/LiveCodeBench/GPQA)上超过 All-GA。
- 反直觉解释:小窗口 = 更好的正则化 + 有效稀疏性;紧窗口迫使 SWA 专注局部、把长程依赖交给 GA 层,形成清晰分工;大窗口会模糊这种分工导致次优。
3.3 轻量 MTP(§2.3)
- MTP 块故意保持轻量:用小 dense FFN(非 MoE)限制参数、用 SWA(非 GA)减 KV 与算力,每块仅 0.33B 参数。
- 预训练时只挂 1 个 MTP head;后训练时复制 K 次形成 K 步 MTP 模块联合训练。每个 head 输入主模型 hidden state + token embedding。
- 两大 RL 加速价值:(1) 用 token 级并行替代大 batch,使小批量 on-policy RL 更实用;(2) 缓解 rollout 长尾 straggler(batch→1 时)导致的 GPU 空闲。
四、预训练(§3)
- 语料 27T token,偏重长程依赖(长网页文档、仓库级代码、PR/issue/commit 历史)。
- 三阶段 data scheduler:
- Stage 1(0–22T):通用高质语料,32K 上下文。
- Stage 2 mid-training(22–26T):上采样代码 + 约 5% 合成推理数据。
- Stage 3 context extension(26–27T):扩到 256K,上采样长程依赖数据。
- 超参:AdamW(β=0.9/0.95,wd 0.1,grad clip 1.0);Stage1 LR 峰值 ;batch warmup 到 2048。RoPE base:GA Stage1=640K→Stage3=5M,SWA=10K。MTP loss 权重 Stage1=0.3、Stage2/3=0.1。
- 长上下文检索 32K–256K 近 100% 成功率;GSM-Infinite 从 16K→128K 退化极小。相较之下 DeepSeek-V3.2-Exp(稀疏注意力)在 32K 最高但 64K/128K 大幅退化。
五、后训练:MOPD(§4)
5.1 三阶段框架
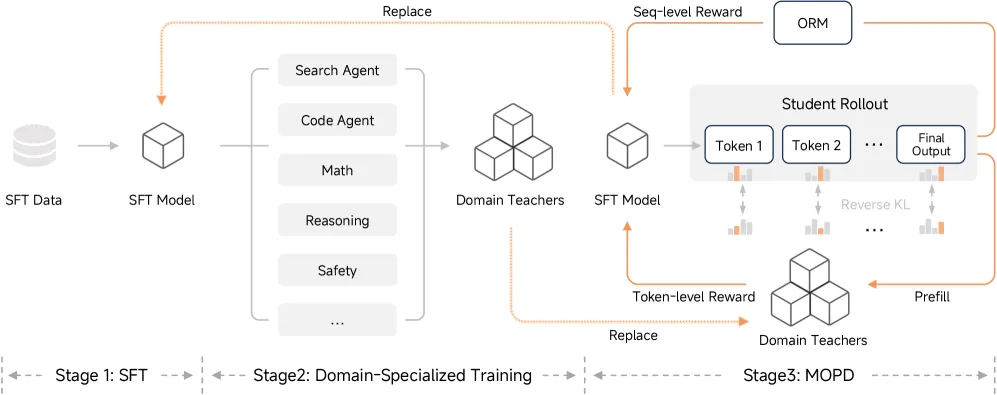
- SFT:数百万高质指令-响应对(含 thinking/non-thinking 模式),由内部领域专家 checkpoint 生成。关键稳定性指标 num-zeros(零梯度参数数):上升=专家负载失衡,下降=过拟合;其稳定性依赖专家 bias 更新率与 AdamW ε。
- 专门化 RL 训教师:分领域独立 RL,含 agentic(搜索/编码/工具)与 non-agentic(数学/通用推理/安全)。
- MOPD:将多教师知识整合建模为 on-policy RL 过程——学生从自身演化分布采样,接受各领域教师的 token 级 KL 散度奖励。
5.2 技术公式
设学生训练策略 、学生采样策略 、prompt 对应领域教师 。反向 KL 损失(学生↔教师);梯度按 IcePop 做 training-inference 重要性采样并丢弃差异过大的 token,得到 MOPD 代理损失。默认与 ORM 优势结合(如 GRPO):
其中 为结果奖励模型给出的优势。
5.3 MOPD 三大优势
| 优势 | 说明 |
|---|---|
| 有效 + 高效 | 保留最强教师在各领域的峰值能力;teacher logits 的稠密 token 级奖励保证稳定的 credit assignment 与快速收敛;学在自身分布上避免 off-policy 的 exposure bias / 分布错配 |
| 模块化 + 可扩展 | 教师可为 RL 专家、别的 SFT 模型、甚至学生自身;解耦设计便于新增教师;无缝配合现有 ORM,尤其利于复杂 agentic 任务 |
| 迭代协同进化 | 蒸馏后的学生可重新进入 RL 阶段产出更强教师 → 更高质监督 → 自增强循环 |
5.4 规模化 RL(§4.3)
- Non-agentic RL:可验证域用程序化工具 + LLM judge 混合验证;主观质量(有用性/安全)用 rubric-based LLM judge。
- Agentic RL(两维扩展:环境多样性 + 算力):
- 代码 Agent:来自真实 GitHub issue,>100K 任务;自动环境搭建管线 8 语言 70% 成功率,K8s 集群 >10000 并发 pod;轻量 scaffold 仅 3 原子工具(bash / str_replace / finish)。
- 终端:Stack Overflow/Exchange 转化约 30K 可验证任务。
- Web 开发:Playwright 渲染视频 + 多模态视觉判别器打分(比静态截图更少视觉幻觉)。
- 搜索 Agent(search/open/find)+ 函数调用 Agent(工具调用图,含数据依赖与逻辑依赖)。
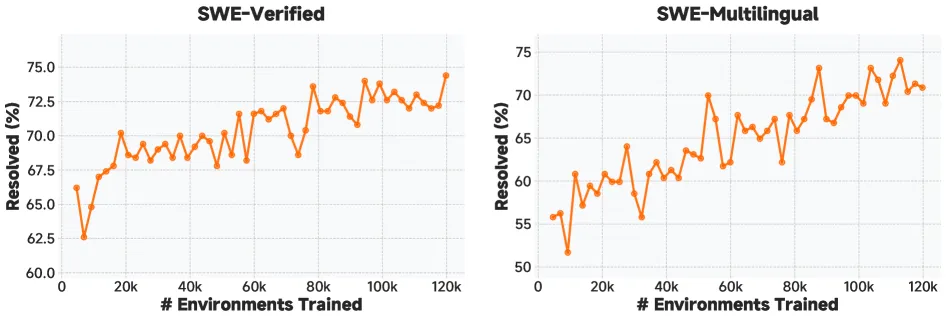
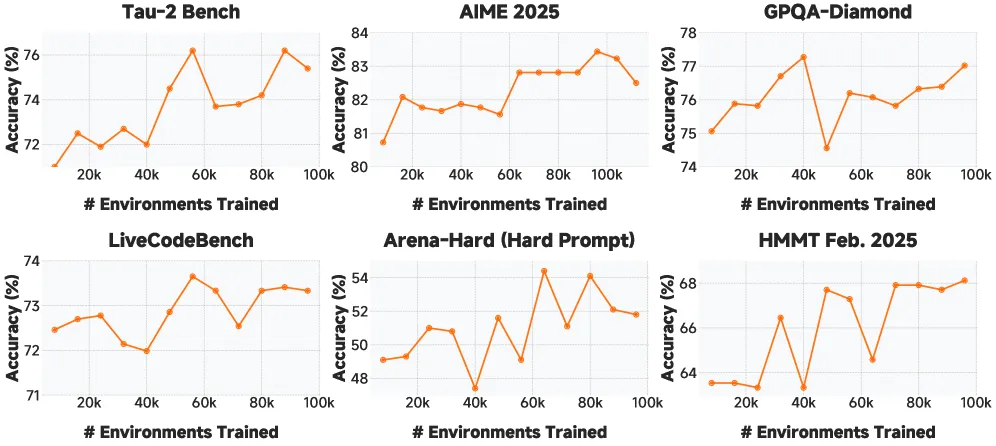
- 关键发现:扩大代码 agentic RL 算力(约 120K 环境)不仅提升 SWE-Bench,还泛化到数学、代码、通用推理(Figure 4/5)。
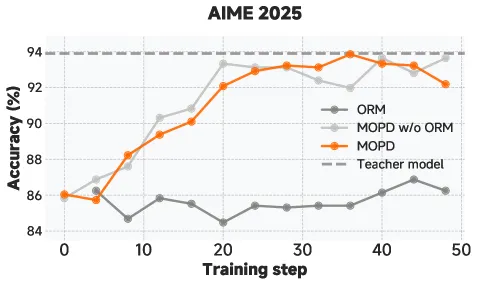
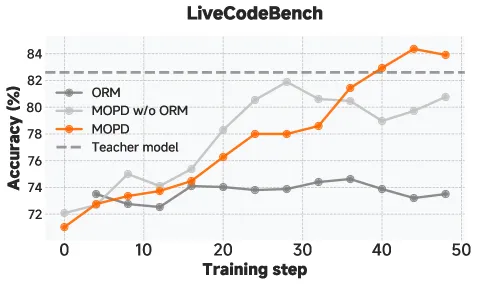
5.5 MOPD 效果(Figure 6)
在 AIME 2025 与 LiveCodeBench 上对比三条曲线:ORM RL、MOPD w/o ORM、MOPD。MOPD 成功保留并融合多教师专门能力,大多数域达到或超过最强教师。
5.6 RL 基础设施(§4.6)
- 推理引擎 SGLang + 训练引擎 Megatron-LM,训练/推理均 FP8。
- Rollout Routing Replay (R3):用 rollout 时的相同路由专家做 RL 训练,解决 MoE 因数值精度导致的 rollout/训练路由不一致;多轮 agent 用 request-level prefix cache 缓存 KV 与路由专家,保证采样一致性。
- Data Scheduler:细粒度序列调度替代 micro-batch,含 partial rollout + staleness-aware truncated importance sampling。
- Toolbox + Tool Manager:基于 Ray 的中心化资源分配(配额/QPS)、环境预热、序列级异步奖励、超时恢复。
六、实验结果
6.1 Base 模型(§3.3)
- 通用基准与 Kimi-K2-Base、DeepSeek-V3.2-Exp-Base 竞争,推理类(MMLU-Pro / GPQA-Diamond / AIME)持续领先。
- SWE-Bench 上以不到 1/3 参数超过更大的 Kimi-K2-Base。
- 受参数量限制,SimpleQA 反映的知识容量弱于更大模型。
6.2 指令模型(§4.5,Table 9)
| 基准 | MiMo-V2-Flash |
|---|---|
| SWE-Bench Verified | 73.4%(开源第一,逼近 GPT-5-High) |
| SWE-Bench Multilingual | 71.7%(开源最强软工模型) |
| BrowseComp | 45.4 → 58.3(配合 Appendix C context management) |
| τ²-Bench(DeepSeek-V3.2 作 user agent) | Telecom 95.3 / Retail 79.5 / Airline 66.0 |
- 多数推理基准与 Kimi-K2-Thinking、DeepSeek-V3.2-Thinking 相当。
- 长上下文(LongBench V2、MRCR)超过更大的全局注意力模型 Kimi-K2-Thinking,印证 hybrid SWA 的长上下文鲁棒性。
6.3 MTP 加速(§5)
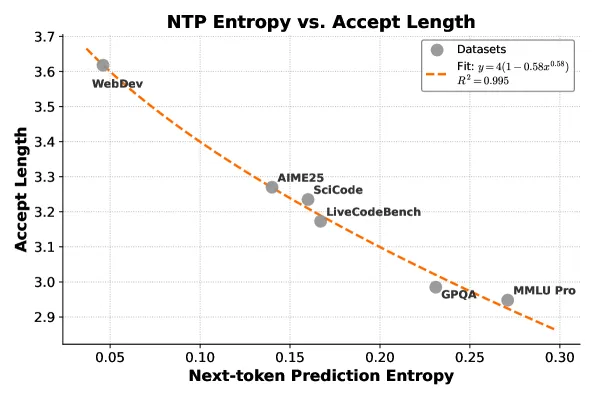
- 接受长度 vs 下一 token 交叉熵呈强反相关:低熵任务(WebDev)接受长度约 3.6,高熵任务(MMLU Pro)较短。拟合 ,。
- 3 层 MTP 在 16K 输入 / 1K 输出下解码提速最高 2.6×,speedup 随接受长度线性增长(Table 10)。
七、核心创新
| 创新点 | 描述 |
|---|---|
| Hybrid SWA + 可学习 attention sink | 5:1、W=128 激进配置下仍匹敌/超过全局注意力,长上下文 KV/算力近 6× 缩减 |
| 小窗口反直觉优势 | W=128 优于 W=512 与 All-GA:局部/全局分工更清晰 + 正则化效应 |
| 轻量 MTP(0.33B/块) | dense FFN + SWA,兼作自投机 draft,且加速小批量 on-policy RL |
| MOPD 后训练范式 | 多领域 RL 教师 token 级 KL 稠密奖励 + ORM,on-policy 融合多专家避免跷跷板效应 |
| 教师-学生协同进化 | 学生可回炉产更强教师,形成自增强循环 |
| RL 基础设施 R3 | Rollout Routing Replay 解决 MoE 路由 rollout/训练不一致 |
八、相关工作 / 附录亮点
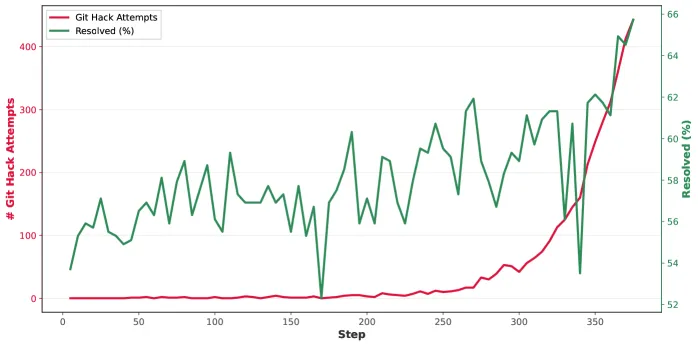
- Appendix B — SWE-Bench reward hacking:官方镜像存在 ground-truth commit 未删的 bug,RL 训练中模型会「偷看未来 commit」刷奖励(Figure 8,Qwen3-32B 上以
git log --all等关键词计数量化)。修复方式:更新到最新 SWE-Bench 镜像 + 遵循官方 git hacking 解决方案。 - 架构谱系:Transformer / MoE (Shazeer) / hybrid attention (Gemma2, MiniMax, Qwen3-Next) / attention sink (gpt-oss)。
- MTP:Gloeckle, DeepSeek-V3, MiMo-7B。MOPD:MiniLLM、on-policy distillation、IcePop、GRPO。
九、总结
核心贡献
- 用 hybrid SWA + attention sink 实现「又快又强」的长上下文 MoE,KV/算力近 6× 缩减且长上下文超越更大全局注意力模型。
- 提出 MOPD 后训练范式,多教师 token 级稠密奖励 on-policy 蒸馏,破解能力跷跷板与学习低效。
- 轻量 MTP 兼作训练加速与自投机解码(2.6× 提速),开源含 3 层 MTP 权重。
技术影响
- 为「小参数量比肩大模型」提供了架构 + 后训练 + 推理三位一体的开源配方。
- MOPD 的多教师协同进化思路对通用 post-training 有借鉴价值。
局限性
- 与最强闭源模型仍有明显差距(拟通过扩规模/算力缩小)。
- 架构探索仍属初步,设计权衡分析有限。
- 受参数量限制,知识容量(SimpleQA)弱于更大模型。
十、参考资源
- arXiv 论文:https://arxiv.org/abs/2601.02780
- 代码/权重:https://github.com/XiaomiMiMo/MiMo-V2-Flash
- 图片索引:
figures/2601.02780-mimo-v2-flash/README.md