Tarragon: Making MoE-based LLM Inference Resilient with Tarragon
面向MoE模型的弹性推理框架,将故障影响限制在单个worker级别,实现160-213×的停顿减少
Tarragon: Making MoE-based LLM Inference Resilient with Tarragon
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Making MoE-based LLM Inference Resilient with Tarragon |
| 作者 | Songyu Zhang, Aaron Tam, Myungjin Lee, Shixiong Qi, K. K. Ramakrishnan |
| 机构 | 未明确标注 |
| 论文 | arXiv:2601.01310 |
| 发布 | 2026-01-04 (v1), 2026-01-06 (v2) |
| 领域 | 分布式、并行和集群计算 (cs.DC) |
二、核心思想
问题定义
MoE模型在大规模部署时面临严重的故障韧性问题:
- 故障频发:随着部署规模增大,故障变得常见
- 粗粒度故障域:现有系统中,单个worker故障会触发整个服务重启
- 进度丢失:重启会丢弃已积累的进度,阻塞整个推理流水线
- 延迟敏感:对于延迟敏感的LLM服务,这种重启方式完全不适用
核心发现
现有系统的问题:
- 单个worker故障会导致64秒的停顿
- 所有参与的worker必须重启或等待
- 用户可见的中断严重影响服务质量
Tarragon的解决方案:
- 将故障影响限制在单个worker级别
- 其余流水线可继续前进
- 故障停顿减少160-213×(从~64秒降至0.3-0.4秒)
解决方案概述
Tarragon 是一个弹性MoE推理框架,通过以下创新实现细粒度故障隔离:
- 可重配置数据通路:将故障域从服务级缩小到worker级
- 自愈机制:放松现有MoE框架的紧密同步执行
- 异步KV缓存检查点:对有状态的AW进行增量检查点
- 影子专家:利用GPU剩余内存部署影子专家,实现快速恢复
三、技术架构
MoE推理架构
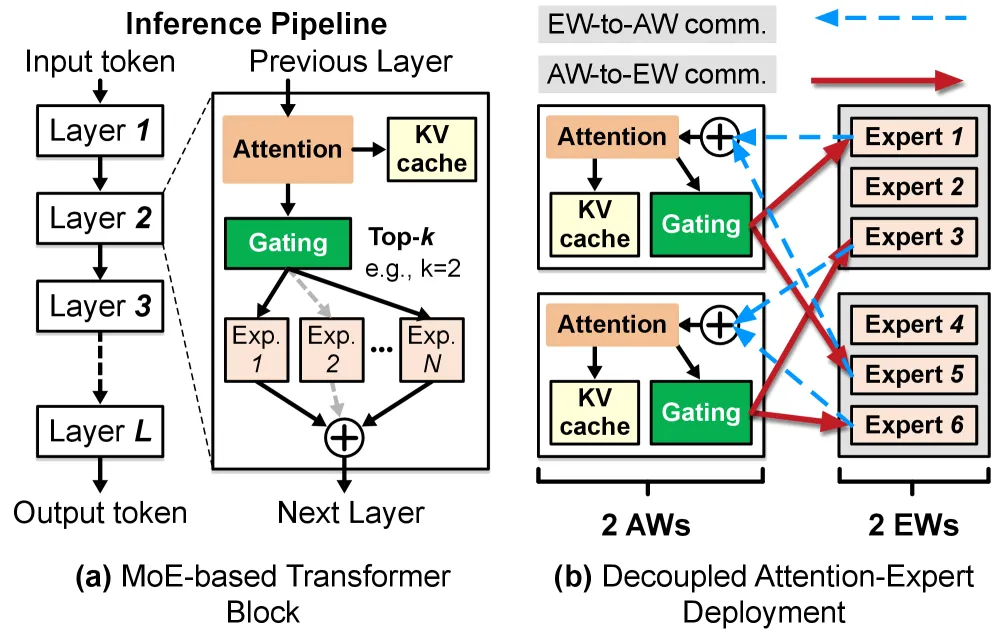
MoE推理流水线:
- 每个Transformer层包含自注意力和FFN(专家)
- 门控网络选择top-k专家处理每个token
- 解耦的注意力-专家部署:AW(注意力worker)和EW(专家worker)
层级同步执行
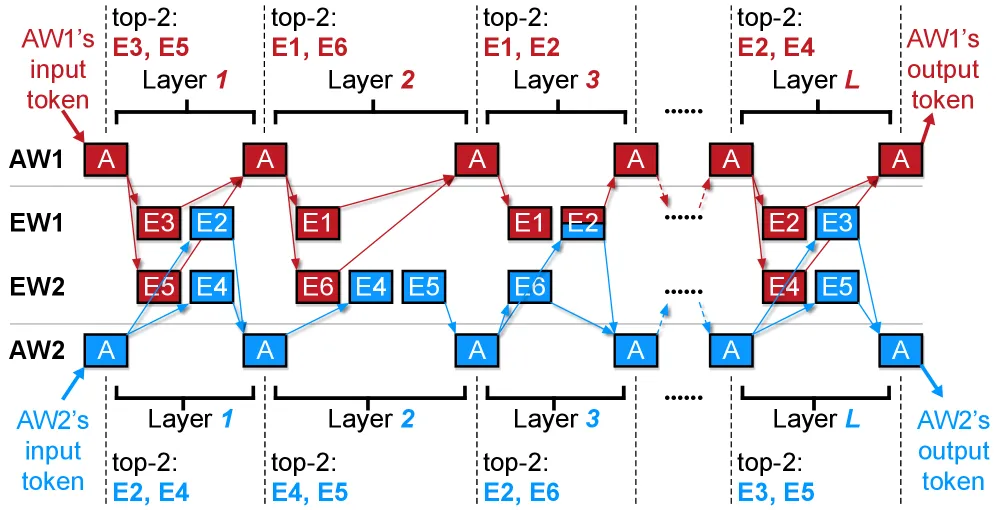
同步机制:
- MoE推理在层与层之间严格同步
- AW完成注意力计算后,将token发送给EW
- EW完成专家计算后,将结果返回给AW
- 每层都需要同步屏障
粗粒度故障恢复
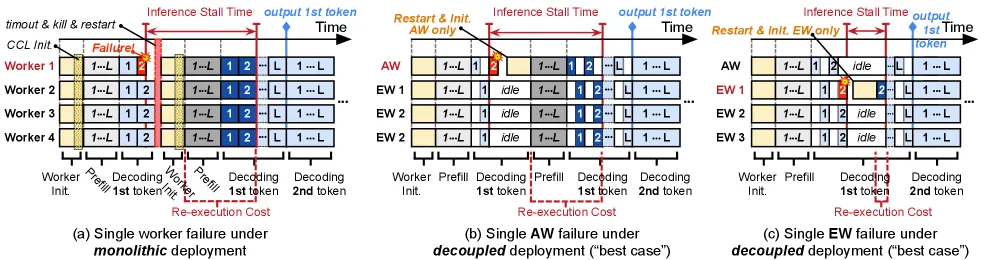
现有系统的问题:
- 单个worker故障导致所有worker重启
- 重启时间:(worker重启)+ (预填充)+ (解码)
- 用户可见的停顿时间长达64秒
停顿分析
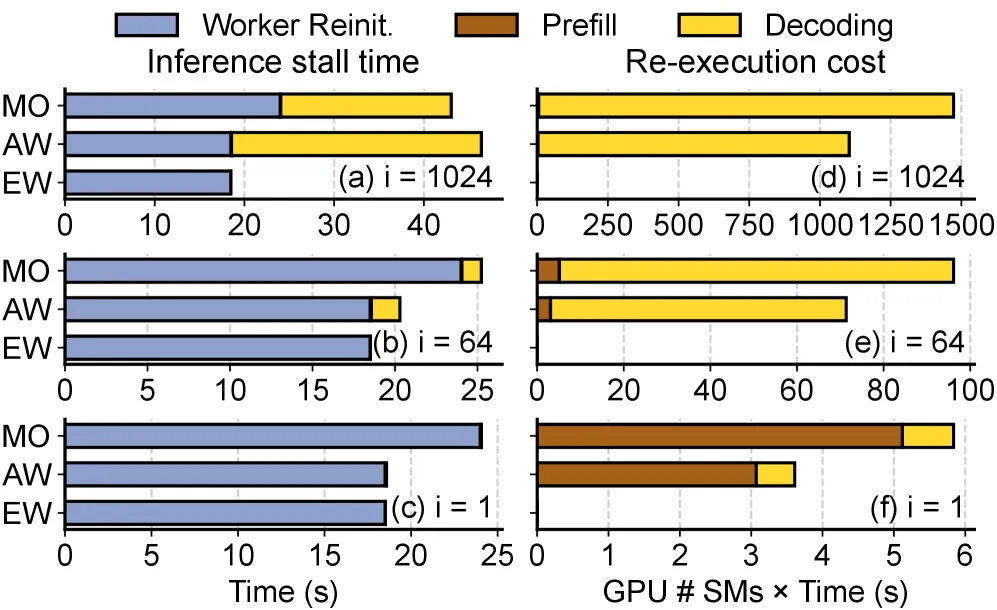
关键发现:
- 不同部署模式下,单个worker故障都会导致大规模停顿
- 重新执行成本高昂
- 需要细粒度的故障域隔离
Tarragon架构总览
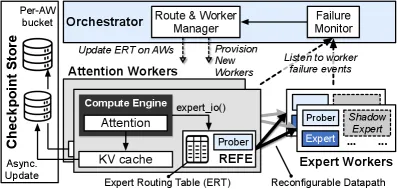
架构组件:
- 注意力Worker (AW):托管注意力模块,管理KV缓存
- 专家Worker (EW):托管活跃专家和影子专家
- REFE(可重配置转发引擎):实现可重配置的AW-EW数据通路
- 编排器:监控worker存活性,管理配置更新
- 检查点存储:存储KV缓存检查点
可重配置数据通路
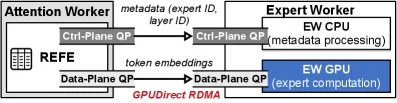
关键设计:
- 控制元数据与高容量tensor传输分离
- REFE在故障检测时动态重路由请求到健康的EW
- 使用RDMA的可靠连接(RC)实现可靠交付
REFE工作原理:
- 暴露简单API:
expert_io(expert_id, layer_id, token_embeddings) - 非阻塞、事件驱动的执行循环
- 维护专家路由表(ERT)实现动态重路由
新Worker配置
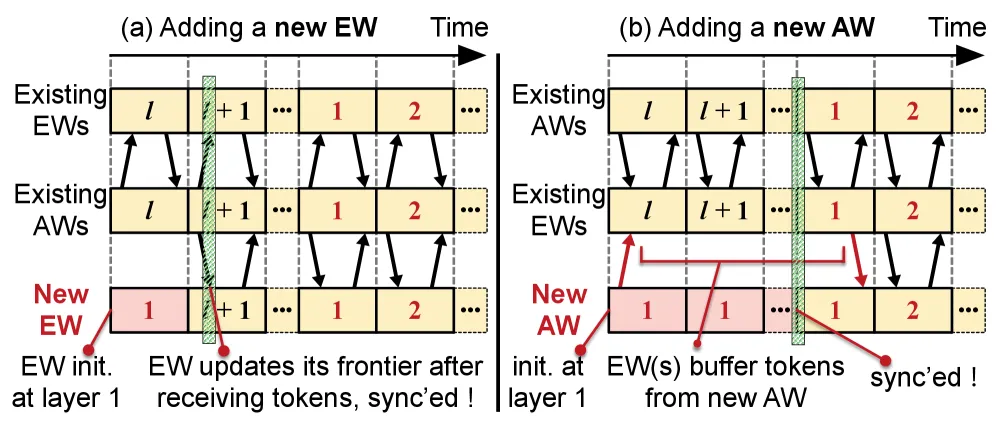
新EW配置:
- 新EW加入集群
- 从检查点存储获取KV缓存
- 从健康的EW获取缺失的token
- 逐步追赶到当前层
新AW配置:
- 新AW加入集群
- 从检查点存储恢复KV缓存
- 从健康的AW获取缺失的token
- 逐步追赶到当前层
KV缓存检查点
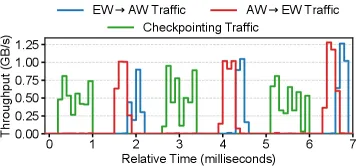
增量检查点机制:
- AW完成每层计算后,异步写入KV缓存到检查点存储
- 使用RDMA单侧写入,不阻塞计算
- 按请求粒度存储,支持细粒度恢复
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 可重配置数据通路 | 将故障域从服务级缩小到worker级 | 动态重路由机制 |
| 自愈机制 | 放松紧密同步,允许部分输入计算 | 双向故障容忍 |
| 异步KV缓存检查点 | 增量、异步、按请求粒度 | RDMA单侧写入 |
| 影子专家 | 利用GPU剩余内存预加载备份专家 | 快速故障切换 |
| 渐进式Worker配置 | 新worker逐步追赶,不中断现有进度 | 最小化配置开销 |
五、实验结果
实验设置
测试平台:
- Google Cloud A3 Ultra节点
- 每节点:224 vCPUs, 3 TB RAM, 8×H200 GPU (141 GB)
- 400 Gbps ConnectX-7 RDMA NICs
- GPUDirect RDMA和NVLink (3.6 Tbps)
模型:
- Mixtral-8×7B:32层MoE Transformer,每层8个专家,top-2选择
工作负载:
- ShareGPT:真实异构输入长度,测试预填充和解码
- Random:固定长度(10输入token,128生成token),强调解码
基线:
- MegaScale-Infer:解耦设计,8 AW + 8 EW
- vLLM-TP:张量并行度16
- vLLM-PP:16阶段流水线
端到端故障切换行为
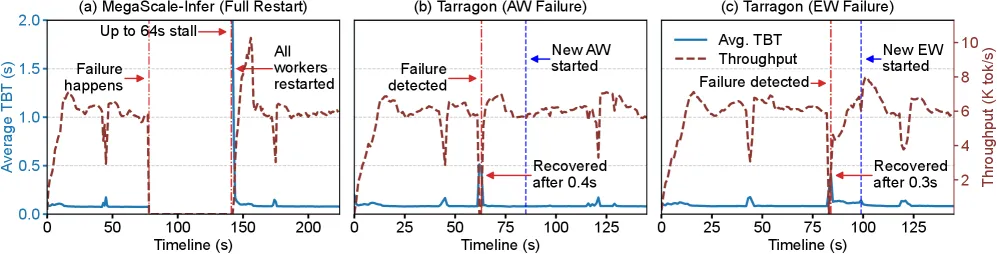
MegaScale-Infer结果:
- 故障注入后(78秒),吞吐量立即降至0
- 系统杀死并重启所有worker
- 恢复时间长,用户可见中断严重
Tarragon结果:
- AW故障:TBT短暂上升后快速恢复,吞吐量影响最小
- EW故障:TBT短暂上升后快速恢复,吞吐量影响最小
- 恢复时间:0.3-0.4秒(vs MegaScale-Infer的~64秒)
关键指标:
- 故障停顿减少:160-213×
稳态性能开销
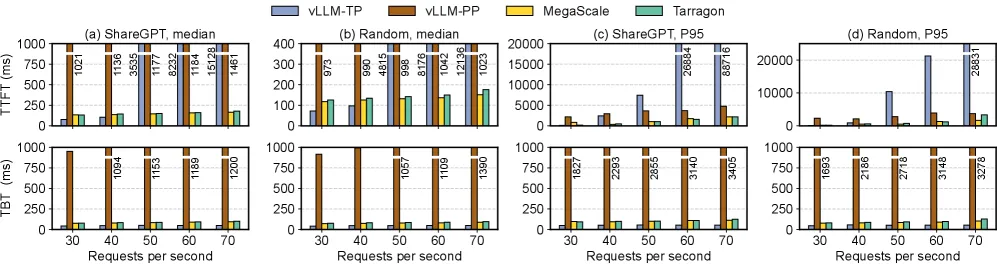
TTFT(首token延迟):
- Tarragon与基线相当
- 在不同负载下(30-70 RPS)表现稳定
TBT(token间延迟):
- Tarragon与基线相当
- P95延迟略有增加,但可接受
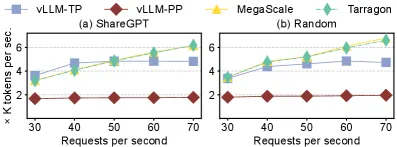
吞吐量:
- Tarragon在无故障时与基线性能相当
- 故障韧性带来的开销极小
KV缓存检查点效率
增量检查点机制:
- 异步写入,不阻塞计算
- 按请求粒度存储
- 恢复时间极低
影子专家效果
影子专家机制:
- 利用GPU剩余内存预加载备份专家
- 故障时可快速切换,无需重新加载
- 恢复时间从数百毫秒降至毫秒级
六、相关工作
| 方法 | 特点 | Tarragon优势 |
|---|---|---|
| MegaScale-Infer | 解耦AW-EW部署 | 无细粒度故障恢复 |
| vLLM | 单体/流水线部署 | 故障域更大 |
| SpotServe | 云实例抢占适应 | 不处理突发故障 |
| Mooncake | 分布式KV缓存 | 无worker级故障切换 |
| 训练容错 | 检查点/冗余计算 | 推理需要更严格延迟 |
七、总结
核心贡献
- 可重配置数据通路:将故障域从服务级缩小到worker级
- 双向自愈机制:AW和EW相互容忍对方故障
- 异步KV缓存检查点:增量、异步、按请求粒度
- 影子专家:利用GPU剩余内存实现快速故障切换
- 显著性能提升:故障停顿减少160-213×,稳态开销极小
技术影响
- 为MoE模型大规模部署提供了实用的故障韧性方案
- 将故障域从服务级缩小到worker级,显著提高可用性
- 适用于延迟敏感的LLM服务
- 可与其他优化技术(如量化、蒸馏)正交使用
局限性
- 主要针对硬件/软件崩溃,不处理网络分区
- 影子专家需要额外GPU内存
- 检查点存储需要额外硬件资源
- 未探索与其他故障恢复技术的结合
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | MoE推理架构 | figure1-moe-architecture.png |
| Figure 2 | 层级同步执行 | figure2-layer-sync.png |
| Figure 3 | 粗粒度故障恢复 | figure3-failure-recovery.png |
| Figure 4 | 停顿分析 | figure4-stall-analysis.png |
| Figure 5 | Tarragon架构总览 | figure5-tarragon-overview.png |
| Figure 6 | 可重配置数据通路 | figure6-datapath.png |
| Figure 7 | 新Worker配置 | figure7-provisioning.png |
| Figure 8 | KV缓存检查点 | figure8-checkpointing.png |
| Figure 9 | 端到端故障切换 | figure9-failover.png |
| Figure 10 | 延迟开销 | figure10-latency-cost.png |
| Figure 11 | 吞吐量 | figure11-throughput.png |