YOLO-Master: MOE-Accelerated with Specialized Transformers for Enhanced Real-time Detection
基于稀疏混合专家的自适应计算实时目标检测框架,通过动态路由实现按场景复杂度分配计算资源。
YOLO-Master: MOE-Accelerated with Specialized Transformers for Enhanced Real-time Detection
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | YOLO-Master: MOE-Accelerated with Specialized Transformers for Enhanced Real-time Detection |
| 作者 | Xu Lin, Jinlong Peng, Zhenye Gan, Jiawen Zhu, Jun Liu |
| 机构 | - |
| 论文 | arXiv:2512.23273 |
| 代码 | 未开源 |
| 发布 | 2025年12月 |
| 领域 | Computer Vision and Pattern Recognition (cs.CV) |
二、核心思想
问题定义
现有实时目标检测(RTOD)方法普遍采用YOLO架构,在精度和速度之间取得良好平衡。然而,这些模型依赖静态密集计算——对所有输入施加均匀处理,导致:
- 简单场景过度分配:对简单图像浪费计算资源
- 复杂场景分配不足:对复杂密集场景缺乏足够的表征能力
- 计算冗余:统一处理造成计算资源浪费
解决方案概述
本文提出YOLO-Master,一种引入实例条件自适应计算的YOLO框架,核心是高效稀疏混合专家(ES-MoE)模块:
- 动态计算分配:根据场景复杂度动态激活不同数量的专家
- 多样化感受野:不同专家采用不同卷积核大小(3×3, 5×5, 7×7),捕获多尺度特征
- 分阶段路由:训练时使用Soft Top-K保持梯度流,推理时切换Hard Top-K实现真正稀疏
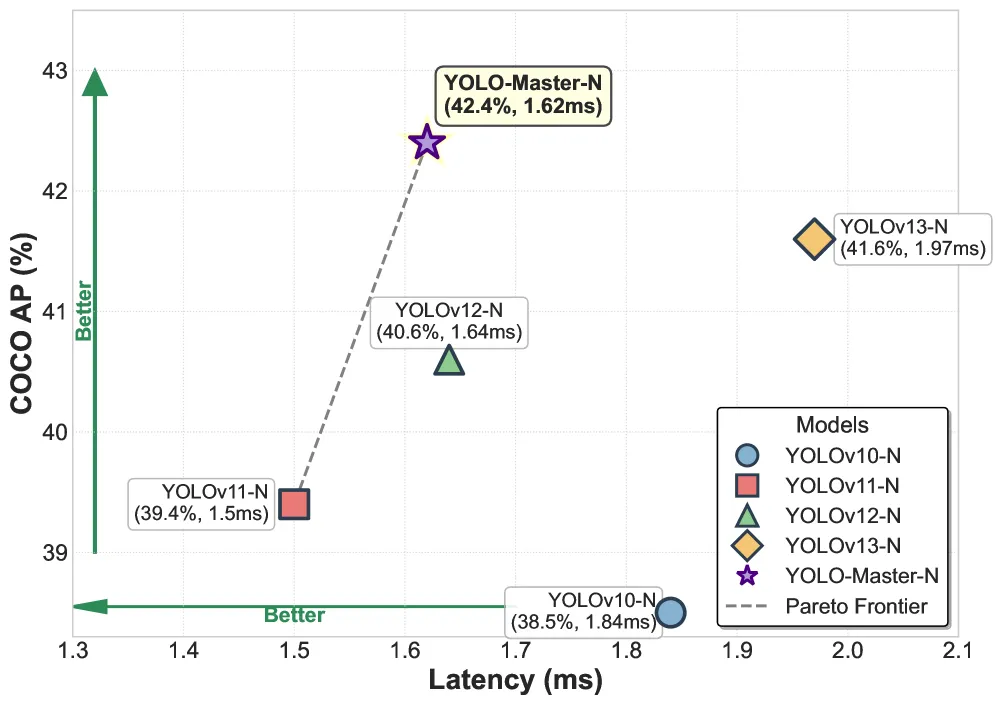
Figure 1: MS COCO上精度-延迟权衡。YOLO-Master-N以1.62ms延迟达到42.4% AP,在Pareto前沿上超越基线。
核心结果:
- MS COCO:42.4% AP,1.62ms延迟
- 比YOLOv13-N高+0.8% mAP,推理速度快17.8%
- 在密集场景(VisDrone +2.1%,KITTI +1.5%)增益最显著
三、技术架构
整体框架
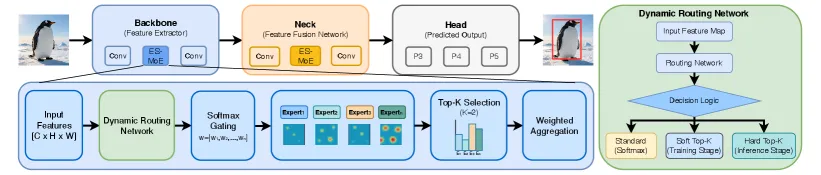
Figure 2: YOLO-Master框架。ES-MoE模块集成到Backbone和Neck中,输入特征通过动态路由网络和Softmax门控选择Top-K专家进行加权聚合。
架构设计:
- 遵循标准YOLO设计:Backbone + Neck + Detection Head
- ES-MoE插入位置:仅Backbone(实验发现Backbone+Neck反而性能下降)
- 默认配置:4个专家,Top-2激活
ES-MoE模块
门控权重计算
给定输入特征图 ,门控权重通过Softmax计算:
其中 是第 个专家的门控函数。
加权聚合
选择Top-K专家后,输出通过加权聚合得到:
其中 是Top-K专家索引集合。
专家架构
每个专家采用**深度可分离卷积(DWconv)**以降低计算开销:
多样化感受野设计:不同专家使用不同卷积核大小 ,覆盖不同空间范围的上下文信息。
动态路由网络
门控网络设计
-
全局信息聚合:使用全局平均池化(GAP)压缩输入
-
轻量级Logits计算:两层1×1卷积(),通道缩减比
分阶段路由策略
Soft Top-K(训练模式)
保持梯度流,构造二值掩码 后重归一化:
Hard Top-K(推理模式)
直接选择Top-K logits,严格置零其余专家权重:
动态切换
损失函数
总损失由检测损失和负载均衡损失组成:
检测损失(遵循YOLOv8标准):
负载均衡损失(防止专家坍缩):
其中 是专家 的平均利用率。实验发现移除DFL损失、仅使用MoE损失()效果最佳(62.2% mAP)。
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| ES-MoE模块 | 高效稀疏MoE,动态计算分配 | +1.3% mAP over baseline |
| 分阶段路由 | 训练Soft Top-K,推理Hard Top-K | 保持梯度流+真正稀疏 |
| 多样化感受野 | 不同专家不同卷积核大小 | 多尺度特征捕获 |
| 轻量级门控 | GAP+两层1×1卷积, | 路由开销可忽略 |
| 仅Backbone集成 | 避免级联路由的梯度干扰 | Backbone: 62.1%, Both: 54.9% |
五、实验结果
基准测试结果
Nano尺度检测(Table 1)
| 方法 | COCO mAP | VOC mAP | VisDrone mAP | KITTI mAP | SKU-110K mAP | 延迟 |
|---|---|---|---|---|---|---|
| YOLOv10-N | 38.5 | 60.6 | 18.7 | 66.0 | 57.4 | 1.84ms |
| YOLOv11-N | 39.4 | 61.0 | 18.5 | 67.8 | 57.4 | 1.50ms |
| YOLOv12-N | 40.6 | 60.7 | 18.3 | 67.6 | 57.4 | 1.64ms |
| YOLOv13-N | 41.6 | 60.7 | 17.5 | 67.7 | 57.5 | 1.97ms |
| YOLO-Master-N | 42.4 | 62.1 | 19.6 | 69.2 | 58.2 | 1.62ms |
Small尺度检测(Table 2)
| 模型 | Params (M) | GFLOPs | mAP |
|---|---|---|---|
| YOLOv11-S | 9.40 | 19.7 | 47.0 |
| YOLOv12-S | 9.13 | 19.7 | 48.0 |
| YOLOv13-S | 9.00 | 20.8 | 48.0 |
| YOLO-Master-S | 9.64 | 28.6 | 49.1 |
分类与分割性能
ImageNet分类(Table 3):
| 模型 | Top-1 | Top-5 |
|---|---|---|
| YOLOv11-cls-N | 70.0 | 89.4 |
| YOLOv12-cls-N | 71.7 | 90.5 |
| YOLO-Master-cls-N | 76.6 | 93.4 |
COCO分割(Table 4):
| 模型 | mAPbox | mAPmask |
|---|---|---|
| YOLOv11-seg-N | 38.9 | 32.0 |
| YOLOv12-seg-N | 39.9 | 32.8 |
| YOLO-Master-seg-N | 42.9 | 35.6 |
消融实验
ES-MoE放置位置(Table 5)
| 配置 | Params (M) | mAP (%) |
|---|---|---|
| Baseline(无ES-MoE) | 2.63 | 60.8 |
| 仅Neck | 2.49 | 58.2 |
| 仅Backbone | 2.66 | 62.1 |
| Backbone+Neck | 2.76 | 54.9 |
关键发现:Backbone+Neck全集成反而严重退化(-5.9%),原因是级联路由机制的梯度干扰。
专家数量(Table 6)
| 专家数 | Params (M) | mAP50 | mAP |
|---|---|---|---|
| 2 | 2.51 | 81.4 | 61.0 |
| 4 | 2.76 | 82.2 | 62.3 |
| 8 | 3.68 | 82.0 | 62.0 |
Top-K选择(Table 7)
| K | 稀疏度 | mAP50 | mAP |
|---|---|---|---|
| 1 | 75% | 81.1 | 61.3 |
| 2 | 50% | 81.9 | 61.8 |
| 3 | 25% | 81.6 | 61.8 |
| 4 | 0% | 81.6 | 61.9 |
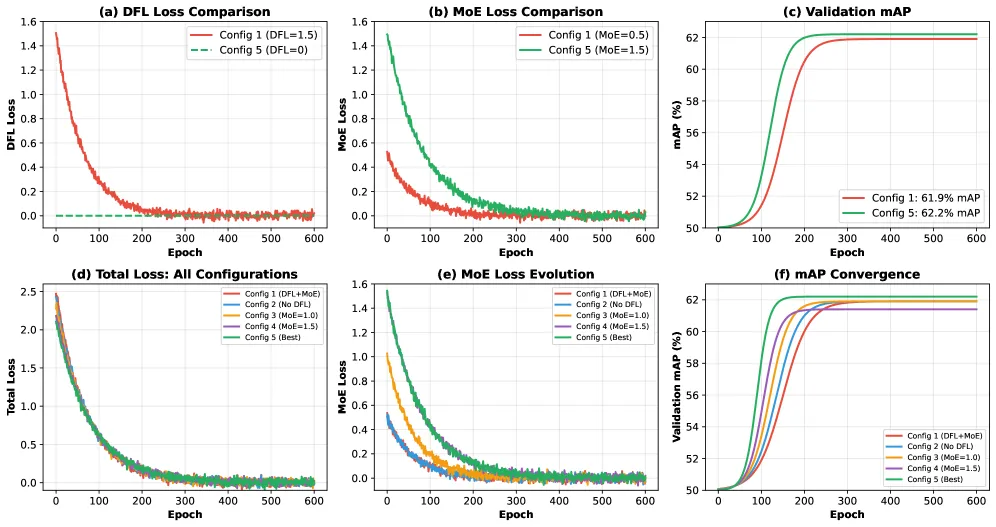
Figure 3: 损失消融研究。(a) DFL损失比较。(b) MoE损失比较。(c) 验证mAP。(d) 总损失。(e) MoE损失演化。(f) mAP收敛。
损失函数配置(Table 8)
| 配置 | DFL | MoE权重 | mAP |
|---|---|---|---|
| Config 1 | ✓ | 0.5 | 61.9 |
| Config 5(Ours) | ✗ | 1.5 | 62.2 |
定性分析
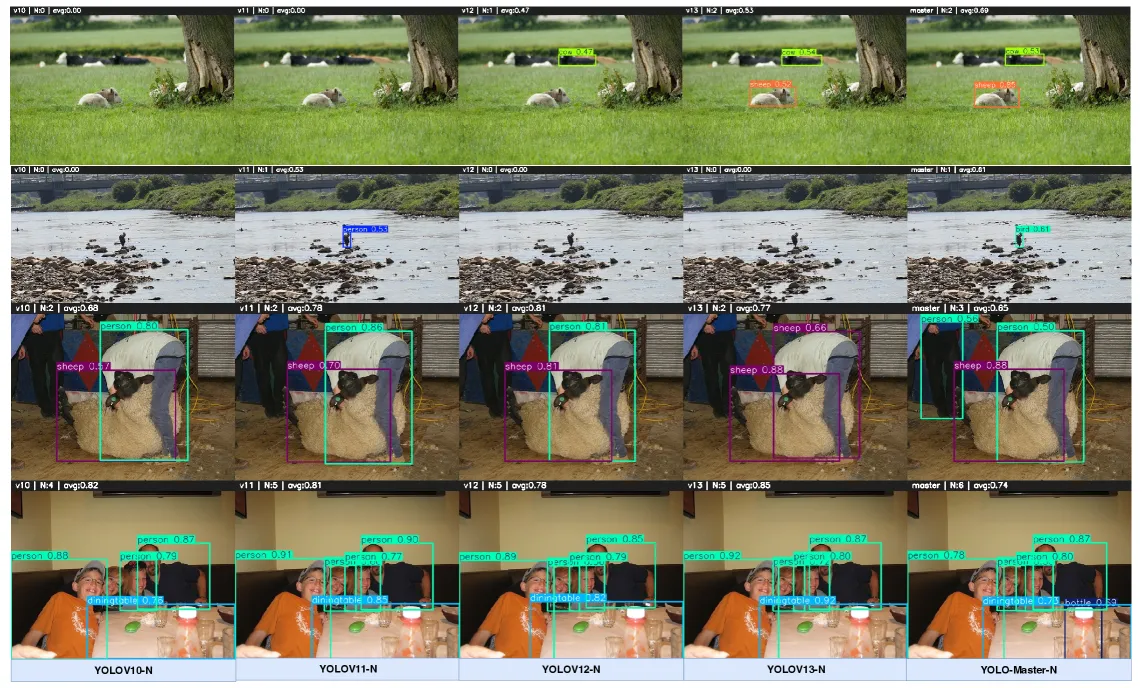
Figure 4: 四个挑战场景下的定性比较。YOLO-Master在密集小目标、遮挡、复杂背景等场景下表现更优。
六、相关工作
实时目标检测器
| 方法 | 特点 | 与本文关系 |
|---|---|---|
| YOLO系列 | Backbone+Neck+Head架构 | 本文基础架构 |
| YOLOv12 | 注意力机制增强 | 本文Baseline |
| YOLOv13 | 最新YOLO变体 | 主要对比对象 |
混合专家
| 方法 | 特点 | 与本文关系 |
|---|---|---|
| Switch Transformer | 稀疏MoE for NLP | 路由策略参考 |
| Vision MoE | 视觉MoE | 专家设计参考 |
| ES-MoE(本文) | 高效稀疏MoE for 检测 | 核心贡献 |
七、总结
核心贡献
- ES-MoE模块:提出高效稀疏混合专家模块,实现实例条件自适应计算
- 分阶段路由策略:训练Soft Top-K + 推理Hard Top-K,平衡梯度流和推理效率
- 多样化感受野专家:不同卷积核大小的专家,增强多尺度特征捕获
- SOTA性能:在5个基准测试上超越现有Nano尺度检测器
技术影响
- 自适应计算:为实时检测引入场景感知的动态计算分配
- 稀疏推理:仅激活2/4专家(50%稀疏度),实际加速推理
- 通用性:ES-MoE可扩展到分类、分割等视觉任务
局限性
- 代码未开源:目前无法复现
- 仅Nano/Small尺度:未验证更大模型的效果
- 训练开销:600 epochs训练周期较长
- GFLOPs增加:Small尺度GFLOPs从20.8增加到28.6(+37%)