RollArt: Scaling Agentic RL Training via Disaggregated Infrastructure
通过解耦基础设施实现 Agentic RL 训练的规模化扩展
RollArt: Scaling Agentic RL Training via Disaggregated Infrastructure
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | RollArt: Scaling Agentic RL Training via Disaggregated Infrastructure |
| 作者 | Wei Gao, Yuheng Zhao, Tianyuan Wu, Shaopan Xiong, Weixun Wang, Dakai An, Lunxi Cao, Dilxat Muhtar, Zichen Liu, Haizhou Zhao, Ju Huang, Siran Yang, Yongbin Li, Wenbo Su, Jiamang Wang, Lin Qu, Bo Zheng, Wei Wang |
| 机构 | HKUST, Alibaba Group, Tongyi Lab |
| 论文 | arXiv:2512.22560 |
| 代码 | GitHub - alibaba/ROLL |
| 发布 | 2025年12月 |
| 主题 | cs.DC, cs.LG |
二、核心思想
问题定义
Agentic Reinforcement Learning (RL) 使大语言模型 (LLM) 能够进行自主决策和长期规划。与标准 LLM 后训练不同,Agentic RL 工作负载高度异构,结合了计算密集的 prefill 阶段、带宽受限的 decoding 阶段以及有状态的 CPU 密集型环境模拟。
核心挑战: 高效的 Agentic RL 训练需要解耦基础设施以利用专用的、最适合的硬件。然而,朴素的解耦会因阶段间复杂依赖关系而引入大量同步开销和资源利用率低下。
核心观察
- 工作负载异构性: LLM 生成包含两个具有相反资源需求的阶段——计算密集的 prefill 阶段和内存带宽受限的 decoding 阶段
- 环境长尾延迟: 环境初始化 (env.reset) 和执行 (env.step) 存在极端长尾分布,延迟可达数百秒
- 奖励计算无状态性: 奖励计算是无状态的,适合 serverless 部署以提高资源利用率
解决方案概述
RollArt 是一个分布式系统,旨在最大化多任务 Agentic RL 在解耦基础设施上的吞吐量。基于三个核心设计原则:
- 硬件亲和性工作负载映射 (Hardware-Affinity Workload Mapping): 将计算密集型和带宽受限型任务路由到最适合的 GPU 设备
- 细粒度异步执行 (Fine-grained Asynchrony): 在轨迹级别管理执行,缓解资源空泡
- 状态感知计算 (Statefulness-aware Computation): 将无状态组件(如奖励模型)卸载到 serverless 基础设施以实现弹性扩展
核心性能
| 指标 | 数值 |
|---|---|
| 端到端训练加速 | 1.35-2.05× vs 单体同步基线 |
| 吞吐量提升 | 2.65-4.58× vs 同步基线 |
| 生产规模 | 3000+ GPU 集群,持续运行一周 |
| 代码规模 | ~60k 行 Python 代码 |
| 模型规模 | 百亿参数 MoE 模型 (Qoder) |
三、技术架构
整体框架
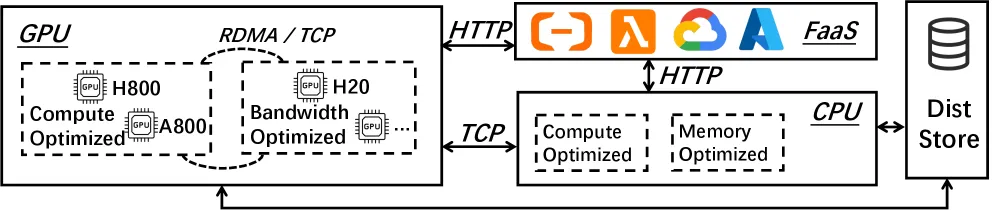
Figure 1: Agentic RL 训练的解耦基础设施。训练集群使用高端计算优化 GPU (H800);推理集群利用带宽优化硬件 (H20);CPU 集群提供弹性容量;serverless 基础设施处理突发无状态工作负载。
同步 vs 异步训练
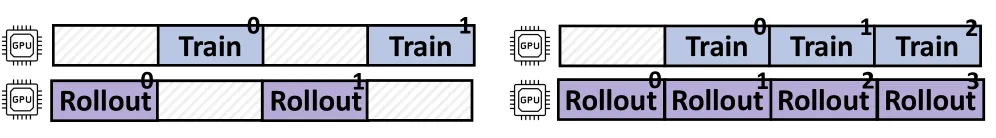
Figure 2: 同步训练存在”依赖空泡”,昂贵的 GPU 在高延迟权重同步和环境步骤期间空闲。异步训练通过并行执行 rollout 和训练来隐藏同步延迟。
核心公式
异步边界 (Asynchronous Bound)
在异步训练中,轨迹生成可能被中断并在更新的 agent LLM 下恢复。RollArt 引入异步边界 来调节每个轨迹的新鲜度:
违反此约束的轨迹将被中止。实验表明设置 可在训练速度和稳定性之间取得平衡。
GRPO 算法
使用 Group Relative Policy Optimization (GRPO) 进行训练:
- 训练批大小: 512
- 组大小: 8
- 所有任务均匀采样
训练步骤延迟分析
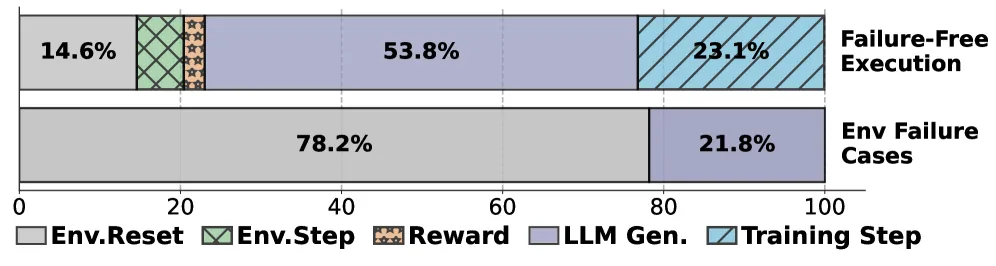
Figure 3: 训练步骤延迟分解:成功运行 (上,平均 365.7s) vs 环境故障执行 (下,平均 513.3s)。在故障场景中,env.reset 占 78% 的 rollout 时间。
硬件亲和性
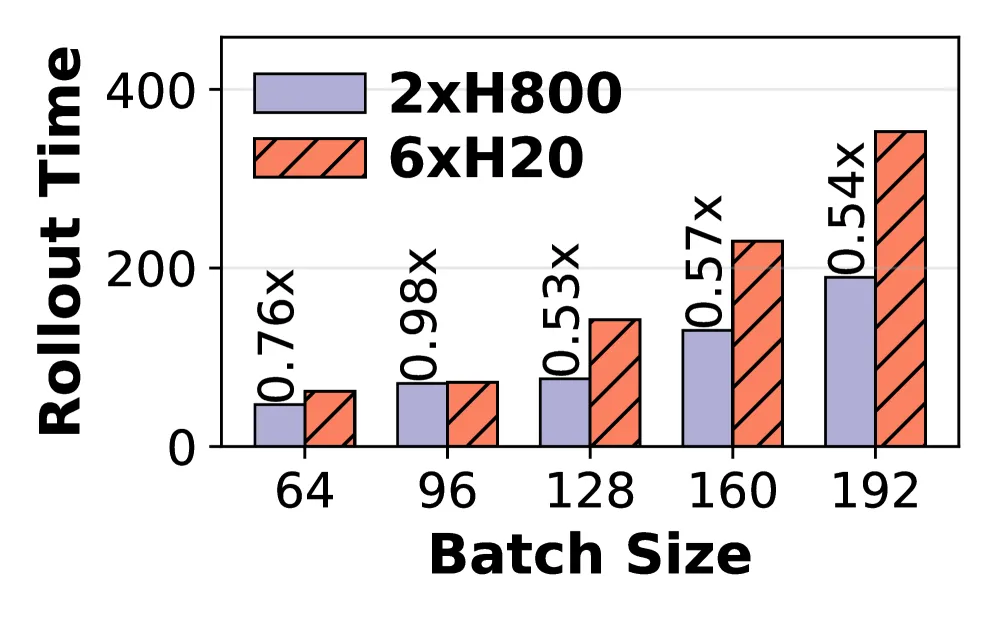
Figure 4: 不同任务在 H20 和 H800 GPU 上的端到端 rollout 时间。(a) FrozenLake [Prefill-Heavy]: H800 优于 H20。(b) GEM-Math [Decode-Heavy]: H20 优于 H800。
| GPU 规格 | H20 | H800 |
|---|---|---|
| TFLOPS | 148 | 989.5 |
| HBM 容量 | 96GB | 80GB |
| HBM 带宽 | 4TB/s | 3.35TB/s |
| NVLink 带宽 | 900GB/s | 400GB/s |
| 归一化成本 | 1.00 | 2.85 |
环境交互分析
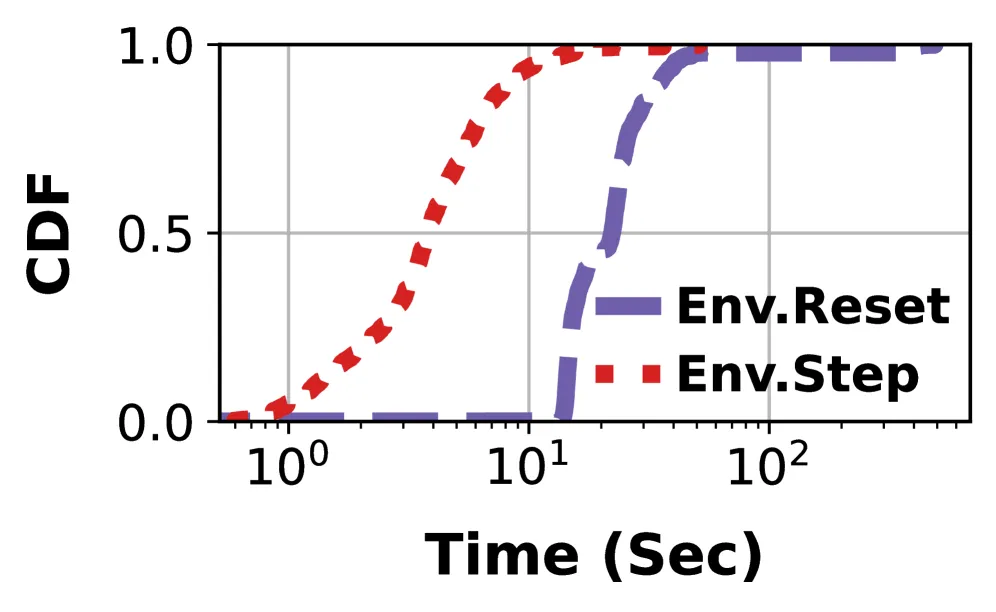
Figure 5: 环境交互分析:(a) env.reset 和 env.step 的累积分布函数(对数刻度)。(b) 长尾环境如何影响批量环境交互下的多轮 rollout。
奖励计算效率
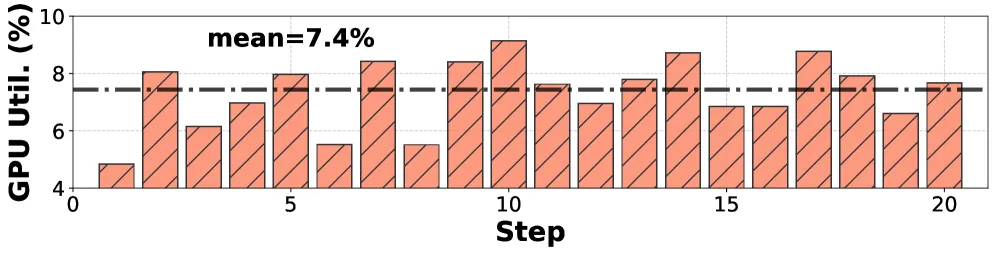
Figure 6: 专用本地 GPU 进行奖励计算时的低效资源使用。专用奖励 GPU 平均利用率仅 7.4%。
轨迹级 Rollout
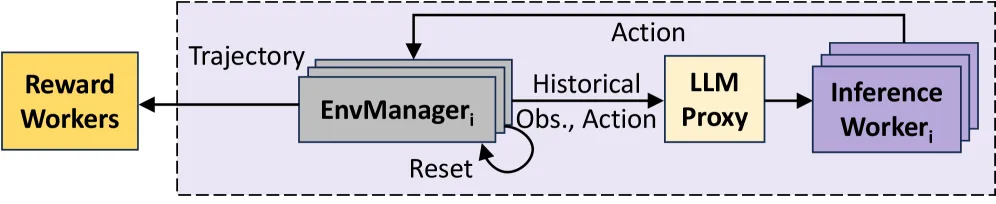
Figure 7: 轨迹级 Rollout 概览。LLMProxy 和 EnvManager 实现细粒度异步执行。
异步训练工作流
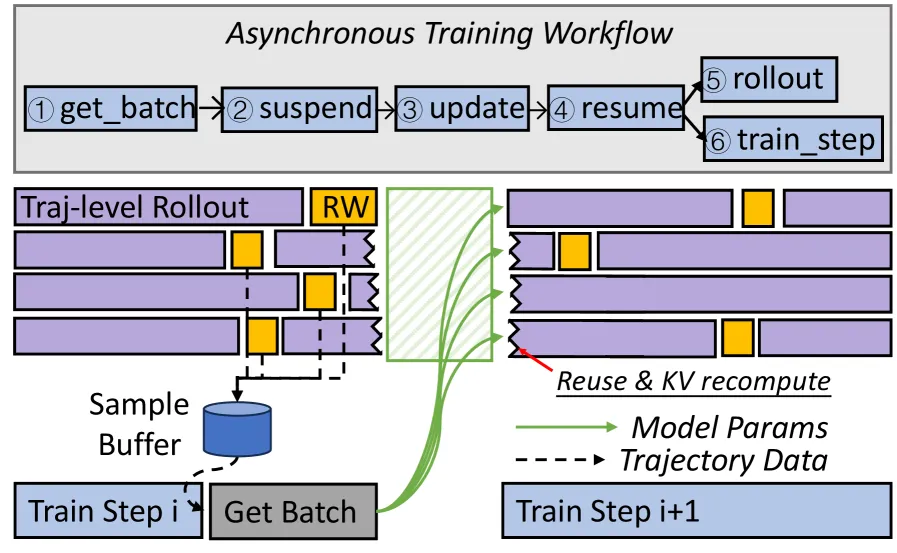
Figure 8: 异步训练工作流。多个 EnvManager 独立运行,持续生成轨迹并入队到 SampleBuffer。
系统架构
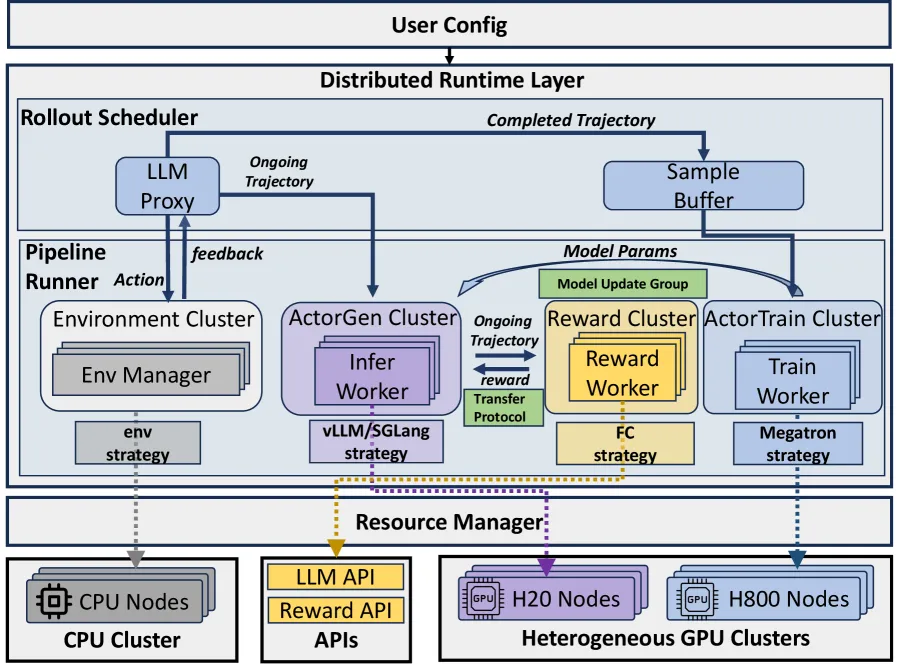
Figure 9: RollArt 系统架构,包括分布式运行时层和资源管理器。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 硬件亲和性映射 | 根据工作负载特性(prefill vs decode)路由到最适合的 GPU | 1.30-1.68× 步骤时间加速 |
| 轨迹级异步执行 | 在轨迹级别管理执行,避免长尾环境阻塞整个流水线 | 1.23-2.27× 性能提升 |
| 冗余环境 Rollout | 启动比严格要求更多的环境,容忍环境故障 | 最大 1.62× 加速 |
| 异步边界控制 | 调节轨迹新鲜度以平衡训练稳定性和吞吐量 | α=1 时效果最佳 |
| Reward-as-a-Service | 将无状态奖励计算卸载到 serverless 平台 | GPU 利用率从 6% 提升到 88% |
| 异步跨集群通信 | 使用 Mooncake 进行异步权重更新,隐藏通信开销 | 1.10-1.16× 步骤时间减少 |
五、实验结果
测试配置
| 配置 | 值 |
|---|---|
| 模型 | Qwen3 (8B-32B) |
| 最大上下文长度 | 32K tokens |
| 训练算法 | GRPO |
| 训练批大小 | 512 |
| 组大小 | 8 |
| 推理引擎 | vLLM 0.8.4 |
| 训练引擎 | Megatron v0.12.2 |
| 权重同步 | NCCL v2.26.5 (集群内), Mooncake v0.3.7 (跨集群) |
| 硬件 | H800 集群 (96 GPU) + H20 集群 (32 GPU) |
| 网络 | 集群内 400Gbps InfiniBand, 跨集群 200Gbps Ethernet |
端到端评估
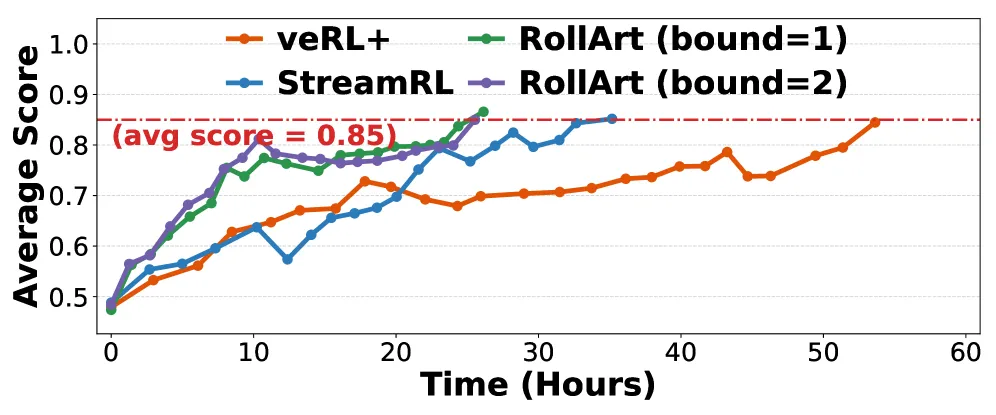
Figure 10: (a) Qwen3-32B 上的端到端 time-to-score;(b) 不同方法的归一化吞吐量;(c) Qwen3-14B 在不同 H800 GPU 数量下的归一化吞吐量。
| 方法 | 端到端加速 | 吞吐量提升 |
|---|---|---|
| veRL+ (基线) | 1.00× | 1.00× |
| StreamRL | 1.52× | 1.31-1.47× |
| RollArt (α=1) | 2.05× | 2.65-4.58× |
| RollArt (α=2) | 1.95× | - |
硬件亲和性分析
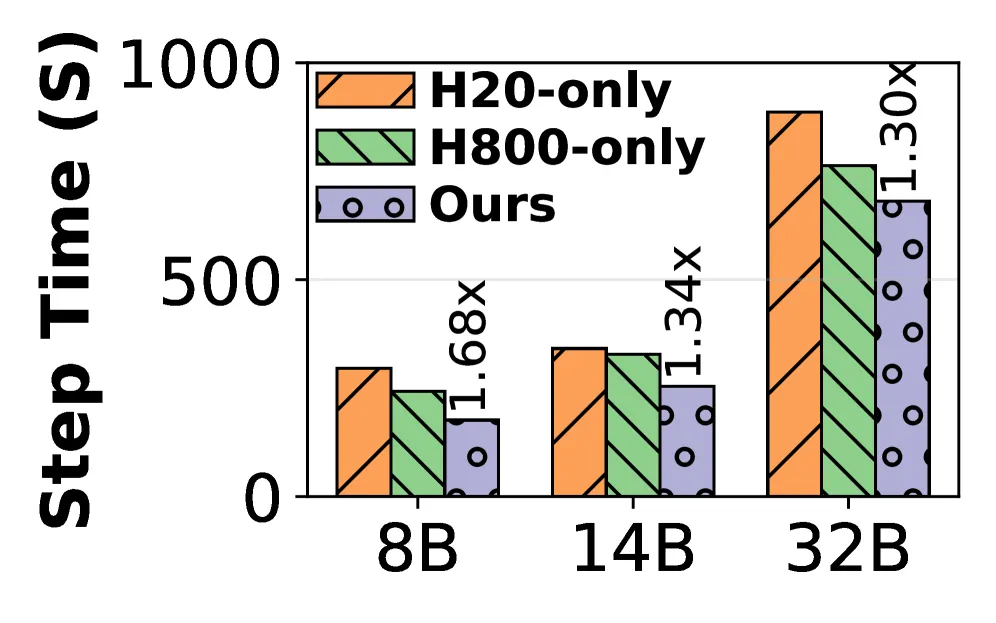
Figure 11: (a) 硬件亲和性的效率;(b) 异步跨集群通信的优势。
| 配置 | vs H20-only | vs H800-only |
|---|---|---|
| 亲和性感知 | 1.30-1.68× | 1.12-1.37× |
轨迹级异步分析
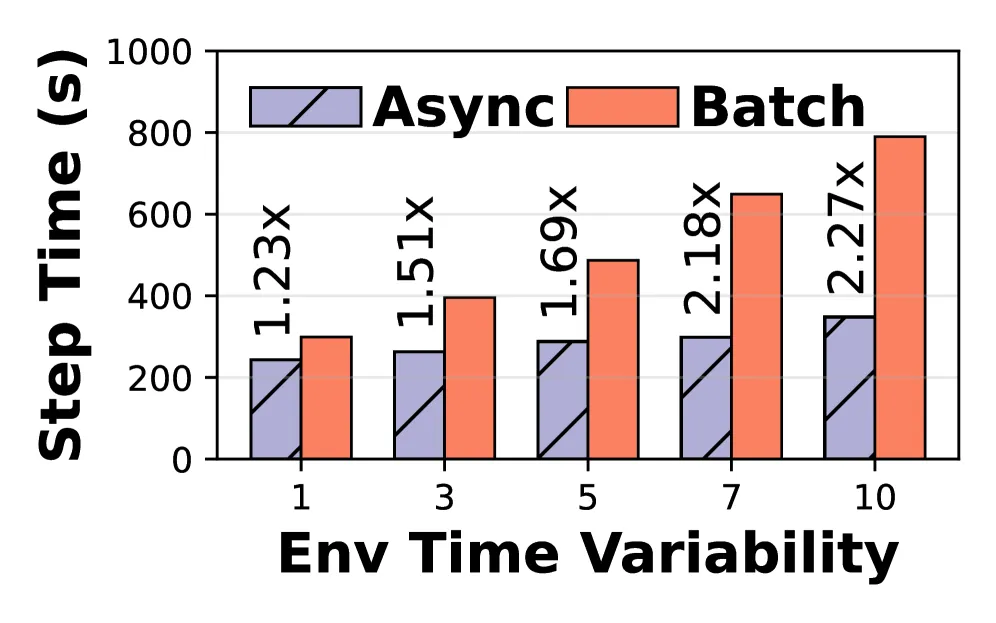
Figure 12: 轨迹级环境的优势:(a) 环境时间变异性下的性能;(b) 冗余环境 Rollout 的加速。
| 延迟方差 σ | 轨迹级 vs 批量级 |
|---|---|
| 1 | 1.23× |
| 10 | 2.27× |
异步边界影响
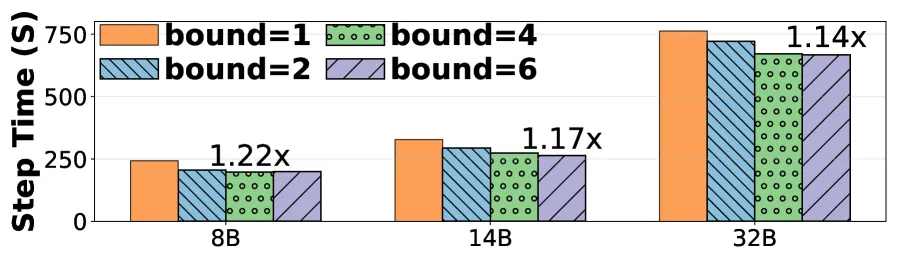
Figure 13: 不同异步边界下 LLM 的平均步骤时间比较。
Serverless 奖励收益
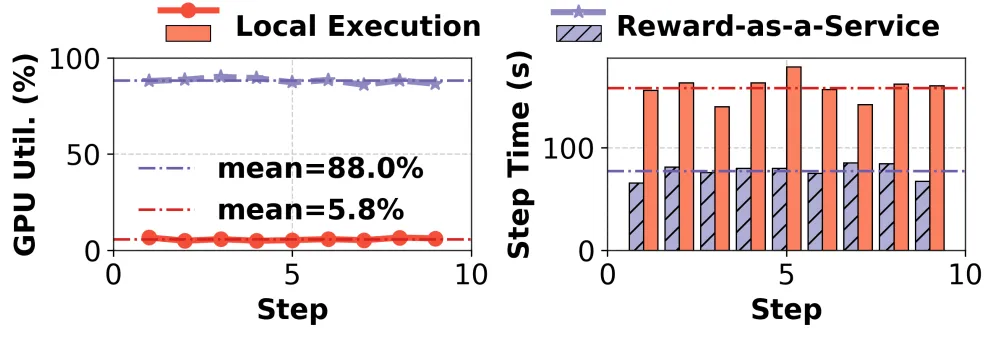
Figure 14: 专用本地 GPU vs Reward-as-a-Service 的比较。
| 指标 | 本地 GPU | Serverless |
|---|---|---|
| GPU 利用率 | 6% | 88% |
| 平均 Rollout 时间 | 158s | 77s |
六、生产部署
工作负载特征
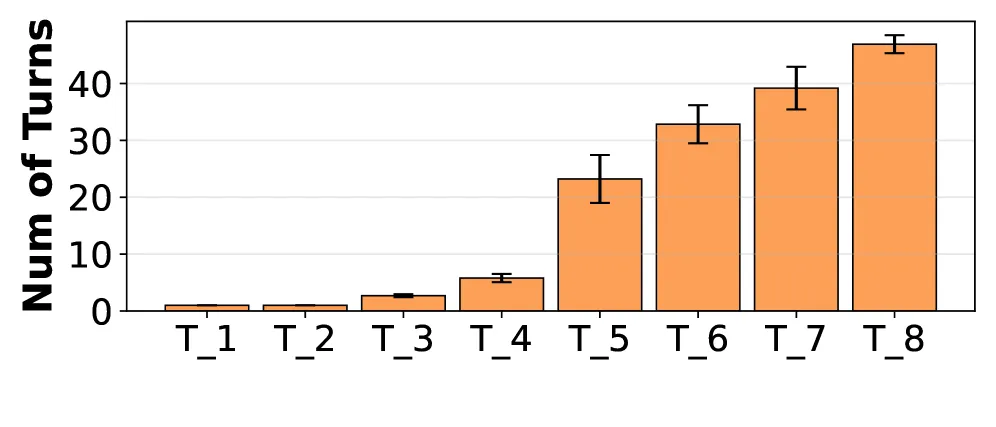
Figure 15: 生产级 Agentic RL 工作负载特征:(a) 每个任务的平均轮数;(b) 步骤时间分布;(c) 累积步骤时间。
- 模型: 百亿参数 MoE LLM (Qoder)
- 集群规模: 3000+ GPU
- 运行时间: 持续一周
- 训练:生成 GPU 比例: 1:5
- 异步边界: 1
- 最大迭代时间: 1.5 小时
环境稳定性优化
- 多层缓存架构:内部镜像注册表 + 分布式负载均衡缓存
- env.reset 成功率: 99.99%
系统弹性
- 持久化会话协议替代请求协议
- 指数退避重试
- 故障隔离:环境/奖励/推理 worker 故障互不影响
- 一周训练运行仅观察到一次故障
七、与现有方法对比
| 方面 | veRL | StreamRL | RollArt |
|---|---|---|---|
| 架构 | 单体集群 | 部分解耦 | 完全解耦 |
| 硬件异构性 | 不支持 | 不支持 | 支持 |
| 环境管理 | 批量级 | 批量级 | 轨迹级 |
| 奖励部署 | 本地 GPU | 本地 GPU | Serverless |
| 训练模式 | 同步 | 异步 (one-off) | 异步 (有界) |
| 端到端加速 | 1.00× | 1.52× | 2.05× |
| 吞吐量 | 1.00× | 1.31-1.47× | 2.65-4.58× |
八、相关工作
| 相关工作 | 与本文关系 |
|---|---|
| veRL | 基线,单体集群架构 |
| StreamRL | 部分解耦,但不支持异构 GPU |
| AsyncFlow/SeamlessFlow | 粗粒度解耦,忽略任务异构性 |
| Mooncake | 跨集群权重同步引擎 |
| vLLM/SGLang | 推理引擎 |
| Megatron | 训练引擎 |
九、总结
核心贡献
- 硬件亲和性工作负载映射: 根据工作负载特性(prefill vs decode)动态路由到最适合的硬件
- 轨迹级细粒度异步: 在轨迹级别管理执行,避免长尾环境阻塞整个流水线
- 状态感知计算: 将无状态奖励计算卸载到 serverless 平台,GPU 利用率从 6% 提升到 88%
- 异步边界控制: 调节轨迹新鲜度以平衡训练稳定性和吞吐量
- 生产验证: 在 3000+ GPU 集群上持续运行一周,验证可扩展性和鲁棒性
技术影响
- 解耦基础设施范式: 单体集群无法高效满足多任务 Agentic RL 的异构资源需求
- 轨迹级调度: 替代批量级调度,提高对环境不稳定性的弹性
- Serverless 奖励: 无状态组件适合 serverless 部署,实现零开销自动扩缩容
- 异步训练: 通过有界异步训练平衡梯度稳定性和系统吞吐量
局限性
- Prefill-decoding 解耦尚未完全自动化,需要手动配置实例
- 跨集群通信仍受限于以太网带宽
- 异步训练引入的数据陈旧性可能影响模型质量
- 当前仅支持全参数训练,未探索 LoRA 等参数高效方法
十、参考资源
- 论文: arXiv:2512.22560
- 代码: GitHub - alibaba/ROLL
- 主题: cs.DC, cs.LG
- 页数: 约 15 页, 15 图