Nightjar: Dynamic Adaptive Speculative Decoding for Large Language Models Serving
Nightjar 将投机长度选择建模为上下文多臂赌博机(Contextual MAB),按 batch 大小自适应选择 γ 或彻底关闭投机,并在高负载下把 draft 模型 offload 到 CPU 释放显存扩大 KV cache;在动态请求率下相比标准 SD 吞吐提升最高 14.76%、延迟降低最高 20.18%,相比无 SD 平均提升 27.29%。
Nightjar: Dynamic Adaptive Speculative Decoding for Large Language Models Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Nightjar: Dynamic Adaptive Speculative Decoding for Large Language Models Serving |
| 作者 | Rui Li, Zhaoning Zhang, Libo Zhang, Huaimin Wang, Xiang Fu, Zhiquan Lai |
| 发表日期 | 2025-12-27 (arXiv, v3) |
| arXiv | 2512.22420 |
| 分类 | cs.DC, cs.AI |
| 系统名 | Nightjar(vLLM 0.8.2 扩展) |
| 代码基线 | Multi-Armed Bandit / ADA-BINGREEDY |
二、核心思想
问题定义:投机解码(SD)通过 draft 模型并行验证多 token 缓解自回归瓶颈,但存在明确权衡:
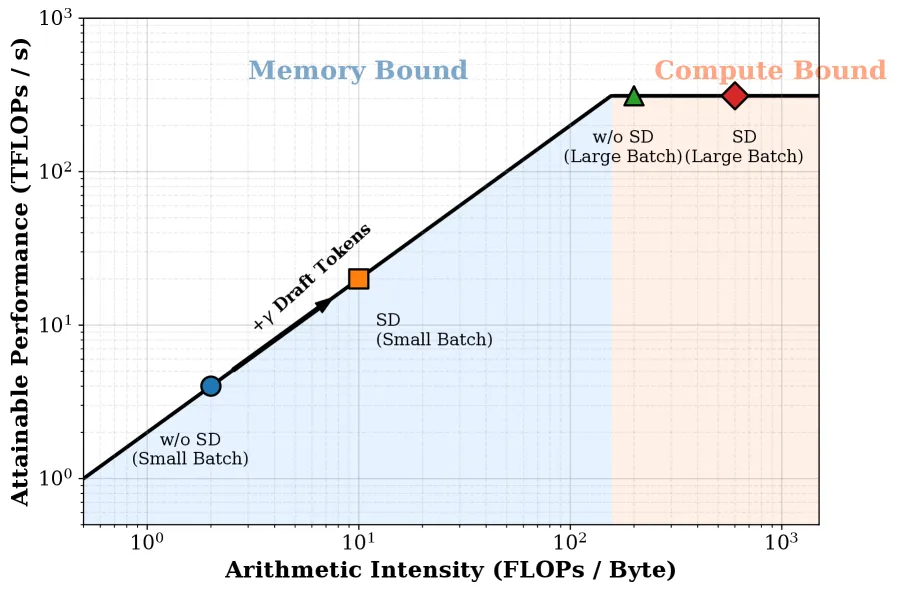
- 低负载 memory-bound 区间 SD 提升算术强度、加速推理;
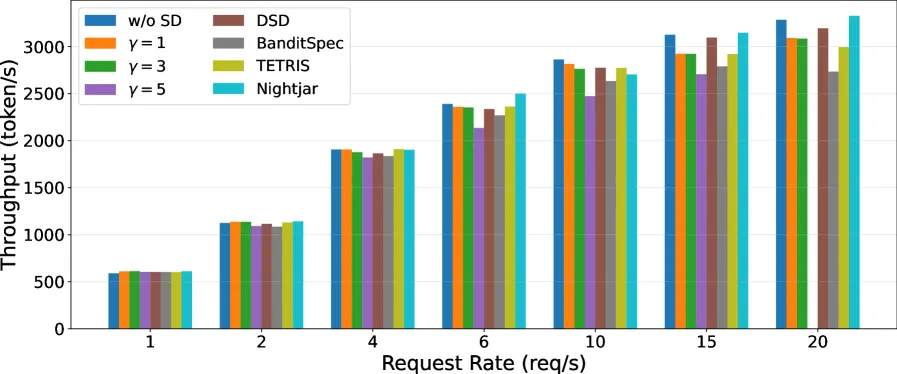
- 高负载 compute-bound 区间验证开销拖累性能,甚至比无 SD 慢 30.25%。
现有 vLLM 等系统采用固定 γ,不能随 batch 变化调整;即便动态方法也忽略了「重启投机时 KV cache 重建」的切换代价,容易陷入决策死锁(关闭 SD 后无新数据可学习)。
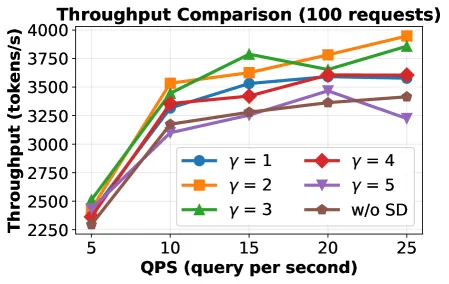
解决方案:Nightjar 是资源感知的自适应投机框架:
- 用上下文 MAB(batch size 为 context)动态选择每步投机长度 γ;
- 当收益不足时主动关闭投机(γ=0);
- 在 GPU 内存紧张且 SD 关闭时把 draft 模型 offload 到 CPU,把释放的显存归还 KV cache 池以扩大 batch。
三、技术架构/方法
3.1 系统架构
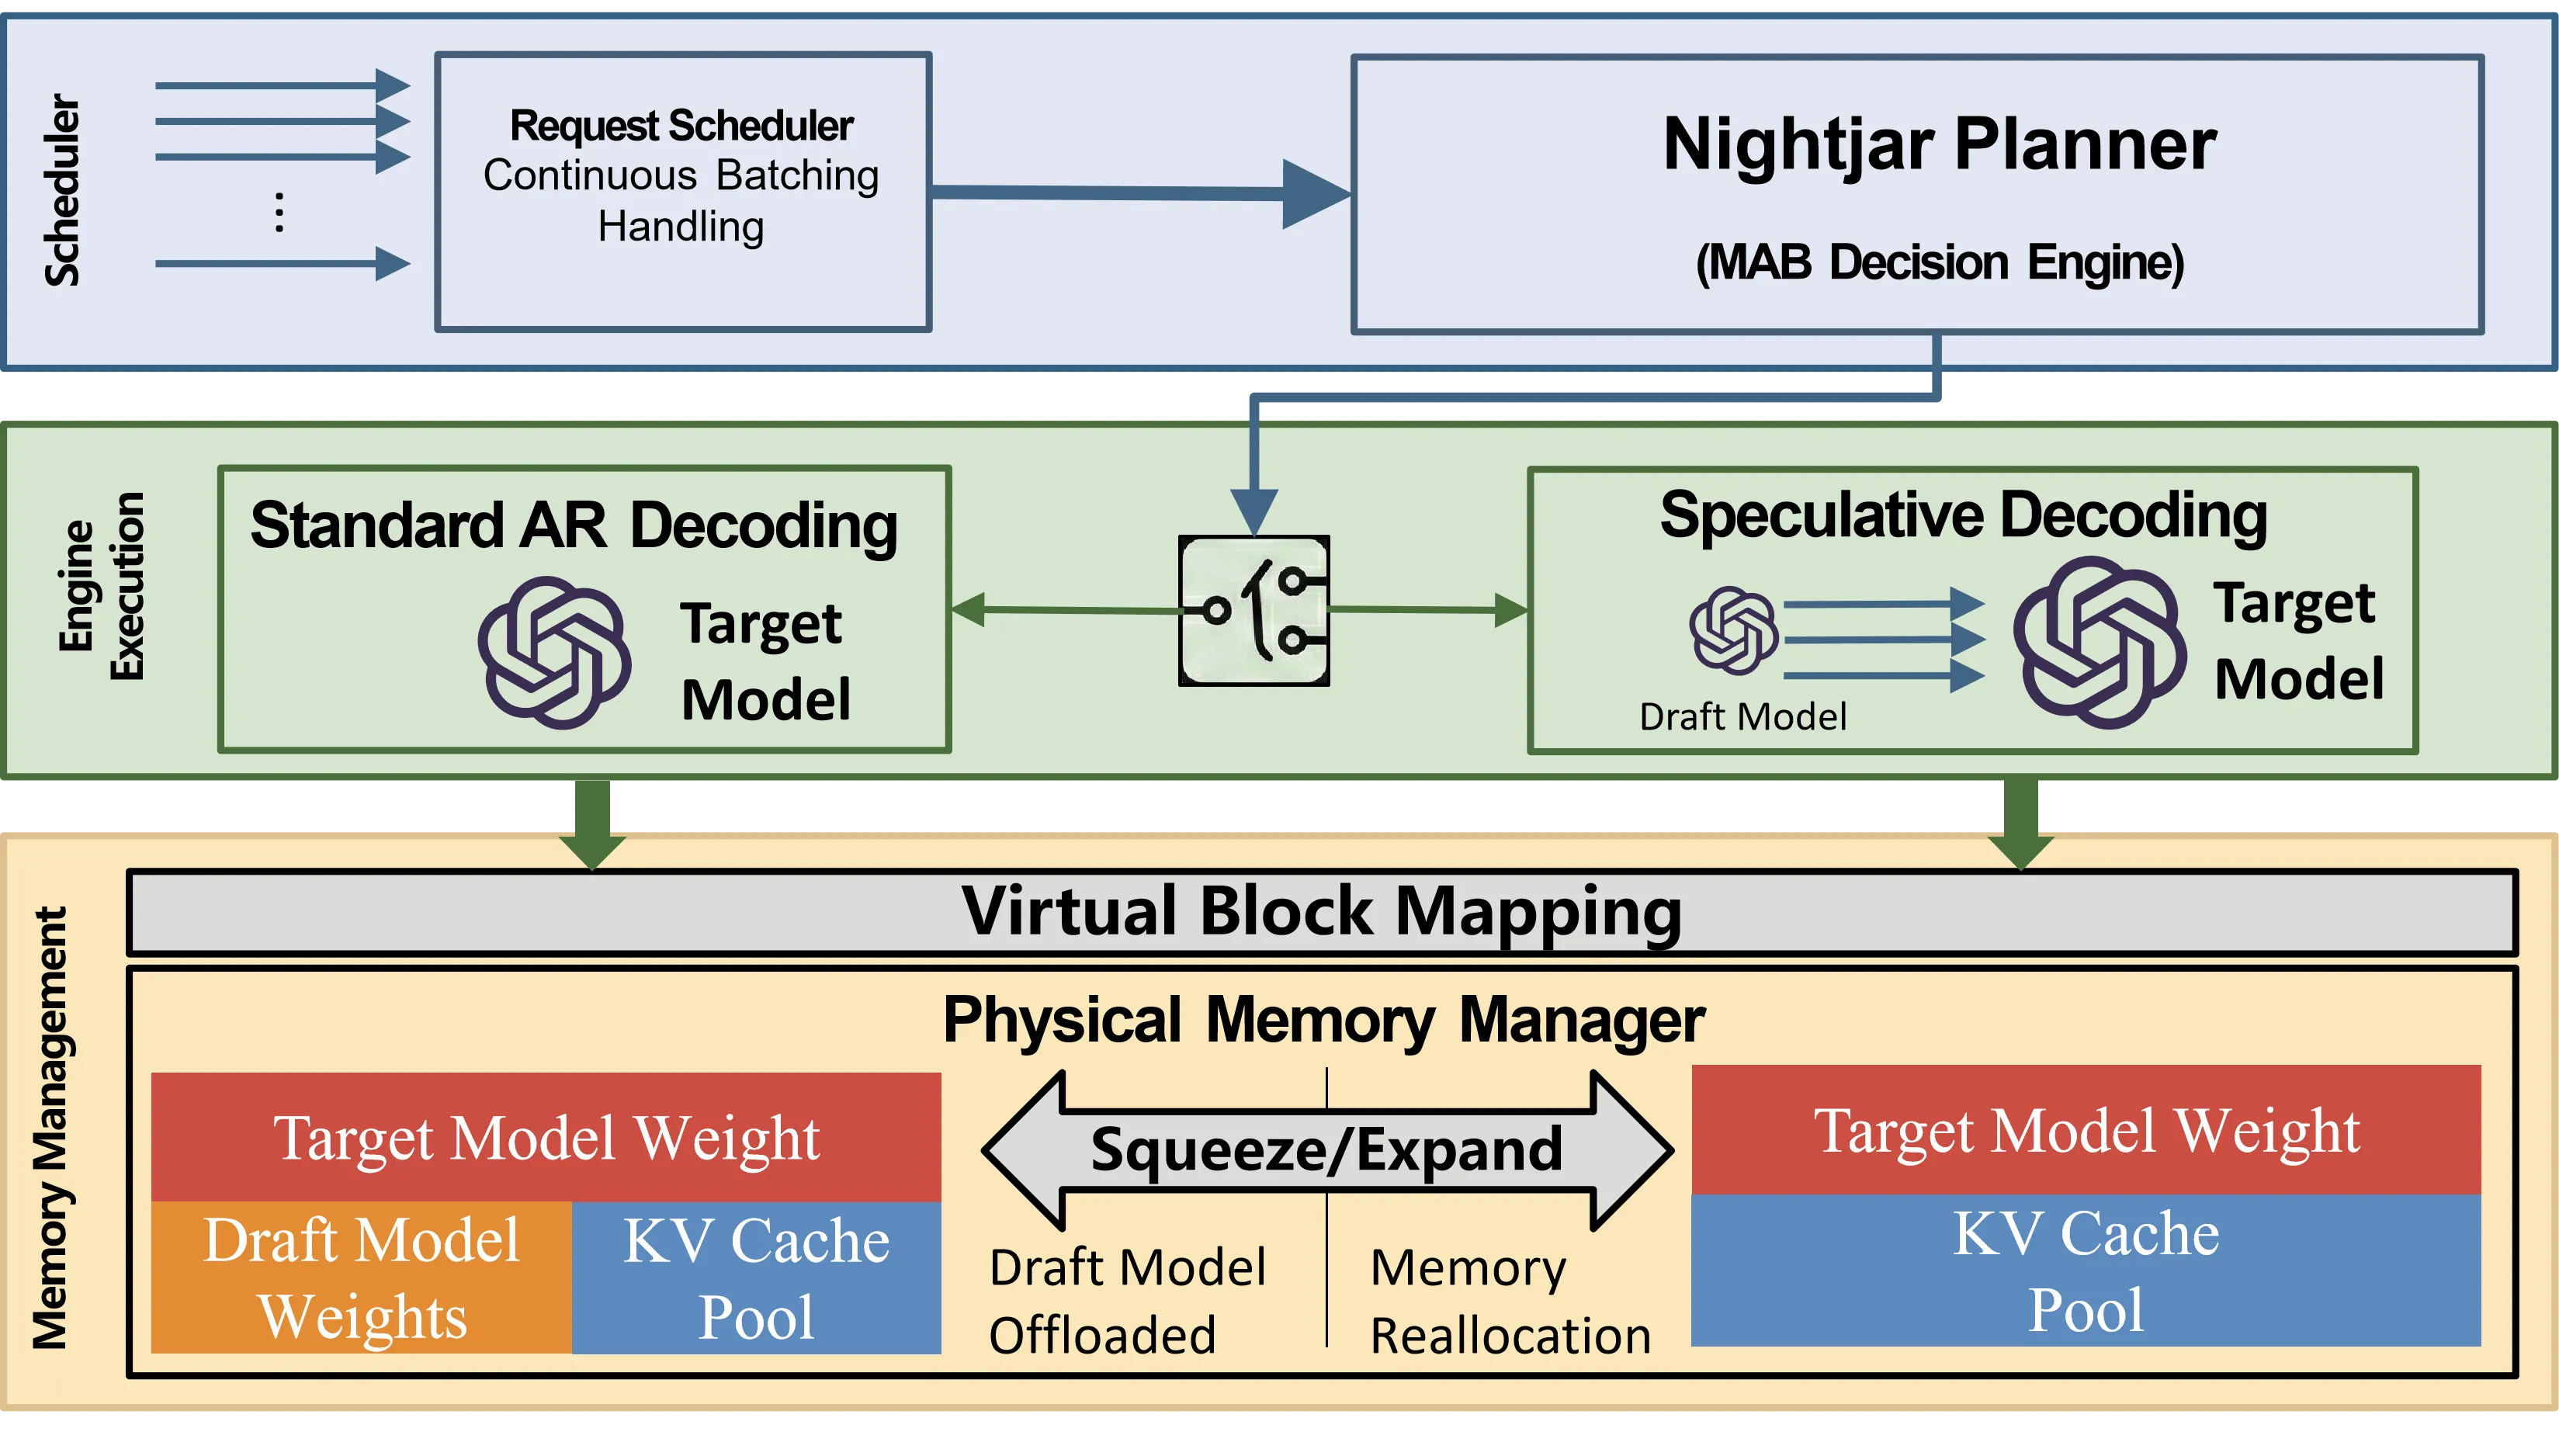
三层协同:
- Scheduler & Planner:Request Scheduler 处理连续 batching;Planner(Contextual MAB)根据当前 batch 决定 γ。
- Engine Execution:γ>0 时启用 draft+并行验证,γ=0 时纯 AR 解码,跳过 draft。
- Memory Manager:Squeeze/Expand 机制在 draft 权重和 KV cache 间弹性分配显存。
3.2 MAB 形式化
目标:给定 batch ,选择使 latency-per-token 最小的 γ:
引入切换代价(KV cache 重建):
累积 regret:
3.3 三级层次 ADA-BINGREEDY
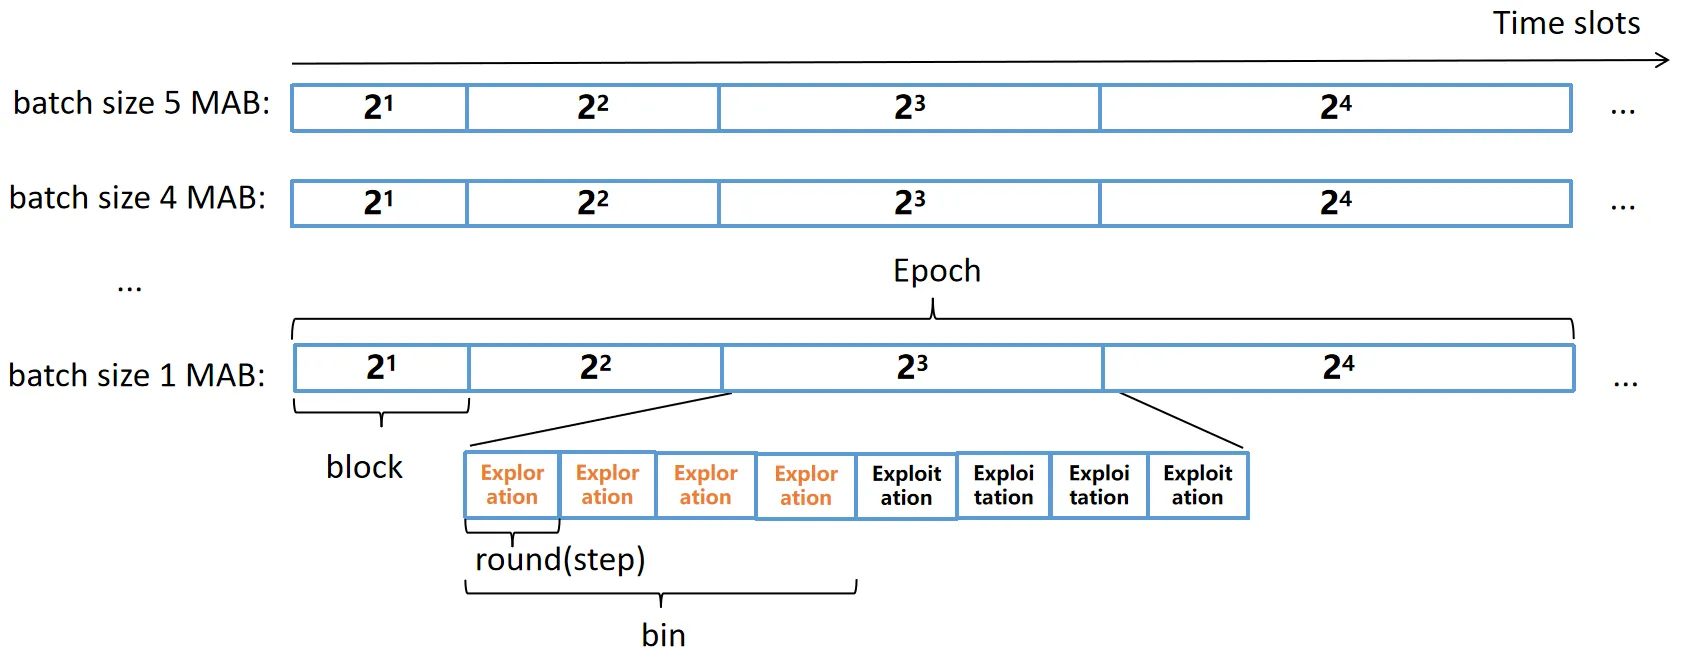
每个 batch 大小维护独立 Epoch,Epoch 由指数增长的 Block 组成,每个 Block 拆分为固定 Bin 。Bin 内做探索-利用平衡;Block 层负责长周期切换。作者在 [ADA-BINGREEDY] 基础上加入按 batch 分组的机制与显式切换代价项。
论文证明该结构保证 sublinear regret。选择时直接估计经验均值 (避免 Jensen 偏置):
3.4 弹性 KV Cache Memory Manager
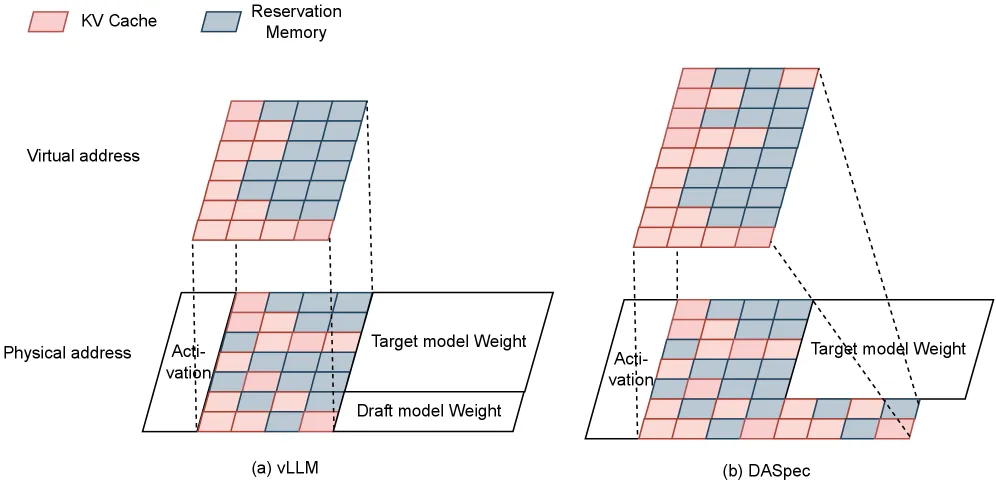
- 传统 vLLM 将 draft 权重与 KV cache 空间隔离;Nightjar 把它们统一到一个物理内存池,通过逻辑映射解耦。
- 显存 = KV cache 大小 + draft 大小 ,块视角:。
触发条件(滞回策略):
- 扩张:SD 关闭 ∧ 持续 步。
- 收缩: ∧ 。
3.5 KV Cache Contraction & Logical Remapping
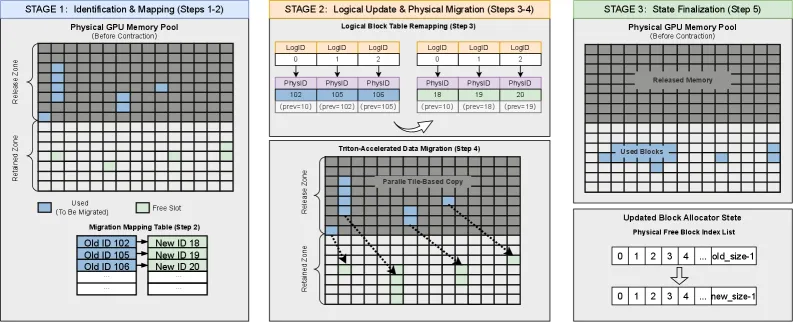
四步:
- 扫描页表,找出待迁移的物理块 ;
- 构造一一映射 ;
- 更新块对象、前驱指针、逻辑 block table、引用计数;
- 用 Triton 实现的向量化 tile-based kernel 完成物理数据迁移。
Draft 模型 offload 采用异步 CUDA 流 + 非阻塞 DMA,与主模型计算重叠,几乎无额外延迟。
四、核心创新
| 创新点 | 说明 |
|---|---|
| Contextual MAB with batch-size 作为 context | 首次将 γ 选择建模为 batch-aware 的 regret 最小化问题,理论保证 sublinear regret |
| 显式切换代价建模 | 首次量化重启 SD 时 KV cache 重建代价并加入 loss,避免决策死锁 |
| 动态 draft offload | 高负载时把 draft 权重转 CPU,为 KV cache 释放显存扩大 batch |
| 统一物理内存池 + 逻辑重映射 | 解耦逻辑 KV cache 与物理位置,就地扩缩容无需大规模拷贝 |
| 异步非阻塞迁移 | 用 Triton kernel + CUDA stream/DMA 隐藏迁移开销 |
| Latency-per-token 目标 | 用 而非 直接优化,避免 Jensen 偏置 |
五、实验结果
5.1 实验设置
- 硬件:单卡 RTX 4090 24GB(7B 目标模型 + 0.5B draft)、A100 40GB(13B 目标 + 68m draft)。
- 目标 / draft:DeepSeek-R1-Distill-Qwen-7B + DeepSeek-R1-DRAFT-Qwen2.5-0.5B;Vicuna-13b + vicuna-68m。
- 数据集:ShareGPT、Alpaca、SpecBench(每个 480 样本);泊松到达 + AzureLLMInferenceDataset 真实 trace。
- 基线:SD (γ=3)、无 SD、DSD、BanditSpec、TETRIS。
5.2 动态请求率
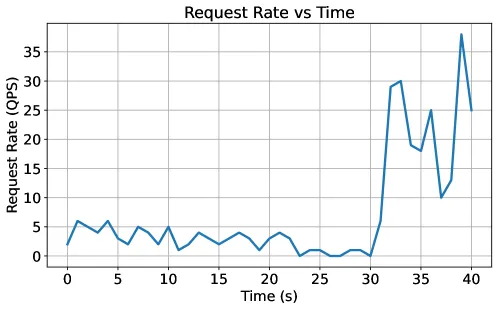
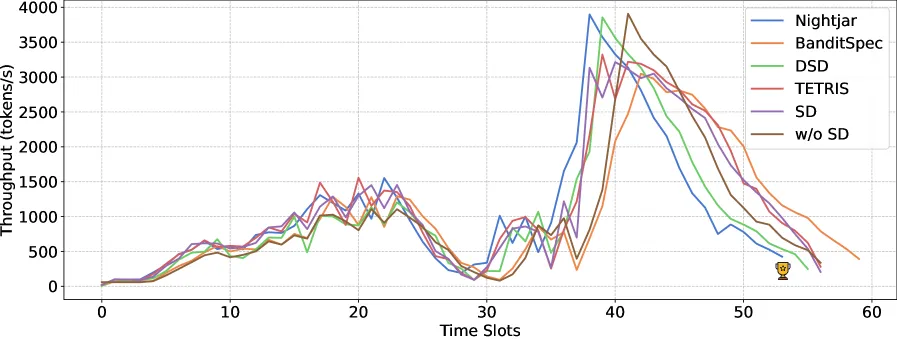
- 低负载 Nightjar 达到最高峰值吞吐;高负载切换为无 SD 避免性能崩塌,保持整体最优。
- DSD 低负载预测不准;TETRIS 高负载因大 batch 开销退化;BanditSpec 无 batch context 不适应动态 batch。
5.3 吞吐与延迟综合结果
7B 与 13B 模型三数据集吞吐(tokens/s):
| Method | 7B-Alpaca | 7B-ShareGPT | 7B-SpecBench | 13B-Alpaca | 13B-ShareGPT | 13B-SpecBench |
|---|---|---|---|---|---|---|
| Nightjar | 2102.73 | 3734.23 | 3326.20 | 721.23 | 1729.68 | 1061.82 |
| BanditSpec | 1860.74 | 3428.75 | 2631.43 | 679.82 | 1383.81 | 763.15 |
| DSD | 2044.40 | 3614.65 | 2789.51 | 603.32 | 1244.96 | 692.01 |
| TETRIS | 1875.91 | 3597.21 | 2974.14 | 702.65 | 1628.86 | 985.40 |
| SD | 1920.63 | 3593.36 | 3044.80 | 628.47 | 1689.53 | 964.02 |
| w/o SD | 2072.38 | 3653.61 | 3207.28 | 438.13 | 1290.04 | 673.48 |
- 相对无 SD 平均吞吐 +27.29%;相对 DSD/BanditSpec +22.89% / +19.76%;相对 TETRIS/SD +7.39% / +8.32%。
- 主 benchmark 里比标准 SD 提升最高 14.76%,比 SD 平均 latency 降低最多 20.18%。
延迟(ms)Nightjar 全面领先或持平最佳。
5.4 消融
- LinUCB / linearTS 假设线性关系,但 SD 的 latency 与 batch 非线性 → Nightjar 的 ADA-BINGREEDY 全 QPS 最佳。
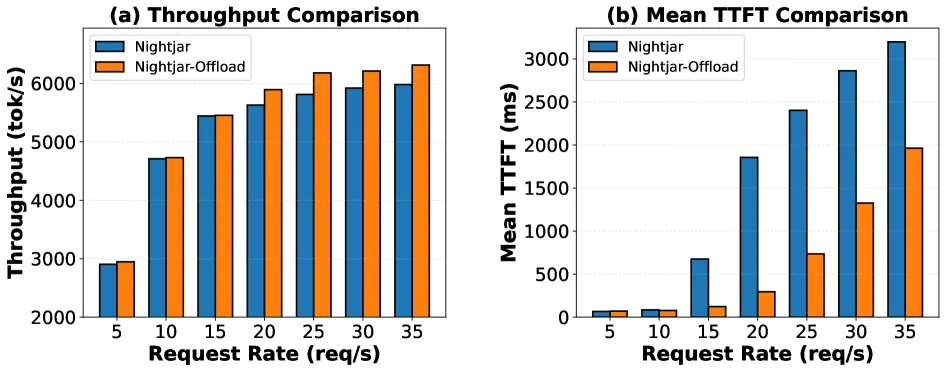
- With Offload > Without Offload:draft offload 显著扩大 KV cache 池、提高高负载 batch。
5.5 大模型验证
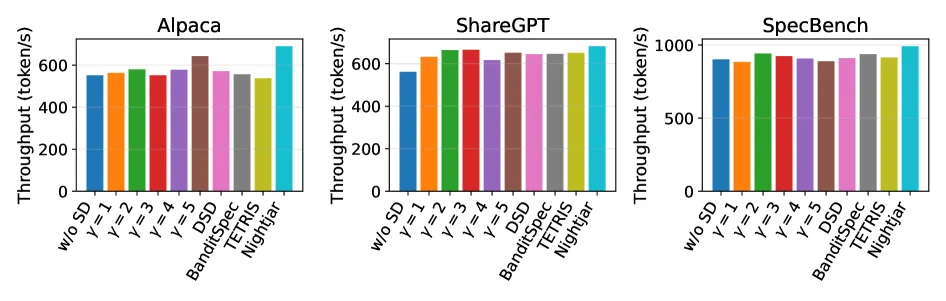
30B 目标模型上 Nightjar 仍稳定领先。
5.6 Draft 内存占比
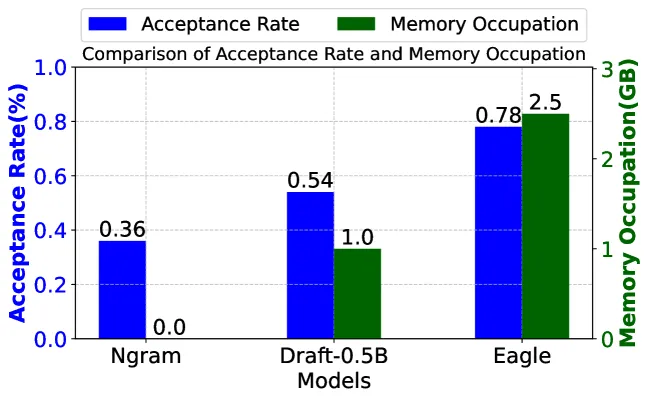
Model-based draft 占用不可忽视,为 offload 合理性提供证据。
六、总结
核心贡献
- 首个以 latency-per-token 为目标、batch size 为 context 的自适应 SD 框架,理论证明 sublinear regret。
- 显式建模 KV cache 重建的切换代价,避免动态 SD 陷入死锁。
- 提出「Draft 模型可 offload」的弹性 KV cache 池,通过 Triton kernel 与异步 DMA 实现低开销 in-place 扩缩容。
- 在 7B / 13B / 30B 目标模型多数据集下均优于 vLLM 内置 SD、DSD、BanditSpec、TETRIS 等基线,动态请求率场景收益最显著。
技术影响
- 为 SD 引入了「资源感知」维度,提示未来投机方法需与 batch/内存耦合。
- 弹性 draft offload 与 KV cache 逻辑重映射,对未来同时支持 LoRA/draft/多目标的服务系统具有参考价值。
局限性
- MAB 需要冷启动探索时间;剧烈负载切换初期可能有短暂次优。
- 切换代价 需要经验估计,跨硬件迁移需校准。
- 仅在 vLLM 0.8.2 + 有限模型对上评估;对不同 draft 架构(tree draft、EAGLE 等)泛化性未验证。
- Draft offload 依赖 PCIe 带宽,在低速互连或多卡场景收益可能缩水。
七、参考资源
- arXiv: https://arxiv.org/abs/2512.22420
- HTML: https://arxiv.org/html/2512.22420v3
- 主题:cs.DC, cs.AI
- 相关方法:DSD、BanditSpec、TETRIS、SpecServe、EAGLE