FinDEP: Efficient MoE Inference with Fine-Grained Scheduling of Disaggregated Expert Parallelism
面向解耦专家并行的细粒度任务调度框架,实现MoE推理吞吐量提升1.61×
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | FinDEP: Efficient MoE Inference with Fine-Grained Scheduling of Disaggregated Expert Parallelism |
| 作者 | Xinglin Pan, Shaohuai Shi, Wenxiang Lin, Yuxin Wang, Zhenheng Tang, Wei Wang, Xiaowen Chu |
| 机构 | HKUST (Guangzhou), HIT Shenzhen, HK Baptist Univ, HKUST |
| 论文 | arXiv:2512.21487 |
| 代码 | - |
| 发布 | 2024-12-25 |
| 领域 | 分布式计算 (cs.DC) |
二、核心思想
问题定义
MoE 模型推理面临内存密集型挑战:attention 层需要存储 KV cache,expert 层虽然只激活部分专家但需要存储全部专家参数。解耦专家并行 (DEP) 将 GPU 分为两个专用组:
- Attention Group (AG):存储 attention 层和共享专家
- Expert Group (EG):存储所有非共享专家
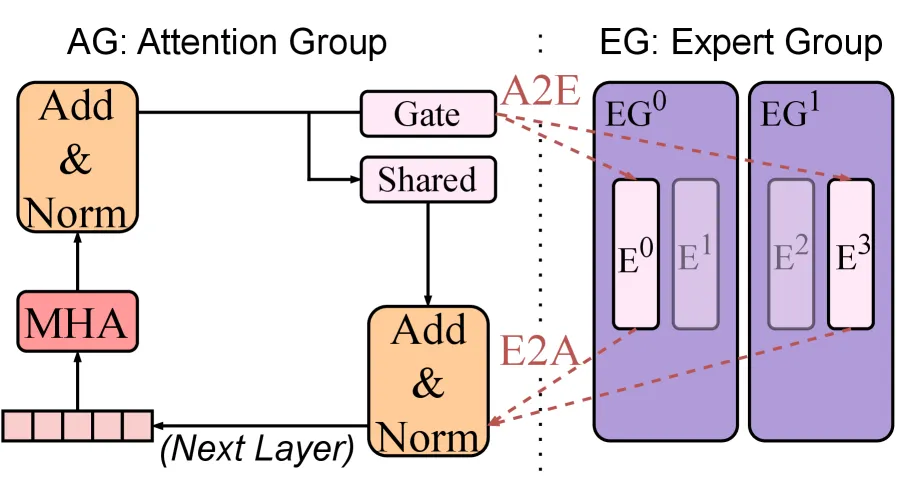
现有问题:AG 和 EG 之间需要双向通信(A2E 和 E2A),导致 GPU 空闲时间长。
现有方案的局限:
- PPPipe(乒乓流水线):仅支持 micro-batch 级别的流水线,不支持共享专家
- StepMesh:CPU offloading,粗粒度调度
解决方案概述
FinDEP 提出细粒度任务调度算法,三大创新:
- 细粒度任务分区:将计算和通信任务分割为更小的子任务
- 优化问题建模:形式化 DEP 推理时间优化问题
- 高效求解算法:多项式时间复杂度求解近似最优解
核心结果:吞吐量提升 1.61×,32 GPU 系统上仍达 1.24× 加速。
三、技术架构
MoE 模型结构
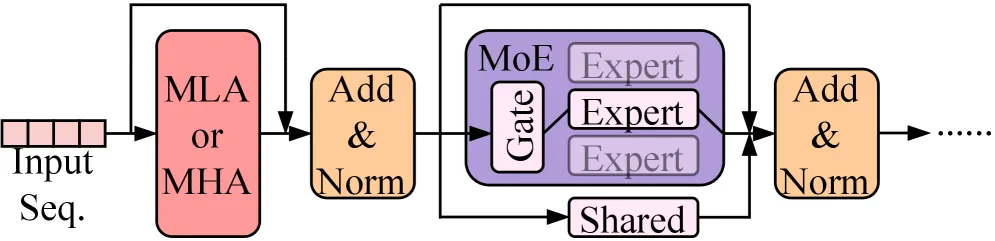
MoE 层将标准 FFN 替换为稀疏激活的专家网络,通过门控函数选择 top-k 个专家处理每个 token。
时间线对比
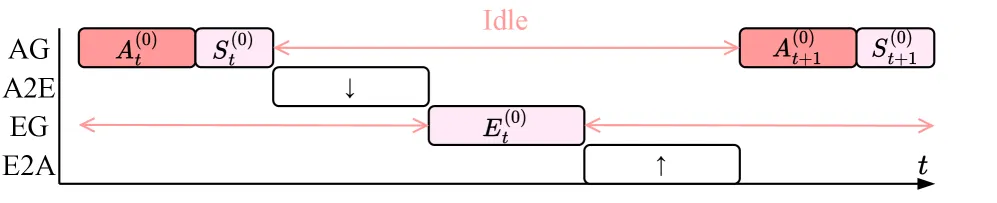
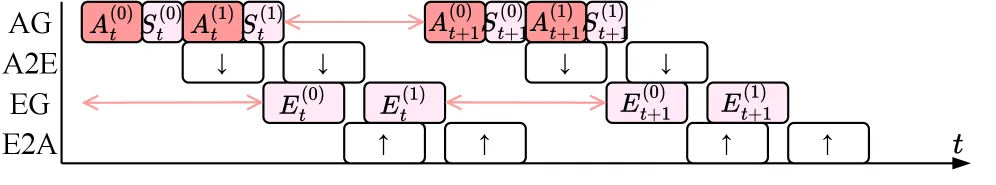
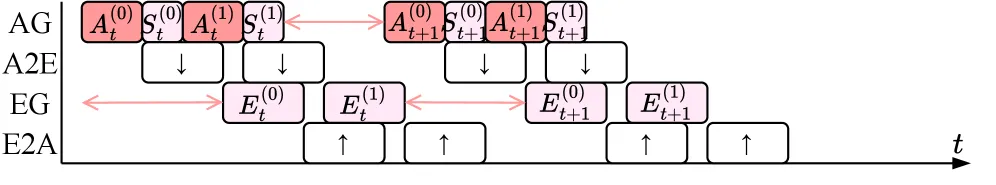
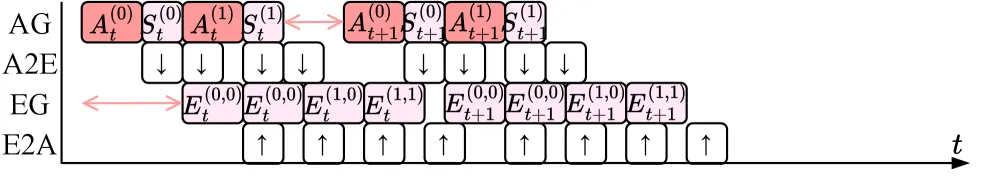
| 方案 | 流水线粒度 | 共享专家支持 | 通信重叠 |
|---|---|---|---|
| Naive DEP | 无 | 是 | 无 |
| PPPipe | micro-batch | 否 | 部分 |
| FinDEP | 细粒度 | 是 | 最大 |
调度策略
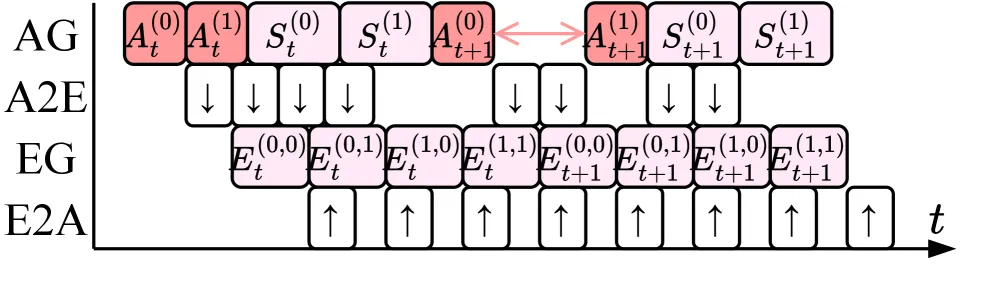
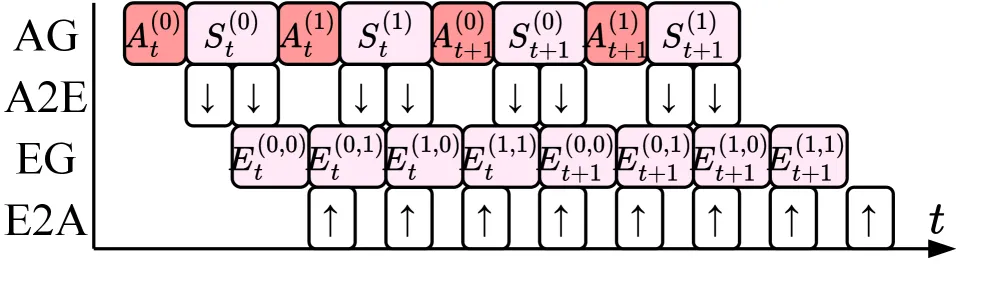
FinDEP 支持两种任务排序策略:
AASS (Attention-All, Shared-All):
- 先处理所有 attention 段,再处理所有 Shared Expert 段
- 优势:更早启动 A2E 通信和专家计算
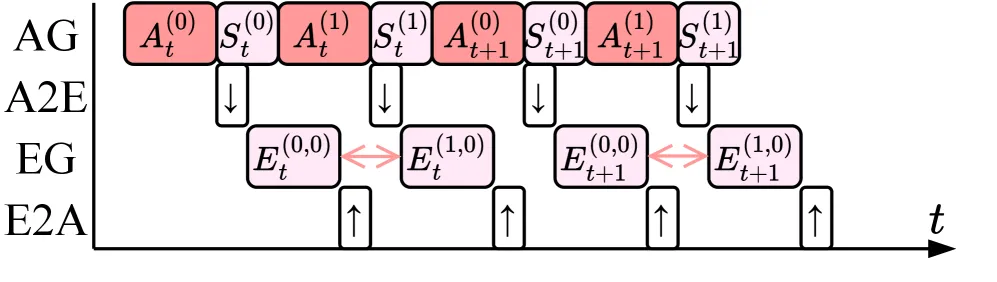
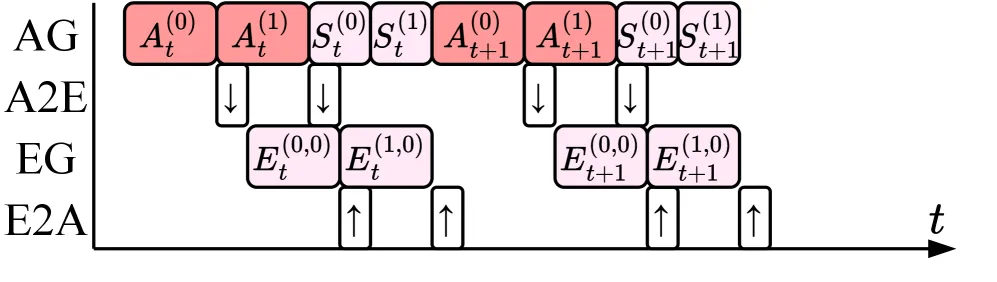
ASAS (Attention-Shared-Alternating-Sequential):
- attention 和 Shared Expert 交替执行
- 优势:提高 GPU 利用率,在等待 attention 信号时交错执行
核心公式
性能模型(线性模型):
| 组件 | 时间模型 |
|---|---|
| GEMM | t_gm(x) = α_gm + β_gm × x |
| Attention | t_attn(y) = α_attn + β_attn × y |
| 通信 | t_c(z) = α_c + β_c × z |
推导的线性模型:
| 任务 | 时间模型 |
|---|---|
| Attention 层 | t_a(m_a) = α_a + β_a × m_a |
| Shared Expert 层 | t_s(m_a) = α_s + β_s × m_a |
| MoE 层 | t_e(m_e) = α_e + β_e × m_e |
| A2E/E2A 通信 | t_a2e(m_e) = α_a2e + β_a2e × m_e |
Attention 层详细公式:
MoE 层公式:
优化目标:
单调性定理
Theorem 1-2:给定 (r₁, r₂),目标函数关于 m_a 单调递增
Theorem 3:给定 (m_a, r₂),目标函数关于 r₁ 单调非递减
Theorem 4:给定 r₁ 和 m_a,目标函数关于 1/r₂ 是凸的
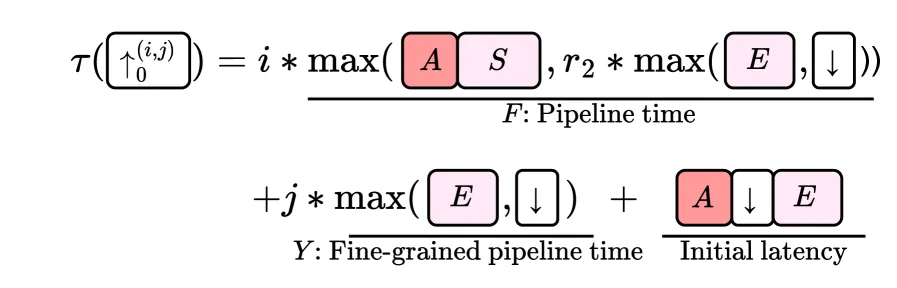
时间戳分解
算法流程
Algorithm 1: FinDEP Configuration Search
输入: P, a_g, e_g, α*, β*, B, S, H, M, N_shared, E, top_k, T
输出: best_config = (m_a, r₁, m_e, r₂, order)

1. 初始化 best_config, best_tps ← 0
2. For m_a = ∞ downto 1:
   - r₁ ← getMaxR1(...)  # 内存约束
   - If r₁ == 0 or r₁ == r₁': continue  # 跳过非Pareto最优
   - For order ∈ {ASAS, AASS}:
     - r₂*, tps ← Solve(min_r₂ Eq. 17)
     - m_e ← m_a · a_g · top_k · S / (r₂* · E)
     - If tps > best_tps: 更新 best_config
3. Return best_config复杂度:O(C · d(M)),其中 d(M) 是 M 的约数个数。求解器在 1 秒内完成。
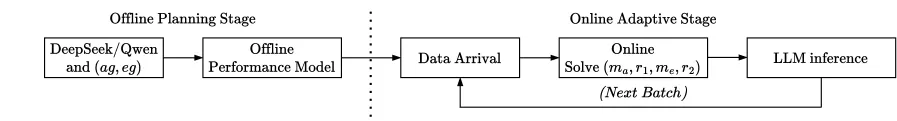
在线流水线
- 离线阶段:选择模型、确定 AG/EG 大小、收集性能模型系数
- 在线阶段:数据到达时执行 Algorithm 1 快速得到最优配置
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 细粒度任务分区 | 将计算/通信分割为 r 个子任务 | 支持共享专家,最大化重叠 |
| 优化问题建模 | 形式化 DEP 推理时间优化 | 支持不同分区粒度和排序 |
| 高效求解算法 | 多项式时间复杂度 | O(C·d(M)),<1秒求解 |
| AASS/ASAS 策略 | 两种互补的任务排序策略 | 适应不同场景 |
| 单调性定理 | 证明目标函数的单调性 | 大幅缩减搜索空间 |
五、实验结果
实验平台
| 平台 | GPU | 显存 | NVLink | 数量 |
|---|---|---|---|---|
| Testbed A | RTX A6000 | 48GB | Yes | 8 |
| Testbed B | A10 | 24GB | No | 8 |
| Testbed C | H20 | 96GB | Yes | 8 |
| Testbed D | H20 | 96GB | Yes | 32 |
模型:DeepSeek-V2, Qwen3-MoE
性能模型验证
| 组件 | R² 值 |
|---|---|
| GEMM | 0.997132 |
| 通信 | 0.994 - 0.999 |
微基准测试耗时 < 2 分钟。
吞吐量 vs m_a 和 r₁
DeepSeek-V2 吞吐量 (tokens/s):
| Testbed | S | m_a=1 | m_a=2 | m_a=4 |
|---|---|---|---|---|
| C | 2048 | 202.67 | 245.33 | 284.00 |
| D | 2048 | 558.23 | 690.47 | 756.35 |
| D | 4096 | 632.41 | 682.49 | 707.57 |
验证了 Theorem 1-2 的单调性。
端到端性能
DeepSeek-V2 吞吐量对比 (tokens/s):
| S | Testbed A PPPipe | Testbed A FinDEP | Testbed B PPPipe | Testbed B FinDEP | Testbed D PPPipe | Testbed D FinDEP |
|---|---|---|---|---|---|---|
| 1024 | 48.50 | 53.40 (1.10×) | 86.70 | 93.04 (1.07×) | 149.58 | 161.50 (1.08×) |
| 2048 | 46.28 | 50.27 (1.09×) | 81.99 | 86.63 (1.06×) | 134.42 | 150.82 (1.12×) |
| 4096 | 44.21 | 51.47 (1.16×) | 81.04 | 85.84 (1.06×) | 120.83 | 132.07 (1.10×) |
| 8192 | 8.57 | 13.14 (1.53×) | 15.98 | 25.71 (1.61×) | 37.19 | 45.26 (1.22×) |
Qwen3-MoE 吞吐量对比:
| S | Testbed A | Testbed B | Testbed C | Testbed D |
|---|---|---|---|---|
| 1024 | 1.13× | 1.11× | 1.03× | 1.08× |
| 2048 | 1.20× | 1.08× | 1.02× | 1.08× |
| 4096 | 1.13× | 1.23× | 1.07× | 1.24× |
| 8192 | 1.53× | 1.61× | 1.35× | 1.22× |
在线场景性能
| Backbone | Tokens | Testbed A | Testbed B | Testbed C | Testbed D |
|---|---|---|---|---|---|
| DeepSeek | 3072 | 1.04× | 1.12× | 1.03× | 1.23× |
| DeepSeek | 6144 | 1.06× | 1.09× | 1.04× | 1.14× |
| Qwen | 3072 | 1.20× | 1.14× | 1.00× | 1.24× |
| Qwen | 6144 | 1.13× | 1.09× | 1.01× | 1.17× |
消融实验:非重叠通信时间
| S | Naive-DEP | PPPipe | FinDEP |
|---|---|---|---|
| 4096 | 905.49ms | 528.94ms | 309.81ms |
| 2048 | 536.22ms | 144.32ms | 52.60ms |
| 1024 | 194.95ms | 188.65ms | 97.33ms |
FinDEP 相比 PPPipe 减少通信时间 1.7×。
六、相关工作
| 方法 | 特点 | FinDEP 优势 |
|---|---|---|
| MegaScale-Infer (PPPipe) | micro-batch 流水线 | 细粒度调度 + 共享专家支持 |
| StepMesh | CPU offloading | 更高效的重叠策略 |
| DistServe | Prefill/Decode 解耦 | 专注 MoE expert 解耦 |
| Mooncake | KVCache 池解耦 | 互补方案 |
| DeepSeek-V3 | 热专家复制 | 可结合使用 |
| 模型量化 | 降低通信量 | 正交优化 |
七、总结
核心贡献
- 细粒度任务分区:将计算和通信任务分割为更小的子任务,支持共享专家
- 优化问题建模:形式化 DEP 推理时间优化,包含任务排序和分区粒度
- 高效求解算法:O(C·d(M)) 多项式时间复杂度,<1 秒求解
- 实验验证:4 种 GPU 平台、2 种 MoE 模型、最高 1.61× 加速
技术影响
- 为 MoE 模型的分布式推理提供了新的调度范式
- 细粒度任务分区思想可推广到其他分布式计算场景
- 在线求解能力使其适用于动态工作负载
局限性
- 性能模型基于线性假设,极端情况下可能不准确
- 主要针对 decode 阶段,prefill 优化较少
- 需要离线微基准测试收集性能参数
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | MoE 模型结构 | moe-structure.png |
| Figure 2 | DEP 架构 (AG/EG) | dep-architecture.png |
| Figure 3a | Naive DEP 时间线 | timeline-naive-dep.png |
| Figure 3b | PPPipe 时间线 | timeline-pppipe.png |
| Figure 3c | FinDEP ASAS 时间线 | timeline-findep-asas.png |
| Figure 3d | FinDEP AASS 时间线 | timeline-findep-aass.png |
| Figure 4a | AASS 调度示例 1 | scheduling-aass-1.png |
| Figure 4b | AASS 调度示例 2 | scheduling-aass-2.png |
| Figure 4c | ASAS 调度示例 1 | scheduling-asas-1.png |
| Figure 4d | ASAS 调度示例 2 | scheduling-asas-2.png |
| Figure 5 | 时间戳分解 | timestamp-decomposition.png |
| Figure 6 | FinDEP 流水线 | findep-pipeline.png |