NVIDIA Nemotron 3: Efficient and Open Intelligence
NVIDIA Nemotron 3 系列(Nano/Super/Ultra)—— 混合 Mamba-Transformer MoE 架构,NVFP4 训练,LatentMoE,MTP,多环境 RL,1M token 上下文
NVIDIA Nemotron 3: Efficient and Open Intelligence
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | NVIDIA Nemotron 3: Efficient and Open Intelligence |
| 作者 | NVIDIA(团队) |
| 机构 | NVIDIA Corporation |
| 论文 | arXiv:2512.20856 |
| 发布 | 2025-12-24 |
| 许可 | 开源(模型权重、训练数据、软件均开源) |
二、核心思想
问题定义
构建面向 agentic AI 应用的高准确率、高效率开源大模型。当前主流大模型面临的核心矛盾:追求更高准确率往往牺牲推理吞吐量,而追求效率则损失模型质量。Nemotron 3 的目标是在 accuracy-throughput 前沿取得突破,同时支持高达 1M token 的长上下文和多环境 RL 后训练。
解决方案概述
Nemotron 3 系列(Nano、Super、Ultra)采用混合 Mamba-Transformer MoE 架构,通过以下核心技术组合实现高效训练与推理:
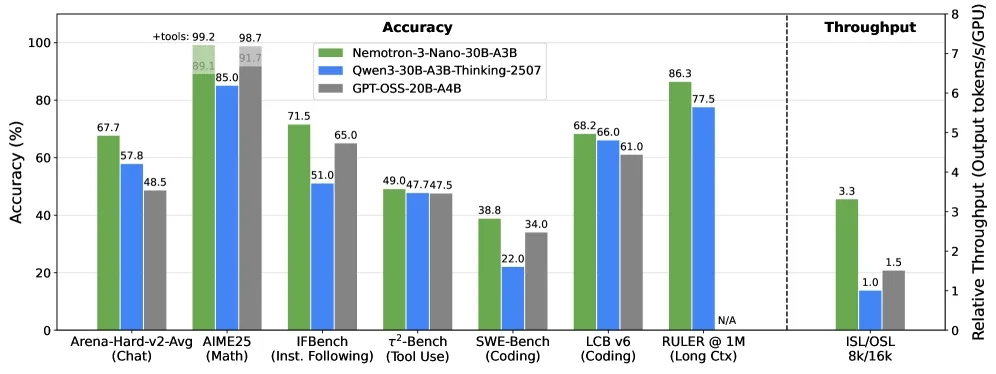
- Hybrid MoE:以 Mamba-2 层替代大部分自注意力层,降低 KV Cache 开销,实现 3.3× 吞吐提升
- LatentMoE:将专家路由维度压缩至 latent space,节省的通信和内存开销用于增加专家数量和 top-K,提升准确率
- MTP(Multi-Token Prediction):为 Super/Ultra 添加 MTP 层,加速推理并提升模型质量(+2.4% 平均准确率)
- NVFP4 训练:全精度 NVFP4 预训练(最多 25T tokens),重量化但保持 BF16/MXFP8 关键层
- 多环境 RL 后训练:数学/代码/SWE/搜索/工具使用/长上下文等多环境同时训练
- 推理时推理预算控制:用户可指定思考 token 预算,模型自适应截断
三、技术架构
Hybrid Mamba-Transformer MoE 架构
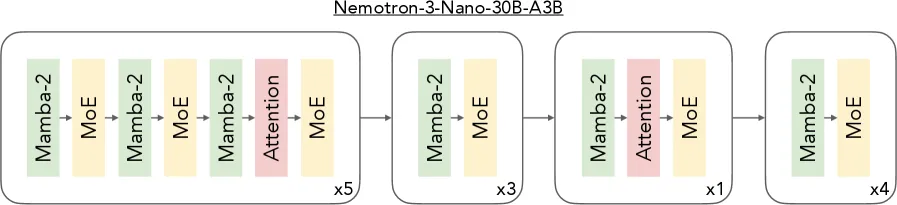
核心设计:Mamba-2 层在生成阶段仅需维护固定大小的状态(不增长),而自注意力层需要维护随序列长度线性增长的 KV Cache。Nemotron 3 用 Mamba-2 层替换了大部分自注意力层,仅保留少数注意力层用于全局信息路由。
架构权衡:
- MoE 层:稀疏参数缩放,给定计算预算下更高准确率
- 注意力层:高保真全对全信息路由(少数关键层)
- Mamba-2 层:固定推理时计算和内存的序列建模
以 Nemotron Nano 30B-A3B 为例,相比 Qwen3-30B-A3B 实现 3.3× 更高吞吐(8k 输入 / 16k 输出),且在 RULER 1M token 长上下文任务上达到 SOTA。
LatentMoE 架构
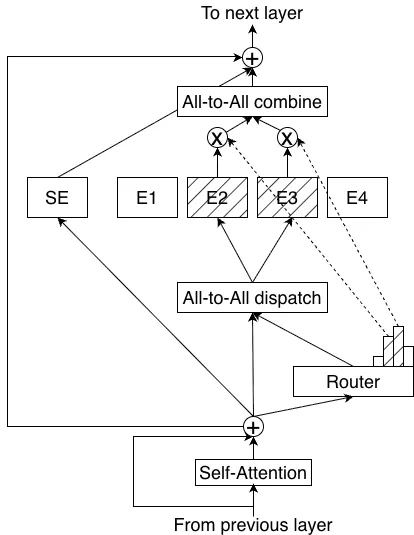
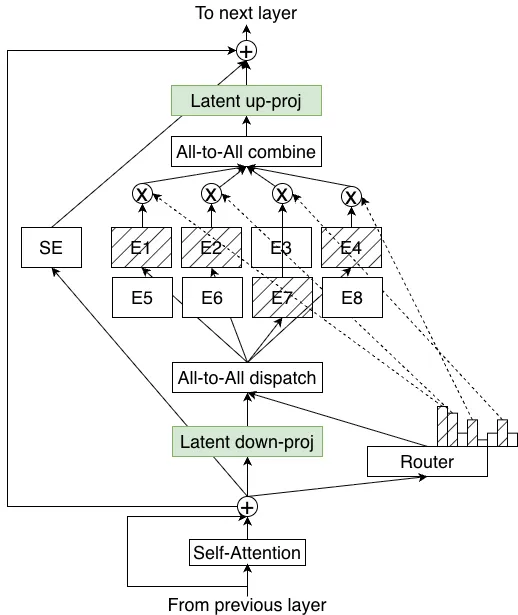
LatentMoE 的核心设计:将 token embedding 从隐藏维度 投影到更小的 latent 维度 (),在 latent space 中进行专家路由和计算,再投影回 。
关键缩放公式:
其中 为总专家数, 为 top-K 活跃专家数。以 Nemotron 3 为例:,,,因此 (vs 128),(vs 6)。
保留在原始维度 的非路由计算:MoE 路由门(gating network)、共享专家计算、非专家层。
NVFP4 训练
NVFP4 格式特性:
- 细粒度(16 元素)micro-block scaling
- E4M3 格式 block scaling factors
- 第二级 FP32 global scale
- E2M1 element format
训练配方(关键层精度保留):
- NVFP4:主体权重、激活、梯度
- BF16:QKV 投影、注意力投影、LatentMoE latent 投影、MTP 层(位于网络末端)
- MXFP8:Mamba 输出投影(NVFP4 量化时高达 40% flush to zero)
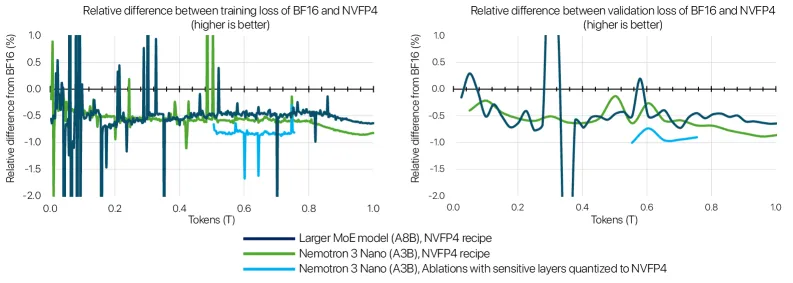
Figure 4 显示:保留敏感层在高精度下,NVFP4 与 BF16 的相对 loss 差 < 1%(Nano A3B),更大模型(A8B)< 0.6%。
长上下文(1M tokens)
- 不使用 RoPE:Mamba 层提供隐式位置信息,注意力层也不依赖 RoPE,避免 OOD RoPE 问题
- CPT 阶段:512k 序列长度持续预训练
- SFT 阶段:256k 序列长度
- RL 阶段:多环境包含长上下文环境(32k token 输入)
- 合成数据:长程检索、多跳推理、多文档信息聚合
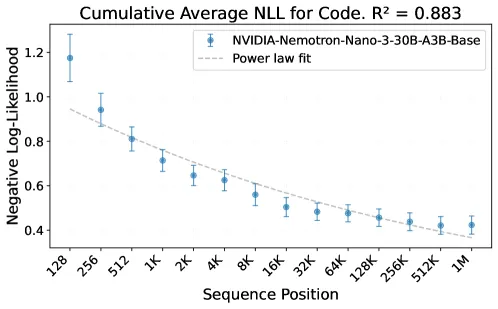
Figure 6 显示 Nemotron 3 Nano base 在 1M token 代码数据上的累积平均 NLL 随序列长度下降,表明模型有效利用了长上下文。
多环境 RL 后训练
同时训练的 RL 环境:数学/科学推理、竞技编程、指令遵循、软件工程、搜索、对话、通用 agentic 工具使用、长上下文等。
关键发现:同时训练优于分阶段训练——更稳定、更少 reward hacking、整体表现更好。
系统设计:
- 异步 RL 架构(解耦训练和推理)
- 利用 MTP 加速 rollout 生成
- GRPO + masked importance sampling(处理训练/rollout 策略差异)
- 开源:NeMo-RL + NeMo-Gym(Apache 2.0)
推理时推理预算控制
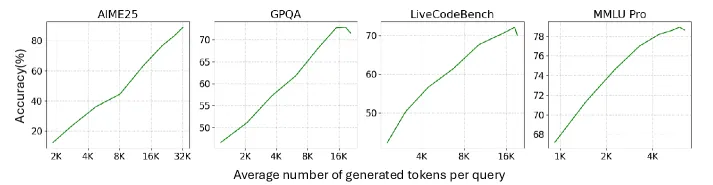
用户可指定最大思考 token 数,模型到达预算后自动附加 </think> token 并继续生成。Figure 8 展示了准确率-效率权衡曲线,提供细粒度控制。
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| Hybrid Mamba-Transformer MoE | 以 Mamba-2 层替换大部分自注意力层,仅保留少量注意力层用于全局路由 | 3.3× 吞吐提升(vs Qwen3-30B-A3B),RULER 1M token SOTA |
| LatentMoE | 将专家路由维度压缩至 latent space,节省的通信/内存用于扩大专家数量和 top-K | Table 1:相同 active/total params 下,所有任务均超越 Standard MoE(MMLU-Pro +4.57pt,Code +3.19pt) |
| MTP 集成 | Super/Ultra 集成 MTP 层,同时提升推理效率和模型质量 | Table 2:8B MoE 基准上平均 +2.4% 准确率,MTP 第一二 token 接受率 ~97% |
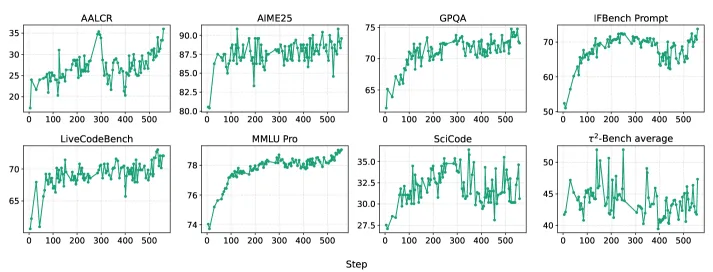
- Figure 4:Nano <1% 相对 loss 差;Figure 5:下游任务轨迹与 BF16 一致 | 多环境 RL 同时训练 | 所有 RL 环境在一次训练中同时优化,优于分阶段训练 | Figure 7:多任务基准在 RL 过程中稳步提升 | | 推理预算控制 | 用户可指定思考 token 预算,模型自适应截断生成 | Figure 8:提供细粒度准确率-效率权衡 |
五、代码实现分析
开源资源
- NeMo-RL: https://github.com/NVIDIA-NeMo/RL — 可扩展 RL 训练实现
- NeMo-Gym: https://github.com/NVIDIA-NeMo/Gym — RL 环境集合
- 许可证: Apache 2.0
- 数据: 超过 10T tokens 的训练数据
架构实现要点
- MoE 路由:LatentMoE 在 latent space () 进行,非路由计算(gating、shared expert)保持在
- MTP 模块:轻量级 MTP 头,位于网络末端,保持 BF16 精度
- NVFP4 GEMM:基于 cuBLAS 后端(Transformer Engine),支持 fprop/dgrad/wgrad
- RL 训练:GRPO 算法 + masked importance sampling,异步 rollout 生成
六、实验结果
Table 1: LatentMoE vs Standard MoE 准确率对比
| 模型 | MMLU-Pro | MMLU | Code | Math | Commonsense |
|---|---|---|---|---|---|
| Standard MoE (8.09B active / 72.6B total) | 48.30 | 70.10 | 51.95 | 78.32 | 81.73 |
| LatentMoE (8.02B active / 72.8B total) | 52.87 | 72.11 | 55.14 | 80.19 | 82.10 |
两个模型均 8B active / ~73B total params,训练 1T tokens。LatentMoE 在所有任务上均超越 Standard MoE。
Table 2: MTP 消融(8B active Transformer MoE 基准)
| 任务 | Baseline | Baseline + MTP | 提升 |
|---|---|---|---|
| MMLU (5-shot) | 70.06 | 71.26 | +1.20 |
| MMLU-Pro (5-shot CoT EM) | 45.05 | 47.84 | +2.79 |
| MBPP-Sanitized (3-shot) | 65.58 | 66.89 | +1.31 |
| ARC-Challenge (25-shot) | 86.43 | 88.05 | +1.62 |
| WinoGrande (0-shot) | 74.59 | 75.45 | +0.86 |
| RACE (0-shot) | 84.02 | 85.36 | +1.34 |
| GSM8K (8-shot) | 82.49 | 84.46 | +1.97 |
Table 3: RULER 长上下文评分(MoE hybrid vs Dense hybrid)
| 模型 | 128k | 256k | 512k | 1M |
|---|---|---|---|---|
| Nemotron-Nano-12B-v2-Base (Dense Hybrid) | 85.13 | 79.85 | 75.12 | 23.43 |
| Nemotron-3-Nano-30B-A3B-Base (MoE Hybrid) | 74.48 | 71.67 | 66.02 | 54.19 |
MoE hybrid 在 1M token 场景下展现出优雅的降阶(graceful degradation),而 dense hybrid 出现急剧下降。
NVFP4 训练结果
- Nano A3B:NVFP4 vs BF16 相对 loss 差 < 1%
- 更大 A8B 模型:相对 loss 差 < 0.6%
- Figure 5 显示 NVFP4 训练的下游任务评估轨迹与 BF16 一致
七、相关工作
MoE 架构
- DeepSeek-V3:使用标准 MoE + MTP
- Nemotron-H:之前的混合 Mamba-Transformer 工作
- SWAN:Transformer 的长上下文替代方案(RoPE-free)
量化训练
- NVFP4 Pretraining (NVIDIA 2025c):模拟 NVFP4 数值(quantize-dequantize around BF16 GEMM)
- Scaling Law for Quantization-Aware Training (Chen et al. 2025):量化诱导的 loss gap 随模型规模减小
长上下文
- RULER (Hsieh et al. 2024):真实上下文长度评估基准
- Mamba-2 (Dao & Gu 2024):结构化状态空间模型,固定推理内存
RL 后训练
- GRPO (Shao et al. 2024):DeepSeekMath 提出的 RL 算法
- Speculative Decoding (Leviathan et al. 2023):MTP 加速推理的基础
八、总结
核心贡献
- Nemotron 3 系列模型:Nano(已发布)、Super/Ultra(即将发布),混合 Mamba-Transformer MoE 架构
- LatentMoE:硬件感知的专家设计,通过 latent space 路由实现准确率提升而不增加推理成本
- NVFP4 全精度预训练:在 Mamba-MoE 架构上首次实现 NVFP4 预训练(最多 25T tokens),使用 native NVFP4 GEMM
- MTP 集成:Super/Ultra 的 MTP 层,~97% 第一二 token 接受率,同时提升推理效率和模型质量
- 多环境 RL 同时训练:证明同时训练优于分阶段训练,NeMo-RL/NeMo-Gym 开源
- 1M token 上下文支持:无 RoPE 设计,优雅的长上下文外推能力
技术影响
Nemotron 3 将高效架构(Mamba-2 + MoE + LatentMoE)与先进训练技术(NVFP4 + MTP + 多环境 RL)结合,为 agentic AI 应用提供了兼具高准确率和推理效率的开源基础模型。完整开源(权重、数据、软件)使其成为研究和生产部署的重要参考。
局限性
- Super 和 Ultra 模型尚未发布(仅 Nano 随本文发布)
- 本文是 white paper 性质,详细 benchmark 在 Nemotron Nano 3 技术报告中
- NVFP4 训练需要 NVIDIA GB300 等支持 FP4 的硬件才能获得 3× 吞吐优势
九、参考资源
- arXiv: https://arxiv.org/abs/2512.20856
- NeMo-RL: https://github.com/NVIDIA-NeMo/RL
- NeMo-Gym: https://github.com/NVIDIA-NeMo/Gym
- Nemotron Nano 3 技术报告: (另行发布)
- NVFP4 Pretraining: https://arxiv.org/abs/2509.25149
- MTP Paper: https://arxiv.org/abs/2402.17764
- GRPO: https://arxiv.org/abs/2402.03300