TraCT: Disaggregated LLM Serving with CXL Shared Memory KV Cache at Rack-Scale
提出基于 CXL 共享内存的机架级 KV Cache 系统 TraCT,消除 RDMA 网络跳数,实现 GPU-CXL 直接 DMA 传输,TTFT 降低 9.8x,吞吐量提升 1.6x
TraCT: Disaggregated LLM Serving with CXL Shared Memory KV Cache at Rack-Scale
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | TraCT: Disaggregated LLM Serving with CXL Shared Memory KV Cache at Rack-Scale |
| 作者 | Dongha Yoon, Younghoon Min, Hoshik Kim, Sam H. Noh, Jongryool Kim |
| 机构 | Virginia Tech, SK Hynix America |
| 论文 | arXiv:2512.18194 |
| 发布 | 2025-12-20 |
| 许可 | CC BY-NC-ND 4.0 |
| 页数 | 15 pages, 11 figures, 1 table |
二、核心思想
问题定义
分离式 LLM 服务(Disaggregated LLM Serving)将计算密集的 prefill 阶段与延迟关键的 decode 阶段分离,但引入了新的瓶颈:KV tensor 传输。现有系统(DistServe, Splitwise, Preble, Dynamo)依赖 RDMA 网络进行 prefill → decode 的 KV 传输,存在以下问题:
- NIC 瓶颈: KV 数据需经过 NIC 队列、主机 DRAM 缓冲区、传输协议层,每请求数百 MB 的 KV 数据传输成为 TTFT 和吞吐量的主要瓶颈
- 网络拥塞敏感: 即使 prefix 命中率高,每次 KV cache 命中仍需通过网络传输
- 尾延迟不可预测: 网络抖动导致 P99 延迟波动大
解决方案概述
TraCT (KV Transfer and prefix-aware Caching Together) 提出基于 CXL 共享内存的机架级 KV Cache 系统:
- CXL 作为传输层: GPU 通过 CXL load/store 和 DMA 直接读写 CXL 共享内存,完全消除 NIC 跳数
- 机架级前缀感知缓存: CXL 共享内存作为机架范围的前缀感知 KV Cache,任何 LLM 服务器均可直接访问
- 去中心化 KV 管理: 无元数据服务器,所有 worker 直接通过 load/store 操作共享元数据
- 两层软件同步机制: 解决 CXL Type-3 设备缺乏跨节点原子操作和一致性的挑战
三、技术架构
整体框架图
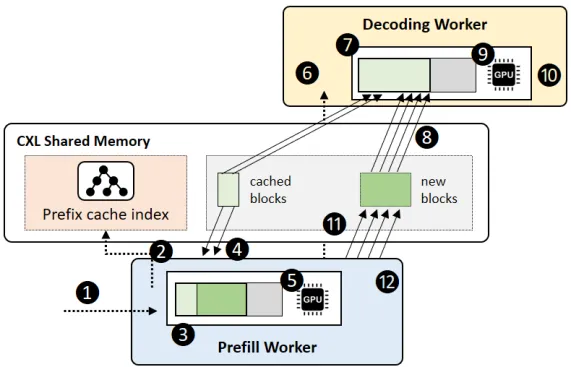
TraCT 架构:
- 每个机架包含多个 prefill 和 decode worker,共享一个 CXL Type-3 设备
- CXL 设备通过 DAX 映射为所有参与服务器的字节可寻址区域
- GPU 通过 PCIe/CXL 直接执行 DMA 操作读写 CXL 内存
- 无需 NIC 参与 KV 传输
核心问题与解决方案
挑战 1: 跨节点互斥(无硬件原子操作)
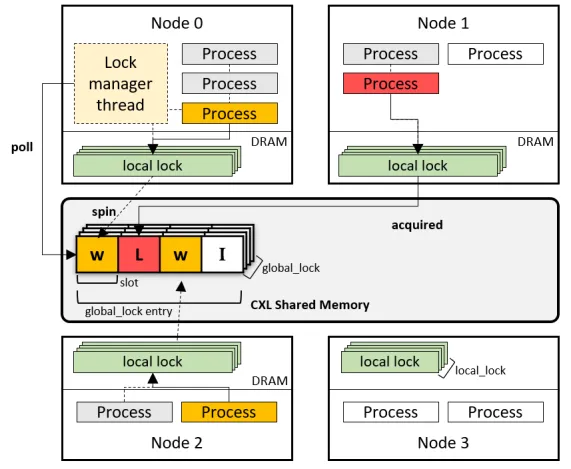
两层互斥锁机制:
| 层级 | 存储位置 | 实现 | 作用 |
|---|---|---|---|
| 本地锁 (Local Lock) | 节点 DRAM | pthread_mutex | 节点内互斥,最多 1 个线程竞争全局锁 |
| 全局锁 (Global Lock) | CXL 共享内存 | 基于 load/store 的自旋锁 | 跨节点仲裁,由 lock manager 管理 |
工作流程:
- 进程先获取本地锁(DRAM),确保每节点最多 1 个线程参与
- 在 CXL 共享内存中设置 global_lock 条目为 WAITING
- Lock manager 扫描 global_locks,选择一个 WAITING 节点授予 LOCKED
- 进程观察到 LOCKED 后进入临界区
- 退出时重置为 IDLE 并释放本地锁
优势: 全局锁条目数 = 节点数(通常 < 10),远小于参与进程数,避免了 cMPI 的 O(N²) 队列问题。
挑战 2: 缓存一致性(非一致性 CXL 内存)
元数据可见性策略:
| 数据类型 | 可见性方法 | 原因 |
|---|---|---|
| 元数据 | 细粒度 cacheline flushing (clflush) | 元数据紧凑,仅 flush 修改的 cacheline |
| KV Payload | 无需 flush | GPU-CXL DMA 绕过 CPU 缓存,payload 不进入 CPU cache |
| 发布边界 | 元数据 flush 后即为可见边界 | DMA 完成后发布元数据,其他节点可安全消费 |
关键选择: 使用 clflush 而非 clflushopt:
clflushopt是异步的,仅排队 flush,不保证数据到达 CXL 设备clflush确保 cacheline 在指令完成前从本地缓存层次驱逐- 虽然延迟更高,但提供跨节点正确性保证
挑战 3: 共享内存数据结构(无共享指针)
偏移量寻址:
所有共享结构使用 64 位偏移量(从 CXL 区域起始),而非虚拟地址。
内存分配器:
- 全局块分配器(CXL 共享内存中的 bitmap)
- 每节点本地堆分配器(DRAM 中的 free-list)
- 将元数据竞争从跨节点范围缩小到节点内范围
共享对象存储:
- 仅发布少量根对象(如前缀索引哈希表)
- 内部结构通过偏移量链接
- 支持层次化数据结构
前缀缓存管理
块哈希:
其中 是前一块的哈希, 是当前块的 token ID 列表。保持前缀关系:相同前缀产生相同块哈希。
数据结构: 固定大小哈希表 + 线性探测(避免动态树结构的频繁指针更新)
LRU 驱逐: 维护共享内存中的 LRU 链表,驱逐零引用计数的最老条目
推理服务流程
| 步骤 | Prefill Worker | Decode Worker |
|---|---|---|
| 1 | 请求入队 | - |
| 2 | 查找前缀缓存 | - |
| 3 | 调度 + 分配 GPU 内存 | - |
| 4 | 命中块: CXL→GPU DMA | - |
| 5 | 计算缺失块 KV,通知 decode | 请求入队 |
| 6 | - | 调度 + 分配 GPU 内存 |
| 7 | - | 读取所有 KV 块 (CXL→GPU) |
| 8 | - | 逐 token 生成 |
| 9 | 发布缓存条目,GPU→CXL DMA | 释放 GPU 内存 |
| 10 | 释放 GPU 资源 | - |
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| CXL 替代 RDMA 传输 | GPU-CXL 直接 DMA,消除 NIC 跳数 | Figure 5-6: TTFT 和吞吐量与 RDMA 相当或更优 |
| 两层互斥锁 | 本地锁 + 全局锁,避免 O(N²) 队列 | Section 3.3: 支持去中心化同步 |
| clflush 正确性 | 使用同步 clflush 而非异步 clflushopt | Section 3.4: 保证跨节点元数据可见性 |
| 偏移量寻址 | 64 位偏移量替代虚拟地址 | Section 4.3: 跨节点地址空间一致性 |
| GPU-CXL 零拷贝 | CUDA host-memory registration 避免 bounce buffer | Section 4.4: 真正的 GPU-CXL 零拷贝传输 |
| 机架级前缀缓存 | CXL 共享内存作为前缀感知 KV Cache | Figure 7-9: 吞吐量和延迟显著改善 |
五、代码实现分析
实现基础: Dynamo v0.5.0 + vLLM v0.10.1.1
代码量: ~5K 行 C/C++(CXL 共享内存库 + KV connector)+ Python 包装器
软件栈:
- CXL 共享内存库: 提供锁、分配、对象共享 API
- KV Connector: 扩展 vLLM 的 KV connector 层
- Dynamo 集成: 与 prefill/decode 管道无缝集成
CXL 库 API:
// 锁操作
int cxl_shm_allocate_lock(cxl_lock_t *lock);
int cxl_shm_acquire_lock(cxl_lock_t lock);
int cxl_shm_release_lock(cxl_lock_t lock);

// 内存分配
void *shmalloc(size_t size);
void shfree(void *ptr);

// 对象共享
int cxl_shm_put(char *key, void *ptr);
int cxl_shm_get(char *key, void **ptr);
六、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| 服务器 | 2 台,各配 NVIDIA A6000 (48GB GDDR) + 512GB DRAM |
| CXL 设备 | Niagara 2.0 (第二代 CXL Type-3), 64GB 共享空间 |
| CXL 性能 | 延迟 640ns, 带宽 10.1 GB/s |
| 网络 | 100 Gbps Mellanox MT2892 NIC (基线) |
| 模型 | DeepSeek-R1-Distill-Llama-8B |
| 基线 | NIXL/UCX (无缓存), LMCache (48GB DRAM 缓存) |
CXL 传输性能
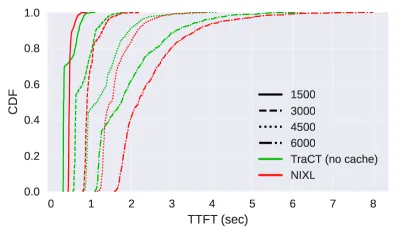
- CXL 共享内存可替代 RDMA 进行 KV 传输
- 所有输入长度下,TraCT TTFT 分布均向左移动(更低延迟)
- 6000 token 时优势最明显
峰值吞吐量
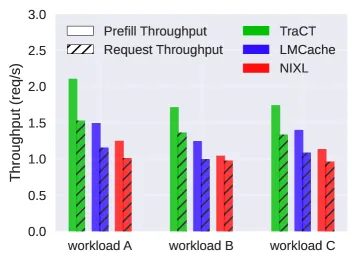
- TraCT 峰值吞吐量比 LMCache 高 1.6×
- 即使缓存命中率与 LMCache 相当或更低,TraCT 吞吐量仍更高
- 原因: 解码 worker 直接从 CXL 共享内存获取 KV,无需网络传输
TTFT 延迟
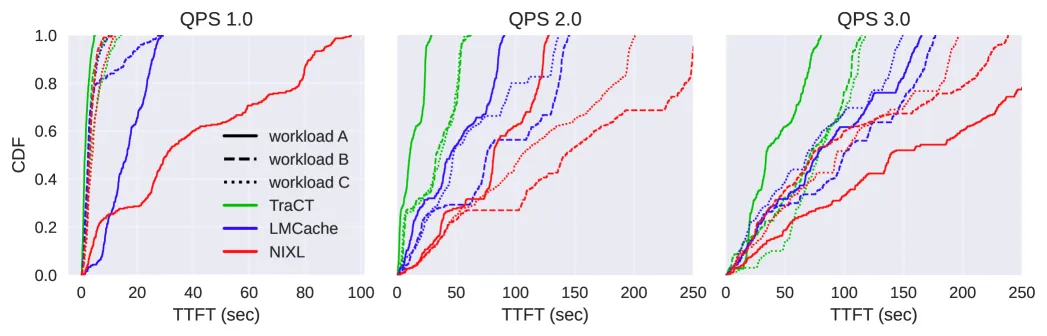
| 指标 | vs NIXL | vs LMCache |
|---|---|---|
| 平均 TTFT | 降低 9.8× | 降低 9.83× |
| P99 TTFT | 降低 6.2× | 降低 6.2× |
TraCT CDF 曲线更陡峭,表明延迟分布更紧凑、更可预测。
时间分解
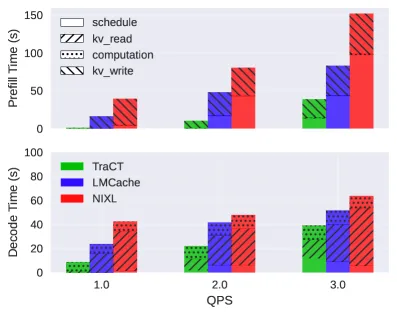
| 组件 | TraCT vs LMCache/NIXL |
|---|---|
| KV Read | 几乎恒定(直接 CXL→GPU DMA) |
| Compute | 缓存命中跳过 KV 重计算 |
| KV Write | 发布缓存条目 + DMA |
| 总体 | 显著减少 prefill 时间 |
GPU 资源利用
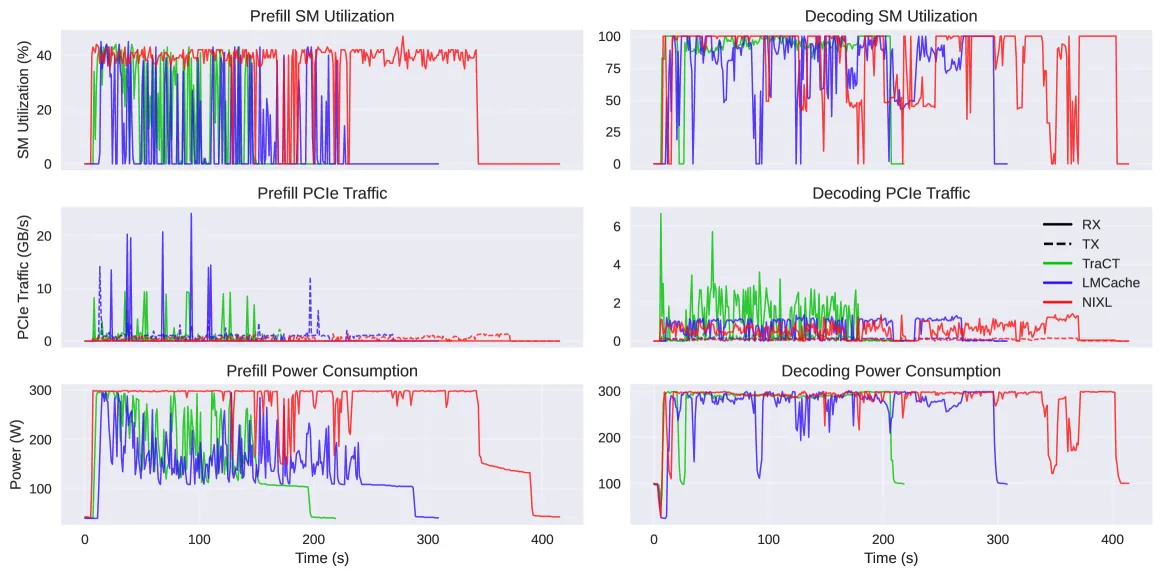
- TraCT 降低 GPU SM 利用率(缓存命中跳过 KV 重计算)
- TraCT 提供更稳定的 GPU RX 带宽(直接 CXL→GPU,无网络抖动)
- LMCache 预取端 RX 带宽峰值更高(PCIe 饱和的 DMA 流量)
- 解码端 TraCT GPU RX 带宽更高(无 RDMA 约束)
综合性能总结
| 指标 | TraCT 最佳提升 |
|---|---|
| 平均 TTFT | 9.8× |
| P99 TTFT | 6.2× |
| 峰值吞吐量 | 1.6× |
| GPU 功耗 | 降低(SM 利用率降低) |
七、相关工作
| 工作 | 方法 | 本文改进 |
|---|---|---|
| DistServe/Splitwise/Preble | RDMA 网络传输 KV | TraCT 用 CXL 共享内存替代 RDMA |
| LMCache/Mooncake | DRAM/SSD 多层 KV Cache | TraCT 将缓存放在 CXL 共享内存,GPU 直接 DMA |
| CXL-SHM | 假设设备端 CAS 支持 | TraCT 无硬件原子操作,纯软件同步 |
| Tigon | CXL 一致性限于小区域 | TraCT 处理全设备非一致性 |
| cMPI | N×N 队列矩阵 | TraCT 两层锁,O(N) 内存 |
| Beluga | 集中式元数据服务器 | TraCT 去中心化,直接 load/store |
八、总结
核心贡献
- CXL 替代 RDMA: 首次在真实 CXL Type-3 硬件上证明 CXL 共享内存可替代 RDMA 进行机架级 KV 传输
- 两层互斥锁: 解决 CXL 设备缺乏跨节点原子操作的挑战,避免 O(N²) 队列问题
- 软件缓存一致性: 使用 clflush(非 clflushopt)保证跨节点元数据可见性
- 去中心化 KV 管理: 无元数据服务器,所有 worker 直接操作共享内存
- 显著性能提升: TTFT 降低 9.8×,P99 降低 6.2×,吞吐量提升 1.6×
技术影响
- CXL 在 LLM 推理中的实际应用: 在真实硬件上验证了 CXL 共享内存的可行性
- 消除网络瓶颈: 将 prefill-decode 通信从网络操作转变为本地 load/store 和 DMA
- 降低 TCO: 更低的 GPU 功耗和更高的吞吐量
- 为 CXL 3.0 奠定基础: 当前设计可扩展到支持硬件一致性的下一代 CXL 设备
局限性
- 硬件依赖: 需要 CXL Type-3 设备支持(当前部署有限)
- 单机架规模: 仅验证 2 节点场景,大规模扩展性待验证
- LRU 策略简单: 未探索更复杂的替换策略
- 模型限制: 仅测试 DeepSeek-R1-Distill-Llama-8B
- NUMA 绑定: 所有线程绑定到 CXL 设备所在 NUMA 节点
九、参考资源
- 论文链接: arXiv:2512.18194
- PDF 下载: arXiv PDF
- 实现基础: Dynamo v0.5.0, vLLM v0.10.1.1
- CXL 设备: Niagara 2.0 (第二代 CXL Type-3)
- 测试模型: DeepSeek-R1-Distill-Llama-8B
- 测试硬件: NVIDIA A6000 (48GB), 512GB DRAM, 100Gbps NIC
- 基线系统: NIXL/UCX, LMCache