Optimal Software Pipelining and Warp Specialization for Tensor Core GPUs(Twill:面向 Tensor Core GPU 的最优软件流水线与 Warp 特化)
arXiv 2512.18134,来自 CudaDMA/Singe 同一血统的团队(Bauer/Aiken + Stanford/NVIDIA/Toronto)。首次把软件流水线(Software Pipelining, SWP)与 warp 特化(Warp Specialization, WS)表述为一个可交给现成约束求解器求解的联合优化问题。核心洞见:SWP 与 WS 不应分开处理——WS 恰恰是实现 Tensor Core GPU 上 SWP schedule 所必需的代码生成手段(解决多 warp 协作发射 TC、寄存器工作集、变长延迟操作、阻塞同步中断四大难题)。方法上先用模调度(modulo scheduling,ℤLP 最优求解)得到初始 initiation interval I 与 modulo schedule M,再将 M/I 展开为一段直线程序 Q,在其上叠加 SWP 约束(Uniqueness/Consistency/Completion/Dependence/Capacity)、内存感知约束(活跃变量 live 传播 + 内存容量/SSA)、warp 分配约束(Warp Uniqueness/Variable Latency/Register Limit/Cross-Warp Spills/Concurrency),交给 SMT 求解器(Yices2 QFLIA)联合求解得到 M*、I*、A*。关键实现技巧:成本归一化(cycle count 比值保持的 ℤLP,令问题可解)、变长流式操作(TMA load)零延迟建模 + 深度作为 autotuning 参数、不可满足时单调增大 I/L 重试。系统 Twill 从 Triton TTGIR 抽取依赖图,无启发式、易扩展新架构、对单层循环保证最优。评估在 H100(Hopper)/B200(Blackwell) 上对 Flash Attention 前向/后向传播自动重新发现 FA3(ping-pong scheduling)与 FA4(三组 warp 策略)专家手工方案,性能达 cuDNN/FA 手工实现的 1%~2% 以内。
Optimal Software Pipelining and Warp Specialization for Tensor Core GPUs(Twill:面向 Tensor Core GPU 的最优软件流水线与 Warp 特化)
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Optimal Software Pipelining and Warp Specialization for Tensor Core GPUs |
| 作者 | Rupanshu Soi, Rohan Yadav, Fredrik Kjolstad, Alex Aiken, Maryam Mehri Dehnavi, Michael Garland, Michael Bauer |
| 机构 | Stanford / NVIDIA / University of Toronto(含 CudaDMA、Singe 作者 Bauer、Aiken) |
| 论文 | arXiv:2512.18134(2025-12-19 提交) |
| 分类 | cs.PL(编程语言)、cs.AR(硬件架构)、cs.LG |
| 系统名 | Twill(斜纹织物,交织 warp 与 weft 线,呼应 warp specialization) |
一句话总结:这是 CudaDMA(SC’11) → Singe(PPoPP’14) → Twill(2025) 这条 warp 特化研究血脉的最新篇章。前两篇教人如何做 warp 特化;Twill 则回答如何做到最优——首次把软件流水线(SWP)与 warp 特化(WS)表述为一个联合约束满足问题,交给现成 ℤLP + SMT 求解器求解,从第一性原理自动重新发现专家为 Hopper(FA3)和 Blackwell(FA4)手工设计的 Flash Attention 调度,并证明其最优性。
二、核心思想
问题定义
新一代 Tensor Core GPU(Hopper/Blackwell)的定点功能单元(GEMM 的 Tensor Core、数据搬运的 TMA)越来越强大,导致:
- 性能可移植性难题:数据搬运与 FLOPS 在通用核与定点单元间的相对比例每代都成倍变化;定点单元接口(数据放置位置、发射所需线程数、异步执行模型)每代都大改。→ 每个程序在每代架构上可能都有不同的最优调度。
- 两种关键变换但组合方式不明:
- 软件流水线(SWP):重排循环内/跨迭代指令以最大化功能单元利用率(挖掘 ILP)。
- warp 特化(WS):不同 warp 子集协作执行程序不同部分,经共享内存交换数据、按需同步。
- 现状之痛:SWP 与 WS 目前靠人类直觉(cutlass、FA3、FA4)或脆弱的编译器启发式(Triton、Cypress、Tawa)决定,二者交互无理论框架。典型代价:Hopper 发布后过了一年才有人做出 FA3,期间浪费无数推理算力。
解决方案概述
核心洞见:SWP 与 WS 必须联合求解。WS 之所以有用,正是因为它直接解决了在 TC GPU 上实现 SWP schedule 的四大代码生成难题(见 §四)。因此把二者当成两个独立步骤会导致次优。
Twill 的两步法:
- 模调度(modulo scheduling,用 ℤLP 最优求解)得到最小 initiation interval 与 modulo schedule 。
- 用 、 展开成直线程序 ,叠加 SWP + 内存 + WS 约束,交给 SMT 求解器(Yices2)联合求解,得到 (可能不同于 但同 )、、warp 分配 。
三、背景:GPU 架构(Section 2)
- SM 含通用浮点/整数单元、load/store 单元、寄存器文件、软件管理的 shared memory。
- SIMT + 顺序发射:warp 内每线程有独立指令流,但同一周期只有执行相同指令的线程子集发射;每线程顺序执行——下一条指令若阻塞在依赖/同步上,则无法继续发射。
- Hopper/Blackwell 每 SM 有 4 个执行上下文,故每周期至多 4 个 warp 发射;warp 多于上下文时由 warp scheduler 动态选择就绪 warp。
- 异步加速器:Tensor Core(Volta 起,加速 GEMM)、TMA(Hopper 起,异步在 global↔shared 间搬运整块 tile)。单条 TMA/TC 指令可执行数千周期,而普通算术指令仅数十周期。
- Blackwell 两大变化:① TC 支持更大 tile、更高吞吐;② 新增 Tensor Memory(TC 的输入源与累加器存储),对累加器做通用计算需显式搬到寄存器文件——这些改动使程序结构需大幅调整才能达峰值。
四、调度理论与四大代码生成难题(Section 3)
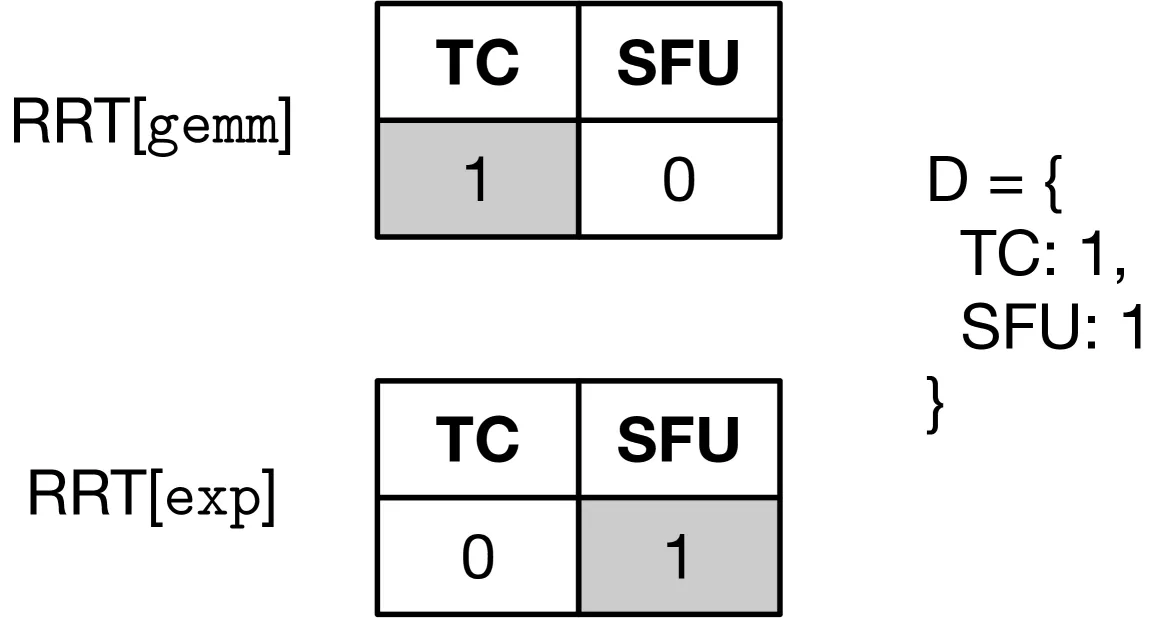
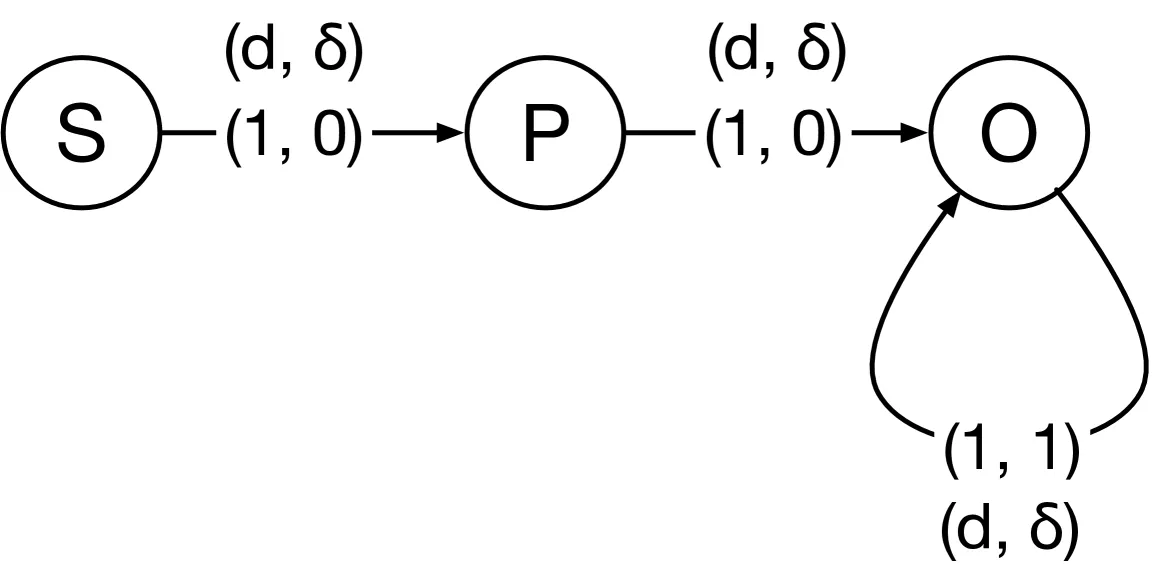
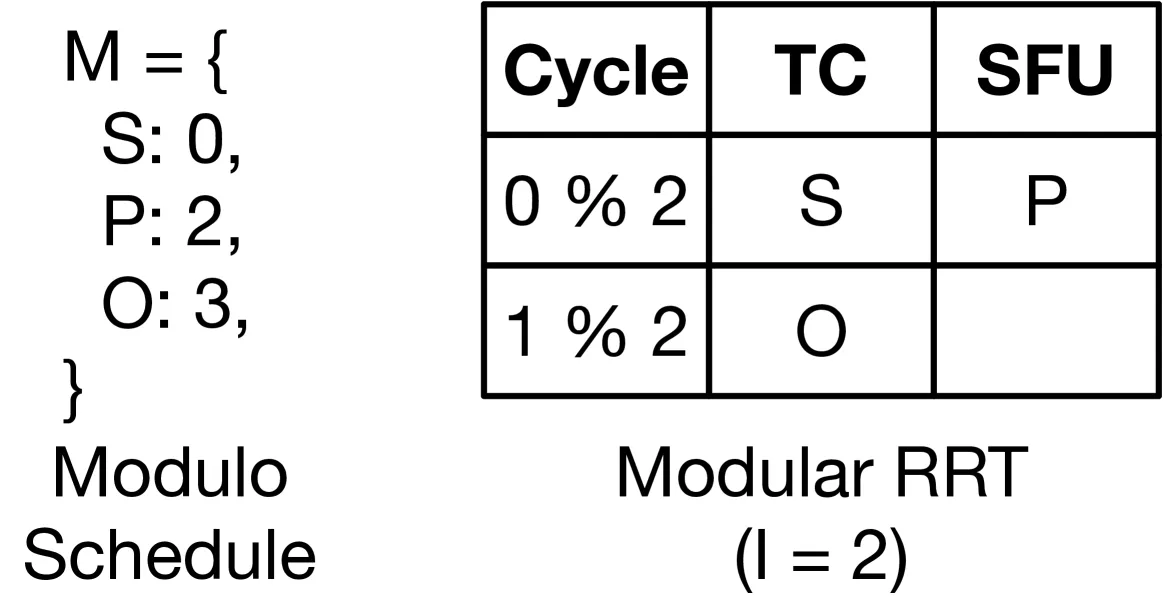
4.1 模调度术语(§3.1)
输入循环表示为依赖图 (假设单层循环、无控制流):
- 每个指令 关联一个资源预留表 RRT:二维整数数组,列=功能单元种类、行=执行周期、元素=该周期占用该单元的实例数。机器描述 给出每种功能单元的容量 cap。
- 每条边 : 是周期延迟( 须在 发射后至少 周期发射), 是迭代延迟( 的第 迭代实例须在 的第 迭代实例后至少 周期)。 即环载依赖到下一迭代。
模调度求 initiation interval (新迭代发射间隔,与吞吐成反比, 最优)与 modulo schedule (每指令相对迭代起点的发射周期)。若 ,则 在 发射。合法性 = 满足所有依赖边 + 功能单元不超容量。
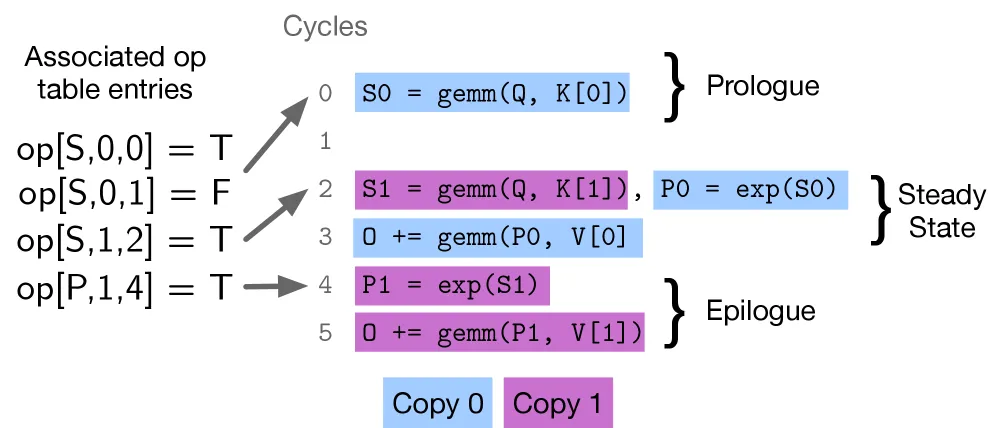
代码生成:设 为 长度,重叠 份 (每份错开 周期)→ 得 prologue(前 周期)+ steady state( 周期循环体)+ epilogue。运行示例中,顺序执行 1 迭代/3 周期,流水后 1 迭代/2 周期。对简化 Flash Attention 应用模调度,恰好复现 FA3 专家设计的流水线(把一个 GEMM 提到 prologue 以隐藏 exp 延迟)。
4.2 四大代码生成难题(§3.2)
Hopper/Blackwell 上大多数 modulo schedule 无法用标准单线程 SIMT 代码实现,四个原因:
| # | 难题 | 说明 |
|---|---|---|
| 1 | 多 warp 协作发射 TC | 大 GEMM 需多个 warp 协同发射,而多数 GPU 编译器基于顺序 IR(LLVM/PTX),无力生成协作 warp 代码 |
| 2 | 寄存器工作集溢出 | modulo schedule 为保持多迭代 live 变量在片上而增大工作集;加上大 TC 需更多数据 → 超 255 寄存器/线程上限,溢出严重掉性能 |
| 3 | 变长延迟操作 | TMA 等跨内存层级搬运的最快/最慢执行时间差超一个数量级;传统模调度用上界估计,但高估→单元闲置、低估→流水线停顿 |
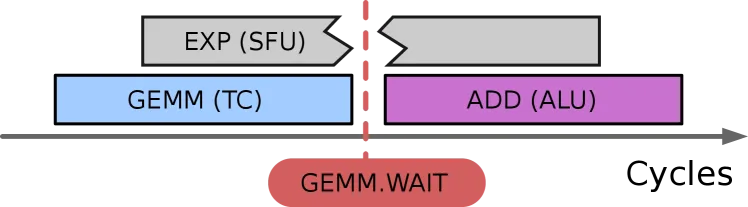
| 4 | 阻塞同步中断发射 | TC/TMA 异步接口需显式阻塞同步消费结果;因线程顺序发射,阻塞同步会中断同一 warp 上并发调度的其他操作(见 Figure 2) |
4.3 Warp 特化恰好解决四大难题(§3.3)
关键洞见:WS 有用正是因为它逐一对应解决上述四难题:
- WS 天然推理 warp 协作 → 可让 warp 子集协作发射 TC 操作。
- 把计算拆到多 warp → 可用多线程的寄存器资源装下大工作集。
- 变长延迟操作可放到专用 warp 动态调度,不干扰定长操作的静态调度。
- 拆到多 warp → 某些 warp 阻塞同步时其他 warp 仍可发射。
但 WS 有两大代价:① 非免费——warp 间数据通信与同步开销,现有自动方法全靠 ad-hoc 启发式(loader/compute warp 角色划分),无最优性框架;② 即便用 WS 也未必能实现某个 modulo schedule(如工作集仍装不下寄存器)。→ 必须把 WS 的代码生成约束直接纳入优化过程,与模调度联合考虑。
五、联合优化问题(Section 4)
目标:输入 ,输出最小 的 modulo schedule + 能实现它的 warp 分配 (每个 分到一个或多个 warp)。
关键简化:把 、 用模调度代码生成过程展开为直线程序 (prologue + steady state + epilogue);假设 steady state 恰好执行一次,从而把三部分当作长度 的直线程序处理——此假设既 sound(允许 steady state 执行一次)又 complete(steady state 各次执行相同),大幅简化约束(无需循环分析)。
5.1 带约束的模调度(§4.1,Figure 4)
定义三维布尔数组 表示第 迭代的操作 调度在周期 。五条约束:
| 约束 | 公式 | 含义 |
|---|---|---|
| Uniqueness | 每操作恰调度一次 | |
| Consistency | 可由某 modulo schedule 得到 | |
| Completion | 所有操作在 前完成 | |
| Dependence | 满足数据依赖 | |
| Capacity | 功能单元不超容量 |
满足赋值即诱导合法 、()。
5.2 内存感知约束(§4.2,Figure 5)
假设 为 SSA 形式,定义 表示第 个 实例在 时刻活跃:
- Memory Capacity:
- Init:环载依赖()的变量在末迭代末周期 live。
- LiveProp-1/2、DeadProp-1/2:沿时间轴反向传播 live/dead 状态(定义处终止、末次使用处开始)。
5.3 Warp 分配约束(§4.3,Figure 6)
定义 表示操作 分到 warp ( 直接定义 ):
| 约束 | 含义 |
|---|---|
| Warp Uniqueness | 每操作恰分到一个 warp(可扩展到跨多 warp 的 warp-group 级操作) |
| Variable Latency | 变长/静态未知延迟操作分到专用 warp ,与定长操作分离 |
| Register Limit | ,强制 的划分不超每 warp 寄存器上限 |
| Cross-Warp Spills | warp 寄存器数据在 上不可访问,除非经 shared memory 传输;消费操作调度须计入传输代价 → 在内存容量、延迟、跨 warp 溢出代价间权衡 |
| Concurrency | 若 需阻塞同步(blocking edge),则 起始时其 warp 上不能有其他操作在执行 → 迫使并发操作放不同 warp 或不同时刻(对应 Figure 2 难题) |
六、实现(Section 5)
- 前端:从 Triton 的中层 IR TTGIR(基于 tile 的 SSA IR)抽取依赖图。用户须指定目标 GPU 架构(用于估算指令/数据搬运成本、声明可用内存、标注需阻塞同步的操作)。
- 求解器:初始模调度用 ℤLP 交给 CBC solver;SMT 约束用 Yices2 的 QFLIA(无量词线性整数算术)理论。产出软件流水化 IR,每指令标注执行 warp——可交给下游编译器(Tawa/Cypress)或供专家做手工参考实现。
6.1 处理不可满足(§5.1,Algorithm 1)
约束不可满足 = 某资源限制/并发交互阻止了当前 。仿照标准模调度:不可满足时用模调度找 的新候选 重试;并在不改变 的前提下搜索更大的 。从最小 单调上搜 → 保证找到最高吞吐的可行调度。
6.2 成本归一化(§5.2)—— 让问题可解的关键
难点:Hopper 上 128×128×128 GEMM 约 1000 周期;最优模调度与联合形式化不仅对 指数级,更对 指数级 → 直接用估算 cycle count 会使 ℤLP/SMT 不可解。
洞见:把所有 cycle count 乘以正整数得到同构问题——重要的是比值而非绝对值。于是用一个独立的 ℤLP 求解:给定原 cycle 列表 ,求更小的 使 (引入变量 界定比值变化,并对 上下界约束避免全零退化解):
6.3 变长延迟优化(§5.3)
无入边依赖的变长操作称流式操作(streaming operations,如输入 tile 的 TMA load):放到独立 warp 上可跑在主流水线前面,提前完成若干迭代。故在成本模型中给它们赋零延迟,让依赖它们的定长操作精确调度;把流水深度作为参数暴露给外部 autotuning 系统。
6.4 局限(§5.4)
- 仅支持单层循环、无额外控制流(可用层次化归约扩展,留作未来工作)。
- tile 大小不由 Twill 决定,需人工或上层 autotuning 选取。
- 求解时间数十秒~几分钟——快速求解非目标,用求解时间换最优性保证;定位为开发者辅助工具或部署前离线编译工具。
七、实验结果(Section 6)
平台:H100 SXM5 80GB(Hopper)、B200 180GB(Blackwell),CUDA 13.0,求解在 Intel Xeon Platinum 8570 单核。基准:Fused Multi-Head Attention 前向/后向传播(FP16,非因果,BATCH=4, HEADS=32, HEAD_DIM=128)。
实现说明:因 Triton 后端在内存分配、layout 转换、同步放置上决策错误,作者手工把 Twill 的流水线 IR 翻译成 CUDA C++(编译器自动化其余正交降级步骤超出本文范围)。
7.1 前向传播
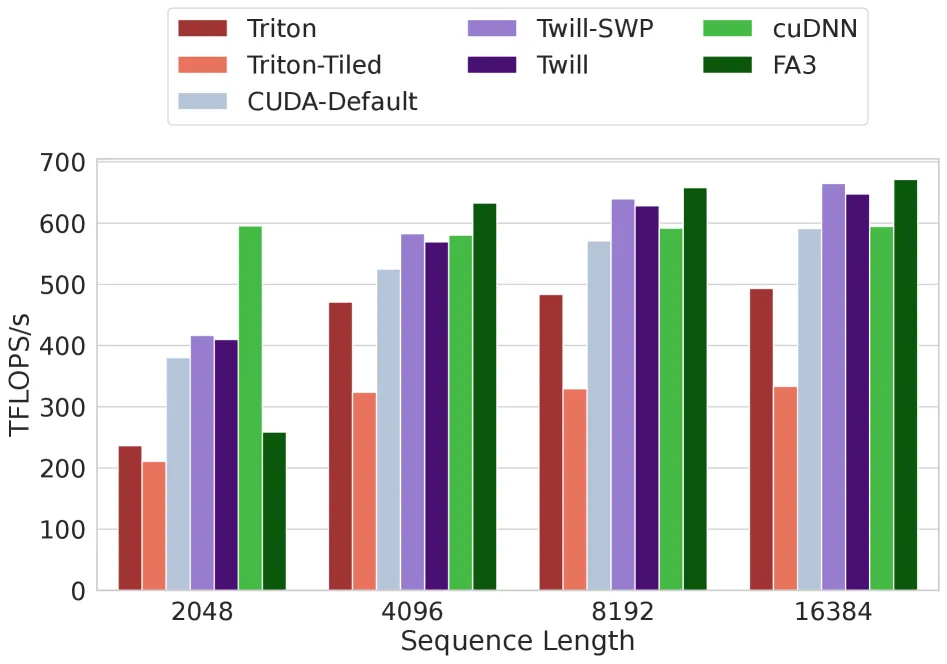
Hopper(求解 28 秒):
- Twill-SWP(仅模调度 + Triton 的 WS):自动发现 FA3 的流水线(GEMM 提到 prologue 隐藏 exp 延迟),在 16384 序列长下达官方 FA3 的 1% 以内。
- Twill(联合 SWP+WS):功能单元容量约束自动复现 FA3 的 ping-pong scheduling(一组 warp 发 exp、另一组用 TC,因 TC 一次只容一操作);且发现只需对一个 warp group 应用流水线即可饱和单元。~645 TFLOPS/s。
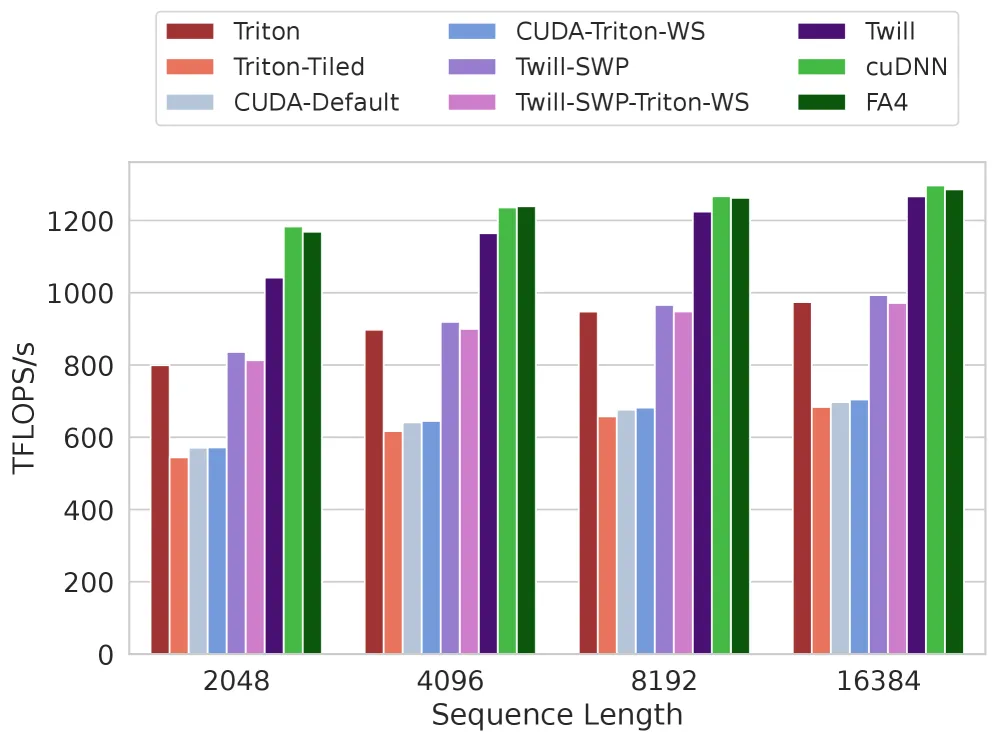
Blackwell(求解 19 秒):Twill 找到的策略与 FA4 完全相同!
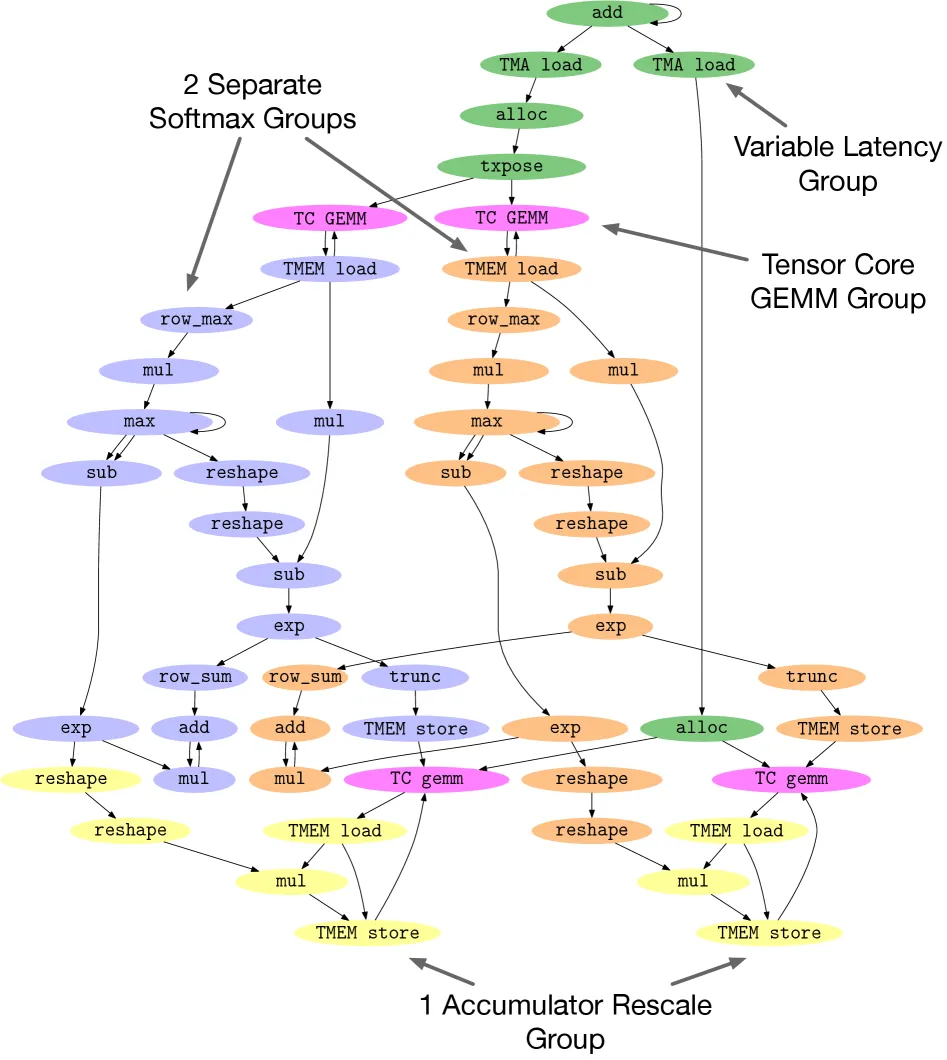
该策略把**变长操作(绿)与 TC GEMM(粉)**分到不同 warp,两个 sub-tile 的 **softmax(蓝/橙)**分到两组 warp,**累加器 rescaling(黄)**分到第三组 warp。原因:从 Tensor Memory 读累加器需阻塞同步,放在发 exp 的 warp 上会打断流水线,故移到第三组(代价是跨 warp 通信,Twill 调度绕开其延迟与同步)。达 FA4 的 2% 以内。且证明:单独考虑 SWP 或套用 Triton WS 启发式(Twill-SWP-Triton-WS / CUDA-Triton-WS)均无收益——联合考虑才是达峰值的关键。
7.2 后向传播
后向 = 单遍算法(FA3 版),含 5 个 GEMM + 1 个 exp + global memory 原子归约,循环结构与前向显著不同。
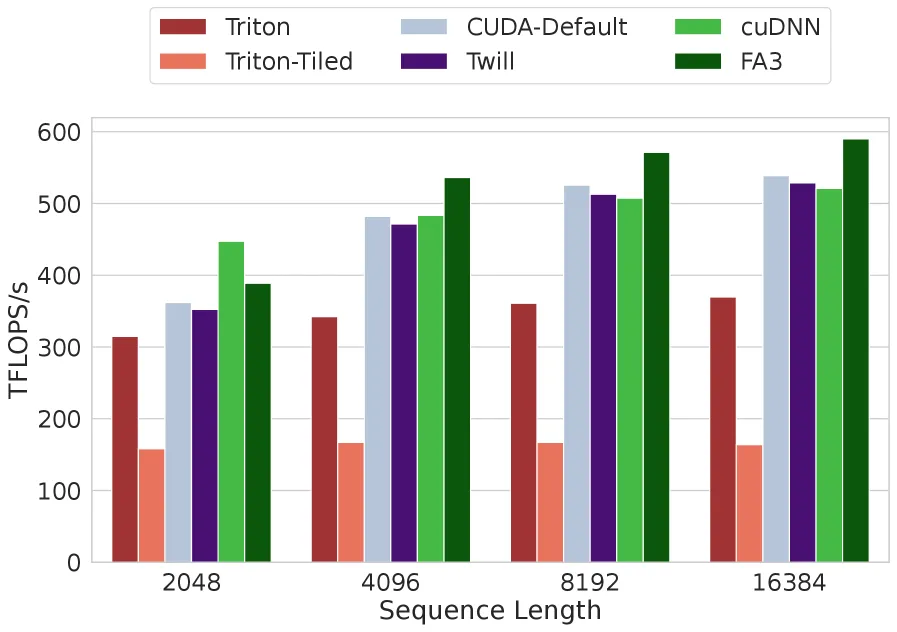
Hopper(求解 88 秒):后向在 Hopper 上受寄存器约束,故 FA3 不做跨迭代 ILP 的流水线;Twill 找到相似调度(迭代内挖 ILP,因寄存器容量无法跨迭代)——证实 FA3 开发者没有错失性能。参考 FA3 在 16384 序列长快 11%,因用了更大 tile(80×128),而 Triton 只支持 2 的幂 tile(非 Twill 本质限制)。
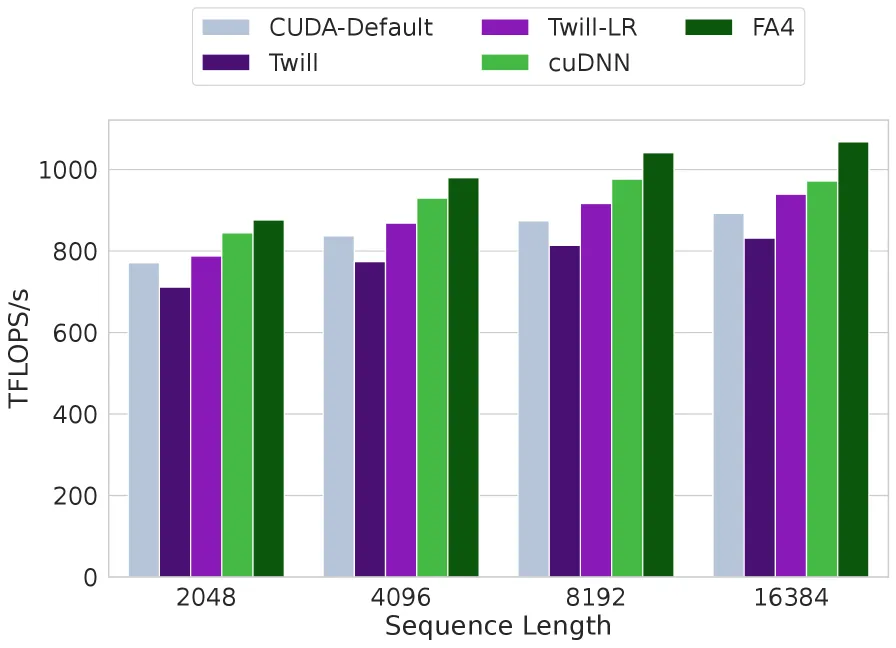
Blackwell:Triton 无法生成代码(无法构造含别名的 Tensor Memory 分配)。FA4 用三组 warp;Twill 269 秒找到两组 warp ping-pong 方案,但 ptxas 无法无溢出地分配寄存器 → 降性能。降低每线程寄存器预算后,Twill 64 秒找到与 FA4 相同的三组 warp 方案(Twill-LR),ptxas 成功分配,取得小幅加速。Blackwell TC 高吞吐使后向差异较小。
八、相关工作(Section 7)
| 方向 | 代表 | 与 Twill 关系 |
|---|---|---|
| TC GPU 编程 | CUTLASS、ThunderKittens、Triton、Pallas、TileLang、Cypress、Tawa | Twill 产出可供其消费或作专家参考;这些系统靠启发式,Twill 无启发式且保证最优 |
| 软件流水线 | modulo scheduling(Lam/Rau greedy、Gao/Stoutchinin ℤLP 最优) | Twill 将 TC GPU 的 SWP 归约到模调度并扩展为联合形式化 |
| Warp 特化 | CudaDMA、Singe(同作者血脉)、FA3、FA4 | 前作教如何做 WS;Twill 首次给出 WS 与 SWP 联合的最优性框架 |
九、总结
核心贡献
- 把 TC GPU 的 SWP schedule 构造归约到模调度问题。
- 提出 SWP + WS 的联合约束满足形式化,可交给现成 ℤLP + SMT 求解器整体求解。
- 实现 Twill——首个对一大类迭代程序(单层循环)无启发式、易扩展新架构、保证最优 的 SWP+WS 自动调度系统。
- 实证:自动重新发现并证明最优 FA3(Hopper)/FA4(Blackwell) 专家手工方案,达 cuDNN/FA 手工实现 1%~2% 以内;并证明分开优化 SWP 与 WS 无法达峰值。
技术影响
- 理论意义:首次为”warp 特化 + 软件流水线该怎么组合”提供了可判定最优性的框架,把一年才被人发现的 FA3 这类调度变成 28 秒可自动求解的问题。
- 血脉延续:CudaDMA(2 路 WS 库)→ Singe(多路 WS 编译器)→ Twill(WS+SWP 最优求解器),完成了从”手工/启发式”到”求解器保证最优”的范式跃迁。
- 工程定位:作为开发者辅助或部署前离线编译工具,指导 Hopper/Blackwell 上关键 kernel(尤其 attention)的调度设计。
局限性
- 仅单层循环无控制流;tile 大小需外部选取;求解时间数十秒~几分钟(换取最优性)。
- 端到端自动代码生成仍需大量工程(当前手工翻译成 CUDA C++);Triton 后端降级质量不足。
十、参考资源
- 论文:arXiv:2512.18134 / HTML v1
- 相关文档(同一 warp 特化研究血脉):
- Singe: 用 Warp 特化实现 GPU 高性能的 DSL 编译器 (PPoPP’14)(多路 WS 编译器,同作者 Bauer/Aiken)
- CudaDMA: 通过 Warp 特化优化 GPU 内存带宽 (SC’11)(2 路 WS 库,warp 特化起源)
- Can Tensor Cores Benefit Memory-Bound Kernels? (No!)(Tensor Core 与访存受限 kernel 的理论边界)
- Veda: 蒸馏式稀疏注意力(现代 Hopper attention kernel 的 producer-consumer warp specialization 实践)