ProCache: Constraint-Aware Feature Caching with Selective Computation for Diffusion Transformer Acceleration
ProCache提出约束感知的特征缓存与选择性计算方法,加速扩散Transformer模型的推理过程。
ProCache: 基于约束感知特征缓存与选择性计算的扩散Transformer加速
原文链接: arXiv:2512.17298
代码仓库: GitHub - macovaseas/ProCache
会议: AAAI 2026 (Poster)
一、论文概述
1.1 研究背景
扩散Transformer(Diffusion Transformers, DiTs)在图像和视频生成领域取得了最先进的性能,但其高昂的计算成本严重制约了实时部署。特征缓存(Feature Caching)作为一种无需训练的加速方案,通过利用去噪步骤间的时间冗余来复用已计算的特征,但现有方法存在两个关键局限:
- 均匀缓存间隔与非均匀时间动态的错配:现有方法采用固定的均匀缓存间隔(如每N步全量计算),无法适应DiT去噪过程中非均匀的特征演化规律。
- 误差累积问题:随着缓存复用间隔增大,过时特征的误差呈指数级衰减,导致严重的质量退化。
1.2 核心贡献
| 贡献 | 描述 |
|---|---|
| 分析洞察 | 揭示了DiT特征在去噪过程中的非均匀演化规律——早期阶段稳定,后期阶段高度动态;误差传播集中在深层网络 |
| 约束感知缓存模式搜索 | 提出离线约束采样机制,生成针对模型时间特性定制的非均匀激活调度模式 |
| 选择性计算模块 | 在缓存步骤中仅对深层块和高重要性token进行选择性计算,以最小开销缓解误差累积 |
| 实验验证 | 在PixArt-alpha和DiT上实现最高1.96x和2.90x加速,质量退化可忽略不计 |
二、核心思想
2.1 关键观察
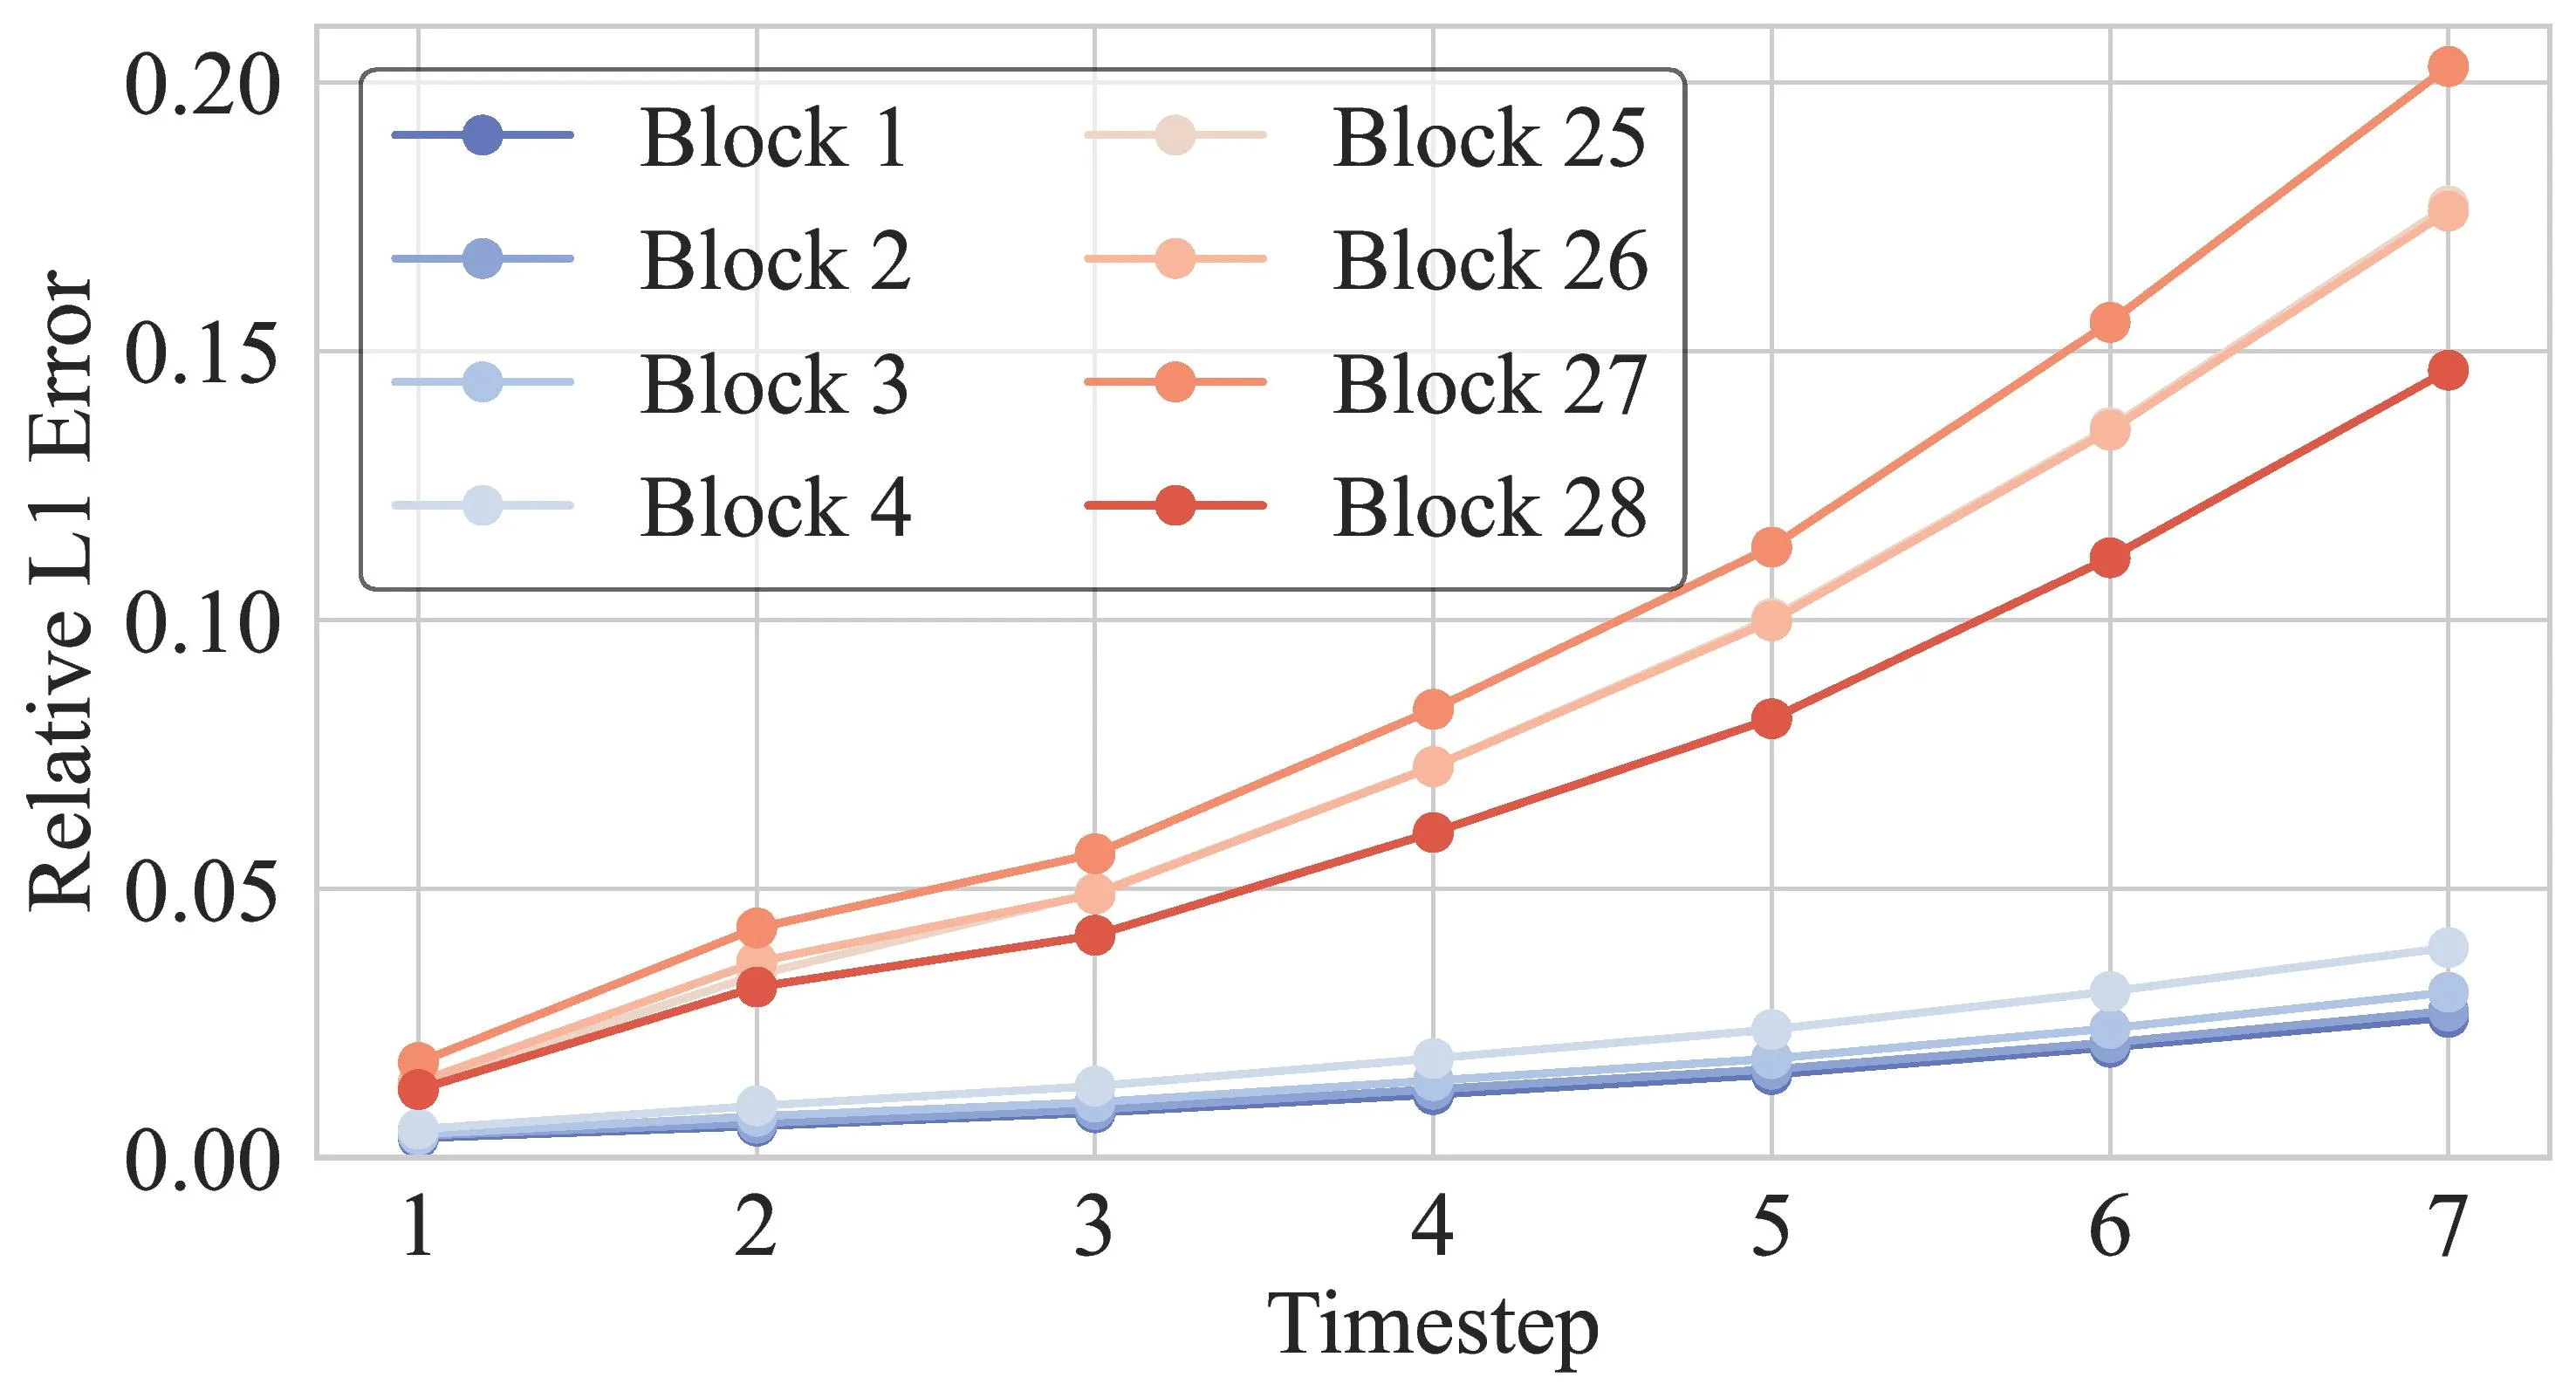 图1:DiT块中相对L1误差在扩散步骤中的演化。误差随步骤递增,深层块(如Block 25-28)的误差幅度显著高于浅层块(如Block 1-4),揭示了误差累积在网络深度上的非均匀性。
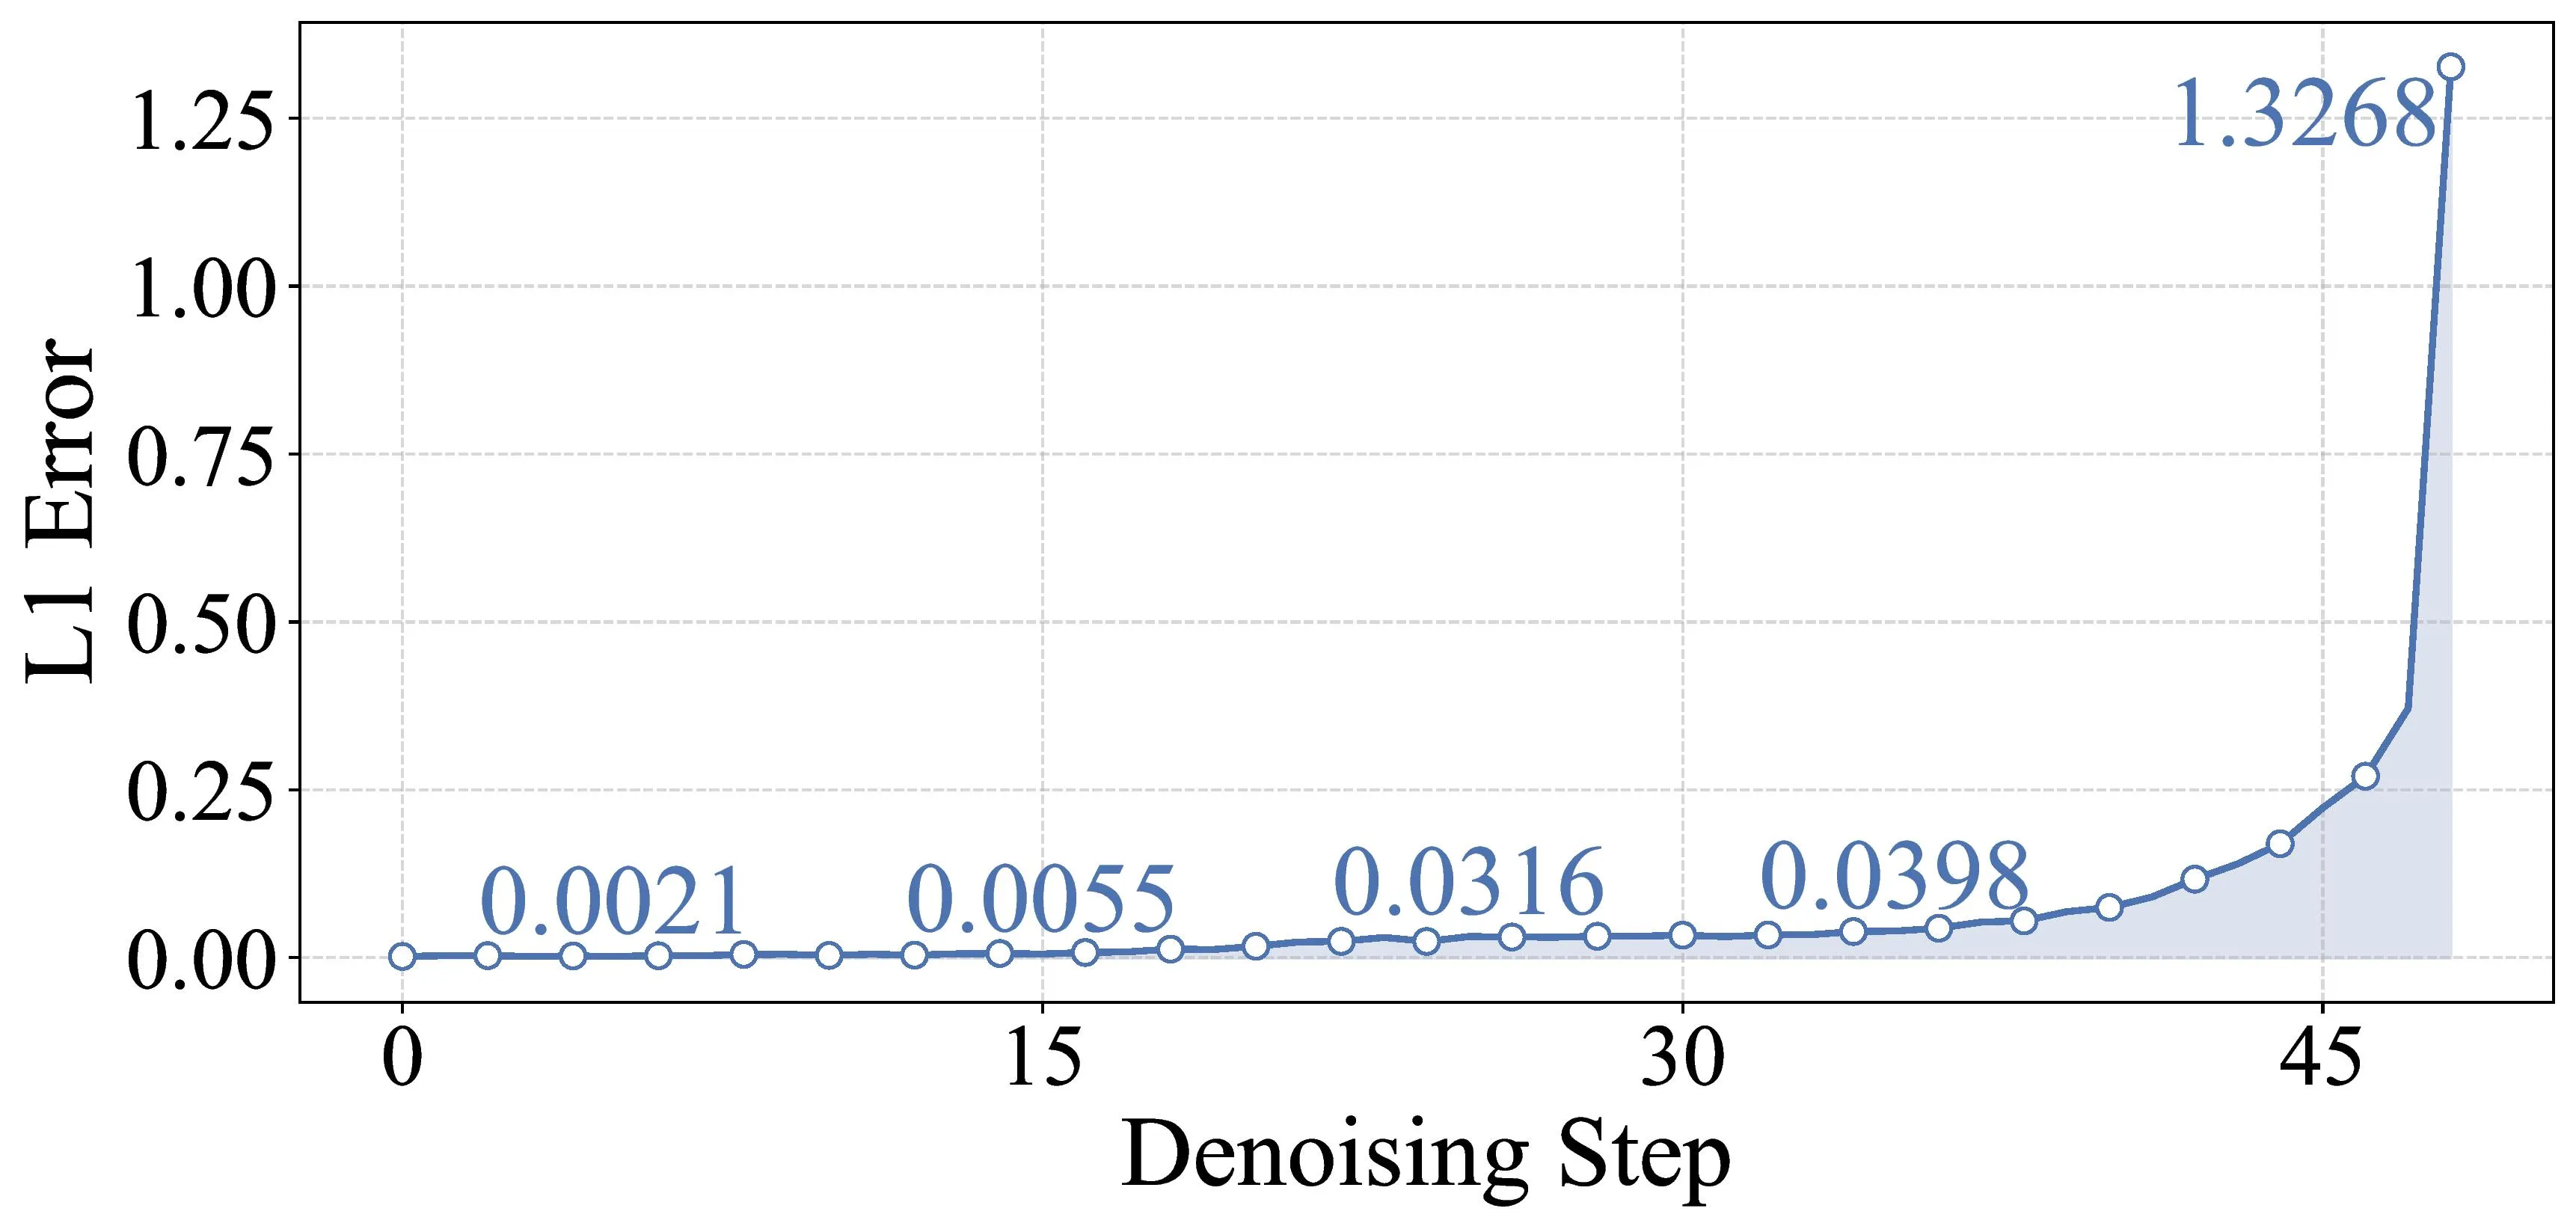 图3:DiT-XL/2在整个扩散过程中当前步骤与前一步骤的输出L1误差。早期和中期阶段特征差异较小,后期步骤急剧增长,呈近似指数趋势。
ProCache的建立在两个关键观察之上:
- 时间维度的非均匀性:DiT输出在去噪早期和中期变化缓慢,后期急剧变化(呈近似指数趋势),均匀缓存策略无法适应这一特性。
- 深度维度的非均匀性:误差主要在网络深层累积,浅层表现出较强的时间稳定性。
2.2 设计思路
基于上述观察,ProCache采用两阶段策略:
- 离线阶段:通过约束采样搜索最优的非均匀缓存模式,在稳定阶段最大化特征复用,在关键阶段确保频繁计算。
- 在线阶段:在缓存步骤中插入轻量级的部分计算,仅刷新深层块中的关键token,以最小开销维持语义一致性。
三、技术架构
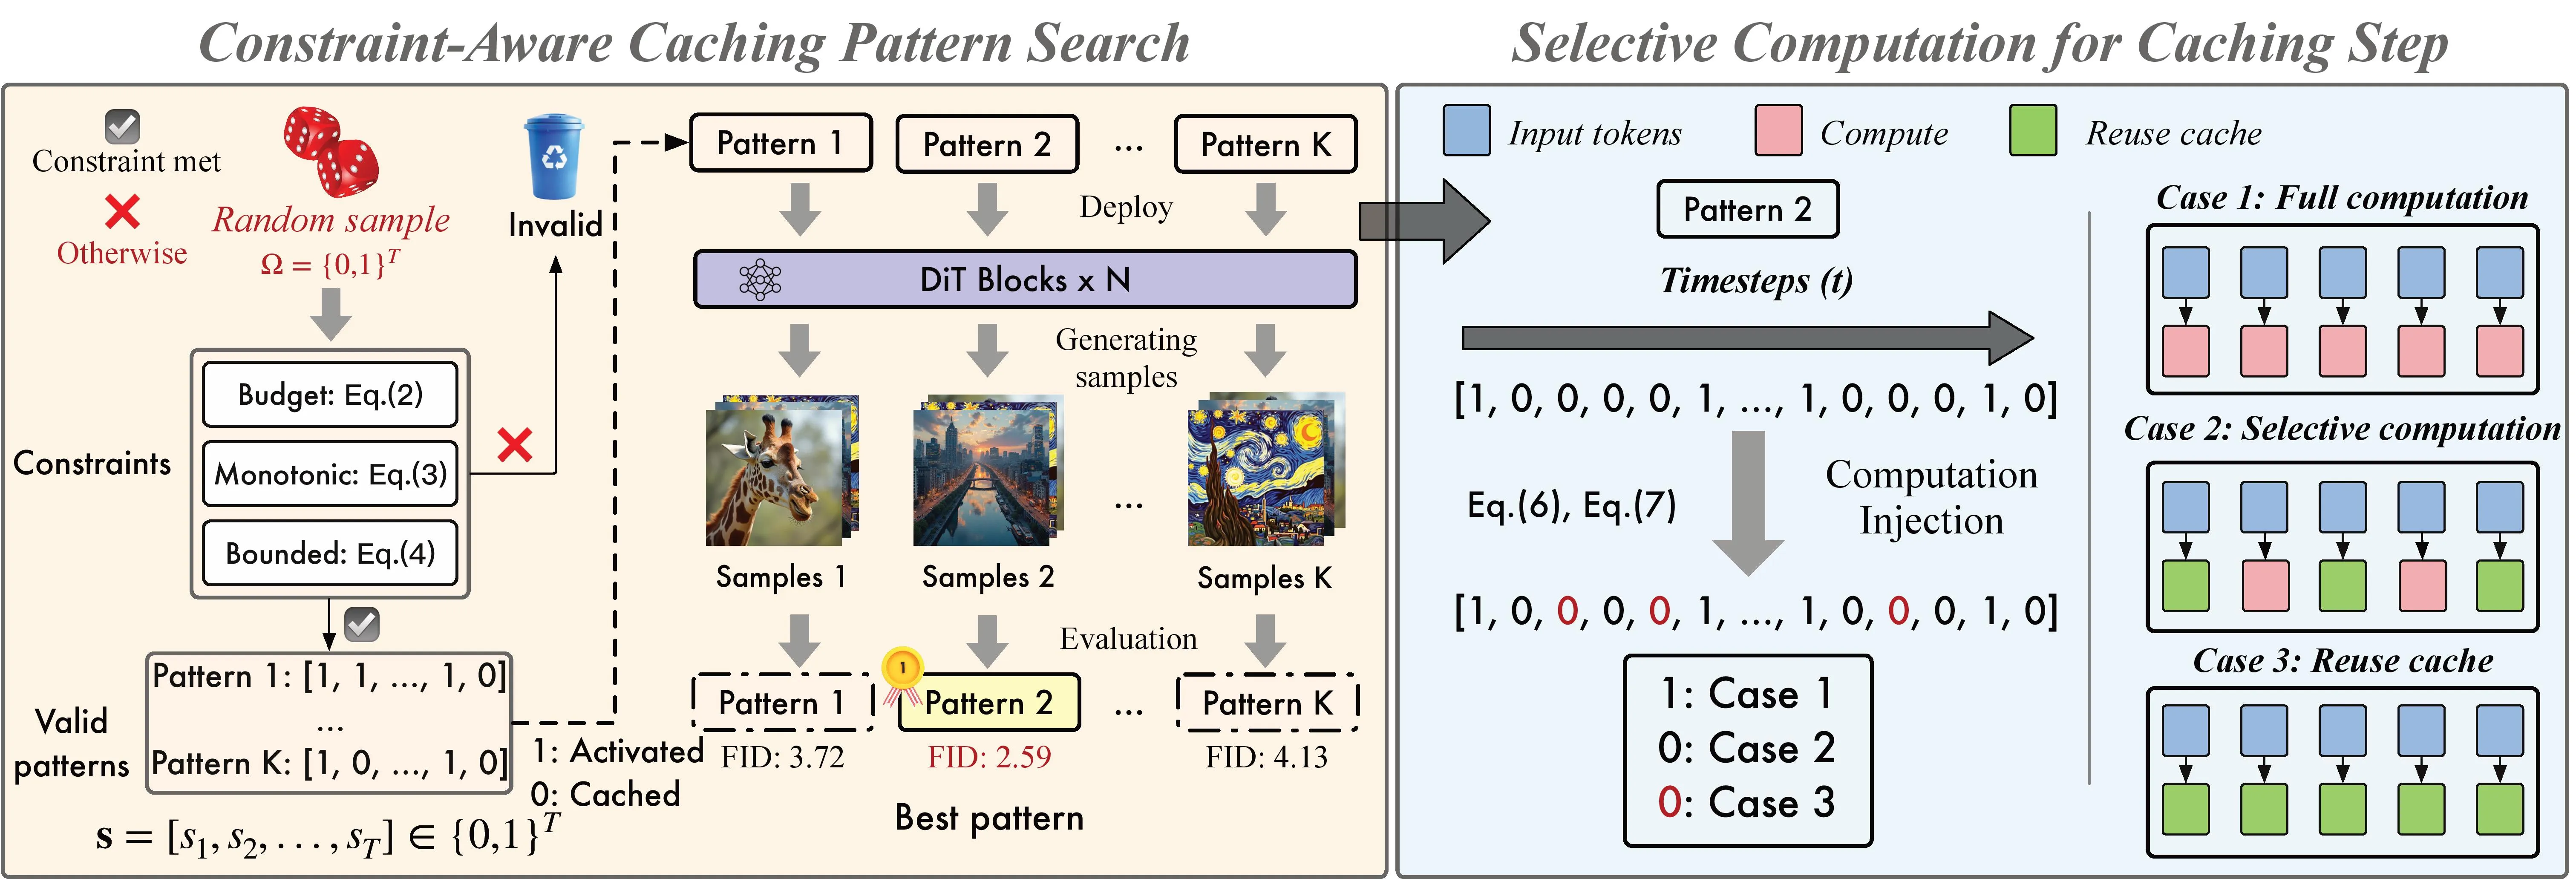 图2:ProCache整体流程。(1) ProCache在三个原则性约束下探索有效缓存模式,并通过轻量级离线采样基于质量指标(如FID)选择最优策略。(2) 然后在连续缓存步骤中插入部分计算,选择性更新深层中的高重要性token。
3.1 问题形式化
设 为预训练的DiT模型,包含 层:。每层包含三个组件:
所有操作统一为:
缓存模式表示为二进制序列 ,其中:
- :在步骤 执行计算
- :从缓存复用特征
3.2 约束感知缓存模式搜索
三个核心约束
| 约束 | 数学表达 | 含义 |
|---|---|---|
| 预算约束 | 激活步骤总数不超过预定义预算 | |
| 单调约束 | 复用间隔随时间非递增,后期阶段计算更频繁 | |
| 有界约束 | 每个间隔在可行范围内,防止过长导致误差累积或过短影响效率 |
其中 定义为第 个复用间隔,表示两个计算步骤之间连续缓存特征的时间步数。
搜索算法
约束搜索空间定义为:
搜索流程(Algorithm A):
- 初始化空候选集
- 当 且尝试次数 时:
- 生成随机二进制序列
- 检查预算约束 → 不满足则丢弃
- 提取激活索引 并验证有界约束 → 不满足则丢弃
- 通过所有约束检查则加入候选集
- 对候选集在小规模代表性数据集上评估(如FID-1k),选择最优 个模式
计算效率:在AMD Ryzen 7 5800H处理器上, 时搜索仅需约0.001秒;整个搜索过程(含评估)在单GPU上不超过1小时。
3.3 选择性计算模块
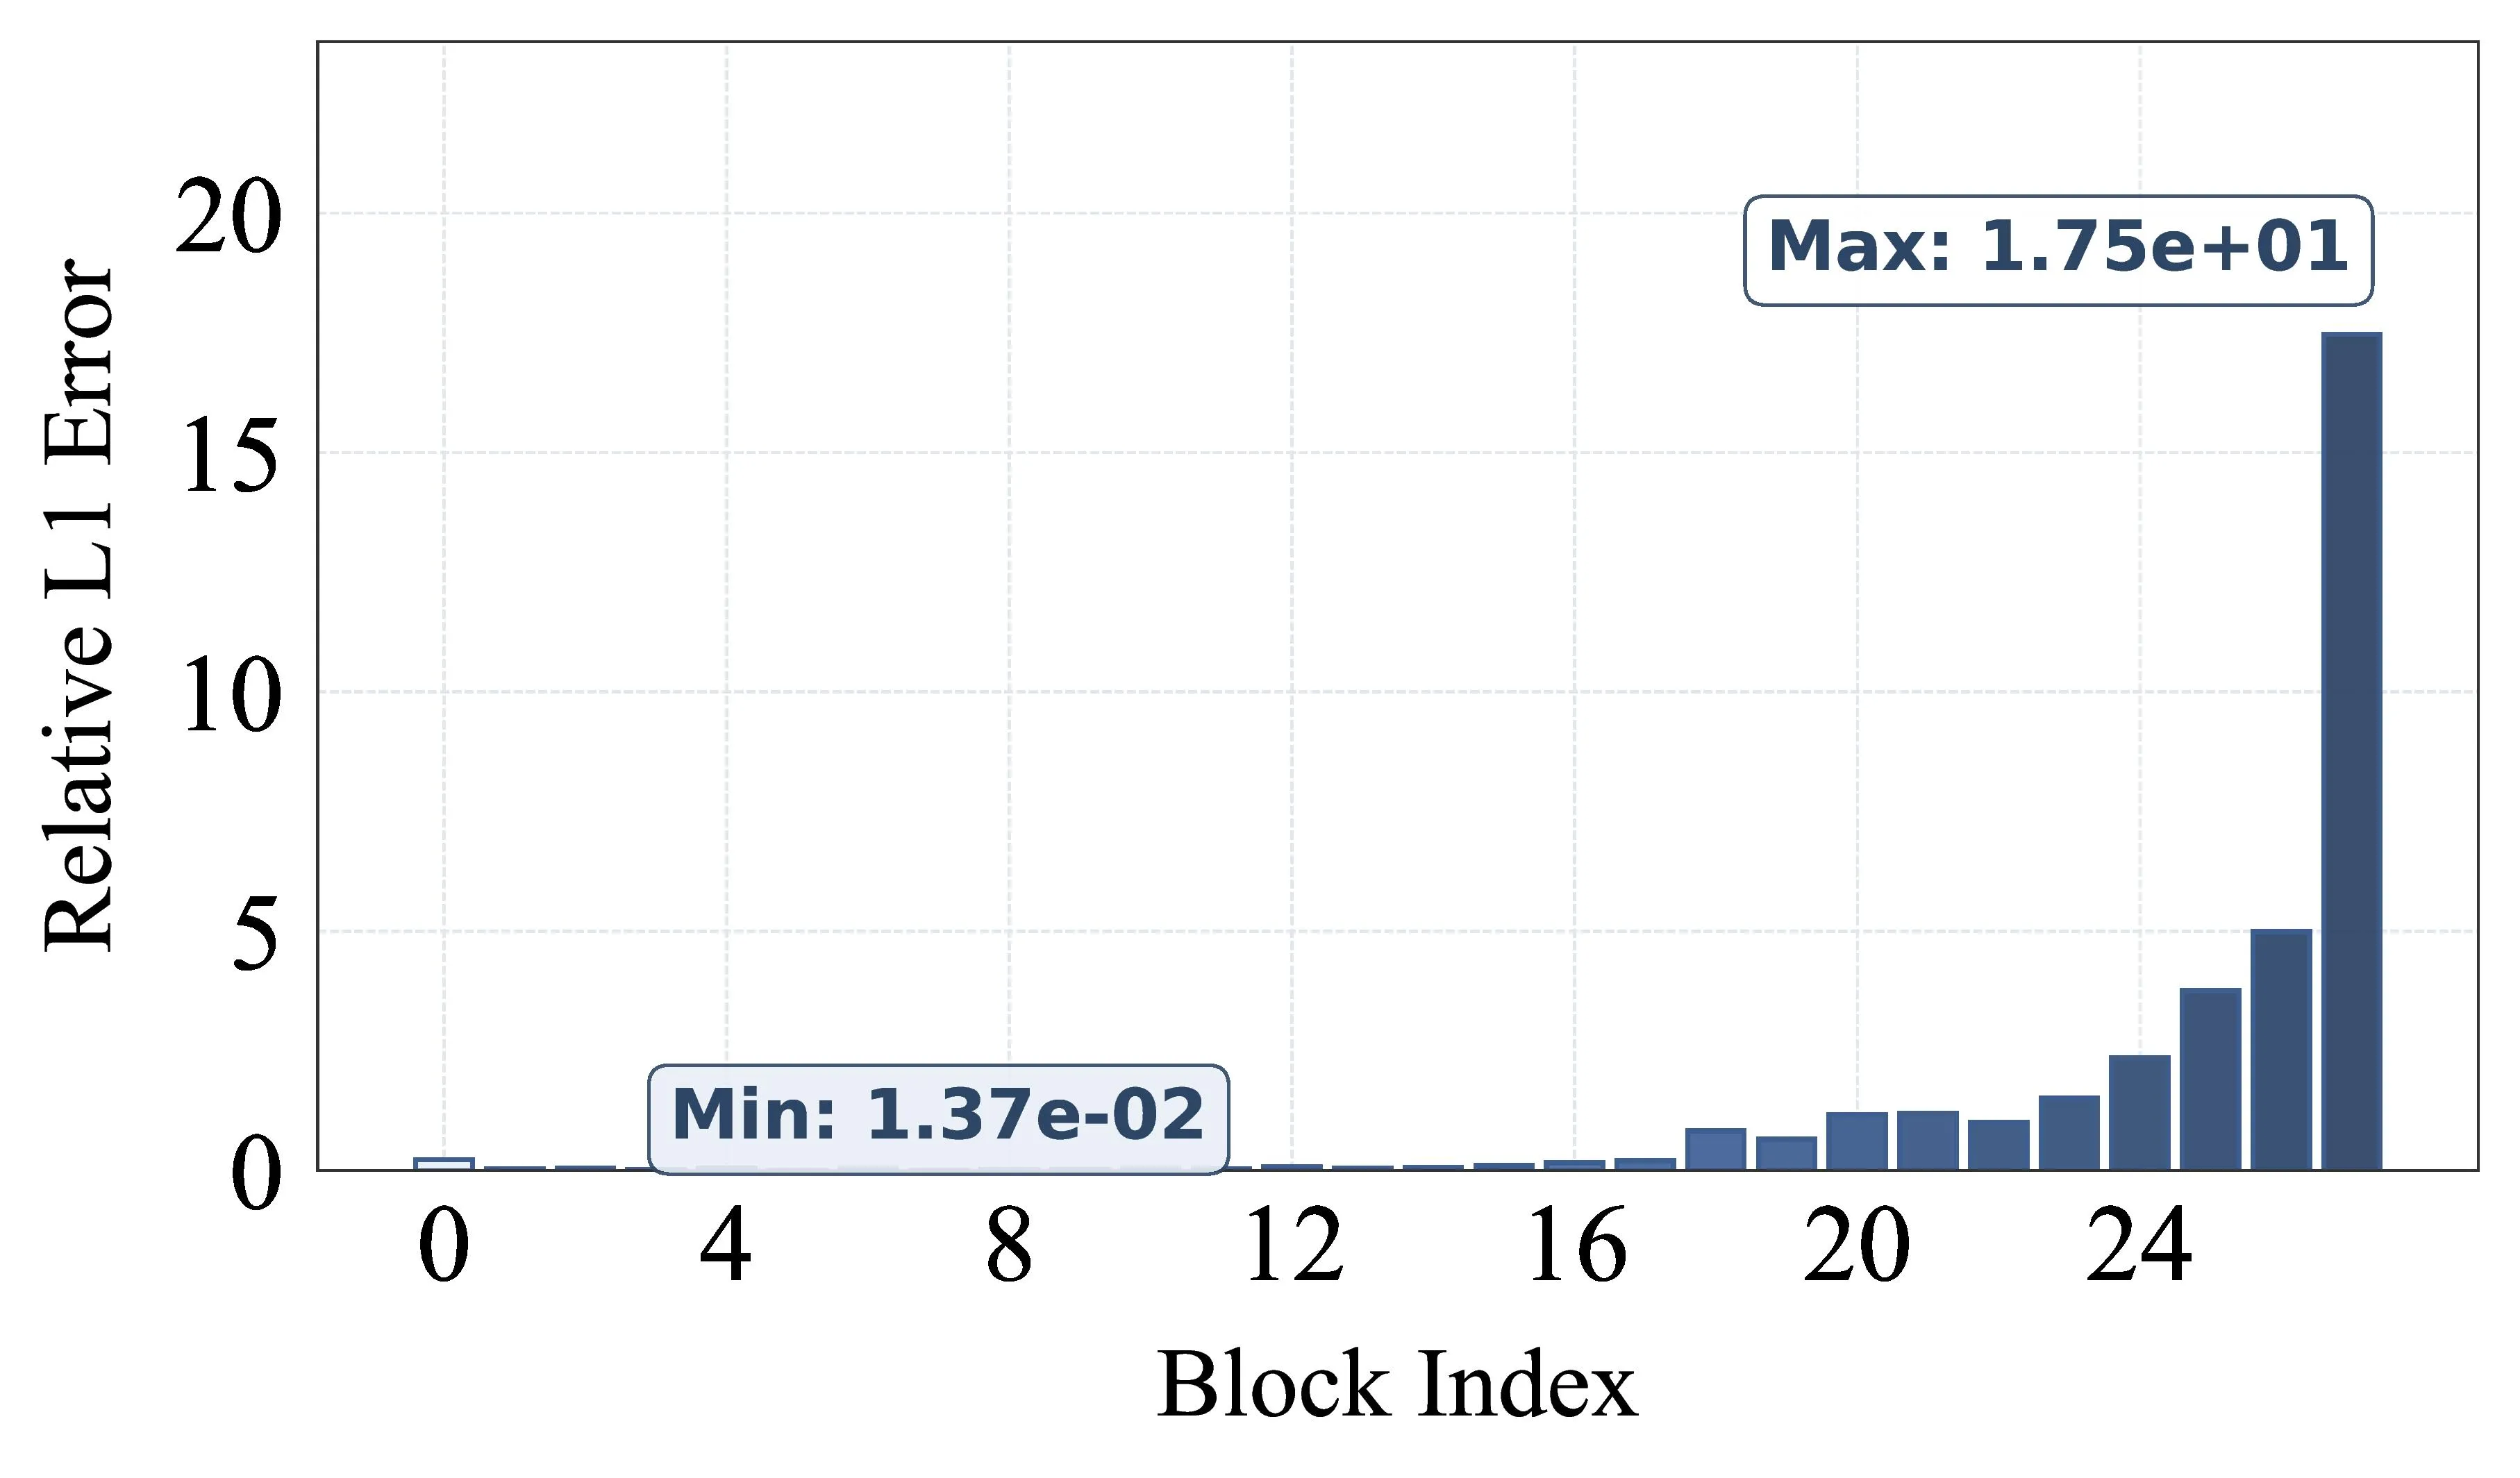 图4:DiT-XL/2中不同块在步骤20处的特征相对L1误差。误差主要在深层累积。
时间步选择
在缓存步骤中,选择性计算每隔一个位置进行更新。设 为包含 的最大连续零块的起始时间步:
对于连续零块,部分计算注入模式示例:
其中 表示仅执行深层更新的时间步。
层选择:聚焦深层块
其中 , 为计算比例。实验表明选择最深的25-50%层即可有效控制误差。
Token选择:优先计算重要token
Token重要性基于注意力模块输出的 范数定义:
其中 。选择top- 最重要的token:
注意:在自注意力模块中不采用token选择策略(因为每个token都参与所有其他token的计算),仅在交叉注意力和FFN模块中应用。
更新规则
额外开销:选择性计算仅引入约3%的额外延迟(在缓存步骤的25%层和7-30% token上计算)。
四、核心创新
4.1 创新点总结
| 创新点 | 描述 | 优势 |
|---|---|---|
| 约束感知模式搜索 | 通过三个原则性约束(预算、单调、有界)限制搜索空间,结合离线评估选择最优模式 | 避免均匀缓存的时间动态错配,搜索开销可忽略(<0.001s) |
| 深层选择性计算 | 仅在最深25-50%层执行部分计算 | 利用误差在深层累积的特性,以最小开销缓解误差传播 |
| 重要性token选择 | 基于注意力value向量的 范数选择top- token | 兼容FlashAttention等优化实现,无需访问注意力分数 |
| 零块注入策略 | 在连续缓存块中每隔一步插入部分计算 | 防止长时间无更新导致的不可逆误差漂移 |
| 完全无训练 | 整个流程无需任何模型微调或重新训练 | 即插即用,部署成本低 |
4.2 与现有方法的对比
| 方法 | 缓存策略 | 误差缓解 | Token级优化 | 训练需求 |
|---|---|---|---|---|
| DeepCache | 均匀间隔,U-Net低分辨率复用 | 周期性全量更新 | 无 | 无 |
| FORA | 均匀间隔,注意力特征复用 | 无 | 无 | 无 |
| -DiT | 均匀间隔,MLP表示共享 | 无 | 无 | 无 |
| ToCa | 均匀间隔,token级缓存 | 无 | 基于重要性分数 | 无 |
| L2C | 动态计算路由 | 训练学习跳过决策 | 层级 | 需要训练 |
| ProCache | 非均匀约束搜索 | 选择性深层+token计算 | 基于value范数 | 无 |
五、实验结果
5.1 实验设置
| 设置项 | 详情 |
|---|---|
| 基线模型 | DiT-XL/2, PixArt-alpha, FLUX.1-dev, FLUX.1-schnell |
| 任务 | 类条件图像生成(ImageNet)、文生图(COCO、PartiPrompts) |
| 分辨率 | 256x256(DiT, PixArt-alpha), 1024x1024(FLUX) |
| 评估指标 | FID, sFID, Precision, Recall, Inception Score, CLIP Score, Image Reward |
| 硬件 | 2x NVIDIA RTX 3090 (DiT, PixArt), 1x NVIDIA A800 (FLUX) |
| 实现框架 | Python 3.9, PyTorch 2.4.0 |
超参数配置
| 模型 | K (采样预算) | B (激活预算) | p (token比例) | r (计算层比例) | ||
|---|---|---|---|---|---|---|
| DiT-XL/2 | 5 | 17 | 7% | 2 | 5 | 75% |
| PixArt-alpha | 5 | 7 | 30% | 2 | 3 | 50% |
| FLUX.1-dev | 5 | 17 | 30% | 2 | 3 | 50% |
| FLUX.1-schnell | - | - | 30% | - | - | 50% |
5.2 主要结果
DiT-XL/2 类条件生成(ImageNet)
| 方法 | 延迟(s) | FLOPs(T) | 加速比 | FID↓ | sFID↓ | Precision↑ | Recall↑ | IS↑ |
|---|---|---|---|---|---|---|---|---|
| DDPM-250 steps | 49.564 | 118.68 | - | 2.31 | 4.98 | 0.82 | 0.58 | 243.42 |
| DDIM-50 steps | 4.549 | 23.74 | 1.00x | 2.43 | 4.40 | 0.80 | 0.59 | 241.25 |
| DDIM-25 steps | 2.263 | 11.87 | 2.00x | 3.18 | 4.74 | 0.79 | 0.58 | 232.01 |
| DDIM-20 steps | 1.862 | 9.49 | 2.50x | 3.81 | 5.15 | 0.78 | 0.58 | 221.43 |
| -DiT () | 2.572 | 16.46 | 1.47x | 3.75 | 5.70 | 0.77 | 0.54 | 207.57 |
| FORA () | 2.191 | 8.59 | 2.76x | 3.88 | 6.43 | 0.79 | 0.54 | 229.02 |
| ToCa () | 2.087 | 10.23 | 2.32x | 3.04 | 5.14 | 0.79 | 0.56 | 230.70 |
| ToCa () | 2.063 | 8.73 | 2.72x | 3.64 | 5.55 | 0.78 | 0.56 | 223.25 |
| ProCache (Ours) | 1.725 | 8.18 | 2.90x | 2.96 | 4.93 | 0.80 | 0.57 | 232.85 |
关键发现:ProCache在2.90x加速下,FID为2.96(最优)、sFID为4.93(最优),相比FORA提升约30%,同时加速比提高5%。
PixArt-alpha 文生图(MS-COCO2017)
| 方法 | 延迟(s) | FLOPs(T) | 加速比 | FID↓ | CLIP↑ |
|---|---|---|---|---|---|
| PixArt-alpha | 2.142 | 11.18 | 1.00x | 28.12 | 16.29 |
| 50% steps | 1.044 | 5.59 | 2.00x | 37.62 | 15.81 |
| -DiT | 1.724 | 7.68 | 1.54x | 28.91 | 16.41 |
| FORA () | 1.575 | 5.66 | 1.98x | 29.63 | 16.40 |
| FORA () | 1.301 | 6.05 | 2.79x | 29.84 | 16.42 |
| ToCa | 1.473 | 6.33 | 1.77x | 28.02 | 16.43 |
| ProCache | 1.215 | 5.70 | 1.96x | 27.66 | 16.45 |
关键发现:ProCache在约2.0x加速下,取得最低FID-30k(27.66)和最高CLIP分数(16.45)。
FLUX 文生图(PartiPrompts)
| 模型 | 方法 | 延迟(s) | FLOPs(T) | 加速比 | Image Reward↑ |
|---|---|---|---|---|---|
| FLUX.1-dev | Euler-50 steps | 33.85 | 3719.50 | 1.00x | 1.202 |
| 68% steps | 23.02 | 2529.26 | 1.47x | 1.200 | |
| FORA | 20.82 | 2483.32 | 1.51x | 1.196 | |
| ToCa () | 19.88 | 2458.06 | 1.51x | 1.202 | |
| ProCache | 18.73 | 2415.25 | 1.54x | 1.207 | |
| FLUX.1-schnell | LCM-4 steps | 2.882 | 277.88 | 1.00x | 1.133 |
| 75% steps | 2.162 | 208.41 | 1.33x | 1.132 | |
| FORA | 2.365 | 225.60 | 1.23x | 1.129 | |
| ToCa () | 1.890 | 181.30 | 1.53x | 1.134 | |
| ProCache () | 1.817 | 177.26 | 1.56x | 1.138 |
5.3 定性结果
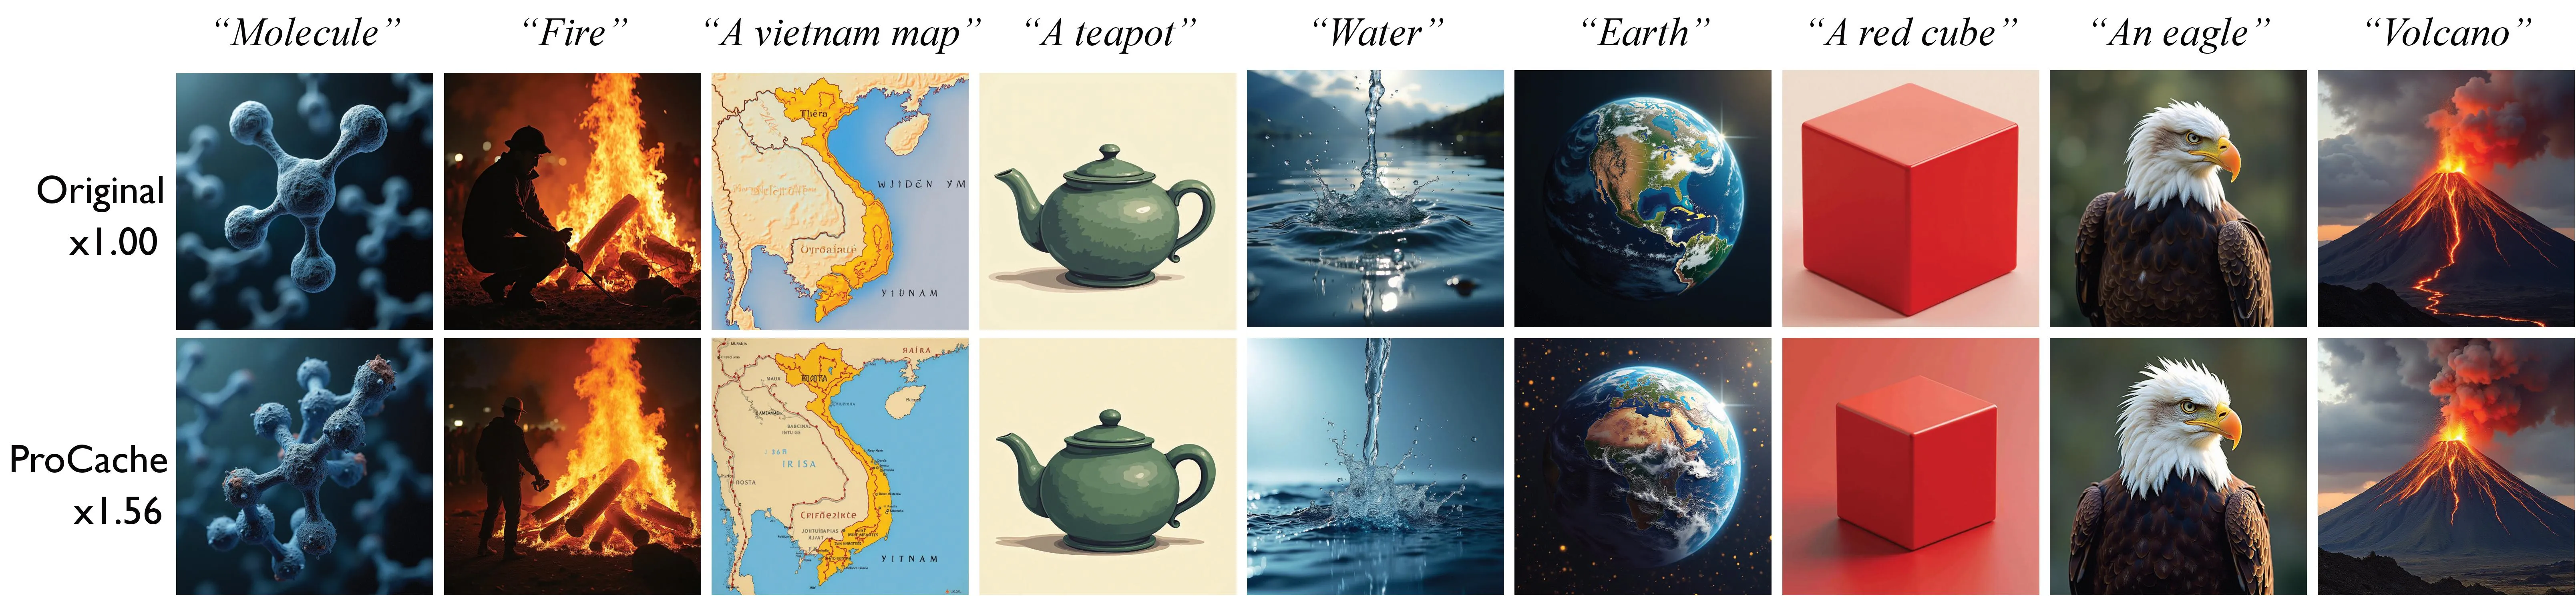 图5:1024x1024分辨率下1.56x加速比的图像生成样本。
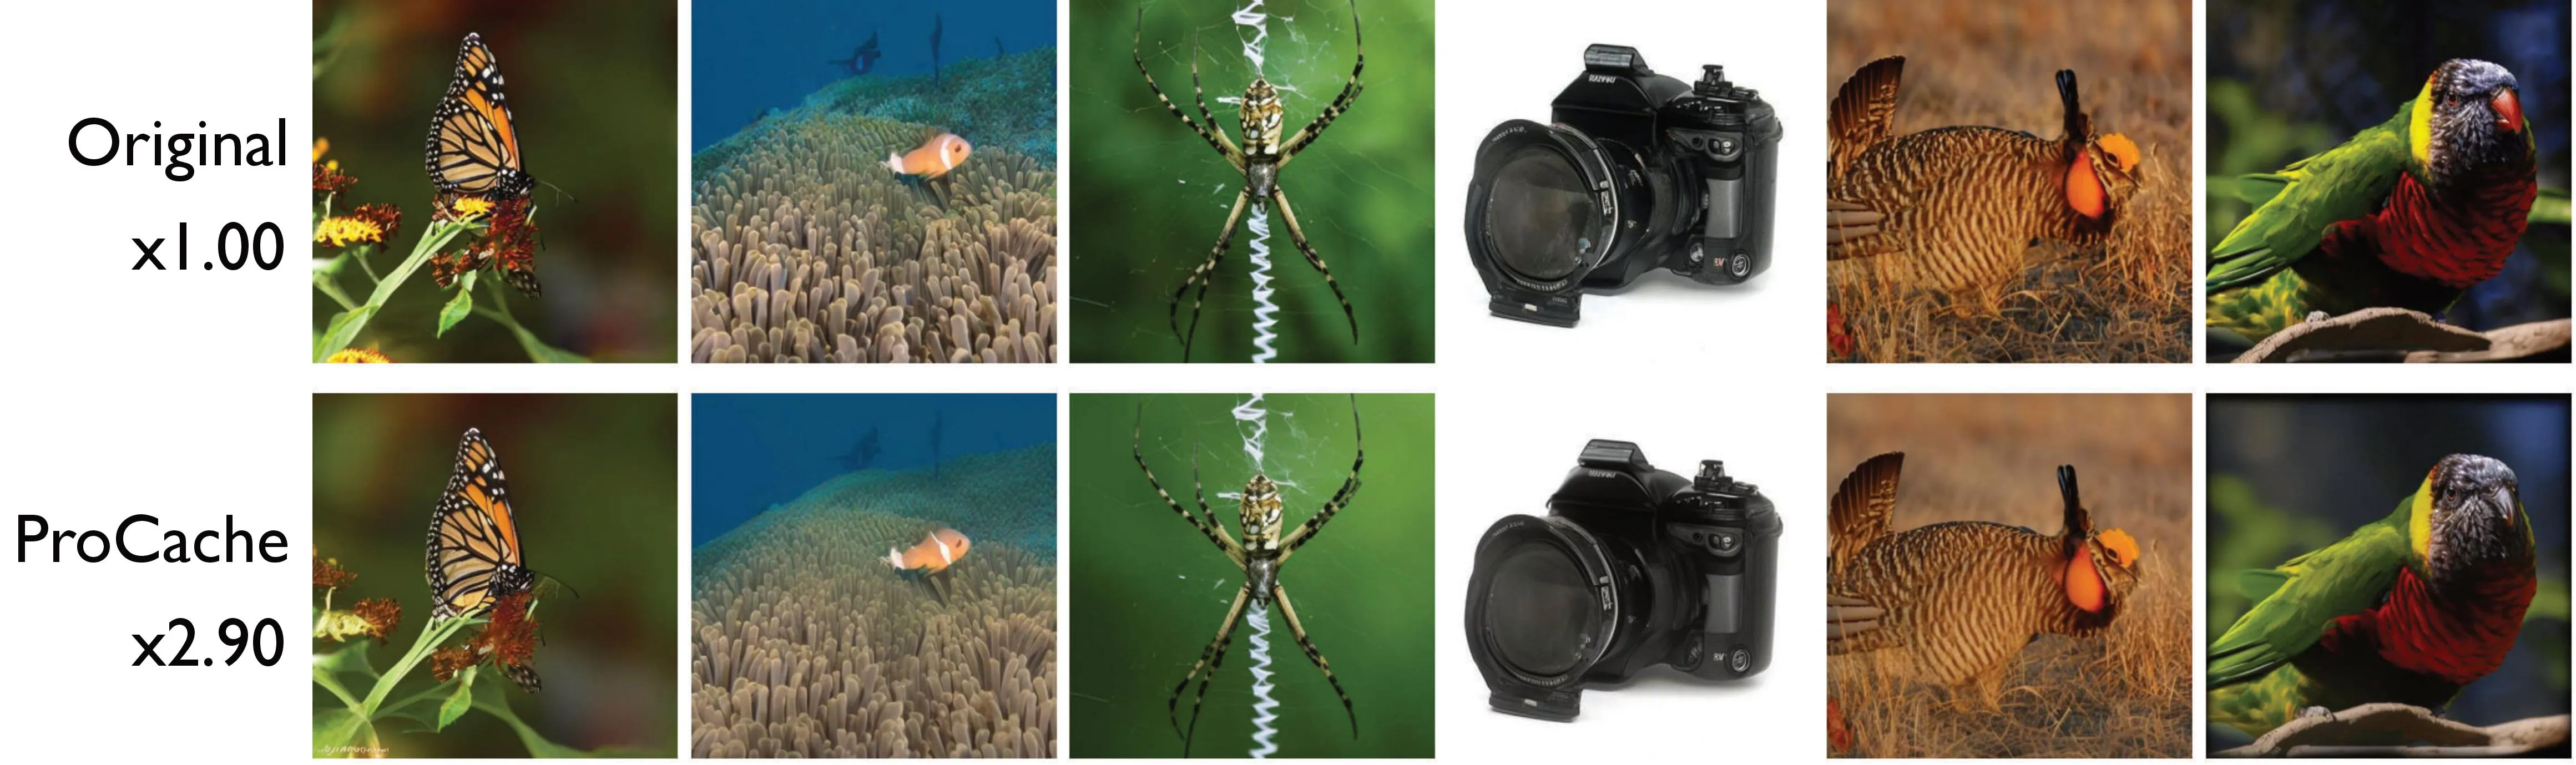 图6:原始采样器(上,1.00x速度)与ProCache(下,2.90x加速)的512x512图像生成定性对比。
5.4 高加速比性能
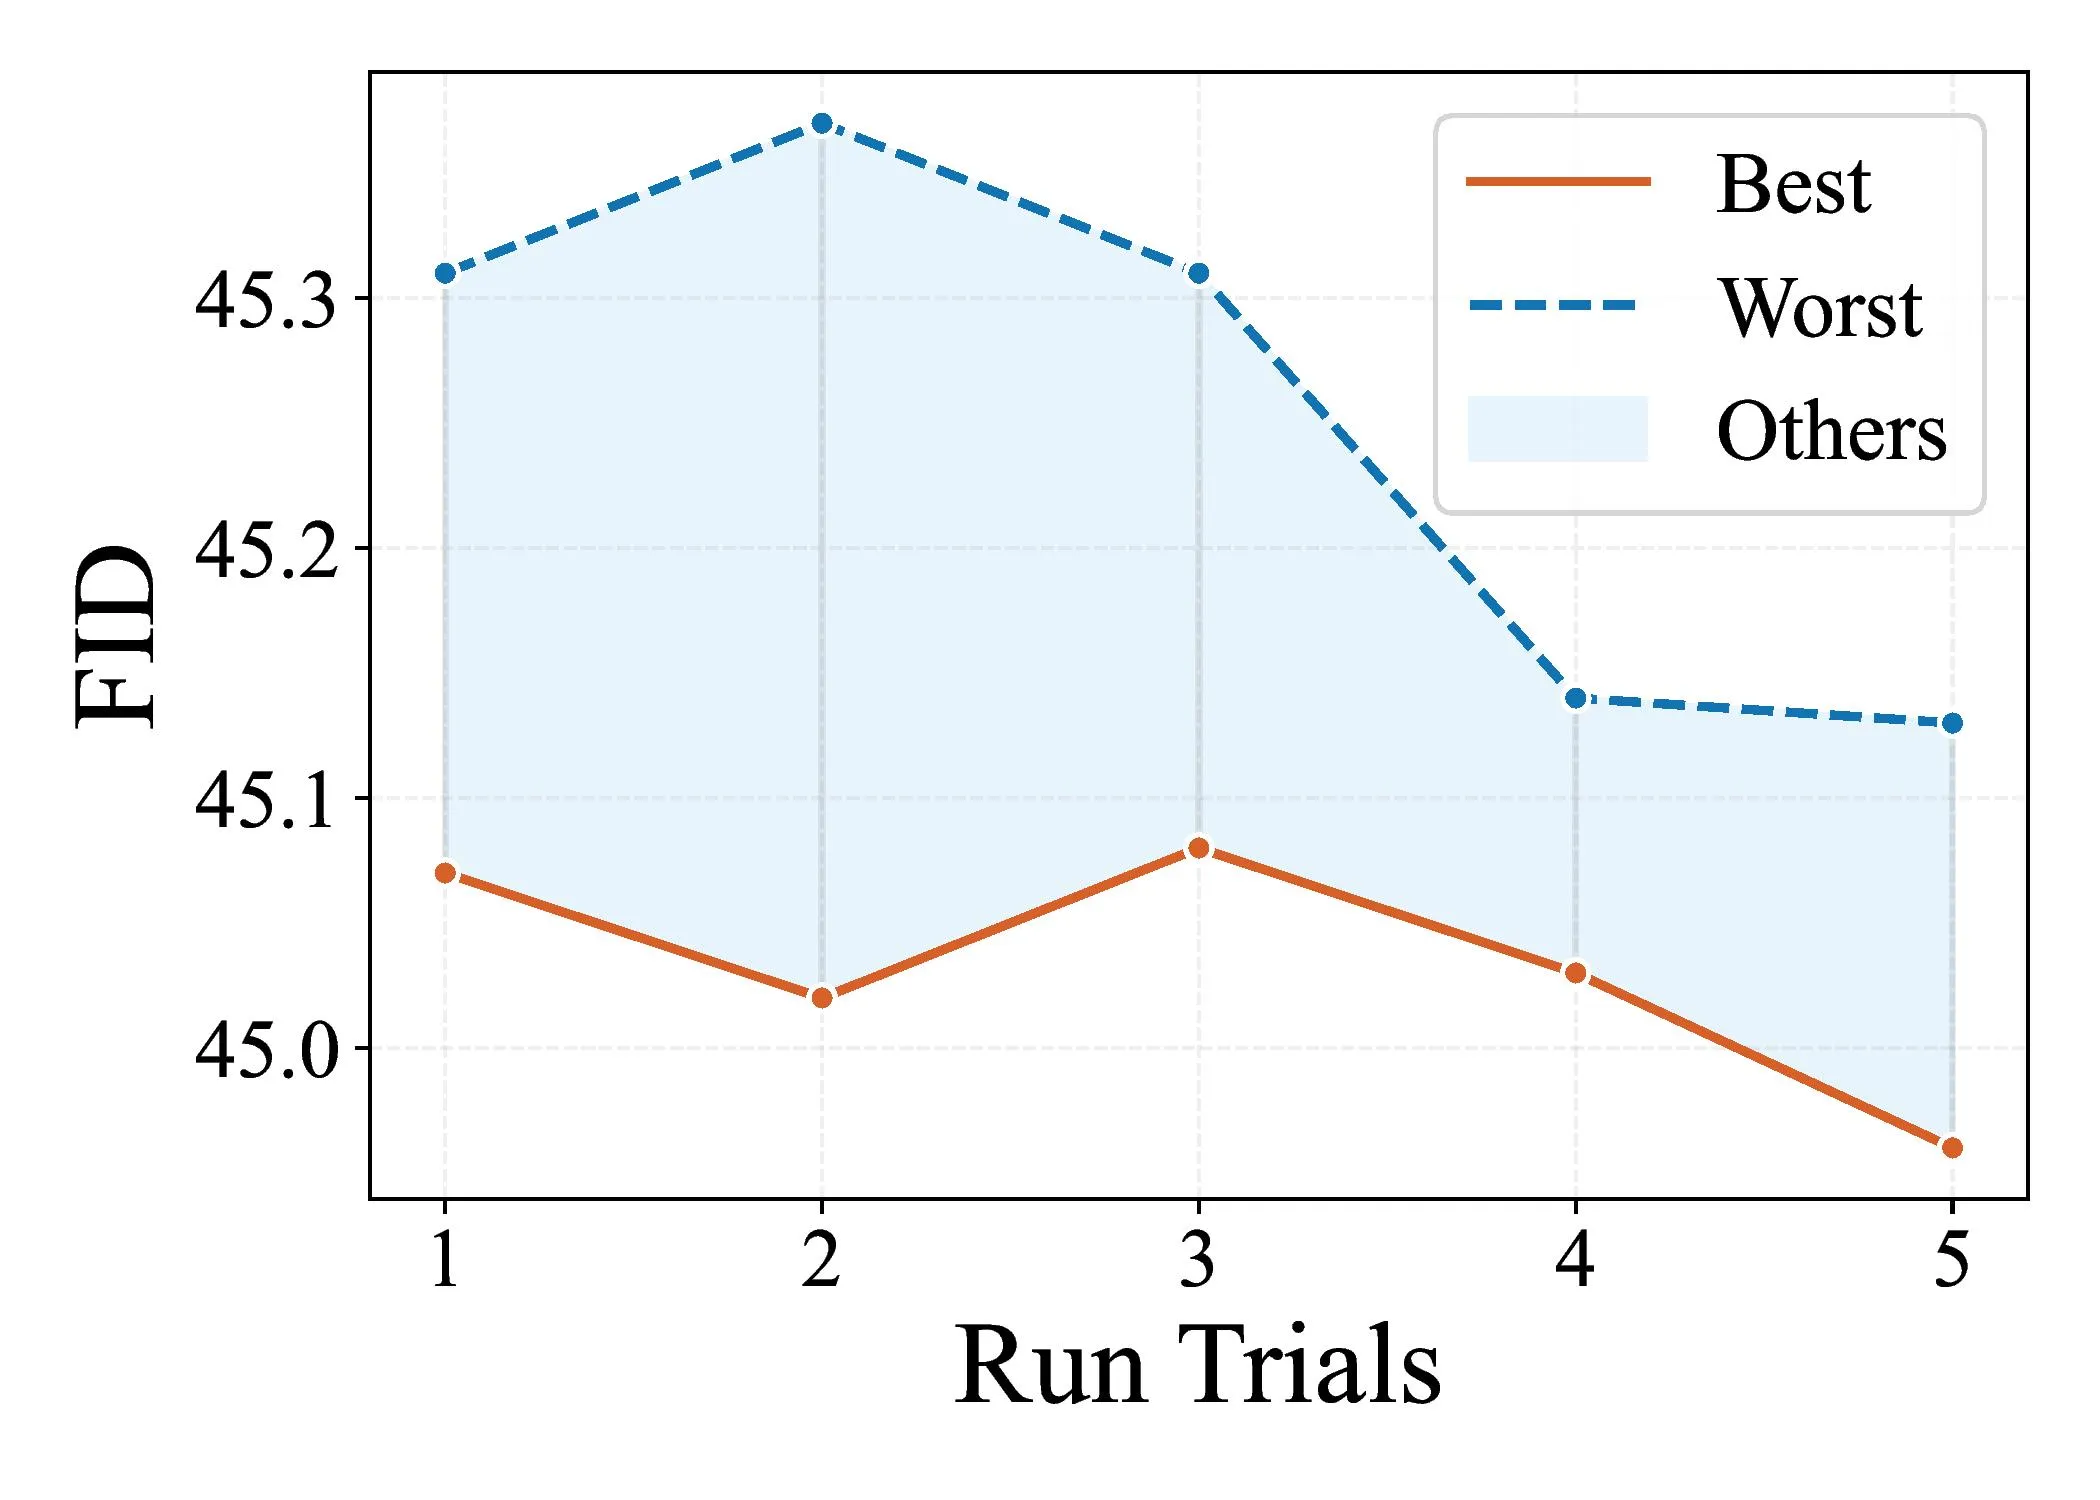 图7:DiT-XL/2在ImageNet-1k(a)和ImageNet-50k(b)上的鲁棒性与效率-质量权衡分析。
ProCache在高加速比下仍保持鲁棒性能:质量退化降低56.2%,在超过4.53x加速比的场景下仍表现稳定。
5.5 消融实验
组件消融
| 配置 | 加速比 | FID↓ | sFID↓ |
|---|---|---|---|
| Default () | 2.93x | 4.75 | 8.43 |
| + Searched Pattern | 2.93x | 3.15 | 5.12 |
| + Selective Computation | 2.90x | 3.28 | 5.95 |
| ProCache (Full) | 2.90x | 2.94 | 4.93 |
发现:
- 搜索缓存模式在无额外计算开销下显著提升FID和sFID
- 选择性计算以微小速度损失(2.90x vs 2.93x)带来可观的质量改进
采样预算K的消融
| K | FID↓ | IS↑ |
|---|---|---|
| 5 | 45.07 | 181.69 |
| 10 | 45.02 | 182.50 |
| 15 | 44.96 | 181.63 |
发现:K从5增加到15时FID略有改善,但即使K=5(最低预算)也优于现有方法。采用K=5作为默认值以最大化计算效率。
计算块比例r的消融
| r | FLOPs(T) | FID↓ | IS↑ |
|---|---|---|---|
| 50% | 9.138 | 45.32 | 184.18 |
| 65% | 8.911 | 45.33 | 184.09 |
| 75% | 8.594 | 45.31 | 183.61 |
| 90% | 8.344 | 45.38 | 182.46 |
发现:75%的块取得最低FID和竞争力的IS。主实验中使用25%(即计算最深75%的块)以最大化加速比。
六、相关工作
6.1 DiT加速方法分类
| 方法类别 | 代表工作 | 特点 | 局限性 |
|---|---|---|---|
| 剪枝 | Structural-Pruning, ToMe, SiTo, TinyDiffusion | 移除冗余层/token | 需要额外后训练 |
| 量化 | PostTrain, TemporalDynamic, HQDiT | 降低数值精度 | 需要校准数据 |
| 知识蒸馏 | SnapFusion, FastSampling | 压缩模型能力 | 需要教师模型和训练 |
| 采样步数减少 | DDIM, DPM-Solver++, Rectified Flow, DC-Solver | 减少迭代次数 | 与特征缓存正交 |
| 特征缓存 | DeepCache, FORA, -DiT, ToCa, PAB | 复用时间冗余特征 | 均匀间隔,误差累积 |
| ProCache(本文) | 约束搜索+选择性计算 | 非均匀缓存+轻量修正 | - |
6.2 特征缓存方法详细对比
| 方法 | 目标架构 | 缓存策略 | Token优化 | 误差控制 |
|---|---|---|---|---|
| DeepCache | U-Net | 低分辨率特征复用 | 无 | 周期性更新 |
| Faster Diffusion | U-Net | 跳过编码器计算 | 无 | 无 |
| FORA | DiT | 注意力特征复用 | 无 | 无 |
| -DiT | DiT | MLP表示共享 | 无 | 无 |
| PAB | DiT | 优化注意力头计算 | 无 | 无 |
| L2C | DiT | 动态计算路由 | 层级 | 训练学习 |
| ToCa | DiT | 均匀间隔+token选择 | 基于注意力分数 | 无 |
| ProCache | DiT | 非均匀约束搜索 | 基于value范数 | 选择性深层计算 |
七、总结
7.1 主要结论
ProCache是一个完全无训练的动态特征缓存框架,专门针对DiT推理加速设计。其核心创新在于:
-
揭示了DiT特征演化的非均匀性:误差在时间和深度两个维度上都呈现非均匀分布,为设计自适应缓存策略提供了理论基础。
-
约束感知缓存模式搜索:通过三个原则性约束(预算、单调、有界)将搜索空间限制在合理范围内,结合离线轻量评估,高效发现针对特定模型定制的最优缓存模式。
-
选择性计算策略:利用深层误差累积的特性,仅在最深层的高重要性token上执行部分计算,以约3%的额外延迟有效缓解误差传播。
7.2 性能亮点
- DiT-XL/2:2.90x加速,FID 2.96(最优),sFID 4.93(最优)
- PixArt-alpha:1.96x加速,FID 27.66(最优),CLIP 16.45(最优)
- FLUX.1-dev:1.54x加速,Image Reward 1.207(最优)
- FLUX.1-schnell:1.56x加速,Image Reward 1.138(最优)
7.3 局限性与未来方向
- 模型特异性:每个模型需要离线搜索其专属缓存模式,虽然开销小(<1小时),但无法直接跨模型迁移。
- 与采样加速的正交性:ProCache专注于特征缓存加速,与采样步数减少方法(如DPM-Solver++)正交,未来可探索二者的联合优化。
- 扩展至视频生成:论文主要验证了图像生成场景,视频生成等更长序列场景的适用性有待进一步探索。
八、参考资源
8.1 核心链接
| 资源 | 链接 |
|---|---|
| arXiv论文 | https://arxiv.org/abs/2512.17298 |
| HTML版本 | https://arxiv.org/html/2512.17298v1 |
| PDF下载 | https://arxiv.org/pdf/2512.17298 |
| GitHub代码 | https://github.com/macovaseas/ProCache |
8.2 关键引用
- DiT: Peebles, W., & Xie, S. (2023). Scalable diffusion models with transformers. ICCV.
- PixArt-alpha: Chen, J., et al. (2024). PixArt-: Fast training of diffusion transformer for photorealistic text-to-image synthesis. ICLR.
- FLUX: Black Forest Labs. (2024). FLUX.
- DeepCache: Ma, X., et al. (2024). DeepCache: Accelerating diffusion models for free. CVPR.
- FORA: Li, H., et al. (2024). Faster diffusion via temporal attention decomposition. arXiv.
- ToCa: Wu, X., et al. (2024). ToCa: Token-wise caching for diffusion transformers. arXiv.
- -DiT: Yang, S., et al. (2024). -DiT: Speeding up diffusion transformers with delta feature caching. arXiv.
- DDIM: Song, J., et al. (2021). Denoising diffusion implicit models. ICLR.
- DPM-Solver++: Lu, C., et al. (2022). DPM-Solver++: Fast solver for guided sampling of diffusion probabilistic models. arXiv.
- Rectified Flow: Liu, X., et al. (2022). Flow straight and fast: Learning to generate and transfer data with rectified flow. ICLR.
8.3 图片资源
所有关键图片已下载至 docs/figures/proc-cache/ 目录:
| 文件名 | 对应论文图表 | 说明 |
|---|---|---|
feature_error.jpg | Figure 1 | DiT块中相对L1误差在扩散步骤中的演化 |
method_pipeline.jpg | Figure 2 | ProCache整体流程图 |
output_error.jpg | Figure 3 | DiT-XL/2输出L1误差随扩散过程的变化 |
block_error.jpg | Figure 4 | 不同块在步骤20处的特征相对L1误差 |
vis_flux.jpg | Figure 5 | FLUX 1024x1024生成样本 |
vis_dit.jpg | Figure 6 | DiT 512x512定性对比 |
sampling_fid.jpg | Figure 7 | 鲁棒性与效率-质量权衡分析 |
tradeoff.jpg | - | 加速比与质量权衡分析 |
分析文档生成时间: 2026-05-30