SonicMoE: Accelerating MoE with IO and Tile-aware Optimizations
面向细粒度和稀疏 MoE 的 IO 和 Tile 感知优化加速器
SonicMoE: Accelerating MoE with IO and Tile-aware Optimizations
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | SonicMoE: Accelerating MoE with IO and Tile-aware Optimizations |
| 作者 | Princeton University 研究团队 |
| 机构 | Princeton University |
| 论文 | arXiv:2512.14080 |
| 代码 | 开源所有内核 |
| 发布 | 2025年12月 |
| 许可 | 未明确 |
二、核心思想
问题定义
Mixture of Experts (MoE) 模型已成为扩展语言模型的主流架构,无需显著增加计算成本。现代 MoE 模型呈现出明确的趋势:
- 高专家粒度(更小的专家中间维度):提高每 FLOP 的模型质量
- 更高稀疏度(总专家数增加但激活专家数恒定):进一步提升效率
然而,细粒度 MoE 面临两个关键挑战:
- 激活内存占用增加:由于更高的 IO 成本导致硬件效率降低
- Grouped GEMM 中的填充浪费:稀疏 MoE 由于填充导致计算浪费
解决方案概述
SonicMoE 提出三个关键优化:
- 内存高效算法:最小化前向和反向传播的激活缓存,减少 45% 激活内存
- IO 感知内核设计:重叠内存 IO 与计算,提高吞吐量
- Token Rounding 路由:最小化 Grouped GEMM 中的填充浪费
核心性能提升
- 激活内存: 减少 45%(7B MoE 模型)
- 计算吞吐量: 提升 1.86×(Hopper GPU,BF16 MoE 内核)
- 训练吞吐量: 64 H100 达到 2130 亿 token/天(vs ScatterMoE 96 H100 的 2250 亿)
- Blackwell 加速: 前向 25%,后向 15%(vs DeepGEMM 基线)
- Token Rounding: 额外 1.16× 内核执行时间加速
三、技术架构
整体框架
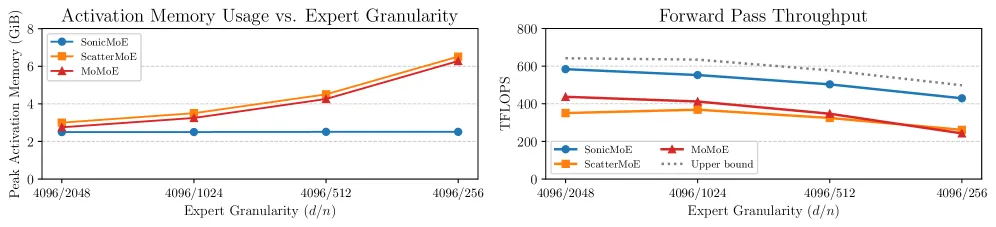
Figure 1: SonicMoE 的每层激活内存占用(左)随专家粒度增加保持恒定,比其他基线更高效;前向计算吞吐量(右)达到上界的 88% 平均值。
计算工作流
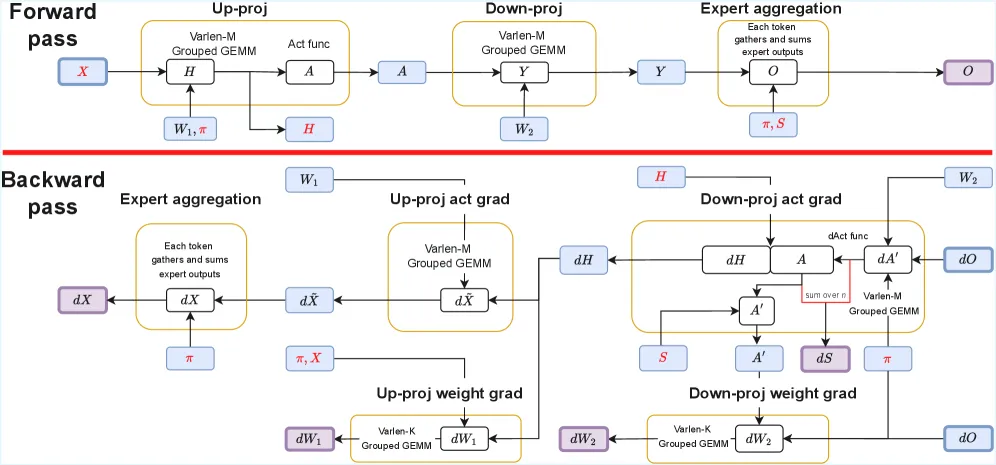
Figure 4: SonicMoE 的 8 个启动内核的计算工作流。前向传播启动 3 个内核,后向传播启动 5 个内核。
前向传播内核:
- Up-proj kernel:
- Down-proj kernel:
- Expert aggregation: 每个 token 聚合其激活专家的输出
后向传播内核:
- dW2 kernel: 计算权重梯度
- dH kernel: 计算激活梯度
- dS kernel: 计算路由分数梯度
- dW1 kernel: 计算权重梯度
- Aggregation kernel: 聚合梯度
内存高效算法
关键优化:仅缓存前向传播中计算反向传播所需的最小激活集:
| 缓存变量 | 说明 | 大小 |
|---|---|---|
| 输入嵌入 | ||
| 每个专家的 gather 后输入 | (每专家) | |
| 每个专家的激活值 | (每专家) | |
| 路由分数 | ||
| 路由元数据 | 元数据 |
核心公式
MoE 前向传播:
其中 是 token 的激活专家集合, 是路由分数。
SwiGLU 激活:
Grouped GEMM: 对于 个专家,每个专家 接收 个 token:
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 内存高效算法 | 最小化反向传播激活缓存 | 激活内存减少 45% |
| Gather 融合 | 将 gather 操作融合到 HBM 加载中 | 减少 IO 开销 |
| SwiGLU/dSwiGLU 融合 | 将激活函数融合到 GEMM epilogue | 减少内核启动 |
| Ping-Pong Warp 调度 | 重叠 MMA 与 epilogue/IO | 提高计算利用率 |
| TMA 存储优化 | 使用异步 TMA 存储替代同步 st.global | 20.1% 加速 |
| Token Routing | Tile 感知的 token 舍入路由 | 1.16× 额外加速 |
IO 感知内核设计
Gather 融合策略
SonicMoE 采用独特的 “gather then GEMM” 策略(Figure 9 左):
- 每个专家直接通过 TMA 存储连续打包的输出
- 在 expert aggregation 内核中,每个 token gather 并求和激活专家的输出
- 相比 ScatterMoE 的 “scatter in epilogue” 策略,实现 17% 加速
Ping-Pong Warp 调度
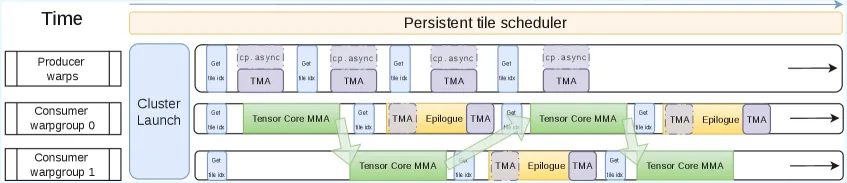
Figure 7: Hopper GPU 上的 Ping-Pong warpgroup 调度。两个消费者 warpgroup 交替执行 MMA 和 epilogue,实现 IO 与计算的重叠。
TMA 存储 vs 同步存储
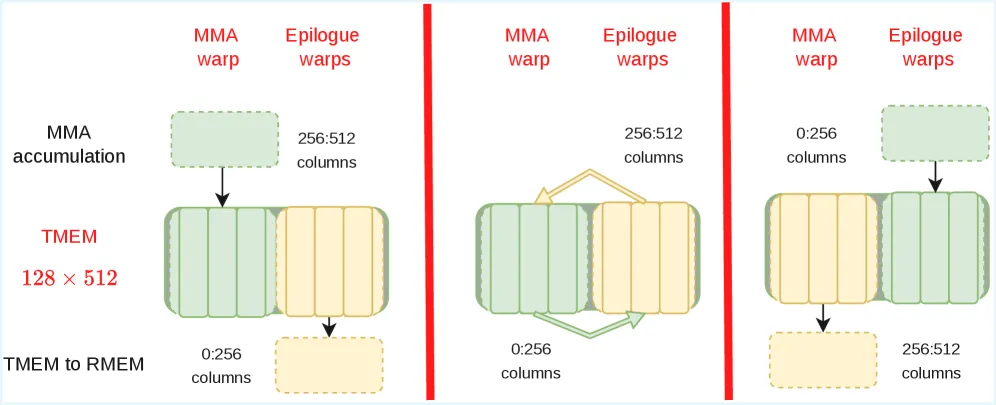
Figure 8: 异步 TMA 存储(上)具有更高内存带宽,可自然与 TensorCore MMA 重叠;同步 st.global(下)阻塞下一个 MMA tile 的执行。
Token Rounding 路由
问题:稀疏 MoE 中,Grouped GEMM 需要将每个专家的 token 数对齐到 tile 大小 ,导致填充浪费。
解决方案:Token Rounding 将每个专家接收的 token 频率舍入到 的倍数:
算法流程:
- Top-K token 选择排序
- 计算每个专家的 token 频率
- 舍入到 的倍数
- 根据舍入后的频率重新分配 token
五、实验结果
运行时分解
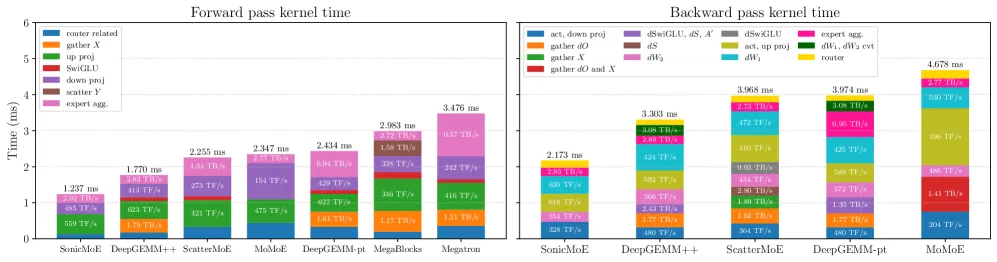
Figure 6: 不同 MoE 内核在 7B MoE 训练上的运行时分解(ms)。
关键观察:
- SonicMoE 在 gather、SwiGLU、expert aggregation 等内存受限内核上实现最高带宽
- Grouped GEMM 内核实现最高计算吞吐量
- 相比 ScatterMoE,前向 down-proj 内核实现 1.75× 加速
激活内存对比
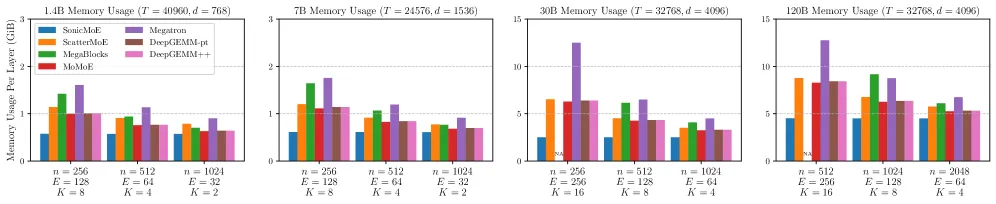
Figure 13: 不同模型规模(1.4B-120B)的峰值激活内存使用。
| 模型规模 | SonicMoE | ScatterMoE | MoMoE | 节省比例 |
|---|---|---|---|---|
| 7B (n=256) | 基准 | +45% | +100%+ | 45% |
| 30B | 基准 | +30% | +80% | 30% |
| 120B | 基准 | +20% | +60% | 3 GiB/层 |
吞吐量对比
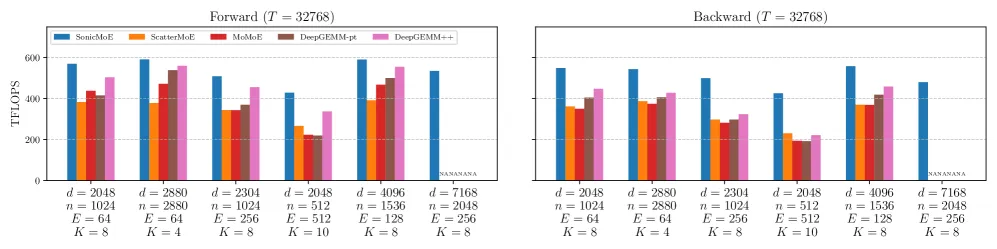
Figure 15: 不同配置(7B-685B)的前向和后向 TFLOPS。
Hopper GPU (H100) 结果:
| 配置 | SonicMoE | ScatterMoE | MoMoE | DeepGEMM++ |
|---|---|---|---|---|
| OLMoE-7B | 950 TFLOPS | 510 TFLOPS | 310 TFLOPS | 850 TFLOPS |
| Qwen3-235B | 880 TFLOPS | 450 TFLOPS | 280 TFLOPS | 800 TFLOPS |
| DeepSeek-V3.2 | 850 TFLOPS | OOM | OOM | OOM |
Blackwell GPU 结果:
- 前向: 25% 相对加速(vs DeepGEMM)
- 后向: 15% 相对加速(vs DeepGEMM)
Token Rounding 效果
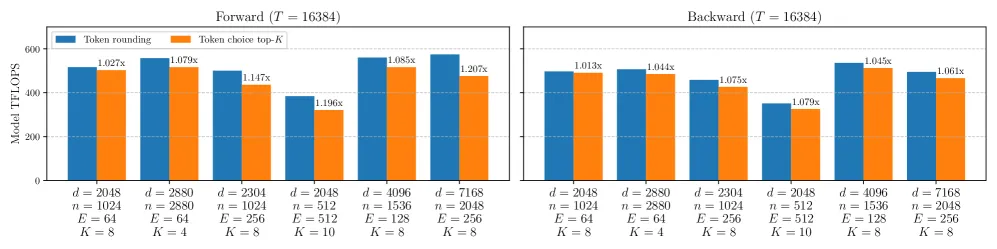
Figure 17: 不同路由方法的前向和后向 TFLOPS。
关键发现:
- Token Rounding (TR) 在高稀疏度配置下提供额外 1.16× 加速
- 与标准 Top-K 路由相比,下游任务性能保持相似
- 训练后可无缝切换回 token choice 路由
训练吞吐量
| 配置 | SonicMoE (64 H100) | ScatterMoE (96 H100) |
|---|---|---|
| 7B MoE | 213B token/天 | 225B token/天 |
关键洞察: SonicMoE 用更少的 GPU(64 vs 96)实现了相当的训练吞吐量。
六、与现有方法对比
| 特性 | SonicMoE | ScatterMoE | MoMoE | MegaBlocks | DeepGEMM |
|---|---|---|---|---|---|
| Gather 融合 (前向) | ✅ | ✅ | ✅ | ❌ | ❌ |
| Gather 融合 (后向) | ✅ | ❌ | ❌ | ❌ | ❌ |
| SwiGLU 融合 | ✅ | ❌ | ✅ | ❌ | N/A |
| dS 计算优化 | ✅ | ❌ | ❌ | ❌ | N/A |
| MMA/IO 重叠 | ✅ | ❌ | ❌ | ❌ | ❌ |
| 无需 shape 对齐 | ✅ | ✅ | ✅ | ❌ | ❌ |
| 高效 Top-K 排序 | ✅ | ❌ | ❌ | ❌ | N/A |
七、总结
核心贡献
- 内存高效算法:最小化细粒度 MoE 的激活内存(减少 45%)
- IO 感知内核:重叠内存 IO 与计算,提高吞吐量 1.86×
- Token Rounding 路由:消除 Grouped GEMM 中的 tile 量化效应,额外 1.16× 加速
- 开源所有内核:促进社区研究和应用
技术影响
- 架构设计: 为细粒度和稀疏 MoE 提供高效的训练方案
- 硬件利用: 通过 IO 重叠和融合最大化 GPU 利用率
- 扩展性: 支持从 7B 到 685B 的模型规模
- 跨平台: 同时优化 Hopper 和 Blackwell GPU
局限性与未来方向
- 当前仅支持 BF16 精度
- 未来方向:扩展到 FP8、MXFP8、MXFP4 等低精度格式
- 分布式设置中的通信与计算重叠(专家并行)
- 模型架构设计应优化 “每计算小时的质量” 而非仅 “每 FLOP 的质量”
八、参考资源
- 论文: arXiv:2512.14080
- PDF: arXiv PDF
- HTML: arXiv HTML
- 相关工作: ScatterMoE, MoMoE, MegaBlocks, DeepGEMM, CUTLASS