ProServe: Unified Multi-Priority Request Scheduling for LLM Serving
ProServe 将多优先级 LLM 服务形式化为服务增益最大化问题,提出 Token-level Deadline-aware Gain (TDG);引擎层 SlideBatching 用滑动 urgent/normal 边界结合密度与截止时间排序,服务层 GoRouting 做增益导向、感知能力的分发,跨四个开源数据集与工业追踪相对 SOTA 系统增益提升最多 35%、SLO 达成率提升最多 52%。
ProServe: Unified Multi-Priority Request Scheduling for LLM Serving
一、论文概述
| 项目 | 内容 |
|---|---|
| arXiv ID | 2512.12928 |
| 标题 | ProServe: Unified Multi-Priority Request Scheduling for LLM Serving |
| 作者 | Weizhe Huang, Tao Peng, Tongxuan Liu, Donghe Jin, Xianzhe Dong, Ke Zhang |
| 机构 | JD.com · USTC |
| 学科 | cs.DC |
| 链接 | https://arxiv.org/abs/2512.12928 |
二、核心思想
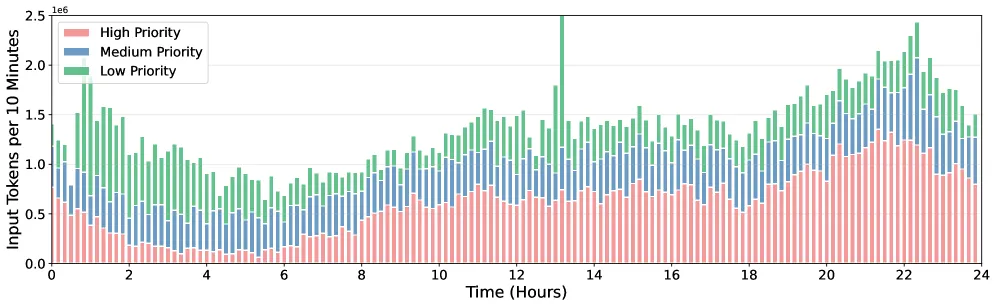
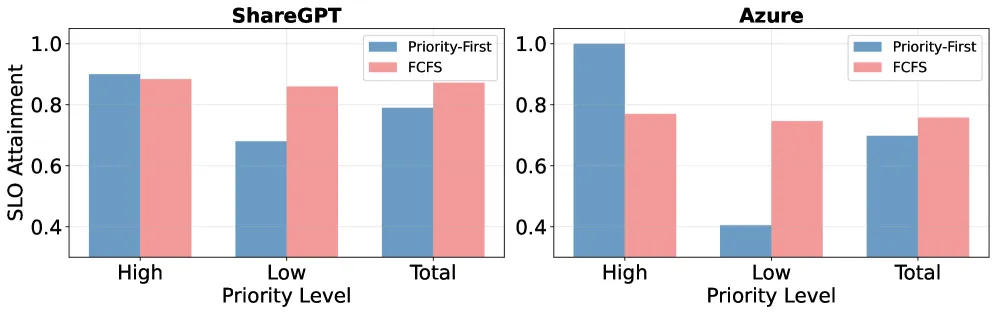
问题定义:现有 LLM 服务系统的调度器很少同时考虑 SLO 达成率 与 客户端级优先级。策略分为三类:(1)SLO 感知(Scorpio、Hyperflexis)——只按截止时间隐式区分;(2)在线/离线协同(Echo、BROS、HyGen)——把所有在线请求视为同优先;(3)在线优先级(Llumnix、Weighted VTC)——不给出显式 latency 保证。当高低优先级都需要各自的 SLO 时,缺一个统一框架。
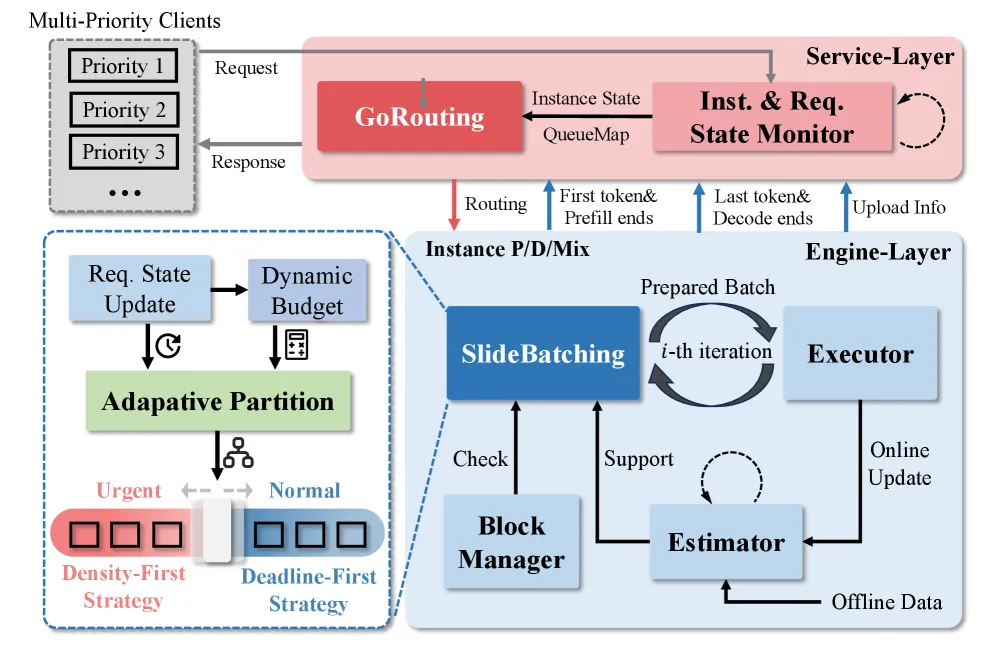
解决方案:把多优先级调度形式化为服务增益(service gain)最大化问题,提出 Token-level Deadline-aware Gain (TDG) 函数,能:区分优先级、感知每 token 延迟、区分首 token 与 decode token、鲁棒于”丢弃/延后”作弊。据此设计两层调度框架 ProServe:引擎层 SlideBatching + 服务层 GoRouting。
三、技术架构 / 方法
3.1 批延迟估计器
将批 的执行时间拆为 prefill / decode 两组线性回归 + 常量开销 :
离线训练后 MAPE ~4.5%;在线用滑动窗口的动量校正 。
3.2 SlideBatching(引擎层)
核心原则:能满足所有请求 deadline 就吃满系统增益;否则优先高优先级请求。批容量 定为队列中最小剩余 deadline,并有下界 :
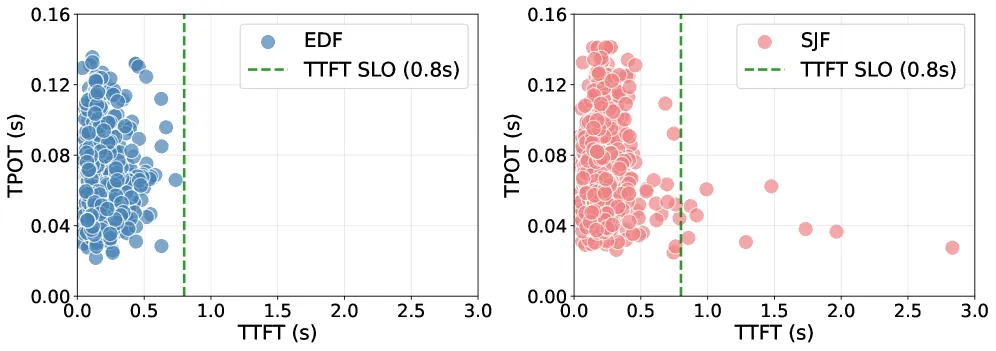
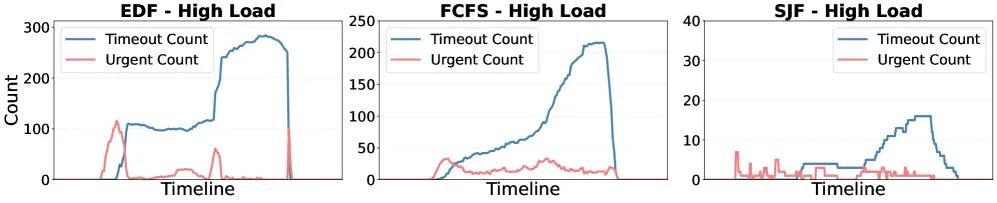
请求分为 Urgent(r.remain < γ · φ(r,Q))与 Normal,Urgent 内部按密度 降序,Normal 按 r.remain 升序。滑动边界随负载自适应。
PD co-located 场景下两种 实现:
PD disaggregation 场景仅调度 prefill 实例:
3.3 GoRouting(服务层)
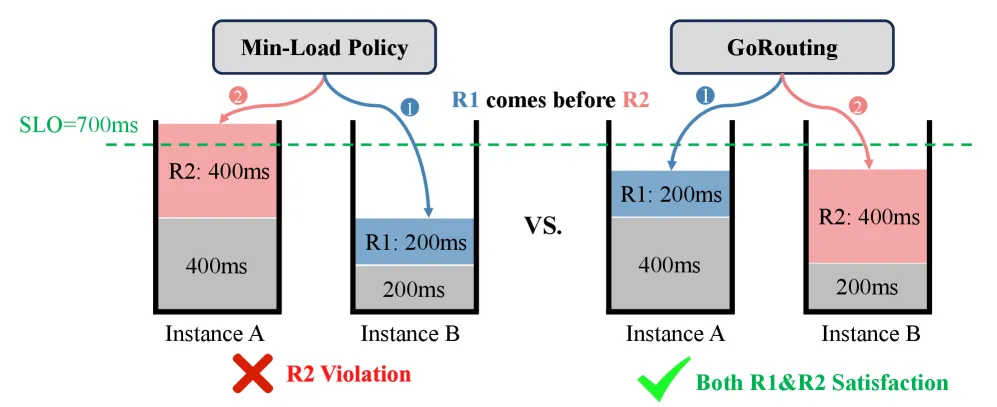
维护每个实例的调度器状态(KV usage、队列压力、running requests、predicted deadline slack)。核心思想:主动为未来高优先级 / 长请求预留容量。避免朴素 least-load 的”过度均衡”缺陷。分 PD 分离与 PD co-located 两种实例选择策略。
四、核心创新
| 创新点 | 说明 |
|---|---|
| TDG gain 函数 | 首个同时区分优先级、感知每 token 延迟、区分首/decode token 且抗丢弃 trick 的 gain |
| SlideBatching | 用滑动 urgent/normal 边界统一 deadline-first 与 density-first;在线校正的批延迟估计 |
| 自适应紧迫性判定 | 引入负载判断函数 的三种实现,覆盖 PD 分离与共置两种部署 |
| GoRouting | 主动为未来高优/长请求预留容量的增益导向路由 |
| 大规模验证 | 8×16 华为 Ascend 910B 集群 32 实例 Qwen3-32B 上工业追踪验证 |
五、实验结果
数据集:4 个开源数据集 + 1 个真实工业追踪。指标:TDG、SLO attainment、TTFT、TPOT。
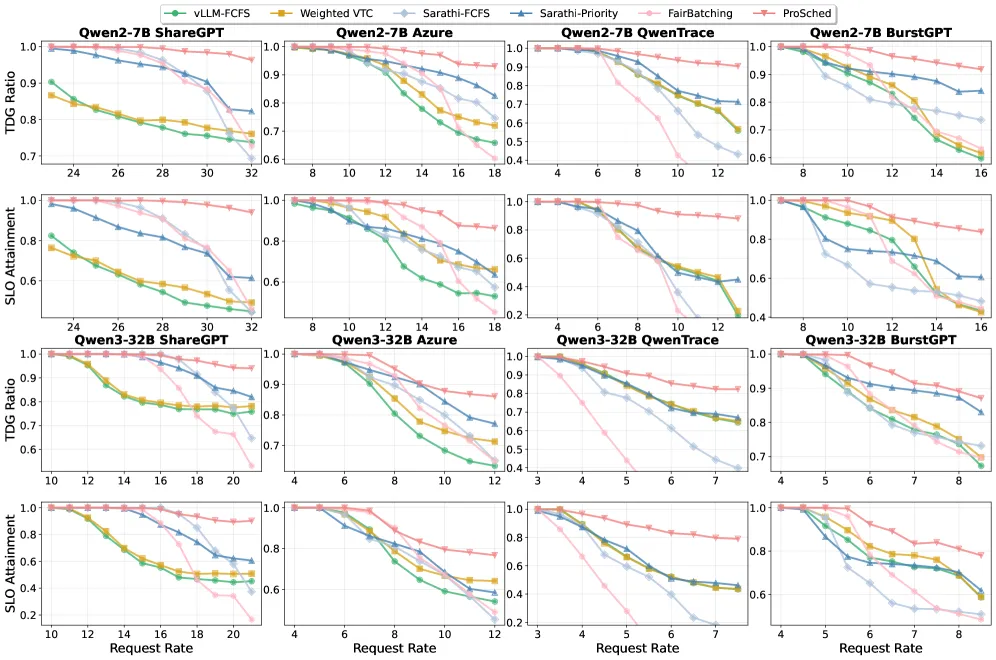
单节点 PD co-located(Figure 10)
- ProServe 在所有测试数据集 / 模型 / 负载下 TDG 与 SLO 均领先。
- Deadline-first 策略(FairBatching、Sarathi-FCFS)低负载与 ProServe 相当,高负载下崩溃到低于 vLLM-FCFS。
- Sarathi-Priority 严格优先级会饿死低优;Weighted VTC 只做 token 公平但忽略 SLO。
多节点
- PD 分离(Fig 11):GoRouting 提升多种本地调度器,轻载匹配 min-load,重载优于(预留容量);SlideBatching 提升 > GoRouting,因后者依赖流量模式。
- PD 共置(Fig 12):结论一致。
优先级视角(Qwen3-32B)
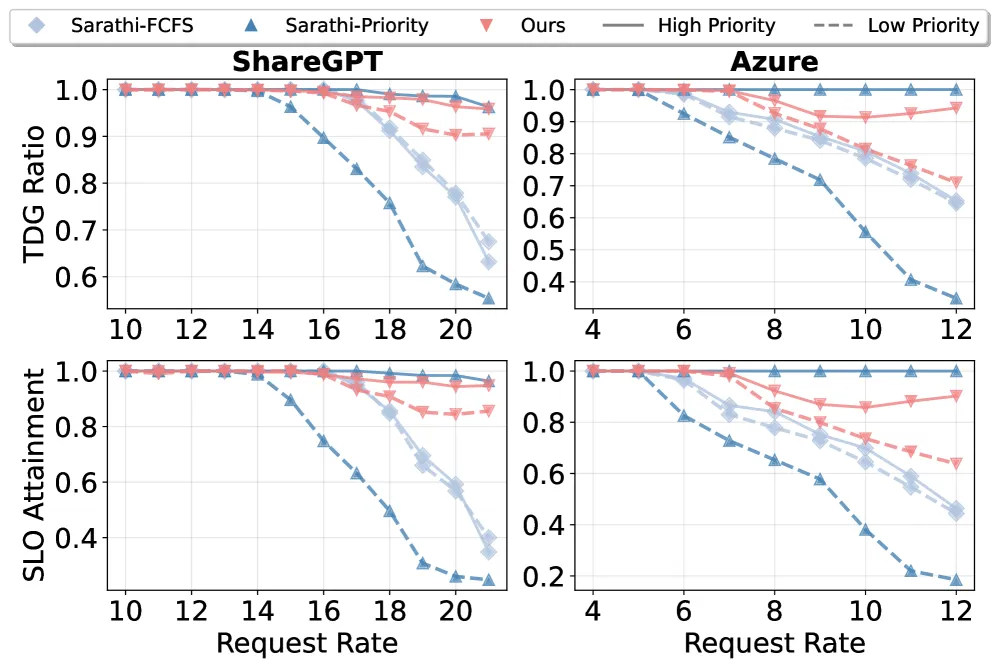
- ProServe 高低优先级 TDG/SLO 差异适度(保持优先级序);Sarathi-Priority 低优严重降级并整体下降;ProServe TTFT/TPOT 在两个优先级间分布最紧凑。
消融
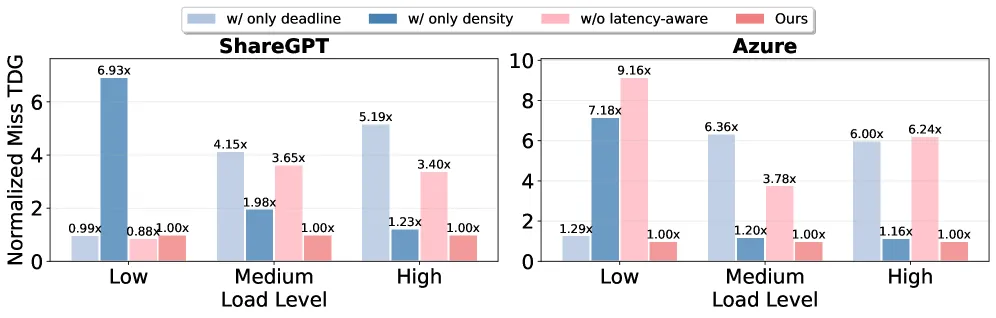
- 只 deadline / 只 density / 无 latency-aware 均下降,验证组件必要性;低负载 deadline > density,高负载相反,与 §3.2 分析一致。
大规模集群
- 8 台服务器 × 16 Ascend 910B,32 个 Qwen3-32B 实例,工业负载中 ProServe 持续优于所有基线,系统增益提升最多 35%,SLO attainment 提升最多 52%。
优先级权重扩展
- 高优 SLO 达成率随权重增加而单调升,低优单调降;总体 SLO 稳定。ProServe 在高负载下”更激进”保护高优,但相比 Sarathi-Priority 综合更均衡。
六、总结
- 核心贡献:把多优先级 LLM 服务形式化为服务增益最大化问题;给出 TDG gain 函数 + 引擎层 SlideBatching + 服务层 GoRouting 的两层框架,并在开源与工业负载上均达 SOTA。
- 技术影响:为大规模企业级 LLM 服务提供了统一处理”优先级 + SLO”的调度栈;批延迟估计器可复用于其他调度策略。
- 局限性:TDG 参数(优先级权重)需业务估计;GoRouting 效果依赖流量模式,具体收益弱于 SlideBatching;实验模型主要是 Qwen 系列,长上下文与多模态负载未评估。
七、参考资源
- 论文原文:arXiv:2512.12928
- 相关系统:Sarathi-Serve、Scorpio、Hyperflexis、Llumnix、Weighted VTC、Tempo、Echo、BROS、HyGen
- 硬件:Ascend 910B × 128 集群