BLASST: Dynamic BLocked Attention Sparsity via Softmax Thresholding
基于softmax阈值的动态块稀疏注意力,无需训练和预计算,同时加速预填充和解码阶段
BLASST: Dynamic BLocked Attention Sparsity via Softmax Thresholding
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | BLASST: Dynamic BLocked Attention Sparsity via Softmax Thresholding |
| 作者 | Jiayi Yuan, Cameron Shinn, Kai Xu, et al. (Song Han, Huizi Mao) |
| 机构 | NVIDIA |
| 论文 | arXiv:2512.12087 |
| 代码 | GitHub (artifact) |
| 发布 | 2025年12月12日(v1),2026年4月28日(v3) |
| 集成 | TensorRT-LLM, FlashInfer |
二、核心思想
BLASST是一种简洁高效的训练无关稀疏注意力方法,通过复用FlashAttention在线softmax计算过程中已有的统计量,动态跳过不重要的注意力块。核心创新在于:
- 零开销跳过决策:利用运行最大值(running maximum)和块最大值(block maximum)的差值判断是否跳过,无需额外计算
- 双阶段加速:同时优化预填充(计算密集)和解码(内存带宽密集)阶段
- 自动校准机制:阈值与上下文长度呈反比关系 ,支持跨场景部署
- 即插即用:无需训练、无预计算开销,支持MHA、GQA、MQA和MLA所有主流注意力变体
问题定义
现有稀疏注意力方法的五大部署障碍:
| 障碍 | 说明 | 代表方法 |
|---|---|---|
| 预计算开销 | 需要额外前向传播确定稀疏模式 | MInference, XAttention |
| 训练需求 | 需要微调或训练新架构 | NSA, DSA |
| 单阶段优化 | 仅优化预填充或解码 | MInference (预填充), Quest (解码) |
| 代理分数误差 | 使用近似分数而非真实softmax统计 | XAttention |
| 注意力变体限制 | 不支持MLA等新架构 | 大多数方法 |
解决方案概述
BLASST通过以下方式解决上述所有障碍:
- 在FlashAttention的分块在线softmax计算中,维护运行最大值
- 当块局部最大值 满足 时跳过该块
- 预填充阶段跳过softmax计算和矩阵乘法(节省CUDA核心和Tensor核心)
- 解码阶段跳过Value块的HBM加载(节省内存带宽)
三、技术架构
整体框架图
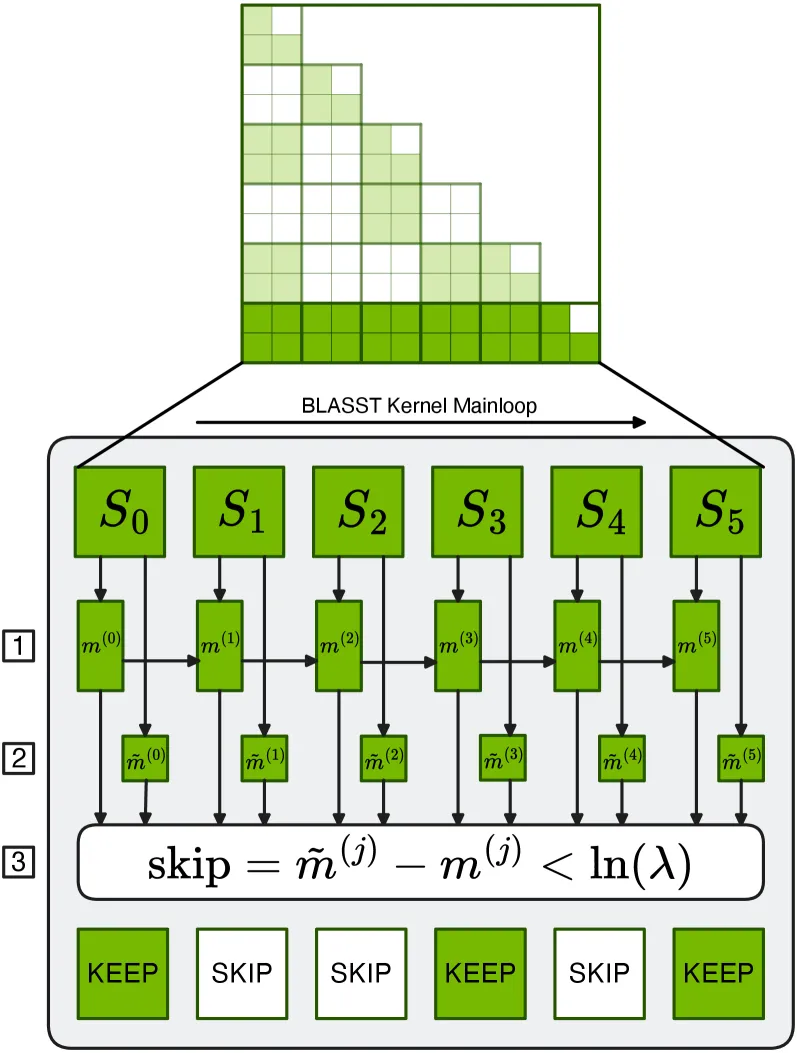
BLASST在FlashAttention的分块注意力计算中引入动态剪枝条件:沿注意力矩阵的每一行顺序处理KV块,维护运行最大值,当块的局部最大值显著低于运行最大值时跳过后续计算。
核心公式
标准注意力softmax:
跳过条件:
其中:
- :处理第 个块后的运行最大值
- :第 个块的局部最大值
- :阈值参数
当条件满足时,该块对最终输出的贡献可忽略不计,可以安全跳过。
阈值校准公式:
其中 是模型特定的缩放因子, 是上下文长度。这个反比关系有理论基础:注意力分数经过行归一化后和为1,更长的序列每个token的平均分数更低,需要更小的阈值。
校准模型:
其中 是目标稀疏度。指数形式反映了注意力分数的重尾分布特性。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 运行最大值追踪 | 在线softmax中维护的统计量 | 每个query块一个值 |
| 块最大值计算 | 当前KV块的局部最大值 | 每个块一次计算 |
| 跳过决策 | 比较差值与阈值 | 每个warp一次VOTE指令 |
| 校准模块 | 自动确定最优阈值 | 约1000个样本的单次前向传播 |
预填充内核优化
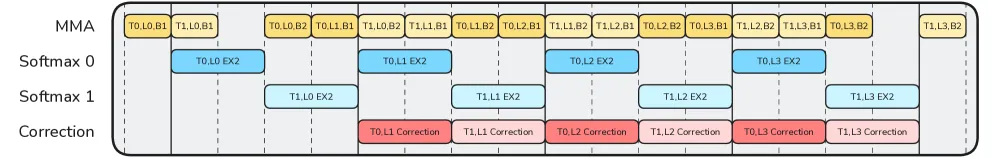
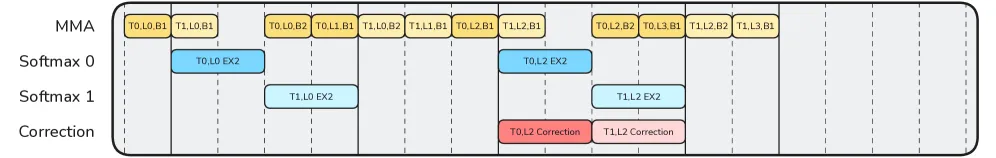
预填充阶段是计算密集型,瓶颈在CUDA核心(softmax)和Tensor核心(矩阵乘法)。
优化策略:
- 仍计算所有 (BMM1) 操作
- 对被跳过的块,省略exp操作(MUFU.EX2 + FMUL + FADD指令)和 矩阵乘法 (BMM2)
- 通过流水线调度隐藏跳过决策的开销
- Value块仍从HBM加载(保持预取流水线的规律性)
解码内核优化
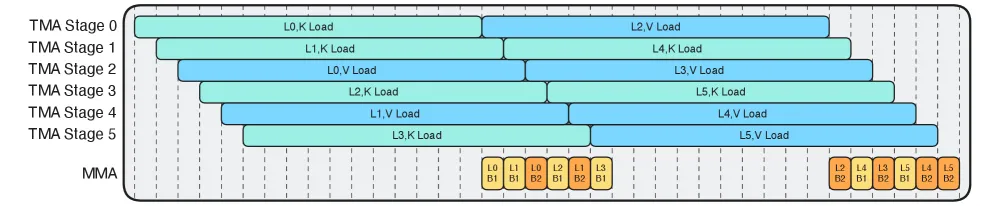
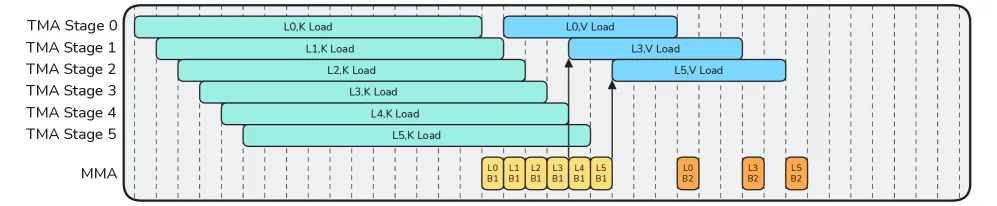
解码阶段是内存带宽密集型,瓶颈在KV缓存的HBM读取。
优化策略:
- 跳过被剪枝块的Value矩阵 的HBM加载
- 使用批量加载调度(batched load scheduling):连续处理多个 乘积后再批量加载Value
- 避免流水线气泡:将跳过决策提前到Key加载阶段
批量加载的优势:
- 原始方案:38个时间单位完成所有V加载
- BLASST方案:20个时间单位完成(仅加载通过阈值检查的块)
训练流程
BLASST是推理时方法,无需训练。但提供可选的稀疏感知训练扩展:
稀疏感知训练:
- 前向传播中应用BLASST跳过不重要的注意力块
- 被跳过的块在反向传播中自然不接收梯度
- 模型学会将重要信息集中在高分注意力块中
- 无需架构修改或辅助损失
训练效果:
- 在50-75%稀疏度范围内,稀疏训练模型比训练无关应用减少高达1.7倍的精度下降
- 在低稀疏度下甚至略优于密集基线
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 零开销跳过决策 | 复用在线softmax已有的统计量 | 0%稀疏度时速度0.96-1.00×,无显著开销 |
| 双阶段优化 | 预填充跳过计算,解码跳过内存访问 | 预填充1.52×,解码1.48× @70%稀疏度 |
| 自动校准 | 反比关系 | 平均误差仅1.2% |
| 通用注意力支持 | MHA、GQA、MQA、MLA | DeepSeek-R1 MLA上验证有效 |
| 组合兼容性 | 与XAttention、RocketKV等方法正交 | 组合使用精度下降最小 |
与现有方法对比
| 方法 | 加速预填充 | 加速解码 | 无需训练 | 无需预计算 |
|---|---|---|---|---|
| H2O | ✗ | ✓ | ✓ | ✓ |
| SnapKV | ✗ | ✓ | ✓ | ✓ |
| RocketKV | ✗ | ✓ | ✓ | ✗ |
| Quest | ✗ | ✓ | ✓ | ✗ |
| DuoAttention | ✓ | ✓ | ✗ | ✓ |
| DSA | ✓ | ✓ | ✗ | ✓ |
| MInference | ✓ | ✗ | ✓ | ✗ |
| SpargeAttention | ✓ | ✗ | ✓ | ✗ |
| XAttention | ✓ | ✗ | ✓ | ✗ |
| BLASST | ✓ | ✓ | ✓ | ✓ |
BLASST是唯一同时满足所有四项特性的方法。
五、实验结果
基准测试
评估设置:
| 项目 | 配置 |
|---|---|
| 模型 | Llama-3.1-8B-Instruct, Qwen3-8B-Instruct |
| 长上下文基准 | RULER (4K-128K), LongBench v2 |
| 推理基准 | MATH500, AIME 2024, GPQA, LiveCodeBench |
| 硬件 | NVIDIA Blackwell B200, Hopper H200 |
| 框架 | TensorRT-LLM, FlashInfer |
主要结果
Table 2: 不同稀疏度下的性能(Llama-3.1-8B 和 Qwen3-8B)
| 模型 | 目标稀疏度 | 预填充阶段 | 解码阶段 |
|---|---|---|---|
| RULER-32K | LongBench | ||
| Llama-3.1-8B | Dense | 92.33 | 31.40 |
| 50% | 91.81 | 31.80 | |
| 75% | 91.67 | 31.80 | |
| Qwen3-8B | Dense | 91.90 | 33.60 |
| 50% | 92.08 | 35.10 | |
| 75% | 92.11 | 34.40 |
关键发现:
- BLASST在50%稀疏度下几乎无精度损失,偶尔超越密集基线
- Qwen3-8B在MATH500上:96.23 vs 95.87(密集基线),AIME 2024:76.50 vs 75.00
- 即使在75%高稀疏度下,精度下降仍然很小
预填充阶段对比
Table 3: Llama-3.1-8B预填充对比
| 方法 | RULER 4K | 8K | 16K | 32K | 64K | 平均 | LongBench |
|---|---|---|---|---|---|---|---|
| Dense | 96.16 | 95.07 | 94.80 | 92.33 | 87.69 | 93.21 | 31.4 |
| FlexPrefill | 95.99 | 93.67 | 92.73 | 88.14 | 81.14 | 87.72 | 25.7 |
| MInference | 96.54 | 94.06 | 91.37 | 85.79 | 83.03 | 84.15 | 31.2 |
| XAttention | 96.37 | 94.47 | 94.48 | 91.91 | 85.01 | 92.44 | 30.6 |
| BLASST (~50%) | 96.17 | 94.70 | 94.61 | 91.81 | 87.06 | 92.87 | 31.8 |
BLASST在所有稀疏方法中获得最佳整体精度(RULER 92.87,LongBench 31.8),最接近密集注意力(93.21,31.4)。
解码阶段对比
Table 4: Qwen3-8B解码对比
| 方法 | RULER-32K | LongBench | MATH500 | AIME 2024 | LiveCodeBench | GPQA | 平均 |
|---|---|---|---|---|---|---|---|
| Dense | 91.90 | 33.60 | 95.87 | 75.00 | 53.83 | 61.21 | 68.57 |
| Quest | 56.23 | 30.30 | 94.18 | 71.50 | 52.17 | 60.12 | 60.75 |
| RocketKV | 87.89 | 30.60 | 95.88 | 73.54 | 53.10 | 60.50 | 66.91 |
| BLASST ~50% | 91.55 | 33.90 | 96.23 | 76.50 | 54.15 | 61.51 | 68.97 |
BLASST在所有推理基准上匹配或超越密集基线,平均精度68.97 vs 68.57。
内核性能
Table 5: Blackwell B200 和 Hopper H200 加速比
| 稀疏度 | Blackwell 预填充 | Hopper 预填充 | Blackwell 解码 | Hopper 解码 |
|---|---|---|---|---|
| 0% | 1.00× | 1.00× | 0.98× | 0.96× |
| ~40% | 1.25× | 1.08× | 1.18× | 1.08× |
| ~50% | 1.33× | 1.27× | 1.25× | 1.20× |
| ~60% | 1.43× | 1.35× | 1.34× | 1.31× |
| ~70% | 1.52× | 1.52× | 1.48× | 1.40× |
| ~80% | 1.61× | 1.64× | 1.64× | 1.47× |
| ~90% | 1.71× | 1.78× | 1.71× | 1.56× |
关键发现:
- 0%稀疏度时速度0.96-1.00×,验证跳过决策逻辑的开销可忽略
- 近无损精度(~50%稀疏度):预填充1.33×,解码1.25×
- 高稀疏度(~70%):预填充1.52×,解码1.48×
- 加速比随稀疏度可预测增长
端到端性能
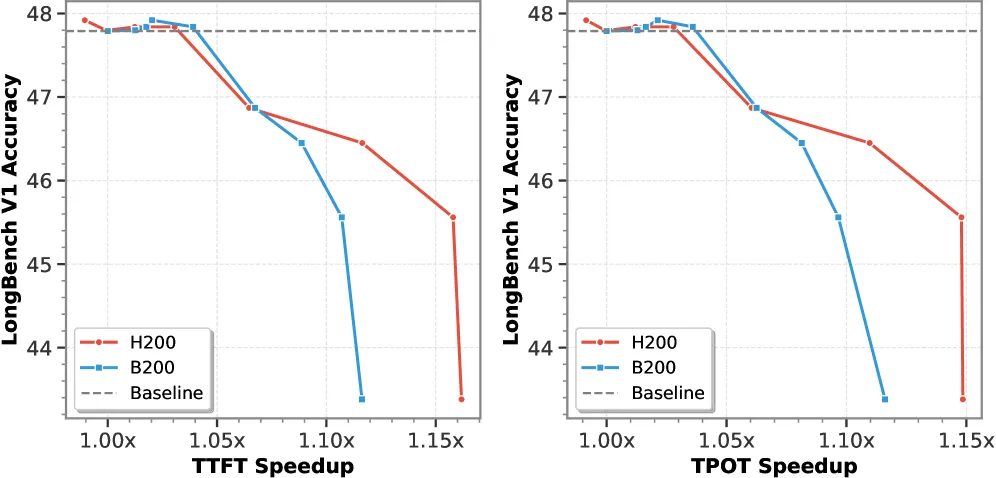
在推理服务环境中,BLASST在中长上下文长度下展现出有意义的端到端加速。以Qwen3-30B-A3B-Instruct在LongBench V1上评估:
- 仅1.1×的TTFT和TPOT加速时,LongBench V1精度仅有边际下降
- 随稀疏度增加,加速比持续提升
校准效果
Table 6: 校准 vs 固定阈值的稀疏度稳定性
| 目标稀疏度 | 方法 | 4K | 8K | 16K | 32K | 64K |
|---|---|---|---|---|---|---|
| 50% | 固定阈值 | 23% | 42% | 55% | 65% | 75% |
| 50% | 校准 | 51% | 50% | 50% | 51% | 52% |
| 70% | 固定阈值 | 45% | 62% | 72% | 78% | 83% |
| 70% | 校准 | 71% | 70% | 70% | 71% | 72% |
校准方法将稀疏度波动从23%-75%(固定阈值)缩小到50%-52%,平均误差仅1.2%。
稀疏感知训练
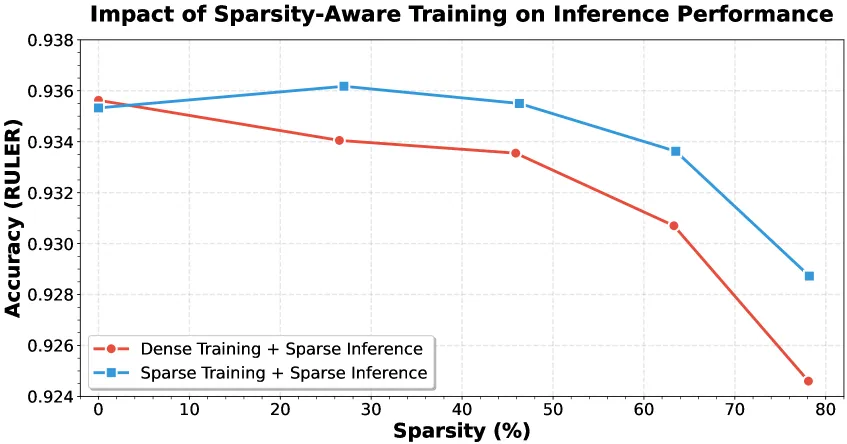
- 在50-75%目标稀疏度范围内,稀疏训练模型比训练无关应用减少高达1.7倍的精度下降
- 在低稀疏度下甚至略优于密集基线
- 模型学会将重要信息集中在高分注意力块中
稀疏度分布分析
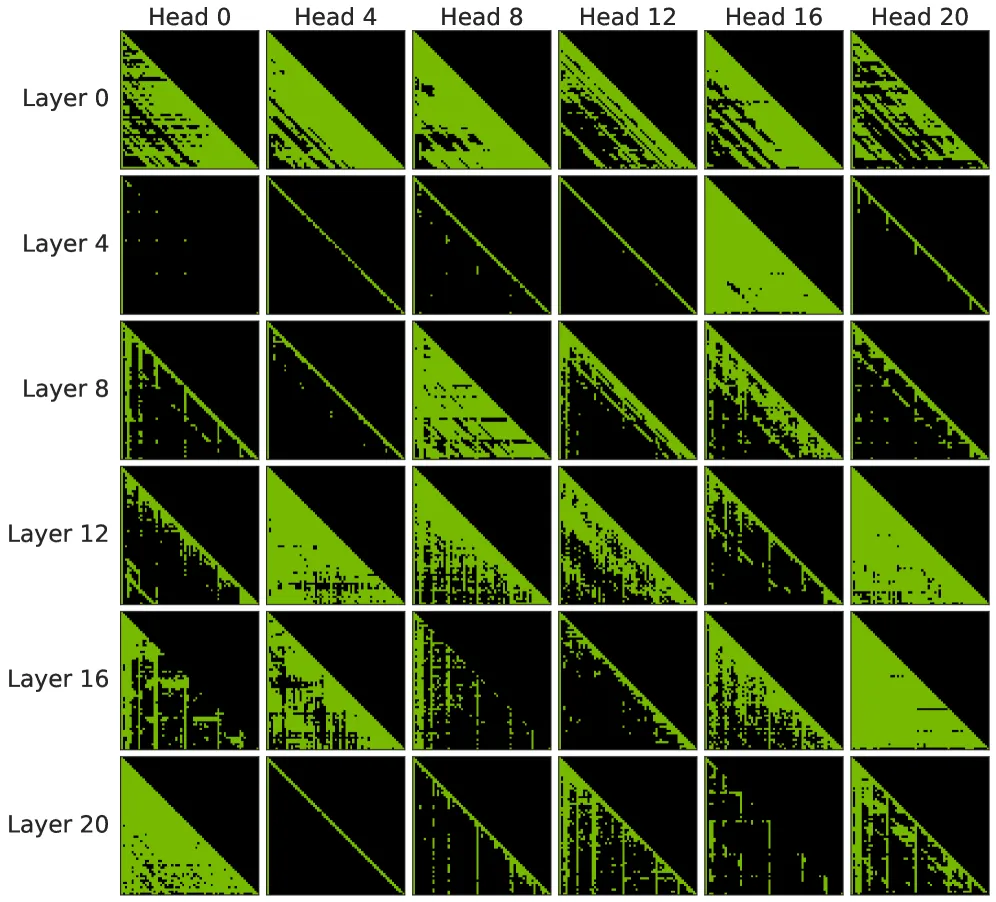
不同层和注意力头之间存在显著的稀疏度异质性:
- 不同层展现不同的稀疏度水平
- 同一层内的不同头也有显著方差
- BLASST通过统一阈值自然适应这种异质性,无需显式的top-k选择或头剪枝
组合兼容性
Table 7: 与其他稀疏方法的组合
| 预填充方法 | 解码方法 | RULER-16K | LongBench-16K |
|---|---|---|---|
| Dense | Dense | 91.90 | 33.60 |
| XAttention | Dense | 91.78 | 33.20 |
| Dense | RocketKV | 88.95 | 31.90 |
| XAttention | BLASST | 91.67 | 33.50 |
| BLASST | RocketKV | 88.79 | 32.30 |
BLASST可以与预填充优化方法(XAttention)和KV缓存压缩方法(RocketKV)有效组合。
超长序列
Table 8: RepoQA基准(Qwen3-Coder-30B)
| 上下文长度 | 注意力模式 | 预填充稀疏度 | 解码稀疏度 | 精度 |
|---|---|---|---|---|
| 16K | Dense | 0% | 0% | 84.9 |
| 16K | BLASST (P) | 44% | 0% | 84.9 |
| 16K | BLASST (P+D) | 44% | 38% | 84.5 |
| 200K | Dense | 0% | 0% | 75.8 |
| 200K | BLASST (P) | 58% | 0% | 75.4 |
| 200K | BLASST (P+D) | 58% | 44% | 75.1 |
在200K超长上下文中,BLASST自然获得更高稀疏度(58%),精度下降最小。
六、相关工作
| 方向 | 代表工作 | BLASST优势 |
|---|---|---|
| 静态稀疏模式 | Sparse Transformer, LongFormer, BigBird | 动态适应输入内容 |
| 动态稀疏(预填充) | MInference, XAttention, FlexPrefill | 同时加速解码,无预计算 |
| KV缓存压缩 | H2O, SnapKV, Quest, RocketKV | 同时加速预填充 |
| 代理分数方法 | SpargeAttention | 使用真实softmax统计,零开销 |
| 架构修改 | NSA, DSA | 训练无关,即插即用 |
| 注意力变体 | MLA (DeepSeek) | 兼容MLA,已验证有效 |
七、总结
核心贡献
- 提出BLASST,一种简洁高效的训练无关稀疏注意力方法
- 通过复用在线softmax统计量实现零开销跳过决策
- 同时优化预填充和解码阶段,填补现有方法的空白
- 提供自动校准机制,阈值与上下文长度呈反比关系
- 开发针对Blackwell和Hopper优化的CUDA内核,集成到TensorRT-LLM和FlashInfer
- 近无损精度(~50%稀疏度):预填充1.33×,解码1.25×;高稀疏度(~70%):预填充1.52×,解码1.48×
技术影响
- 唯一同时满足无需训练、无需预计算、加速预填充、加速解码四项特性的方法
- 已集成到主流推理框架(TensorRT-LLM, FlashInfer),具备实际部署价值
- 与其他稀疏方法正交,可组合使用构建端到端优化流水线
- 稀疏感知训练进一步拓展精度-稀疏度前沿
局限性
- 加速比与稀疏度可预测相关,但极端稀疏度(>90%)下精度退化加速
- 校准需要约1000个样本的单次前向传播,虽开销小但需要额外步骤
- 稀疏感知训练需要额外的微调成本
- 当前主要在8B-30B规模模型上验证,更大模型的扩展性待进一步评估