EditMGT: Unleashing Potentials of Masked Generative Transformers in Image Editing
首个基于掩码生成Transformer的图像编辑框架,通过注意力注入和区域保持采样实现6倍加速编辑
EditMGT: Unleashing Potentials of Masked Generative Transformers in Image Editing
论文信息: arXiv:2512.11715 [cs.CV] 12 Dec 2025
机构: ByteDance Inc.
模型规模: 960M 参数(基于 Meissonic)
一、论文概述
1.1 研究背景
图像编辑在生成式 AI 时代取得了显著进展,但扩散模型(DMs)的全局去噪动态导致编辑”泄漏”到非目标区域,造成意外修改。
核心挑战:
| 挑战 | 说明 |
|---|---|
| 全局去噪 | DMs 的全局去噪过程导致编辑泄漏 |
| 非目标修改 | 非目标区域被意外修改 |
| 推理速度 | 现有方法推理速度慢 |
| 模型规模 | 现有模型参数量大(2B-12B) |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| EditMGT 框架 | 首个基于 MGT 的图像编辑框架 |
| 注意力注入 | 无需额外参数的图像条件集成 |
| 多层注意力整合 | 增强注意力权重,实现精确定位 |
| 区域保持采样 | 限制低注意力区域的 token 翻转 |
| CrispEdit-2M 数据集 | 2M 高分辨率编辑样本,7 个类别 |
1.3 一句话总结
EditMGT 是首个基于掩码生成 Transformer 的图像编辑框架,通过注意力注入和区域保持采样实现 6 倍加速编辑,在风格转换任务上提升 17.6%。
二、核心思想
2.1 设计原则
┌─────────────────────────────────────────────────────────────────┐
│                    EditMGT 设计原则                              │
├─────────────────────────────────────────────────────────────────┤
│  1. 局部解码范式 (Localized Decoding Paradigm)                   │
│     • 预测多个掩码 token 而非整体精炼                             │
│     • 天然支持零样本图像修复                                     │
│     • 避免 DMs 的纠缠问题                                       │
│                                                                 │
│  2. 自适应定位 (Adaptive Localization)                           │
│     • 跨注意力图提供定位信号                                     │
│     • 多层注意力整合增强信号                                     │
│     • 无需手动预定义掩码                                         │
│                                                                 │
│  3. 区域保持 (Region Preservation)                               │
│     • 低注意力区域保持原 token                                   │
│     • 显式保留非目标区域                                         │
│     • 解决编辑泄漏问题                                          │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | EditMGT 解决方案 |
|---|---|---|
| 编辑泄漏 | DMs 全局去噪导致非目标修改 | MGT 局部解码 + 区域保持采样 |
| 定位精度 | 需要手动预定义掩码 | 多层注意力整合实现自适应定位 |
| 推理速度 | DMs 迭代去噪速度慢 | MGT 并行预测,6 倍加速 |
| 模型规模 | 现有模型 2B-12B 参数 | 仅 960M 参数 |
三、技术架构
3.1 整体架构
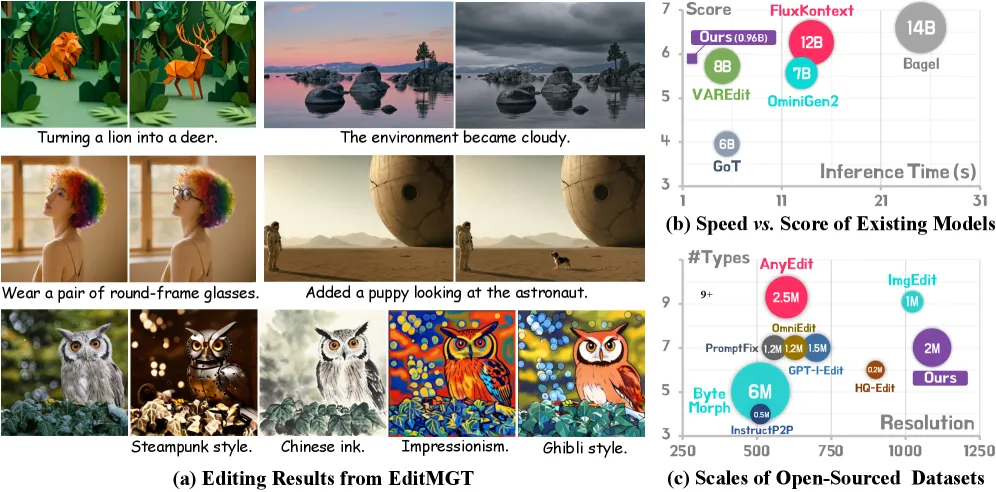 图 1:EditMGT 和 CrispEdit-2M 概览。EditMGT 是首个基于 MGT 的模型,以 960M 参数在 2 秒内完成编辑,比同等性能模型快 6 倍。
核心组件:
| 组件 | 说明 | 关键特性 |
|---|---|---|
| MGT 骨干 | Meissonic 基础模型 | 掩码生成 Transformer |
| 注意力注入 | 图像条件集成 | 无额外参数 |
| 多层注意力整合 | 增强注意力权重 | 精确定位编辑区域 |
| 区域保持采样 | 限制 token 翻转 | 保留非目标区域 |
3.2 架构细节
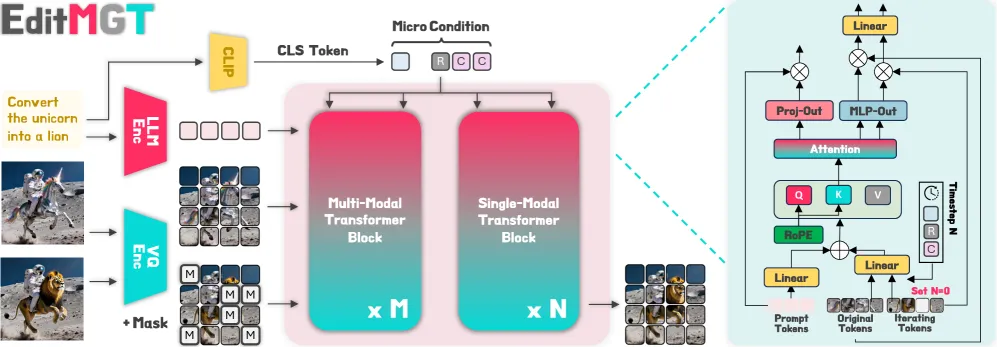 图 2:EditMGT 概览。我们的方法通过原始图像注意力注入监督编辑图像生成。右侧面板说明了多模态 Transformer 块内的 token 级交互。
MGT 预备知识:
- 从空白画布开始,所有视觉 token 被掩码
- 每次采样迭代并行预测所有缺失 token
- 使用拒绝标准:低模型可能性的 token 被掩码并在下一次迭代重新预测
图像条件集成:
- 定义图像条件 token ,与 形状相同
- 与 共享参数,但时间步固定为 0
- 通过注意力偏置 控制条件强度
3.3 核心公式
训练目标:
注意力偏置矩阵:
区域保持采样定位图:
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 首个 MGT 编辑框架 | 利用 MGT 局部解码特性 | 解决 DMs 编辑泄漏问题 |
| 注意力注入 | 无额外参数的图像条件集成 | 从 T2I 模型转换为编辑模型 |
| 多层注意力整合 | 增强注意力权重,精确定位 | 自适应定位编辑区域 |
| 区域保持采样 | 限制低注意力区域 token 翻转 | 显式保留非目标区域 |
| CrispEdit-2M | 2M 高分辨率编辑样本 | 7 个类别,严格过滤 |
4.2 技术亮点
1. 注意力注入机制:
- 与 共享参数,时间步固定为 0
- 通过 控制条件强度
- 移除条件影响, 增强条件
2. 多层注意力整合:
- 聚合第 28-36 层的注意力权重
- 使用自适应滤波增强清晰度和空间精度
- 解决激活区域不完整和边界不清晰问题
3. 区域保持采样:
- 定义阈值 确定哪些 token 应恢复
- 的 token 恢复为原始 token
- 保持采样调度器的完整性
五、实验结果
5.1 Emu Edit & MagicBrush 基准
| 方法 | Emu Edit | MagicBrush | ||||||
|---|---|---|---|---|---|---|---|---|
| CLIP_im | CLIP_out | L1 | DINO | CLIP_im | CLIP_out | L1 | DINO | |
| InstructPix2Pix | 0.834 | 0.219 | 0.121 | 0.762 | 0.837 | 0.245 | 0.093 | 0.767 |
| MagicBrush | 0.838 | 0.222 | 0.100 | 0.776 | 0.883 | 0.261 | 0.058 | 0.871 |
| AnyEdit | 0.872 | 0.285 | 0.070 | 0.821 | 0.898 | 0.275 | 0.051 | 0.881 |
| VAREdit-8B | 0.876 | 0.280 | 0.094 | 0.825 | 0.901 | 0.287 | 0.083 | 0.844 |
| EditMGT | 0.878 | 0.308 | 0.093 | 0.832 | 0.911 | 0.301 | 0.058 | 0.881 |
关键发现:
- EditMGT 在图像相似度(CLIP_im)上达到 SOTA
- 在 MagicBrush 上 DINO 分数达到 SOTA
- 仅 960M 参数,比基线模型小 2-8 倍
5.2 GEdit-EN-full 基准
| 模型 | BG | Color | Mat. | Motion | Style | Add | Remove | Replace | Text | Tone | Avg |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AnyEdit | 4.31 | 4.25 | 2.64 | 0.67 | 1.90 | 3.72 | 3.75 | 3.23 | 0.77 | 4.21 | 2.85 |
| MagicBrush | 6.17 | 5.41 | 4.75 | 1.55 | 2.90 | 5.53 | 4.13 | 5.10 | 1.33 | 5.07 | 4.19 |
| VAREdit-8B | 6.77 | 6.64 | 5.40 | 3.33 | 4.20 | 5.86 | 7.29 | 6.67 | 3.87 | 6.54 | 5.73 |
| FluxKontext.dev | 7.06 | 7.03 | 5.52 | 5.62 | 4.68 | 6.95 | 6.76 | 6.13 | 6.10 | 7.48 | 6.26 |
| EditMGT | 7.69 | 7.71 | 5.77 | 3.84 | 5.13 | 6.13 | 5.24 | 5.56 | 4.53 | 6.42 | 5.87 |
关键发现:
- EditMGT 在背景变化、颜色变化、肖像编辑、风格转换上超越 FluxKontext.dev
- 风格转换任务提升 17.6%
- 仅 960M 参数,比 FluxKontext.dev(12B)小 12 倍
5.3 定性比较
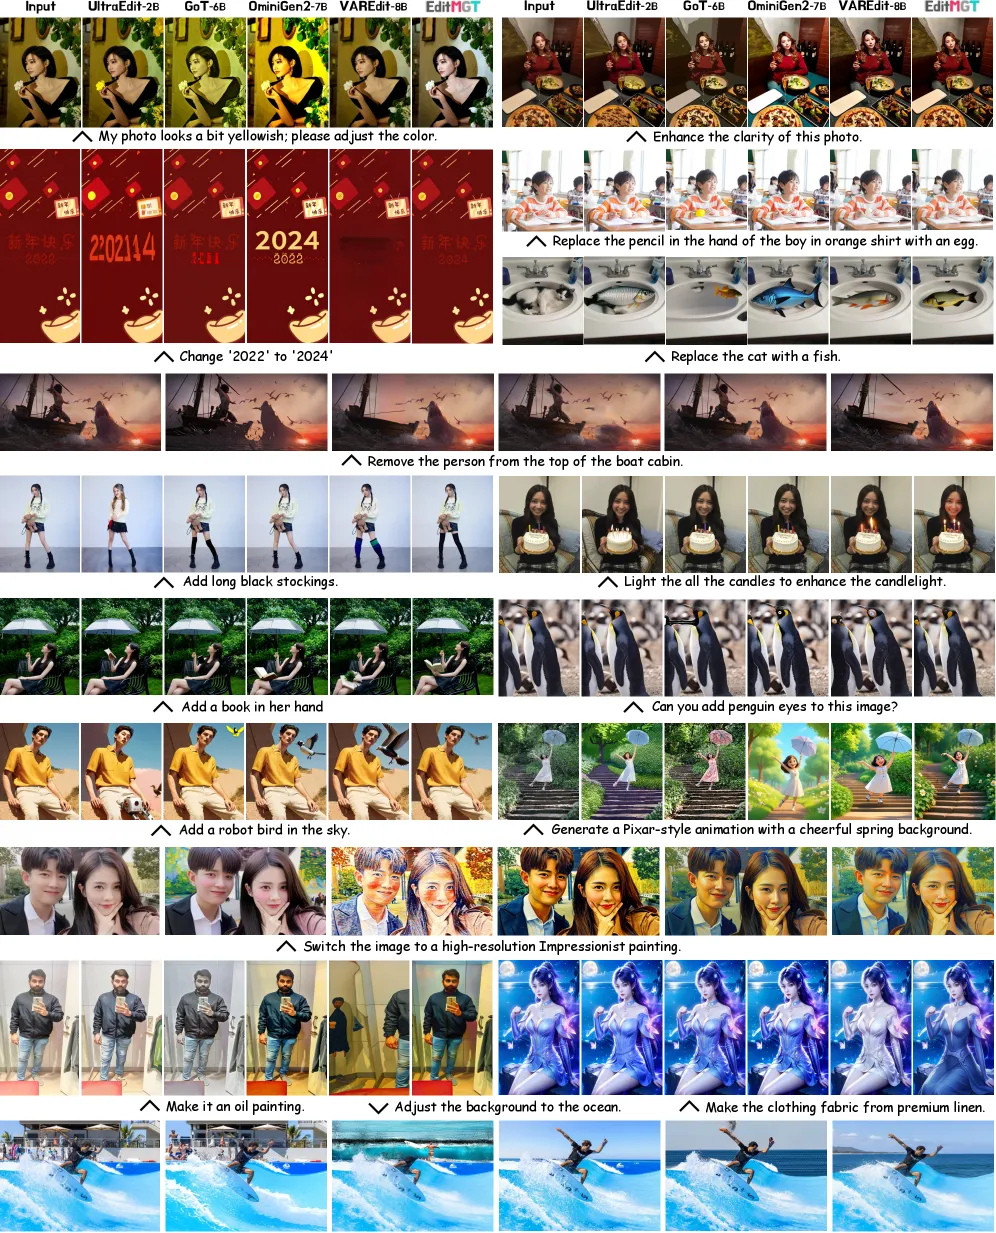 图 5:EditMGT 与其他开源编辑模型的定性比较
关键观察:
- 指令理解:EditMGT 正确理解隐式指令(如”调整颜色”→减少暖色调)
- 属性理解:准确理解形容词修饰(如”长黑色长袜”)
- 结构保持:有效保持原始结构组成
5.4 推理速度
| 指标 | EditMGT | 基线模型 |
|---|---|---|
| 参数量 | 960M | 2B-12B |
| 编辑速度 | 2 秒 | 12+ 秒 |
| 加速比 | 6 倍 | - |
| 内存占用 | 13.8 GB | - |
六、CrispEdit-2M 数据集
6.1 数据集概览
| 统计项 | 数量 |
|---|---|
| 总样本数 | 2M |
| 编辑类别 | 7 |
| 分辨率 | ≥1024 |
| 训练数据 | 4M(2M CrispEdit + 2M 额外) |
6.2 数据构建流程
三阶段训练:
| 阶段 | 目标 | 数据量 | 步数 |
|---|---|---|---|
| Stage 1 | 基础模型 + LLM 编码器 | 11M 文本-图像对 | 5,000 |
| Stage 2 | 全参数微调编辑模型 | 44M 编辑数据 | 50,000 |
| Stage 3 | 高质量全参数微调 | 高质量编辑数据 | 1,000 |
七、应用场景
7.1 指令引导编辑
- 文本指令:根据文本描述修改图像
- 隐式指令:理解隐式编辑意图
- 多条件编辑:同时满足多个编辑条件
7.2 风格转换
- 艺术风格:转换为特定艺术风格
- 动画风格:生成动画风格图像
- 色调调整:调整图像色调和氛围
7.3 对象操作
- 添加对象:在图像中添加新对象
- 移除对象:从图像中移除对象
- 属性修改:修改对象属性(颜色、大小等)
八、相关工作
8.1 扩散模型编辑
| 方法 | 特点 | 局限性 |
|---|---|---|
| InstructPix2Pix | 指令引导编辑 | 编辑泄漏问题 |
| UltraEdit | 高质量编辑 | 推理速度慢 |
| VAREdit | VAR 架构 | 参数量大 |
8.2 掩码生成模型
| 方法 | 特点 | 局限性 |
|---|---|---|
| Meissonic | MGT 基础模型 | 未针对编辑优化 |
| EditMGT | 首个 MGT 编辑框架 | 本方法 |
九、总结
9.1 核心贡献
- EditMGT 框架:首个基于 MGT 的图像编辑框架
- 注意力注入:无额外参数的图像条件集成
- 多层注意力整合:增强注意力权重,精确定位
- 区域保持采样:显式保留非目标区域
- CrispEdit-2M:2M 高分辨率编辑数据集
9.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| 图像编辑 | 解决 DMs 编辑泄漏问题 |
| 生成模型 | 展示 MGT 在编辑任务上的潜力 |
| 推理效率 | 实现 6 倍加速编辑 |
| 数据集 | 提供高质量编辑训练数据 |
9.3 局限性
- 模型规模:960M 参数仍有一定开销
- 类别覆盖:仅支持 7 个编辑类别
- 分辨率:主要针对高分辨率图像
- 隐式指令:隐式指令理解仍有提升空间
9.4 未来方向
- 模型压缩:进一步减小模型规模
- 更多类别:扩展到更多编辑类别
- 视频编辑:扩展到视频编辑任务
- 交互式编辑:支持用户交互式编辑
十、参考资源
10.1 论文链接
10.2 代码资源
- HuggingFace 模型: https://huggingface.co/WeiChow/EditMGT
- HuggingFace 数据集: https://huggingface.co/datasets/WeiChow/CrispEdit-2M
10.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | EditMGT 和 CrispEdit-2M 概览 | figure-1-overview.png |
| 图 2 | EditMGT 架构 | figure-2-architecture.png |
| 图 3 | 注意力机制 | figure-3-attention-mechanism.png |
| 图 4 | 阈值可视化 | figure-4-threshold-visualization.png |
| 图 5 | 定性比较 | figure-5-qualitative-comparison.png |
| 图 6 | AnyBench 结果 | figure-6-anybench-results.png |


10.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Meissonic | - | 2024 | MGT 基础模型 |
| InstructPix2Pix | Brooks et al. | 2023 | 扩散模型编辑基线 |
| FluxKontext.dev | - | 2025 | 12B 编辑模型基线 |
| VAREdit | - | 2025 | VAR 架构编辑基线 |
10.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 掩码生成 Transformer | Masked Generative Transformer (MGT) | 预测掩码 token 的生成模型 |
| 注意力注入 | Attention Injection | 无额外参数的条件集成 |
| 区域保持采样 | Region-Hold Sampling | 限制低注意力区域 token 翻转 |
| 多层注意力整合 | Multi-layer Attention Consolidation | 增强注意力权重 |
| 编辑泄漏 | Editing Leakage | 非目标区域被意外修改 |
分析完成时间:2026年6月17日 分析工具:Claude Code + agent-browser