xGR: Efficient Generative Recommendation Serving at Scale
面向生成式推荐的高效推理系统,通过xAttention/xBeam/xSchedule三层优化实现3.49倍吞吐量提升
xGR: Efficient Generative Recommendation Serving at Scale
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | xGR: Efficient Generative Recommendation Serving at Scale |
| 作者 | Qingxiao Sun, Tongxuan Liu, Shen Zhang, Siyu Wu, Peijun Yang, Haotian Liang, Menxin Li, Xiaolong Ma, Zhiwei Liang, Ziyi Ren, Minchao Zhang, Xinyu Liu, Ke Zhang, Depei Qian, Hailong Yang |
| 机构 | 北京航空航天大学、京东、北京科技大学、华为 |
| 论文 | arXiv:2512.11529 |
| 硬件 | 华为昇腾NPU集群 (64节点×16 NPU)、NVIDIA H800集群 (8节点×8 GPU) |
| 领域 | 生成式推荐、推理系统优化 |
二、核心思想
问题定义
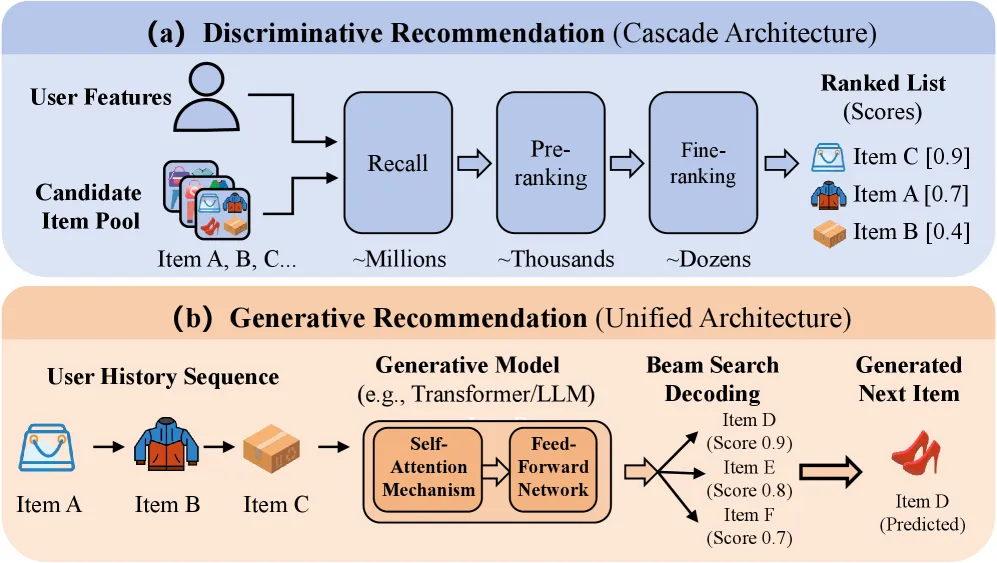
Figure 1: 判别式推荐与生成式推荐的架构对比
推荐系统从传统的判别式级联架构(DLRM)演进到生成式推荐(GR),后者利用LLM增强对长用户-物品序列的理解。然而,GR的工作负载与标准LLM推理有显著差异:
- 长提示短输出:GR处理长用户历史(prompt),生成短的固定长度输出
- 大束宽解码:beam search宽度≥128,解码阶段计算开销极高
- 海量物品空间:排序开销特别耗时
工作负载特征分析
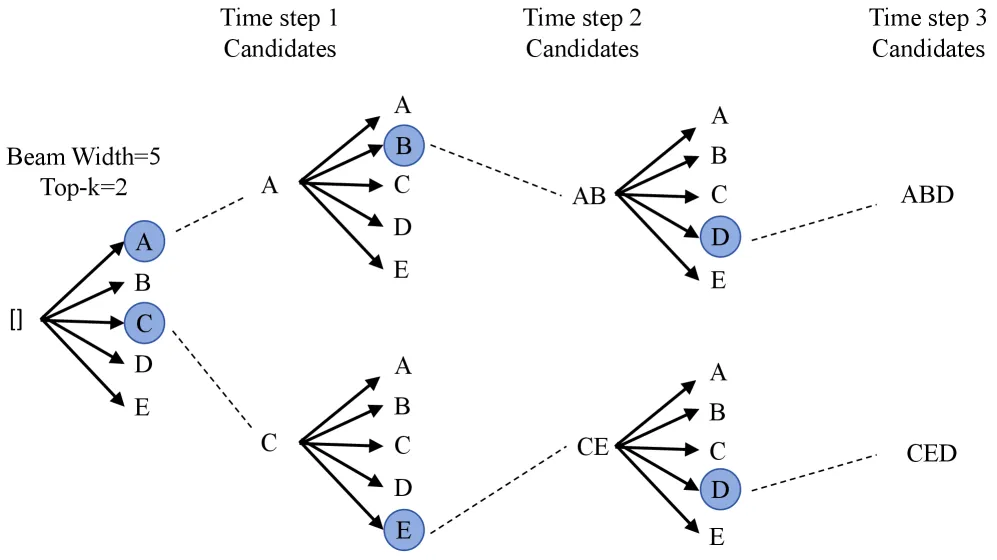
Figure 2: 束搜索过程示例
GR推理的三大关键特征:
| 特征 | 描述 | 影响 |
|---|---|---|
| 冗余内存访问 | 长上下文beam search中KV缓存重复加载 | 内存带宽瓶颈 |
| 内存低效 | beam分叉导致大量块复制和碎片化 | 内存消耗激增 |
| 延迟敏感 | 严格SLO(P99≤200ms)+ 小模型规模 | 调度挑战 |
动机分析
注意力性能问题:
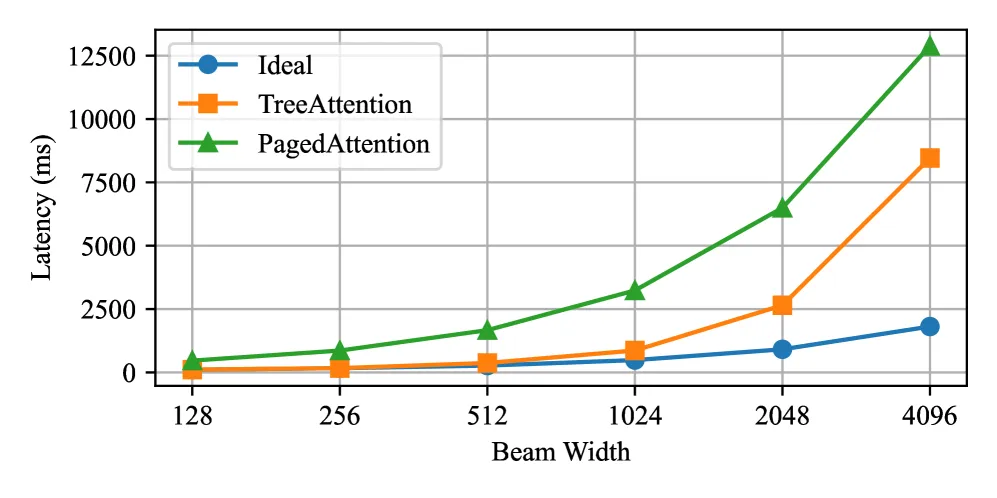
Figure 3: 不同束宽下各种注意力核的延迟对比
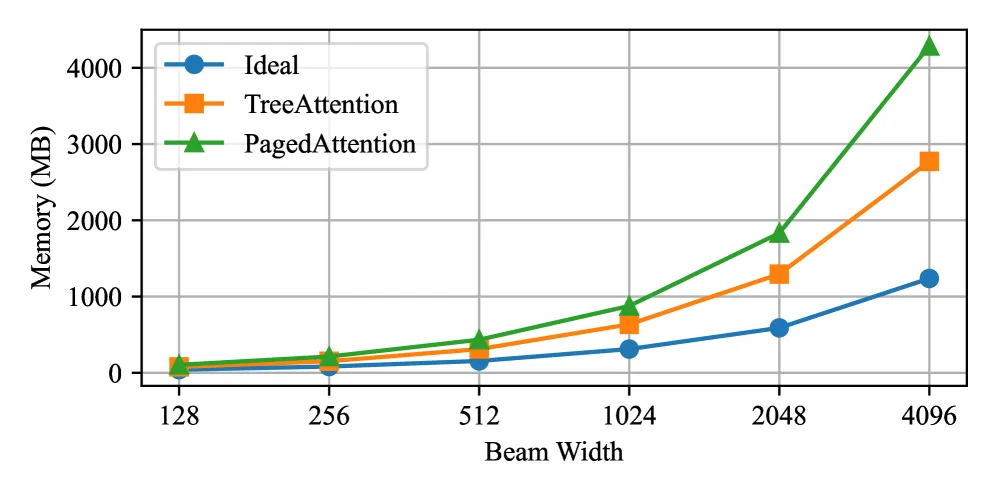
Figure 4: 不同束宽下各种注意力核的内存消耗对比
- PagedAttention延迟随束宽增加急剧上升
- TreeAttention部分缓解但有mask生成开销
- 内存消耗因块复制和碎片化而急剧增长
无效物品生成:
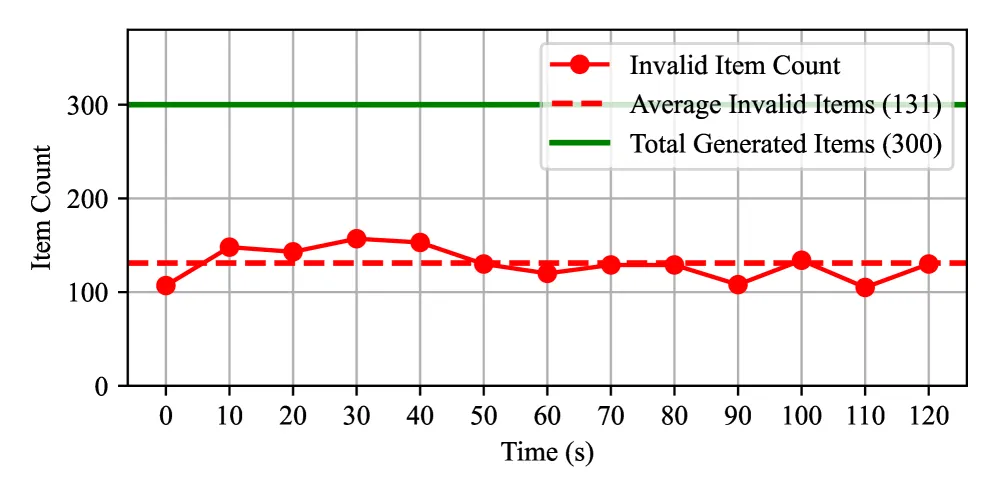
Figure 5: 无过滤时约50%的生成物品无效
- 约**50%**的生成物品在无过滤时无效
- 浪费大量计算资源
三、技术架构
系统概述
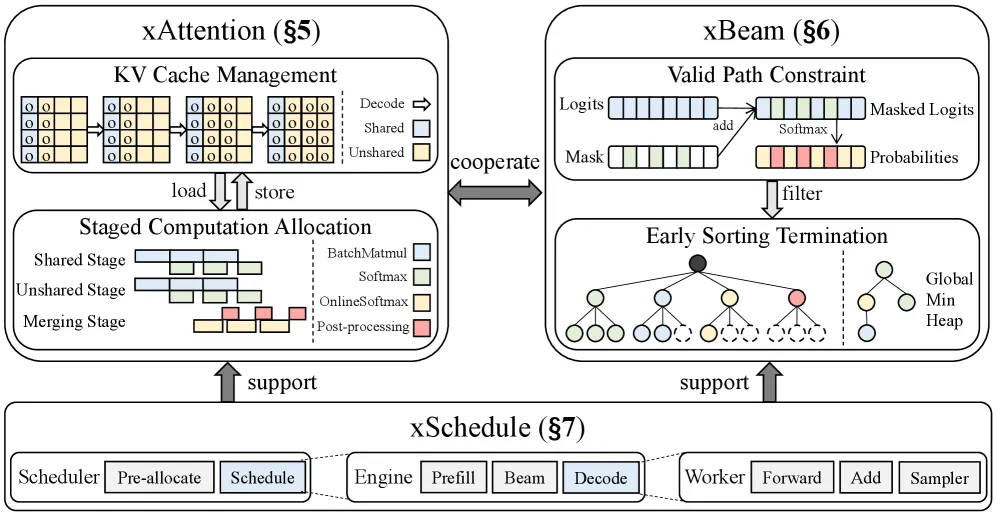
Figure 6: xGR设计概述
xGR包含三个核心组件,分别在算子级、算法级和系统级进行优化:
| 组件 | 层级 | 功能 |
|---|---|---|
| xAttention | 算子级 | KV缓存管理 + 分阶段计算 |
| xBeam | 算法级 | 物品过滤 + 提前终止排序 |
| xSchedule | 系统级 | 流水线并行 + 动态批处理 |
xAttention:注意力计算优化
KV缓存管理
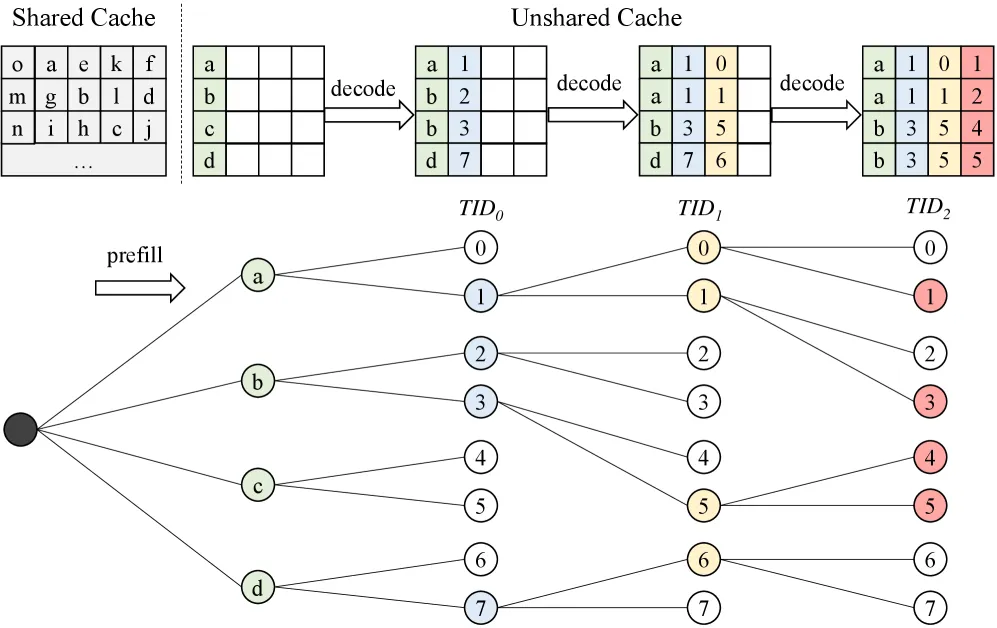
Figure 7: xAttention中的KV缓存管理
分离式KV缓存:
- 共享缓存(Shared Cache):存储prompt部分的KV,所有beam共享
- 非共享缓存(Unshared Cache):存储beam token的KV,各自独立
- token粒度管理:无需块复制,直接索引访问
原地块更新:
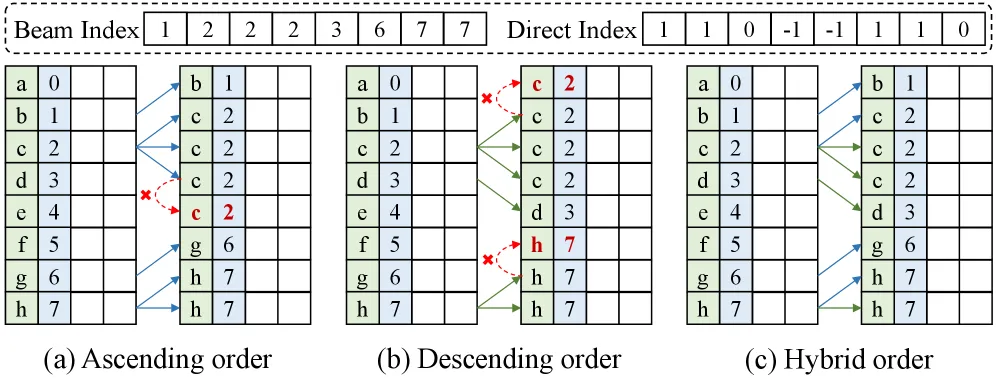
Figure 8: 非共享缓存中的原地块更新
使用直接索引(1表示向上,-1表示向下)安全更新块,避免写前读冲突:
分阶段计算分配
三阶段注意力计算:
- Shared Stage:计算共享prompt部分的注意力
- Unshared Stage:计算各beam独立token的注意力
- Merging Stage:合并共享和非共享结果
关键技术:
- OnlineSoftmax集成
- FlashAttention风格的分块计算
- 决策树回归器优化CG(Core Group)分区
流水线并行:
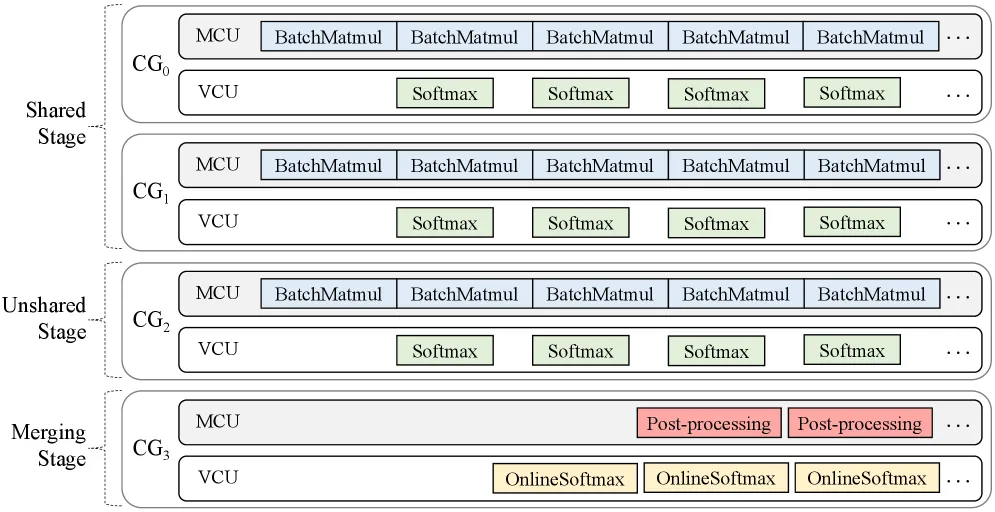
Figure 9: 跨硬件单元的流水线并行
- MCU/VCU流水线化
- CG间embarrassingly parallel执行
- 计算与通信重叠
xBeam:束搜索优化
有效路径约束
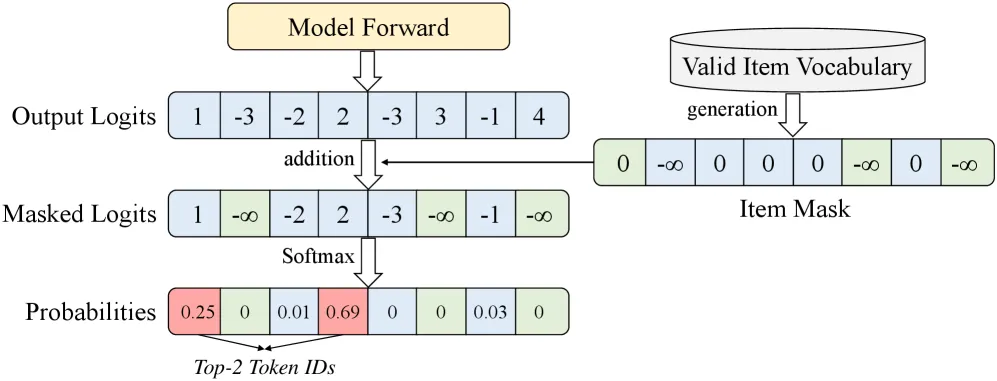
Figure 10: token生成中的有效路径约束
物品掩码机制:
- 在logits上添加物品掩码过滤无效token ID
- 稀疏+密集混合存储提高效率
- 设备端过滤,无需主机-设备同步开销
提前排序终止
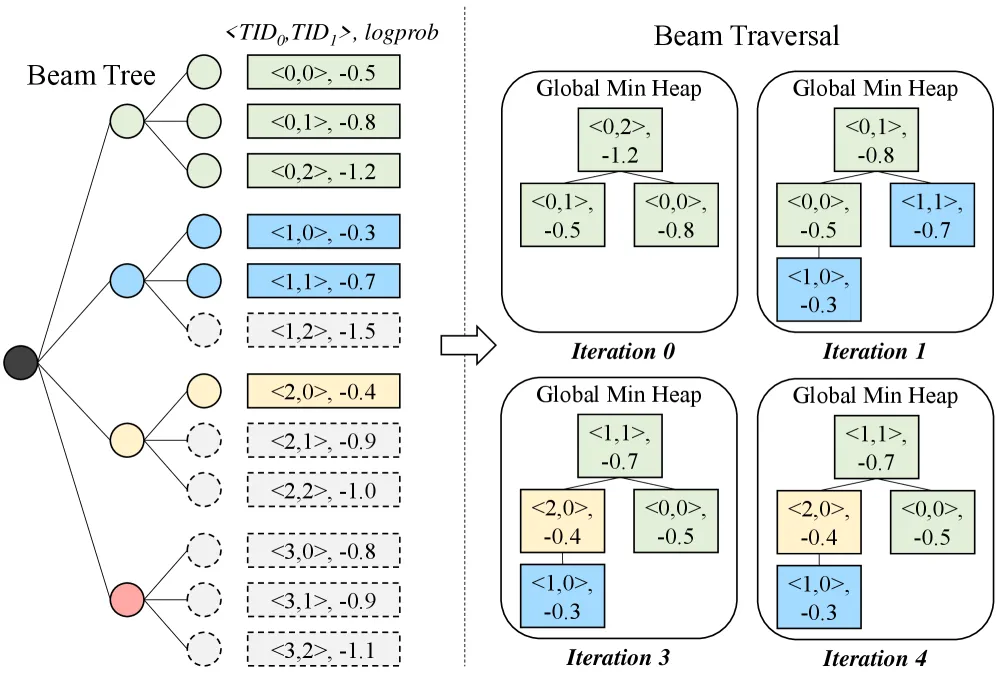
Figure 11: 带提前终止的排序过程
全局最小堆机制:
- 维护大小为BW的全局最小堆
- 当beam的log_prob低于堆顶时终止排序
- 显著减少排序计算量
数据结构复用
- 退役序列的数据结构被新序列复用
- 避免频繁的内存分配和释放
xSchedule:系统调度
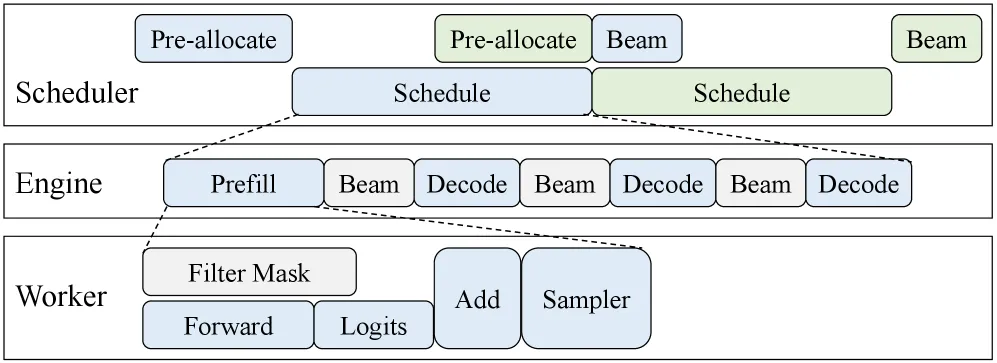
Figure 12: xSchedule整体流水线
三层调度架构:
| 层级 | 职责 |
|---|---|
| Scheduler | 请求路由和负载均衡 |
| Engine | 批次管理和执行调度 |
| Worker | 算子执行和资源管理 |
关键优化:
- 主机-设备重叠
- Kernel Graph调度
- 多流并行
- 动态批处理(token容量调整)
- H2D传输与计算重叠
四、核心创新
| 创新点 | 层级 | 说明 | 效果 |
|---|---|---|---|
| 分离式KV缓存 | 算子 | 共享/非共享缓存分离,token粒度管理 | 消除块复制 |
| 分阶段计算 | 算子 | Shared/Unshared/Merging三阶段 | 计算优化 |
| 物品掩码过滤 | 算法 | 设备端有效路径约束 | 过滤50%无效物品 |
| 提前排序终止 | 算法 | 全局最小堆机制 | 减少排序计算 |
| 数据结构复用 | 算法 | 退役序列资源复用 | 降低内存分配开销 |
| 三层调度架构 | 系统 | Scheduler/Engine/Worker层次化 | 流水线并行 |
| 跨平台移植 | 系统 | Ascend NPU + NVIDIA GPU统一抽象 | 广泛适用性 |
五、实验结果
实验设置
| 配置 | 详情 |
|---|---|
| Ascend集群 | 64节点,每节点16个NPU(64GB),HCCS互联 |
| GPU集群 | 8节点,每节点8个H800 GPU(80GB),NVLink互联 |
| 模型 | Qwen3 (0.6B-4B), OneRec (0.1B-3B) |
| 基线 | vLLM, xLLM |
| 数据集 | Amazon Review, JD Trace |
| 束宽 | 128, 256, 512 |
| SLO | P99 ≤ 200ms |
端到端性能
Qwen3模型结果:
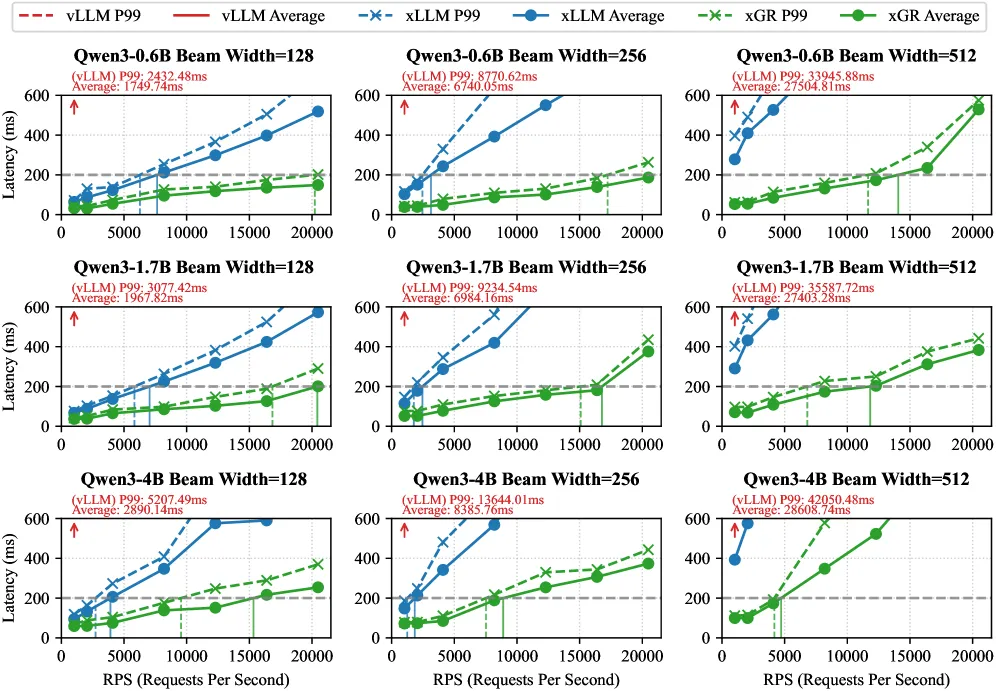
Figure 13a: Qwen3在Amazon Review数据集上的端到端对比
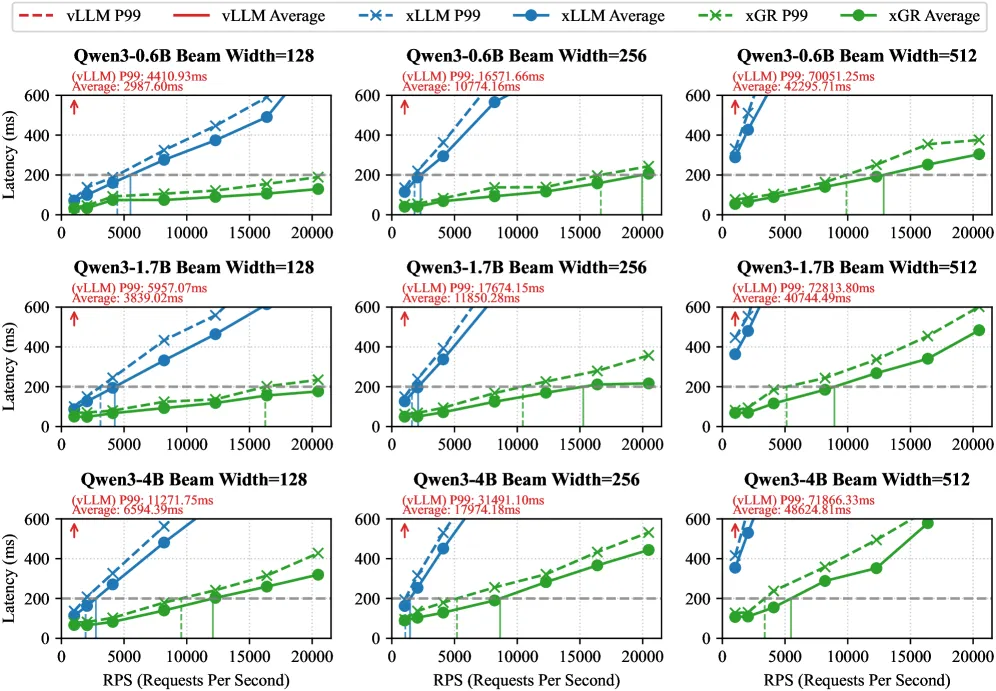
Figure 13b: Qwen3在JD数据集上的端到端对比
OneRec模型结果:
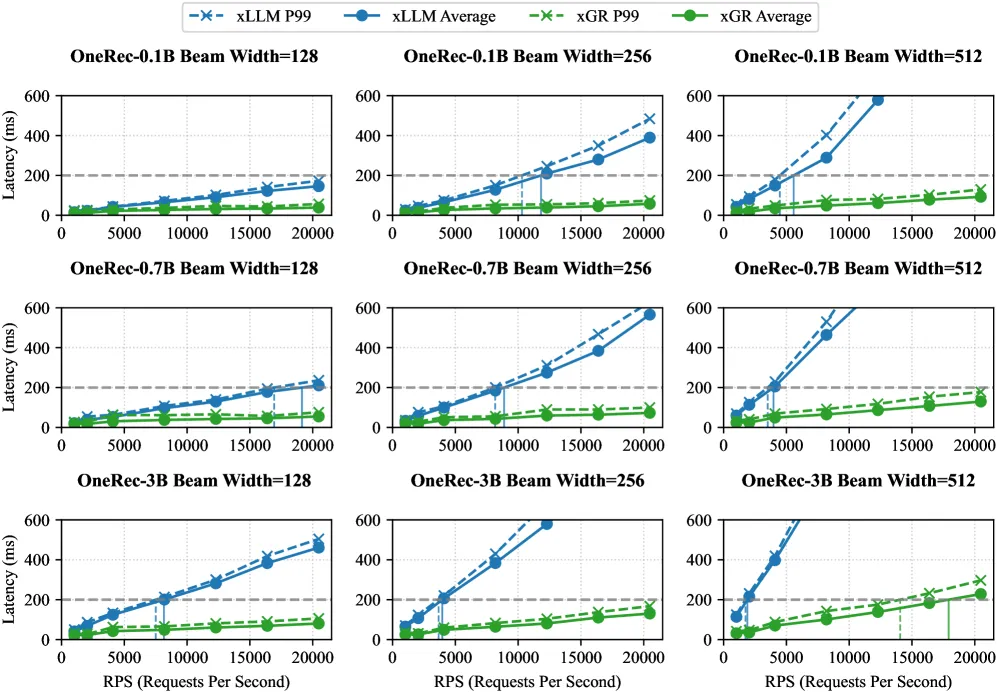
Figure 14a: OneRec在Amazon Review数据集上的端到端对比
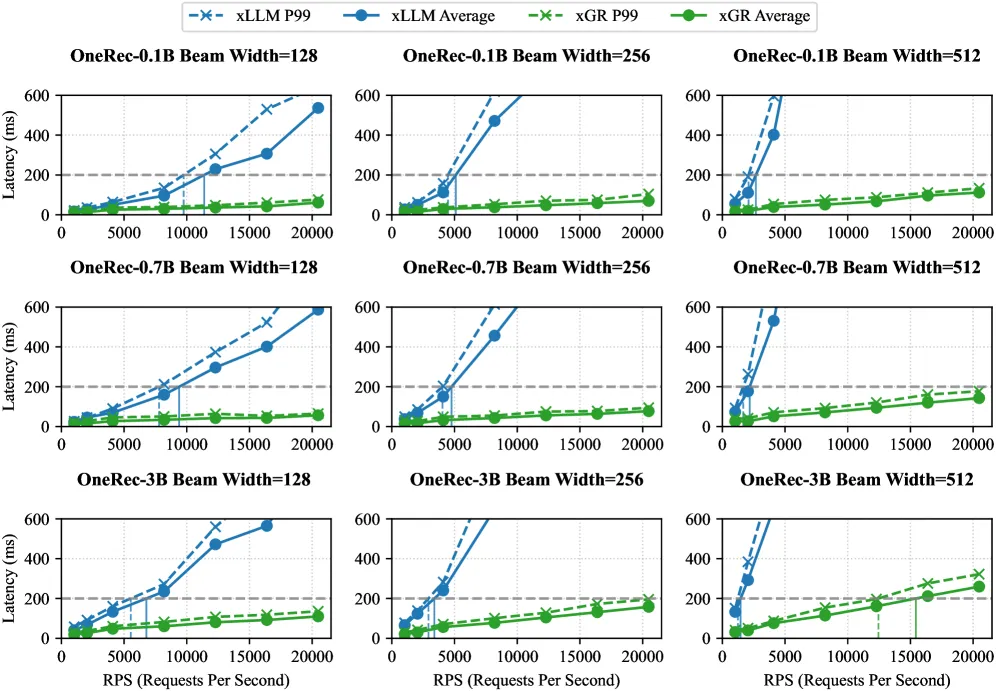
Figure 14b: OneRec在JD数据集上的端到端对比
核心结果:
- xGR在严格延迟约束下实现至少3.49倍吞吐量提升
- 在所有模型规模和束宽设置下均优于基线
内存效率
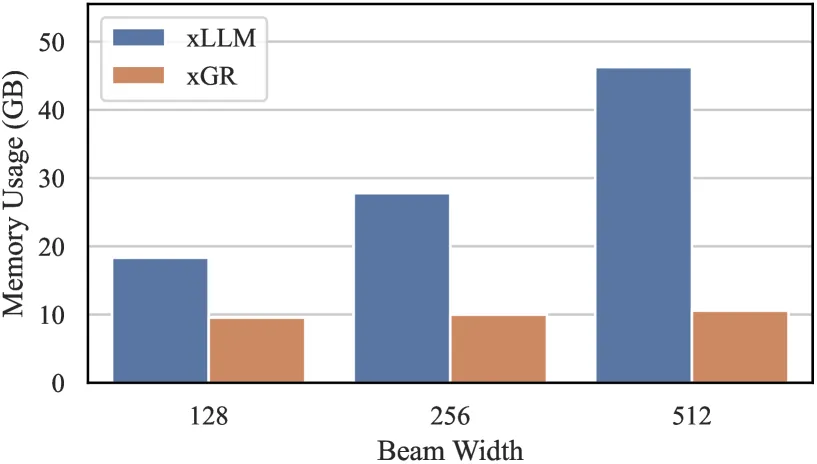
Figure 15: Qwen3-4B在不同束宽下的峰值内存(RPS=4)
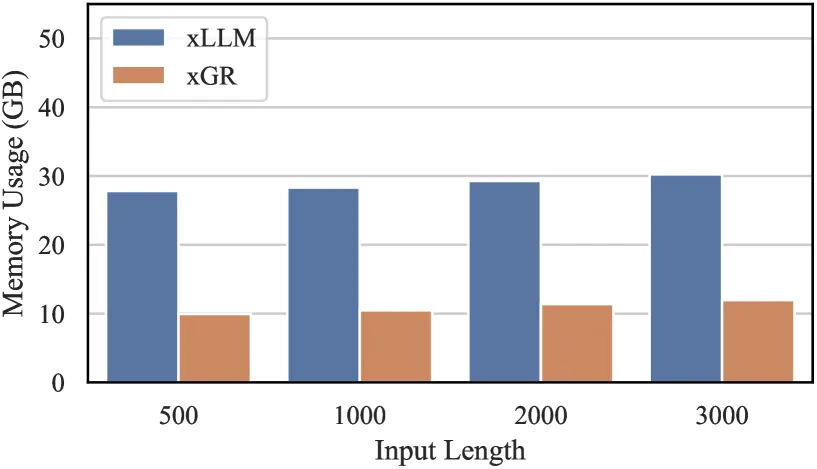
Figure 16: Qwen3-4B在不同输入长度下的峰值内存(BW=256)
关键结果:
| 指标 | xGR | xLLM | 改善 |
|---|---|---|---|
| 内存(BW=512) | 10.6GB | 46.3GB | 4.4倍 |
| 内存(3k tokens) | 12.0GB | ~30GB | 2.5倍 |
内核效率
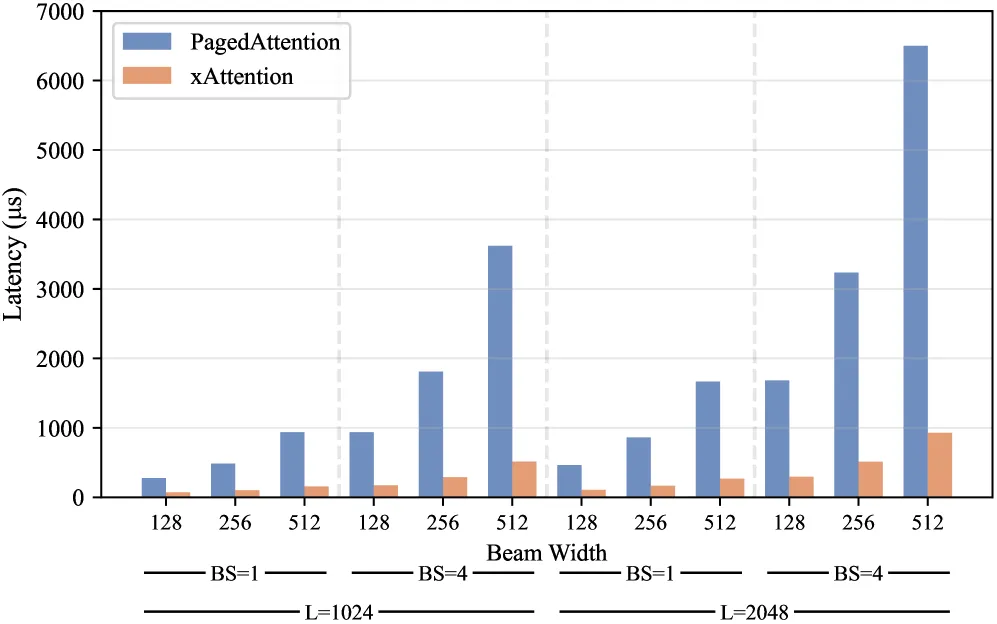
Figure 17a: PagedAttention和xAttention的内核延迟
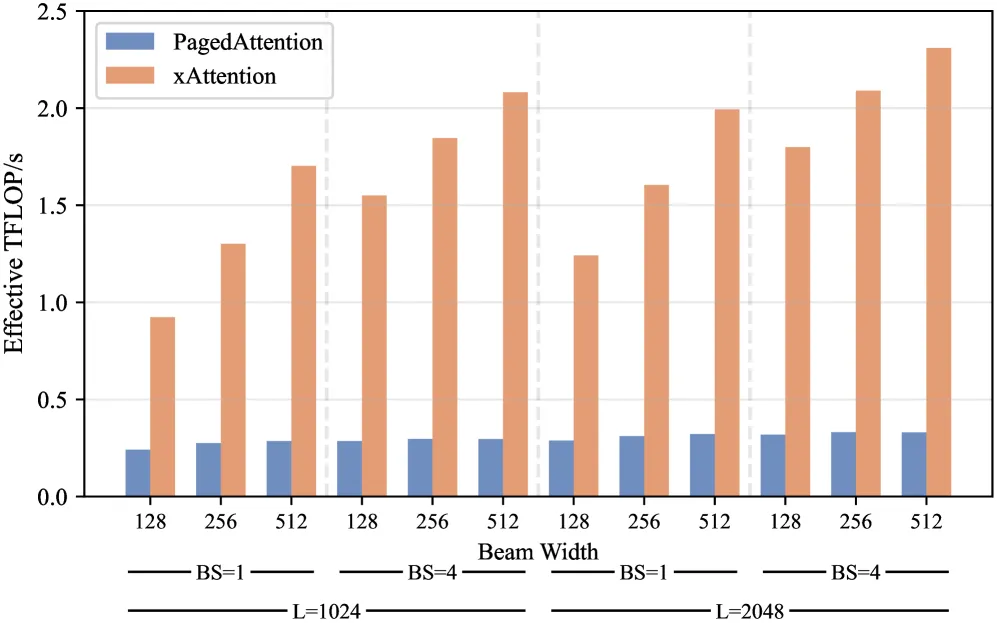
Figure 17b: 计算吞吐量对比
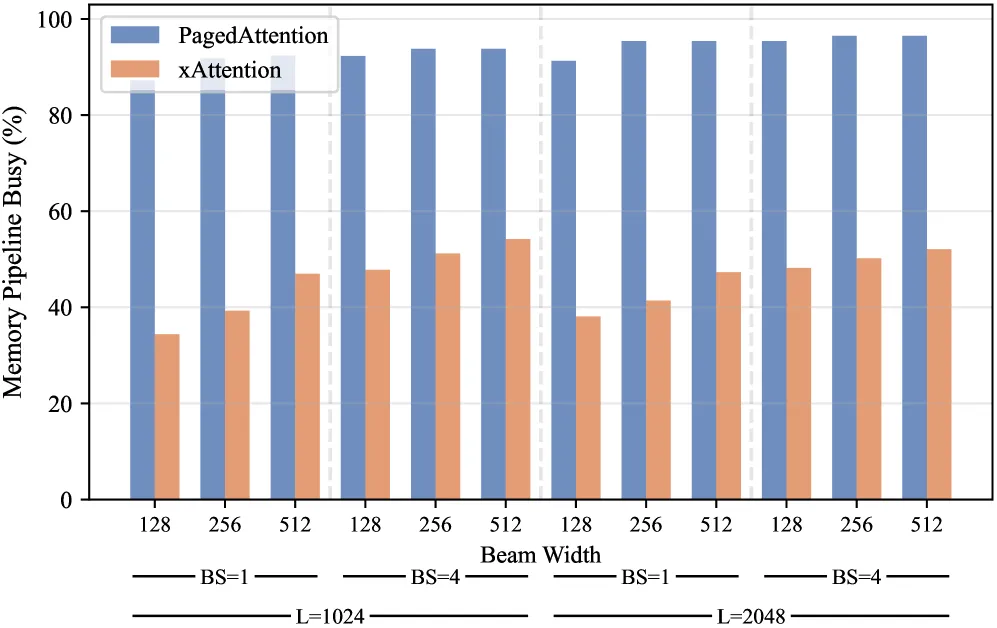
Figure 17c: 内存访问开销
关键结果:
| 指标 | PagedAttention | xAttention | 改善 |
|---|---|---|---|
| 内核延迟(BW=512) | - | - | 6.6倍降低 |
| 计算吞吐量(BW=512) | - | - | 7倍提升 |
| 内存访问忙率 | 93.4% | 52% | 内存→计算瓶颈转化 |
消融实验
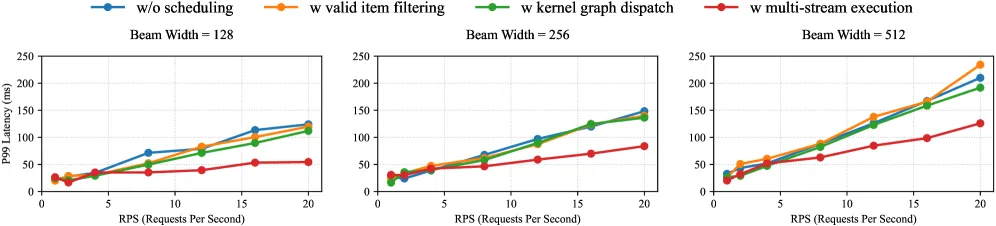
Figure 18: 调度优化的消融研究(OneRec-0.1B, Amazon Review)
各优化组件的独立贡献:
- 有效物品过滤
- Kernel Graph调度
- 多流执行
GPU集群部署
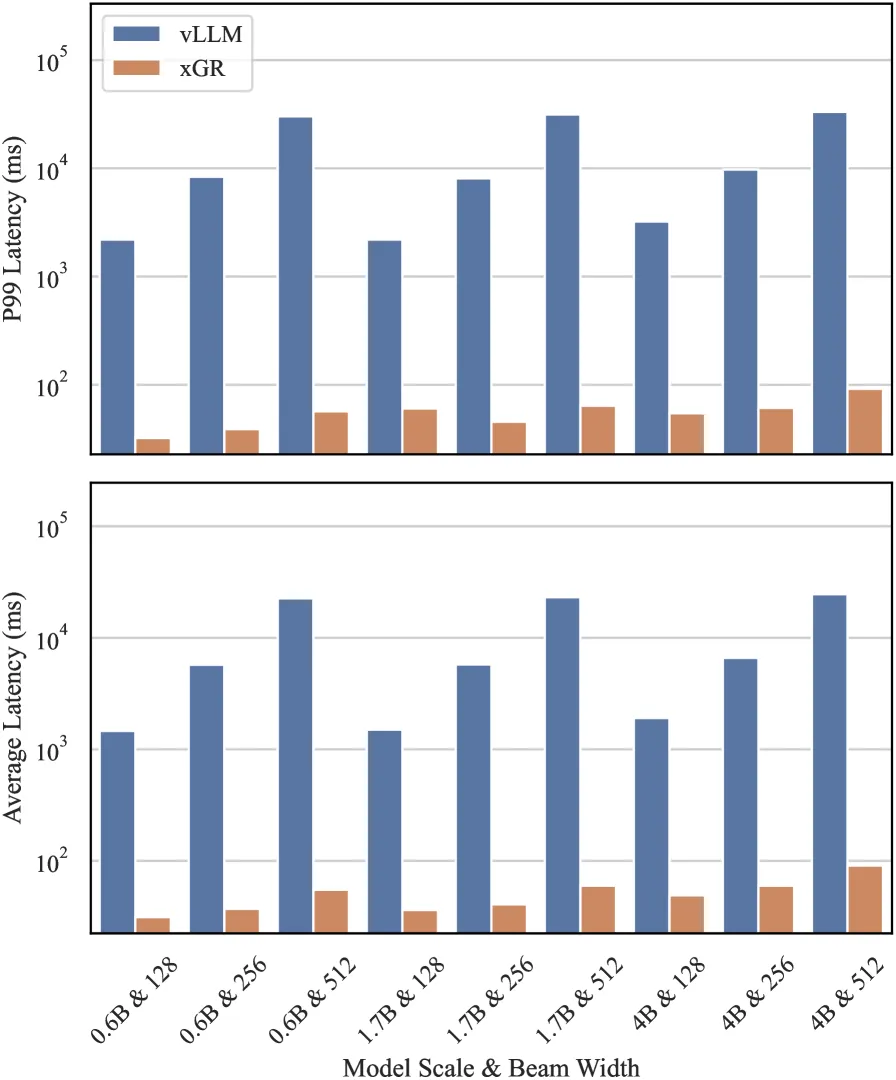
Figure 19: GPU集群上的端到端对比(Amazon Review, RPS=64)
- 在H800 GPU上的结果与Ascend趋势一致
- 证明硬件升级不足以解决GR工作负载问题
生产部署
| 指标 | 数据 |
|---|---|
| 部署时长 | 3个月 |
| 服务用户 | 数亿用户 |
| 峰值RPS | 数万 |
| P99延迟 | ≤200ms |
六、相关工作对比
| 方法 | 类型 | 局限 | xGR优势 |
|---|---|---|---|
| vLLM | LLM推理引擎 | 冗余KV缓存加载 | 3.49x吞吐量 |
| SGLang | LLM推理引擎 | 未针对GR优化 | GR专用优化 |
| xLLM | 推理框架 | 缺少beam search优化 | 完整GR优化栈 |
| PrefillOnly | 推理引擎 | 假设单token输出 | 支持多步解码 |
| Ekko/GRACE/Prism | DLRM系统 | 受限于级联架构 | 统一GR架构 |
关键差异化:
- 首个全面重构GR推理范式的工作
- 优化覆盖算子、算法、系统三个层级
- 解决现有系统忽略的共享前缀问题
- 设备端物品过滤(无主机-设备同步开销)
七、总结
核心贡献
- xAttention:分离式KV缓存管理 + 分阶段计算分配,消除块复制冗余
- xBeam:物品掩码过滤 + 提前排序终止 + 数据结构复用,减少无效计算
- xSchedule:三层调度架构 + 流水线并行 + 多流执行,最大化硬件利用率
- 跨平台移植:统一Ascend NPU和NVIDIA GPU抽象,17k行C/C++/CUDA代码
- 生产验证:3个月大规模部署,服务数亿用户
实际意义
- 严格延迟约束下吞吐量提升3.49倍
- 内存消耗降低4.4倍(BW=512时)
- 过滤50%无效物品生成
- 支持束宽128-512的高效推理
- 跨Ascend NPU和NVIDIA GPU平台
技术影响
- 首次系统性分析并优化生成式推荐推理工作负载
- 证明GR工作负载需要专用系统设计,而非简单复用LLM引擎
- 为推荐系统从判别式向生成式范式转型提供基础设施支撑
八、关键图片索引
| 图片 | 说明 | 文件名 |
|---|---|---|
| Figure 1 | 架构对比 | figure1-arch-comparison.png |
| Figure 2 | 束搜索示例 | figure2-beam-search-example.png |
| Figure 3 | 注意力延迟 | figure3-attention-latency.png |
| Figure 4 | 注意力内存 | figure4-attention-memory.png |
| Figure 5 | 无效物品比例 | figure5-invalid-items.png |
| Figure 6 | xGR概述 | figure6-xgr-overview.png |
| Figure 7 | KV缓存管理 | figure7-kv-cache-management.png |
| Figure 8 | 原地块更新 | figure8-inplace-block-updates.png |
| Figure 9 | 流水线并行 | figure9-pipeline-parallelism.png |
| Figure 10 | 有效路径约束 | figure10-valid-path-constraint.png |
| Figure 11 | 提前排序终止 | figure11-early-sorting-termination.png |
| Figure 12 | xSchedule流水线 | figure12-xschedule-pipeline.png |
| Figure 13a | Qwen3 Amazon | figure13a-qwen3-amazon.png |
| Figure 13b | Qwen3 JD | figure13b-qwen3-jd.png |
| Figure 14a | OneRec Amazon | figure14a-onerec-amazon.png |
| Figure 14b | OneRec JD | figure14b-onerec-jd.png |
| Figure 15 | 峰值内存-束宽 | figure15-peak-memory-beamwidth.png |
| Figure 16 | 峰值内存-输入长度 | figure16-peak-memory-inputlen.png |
| Figure 17a | 内核延迟 | figure17a-kernel-latency.png |
| Figure 17b | 计算吞吐量 | figure17b-computational-throughput.png |
| Figure 17c | 内存访问开销 | figure17c-memory-access-overhead.png |
| Figure 18 | 调度消融 | figure18-ablation-scheduling.png |
| Figure 19 | GPU集群对比 | figure19-gpu-cluster-comparison.png |