Chopper: 多层次 GPU 表征工具及 LLM 训练低效来源分析
AMD 提出的 Chopper 多粒度 GPU 剖析框架,对 8 卡 MI300X 上 Llama 3 8B 的 FSDP 训练做端到端表征,揭示频率开销(DVFS)是理论与实测性能差距的最大来源。
Chopper: 多层次 GPU 表征工具及 LLM 训练低效来源分析
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Chopper: A Multi-Level GPU Characterization Tool & Derived Insights Into LLM Training Inefficiency |
| 作者 | Marco Kurzynski, Shaizeen Aga, Di Wu |
| 机构 | AMD(推断,作者含 AMD 研究人员) |
| 论文 | arXiv:2512.08242v1 |
| HTML | arXiv HTML |
| 发布 | 2025-12 |
| 主题 | cs.DC(分布式并行计算)、cs.AR(硬件架构) |
二、核心思想
大语言模型训练的高效运行,需要深刻理解现代 GPU 系统在真实分布式训练负载下的行为。以往工作大多聚焦于内核级性能或单卡微基准,而多 GPU LLM 训练中通信、计算、内存行为与功耗管理之间的复杂交互仍缺乏充分表征。
本文提出 Chopper——一个剖析与分析框架,跨多种粒度(从单个内核 → 操作 → 层 → 阶段 → 迭代 → GPU)采集、对齐并可视化 GPU 内核轨迹与硬件性能计数器。作者用 Chopper 对 8 卡 AMD Instinct™ MI300X 节点上、采用**全分片数据并行(FSDP)**训练的 Llama 3 8B 做了首个端到端全面表征。
问题定义
尽管 GPU 系统端到端速度已大幅提升,但仍不清楚:当前系统离理论性能有多近?是什么阻碍了进一步的性能提升? 各类软硬件优化(kernel fusion、FlashAttention、C3 并发计算通信、张量核心、FP8、HBM 等)究竟如何贡献于 LLM 训练性能?
解决方案概述
构建一个能同时关联运行时轨迹(准确时间戳、C3 重叠)与硬件性能计数器(需串行化内核)的多粒度剖析框架,通过轨迹对齐把底层硬件计数器映射到高层操作/层/迭代,从而做出细致的开销分解,量化理论与实测性能之间的差距。
核心发现:频率开销(DVFS 效应)是理论与实测性能差距的最大单一贡献者,超过 MFMA 利用率损失、通信/计算重叠、内核启动开销的影响。
三、技术架构
Chopper 框架
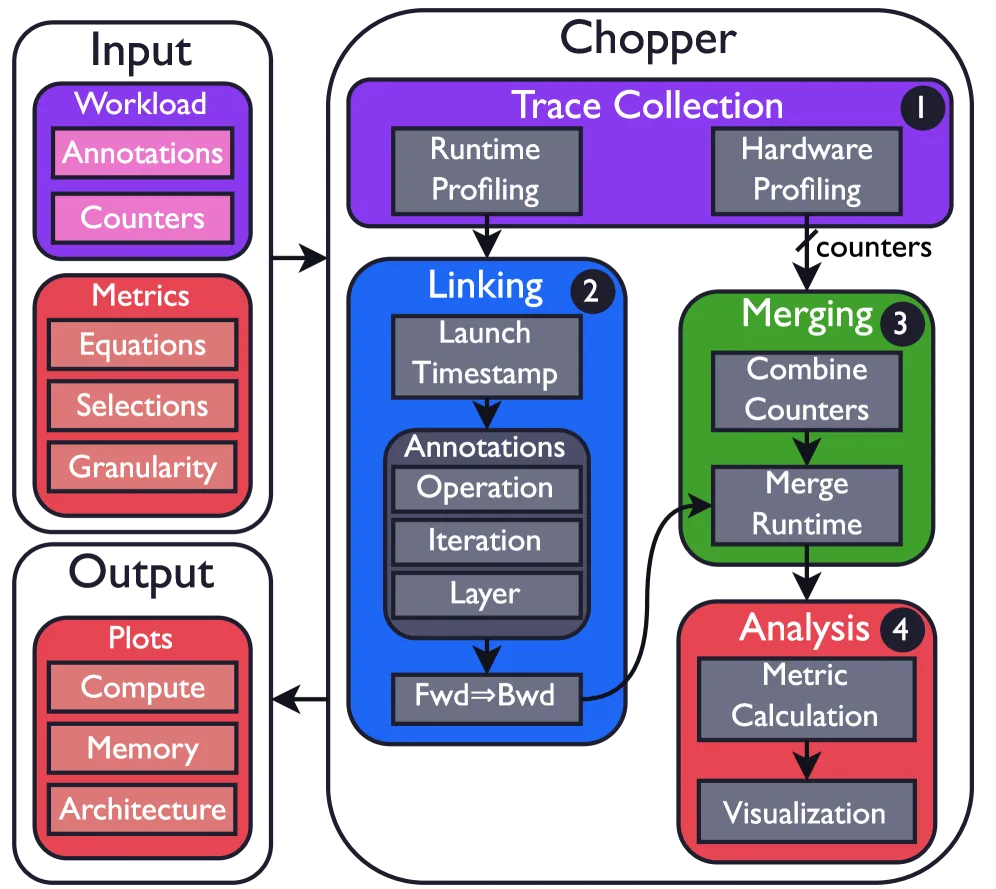
Chopper 包含三大模块:
| 模块 | 子功能 | 说明 |
|---|---|---|
| 轨迹采集(Trace Collection) | 运行时剖析(Runtime Profiling) | 记录 GPU 内核与 host CPU 启动过程的准确时间戳;记录前向→反向内核映射(反向内核由前向派生);含内核/操作/层/迭代标注 |
| 硬件剖析(Hardware Profiling) | 采集目标性能计数器;每次仅能采集 2–3 个;采集计数器会强制内核串行化,故无法捕捉 C3 重叠、也无法提取有效时间戳 | |
| 轨迹处理(Trace Processing) | 轨迹对齐(Trace Alignment) | 合并对齐运行时与硬件两类轨迹,使硬件计数器可关联到高层操作/层/迭代 |
| 轨迹分析(Trace Analysis) | 指标聚合(Metric Aggregation) | 直接读取或用多计数器推导指标(如由传输字节与内核时长算带宽),可约束到特定粒度 |
| 可视化(Visualization) | 从硬件利用率到端到端性能的多种可视化,可按粒度定制过滤 |
与既有工作的差异:Chopper 在应用与硬件两个维度都覆盖了全部粒度、提供全部洞见类型,并且是唯一提供工具的(对比 Multi-level、Bottleneck、TC、TKLQT、BERT 等)。
背景:FSDP v1 vs v2
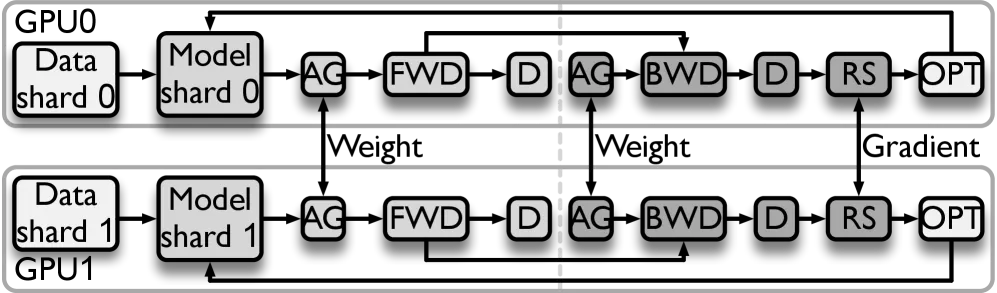
FSDP(全分片数据并行)除分片数据集外,还分片模型权重、梯度和优化器状态,每个分片在一个 GPU 上处理:
- 前向:每个 GPU 用 all gather(AG) 从其他 GPU 收集分片以拼装该层;层前向完成后删除已收集的分片
- 反向:反向前再次 all gather 收集权重;反向后删除权重,梯度用 reduce scatter(RS) 求和并重分片
- 优化步:各 GPU 本地更新权重
- 全程利用 C3(并发计算与通信) 提升效率
v1 vs v2 关键区别:
- FSDPv1:内存块复用非确定性,all gather 可能在层被删除前分配新内存块,导致内存用量尖峰
- FSDPv2:采用逐参数分片(per-parameter sharding),解决内存尖峰问题;但在通信集合操作周围引入额外拷贝(copy kernels)
核心公式
启动开销分解(准备开销 + 调用开销), 为内核 起始时间戳、 为结束时间戳、 为内核派发时间:
O_{\text{prep}} = \max(t_{l_i} - t_{ke_{i-1}}, 0) \tag{1}
O_{\text{call}} = \min(t_{ks_i} - t_{l_i},\ t_{ks_i} - t_{ke_{i-1}}) \tag{2}
O_{\text{launch}} = O_{\text{prep}} + O_{\text{call}} \tag{3}
CPU 核利用率( 活跃核数、 理论下界):
C_{\text{active}} = \sum_{i=1}^{N}[\text{Util}_i > 0] \tag{4}
C_{\text{min}} = \sum_{i=1}^{N}\frac{\text{Util}_i}{100} \tag{5}
开销分解模型(理论时长、指令开销、利用率开销、重叠开销、频率开销):
D_{\text{thr}} = \frac{F_{\text{gemm}}}{\text{TPT}_{\text{peak}}} \tag{6}
\text{Ovr}_{\text{inst}} = \frac{F_{\text{perf}}}{F_{\text{gemm}}} \quad (\text{padding 多算的 flops}) \tag{7}
\text{Ovr}_{\text{util}} = \frac{1}{\text{MFMA}_{\text{util}}} \quad (\text{MFMA 核未满载}) \tag{8}
\text{Ovr}_{\text{overlap}} = \frac{D_{50\%}}{D_{0\%}} \quad (\text{C3 资源争用近似}) \tag{9}
D_{\text{peak}} = \frac{C_{\text{gpu}}}{\text{Freq}_{\text{peak}}}, \quad \text{Ovr}_{\text{freq}} = \frac{D_{\text{act}}}{D_{\text{peak}}} \Big/ \text{Ovr}_{\text{overlap}} \quad (\text{DVFS}) \tag{10}
四、实验设置
| 项目 | 配置 |
|---|---|
| 模型 | Llama 3 8B(32 层,token size 4096,hidden dim 14336,Attn/KV heads 32/8,内置 GQA) |
| 扫描配置 | batch size × sequence length:b1s4、b2s4、b4s4、b1s8、b2s8(s 单位 K tokens) |
| 框架 | PyTorch + FSDP / FSDPv2;FlashAttention V2;BF16;未用 torch.compile 或高级 kernel fusion |
| CPU | 2× AMD EPYC™ 9684X,共 2.3 TB host 内存 |
| GPU | 8× AMD Instinct™ MI300X,每卡 1.3 PFLOPS(BF16)、192 GB HBM、5.3 TB/s 带宽 |
| 互连 | GPU 对间 AMD Infinity Fabric™ 128 GB/s 双向;GPU↔CPU 走 Gen5 ×16 PCIe,全连接 8 卡系统 |
| 矩阵核 | MI300X 有 1,216 个 matrix core,执行 MFMA 指令(FP32/FP16/BF16/INT8/FP8),驱动 rocBLAS |
| 剖析工具 | AMD rocprofv3(性能计数器)+ PyTorch profiler / roctracer(轨迹) |
| 采样 | 跑 20 次迭代,前 10 warmup、后 10 采样;分别跑「含优化步(第 15 迭代)」与「不含」两种 |
五、核心洞见与发现
分析采用自顶向下方式:端到端性能 → 操作运行时与变化 → C3 重叠 → CPU 行为与启动开销 → 频率功耗 → 综合开销分解。
5.1 端到端性能分解
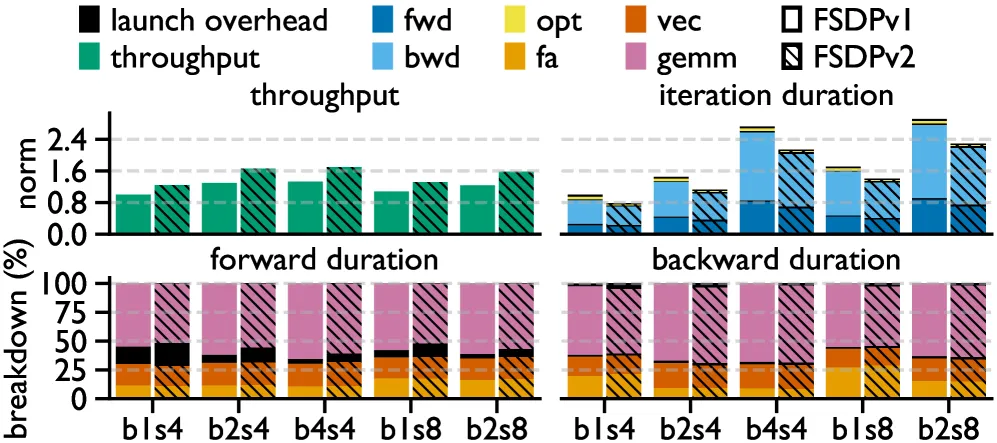
- 吞吐对 batch/seq 的敏感性:
b2s4/b4s4(batch>1, seq 4K)吞吐最高;b1s4/b1s8(batch=1)吞吐最低;b2s8(大 seq)吞吐略降。 - 阶段/操作分解:反向阶段主导训练,其次前向,优化步贡献很小。GEMM 占前向和反向约 60%。FlashAttention 时长随 增长,大 seq 时占比更高。
观察 1:batch=1 严重欠利用(吞吐约低 30%),与序列长度无关。
观察 2:反向 FlashAttention 扩展次优——batch=1 时它在反向分解中占比高于 batch=2/4。
观察 3:启动开销在前向和优化阶段更突出,其占比随 batch/seq 增大而下降。
5.2 操作时长与变化
- GEMM:全部随 扩展,MLP GEMM 主导前后向;up/gate projection 在反向有显著变化尾部(源于少数快/慢 GPU)。
- FlashAttention:前向按 扩展(符合预期);但反向 FlashAttention 在 batch>1 时反而时长更低,尽管做了更多 flops——说明 batch=1 的反向 FA 实现优化很差。
- Vector(向量):RMSNorm 操作(
mlp_n、attn_n)主导前后向;两个计算完全相同的操作却因通信重叠导致时长不同。
洞见 1:反向 FlashAttention 对 batch=1 优化很差(batch=2 时长反而更低,尽管 flops 更多),加剧了 batch=1 的欠利用。
建议 1:用 Chopper 可视化轨迹,定位并修复 batch=1 反向 FlashAttention 的实现问题。
5.3 通信与计算重叠
- 通信主内核为 all gather(ag) 与 reduce scatter(rs)。理论上通信时长为 ( 隐藏层、 GPU rank 数),只与权重/梯度有关,不应随 、 变化。
- 实测中值通信时长却随计算时间(迭代时长)扩展,仅尾部保持恒定 → 迭代时长增大时存在低效。
- GEMM 重叠:重叠比与 GEMM 时长高度相关;少数 GPU 重叠≈0%、多数≈100%,导致少数 GPU 时长低约 15–20%,证实变化尾部来自快/慢 GPU 而非迭代。
- FlashAttention 重叠:仅前向 FA 持续有重叠;小 batch/seq 时重叠更多 → 更多资源争用 → 欠利用。
洞见 2:尾部通信时长符合理论(对 、 恒定),但中值随计算时间扩展,说明迭代增大时有低效。
洞见 3:GPU 间重叠差异导致 GPU 间时长差异。
洞见 4:高效重叠对小 batch/seq 尤为重要——它们内核更短、重叠更多,引发更多资源争用,影响效率与吞吐。
观察 4:相同计算的操作可能因重叠比不同而时长不同。
5.4 内核启动开销
将启动开销拆为准备开销(Preparation)与调用开销(Call):
- 准备开销:CPU 本应派发下一内核却没派发的时间。
f_ie、opt_step准备开销大——它们分别位于迭代开始/结束,是填充/清空 all gather 与 reduce scatter 流水线导致,并非 CPU 瓶颈。 - 调用开销:
f_ie、b_ga(填充/清空通信流水线时)与opt_step(许多小向量内核、间隙大)调用开销最高;FSDPv1→v2 显著减少这些间隙。有趣的是,FSDPv2 因逐参数分片序列化了更多 copy 内核,反而在某些点显示更多调用开销。
洞见 5:迭代首尾的准备开销来自填充/清空 all gather 与 reduce scatter 流水线,不代表 CPU 瓶颈。
洞见 6:启动开销影响随 batch/seq 增大而减小。
观察 5:FSDPv2 序列化了更多 copy 操作,却比 FSDPv1 吞吐显著更高。
建议 3:典型的 graph launch 优化聚焦迭代内启动开销,但迭代间开销才是主导,这些技术应扩展以考虑此类开销。
5.5 CPU 利用率
- 中值 25 个活跃核,而理论下界仅 9 个 → 活跃核数可减少 2 倍以上。
- 尽管开了 SMT(两逻辑核映射一物理核),实际很少发生;训练全程仅 12.5% 物理核有活跃逻辑核映射 → CPU 严重欠利用。
洞见 7:LLM 训练中 CPU 严重欠利用,尽管活跃核数是下界的两倍多。
建议 4:未来 LLM 训练系统不需要那么多活跃 CPU 核;系统设计者可把 CPU 功耗「转移(power-sloshing)」给 GPU 而不影响训练性能。
5.6 频率与功耗
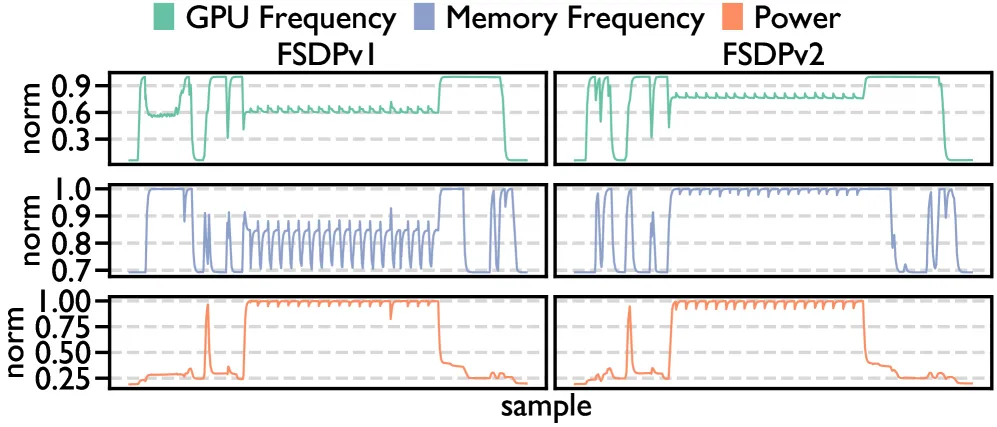
- 观察到 FSDPv2 即使在 0% 重叠时,所有操作时长仍均匀更低——模型和主计算内核相同,因此频率是最可能的解释。
- FSDPv2 的 GPU 与内存时钟频率高约 20–25%、变化显著更小,功耗曲线几乎一致。
- 假设:FSDPv2 更确定性的内存分配降低了 HBM 功耗波动,提升效率,使 GPU 和内存在相同功耗约束下维持更高时钟。
观察 6:FSDPv2 更省电,使平均 GPU 频率高约 25% 而功耗不变。
5.7 理论与实测性能的差距(开销分解)
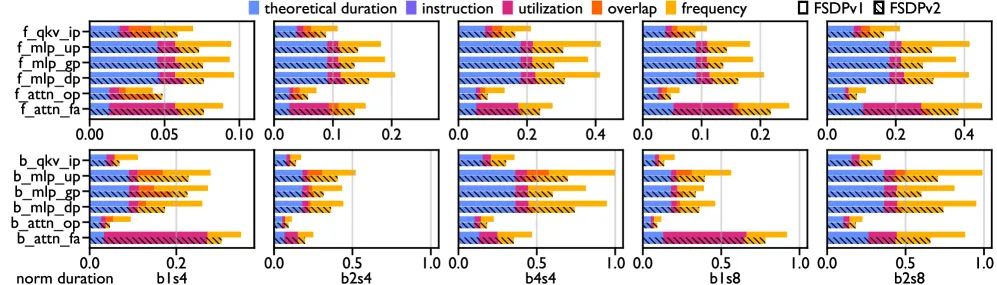
综合分解各开销来源(对应公式 6–10):
- 指令开销(padding):罕见,仅
f_mlp_dp在 b1s4 可见。 - 利用率开销(MFMA 未满载):FlashAttention 特别高(既做向量又做 GEMM);FSDPv1/v2 相近(同一计算内核)。
- 重叠开销(C3 争用):随 batch/seq 增大而减小;FSDPv2 大多降低。
- 频率开销(DVFS):占主导,尤其对 GEMM,且是 FSDPv1→v2 之间的最大差异。
洞见 8(核心结论):频率开销占主导,是 FSDPv1→v2 的最大改进来源。
建议 5:频率应成为剖析的核心组成部分,尤其在比较训练框架时;同一负载在不同框架下会呈现不同的频率决策,因此需要功耗管理固件的调优与优化。
六、核心创新与贡献
| 创新点 | 说明 | 依据 |
|---|---|---|
| 多粒度表征框架 | 首个跨内核→操作→层→阶段→迭代→GPU 全粒度,并统一关联运行时轨迹与硬件计数器的工具 | Table I 对比 |
| 首个 MI300X LLM 训练整体表征 | 首次对 AMD Instinct MI300X 上 LLM 训练做整体、多粒度表征 | 8 卡 Llama 3 8B FSDP |
| DVFS 是最大低效来源 | 量化证明频率开销超过 MFMA 利用率损失、C3 重叠、启动开销 | Figure 15 开销分解 |
| 内存确定性 → 更高更稳频率 | 揭示 FSDPv2 确定性内存分配降低 HBM 功耗波动,从而维持更高时钟 | Figure 14 |
| CPU 严重欠利用 → 功耗可转移 | 仅 12.5% 物理核活跃,可 power-slosh 给 GPU | Figure 13 |
七、总结
核心贡献
- 提出 Chopper 多粒度 GPU 剖析分析框架,自动化轨迹采集、对齐、指标聚合与可视化。
- 对 8 卡 MI300X 上 Llama 3 8B 的 FSDP 训练做首个端到端整体表征。
- 揭示多个此前未充分探索的瓶颈:batch=1 欠利用(反向 FA 实现差、更多重叠争用、更高启动开销占比)、GPU 间重叠差异引发时长差异、CPU 严重欠利用。
- 量化理论与实测性能的差距,指出频率开销(DVFS)为最大单一贡献者。
技术影响
为优化训练框架、改进功耗管理策略、指导未来 GPU 架构与系统设计提供可操作洞见;特别提示频率/DVFS 与功耗管理固件应成为训练性能分析和优化的一等公民。
局限性
- 仅评估单节点 8 卡、Llama 3 8B、FSDP(未含张量/流水线/上下文并行、未用 torch.compile 等高级融合)。
- 结论基于 AMD MI300X,对 NVIDIA 平台的普适性待验证。
- 硬件计数器采集需串行化内核,无法直接捕捉 C3 重叠(靠运行时轨迹补足)。
八、参考资源
- 论文:arXiv:2512.08242v1
- HTML:arXiv HTML
- 相关文档:
- GPU 架构基础:内存层次、CUDA 与张量核心(通用 GPU 原理,含 Roofline / DVFS 背景)
- Blackwell GPU 架构综述(NVIDIA 侧微基准表征,可与本文 AMD 侧对照)