Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth Architectural Analysis
一、论文概述
| 项目 | 内容 |
|---|
| 标题 | Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth Architectural Analysis |
| 作者 | Aaron Jarmusch, Sunita Chandrasekaran |
| 机构 | University of Delaware |
| 论文 | arXiv:2512.02189 |
| 代码 | 开源微基准测试套件 |
| 发布 | 2025年12月1日 (v1), 2026年3月2日 (v3) |
| 许可 | CC BY 4.0 |
二、核心思想
问题定义
随着 GPU 架构快速演进以满足百亿亿次计算和机器学习的需求,架构创新对多样化工作负载的性能影响仍未被充分理解。NVIDIA Blackwell (B200) 引入了多项重大架构进步,包括第五代张量核心、张量内存 (TMEM)、解压缩引擎 (DE) 和双芯片设计,但量化这些改进的系统方法论滞后于硬件开发周期。
解决方案概述
本文贡献了一个开源微基准测试套件,提供了优化工作负载以充分利用现代 GPU 架构丰富功能集的实用见解。研究 Blackwell GPU 并与 H200 代进行比较,涵盖内存子系统、张量核心流水线和浮点精度 (FP32, FP16, FP8, FP6, FP4)。
核心发现
- B200 张量核心增强实现 1.85× ResNet-50 和 1.55× GPT-1.3B 混合精度训练吞吐量
- 能效比 H200 提高 32%
- FP4 精度下推理吞吐量提升 2.5×
三、技术架构
整体框架图
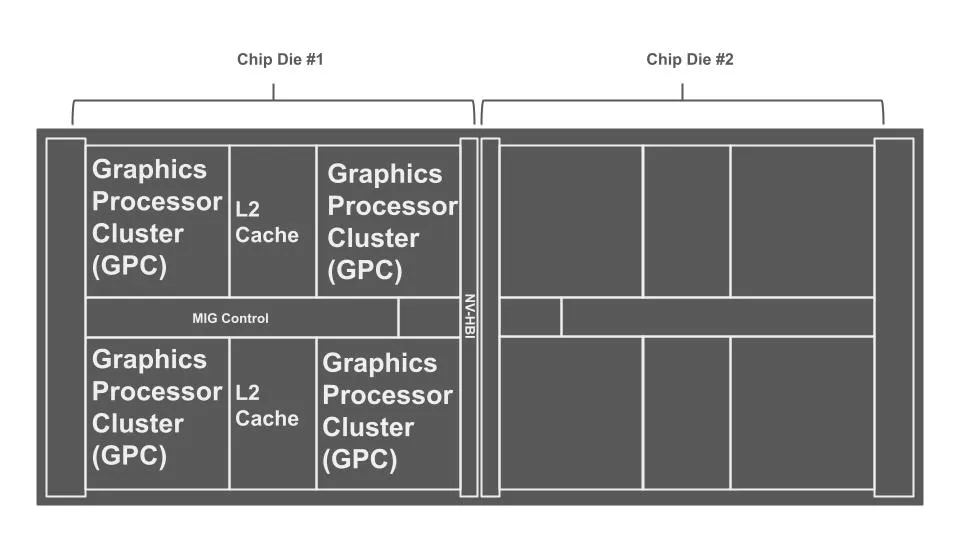
Figure 1: NVIDIA Blackwell GPU 双芯片设计,通过 NV-HBI 互连。
Blackwell 架构关键特性
| 特性 | 说明 |
|---|
| 双芯片设计 | 两个 GPU 芯片,2080 亿晶体管 |
| SM 数量 | 148 个 SM,分布在 8 个 GPC 中 |
| L2 缓存 | 4 个分区(Hopper 的两倍) |
| HBM3e | 8 个 HBM3e 内存堆栈,192 GB 统一内存空间 |
| NV-HBI | 高带宽接口,提供连贯的单一设备视图 |
第五代张量核心
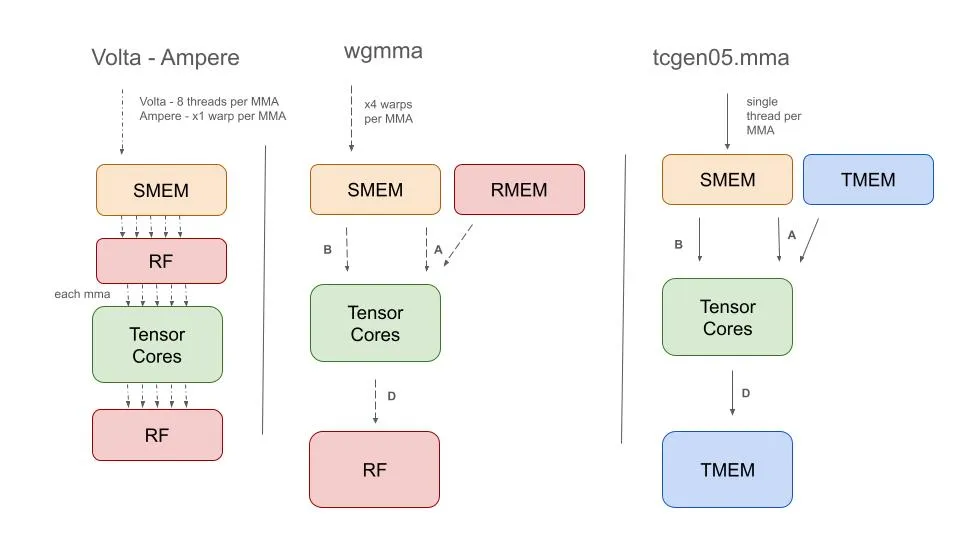
Figure 2: tcgen05、wgmma 和 Volta/Ampere 架构的张量核心指令流水线。
PTX 到 SASS 映射
| 精度 | PTX (tcgen05.mma) | SASS | wgmma |
|---|
| FP16, BF16 | kind::f16 | HMMA | HGMMA |
| FP32, TF32 | kind::tf32 | HMMA | HGMMA |
| FP8 | kind::mxf8 / f8f6f4 | QMMA | QGMMA |
| FP6 | kind::mxf6 | QMMA | N/A |
| FP4 | kind::mxf4 / mxf4nvf4 | OMMA | N/A |
| INT4, INT8 | kind::i8 | IMMA | IGMMA |
| FP64 | not supported | —* | DMMA |
*注:FP64 不支持 tcgen05.mma;B200 FP64 使用独立路径(双倍 FP64 单元,DMMA)
张量内存 (TMEM)
- 容量: 每 SM 256KB 专用片上内存
- 结构: 512 列 × 128 通道的 2D 数组,32 位单元
- 用途: 专为张量核心操作设计,分离张量核心存储与寄存器
- 优势: 允许中间矩阵结果在 warp 组之间持久化,减少对寄存器或共享内存的依赖
解压缩引擎 (DE)
支持多种压缩格式:
| 格式 | 压缩比 | 输入吞吐量 (GB/s) | 输出吞吐量 (GB/s) | 延迟 (ms) | 用例 |
|---|
| lz4 | 1.00× | 173.23 | 172.55 | 0.608 | - |
| snappy | 1.91× | 61.38 | 117.24 | 0.894 | 实时 |
| zstd | 2.00× | 77.50 | 154.94 | 0.677 | 通用 |
| gzip | 2.00× | 42.00 | 83.83 | 1.251 | 遗留 |
| bitcomp | 3.00× | 154.02 | 462.37 | 0.227 | 科学计算 |
| ans | N/A | N/A | 539.21 | 0.194 | - |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|
| 第五代张量核心 | 打破 warp 同步范式,引入 tcgen05 指令 | FP16 延迟从 32 周期降至 11 周期 |
| 张量内存 (TMEM) | 256KB 专用片上内存用于张量操作 | 注意力模块延迟降低 1.65× |
| 解压缩引擎 (DE) | 硬件加速解压缩 | SpMV 性能提升 3.16× |
| 双芯片设计 | NV-HBI 互连,2080 亿晶体管 | 统一 192GB HBM3e 内存空间 |
| FP4/FP6 精度 | 新增低精度支持 | FP4 推理吞吐量提升 2.5× |
单指令延迟对比
| 指令 | Tile Shape | 作用域 | 延迟 (周期) |
|---|
| wgmma | m64n64k16 | Warp-group | 32.0 |
| wgmma | m64n128k16 | Warp-group | 64.0 |
| wgmma | m64n256k16 | Warp-group | 128.0 |
| tcgen05.mma | m64n64k16 | Warp | 11.0 |
| tcgen05.mma | m128n128k16 | Warp | 11.3 |
| tcgen05.mma | m256n256k16 | Warp | 11.4 |
五、实验结果
张量核心吞吐量
| 精度 | B200 (TFLOPS) | % Peak | H200 (TFLOPS) | 加速比 |
|---|
| FP64 | 44.8 | 99.6% | 34.0 | 1.32× |
| FP32 | 482.0 | 96.4% | 378.4 | 1.27× |
| TF32 | 964.5 | 96.5% | 756.9 | 1.27× |
| BF16 | 1926.4 | 96.3% | 1513.5 | 1.27× |
| FP16 | 1929.6 | 96.5% | 1515.2 | 1.27× |
| FP8 | 3850.6 | 96.3% | 3026.9 | 1.27× |
| FP6 | 5134.4 | 96.0% | N/A | 新增 |
| FP4 | 7700.2 | 96.2% | N/A | 新增 |
| INT8 | 3928.5 | 98.2% | 3088.4 | 1.27× |
LLM 推理性能
| 模型 | 精度 | B200 tok/s | H200 tok/s | 加速比 | Perplexity | ΔPPL |
|---|
| Mistral-7B | FP16 | 56,028 | 28,500 | 1.97× | 6.82 | — |
| Mistral-7B | FP8 | 57,125 | 49,200 | 1.16× | 6.95 | +1.9% |
| Mistral-7B | FP4 | 112,800 | N/A | N/A | 7.38 | +8.2% |
| Mixtral-8x7B | FP16 | 31,033 | 18,100 | 1.71× | 5.94 | — |
| Mixtral-8x7B | FP8 | 51,200 | 32,400 | 1.58× | 6.08 | +2.4% |
| Mixtral-8x7B | FP4 | 76,900 | N/A | N/A | 6.48 | +9.1% |
训练性能
| 模型 | Batch Size | B200 吞吐量 | H200 吞吐量 | 加速比 | 能效 |
|---|
| ResNet-50 | 1024 | 2,928 img/s | 1,580 img/s | 1.85× | 5.09 img/s/W |
| GPT-1.3B | 128 | 14,363 tok/s | 9,240 tok/s | 1.55× | 20.63 tok/s/W |
| GPT-1.3B | 64 | 14,121 tok/s | 9,070 tok/s | 1.55× | 20.27 tok/s/W |
性能总结
| 工作负载 | 指标 | B200 | H200 | 改进 | 关键特性 |
|---|
| LLM 推理 (7B, FP4) | tok/s | 112,800 | N/A | 2.50× vs FP16 | FP4 张量核心 |
| LLM 推理 (8x7B, FP8) | tok/s | 51,200 | 32,400 | 1.58× | 第5代 TC, TMEM |
| LLM 推理 (BS=1, FP8) | 延迟 (ms) | 12.3 | 18.7 | 1.52× | 延迟流水线 |
| 注意力模块 | 延迟 (μs) | 284 | 468 | 1.65× | TMEM |
| HPC DGEMM (FP64) | TFLOPS | 36.3 | 18.9 | 1.92× | 双倍 FP64 单元 |
| STREAM Triad | BW (TB/s) | 4.14 | – | – | HBM3e |
| SpMV (压缩) | GFLOPS | 5.08 | 3.2 | 1.58× | 解压缩引擎 |
| GPT 训练 (1.3B) | tok/s | 14,363 | 9,240 | 1.55× | CTA pairs, TMEM, TC |
| ResNet 训练 | img/s | 2,928 | 1,580 | 1.85× | 第5代 TC, 内存带宽 |
六、架构权衡与讨论
关键权衡
- TMEM: 解决寄存器压力和 L2 流量问题,但需要显式分配和 tcgen05 数据移动;内核必须为 Blackwell 重写
- 解压缩引擎: 受输出带宽限制;在高度可压缩数据上,压缩输入吞吐量下降(如 1/C 缩放)
- FP64 不支持 tcgen05.mma: B200 FP64 使用独立路径(双倍 FP64 单元),TMEM 不直接改善 FP64 科学内核
软件生态系统
- CUDA 13.0 提供初步 TMEM/CTA 支持;框架集成进行中
- FP6 硬件支持存在但缺乏软件工具
- FP4/FP6 需要逐层精度选择——FP4 的 8.2% 困惑度退化是平均值;某些层容忍 FP4 而其他层需要 FP8
性能指南
- (a) 使用 TMEM 进行累加器暂存和多阶段张量流水线(如融合注意力 QKT)
- (b) 对可压缩数据使用 DE,当解压缩输出而非输入带宽是瓶颈时
- (c) 为 FP4/FP6 实施逐层精度选择以平衡性能与精度
七、总结
核心贡献
- 首个详细的基于微基准测试套件的 NVIDIA Blackwell B200 GPU 特征化
- 量化 TMEM 对矩阵密集型工作负载的影响
- 评估硬件解压缩引擎的吞吐量和最佳使用方式
- 通过新的 tcgen05 PTX 指令分析第五代张量核心执行
- 评估 FP4 和 FP6 精度权衡
- 在多样化工作负载上基准测试 Blackwell(LLM 推理、科学内核、混合精度训练)
- 为开发者提供针对下一代架构的可操作性能指南
技术影响
- B200 代表 GPU 架构的重大转变,从最大化 FLOPS 转向强调推理效率
- TMEM 和 tcgen05 指令改变了数据移动范式
- FP4/FP6 为 LLM 推理提供新的精度-性能权衡
局限性
- 实验主要测试单芯片行为;双芯片 (NV-HBI) 交互和跨芯片延迟留作未来工作
- FP6 硬件支持存在但缺乏软件工具
- FP4/FP6 需要逐层精度选择,增加复杂性
八、参考资源