Four Over Six: More Accurate NVFP4 Quantization with Adaptive Block Scaling
NVFP4 量化精度提升的自适应块缩放方法
Four Over Six: More Accurate NVFP4 Quantization with Adaptive Block Scaling
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Four Over Six: More Accurate NVFP4 Quantization with Adaptive Block Scaling |
| 作者 | Jack Cook, Junxian Guo, Guangxuan Xiao, Yujun Lin, Keith Wyss, Mahdi Nazemi, Asit Mishra, Carlo del Mundo, Tijmen Blankevoort, Song Han |
| 论文 | arXiv:2512.02010 |
| 代码 | GitHub |
| 发布 | 2025年12月1日(v5: 2026年5月9日) |
二、核心思想
问题定义
随着 LLM 规模不断增大,低精度数值格式(如 NVFP4)成为提升速度和减少内存使用的关键。然而,将模型量化到 NVFP4 仍然具有挑战性:
NVFP4 的局限:
- FP4 只有 16 个可表示值:{-6, -4, -3, -2, -1.5, -1, -0.5, 0, 0.5, 1, 1.5, 2, 3, 4, 6}
- 浮点格式的非均匀步长导致大值的量化误差更大
- 步长在 0-2 之间为 0.5,在 2-4 之间为 1,在 4-6 之间为 2
误差来源分析:
- 缩放因子的 FP8 量化误差(影响整个块)
- FP4 值的舍入误差(主要来自接近最大值的值,约 5 附近)
解决方案概述
本文提出 Four Over Six (4/6),一种修改 NVFP4 块缩放量化算法的方法:
- 核心思想:自适应地将某些块缩放到较小的 FP4 值(4 而非 6),使可表示值的分布更均匀
- 优势:减少接近最大值的值的量化误差
- 实现效率:在现代硬件上高效实现,量化操作开销 <15%
关键创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 自适应块缩放 | 每个块可选择缩放到 4 或 6 | 减少接近最大值的量化误差 |
| MSE 选择规则 | 比较 M=4 和 M=6 的量化误差,选择 MSE 更小的 | PTQ 性能最优 |
| MAE 选择规则 | 使用 MAE 选择缩放因子 | 预训练性能最优 |
| 减少 FP32 张量缩放 | 降低全局缩放因子,允许更多块缩放到 4 | 预训练性能提升 |
| 仅激活量化 | 4/6 仅应用于激活量化 | 预训练中效果最佳 |
三、技术架构
NVFP4 量化基础
NVFP4 是一种块缩放量化格式:
- 值格式:FP4 E2M1(4 位浮点,2 位指数,1 位尾数)
- 块缩放因子:FP8 E4M3,每 16 个值一个
- 张量缩放因子:FP32,整个张量一个
量化公式:
其中:
- ( 为 FP4 最大值,通常为 6)
Four Over Six 核心机制
问题:当缩放到 M=6 时,接近最大值的值(如 5)的量化误差很大,因为步长为 2。
解决方案:允许块选择缩放到 M=4:
- 缩放到 6:值分布在 [-6, 6],步长不均匀
- 缩放到 4:值分布在 [-4, 4],大值区域步长更小
示例:
| 原始值 | M=6 量化值 | M=4 量化值 | M=6 误差 | M=4 误差 |
|---|---|---|---|---|
| 5.0 | 6 | 4 | 1.0 | 1.0 |
| 4.5 | 4 | 4 | 0.5 | 0.5 |
| 3.5 | 4 | 4 | 0.5 | 0.5 |
| 5.5 | 6 | 4 | 0.5 | 1.5 |
对于某些块,缩放到 4 可以减少大值的量化误差。
缩放因子选择规则
MSE 选择(PTQ 最优):
MAE 选择(预训练最优):
实现细节
PTX 指令:使用 NVIDIA Blackwell GPU 的 cvt 指令族执行 FP4 量化和反量化。
CUDA 内核:
- 所有量化值、反量化值和误差保持在寄存器中
- 每个块量化两次(M=4 和 M=6)
- 比较误差并选择更优的缩放因子
- 开销 <15%
计算流程
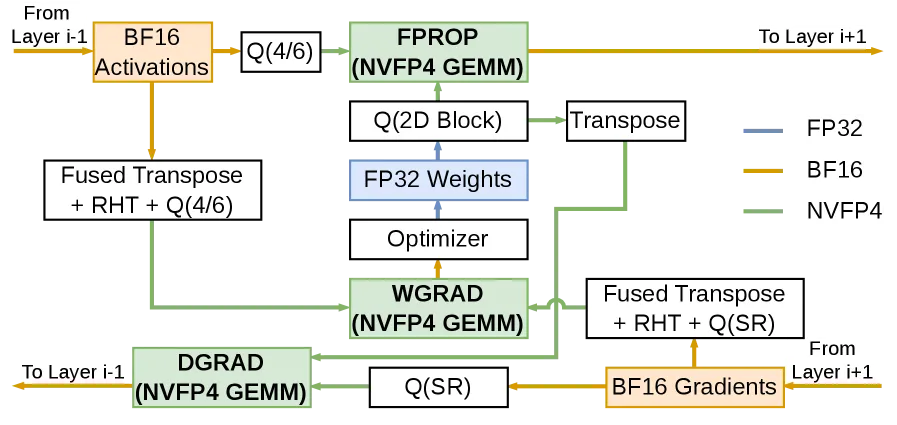
所有矩阵乘法(FPROP、DGRAD、WGRAD)都在 NVFP4 中执行:
- 权重:2D 块量化 + 4/6
- 激活:per-token 量化 + 4/6
- 梯度:per-token 量化 + 4/6(可选)
四、核心能力
预训练改进
- 训练损失:比 NVFP4 基线降低 13.0%,更接近 BF16
- 模型架构:Nemotron 3 Nano 30B-A3B
- 训练数据:1 万亿 token
- 仅激活量化:4/6 仅应用于激活时效果最佳
后训练量化改进
- 通用方法:可与 AWQ、GPTQ、SmoothQuant 等现有 PTQ 方法结合
- 一致改进:在所有测试的模型和方法上均带来性能提升
- 无额外开销:PTQ 阶段无额外计算开销
硬件效率
- Blackwell GPU 支持:利用原生 NVFP4 硬件加速
- 低开销:4/6 量化操作开销 <15%
- INT8 级速度:4-6× 快于 BF16 矩阵乘法
五、实验结果
WikiText-2 困惑度(W4A4 PTQ)
| 方法 | Llama 3 1B | Llama 3 8B | Llama 3 70B | Qwen 3 1.7B | Qwen 3 8B | Qwen 3 32B |
|---|---|---|---|---|---|---|
| BF16 | 11.98 | 7.54 | 2.86 | 21.06 | 12.22 | 9.34 |
| MXFP4 | 17.67 | 9.66 | 5.53 | 26.95 | 14.08 | 11.92 |
| NVFP4 (M=6) | 14.27 | 8.43 | 4.00 | 23.06 | 12.68 | 9.85 |
| NVFP4 (M=4) | 14.75 | 8.63 | 4.48 | 24.43 | 12.98 | 10.57 |
发现:MXFP4 性能最差,NVFP4 (M=6) 优于 NVFP4 (M=4)。但自适应选择(4/6)可以进一步提升。
PTQ 方法 + 4/6(WikiText-2 困惑度)
| 方法 | Llama 3 1B | Llama 3 8B | Llama 3 70B | Qwen 3 1.7B | Qwen 3 8B | Qwen 3 32B |
|---|---|---|---|---|---|---|
| BF16 | 11.98 | 7.54 | 2.86 | 21.06 | 12.22 | 9.34 |
| RTN | 14.27 | 8.43 | 4.00 | 23.06 | 12.68 | 9.85 |
| RTN + 4/6 | 13.84 | 8.30 | 3.83 | 23.60 | 12.56 | 9.84 |
| GPTQ | 13.73 | 8.33 | – | 21.48 | 12.50 | 9.67 |
| GPTQ + 4/6 | 13.67 | 8.30 | – | 22.70 | 12.65 | 9.66 |
| AWQ | 14.04 | 8.33 | 3.86 | 22.20 | 12.68 | 9.69 |
| AWQ + 4/6 | 13.67 | 8.24 | 3.71 | 21.67 | 12.57 | 9.64 |
| SmoothQuant | 14.17 | 8.38 | 3.86 | 21.99 | 12.64 | 9.65 |
| SmoothQuant + 4/6 | 14.03 | 8.32 | 3.80 | 21.97 | 12.62 | 9.63 |
关键发现:
- AWQ + 4/6 效果最好:Llama 3 8B 从 8.33 降至 8.24,Qwen 3 1.7B 从 22.20 降至 21.67
- 4/6 在所有 PTQ 方法上均带来一致改进
- Llama 3 70B 上 AWQ + 4/6 从 3.86 降至 3.71(接近 BF16 的 2.86)
下游任务性能(Llama 3)
| 方法 | BoolQ 1B | BoolQ 8B | Arc-E 1B | Arc-E 8B | Arc-C 1B | Arc-C 8B | HellaSwag 1B | HellaSwag 8B | Avg 1B | Avg 8B |
|---|---|---|---|---|---|---|---|---|---|---|
| BF16 | 63.7 | 83.2 | 61.8 | 82.5 | 37.0 | 55.0 | 64.3 | 79.3 | 56.7 | 75.0 |
| RTN | 58.6 | 80.2 | 57.3 | 77.5 | 34.3 | 52.5 | 60.0 | 77.7 | 52.3 | 72.0 |
| RTN + 4/6 | 57.7 | 80.9 | 56.9 | 80.2 | 33.0 | 52.6 | 60.0 | 78.0 | 51.9 | 72.2 |
| AWQ | 59.8 | 81.3 | 58.0 | 78.4 | 34.2 | 51.7 | 60.9 | 77.5 | 53.2 | 72.2 |
| AWQ + 4/6 | 61.0 | 80.4 | 58.8 | 80.2 | 35.5 | 53.6 | 61.2 | 78.2 | 54.1 | 73.1 |
| SmoothQuant | 61.1 | 81.1 | 57.4 | 77.6 | 35.5 | 52.7 | 60.7 | 77.6 | 53.7 | 72.3 |
| SmoothQuant + 4/6 | 61.6 | 80.4 | 58.0 | 78.6 | 35.6 | 52.2 | 61.6 | 80.4 | 54.2 | 72.9 |
下游任务性能(Qwen 3)
| 方法 | BoolQ 1.7B | BoolQ 8B | Arc-E 1.7B | Arc-E 8B | Arc-C 1.7B | Arc-C 8B | HellaSwag 1.7B | HellaSwag 8B | Avg 1.7B | Avg 8B |
|---|---|---|---|---|---|---|---|---|---|---|
| BF16 | 77.6 | 86.6 | 70.2 | 80.9 | 43.0 | 56.7 | 60.4 | 74.9 | 62.8 | 74.8 |
| RTN | 73.1 | 85.5 | 59.9 | 78.6 | 35.3 | 54.1 | 58.0 | 73.2 | 56.6 | 72.3 |
| RTN + 4/6 | 76.3 | 85.8 | 66.3 | 78.5 | 38.7 | 53.7 | 58.0 | 73.7 | 59.8 | 72.9 |
| AWQ | 72.8 | 86.5 | 58.0 | 78.4 | 36.3 | 55.2 | 57.8 | 73.6 | 56.2 | 73.4 |
| AWQ + 4/6 | 75.9 | 86.5 | 63.8 | 78.1 | 39.2 | 55.8 | 57.9 | 73.6 | 59.2 | 73.5 |
关键发现:
- AWQ + 4/6 在 Qwen 3 1.7B 上平均提升 +3.0(56.2→59.2)
- RTN + 4/6 在 Qwen 3 1.7B 上提升最大(56.6→59.8,+3.2)
- 4/6 在小模型上改进更显著
预训练实验
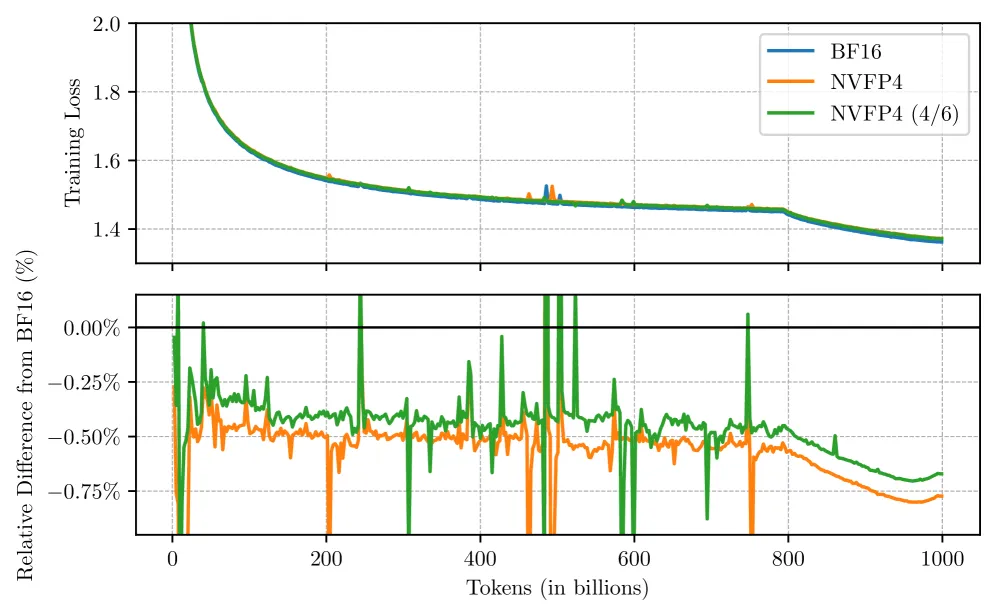
关键发现:
- 4/6 将训练损失比 NVFP4 基线降低 13.0%,更接近 BF16
- 仅在激活上使用 4/6 即可获得大部分收益
- MAE 选择规则在预训练中优于 MSE
消融实验
缩放因子选择规则
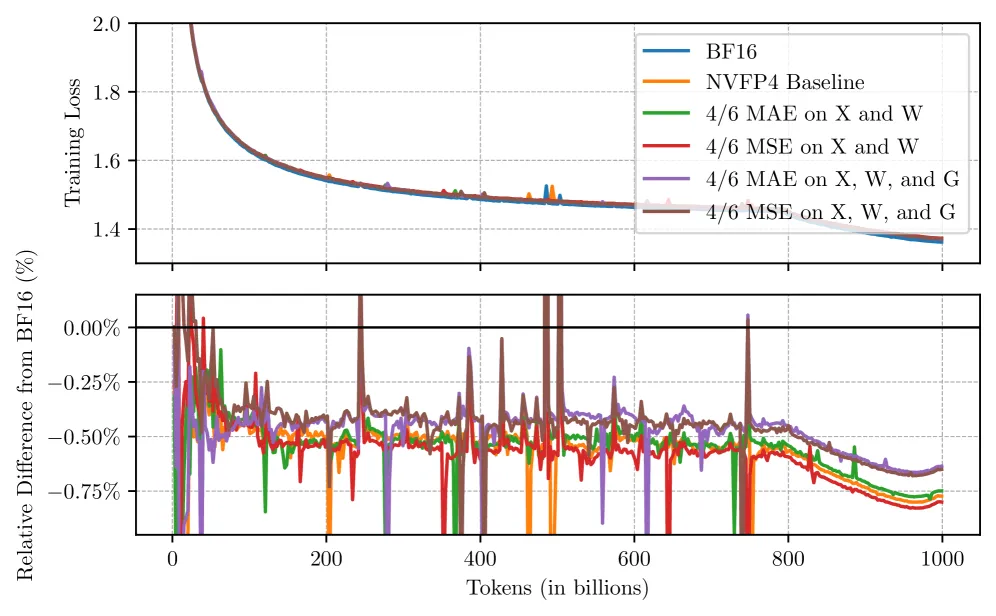
发现:
- MSE 在 PTQ 中更好
- MAE 在预训练中更好
FP32 张量缩放
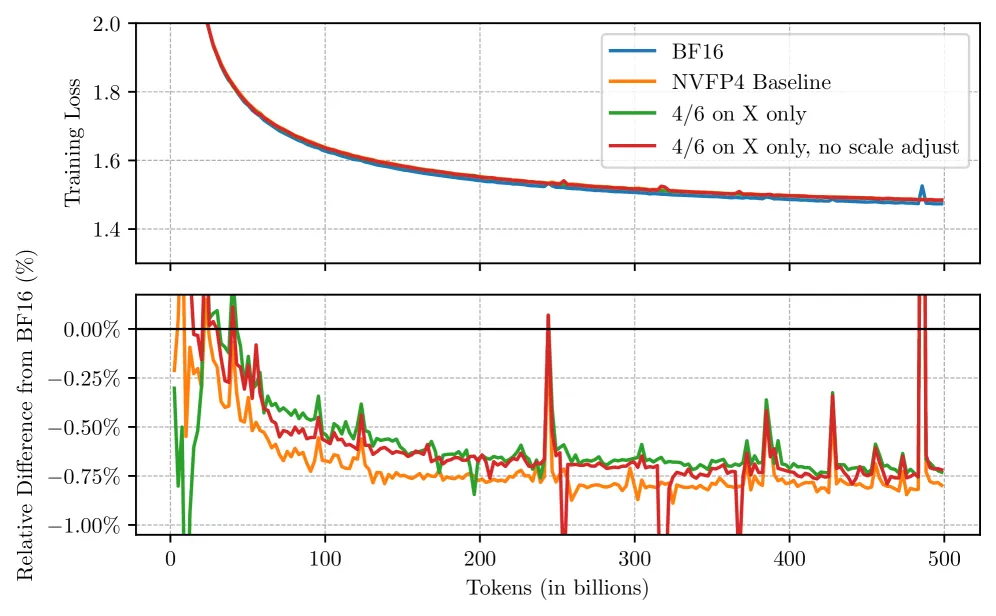
发现:减少 FP32 张量缩放允许更多块缩放到 4,提升预训练性能。
激活 vs 全部张量
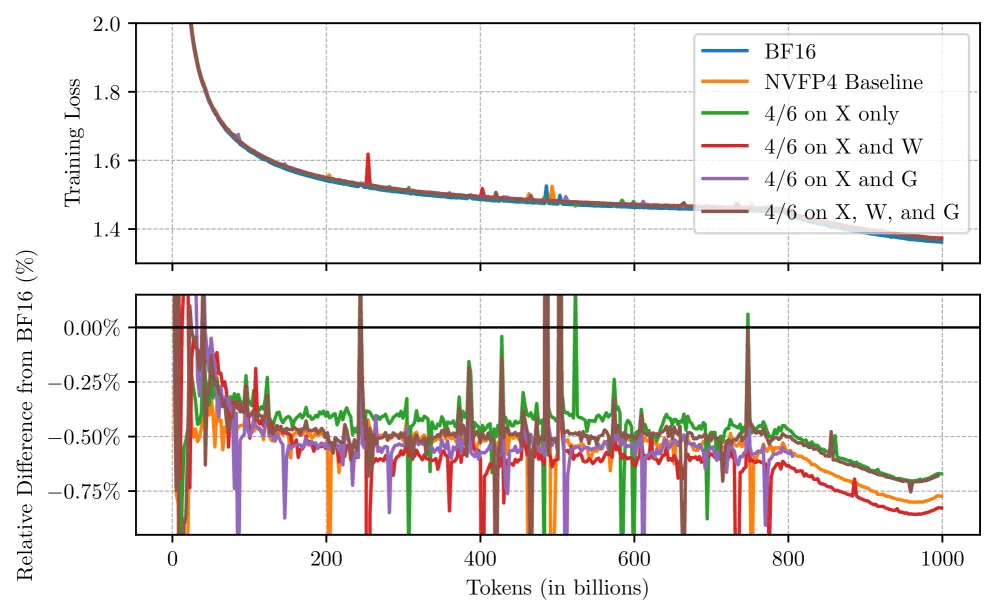
发现:仅在激活上使用 4/6 效果最佳,可能因为权重和梯度的分布特性不同。
六、实现细节
| 配置 | 值 |
|---|---|
| 基础模型 | Nemotron 3 Nano 30B-A3B |
| 训练数据 | 1 万亿 token |
| 序列长度 | 8192 |
| 批量大小 | 3072 |
| 优化器 | AdamW (β1=0.9, β2=0.95) |
| 学习率 | Warmup-Stable-Decay |
| 量化格式 | NVFP4 (FP4 E2M1 + FP8 E4M3) |
| 块大小 | 16 values |
| 4/6 开销 | <15% |
| 硬件 | NVIDIA Blackwell B200 |
训练配置
- 随机舍入(梯度)
- 随机 Hadamard 变换(权重梯度计算)
- 2D 块量化(权重矩阵)
- 注意力组件、输出投影和嵌入层保持高精度
七、与现有方法对比
| 方法 | 类型 | 适用场景 | 改进方式 | 效果 |
|---|---|---|---|---|
| MXFP4 | 块缩放 FP4 | 通用 | 固定缩放 | 基线 |
| NVFP4 | 块缩放 FP4 | Blackwell GPU | 固定缩放到 6 | 优于 MXFP4 |
| AWQ | PTQ | 推理 | 通道缩放 | 与 4/6 兼容 |
| GPTQ | PTQ | 推理 | 二阶信息 | 与 4/6 兼容 |
| SmoothQuant | PTQ | 推理 | 平滑量化 | 与 4/6 兼容 |
| 4/6 | 量化算法 | 训练+推理 | 自适应块缩放 | 一致改进 |
独特优势:
- 通用方法,可与任何 PTQ 方法结合
- 支持预训练和后训练量化
- 硬件高效实现(<15% 开销)
- 无需修改模型架构或训练流程
八、相关工作
| 方向 | 代表工作 | 与 4/6 的关系 |
|---|---|---|
| 低精度训练 | FP8, FP4 training | 4/6 改进 FP4 训练 |
| 块缩放格式 | MXFP4, NVFP4 | 4/6 修改 NVFP4 算法 |
| PTQ 方法 | AWQ, GPTQ, SmoothQuant | 4/6 与之兼容 |
| 旋转方法 | SpinQuant, QuaRot | 互补方法 |
| 异常值处理 | Outlier suppression | 4/6 的替代方案 |
九、总结
核心贡献
- 自适应块缩放:允许块选择缩放到 4 或 6,减少大值量化误差
- 预训练改进:训练损失比 NVFP4 基线降低 13.0%,更接近 BF16
- PTQ 一致改进:与 AWQ、GPTQ、SmoothQuant 结合均带来性能提升
- 硬件高效:在 Blackwell GPU 上实现,开销 <15%
- 通用方法:适用于训练和推理,无需修改模型架构
技术影响
- 为 NVFP4 量化提供了简单有效的改进方案
- 预训练中仅需在激活上使用 4/6 即可获得大部分收益
- PTQ 中 AWQ + 4/6 组合效果最好
- 代码开源,可直接集成到现有训练和推理框架
局限性
- 仅适用于 NVFP4,不兼容 MXFP4(FP8 缩放因子精度不足)
- 需要 Blackwell GPU 的硬件支持
- 某些模型(如 Qwen 3 1.7B + GPTQ)上 4/6 可能略有下降
- 预训练实验仅在 30B-A3B 模型上验证
十、参考资源
- 论文: arXiv:2512.02010
- 代码: GitHub: inspire-group/four-over-six
- 关键引用:
- NVFP4 (NVIDIA et al., 2025a) — 基础量化格式
- MXFP4 (Rouhani et al., 2023) — 替代块缩放格式
- AWQ (Lin et al., 2024) — 权重量化方法
- GPTQ (Frantar et al., 2023) — 二阶量化方法
- SmoothQuant (Xiao et al., 2024a) — 平滑量化方法
- Nemotron 3 (NVIDIA, 2025) — 预训练模型架构
分析日期: 2026-06-05