Vidi2.5: Large Multimodal Models for Video Understanding and Creation
支持时空定位、时序检索和视频问答的大规模多模态模型,通过统一编码架构实现视频理解与创作
Vidi2.5: Large Multimodal Models for Video Understanding and Creation
论文信息: arXiv:2511.19529 [cs.CV] 28 Nov 2025
机构: Vidi Team, ByteDance Inc.
模型规模: 12B 参数(基于 Gemma-3)
一、论文概述
1.1 研究背景
视频已成为互联网上沟通和创作的主要媒介,推动了对可扩展、高质量视频制作的需求。现有视频理解模型在以下方面存在不足:
| 挑战 | 说明 |
|---|---|
| 时空定位 | 无法精确定位视频中目标对象的时间戳和边界框 |
| 剧情理解 | 缺乏对复杂剧情的细粒度感知和推理能力 |
| 视频编辑规划 | 难以将理解能力转化为实际的编辑工作流 |
1.2 核心贡献
| 贡献 | 说明 |
|---|---|
| Vidi2.5 模型 | 基于 Vidi 升级,支持 STG、TR、Video QA |
| VUE-STG 基准 | 首个大规模时空定位评估基准 |
| VUE-TR-V2 基准 | 升级版时序检索基准,覆盖更多视频类型 |
| VUE-PLOT 基准 | 情节理解与推理评估基准 |
| 多任务应用 | 支持高亮提取、情节理解、故事线创作 |
1.3 一句话总结
Vidi2.5 是一个 12B 参数的大规模多模态模型,通过统一的视觉-音频-文本编码架构,在时空定位、时序检索和视频问答任务上显著超越 Gemini 3、GPT-5 等闭源模型。
二、核心思想
2.1 设计原则
┌─────────────────────────────────────────────────────────────────┐
│                    Vidi2.5 设计原则                              │
├─────────────────────────────────────────────────────────────────┤
│  1. 统一编码架构 (Unified Encoding)                              │
│     • 图像视为 11 秒静音视频                                     │
│     • 自适应 Token 压缩策略                                     │
│     • 视觉-音频-文本三模态融合                                   │
│                                                                 │
│  2. 多任务协同 (Multi-Task Synergy)                              │
│     • 时空定位 (STG)                                            │
│     • 时序检索 (Temporal Retrieval)                              │
│     • 视频问答 (Video QA)                                       │
│     • 情节理解 (Plot Understanding)                              │
└─────────────────────────────────────────────────────────────────┘
2.2 关键技术问题
| 问题 | 现有方案的局限 | Vidi2.5 解决方案 |
|---|---|---|
| 时空对齐 | 大多数模型仅支持时间或空间定位 | 统一输出时空 Tube(时间范围 + 边界框序列) |
| 视频长度 | 固定帧采样导致信息丢失 | 自适应 Token 压缩,平衡长短视频效率 |
| 多模态 | 视觉和音频分开处理 | 统一编码接口,联合处理视觉、音频、文本 |
| 训练数据 | 合成数据为主,质量有限 | 增加真实视频数据比例,提升泛化能力 |
三、技术架构
3.1 整体架构
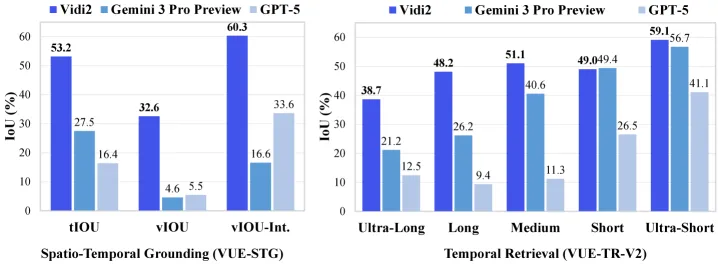 图 1:Vidi2.5 在时空定位和时序检索基准上的结果展示
核心组件:
| 组件 | 说明 | 关键特性 |
|---|---|---|
| 视觉编码器 | 多模态视觉编码器 | 支持图像和视频输入 |
| 音频编码器 | 音频特征提取 | 语音、音乐、音效 |
| LLM 骨干 | Gemma-3 12B | 强大的语言理解与生成 |
| 自适应压缩 | Token 压缩策略 | 平衡长短视频效率 |
3.2 时空定位输出格式
Vidi2.5 输出时空 Tube——一个由离散化边界框组成的序列:
输入: "黄色校车停在有黄叶树附近的街道上"
输出: [
{"timestamp": "00:30", "box_2d": [100, 200, 300, 400]},
{"timestamp": "00:31", "box_2d": [102, 201, 302, 401]},
...
]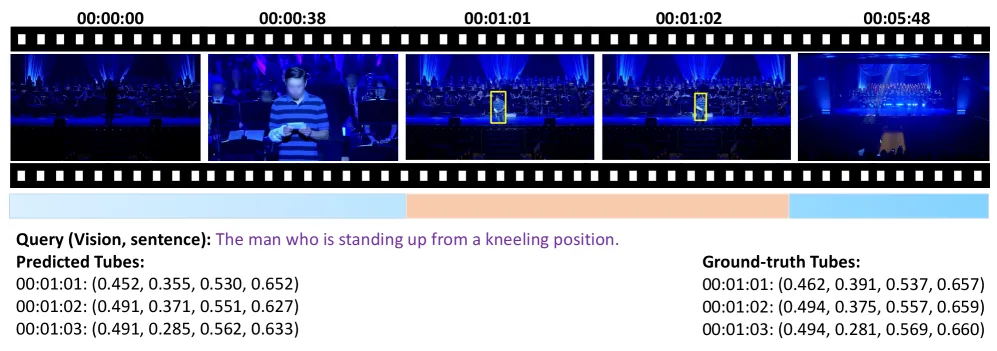 图 2:时空定位查询示例,展示文本查询与对应的时间范围和对象 Tube
3.3 训练流程
三阶段渐进式训练:
| 阶段 | 目标 | 数据特点 |
|---|---|---|
| 多模态对齐 | 建立视觉-音频-文本对齐 | 大规模配对数据 |
| 监督微调 | 任务特定能力优化 | STG、TR、QA 数据 |
| 后训练 | 通用视频 QA 增强 | 增加真实视频 QA 数据 |
关键改进:
- 增加真实视频数据比例,提升泛化能力
- 扩展时序检索 SFT 数据集
- 引入通用 QA 数据,增强开放式推理
3.4 模型变体
| 变体 | 能力 | 应用场景 |
|---|---|---|
| Vidi2 | 基础版本,支持 TR、STG、Video QA | 通用视频理解 |
| Vidi2.5 | RL 训练增强 STG 和 TR | 高精度时空定位 |
| Vidi2.5-Think | 思考模型,复杂剧情推理 | 电影/电视剧分析 |
| Vidi-Edit | 视频编辑规划后训练 | 自动化视频编辑 |
四、核心创新
4.1 创新点总结
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 统一时空 Tube 输出 | 同时输出时间范围和空间边界框 | VUE-STG 基准验证 |
| 自适应 Token 压缩 | 平衡长短视频编码效率 | 不同长度视频性能一致 |
| 三模态统一编码 | 视觉、音频、文本联合处理 | 音频查询支持 |
| 多任务协同训练 | STG + TR + QA 联合优化 | 泛化能力提升 |
4.2 技术亮点
1. 自适应 Token 压缩:
- 根据视频长度动态调整压缩率
- 短视频保留更多细节,长视频保持关键信息
- 统一的 11 秒静音视频编码接口
2. 时空 Tube 输出:
- 时间维度:离散化到秒级精度
- 空间维度:归一化边界框 [0, 1]
- 支持多目标同时定位
3. 多模态查询支持:
- 文本查询:关键词、短语、句子
- 视觉查询:图像参考
- 音频查询:语音内容
- 视觉+音频联合查询
五、评估基准
5.1 VUE-STG(时空定位基准)
| 特性 | 说明 |
|---|---|
| 任务 | 给定文本查询,输出时空 Tube |
| 评估维度 | 时间精度、空间精度、时空联合精度 |
| 视频类型 | 超短、短、中等长度视频 |
| 目标大小 | 小(<10%)、中(10-30%)、大(>30%) |
评估指标:
- 时间指标:时间精度 (tP)、时间召回 (tR)、时间 IoU (tIoU)
- 时空指标:视频 IoU (vIoU)、视频精度 (vP)、视频召回 (vR)
- 主排名指标:vIoU(联合捕获时间和空间对齐精度)
5.2 VUE-TR-V2(时序检索基准)
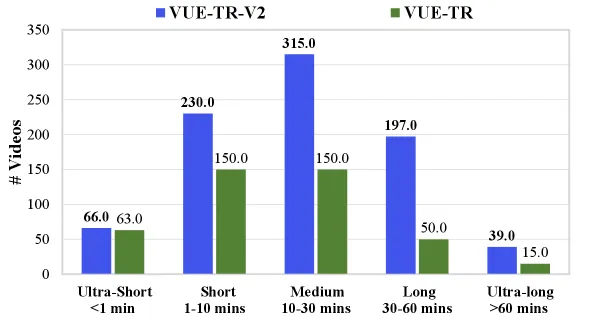 图 3:VUE-TR-V2 与 VUE-TR 的视频分布对比
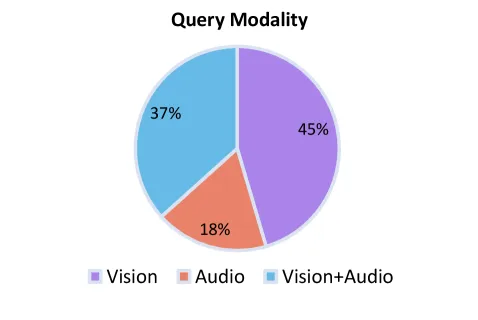 图 4:VUE-TR-V2 中查询模态和格式的分布
| 特性 | 说明 |
|---|---|
| 任务 | 给定文本查询,输出时间范围 |
| 查询类型 | 关键词、短语、句子 |
| 查询模态 | 文本、视觉、音频、视觉+音频 |
| 视频长度 | 超短(<1m)到超长(>60m) |
改进点:
- 更平衡的视频时长分布
- 更多人工编写的自由格式查询
- 增加长视频和超长视频比例
5.3 VUE-PLOT(情节理解基准)
| 特性 | 说明 |
|---|---|
| 任务 | 复杂情节推理与人物关系理解 |
| 评估维度 | 角色识别、事件因果、时间推理 |
| 视频类型 | 电影、电视剧等叙事性视频 |
两个赛道:
- Character Track:细粒度角色理解(说话人识别、人脸追踪)
- Reasoning Track:复杂剧情推理
六、实验结果
6.1 时空定位基准 (VUE-STG)
时序性能:
| 模型 | tIoU (%) | tP (%) | tR (%) |
|---|---|---|---|
| Vidi2.5 | 53.19 | 73.00 | 59.80 |
| Gemini 3 Pro Prev. | 27.50 | 51.91 | 35.26 |
| GPT-5 | 16.40 | 38.29 | 19.53 |
| Qwen3-VL-32B | 25.91 | 45.29 | 39.19 |
时空性能:
| 模型 | vIoU (%) | vIoU-Int. (%) | vP (%) | vR (%) |
|---|---|---|---|---|
| Vidi2.5 | 32.57 | 60.30 | 44.56 | 36.32 |
| Gemini 3 Pro Prev. | 4.61 | 16.59 | 8.95 | 5.71 |
| GPT-5 | 5.47 | 33.64 | 13.01 | 6.50 |
| Qwen3-VL-32B | 5.12 | 18.47 | 8.61 | 7.49 |
分视频长度性能:
| 视频长度 | Vidi2.5 tIoU | Gemini 3 tIoU | GPT-5 tIoU |
|---|---|---|---|
| 超短视频 (<1m) | 61.43 | 38.68 | 64.66 |
| 短视频 (1-10m) | 61.48 | 35.39 | 19.73 |
| 中等视频 (10-30m) | 47.27 | 21.13 | 4.10 |
关键发现:
- Vidi2.5 在所有时空定位指标上显著超越竞争模型
- 在中等长度视频(10-30分钟)上优势尤为明显
- 对小目标(<10% 面积)的定位精度远超其他模型
6.2 时序检索基准 (VUE-TR-V2)
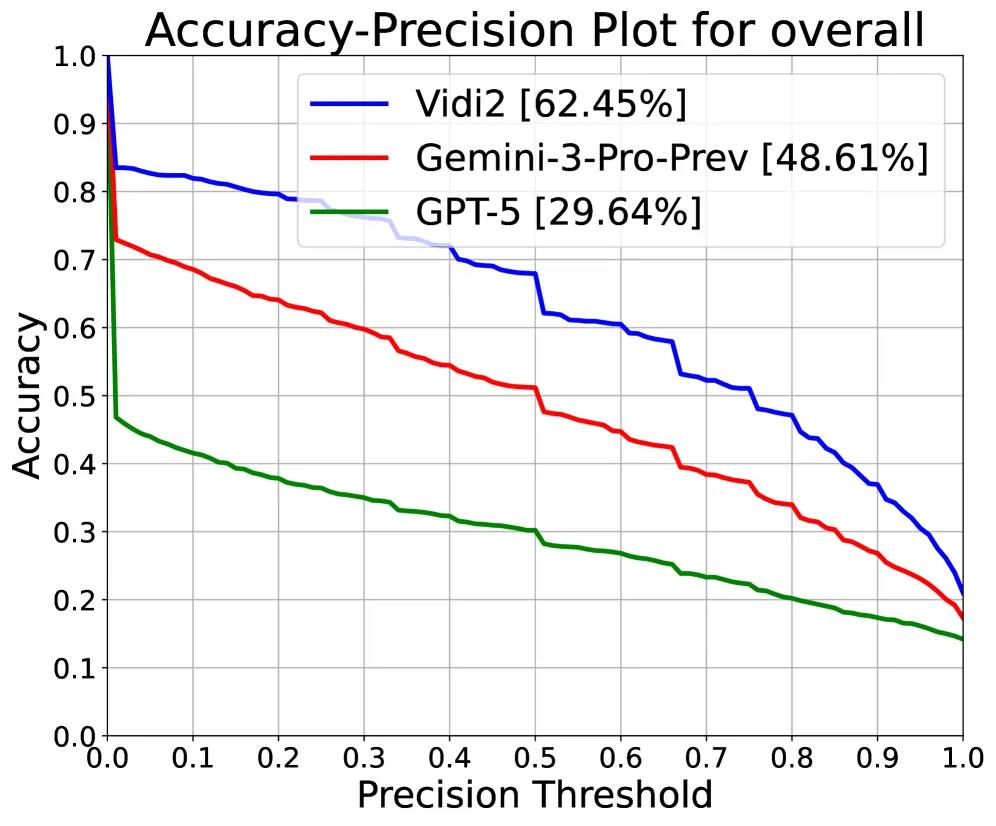 图 5:VUE-TR-V2 基准上不同时序检索模型的整体性能曲线
| 模型 | IoU̅ (%) | P̅ (%) | R̅ (%) |
|---|---|---|---|
| Vidi2.5 | 48.75 | 62.45 | 64.93 |
| Gemini 3 Pro Prev. | 37.58 | 48.61 | 56.30 |
| GPT-5 | 17.15 | 29.64 | 26.63 |
分视频长度性能:
| 视频长度 | Vidi2.5 IoU̅ | Gemini 3 IoU̅ | GPT-5 IoU̅ |
|---|---|---|---|
| 超短视频 (<1m) | 59.09 | 56.72 | 41.08 |
| 短视频 (1-10m) | 49.01 | 49.40 | 26.52 |
| 中等视频 (10-30m) | 51.05 | 40.56 | 11.28 |
| 长视频 (30-60m) | 48.15 | 26.20 | 9.39 |
| 超长视频 (>60m) | 38.65 | 21.19 | 12.49 |
分查询类型性能:
| 查询类型 | Vidi2.5 IoU̅ | Gemini 3 IoU̅ | GPT-5 IoU̅ |
|---|---|---|---|
| 关键词 | 47.73 | 38.41 | 23.17 |
| 短语 | 50.11 | 37.84 | 17.02 |
| 句子 | 48.17 | 36.73 | 12.92 |
| 音频 | 46.90 | 33.27 | 6.93 |
| 视觉 | 51.04 | 39.54 | 20.62 |
| 视觉+音频 | 46.81 | 37.26 | 17.85 |
关键发现:
- Vidi2.5 在时序检索上整体 IoU 超越 Gemini 3 达 10%+
- 在长视频(>30分钟)上优势更加明显
- 对音频查询的支持显著提升检索性能
6.3 视频问答基准
| 基准 | Vidi2.5 | Qwen2.5-VL-7B | Gemini-2.5-Pro |
|---|---|---|---|
| LVBench | 45.8 | 45.3 | 78.7 |
| LongVideoBench | 57.1 | 54.7 | 84.3 |
| VideoMME | 63.5 | 65.1 | - |
关键发现:
- Vidi2.5 在视频 QA 上与同等规模开源模型(Qwen2.5-VL-7B)性能相当
- 虽然落后于 Gemini-2.5-Pro,但作为专注于检索和定位的模型表现优异
- 多任务协同训练带来通用视频理解能力
七、应用场景
7.1 高亮提取与标题生成
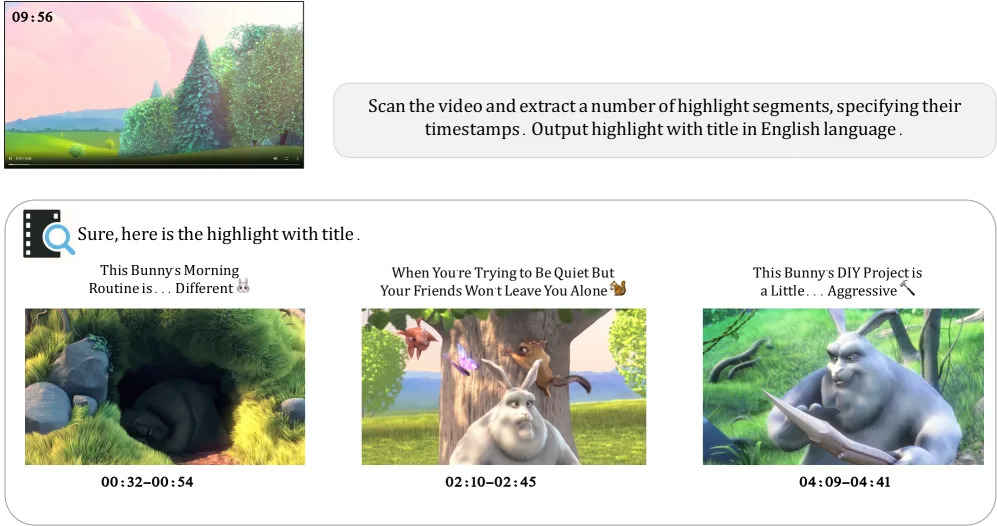 图 6:高亮提取应用示例
- 输入:长原始视频
- 输出:多个高亮片段 + 简洁标题
- 应用:短视频自动生成、视频摘要
7.2 情节理解与推理
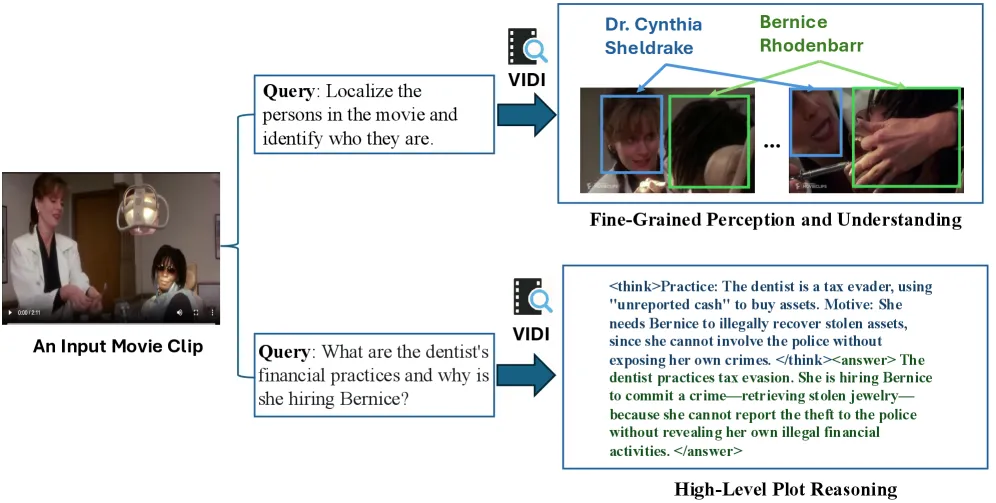 图 7:情节理解应用示例
- 能力:理解人物身份、交互关系、事件因果
- 示例:“一个角色举手要打另一个角色,但没打中,反而打到了朋友”
- 应用:电影/电视剧自动剪辑、人物关系分析
7.3 故事线视频创作
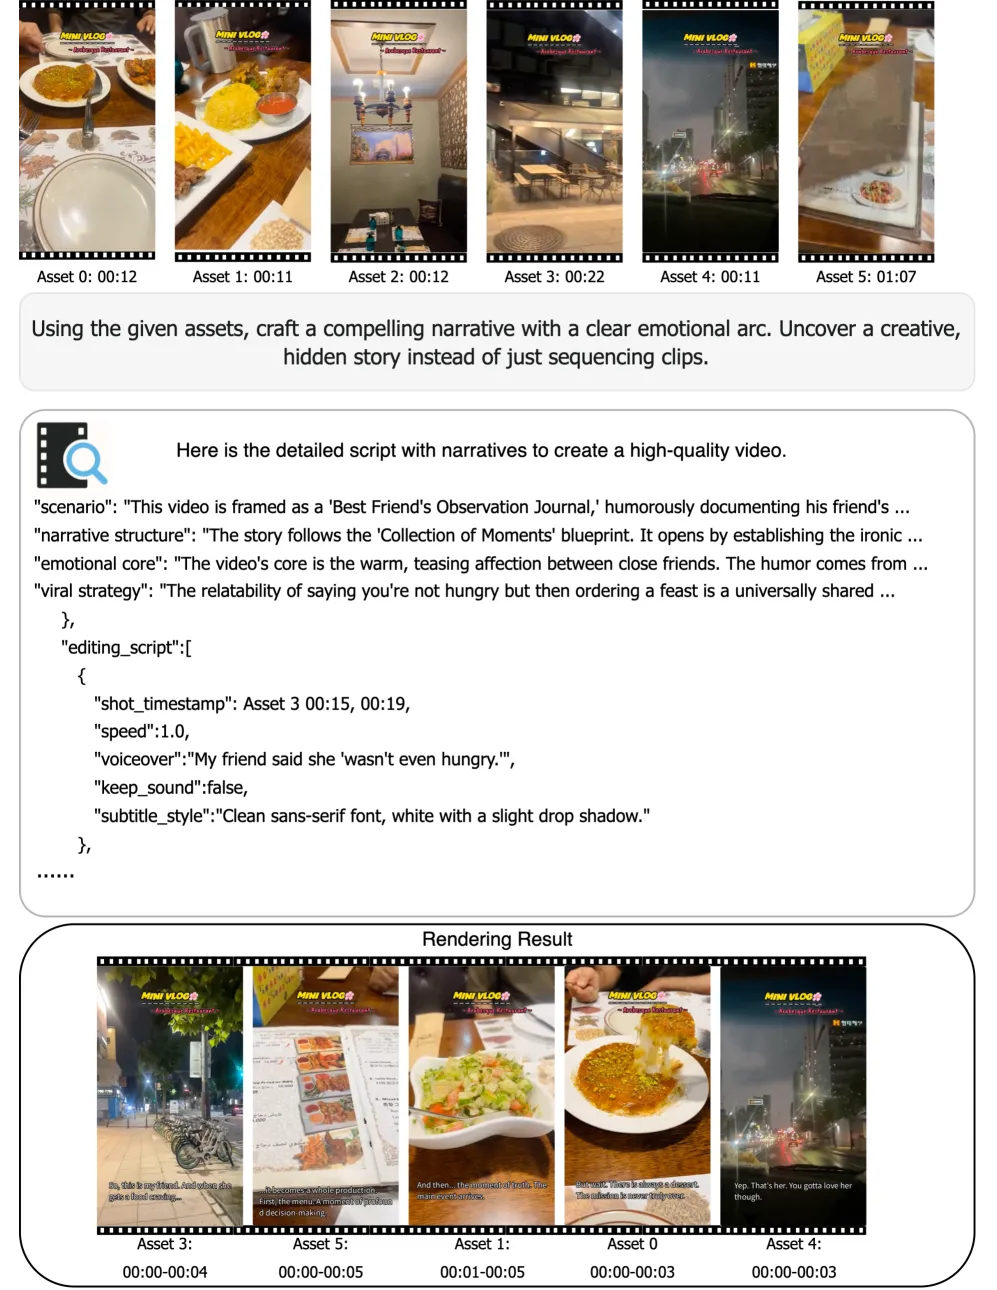 图 8:故事线视频创作应用示例
- 输入:6 个视频片段
- 输出:完整的视频创作指令集
- 包含:旁白、音乐、动画、转场效果
- 应用:自动化视频创作工作流
八、相关工作
8.1 视频理解模型
| 模型 | 特点 | 局限性 |
|---|---|---|
| Gemini 3 | 多模态理解,支持长视频 | 时空定位能力有限 |
| GPT-5 | 强大的语言推理 | 不支持音频,帧数限制 |
| Qwen3-VL | 开源多模态模型 | 时空定位精度不足 |
| Vidi (v1) | 时序检索专用 | 不支持 STG 和 Video QA |
8.2 时空定位方法
| 方法 | 特点 | 局限性 |
|---|---|---|
| 两阶段方法 | 先检测再匹配 | 效率低,误差累积 |
| 端到端方法 | 直接预测时空 Tube | 训练数据需求大 |
| Vidi2.5 | 统一输出时空 Tube | 12B 参数,计算开销较大 |
8.3 Vidi2.5 定位
Vidi2.5 作为视频理解与创作的基础模型,结合了:
- 时空定位的精确性
- 时序检索的全面性
- 视频问答的通用性
- 多任务应用的实用性
九、总结
9.1 核心贡献
- Vidi2.5 模型:基于 Gemma-3 的 12B 参数多模态模型
- 时空 Tube 输出:统一输出时间范围和空间边界框
- 自适应 Token 压缩:平衡长短视频编码效率
- 多任务协同训练:STG + TR + QA 联合优化
- 三个新基准:VUE-STG、VUE-TR-V2、VUE-PLOT
- 多模态查询:支持文本、视觉、音频查询
9.2 技术影响
| 影响领域 | 具体影响 |
|---|---|
| 视频理解 | 推动时空定位和时序检索研究 |
| 视频编辑 | 支持自动化高亮提取和情节理解 |
| 内容创作 | 实现故事线驱动的视频生成 |
| 多模态 AI | 展示多任务协同的泛化能力 |
9.3 局限性
- 模型规模:12B 参数,推理开销较大
- 视频 QA:落后于专用模型(Gemini-2.5-Pro)
- 实时性:不支持实时视频流处理
- 3D 理解:缺乏深度和 3D 空间理解
9.4 未来方向
- 模型压缩:减小模型规模,提升推理效率
- 实时处理:支持视频流的实时理解
- 3D 时空:扩展到 3D 空间定位
- 交互式编辑:支持用户交互的视频编辑
十、参考资源
10.1 论文链接
10.2 代码资源
10.3 关键图表
| 图表 | 说明 | 路径 |
|---|---|---|
| 图 1 | 时空定位与检索结果 | figure-1-stg-results.png |
| 图 2 | 时空定位查询示例 | figure-2-stg-examples.png |
| 图 3 | VUE-TR-V2 视频分布 | figure-3-vue-tr-v2-comparison.png |
| 图 4 | 查询模态分布 | figure-4-query-distribution.png |
| 图 5 | 时序检索性能曲线 | figure-5-temporal-retrieval-curves.png |
| 图 6 | 高亮提取应用 | figure-6-highlight-extraction.png |
| 图 7 | 情节理解应用 | figure-7-plot-understanding.png |
| 图 8 | 故事线创作应用 | figure-8-storyline-creation.png |


10.4 相关论文
| 论文 | 作者 | 年份 | 关系 |
|---|---|---|---|
| Vidi | Vidi Team | 2025 | 前序模型 |
| Gemma-3 | 2025 | LLM 骨干 | |
| Gemini 3 | 2025 | 竞争模型 | |
| GPT-5 | OpenAI | 2025 | 竞争模型 |
| Qwen3-VL | Alibaba | 2025 | 竞争模型 |
10.5 关键技术术语
| 术语 | 英文 | 说明 |
|---|---|---|
| 时空定位 | Spatio-Temporal Grounding (STG) | 同时定位时间和空间位置 |
| 时序检索 | Temporal Retrieval | 根据查询检索视频时间范围 |
| 时空 Tube | Spatio-temporal Tube | 时间范围 + 边界框序列 |
| 视频问答 | Video QA | 基于视频内容回答问题 |
| 情节理解 | Plot Understanding | 理解复杂叙事和人物关系 |
分析完成时间:2026年6月17日 分析工具:Claude Code + agent-browser