Nemotron-Flash: Towards Latency-Optimal Hybrid Small Language Models
面向延迟最优的混合小语言模型,通过深度-宽度优化、算子搜索和权重归一化实现SOTA效率
Nemotron-Flash: Towards Latency-Optimal Hybrid Small Language Models
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Nemotron-Flash: Towards Latency-Optimal Hybrid Small Language Models |
| 作者 | Yonggan Fu, Xin Dong, Shizhe Diao, Matthijs Van keirsbilck, Hanrong Ye, Wonmin Byeon, Yashaswi Karnati, Lucas Liebenwein, Hannah Zhang, Nikolaus Binder, Maksim Khadkevich, Alexander Keller, Jan Kautz, Yingyan (Celine) Lin, Pavlo Molchanov |
| 机构 | NVIDIA, Georgia Institute of Technology |
| 论文 | arXiv:2511.18890 |
| 发布 | 2025-11-24 |
| 主题 | cs.CL (Computation and Language) |
| 模型 | Nemotron-Flash-1B/3B |
二、核心思想
问题定义
小语言模型 (SLM) 的高效部署对延迟敏感的现实应用至关重要。现有工作主要关注减少参数量来实现参数效率,但参数效率不一定能转化为成比例的实际设备加速。
核心问题:
- 深-窄模型是否在延迟-精度权衡上最优?
- 哪些高效注意力算子最适合SLM?
- 如何系统性地训练延迟最优的SLM?
核心观察
关键发现:
- 深-窄模型虽然参数高效,但延迟-精度权衡次优
- 存在最优深度-宽度比,取决于目标延迟预算
- DeltaNet和Gated DeltaNet是线性注意力的有力候选
- 权重归一化可有效提升收敛和下游精度
解决方案概述
Nemotron-Flash:延迟最优的混合SLM家族。
三大创新:
- 深度-宽度优化:增强缩放定律确定最优比例
- 进化搜索:自动发现混合注意力算子组合
- 权重归一化:约束权重范数提升有效学习率
三、技术架构
整体框架
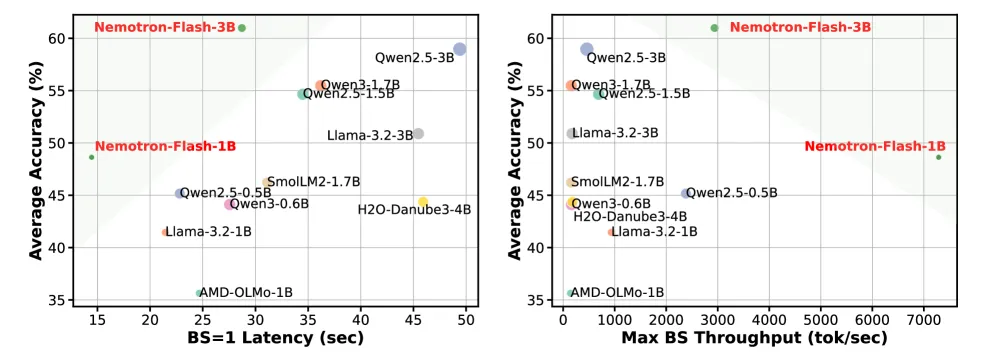
Figure 1: Nemotron-Flash显著推进了SLM的精度-效率前沿。
深度-宽度探索
核心问题:深-窄 vs 宽-浅,哪个更适合延迟优化?
实验设置:
- 训练一系列Llama模型,深度设置:6/12/18/24/30层
- 每个深度设置变化隐藏大小
- 在100B tokens上训练
关键发现:
| 观察 | 说明 |
|---|---|
| 观察1 | 深-窄模型在参数-精度权衡上更优,但收益逐渐饱和 |
| 观察2 | 在延迟-精度权衡上,深-窄不一定最优 |
| 观察3 | 存在最优深度,取决于延迟预算 |
示例:延迟预算3秒时,深度12的模型优于深度24的模型。
增强缩放定律
标准缩放定律:
增强缩放定律(引入深度D和宽度W):
实际应用:
- 在目标延迟约束下,profile一系列深度-宽度配置
- 选择满足延迟约束且损失最低的配置
算子探索
探索的算子:
| 算子 | 特点 |
|---|---|
| Mamba | 选择性状态空间模型 |
| Mamba2 | 改进版Mamba |
| GLA | 门控线性注意力 |
| DeltaNet | 增量规则线性注意力 |
| Gated DeltaNet | 门控版DeltaNet |
| RWKV7 | 线性注意力变体 |
| SWA | 滑动窗口注意力 |
关键发现:
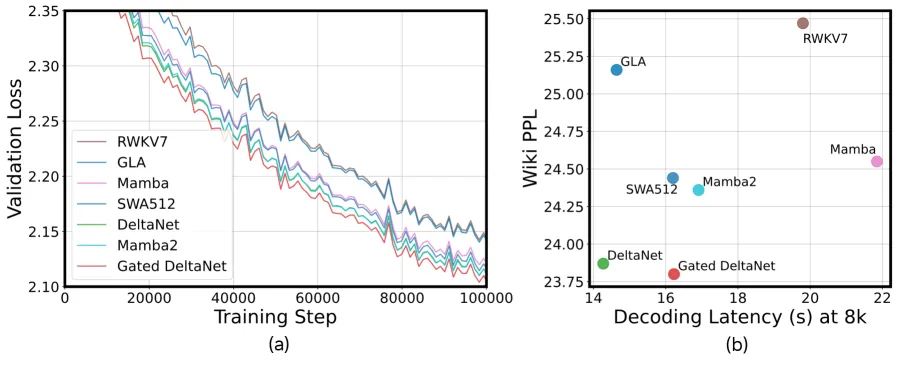
Figure 4: 算子探索结果。
Table 1: 算子组合探索(500M参数)
| 算子1 | 算子2 | Wiki PPL ↓ | CR Acc ↑ |
|---|---|---|---|
| Mamba2 | - | 24.36 | 47.72% |
| Attention | - | 24.44 | 48.02% |
| DeltaNet | - | 23.87 | 47.83% |
| DeltaNet | Mamba2 | 23.37 | 48.03% |
| Gated DeltaNet | Mamba2 | 23.37 | 48.03% |
关键发现:
- DeltaNet和Gated DeltaNet是PPL-延迟前沿的最佳候选
- 与Mamba2配对通常效果更好
- 纯DeltaNet优于纯Attention
进化搜索框架
搜索空间:
- 候选算子:DeltaNet, Attention, Mamba2
- 三阶段策略:早/中/晚阶段各一种构建块
- 每阶段可搜索:算子类型、比例、FFN数量
搜索算法:
- 使用老化进化搜索 (Aging Evolution Search)
- 短训练PPL作为搜索代理:利用架构排名早期稳定的特性
- 每个架构训练10B tokens(约2小时,32×A100)
搜索结果:
Table 2: 不同效率指标搜索的架构
| 搜索指标 | 参数量 | Wiki PPL | CR Acc | 架构 |
|---|---|---|---|---|
| 解码延迟 | 837M | 20.70 | 51.04% | [d,f,m2,f,a,f,m2,f,d,…] |
| 参数量 | 497M | 23.06 | 49.23% | [m2,f,a,f,a,f,d,m2,f,…] |
Table 3: 搜索架构 vs 基线(相同延迟)
| 模型 | 参数量 | Wiki PPL ↓ | CR Acc ↑ |
|---|---|---|---|
| SWA | 616M | 23.33 | 48.72% |
| GLA | 862M | 22.67 | 48.43% |
| DeltaNet | 852M | 20.90 | 50.38% |
| Mamba2+FFN | 889M | 21.43 | 50.04% |
| Searched (Ours) | 837M | 20.70 | 51.04% |
权重归一化
动机:训练后的权重矩阵存在非平滑性,某些维度权重幅度过大。
方法:将模型权重投影到单位范数球上。
效果:
Table 4: 权重归一化效果(1B模型)
| 模型 | 设置 | Wiki PPL ↓ | CR Acc ↑ |
|---|---|---|---|
| Llama 1B | w/o wnorm | 18.67 | 53.81% |
| w/ wnorm | 18.03 | 54.85% | |
| DeltaNet 1B | w/o wnorm | 18.86 | 53.46% |
| w/ wnorm | 18.19 | 54.39% | |
| Mamba2 1B | w/o wnorm | 18.44 | 53.30% |
| w/ wnorm | 17.88 | 54.71% |
关键发现:
- 一致性提升CR精度 +1.20%
- 平均降低PPL 0.66
Meta Tokens
作用:缓解注意力沉降现象,为线性注意力提供学习到的缓存初始化。
Table 5: Meta Tokens效果
| 模型 | Meta Token | Wiki PPL ↓ | CR Acc ↑ |
|---|---|---|---|
| Mamba2-48L-1B | w/o | 19.04 | 51.71% |
| w/ | 18.98 | 52.33% | |
| DeltaNet-48L-1B | w/o | 19.60 | 52.12% |
| w/ | 19.47 | 52.46% |
四、实验结果
Nemotron-Flash模型配置
Table 11: Nemotron-Flash配置
| 模型 | 参数量 | 深度 | 构建块 | 全注意力层 |
|---|---|---|---|---|
| Nemotron-Flash-1B | 0.96B | 12 | Block-1 + Block-2 | 2层 |
| Nemotron-Flash-3B | 2.7B | 18 | Block-1 + Block-2 | 3层 |
构建块:
- Block-1: DeltaNet-FFN-Mamba2-FFN
- Block-2: Attention-FFN-Mamba2-FFN
主要结果
Table 6: 与SOTA SLMs对比
| 模型 | 参数 | 延迟(s)↓ | 吞吐(tok/s)↑ | MMLU | CR | Math | Coding | Recall | Avg |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-0.6B | 0.6B | 27.55 | 160 | 52.44 | 48.91 | 36.88 | 24.32 | 62.92 | 44.11 |
| Nemotron-Flash-1B | 0.96B | 14.45 | 7289 | 44.63 | 54.46 | 34.86 | 37.91 | 67.11 | 49.63 |
| Qwen3-1.7B | 1.7B | 36.20 | 157 | 62.46 | 57.21 | 53.71 | 43.76 | 66.42 | 55.47 |
| Qwen2.5-3B | 3B | 49.40 | 459 | 65.56 | 58.88 | 53.83 | 49.46 | 73.03 | 58.96 |
| Nemotron-Flash-3B | 2.7B | 28.71 | 2939 | 61.19 | 61.02 | 57.62 | 53.33 | 73.25 | 60.98 |
关键结果:
- Nemotron-Flash-1B: 比Qwen3-0.6B精度+5.5%,延迟**1.9×降低,吞吐46×**提升
- Nemotron-Flash-3B: 比Qwen2.5-3B精度+2.0%,延迟**1.7×降低,吞吐6.4×**提升
- 在常识推理、数学、编码、召回任务上达到最高精度
指令微调结果
Table 7: Nemotron-Flash-3B-Instruct
| 模型 | 参数 | 延迟(s)↓ | 吞吐(tok/s)↑ | MMLU | GPQA | GSM8K | IFEval | Avg |
|---|---|---|---|---|---|---|---|---|
| Qwen2.5-1.5B | 1.5B | 34.50 | 687 | 59.73 | 30.13 | 56.03 | 46.78 | 48.17 |
| Qwen3-1.7B | 1.7B | 36.20 | 157 | 60.18 | 28.34 | 64.88 | 31.29 | 46.17 |
| Nemotron-Flash-3B | 2.7B | 28.71 | 2939 | 60.34 | 29.54 | 69.45 | 52.03 | 52.84 |
关键结果:
- 平均精度**+4.7%**
- 吞吐**4.3×/18.7×**高于Qwen2.5-1.5B/Qwen3-1.7B
注意力配置消融
Table 8: Nemotron-Flash-3B注意力配置
| 配置 | 延迟(s)↓ | 吞吐(tok/s)↑ | MMLU | CR | Math | Coding | Recall | Avg |
|---|---|---|---|---|---|---|---|---|
| 3FA | 28.71 | 2939 | 61.19 | 61.02 | 57.62 | 53.33 | 73.25 | 60.98 |
| 2FA+1SWA | 28.06 | 3737 | 61.02 | 60.93 | 58.56 | 51.82 | 73.37 | 60.69 |
| 1FA+2SWA | 27.95 | 4657 | 61.19 | 60.94 | 57.88 | 52.40 | 73.77 | 60.84 |
关键发现:
- 1FA+2SWA配置:吞吐提升1.6×,精度几乎不变
- 仅需2-3个全注意力层即可保持召回性能
与nGPT对比
Table 12: 权重归一化 vs nGPT
| 方法 | Wiki PPL ↓ | CR Acc ↑ |
|---|---|---|
| Baseline | 18.44 | 53.30% |
| Weight Norm (Ours) | 17.88 | 54.71% |
| nGPT | 17.71 | 54.29% |
关键发现:
- 权重归一化是nGPT的简化高效变体
- 关键在于权重归一化本身,而非激活归一化
五、核心创新
| 创新点 | 说明 | 效果 |
|---|---|---|
| 深度-宽度优化 | 增强缩放定律确定最优比例 | 避免深-窄陷阱 |
| 进化搜索框架 | 自动发现混合算子组合 | PPL降低0.74,CR+1.21% |
| 短训练代理 | 利用排名早期稳定特性 | 搜索效率提升50× |
| 权重归一化 | 投影到单位范数球 | CR+1.20%,PPL-0.66 |
| Meta Tokens | 缓解注意力沉降 | CR+0.62% |
| 混合架构 | DeltaNet+Mamba2+Attention | 兼顾效率和召回 |
六、与相关方法对比
| 方法 | 特点 | Nemotron-Flash优势 |
|---|---|---|
| MobileLLM | 深-窄设计 | 延迟优化更佳 |
| MiniCPM | 参数效率 | 真实设备加速更显著 |
| Qwen3 | 全注意力 | 更低延迟,更高吞吐 |
| Llama3.2 | 标准架构 | 混合架构更高效 |
| nGPT | 球面归一化 | 更简单,同等效果 |
七、局限性
- 长上下文限制:滑动窗口注意力限制了超长上下文能力
- 搜索成本:进化搜索需要大量GPU时间
- 硬件依赖:延迟测量依赖特定硬件和优化内核
- 全注意力层:仍需少量全注意力层保证召回
八、总结
核心贡献
- 延迟优化范式:从参数优化转向延迟优化
- 系统性方法论:深度-宽度、算子选择、训练策略三位一体
- 进化搜索:自动发现最优混合架构
- 权重归一化:简单有效的训练增强
- SOTA性能:Nemotron-Flash家族在延迟-精度权衡上领先
性能总结
| 模型 | 参数 | 延迟 | 吞吐 | 平均精度 |
|---|---|---|---|---|
| Nemotron-Flash-1B | 0.96B | 14.45s | 7289 tok/s | 49.63% |
| Nemotron-Flash-3B | 2.7B | 28.71s | 2939 tok/s | 60.98% |
| Nemotron-Flash-3B-Instruct | 2.7B | 28.71s | 2939 tok/s | 52.84% |
技术影响
Nemotron-Flash展示了延迟优先的SLM设计范式:
- 参数效率 ≠ 延迟效率:深-窄不一定最优
- 混合架构潜力:DeltaNet+Mamba2+Attention互补
- 搜索自动化:进化搜索可高效探索设计空间
- 训练增强:权重归一化简单有效
九、参考资源
- 论文: arXiv:2511.18890
- 模型: Nemotron-Flash-1B | 3B | 3B-Instruct
- 相关工作: