MobileVLA-R1: Reinforcing Vision-Language-Action for Mobile Robots
通过强化学习增强视觉-语言-动作框架,实现四足机器人的显式推理和连续控制
MobileVLA-R1: Reinforcing Vision-Language-Action for Mobile Robots
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MobileVLA-R1: Reinforcing Vision-Language-Action for Mobile Robots |
| 作者 | Ting Huang, Dongjian Li, Rui Yang, Zeyu Zhang, Zida Yang, Hao Tang |
| 论文 | https://arxiv.org/abs/2511.17889 |
| 发布 | 2025-11-22 |
| 代码 | https://github.com/MobileVLA-R1/MobileVLA-R1 |
| 网站 | https://mobilevla-r1.github.io |
二、核心思想
问题定义
四足机器人视觉-语言-动作(VLA)面临的核心挑战:
| 挑战 | 说明 |
|---|---|
| 语义-动作鸿沟 | 高层语义推理与低层电机控制难以桥接 |
| 推理不透明 | 缺乏可解释的推理结构 |
| 泛化能力弱 | 实际部署中稳定性和泛化性不足 |
解决方案概述
MobileVLA-R1 提出层级化推理-执行框架:
- Chain-of-Thought (CoT) 推理:生成结构化推理计划
- 两阶段训练:SFT对齐 + GRPO强化学习
- 连续控制:将推理转化为连续控制命令
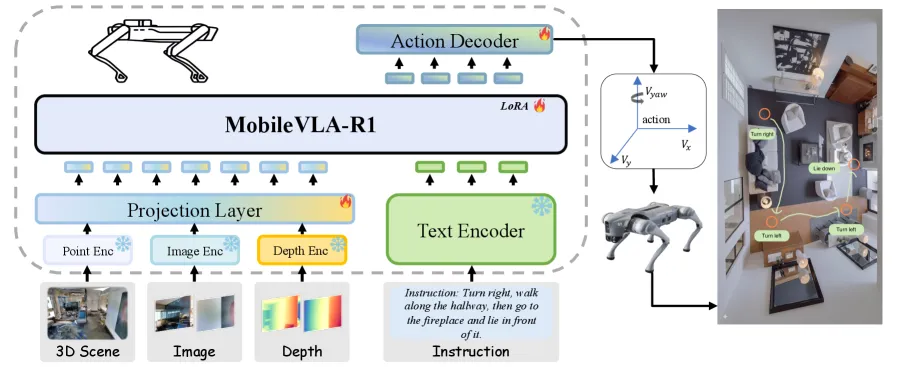
MobileVLA-R1架构:端到端框架,集成自然语言指令与多模态感知,通过CoT推理生成结构化动作计划
三、技术架构
整体框架
多模态输入 (RGB + Depth + Point Cloud)
          ↓
    视觉编码器 (DepthAnything V2 + Point Transformer v3)
          ↓
    多模态融合 (Projection Module)
          ↓
    LLaMA3-8B语言骨干
          ↓
    CoT推理生成 (<think>...</think>)
          ↓
    动作解码器 (连续速度 + 离散动作)
          ↓
    四足机器人控制
核心公式
策略映射:
其中:
- :x/y轴平移速度
- :偏航角速度
- :离散高层动作
GRPO目标函数:
其中 是归一化后的组内奖励。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| RGB编码器 | 视觉感知 | 从NaVILA初始化 |
| 深度编码器 | DepthAnything V2 | 3D几何感知 |
| 点云编码器 | Point Transformer v3 | 3D点云处理 |
| 语言骨干 | LLaMA3-8B | CoT推理生成 |
| 动作解码器 | 连续+离散动作 | 统一控制 |
训练流程
两阶段训练范式:
| 阶段 | 方法 | 数据 | 目标 |
|---|---|---|---|
| 冷启动 | SFT | MobileVLA-CoT (134K) | 格式对齐,初始化推理 |
| 强化学习 | GRPO | 在线采样 | 推理一致性,控制稳定性 |
LoRA配置:
- ,
- 仅训练投影层和注意力层
- 视觉编码器冻结
四、核心创新
| 创新点 | 说明 | 优势 |
|---|---|---|
| CoT数据引擎 | 使用Gemini生成多粒度推理标注 | 高质量推理监督 |
| 层级化推理 | 从高层推理到低层控制的显式映射 | 可解释性强 |
| GRPO强化学习 | 组内相对奖励优化 | 训练稳定,避免过更新 |
| 多模态融合 | RGB + Depth + Point Cloud | 3D感知增强 |
| 统一框架 | 导航+控制任务统一处理 | 通用性强 |
五、代码实现分析
数据集统计:
| 数据集 | 导航 | 控制 | CoT标注 | 规模 |
|---|---|---|---|---|
| R2R | ✓ | × | × | 50K |
| RxR | ✓ | × | × | 58 |
| QUARD | ✓ | ✓ | × | 262K |
| MobileVLA-CoT-Episode | × | ✓ | ✓ | 18K |
| MobileVLA-CoT-Step | × | ✓ | ✓ | 78K |
| MobileVLA-CoT-Nav | ✓ | × | ✓ | 38K |
CoT数据引擎流程:
- 输入:RGB-D观察 + 自然语言指令 + 状态-动作历史
- 模型:Gemini-2.5-Flash
- 输出:
<think>...</think>推理 +<answer>...</answer>动作 - 验证:规则过滤 + 人工检查
六、实验结果
VLN-CE导航任务
R2R-CE Val-Unseen结果:
| 方法 | NE↓ | OS↑ | SR↑ | SPL↑ |
|---|---|---|---|---|
| NaVILA | 5.22 | 62.5 | 54.0 | 49.0 |
| CorrectNav | 4.24 | 67.5 | 65.1 | 62.3 |
| MobileVLA-R1 | 4.05 | 69.7 | 68.3 | 65.2 |
RxR-CE Val-Unseen结果:
| 方法 | NE↓ | SR↑ | SPL↑ | nDTW↑ |
|---|---|---|---|---|
| NaVILA | 6.77 | 49.3 | 44.0 | 58.8 |
| CorrectNav | 4.09 | 69.3 | 63.3 | 75.2 |
| MobileVLA-R1 | 3.92 | 71.5 | 66.8 | 76.1 |
关键发现:
- MobileVLA-R1在VLN-CE任务上达到SOTA
- 相比CorrectNav,SR提升2.2%(R2R-CE)和3.4%(RxR-CE)
- 无需预训练路点预测器
QUARD四足控制任务
整体性能:
| 方法 | Easy | Medium | Hard | 平均 |
|---|---|---|---|---|
| CLIP | 0.44 | 0.35 | 0.00 | 0.25 |
| VC-1 | 0.46 | 0.38 | 0.00 | 0.28 |
| QUART | 0.66 | 0.49 | 0.22 | 0.44 |
| MoRE | 0.82 | 0.62 | 0.41 | 0.60 |
| MobileVLA-R1 | 0.92 | 0.75 | 0.51 | 0.73 |
详细任务结果:
| 任务 | 难度 | MoRE | MobileVLA-R1 | 提升 |
|---|---|---|---|---|
| Distinguish | Easy | 0.82 | 0.92 | +12.2% |
| Go to | Easy | 0.80 | 0.89 | +11.3% |
| Go avoid | Medium | 0.59 | 0.71 | +20.3% |
| Go through | Medium | 0.57 | 0.65 | +14.0% |
| Crawl | Hard | 0.49 | 0.58 | +18.4% |
| Unload | Hard | 0.33 | 0.44 | +33.3% |
关键发现:
- MobileVLA-R1在所有6个任务上均超越现有方法
- 平均提升21.7%,困难任务提升更大(Crawl +18.4%, Unload +33.3%)
- 证明推理对齐的控制在复杂任务中更有效
消融实验
训练阶段影响:
| 配置 | SR (R2R-CE) | SR (RxR-CE) | QUARD |
|---|---|---|---|
| SFT only | 65.1 | 68.2 | 0.68 |
| SFT + RL | 68.3 | 71.5 | 0.73 |
强化学习提升:
- VLN任务:SR提升3-4%
- QUARD任务:成功率提升7.4%
真实世界部署
硬件平台:
- 机器人:Unitree Go2四足机器人
- 计算:Jetson Orin Nano(车载PC)
- 传感器:L2 LiDAR + Intel RealSense D435i RGB-D相机
部署流程:
- RGB-D和3D点云数据传输到MobileVLA-R1
- 多模态推理和动作生成
- 速度和运动命令回传车载PC
- 实时执行
关键发现:
- 在杂乱和部分可观测条件下表现稳健
- 支持实时控制(低延迟推理)
- 无需额外仿真预训练
七、相关工作
视觉-语言导航
| 方法 | 特点 | 局限性 |
|---|---|---|
| NaVILA | VLN预训练 | 无显式推理 |
| CorrectNav | 纠错机制 | 推理不透明 |
| VLN-R1 | RL优化 | 缺乏结构化推理 |
四足控制
| 方法 | 特点 | 局限性 |
|---|---|---|
| QUART | 四足强化学习 | 无语言理解 |
| MoRE | 多模态表征 | 推理不显式 |
| VC-1 | 视觉控制 | 泛化能力弱 |
链式思维推理
- DeepSeek-R1:RL增强推理
- MobileVLA-R1创新:将CoT应用于具身控制
八、总结
核心贡献
- MobileVLA-R1框架:层级化推理-执行的VLA框架
- MobileVLA-CoT数据集:大规模多粒度CoT标注
- 两阶段训练:SFT对齐 + GRPO强化学习
- SOTA性能:VLN和四足控制任务均达到最优
技术影响
- 可解释性:显式推理过程便于调试和优化
- 泛化能力:跨任务、跨环境的稳健表现
- 实时部署:支持车载实时控制
- 通用框架:统一导航和控制任务
局限性
- 计算开销:多模态编码增加推理延迟
- 数据依赖:CoT数据生成需要大模型
- 硬件要求:需要LiDAR和深度相机
- 任务范围:主要验证于四足机器人,其他平台待探索
九、参考资源
论文
- 本文: https://arxiv.org/abs/2511.17889
- 代码: https://github.com/MobileVLA-R1/MobileVLA-R1
- 网站: https://mobilevla-r1.github.io
相关方法
- NaVILA: 具身VLN预训练
- CorrectNav: VLN纠错导航
- QUART: 四足强化学习
- MoRE: 多模态表征学习
- DeepSeek-R1: RL增强推理