Seer: Online Context Learning for Fast Synchronous LLM Reinforcement Learning
一种通过组感知上下文学习加速同步 LLM 强化学习 Rollout 的系统
Seer: Online Context Learning for Fast Synchronous LLM Reinforcement Learning
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Seer: Online Context Learning for Fast Synchronous LLM Reinforcement Learning |
| 作者 | Ruoyu Qin†♢, Weiran He†, Weixiao Huang†, Yangkun Zhang†, Yikai Zhao†, Bo Pang†, Xinran Xu†, Yingdi Shan♢, Yongwei Wu♢, Mingxing Zhang♢ |
| 机构 | † Moonshot AI, ♢ Tsinghua University |
| 论文 | arXiv:2511.14617 |
| 代码 | 未公开 |
| 发布 | 2025年11月 (v1), 2026年4月 (v3) |
| 领域 | 分布式并行计算 (cs.DC), 机器学习 (cs.LG) |
二、核心思想
问题定义
现代 LLM 强化学习 (RL) 训练中,Rollout 阶段占据了端到端迭代时间的 63%-87%(见 Table 1),存在两个核心瓶颈:
-
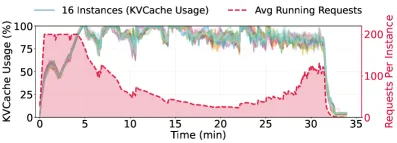
请求调度困境:长 CoT 推理任务导致 KVCache 内存从几乎为零增长到数 GB/请求,并发控制困难——高并发导致内存不足和抢占,低并发导致计算资源浪费。
-
严重长尾效应:输出长度呈重尾分布,Rollout 末尾仅少数超长请求仍在运行,大量加速器空闲。长尾阶段可占总 Rollout 时间的近 50%。
| 模型 | Rollout 占比 | Training 占比 | Weight Update 占比 |
|---|---|---|---|
| Moonlight (32GB) | 84% | 14% | 2% |
| Qwen2-VL-72B (146GB) | 63% | 31% | 6% |
| Kimi-K2 (1TB) | 87% | 10% | 3% |
解决方案概述
Seer 的核心观察:GRPO 算法中同一 prompt 组内的请求在输出长度和响应模式上具有强相似性。
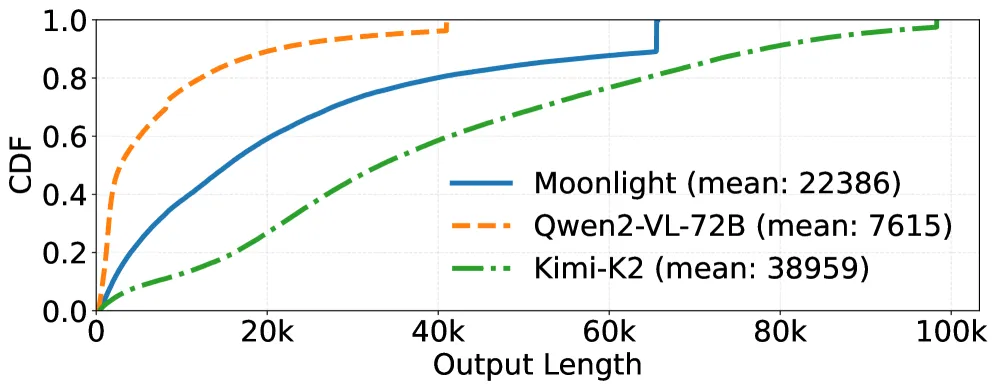
基于此观察,Seer 提出三个协同技术:
- Divided Rollout(分段 Rollout):将请求分解为可调度的小单元,实现细粒度负载均衡
- Context-Aware Scheduling(上下文感知调度):利用长度上下文近似最长任务优先调度
- Adaptive Grouped Speculative Decoding(自适应分组推测解码):利用分组模式上下文提升推测解码接受率
三、技术架构
整体框架图
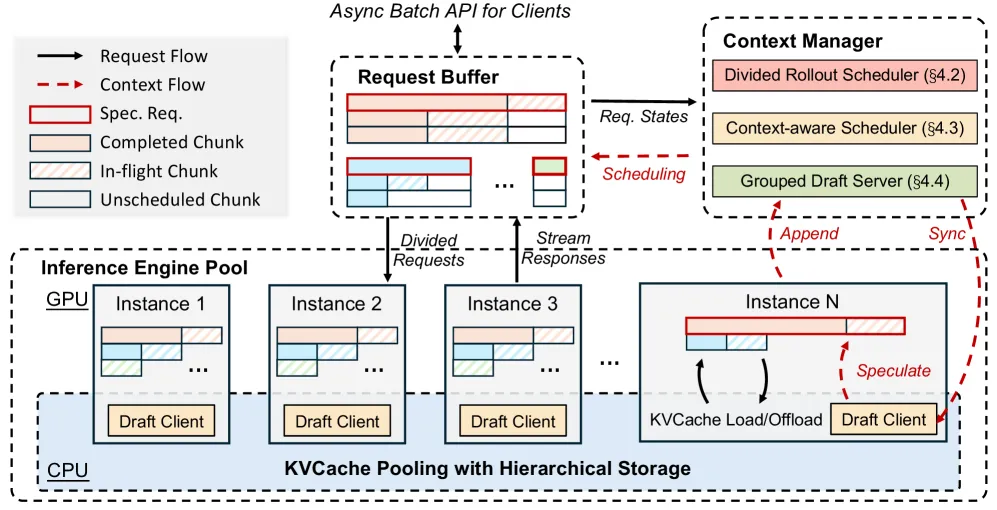
Seer 的 Rollout 子系统由三个紧密连接的组件组成:
| 组件 | 功能 | 关键特性 |
|---|---|---|
| Inference Engine Pool | 多模型服务实例 | 支持跨节点 KVCache 迁移,无需重计算 |
| Request Buffer | 全局请求视图 | 管理所有待处理和进行中的 Rollout 工作 |
| Global Scheduler | 全局调度器 | 基于上下文信息做出调度决策 |
训练使用 Megatron 进行分布式优化,Rollout 使用 vLLM 进行生成,奖励计算使用异步后端。
核心公式
推测解码吞吐量模型
设 为接受率(, 为每个位置的接受概率), 为草稿 token 数, 为当前 batch size, 为草稿模型前向时间, 为目标模型前向时间。
每次前向每个请求生成的期望 token 数:
推测解码生成每个 token 的期望时间:
推测解码获益条件:
- 当 较小时:,SD 明显获益
- 当 较大时: 不可忽略, 随 快速增长,SD 可能产生负收益
自适应推测长度策略 (MBA)
Algorithm 1 (Marginal-Benefit-Aware Adaptive Speculation) 根据离线 profiling 的 模型和在线收集的接受率与 batch size,动态确定高优先级和低优先级请求的草稿长度 。
三大核心技术详解
1. Divided Rollout(分段 Rollout)
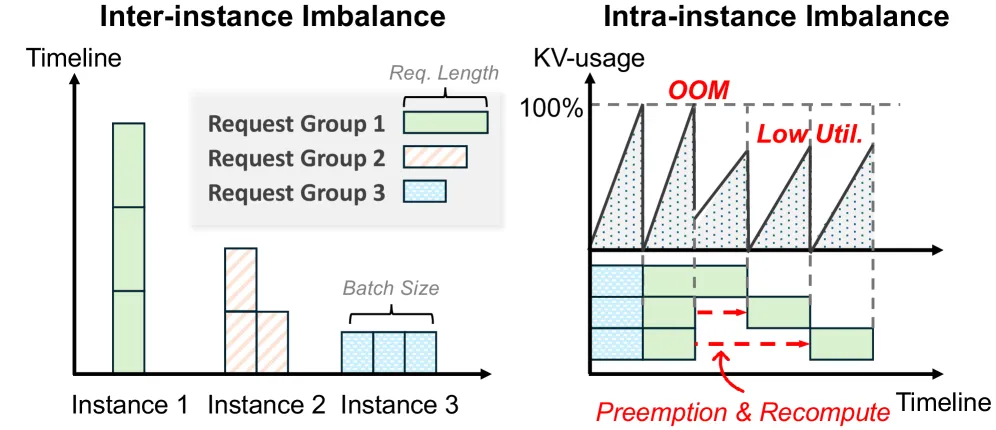
传统方法的问题:Group-level 调度将同一 prompt 组的所有请求作为不可分割单元,导致严重的实例间和实例内负载不均衡。
Seer 的方案:
- 不仅将请求组分解为独立请求,还进一步将每个请求分解为可调度的 chunk
- 基于 Mooncake 构建全局共享 KVCache 池,跨推理节点分布式存储
- 支持 RDMA 快速 KVCache 传输,chunk 调度可在全局范围内自由放置
关键创新:KVCache 迁移不再是被动的内存压力应对措施,而是主动的全局负载优化手段。
2. Context-Aware Scheduling(上下文感知调度)
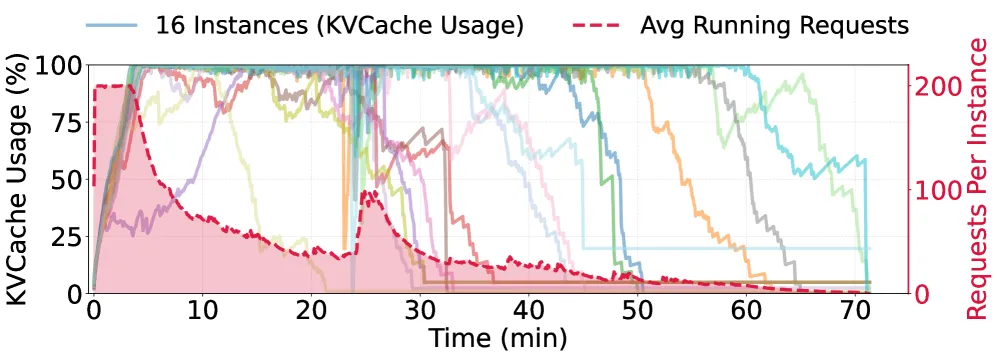
核心机制:
- 每个 GRPO 组指定一个推测请求 (speculative request) 作为在线探针
- 推测请求进入高优先路径,按最短任务优先 (SFS) 策略调度
- 通过观察推测请求的完成速度,推断同组其他请求的近似长度
- Context Manager 持续更新每组的估计输出长度(取已完成请求的最大生成长度)
调度流程:
- 推测请求优先执行,尽早收集长度信息
- Context Manager 维护并更新每组的估计输出长度
- 基于估计长度实现近似最长任务优先 (LFS) 调度
防护机制:偶尔调度未充分服务组的请求以避免饥饿,保守更新组长度估计。
3. Adaptive Grouped Speculative Decoding(自适应分组推测解码)
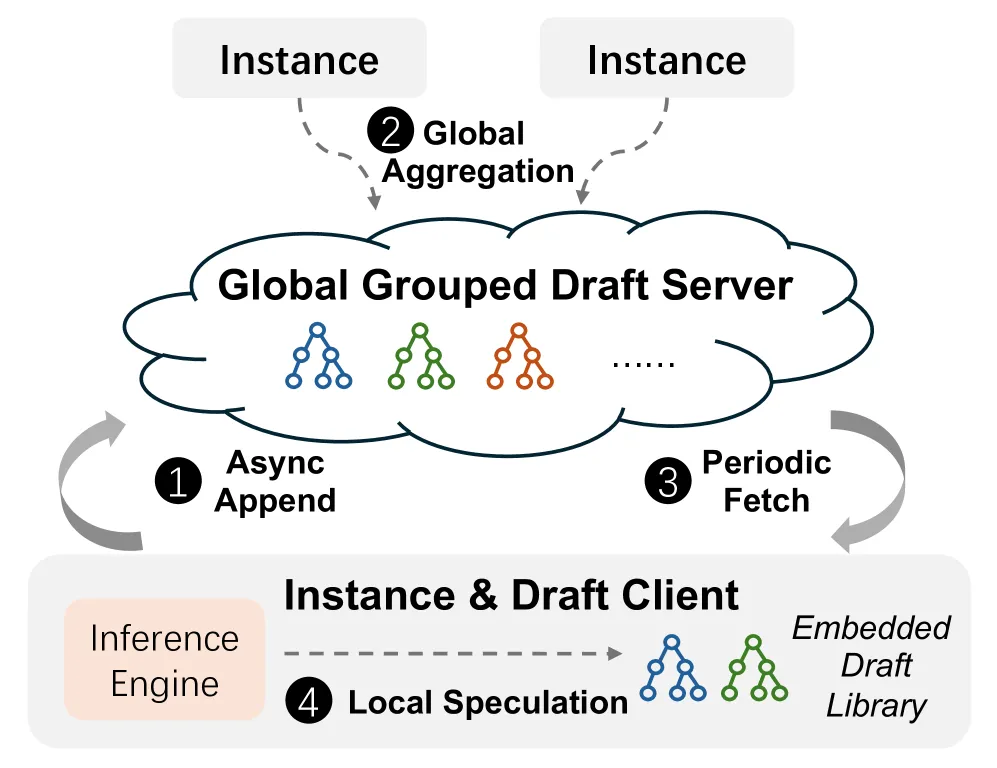
传统 SD 的问题:固定长度 SD 在 Rollout 场景中 batch size 动态变化(从数百到 1),无法同时优化资源利用。
Seer 的方案 - DGDS (Distributed Grouped Draft Server):
- 独立的草稿服务器,聚合跨请求和实例的响应模式上下文
- 异步分发上下文到每个推理实例内嵌的草稿客户端
- 核心数据结构:分组共享的 token 模式树 (Grouped Pattern Tree)
自适应策略:
- 根据当前 batch size 动态调整
- 高优先级推测请求和低优先级请求使用不同草稿长度
- 长尾阶段使用更大草稿长度 + 多路径推测解码进一步提升接受长度
消融实验结果
| 方法 | Moonlight | Qwen2-VL-72B | Kimi-K2 |
|---|---|---|---|
| Baseline | 1.00× | 1.00× | 1.00× |
| + Divided Rollout | 1.41× | 1.42× | 1.16× |
| + Context Sched. | 1.47× | 1.56× | 1.27× |
| + Grouped SD | 1.90× | 2.04× | 1.53× |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| Divided Rollout | 将请求分解为 chunk 级可调度单元,结合全局 KVCache 池实现主动负载均衡 | 内存受限任务吞吐量提升最高 42% |
| Context-Aware Scheduling | 利用 GRPO 组内长度相似性,通过推测请求在线预测输出长度 | 长尾延迟降低 89%(相比 baseline) |
| Adaptive Grouped SD | 分组共享模式树 + 动态草稿长度调整,解决传统 SD 在 Rollout 场景的接受率崩溃 | 相比 vanilla SD 吞吐量提升 13%-37% |
| Group-Aware Context Learning | 统一框架:将组内共享属性(长度相似性、模式相似性)转化为调度和解码信号 | 端到端吞吐量提升 44%-104% |
五、实验结果
实验配置
| 指标 | Moonlight | Qwen2-VL-72B | Kimi-K2 |
|---|---|---|---|
| 模型大小 | 32 GB | 146 GB | 1 TB |
| 总 GPU 数 | 32 | 128 | 256 |
| 每实例 GPU 数 | 1 | 8 | 32 |
| 每迭代请求数 | 3200 | 9600 | 6400 |
| Group Size | 8 | 16 | 8 |
| 温度 | 1.0 | 0.8 | 1.0 |
| 最大生成长度 | 65536 | 40960 | 98304 |
| 平均生成长度 | 22386 | 7615 | 38959 |
基础设施:32 个高性能计算节点,每节点 8×H800 GPU、224 CPU 核心、2TB DRAM、4TB NVMe 存储。
端到端性能
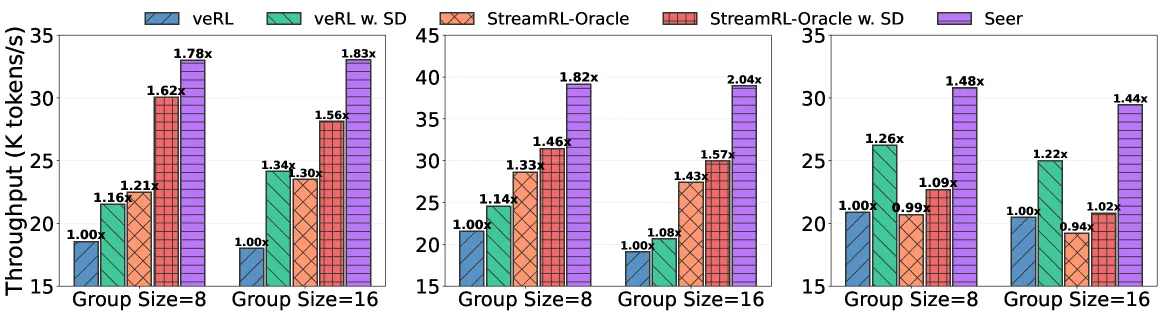
- Seer 在所有任务上一致地实现显著加速
- 吞吐量提升范围:44% - 104%(相比 veRL)
- 最高达到 2.04× 端到端 Rollout 吞吐量提升
长尾延迟分析
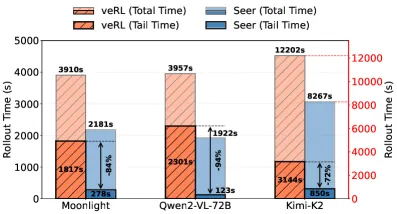
- 长尾延迟降低 72% - 94%
- 长尾阶段占总 Rollout 时间的近 50%(baseline)
- Seer 显著缩短长尾阶段持续时间
推测解码策略对比
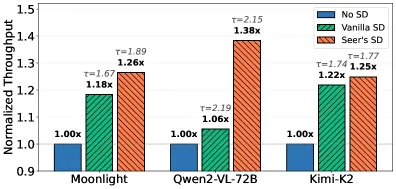
- 自适应分组 SD 在所有任务上一致优于 vanilla SD
- 吞吐量提升 13%-37%
- 平均接受长度 (τ) 显著提高
与非严格同步 RL 对比
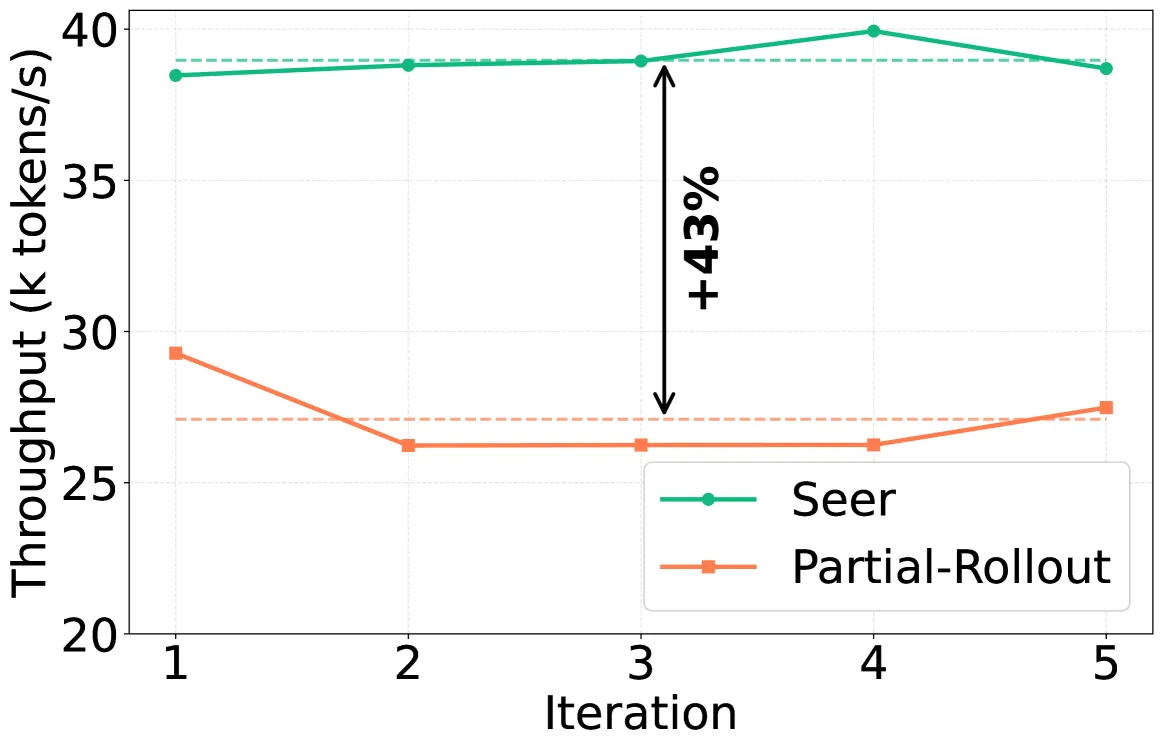
- Seer 比 Partial Rollout 吞吐量高 43%
- 优势来源:内存受限场景下 Partial Rollout 加剧抢占问题 + 自适应分组 SD 进一步提升吞吐
六、相关工作
RL 框架
- veRL (Sheng et al., 2025): 同步 RL 系统,支持高效的训练-Rollout 协同部署
- StreamRL (Zhong et al., 2025): 解耦异步 RL 框架,提出偏度感知调度
- Areal (Fu et al., 2025), AsyncFlow (Han et al., 2025), Laminar (Sheng et al., 2025): 异步 RL 方法
推测解码
- SuffixDecoding (Oliaro et al., 2025): 基于后缀树的 SD
- EAGLE 系列 (Li et al., 2024-2025): 基于特征的 SD
- Medusa (Cai et al., 2024): 多头预测 SD
长尾优化
- RollPacker (Gao et al., 2025), Partial Rollout (Zhou et al., 2025): 非严格同步方法
- Roll Flash (Lu et al., 2025): Prompt 复制方案
七、总结
核心贡献
- Divided Rollout:将请求分解为 chunk 级可调度单元,结合全局 KVCache 池实现主动式负载均衡,解决并发-内存困境
- Context-Aware Scheduling:利用 GRPO 组内长度相似性,通过推测请求在线预测输出长度,实现近似最长任务优先调度
- Adaptive Grouped Speculative Decoding:分布式分组草稿服务器 (DGDS) + 动态草稿长度调整,解决传统 SD 在 Rollout 场景的接受率崩溃问题
- 系统级验证:在 256 个 H800 GPU 上跨多个生产级 RL 工作负载验证,吞吐量提升最高 2.04×,长尾延迟降低 72%-94%
技术影响
- 证明了 GRPO 组内共享上下文信息的巨大潜力,为同步 RL 系统优化开辟新方向
- 提出了将 KVCache 迁移从被动应对转为主动优化的系统设计范式
- 为推测解码在动态 batch 场景的应用提供了理论和实践指导
局限性
- 论文未公开代码实现
- 实验仅在 Moonshot AI 内部工作负载上验证,未在公开 benchmark 上测试
- 依赖 GRPO 算法的组采样特性,对其他 RL 算法的适用性需进一步验证
- 全局 KVCache 池依赖 Mooncake 基础设施,部署门槛较高
八、参考资源
- 论文: arXiv:2511.14617
- HTML 版本: arXiv HTML
- 关键依赖: Mooncake (分布式 KVCache), vLLM, Megatron-LM
分析日期: 2026-06-04