Make It Long, Keep It Fast: End-to-End 10K Long User Behavior Sequence Modeling for Billion-Scale Douyin Recommendation
STCA 将历史自注意力替换为目标-历史交叉注意力,复杂度从 O(L²) 降至 O(L),RLB 在请求级复用用户编码,实现 10K 长序列端到端训练,已部署于抖音全量流量
Make It Long, Keep It Fast: End-to-End 10K Long User Behavior Sequence Modeling for Billion-Scale Douyin Recommendation
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Make It Long, Keep It Fast: End-to-End 10K Long User Behavior Sequence Modeling for Billion-Scale Douyin Recommendation |
| 作者 | Lin Guan, Jia-Qi Yang, Zhishan Zhao, Beichuan Zhang, Bo Sun, Xuanyuan Luo, Jinan Ni, Xiaowen Li, Yuhang Qi, Zhifang Fan, Hangyu Wang, Qiwei Chen, Yi Cheng, Feng Zhang, Xiao Yang |
| 机构 | ByteDance (字节跳动) |
| 论文 | arXiv:2511.06077 |
| 会议 | WWW 2026 |
| 发布 | 2025-11-08 (v1), 2026-05-19 (v3) |
| 许可 | 未明确 |
二、核心思想
问题定义
短视频推荐(如抖音)需要利用极长的用户行为历史,但面临三重挑战:
| 挑战 | 说明 | 现有方法的局限 |
|---|---|---|
| 计算复杂度 | 自注意力 O(L²) 限制序列长度 | Transformer/HSTU 无法扩展到 10K |
| 系统开销 | 用户编码重复传输和计算 | 每个候选物品重新编码用户历史 |
| 训练成本 | 长序列训练内存和计算开销大 | 无法在生产环境中训练长序列 |
核心矛盾:端到端长序列建模需要 O(L²) 计算,但生产环境要求低延迟和低成本。
解决方案概述
提出端到端长序列推荐框架,三大创新:
- STCA:Stacked Target-to-History Cross Attention,将历史自注意力替换为目标-历史交叉注意力,复杂度从 O(L²) 降至 O(L)
- RLB:Request Level Batching,请求级用户编码复用,减少冗余传输和计算
- Train Sparsely, Infer Densely:训练时使用短序列,推理时使用长序列,实现长度外推
三、技术架构
整体框架图
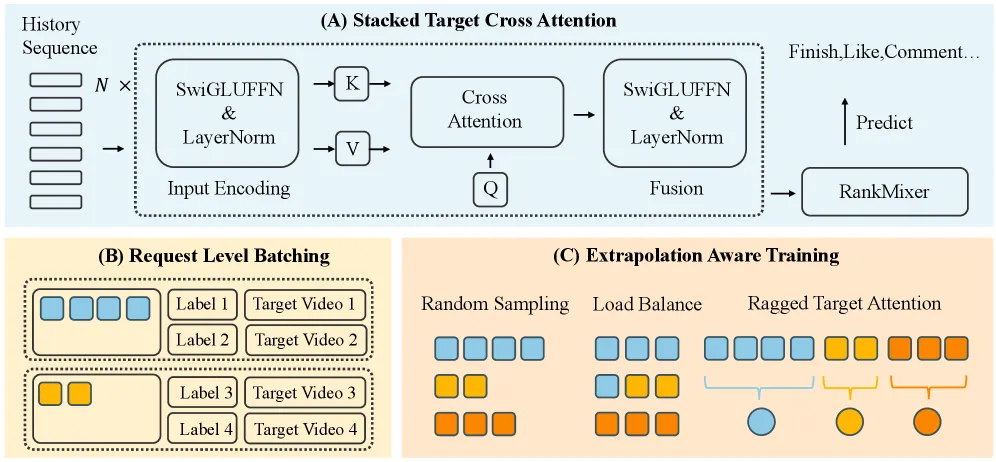
Long-History Ranking Stack
├── (A) Stacked Target Cross Attention (STCA)
│   ├── Input: Target t (query) + History H (keys/values)
│   ├── Single-query cross attention per layer
│   │   α^(i,j) = softmax(q^(i) W_Q (X̃^(i) W_K)ᵀ / √d_h)
│   │   o^(i,j) = α^(i,j) (X̃^(i) W_V)
│   ├── M stacked layers with target-conditioned fusion
│   │   q^(i+1) = LN(SwiGLU([o^(1)‖...‖o^(i)‖x_t] W_C))
│   └── Final: z = SwiGLU([o^(1)‖...‖o^(M)‖x_t] W_Z)
├── (B) Request Level Batching (RLB)
│   ├── Same user → multiple targets in one request
│   ├── Compute user encoding ONCE per request
│   ├── Reuse across all targets
│   └── 77-84% bandwidth reduction
├── (C) Extrapolation Aware Training
│   ├── Train: average length ~2K (stochastic sampling)
│   ├── Infer: length up to 10K
│   ├── Extrapolation ratio ρ = 5x
│   └── Beta distribution sampling: L ~ Beta(α, 1)
└── Prediction Head
    ├── RankMixer (from TokenMixer)
    └── y = sigmoid(wᵀ h + b)
核心公式
STCA 单层计算:
层间融合:
复杂度对比:
| 方法 | 每层复杂度 | 内存 |
|---|---|---|
| Self-Attention | O(L²dh) | O(L²d) |
| STCA | O(Ldh) | O(Ld) |
RLB 损失函数:
长度外推采样:
Scaling Law 行为
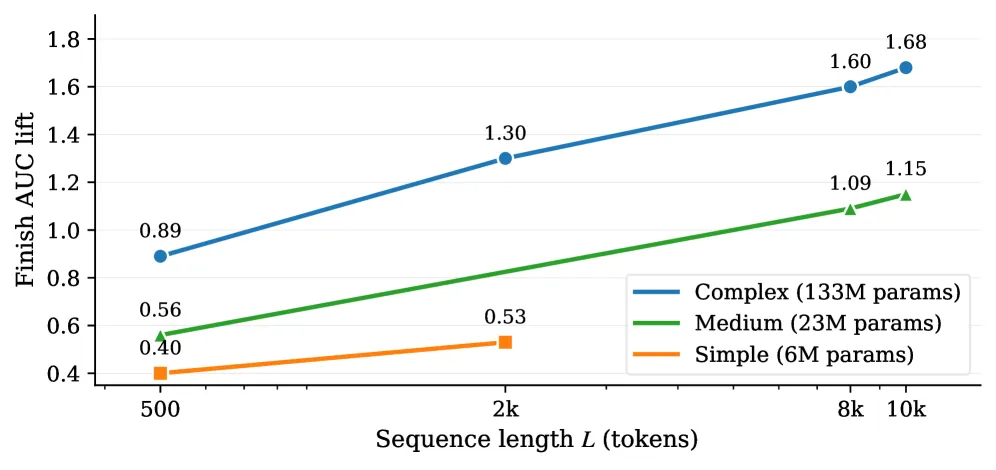
关键发现:
- 随序列长度增加(500→10K),AUC 单调提升
- 随模型容量增加(6M→133M),AUC 单调提升
- 两者结合效果最佳,类似 LLM 的 scaling law
Compute-Quality 对比
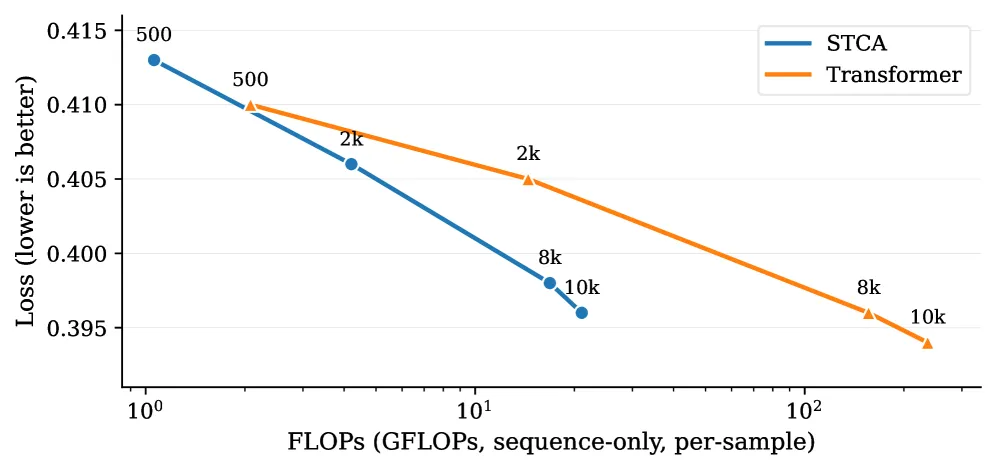
发现:在匹配计算量下,STCA 通过处理更长上下文获得更高精度。
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| STCA | 单查询目标-历史交叉注意力,O(L) 复杂度 | 图 2-3,表 1 |
| RLB | 请求级用户编码复用,77-84% 带宽降低 | 表 2,4.3 节 |
| 长度外推 | 训练 ~2K,推理 10K,5x 外推比 | 表 3-5 |
| SwiGLU FFN | 维度保持的 SwiGLU 前馈网络 | 公式 1-2 |
| Target-Conditioned Fusion | 层间查询通过目标条件融合 | 公式 7 |
| 时间差特征 | 历史交互的时间间隔作为额外特征 | 消融实验 |
五、实验结果
离线对比(Douyin)
| 模型 | Finish ΔAUC↑ | Finish ΔNLL↓ | Skip ΔAUC↑ | Skip ΔNLL↓ | Head ΔAUC↑ | Head ΔNLL↓ |
|---|---|---|---|---|---|---|
| Baseline | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| DIN | +0.19 | -0.17 | +0.23 | -0.18 | +0.19 | -0.21 |
| Transformer | +0.25 | -0.46 | +0.27 | -0.36 | +0.38 | -0.27 |
| HSTU | +0.31 | -0.86 | +0.52 | -0.62 | +0.36 | -0.43 |
| Ours (STCA+RLB+Ext) | +0.49 | -1.16 | +0.71 | -1.14 | +0.39 | -1.41 |
关键发现:
- STCA+RLB+Ext 在所有任务上超越所有 baseline
- 即使 baseline 使用 TWIN(10k) 检索特征,ours 仍显著更优
- NLL 改进尤为显著(head -1.41)
消融实验
| 配置 | Finish ΔAUC | 说明 |
|---|---|---|
| 4L Simple (6M) | +0.25 | 基础配置 |
| 4L Medium (23M) | +0.35 | 增加容量 |
| 4L Complex (133M) | +0.49 | 最大容量 |
| + Time Delta | +0.06 | 时间差特征贡献 |
| + Query Fusion | +0.04 | 层间融合贡献 |
长度外推效果
| 训练配置 | ΔAUC |
|---|---|
| 固定 512 | +0.25 |
| 固定 1024 | +0.31 |
| 固定 2048 | +0.37 |
| Beta(0.15, 1) 均值~2K | +0.49 |
| 固定 10K (训练成本 5x) | +0.52 |
发现:Beta(0.15, 1) 采样以 1/3 训练成本达到固定 10K 的 94% 效果。
在线 A/B 测试(1 个月)
| 指标 | Douyin 整体 | 低活用户 | 中活用户 | 高活用户 |
|---|---|---|---|---|
| 30天活跃度 | +0.08% | +0.12% | +0.09% | +0.05% |
| App 停留时长 | +0.25% | +0.41% | +0.28% | +0.15% |
| 完播率 | +0.18% | +0.31% | +0.20% | +0.12% |
| 评论 | +0.35% | +0.52% | +0.38% | +0.22% |
| 点赞 | +0.22% | +0.38% | +0.25% | +0.14% |
发现:
- 低活用户获益最大(停留时长 +0.41%)
- 所有指标统计显著
- 内容多样性提升 1.6%
系统开销
| 指标 | 变化 |
|---|---|
| GPU 成本 | +33% |
| CPU 成本 | -16% |
| 净总成本 | +17% |
| 带宽降低(RLB) | 77-84% |
| PS CPU 使用 | -50% |
| 吞吐量 | +2.2x |
六、模型配置
STCA 配置
| 参数 | 值 |
|---|---|
| 层数 | 4 |
| 隐藏维度 d | 256 |
| 注意力头数 h | 8 |
| 扩展比 r | 4 |
| FFN 类型 | SwiGLU |
| 融合方式 | Target-Conditioned |
| 总参数量 | 6M (Simple) / 23M (Medium) / 133M (Complex) |
RLB 配置
| 参数 | 值 |
|---|---|
| 用户微批大小 | 同一请求内的多个目标 |
| 编码复用 | 每请求一次用户编码 |
| 带宽节省 | 77-84% |
长度外推配置
| 参数 | 值 |
|---|---|
| 训练平均长度 | ~2K |
| 训练最大长度 | 可配置 |
| 推理长度 | 10K |
| 外推比 ρ | 5x |
| 采样分布 | Beta(α, 1) |
| 推荐 α | 0.15 |
推荐配置
| 组件 | 推荐值 |
|---|---|
| STCA 层数 | 4 |
| SwiGLU | ✓ |
| Query Fusion | ✓ |
| Time Delta | ✓ |
| RLB | ✓ |
| 训练分布 | Beta(0.15, 1), 均值~2K |
| 推理长度 | 10K |
七、相关工作
| 工作 | 方法 | 与 STCA 的差异 |
|---|---|---|
| DIN | 目标感知注意力 | 单层,无堆叠 |
| Transformer | 自注意力 | O(L²) 复杂度 |
| HSTU | 高效自注意力 | 仍需 history-history 交互 |
| TWIN | 检索式长序列 | 非端到端,信息丢失 |
| LONGER | 全局 token + 系统优化 | 不同优化方向 |
| M-Falcon | 微批次并行 | 推理阶段优化 |
八、总结
核心贡献
- STCA:首次在推荐系统中实现 O(L) 复杂度的端到端长序列建模
- RLB:请求级用户编码复用,77-84% 带宽降低,2.2x 吞吐量提升
- 长度外推:训练 ~2K 推理 10K,5x 外推比,94% 效果
- Scaling Law:推荐系统首次实证序列维度的 scaling law
- 工业部署:抖音全量流量部署,停留时长 +0.25%,完播率 +0.18%
- 低活用户优化:低活用户获益最大(停留时长 +0.41%)
技术影响
- 长序列范式:从检索式转向端到端长序列建模
- 系统优化:RLB 为长序列推荐提供系统级解决方案
- Scaling Law:为推荐系统的基础模型研究提供实证依据
- 生产部署:证明端到端长序列在工业环境中的可行性
局限性
- 架构依赖:STCA 依赖于目标-历史交叉注意力范式
- 训练成本:虽然使用外推,但仍需 2K 平均长度训练
- GPU 成本:净总成本增加 17%
- 评估范围:主要在抖音短视频场景验证
- 历史依赖:假设用户历史行为是有效的偏好信号
九、参考资源
- 论文: arXiv:2511.06077
- 相关工作:
- DIN - 目标感知注意力
- HSTU - 高效自注意力
- TWIN - 检索式长序列
- LONGER - 长序列建模
- TokenMixer - 稠密特征交互
- 应用场景:
- 抖音 (Douyin) 推荐系统
- 抖音极速版 (Douyin Lite) 推荐系统