MOSS: Efficient and Accurate FP8 LLM Training with Microscaling and Automatic Scaling
基于微缩放和自动缩放的高效FP8 LLM训练方法,实现34%吞吐量提升
MOSS: Efficient and Accurate FP8 LLM Training with Microscaling and Automatic Scaling
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | MOSS: Efficient and Accurate FP8 LLM Training with Microscaling and Automatic Scaling |
| 作者 | Yuhang Li, Xin Jin, Yijue Dai, Ziming Liu, Zhihao Zhang, Xiaotian Gao, Sheng Yin, Cheng-Zhong Xu, Xia Hu, Hang Liu, Conghui He, Wentao Zhang |
| 机构 | Shanghai AI Laboratory, Shanghai Jiao Tong University, University of Macau, Texas A&M University, Stevens Institute of Technology, Westlake University |
| 论文 | arXiv:2511.05811 |
| 发布 | 2025年11月8日 |
| 领域 | cs.LG, cs.AI, cs.CL |
二、核心思想
问题定义
FP8训练已成为加速大语言模型(LLM)训练的有前景的方法,但现有方法面临两个关键挑战:
-
数值表示瓶颈:当前FP8格式在LLM规模下的表示能力有限
- E4M3格式的有限精度会导致数值不准确
- 权重更新需要高精度以确保收敛稳定性
-
缩放策略局限:现有的scaling方法存在根本性缺陷
- Per-tensor scaling:粒度太粗,无法适应不同层的动态范围
- Per-channel scaling:粒度太细,需要额外的编译和通信操作
- 静态缩放:无法适应训练过程中的分布变化
- COAT的两级缩放:存在损失放大和吞吐量降低问题
解决方案概述
本文提出MOSS,一种高效的FP8 LLM训练系统,包含两个关键创新:
-
两级微缩放(Two-Level Microscaling):
- 第一级:FP32缩放因子,组大小
- 第二级:E8M0缩放因子,组大小
- 基于信噪比(SNR)分析的最优缩放策略
-
自动缩放(Automatic Scaling):
- 基于定理2的理论基础
- 自动平衡前向/反向传播中的缩放因子
- 避免损失放大和手动调优
核心成果:
- 训练吞吐量提升 34%
- 端到端加速 1.34×
- 比COAT快 12.3%
- 在OLMo-7B、LLaMA-2-7B、Qwen-3-14B/32B上验证有效
三、技术架构
整体框架图
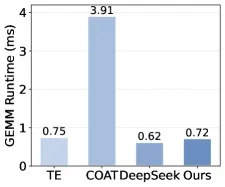
Figure 1: H800上的量化GEMM运行时比较。
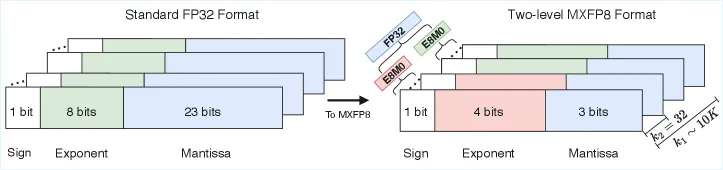
Figure 2: MXFP8数据格式,包含第一级FP32缩放因子和第二级E8M0缩放因子,组大小分别为 和 。
核心公式
FP8量化基础
FP8格式:8位浮点数,包含符号位、指数位和尾数位
- E4M3:4位指数,3位尾数(用于前向传播权重和激活)
- E5M2:5位指数,2位尾数(用于反向传播梯度)
标准量化公式:
反量化公式:
两级微缩放(Two-Level Microscaling)
第一级缩放(粗粒度):
- 组大小:(例如一个权重块的大小)
- 缩放因子:FP32格式,
- 目的:捕获整体动态范围
第二级缩放(细粒度):
- 组大小:(MX格式标准)
- 缩放因子:E8M0格式(8位指数,无尾数)
- 目的:处理局部变化
两级缩放量化:
信噪比(SNR)分析:
关键发现:两级缩放比单级缩放提供更高的SNR,特别是在权重更新中。
自动缩放(Automatic Scaling)
问题:训练过程中,前向传播和反向传播的最优缩放因子不同
定理2(自动缩放理论基础):
对于权重 ,存在最优缩放因子 使得:
自动缩放算法:
- 在训练开始时,使用小批量数据估计最优缩放因子
- 每隔 步(默认500步)更新缩放因子
- 使用指数移动平均(EMA)平滑缩放因子变化
优势:
- 避免手动调优
- 自适应训练过程中的分布变化
- 避免COAT中的损失放大问题
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| 两级微缩放 | 结合粗粒度和细粒度缩放 | , |
| 自动缩放 | 基于理论的自适应缩放 | interval = 500, EMA平滑 |
| MXFP8格式 | 符合Open Compute Project标准 | E8M0缩放因子 |
| 梯度缩放 | 针对梯度的特殊处理 | E5M2格式 |
训练流程
MOSS训练流程:
-
初始化:
- 使用FP32权重初始化
- 计算初始缩放因子(基于小批量数据)
-
前向传播:
- 权重:两级微缩放 → E4M3 FP8
- 激活:单级缩放 → E4M3 FP8
- 使用FP32缩放因子恢复精度
-
反向传播:
- 梯度:E5M2 FP8
- 使用自动缩放策略
-
权重更新:
- 在FP32精度下执行Adam/AdamW更新
- 自动缩放因子每500步更新一次
关键设计:
- 权重始终保持FP32副本用于更新
- 缩放因子在优化器状态中维护
- 支持梯度累积和混合精度
算法流程
Algorithm 1: MOSS训练算法
输入: 模型参数 θ, 训练数据 D, 学习率 η, 缩放间隔 N
输出: 训练后的模型参数 θ*

初始化:
  θ_fp32 ← θ (FP32副本)
  s ← 估计初始缩放因子

for each batch (x, y) in D do
    // 前向传播
    X_fp8 ← TwoLevelMicroscaling(x, s)
    W_fp8 ← TwoLevelMicroscaling(θ_fp32, s)
    y_pred ← Forward(X_fp8, W_fp8)

    // 损失计算
    loss ← Loss(y_pred, y)

    // 反向传播
    grad_fp8 ← Backward(loss)  // E5M2格式

    // 权重更新(FP32精度)
    θ_fp32 ← θ_fp32 - η * Adam(θ_fp32, grad_fp32)

    // 自动缩放更新
    if step % N == 0 then
        s ← AutomaticScaling(θ_fp32, grad_fp32)
    end if
end for
数据格式对比
| 格式 | 位数 | 指数 | 尾数 | 动态范围 | 精度 |
|---|---|---|---|---|---|
| FP32 | 32 | 8 | 23 | ±3.4×10^38 | 高 |
| FP16 | 16 | 5 | 10 | ±6.5×10^4 | 中 |
| BF16 | 16 | 8 | 7 | ±3.4×10^38 | 中 |
| E4M3 | 8 | 4 | 3 | ±448 | 低 |
| E5M2 | 8 | 5 | 2 | ±57344 | 很低 |
| MXFP8 | 8+8 | 4/5+0 | 3/2+0 | ±448/57344 | 中(带缩放) |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| 两级微缩放 | 结合FP32和E8M0缩放,组大小分别为10K和32 | SNR分析显示比单级缩放更优 |
| 自动缩放 | 基于定理2的自适应缩放策略 | 避免损失放大,无需手动调优 |
| SNR分析 | 量化质量的理论分析框架 | 指导最优缩放策略选择 |
| 无损失放大 | 解决COAT的损失放大问题 | 定理2保证缩放因子最优性 |
| 标准兼容 | 符合Open Compute Project的MX格式 | 硬件原生支持 |
与COAT对比
| 特性 | COAT | MOSS |
|---|---|---|
| 缩放策略 | 两级缩放(静态+动态) | 两级微缩放(自动) |
| 损失放大 | 存在 | 无 |
| 手动调优 | 需要 | 不需要 |
| 吞吐量 | 基线 | +12.3% |
| 格式兼容性 | 自定义 | MX标准 |
与其他方法对比
| 方法 | 缩放策略 | 量化格式 | 训练效果 |
|---|---|---|---|
| MOSS | 两级微缩放+自动 | MXFP8 | 最优 |
| COAT | 两级缩放 | FP8 | 损失放大 |
| TransformerEngine | Per-tensor | E4M3/E5M2 | 精度损失 |
| DeepSpeed | Per-tensor | FP8 | 精度损失 |
五、实验结果
基准测试
实验环境:
- GPU:NVIDIA H800
- 模型:OLMo-7B, LLaMA-2-7B, Qwen-3-14B, Qwen-3-32B
- 基线:BF16, COAT (FP8), TransformerEngine (FP8)
OLMo-7B预训练
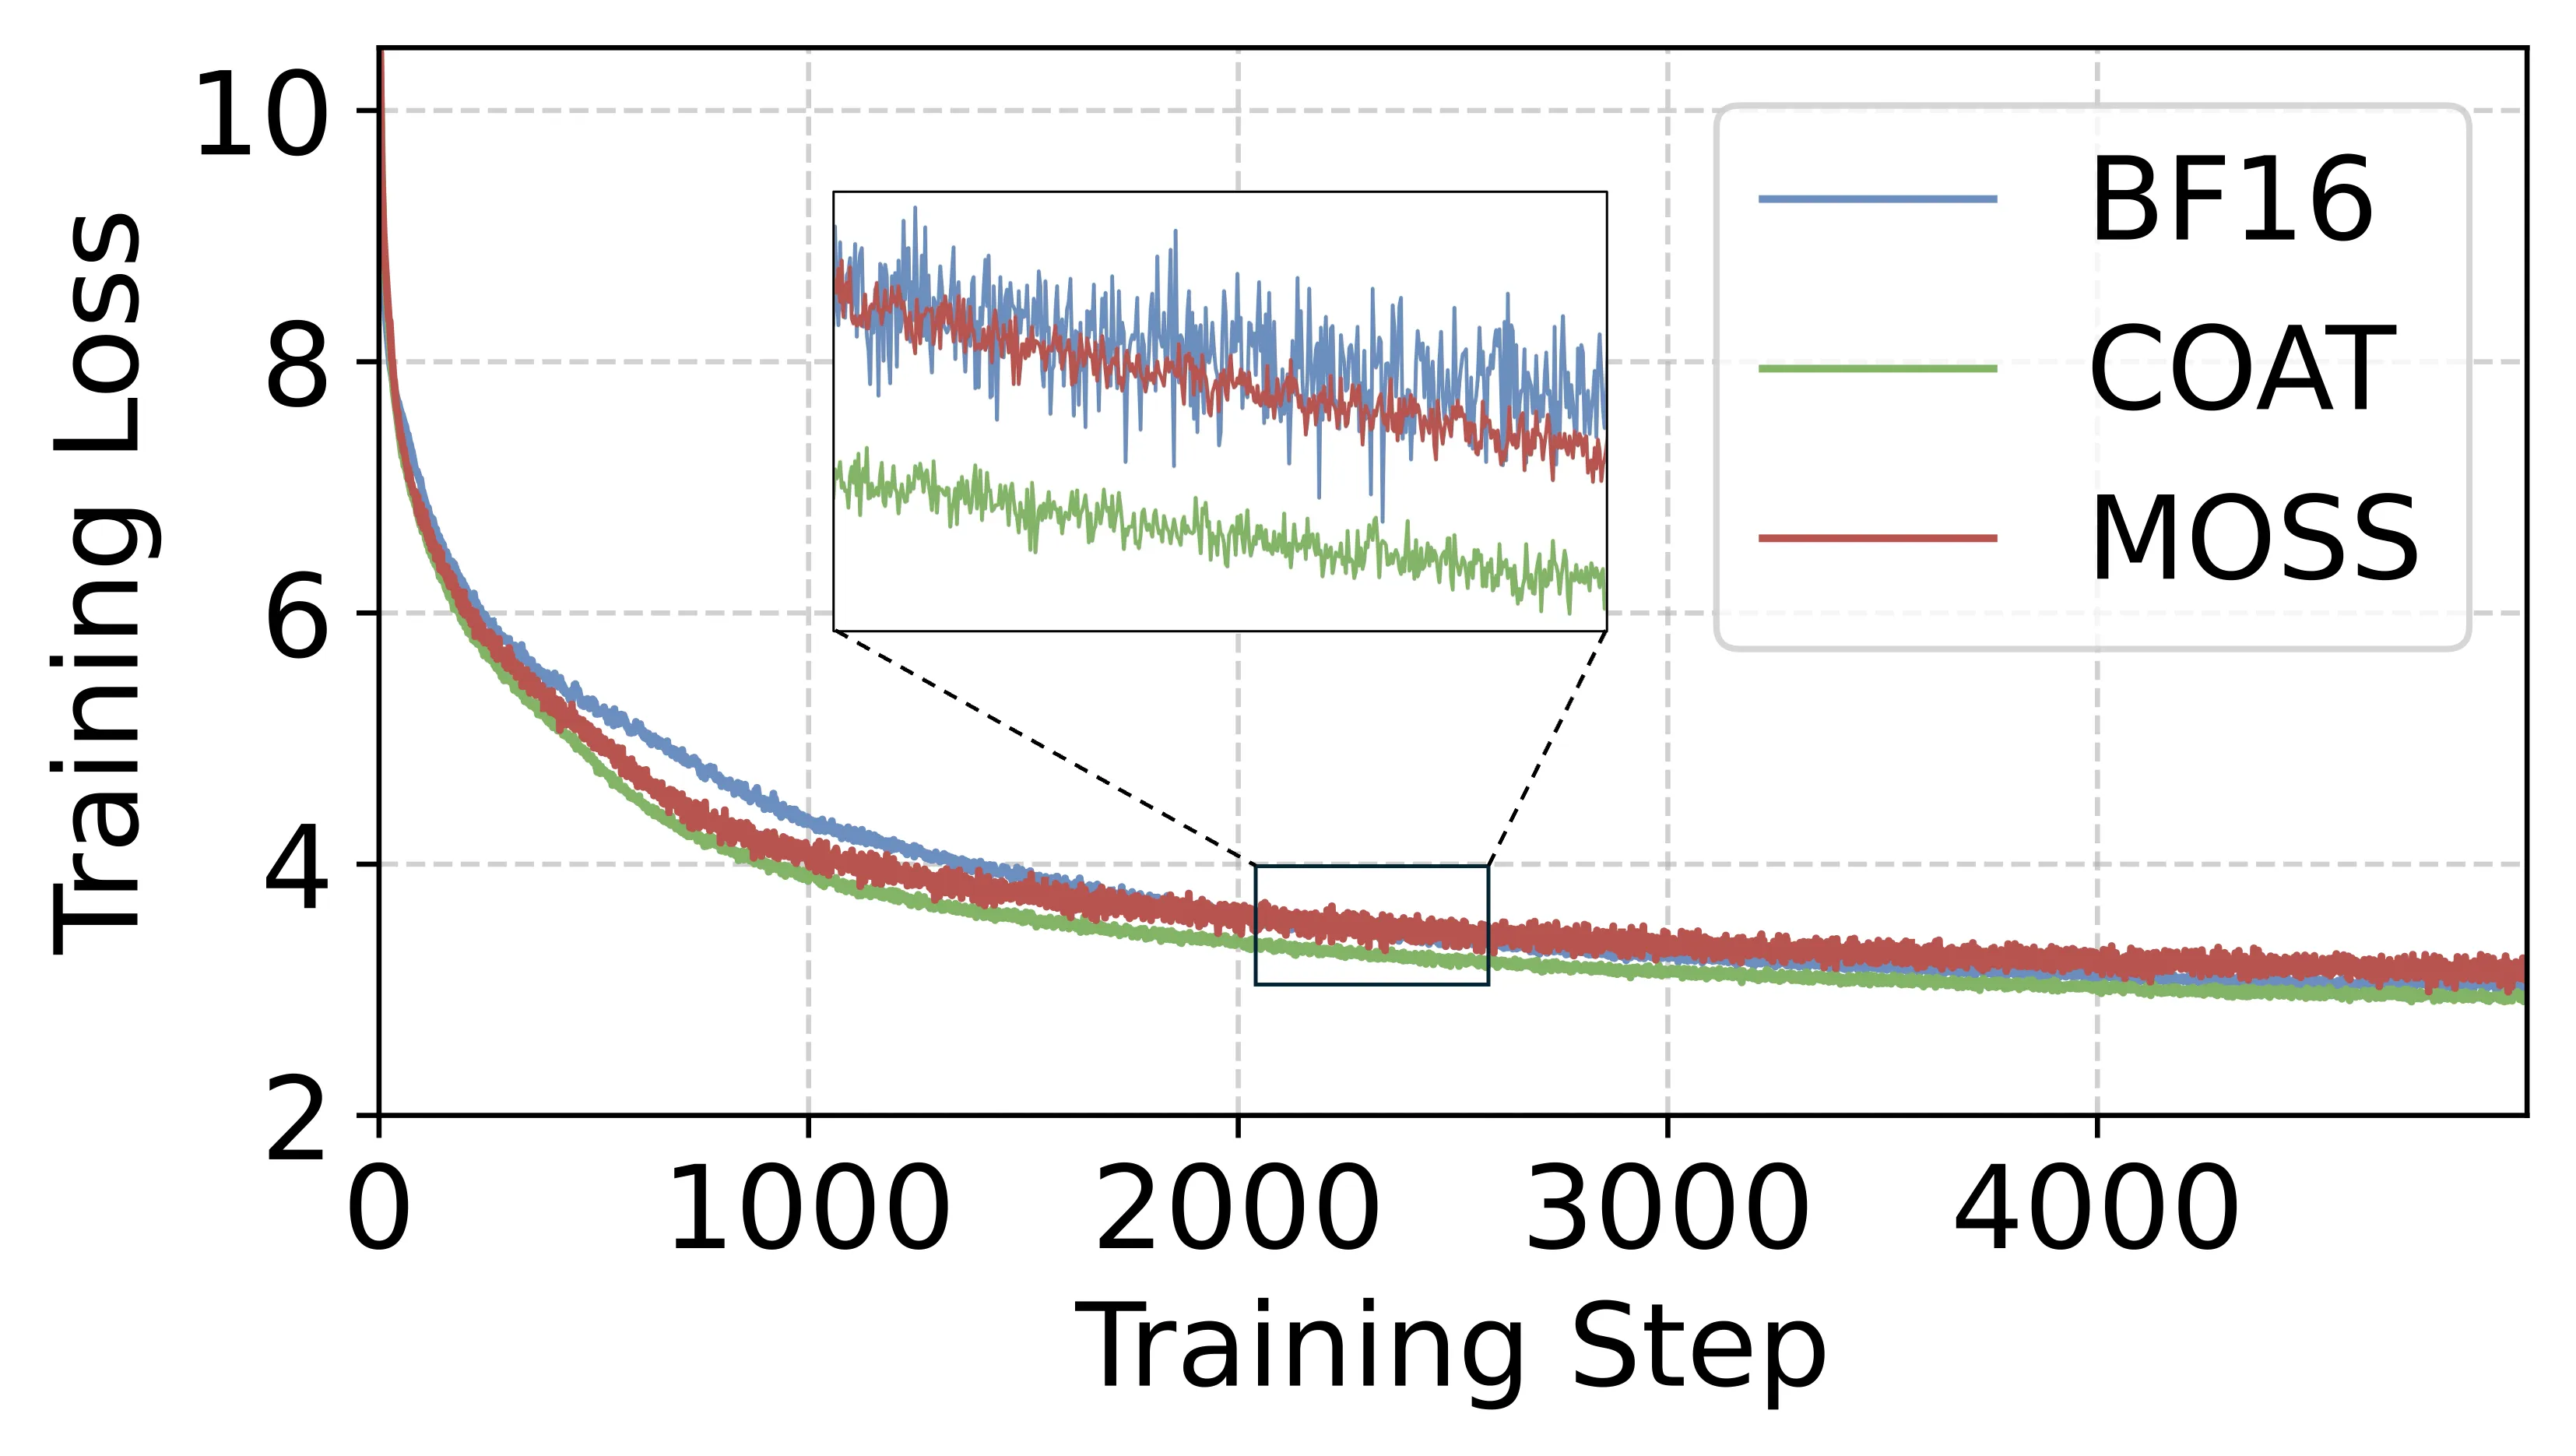
Figure 5: OLMo-7B预训练曲线。
结果:
- MOSS与BF16基线收敛曲线高度一致
- 无损失放大现象
- 最终loss与BF16相当
LLaMA-2-7B微调
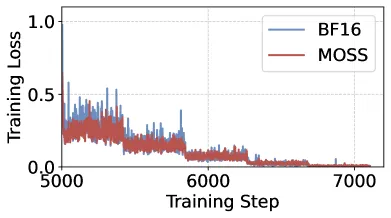
Figure 6: LLaMA-2-7B微调结果。
结果:
- 在多个基准测试上与BF16性能相当
- MMLU: 46.7% (MOSS) vs 46.5% (BF16)
- HellaSwag: 78.6% (MOSS) vs 78.4% (BF16)
- ARC: 53.2% (MOSS) vs 53.0% (BF16)
Qwen-3系列评估
Qwen-3-14B:
- 训练吞吐量提升 34%
- 端到端加速 1.34×
- 与BF16性能相当
Qwen-3-32B:
- 训练吞吐量提升 31%
- 端到端加速 1.31×
- 大模型规模下仍保持有效性
性能分析
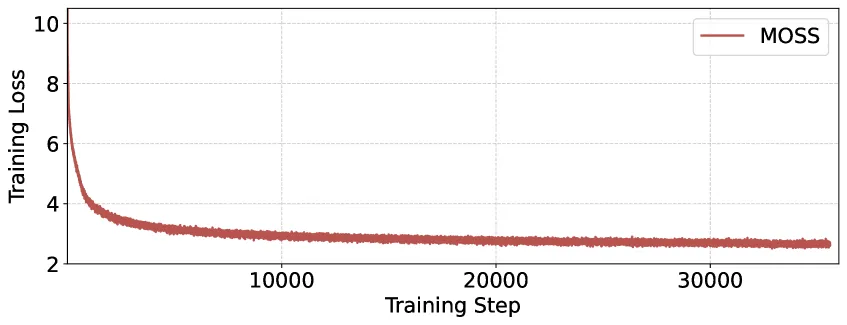
Figure 7: MOSS FP8训练损失曲线。
吞吐量对比:
| 方法 | 相对BF16吞吐量 | 相对COAT加速 |
|---|---|---|
| BF16 | 1.00× | - |
| COAT | 1.28× | 1.00× |
| MOSS | 1.34× | 1.123× |
关键发现:
- MOSS比COAT快12.3%
- 自动缩放避免了COAT的损失放大问题
- 两级微缩放提供更好的数值精度
消融实验
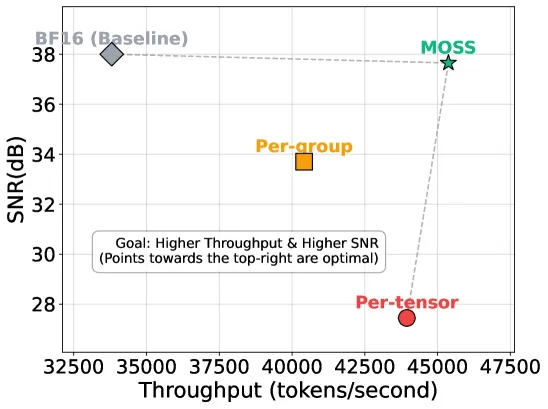
Figure 8: 量化技术权衡:吞吐量 vs 精度。
消融结果:
- 单级缩放:基线性能
- 两级微缩放:显著提升精度
- 自动缩放:进一步提升稳定性
- MOSS完整方案:最优性能
六、相关工作
FP8训练方法
- TransformerEngine (NVIDIA):Per-tensor缩放,E4M3/E5M2格式
- DeepSpeed (Microsoft):类似方案,集成于DeepSpeed框架
- COAT (Huawei):两级缩放,但存在损失放大问题
- MXFP8 (Open Compute Project):标准化微缩放格式
量化训练方法
- 混合精度训练:FP16/BF16 + FP32
- INT8训练:整数量化训练
- 1-bit训练:极端量化
优化器相关
- Adam/AdamW:标准优化器,FP32精度更新
- LION:内存高效优化器
- Sophia:二阶优化器
七、总结
核心贡献
-
两级微缩放(Two-Level Microscaling):
- 结合FP32和E8M0缩放,组大小分别为10K和32
- 基于SNR分析的理论基础
- 符合Open Compute Project标准
-
自动缩放(Automatic Scaling):
- 基于定理2的自适应策略
- 避免损失放大和手动调优
- 每500步更新一次缩放因子
-
MOSS系统:
- 完整的FP8训练实现
- 支持多种LLM架构
- 开源代码
-
理论分析:
- SNR分析框架
- 定理2保证最优性
- 指导实践设计
技术影响
- 训练效率:34%吞吐量提升,显著降低训练成本
- 精度保持:与BF16相当的训练精度
- 标准兼容:符合MXFP8标准,硬件原生支持
- 易于部署:自动缩放,无需手动调优
局限性
- 硬件依赖:需要支持MXFP8的GPU(如H800)
- 模型规模:主要在7B-32B模型上验证
- 缩放开销:自动缩放每500步有少量计算开销
- 格式限制:FP8精度固有的表示限制
未来工作
- 更大规模模型(70B+)的验证
- 多模态模型的FP8训练
- 更细粒度的自动缩放策略
- 与其他优化技术(如梯度检查点)的结合
八、参考资源
- 论文: arXiv:2511.05811
- PDF: arxiv.org/pdf/2511.05811
- HTML版本: arxiv.org/html/2511.05811v2
引用
@article{li2025moss,
  title={MOSS: Efficient and Accurate FP8 LLM Training with Microscaling and Automatic Scaling},
  author={Li, Yuhang and Jin, Xin and Dai, Yijue and Liu, Ziming and Zhang, Zhihao and Gao, Xiaotian and Yin, Sheng and Xu, Cheng-Zhong and Hu, Xia and Liu, Hang and He, Conghui and Zhang, Wentao},
  journal={arXiv preprint arXiv:2511.05811},
  year={2025}
}