Scalable Processing-Near-Memory for 1M-Token LLM Inference
CXL-Enabled KV-Cache Management Beyond GPU Limits
Scalable Processing-Near-Memory for 1M-Token LLM Inference: CXL-Enabled KV-Cache Management Beyond GPU Limits
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | Scalable Processing-Near-Memory for 1M-Token LLM Inference: CXL-Enabled KV-Cache Management Beyond GPU Limits |
| 作者 | Dowon Kim, MinJae Lee, Janghyeon Kim, HyuckSung Kwon, Hyeonggyu Jeong, Sang-Soo Park, Minyong Yoon, Si-Dong Roh, Yongsuk Kwon, Jinin So, Jungwook Choi |
| 机构 | Samsung Memory Research Center (SMRC), 韩国 |
| 论文 | arXiv:2511.00321 |
| 代码 | 无公开代码 |
| 发布 | 2025-10-31 |
| 许可 | arXiv 非独占分发许可 |
二、核心思想
随着大语言模型(LLM)上下文窗口扩展到百万级 token,KV 缓存的内存和计算瓶颈成为推理系统的核心挑战。传统 GPU 内存容量和带宽增长停滞,无法满足超长上下文推理需求。
本文提出基于 CXL(Compute Express Link)的近内存处理(Processing-Near-Memory, PNM)架构,将 KV 缓存管理和注意力计算完全卸载到 CXL 内存端的专用加速器上,从根本上消除 GPU 与外部内存之间的数据召回开销,实现百万 token 级 LLM 推理的可扩展性。
问题定义
- GPU 内存容量限制:随着上下文长度增加,KV 缓存占用 GPU 内存,导致可用 batch size 急剧下降,GPU 利用率低
- 数据召回开销:非驱逐式 KV 缓存管理(如 ArkVale)将完整 KV 缓存保留在外部内存,但召回非驻留 token 产生高昂的数据传输开销
- 扩展性瓶颈:随着序列长度从 64K 增加到 320K,每层平均召回次数稳步上升,召回开销占 FC + 注意力延迟的比例显著增加
解决方案概述
PNM-KV:将 KV 缓存管理和注意力计算完全卸载到 CXL-PNM 加速器,GPU 仅负责 FC 计算 PnG-KV:GPU-PNM 混合执行,通过稳态 token 选择(Steady Selection)在 GPU 和 PNM 之间分配注意力计算,负载均衡
三、技术架构
整体框架图
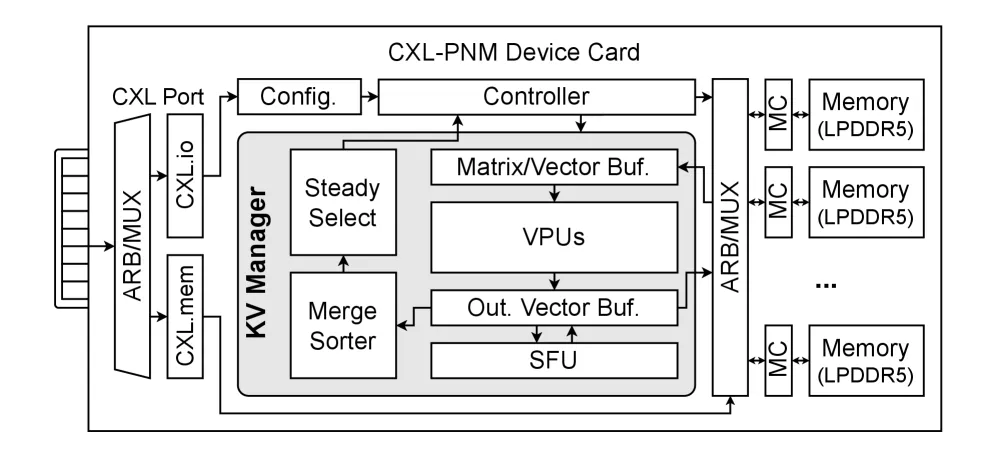
CXL-PNM 系统架构基于 LPDDR5X CXL-PNM 模块,集成专用 KV 缓存管理组件,位于 CXL 协议栈和 LPDDR5X 内存控制器之间。
核心公式
注意力计算卸载:
上下文长度无关的数据传输:
传输量仅取决于 batch size 和隐藏维度,与上下文长度无关,确保超长上下文推理的可扩展性。
模型组件
| 组件 | 说明 | 关键参数 |
|---|---|---|
| VPU (Vector Processing Unit) | 可重构向量处理单元,支持 GEMV、Digest 生成、Score 估计三种模式 | 128 宽乘法器阵列,128 宽比较器阵列,64 长加法树 |
| Top-K Sorter | 并行归并排序,快速提取 Top-K token page 评分 | 硬件加速排序 |
| SFU (Special Functional Unit) | 支持 softmax 近内存执行 | 乘法器/加法器阵列 + LUT 指数/倒数单元 |
| DMA Engine | 高带宽数据传输 | 1 MB 缓冲区 |
| On-chip Buffer | 片上缓冲 | 2.25 MB |
控制机制
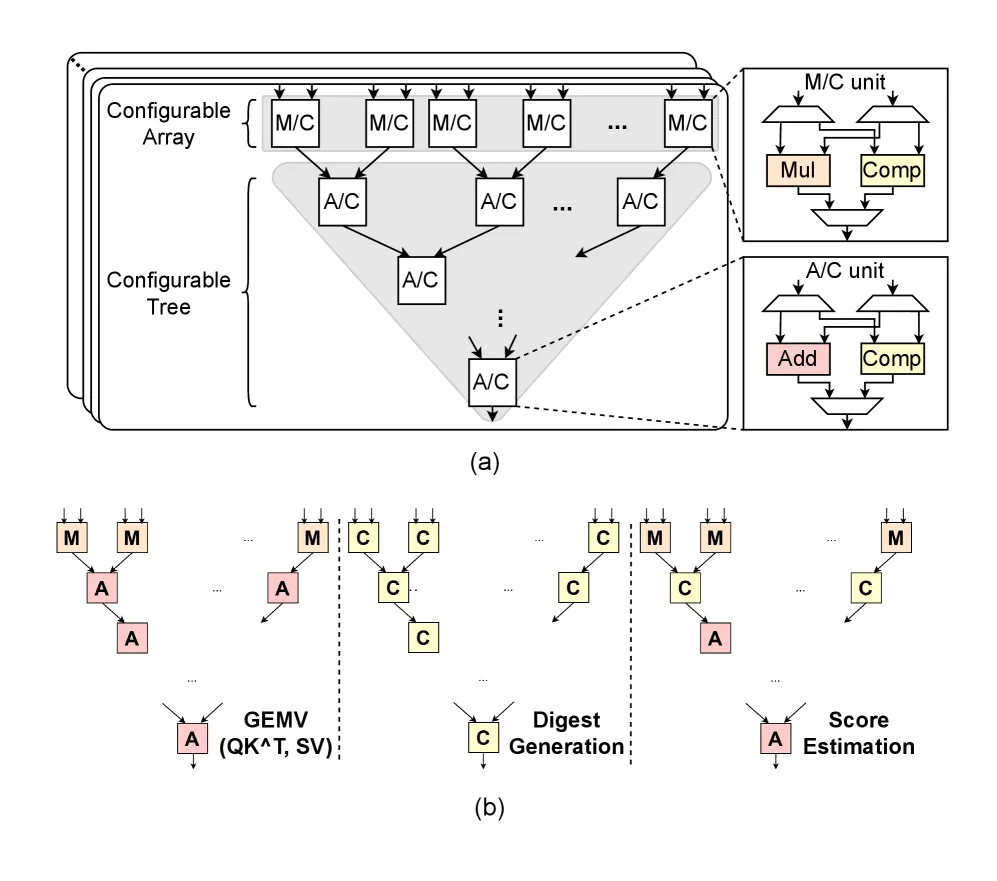
三种 KV 缓存管理模式:
- GEMV 模式:注意力计算( 和 ),顶部配置为乘法器(M),底部为加法器(A)
- Digest 生成模式:页面摘要生成(min/max 比较),顶部和底部均为比较器(C)
- Score 估计模式:页面重要性评分(内积运算),顶部比较器(C)选择 min/max 向量中较高的结果
工作负载分区
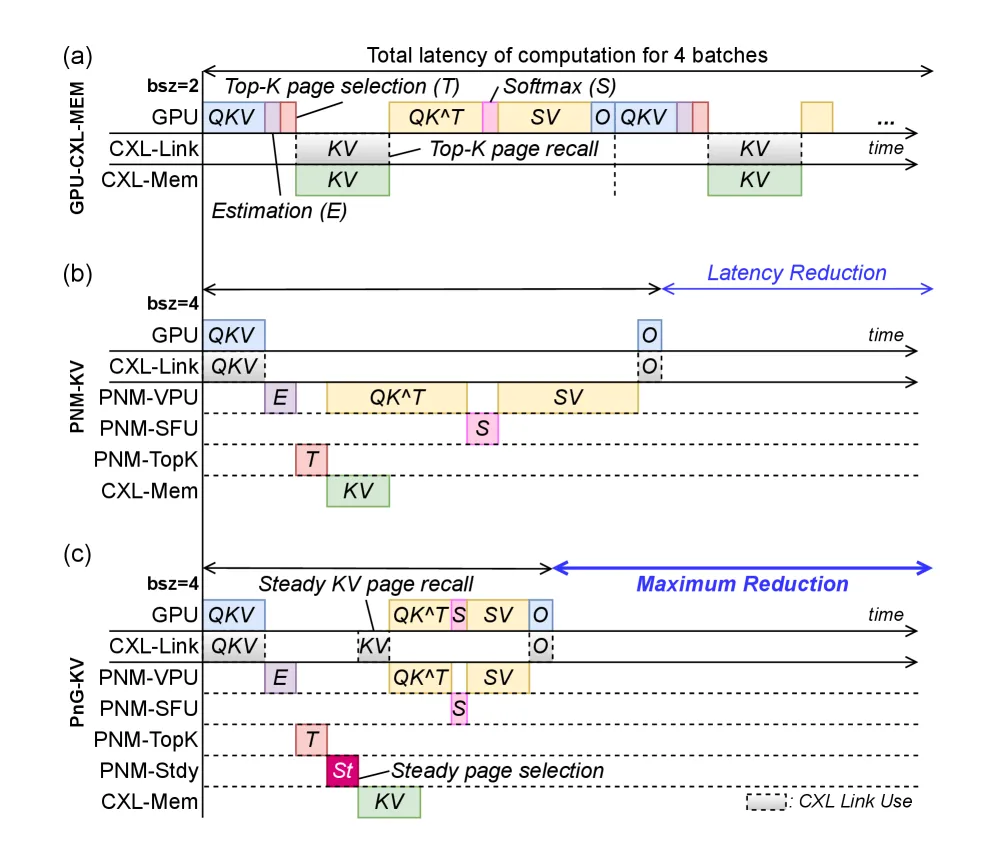
| 方案 | GPU 职责 | PNM 职责 | 优势 |
|---|---|---|---|
| GPU-CXL-Mem (Baseline) | FC + 注意力 + KV 管理 | 仅存储 | batch size 受限 |
| PNM-KV | 仅 FC | KV 管理 + 注意力 | 消除召回开销,更大 batch size |
| PnG-KV | FC + 部分注意力 | KV 管理 + 部分注意力 | 负载均衡,最优吞吐量 |
并行策略
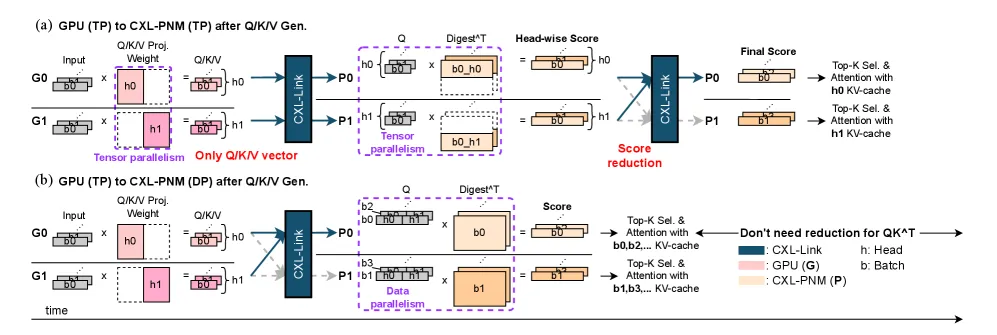
关键洞察:GPU 使用 TP(Tensor Parallelism),PNM 使用 DP(Data Parallelism)
- TP→TP 需要 N 次 Top-K 排序和 (N-1) 次归约消息
- TP→DP 使用 scatter-gather,相同数据量但无归约,更适合 CXL 基础设施
稳态 Token 选择
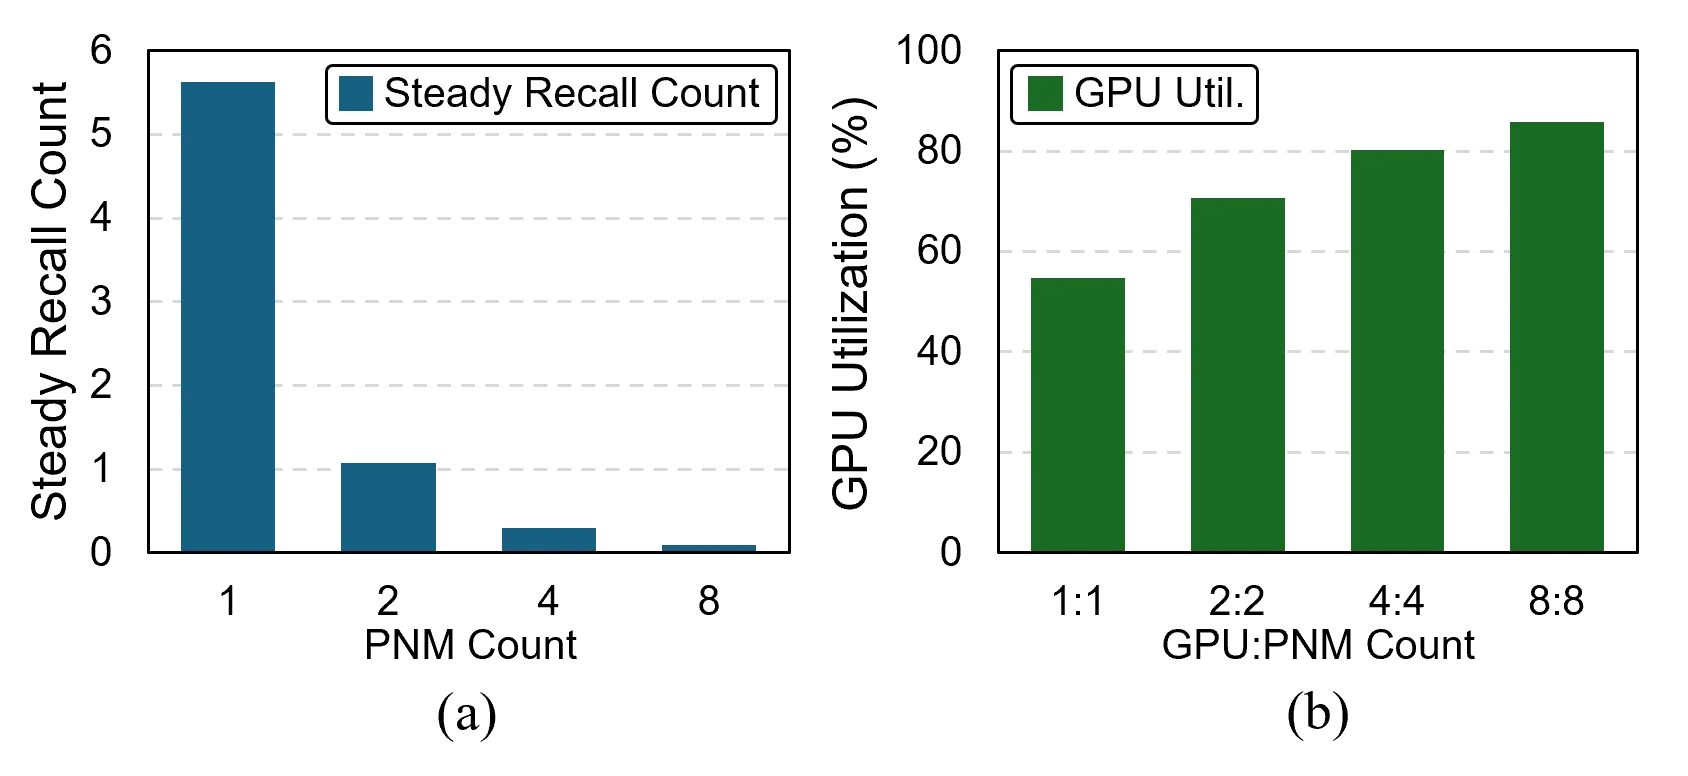
PnG-KV 的核心机制是 Steady Selection,将 token 分为:
- 稳态 token:在 GPU 上驻留和计算,减少数据传输
- 动态 token:在 PNM 上计算,利用大容量内存
当 PNM 设备数量增加时,召回次数急剧下降,GPU 利用率逐步提升。
硬件平台参数
| 参数 | 值 |
|---|---|
| 工艺/频率/电压 | 7nm / 1.0 GHz / 1.0V |
| 加法树乘法器/加法器 | 4,096 / 4,064(峰值 8 TFLOPS) |
| 比较器数量 | 8,160 |
| 片上缓冲 | 2.25 MB |
| DMA 缓冲 | 1 MB |
| DRAM/SRAM I/O 宽度 | 1,024 / 16,384 |
| CXL-PNM 控制器功耗 | ~90 W |
| DRAM 功耗 | ~40 W |
| CXL-PNM 平台总功耗 | ~150 W |
四、核心创新
| 创新点 | 说明 | 理论/实验依据 |
|---|---|---|
| CXL-PNM 架构 | 首个基于 CXL 的近内存 LLM 推理加速器,将注意力计算卸载到内存端 | 消除 GPU-PNM 间数据召回开销 |
| 上下文长度无关通信 | GPU-PNM 数据传输仅取决于 batch size 和隐藏维度,与上下文长度无关 | 支持百万 token 扩展 |
| TP→DP 并行映射 | GPU 使用 TP,PNM 使用 DP,避免 CXL 基础设施中的跨设备归约 | 消除 device-to-device 通信开销 |
| Steady Selection | 稳态 token 选择机制,平衡 GPU 和 PNM 的注意力计算 | 实现负载均衡的混合执行 |
| 可重构 VPU | 单一硬件单元支持 GEMV、Digest 生成、Score 估计三种模式 | 最小化面积和能耗开销 |
五、代码实现分析
本文无公开代码。论文描述了完整的软件栈实现:
CXL-PNM 软件栈:
- 设备驱动:扩展 Linux DAX 框架,注册 CXL 内存(CXL.mem)和加速器控制寄存器(CXL.io)
- Python 运行时:透明卸载,无需修改源代码,管理 CXL 空间内存分配、模型参数加载、控制寄存器配置和指令执行
- 中断处理:通过 MSI-X 接口管理加速器中断
六、实验结果
基准测试
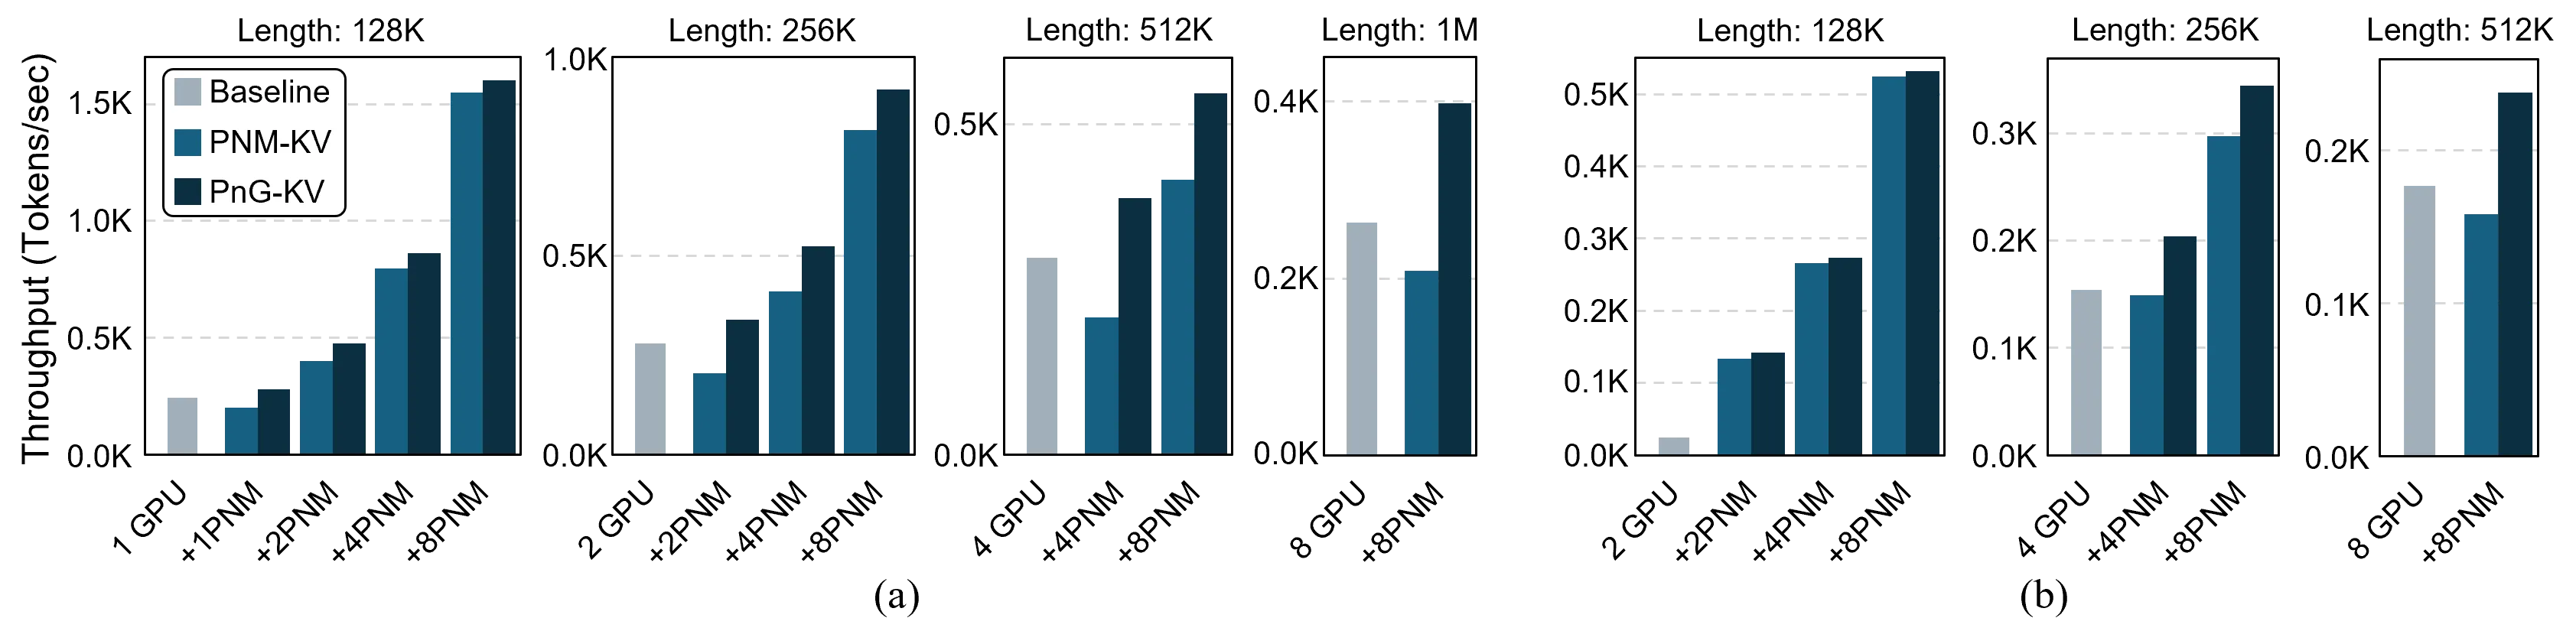
Server 级评估(Llama3.1-8B, 128K-1M tokens):
- PNM-KV 相比 baseline:最高 21.9x 吞吐量提升
- PnG-KV 相比 PNM-KV:平均 28.3% 吞吐量提升
- PnG-KV 相比 baseline:2.7x 吞吐量提升
Server 级评估(Llama3.1-70B, 128K-512K tokens):
- 2GPU+8PNM PnG-KV:最高 60x 更低能耗/每 token
能耗分析
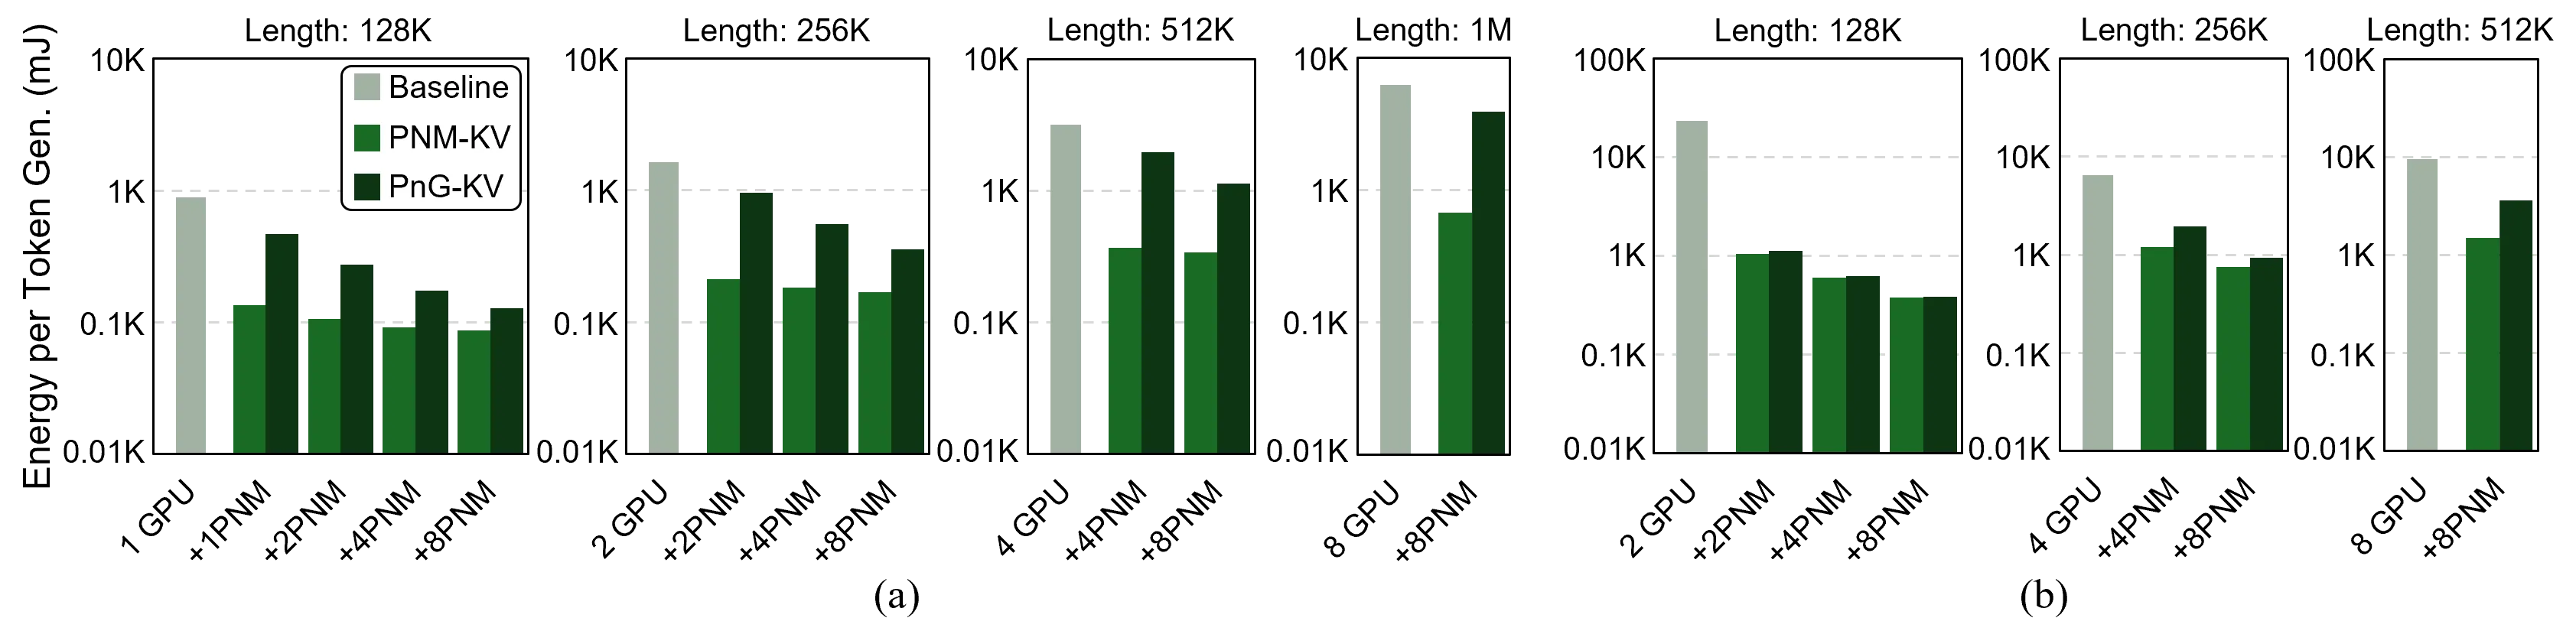
PnG-KV 虽然能耗高于 PNM-KV(约 2.2x),但仍远优于 baseline(2.7x 更高吞吐量,4.9x 更低能耗)。
Rack-Scale 评估
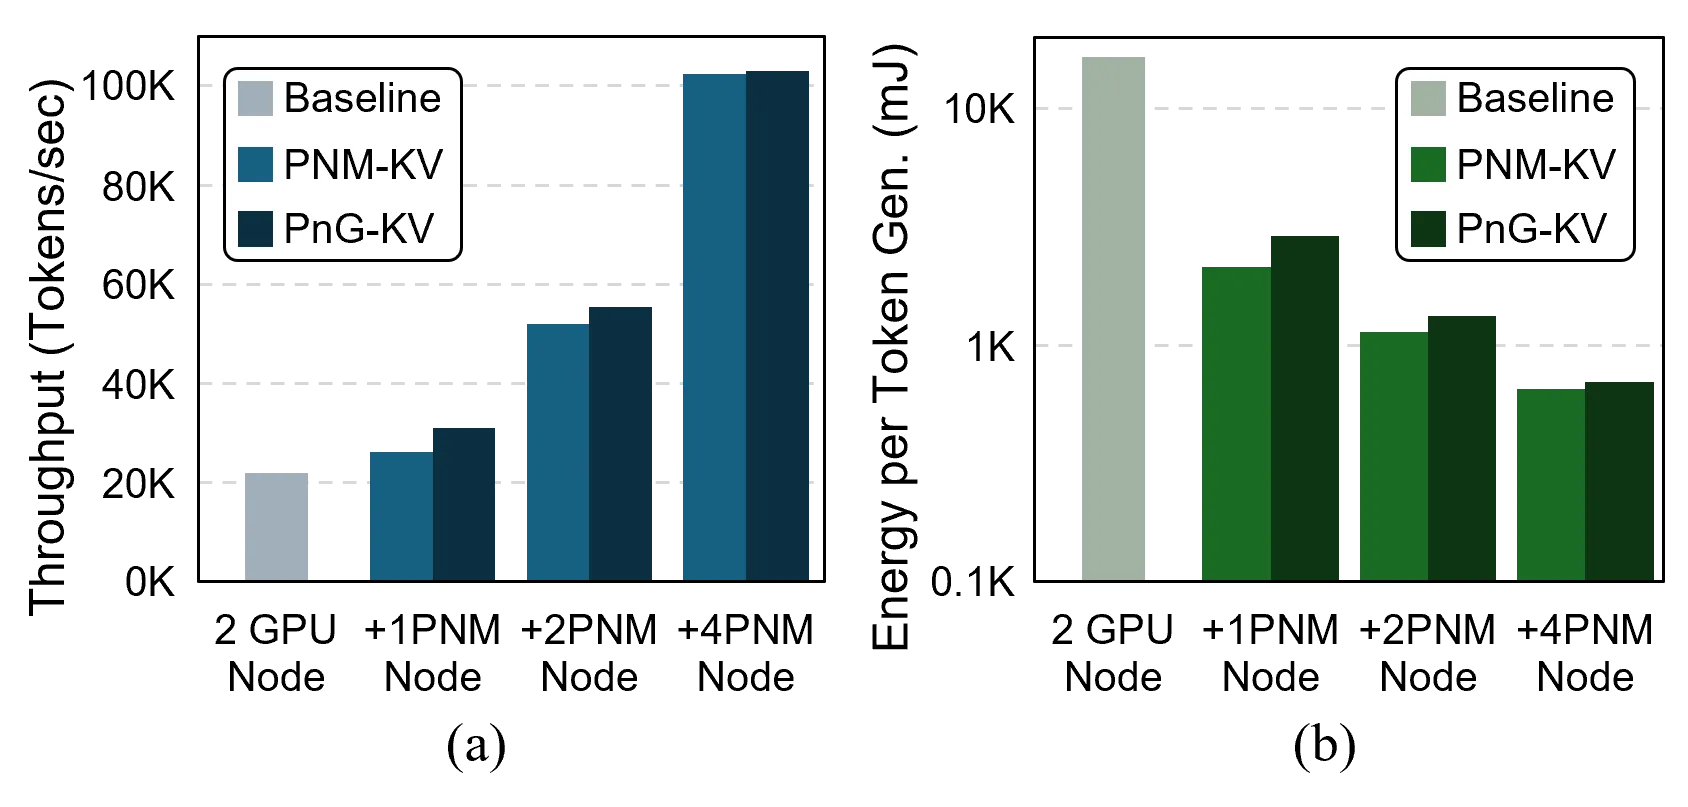
Llama3.1-405B, 1M tokens, 2xGPU node:
- 添加 PNM 节点扩展容量,保持更多 KV 驻留
- PNM-KV 和 PnG-KV 均优于 baseline
- PnG-KV:2.6x 更高吞吐量,11.8x 更低能耗
延迟分解
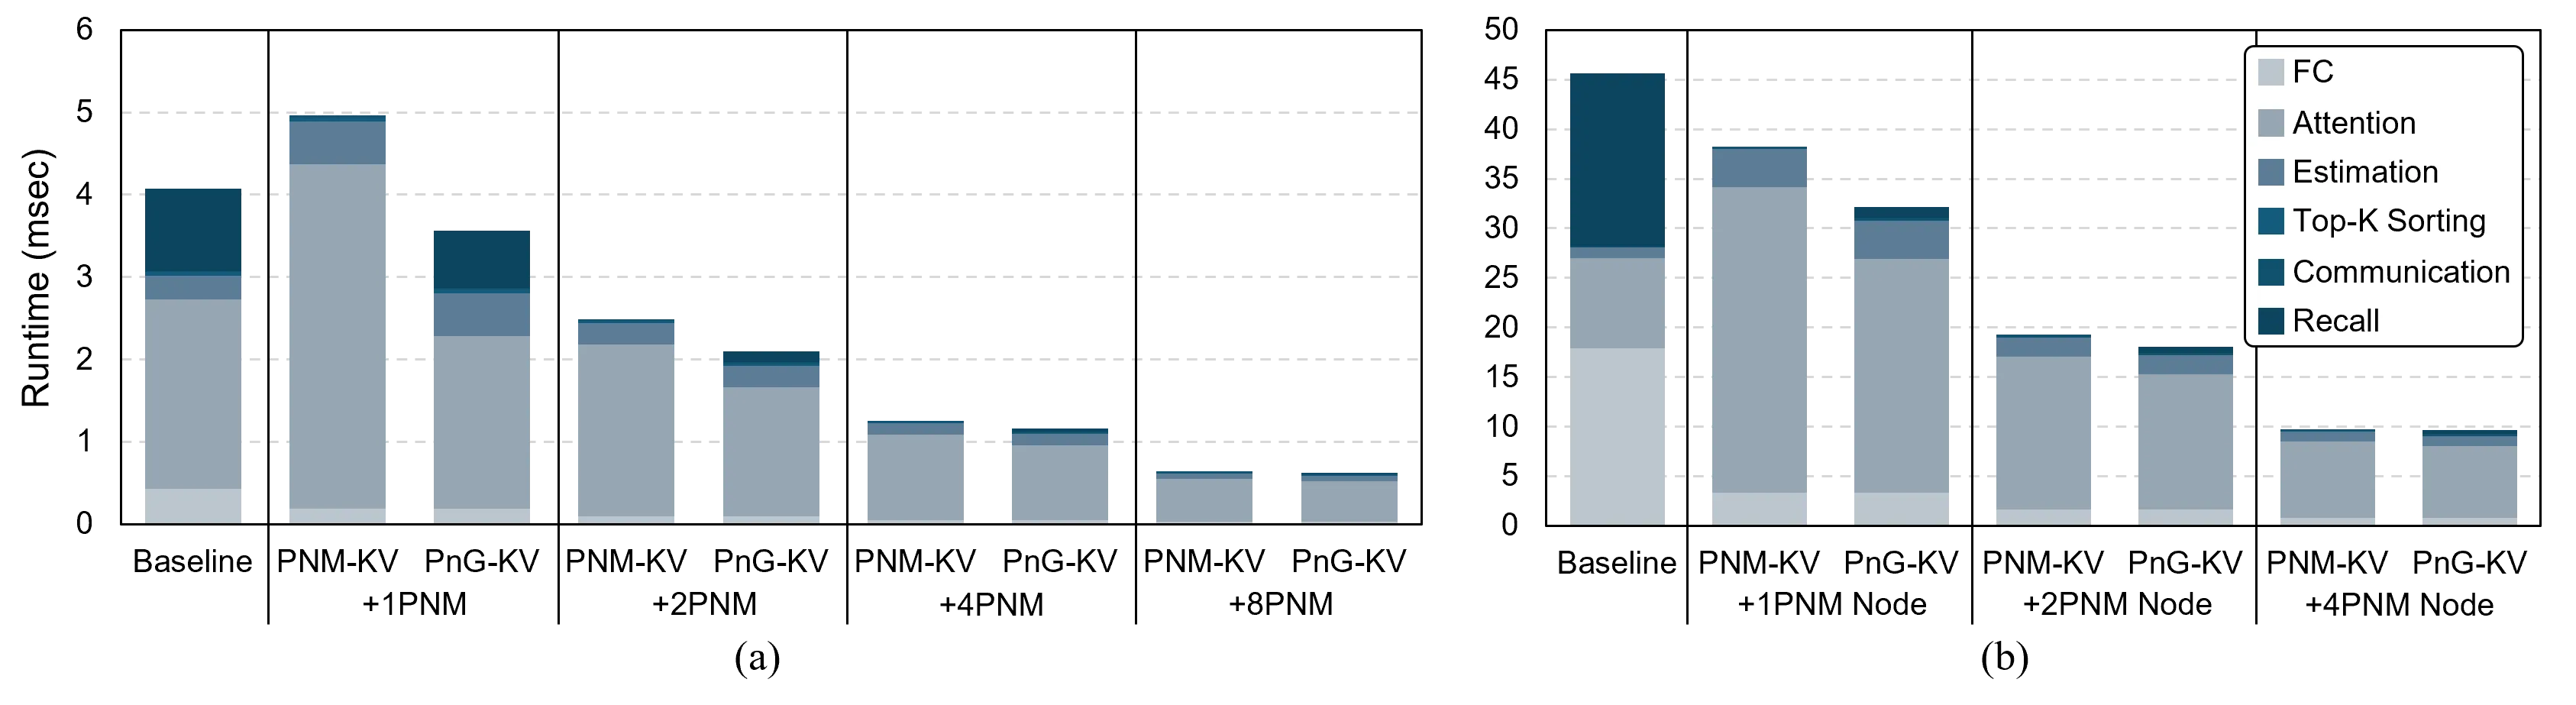
- Baseline:注意力计算和 KV 缓存召回主导延迟
- PNM-KV:完全消除召回开销
- PnG-KV:引入部分召回但减少端到端延迟
- Hidden-state 通信和 Top-K 排序延迟可忽略
TCO(总拥有成本)
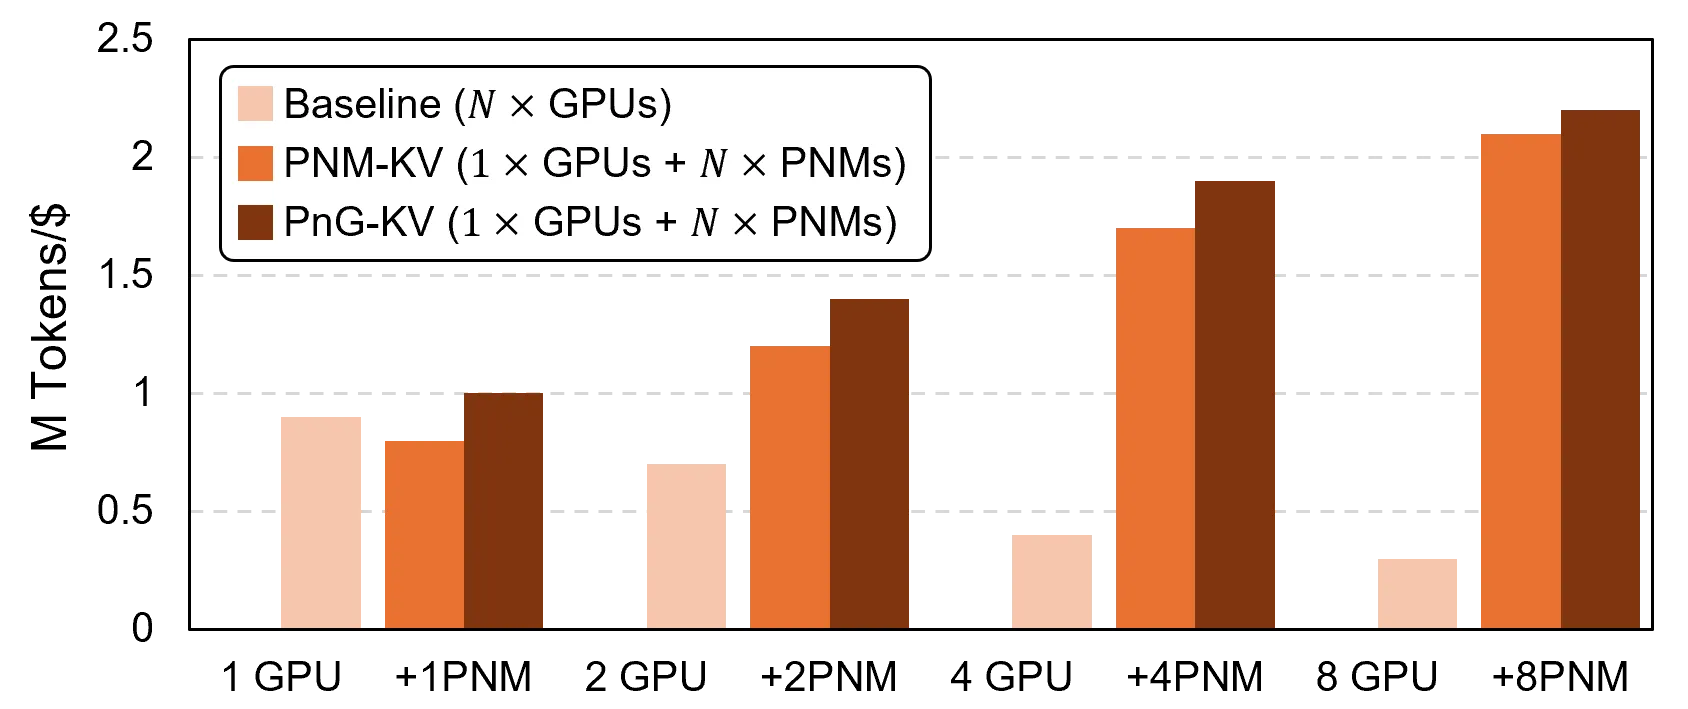
| 硬件 | A100 GPU | CXL-PNM |
|---|---|---|
| 单设备最大功耗 | ~400 W | ~150 W |
| 单设备运营成本 | $0.072/小时 | $0.027/小时 |
| 单设备硬件成本 | $0.761/小时 | $0.266/小时 |
关键发现:
- GPU 扩展受限于内存容量限制,吞吐量饱和后 TCO 效率下降(降至单 GPU 的 0.4x)
- PNM 扩展单调递增提升 TCO 效率
- 1GPU+8PNM PnG-KV:7.3x 更高 TCO 效率(相比 8-GPU baseline)
与现有方法对比
| 方法 | 类型 | 上下文长度 | GPU 利用率 | 数据召回 |
|---|---|---|---|---|
| StreamingLLM | 驱逐式 | 有限 | 高 | 无 |
| ArkVale | 非驱逐式 | 长 | 低 | 高开销 |
| GPU-CXL-Mem | 内存扩展 | 长 | 低 | 高开销 |
| PNM-KV | 近内存处理 | 百万级 | 高 | 无 |
| PnG-KV | 混合执行 | 百万级 | 最高 | 最小 |
七、相关工作
KV 缓存管理
- 驱逐式方法:StreamingLLM(滑动窗口)、H2O(分层缓存)、InfiniPot(固定大小缓存蒸馏)
- 非驱逐式方法:ArkVale、InfLLM、Quest、SqueezedAttention(动态选择相关 token)
- 系统级研究:ALISA(稀疏感知注意力)、InfiniGen(推测预取)、NEO(异步 GPU-CPU 流水线)
CXL 内存系统
- CXL 在内存池化、分层内存管理和生产部署中展示有效性
- Tang 等人证明 CXL 卸载可减少 GPU 内存使用达 87%
- Gouk 等人实现 sub-100ns 访问延迟的 CXL 内存控制器
八、总结
核心贡献
- 提出首个基于 CXL 的近内存处理(PNM)架构,用于百万 token 级 LLM 推理
- 设计上下文长度无关的 GPU-PNM 通信机制,支持百万 token 扩展
- 提出 TP→DP 并行映射策略,避免 CXL 基础设施中的跨设备归约
- 引入 Steady Selection 混合执行模型,平衡 GPU 和 PNM 的注意力计算
- 在 7nm ASIC 上实现 CXL-PNM 平台,峰值 8 TFLOPS,功耗 150W
技术影响
- CXL-PNM 作为可扩展骨干,支撑未来长上下文 LLM 推理工作负载
- PNM 设备成本仅为 GPU 的 1/3,能耗仅为 37.5%
- 为百万 token 级推理提供经济高效的解决方案
局限性
- 需要专用 CXL-PNM 硬件支持,部署门槛较高
- 评估基于循环级模拟器,尚未进行真实硬件部署验证
- PnG-KV 的能耗高于 PNM-KV,需要根据场景权衡吞吐量和能耗
九、参考资源
- 论文:arXiv:2511.00321
- 相关工作:
- ArkVale (Chen et al., 2024a) - 非驱逐式 KV 缓存管理
- StreamingLLM (Xiao et al., 2023) - 滑动窗口驱逐
- InfiniGen (Lee et al., 2024) - 推测预取
- NEO (Jiang et al., 2024) - 异步 GPU-CPU 流水线