ExpertFlow: Adaptive Expert Scheduling and Memory Coordination for Efficient MoE Inference
自适应专家调度与内存协调的MoE推理运行时系统,通过动态步长预测和缓存感知路由消除99.9%等待延迟。
ExpertFlow: Adaptive Expert Scheduling and Memory Coordination for Efficient MoE Inference
一、论文概述
| 项目 | 内容 |
|---|---|
| 标题 | ExpertFlow: Adaptive Expert Scheduling and Memory Coordination for Efficient MoE Inference |
| 作者 | Zixu Shen, Kexin Chu, Yifan Zhang, Dawei Xiang, Runxin Wu, Wei Zhang |
| 机构 | - |
| 论文 | arXiv:2510.26730 |
| 代码 | 未开源 |
| 发布 | 2025年10月 |
| 领域 | Distributed, Parallel, and Cluster Computing (cs.DC); AI; Performance |
二、核心思想
问题定义
大语言模型的扩展日益受到GPU有限内存容量的限制。MoE架构通过仅激活部分参数来降低内存和计算开销,但现有MoE推理方法存在两个关键瓶颈:
- 层间独立选择:传统方法在每一层独立选择活跃专家,导致频繁的Host-GPU参数传输,引入显著延迟
- 固定步长预测:现有跨层预测策略采用固定步长,缺乏对不同硬件平台和工作负载的适应性
- 缓存未命中:专家参数在GPU内存中的驻留不一致,导致频繁的swap-in/swap-out操作
解决方案概述
本文提出ExpertFlow,一个MoE推理运行时系统,结合三个核心技术:
- 自适应专家预门控(Adaptive Expert Pre-gating):动态确定跨层预测步长S,基于运行时统计(传输带宽、参数维度、模型反馈信号)实时调整
- 专家内存管理(Expert Memory Management):两级LRU缓存架构(LRU_high + LRU_low),配合动态重分配和预取协调
- 缓存感知路由(Cache-aware Routing):将缓存未命中处理与活跃推理任务重叠,优先调度专家已驻留的token
核心结果:
- 等待延迟降低至基线的0.1%以下(Qwen1.5延迟降低99.9%+)
- 专家预测准确率提升平均21.79%(最高30.36%)
- 缓存感知路由降低延迟96.65%(DeepSeek/Qwen1.5)
三、技术架构
整体框架
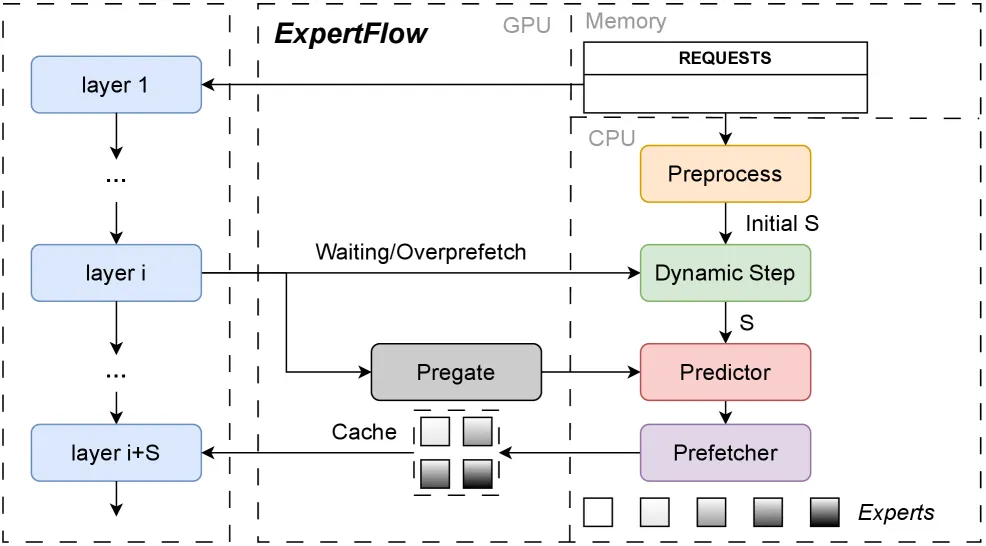
Figure 5: ExpertFlow系统架构。
核心组件:
| 组件 | 功能 | 关键技术 |
|---|---|---|
| 自适应预门控 | 动态确定步长S | 运行时反馈循环 |
| 跨层预测器 | 预测未来层专家激活 | Random Forest + token语义 |
| 两级LRU缓存 | 管理GPU内存中的专家 | LRU_high + LRU_low |
| 缓存感知路由 | 重叠缓存未命中与计算 | 优先调度驻留专家 |
自适应专家预门控
动态步长计算
步长S表示跳过的层数,基于通信开销和计算的权衡:
其中:
- :预期激活的专家数量
- :专家大小
- :通信带宽
- :每层计算时间
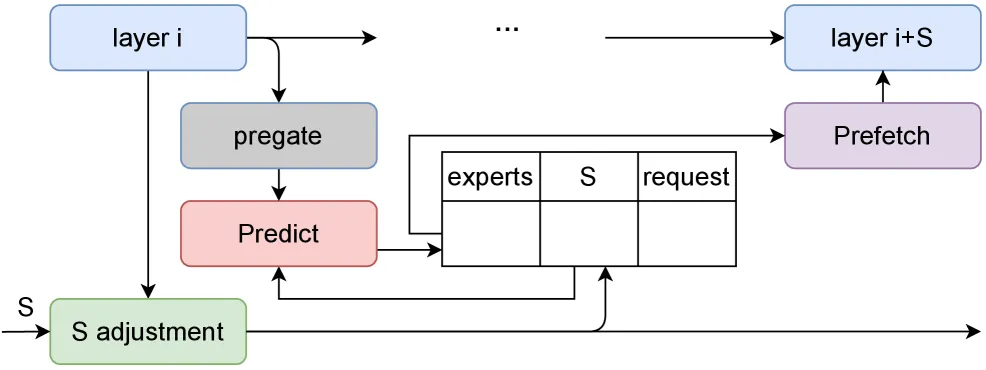
Figure 6: 动态步长S的确定机制。
反馈循环调整
ExpertFlow通过轻量级反馈循环实时调整步长S:
- 等待计数器:当预测专家不可用(导致等待延迟)时递增,超过阈值后S增加1
- 过度获取计数器:当专家在需要时已加载时递增,超过阈值后S减少1
跨层预测器
预测器结合三个输入信号:
其中:
- :token嵌入(通过随机嵌入表+均值池化)
- :当前步长
- :当前层索引
- :前序层专家激活状态的二值向量
训练:使用RandomForestRegressor(scikit-learn),在CPU上运行以避免GPU干扰。目标是最小化MSE:
专家内存管理
两级LRU缓存
| 缓存层级 | 存储内容 | 驱逐策略 |
|---|---|---|
| LRU_high | 高复用潜力专家(近期访问或预测即将激活) | 最后驱逐 |
| LRU_low | 低复用潜力专家(未近期访问) | 优先驱逐到DRAM |
设计动机:标准LRU策略会过早驱逐初始层的专家——尽管这些专家在解码阶段经常被复用。
预取与缓存协调
- 计算跳步距离S前,查询当前缓存占用以估算有效带宽和驱逐成本
- 预取后,观察到的传输时间更新带宽估计
- 预取适应的反馈计数器纳入缓存命中/未命中统计
缓存感知路由
当缓存未命中触发专家swap-in时,传输与活跃推理任务并行执行。缓存感知路由策略给予专家已驻留内存的token调度优先级,延迟需要额外I/O的token。
- 缓存未命中解决在内存队列中具有最高优先级
- 减少暴露延迟,提高整体吞吐量
四、核心创新
| 创新点 | 说明 | 实验依据 |
|---|---|---|
| 动态步长S | 基于运行时统计自适应调整跨层预测距离 | 平均延迟降低98.5% |
| 跨层预测器 | Random Forest + token语义 + 激活历史 | 准确率提升21.79% |
| 两级LRU缓存 | 区分高/低复用潜力专家 | 减少缓存未命中 |
| 缓存感知路由 | 重叠缓存未命中处理与计算 | 延迟降低96.65% |
| CPU预测器 | RandomForest在CPU运行,避免GPU干扰 | 零GPU开销 |
五、实验结果
实验配置
测试平台:
- NVIDIA A6000(64 GB/s带宽)
- NVIDIA H20(128 GB/s带宽)
- Ascend 910B(128 GB/s带宽)
模型:DeepSeek-V2-Lite, Qwen1.5, Qwen2.0(4-bit量化)
内存限制:GPU内存限制在20GB以模拟资源受限场景
基线:Transformers + ProMoE + Yandex pre-gate
整体延迟降低
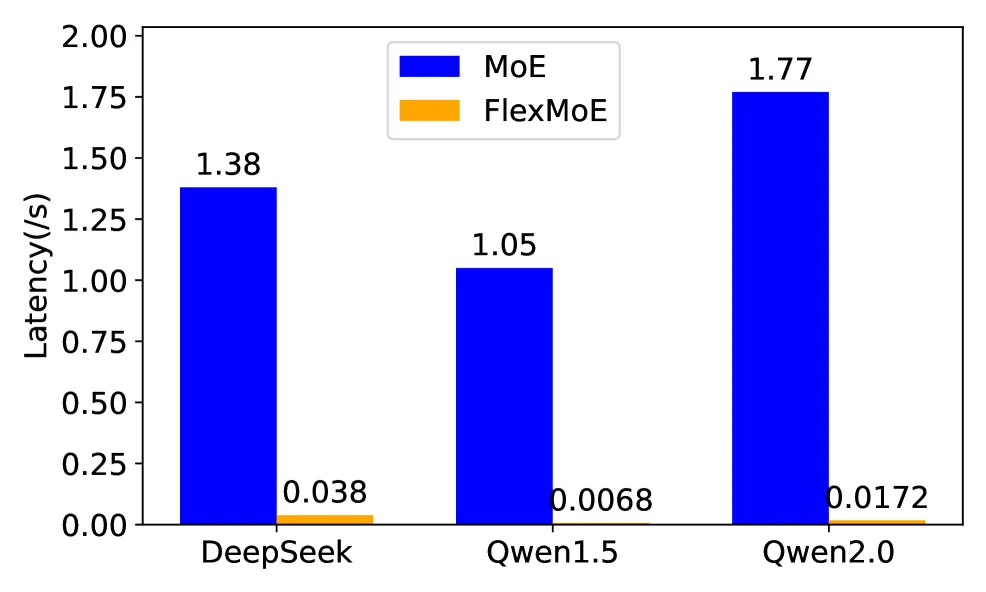
Figure 7(a): A6000上的整体等待延迟。
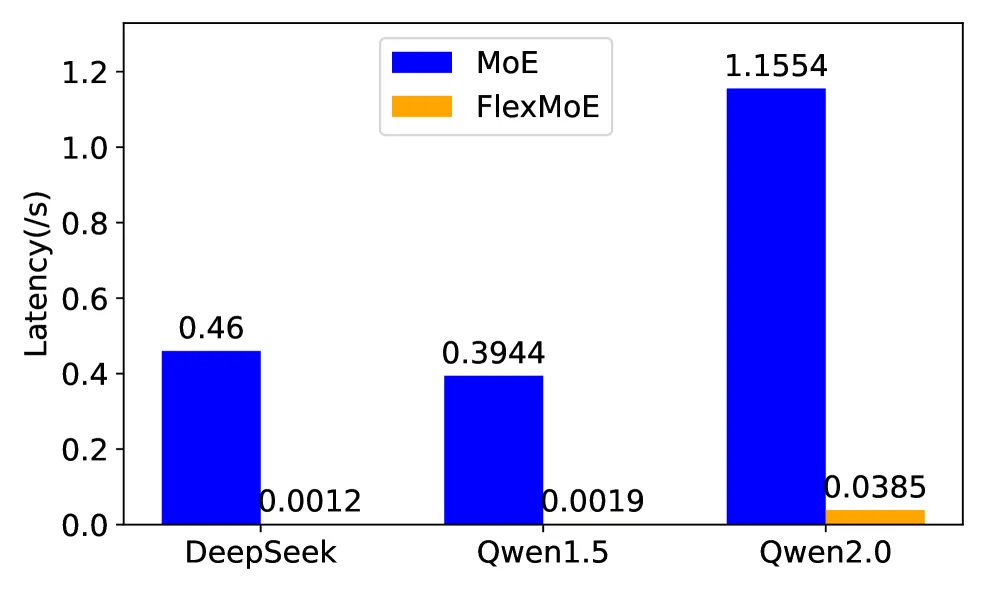
Figure 7(b): H20上的整体等待延迟。
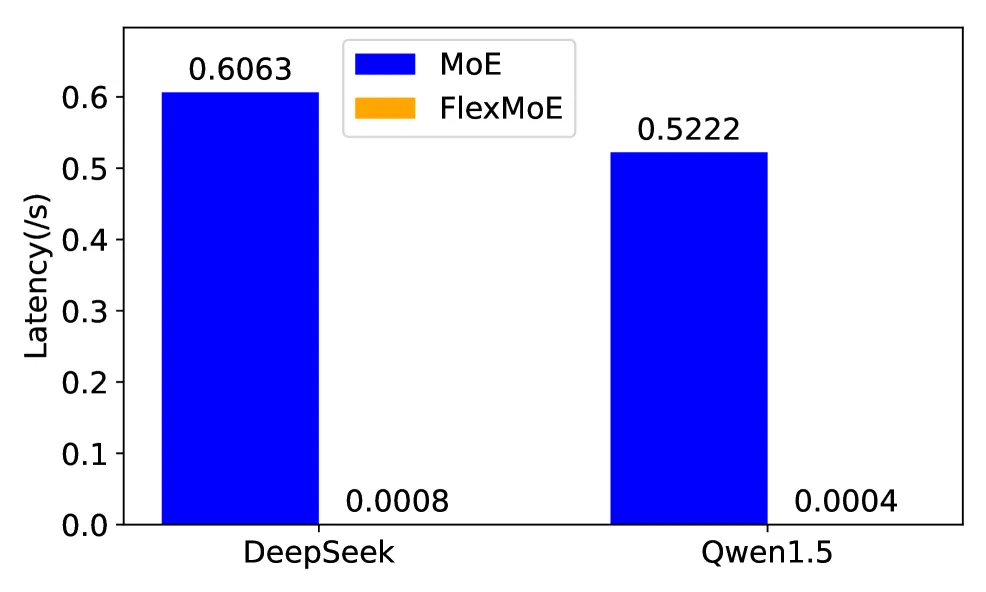
Figure 7(c): Ascend 910B上的整体等待延迟。
延迟对比(秒):
| 模型 | A6000 基线 | A6000 ExpertFlow | H20 基线 | H20 ExpertFlow |
|---|---|---|---|---|
| DeepSeek | 1.38 | 0.0328 | 0.46 | 0.0029 |
| Qwen1.5 | 1.05 | 0.0216 | 0.39 | 0.0022 |
| Qwen2 | 1.77 | 0.1034 | 1.16 | 0.0978 |
预测器准确率
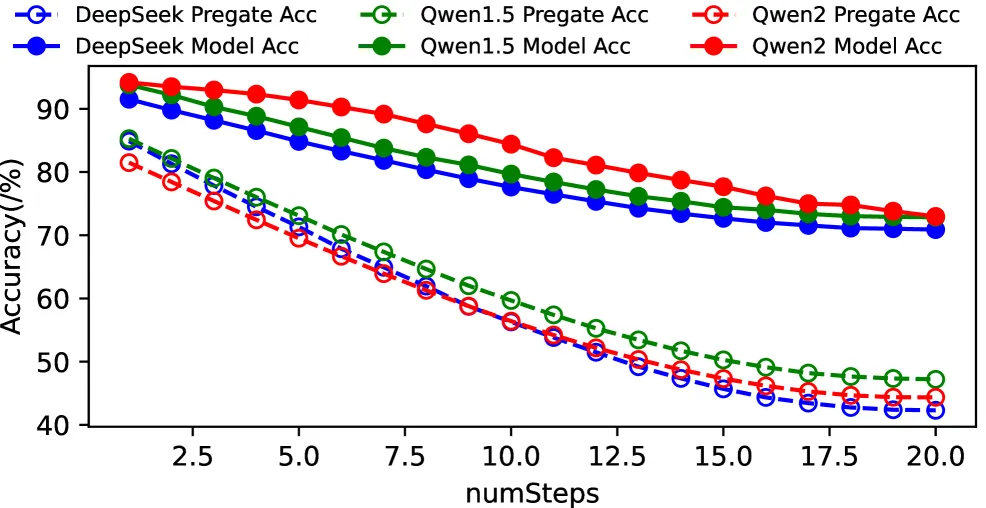
Figure 8: 预门控与ExpertFlow预测器的准确率对比。
准确率对比:
| 模型 | 预测器 | 预门控 | 差值 |
|---|---|---|---|
| DeepSeek | 63.44% | 26.43% | +37.01% |
| Qwen1.5 | 65.31% | 33.29% | +32.02% |
| Qwen2 | 60.45% | 29.61% | +30.84% |
准确率衰减建模:使用指数衰减函数拟合:
内存管理效果
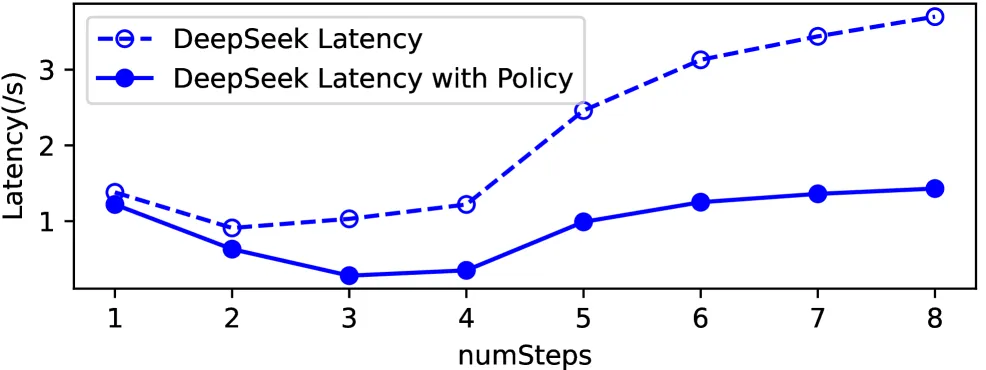
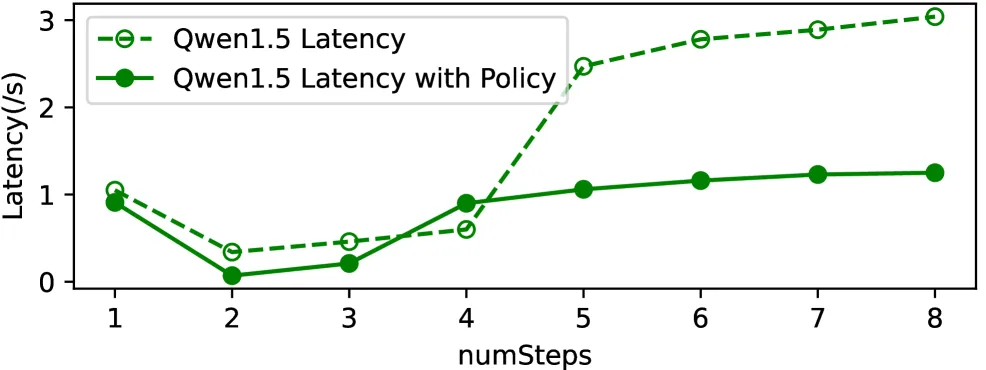
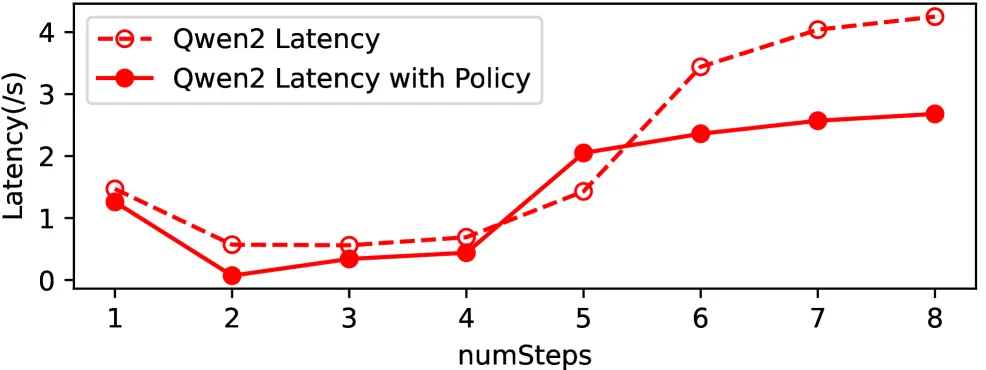
Figure 10: 新内存管理策略下的延迟。
关键观察:在S≈4处出现延迟”跳跃”,原因是GPU内存有限,小步长增加专家预测导致频繁swap-in,最终超出内存容量触发驱逐。
缓存感知路由效果
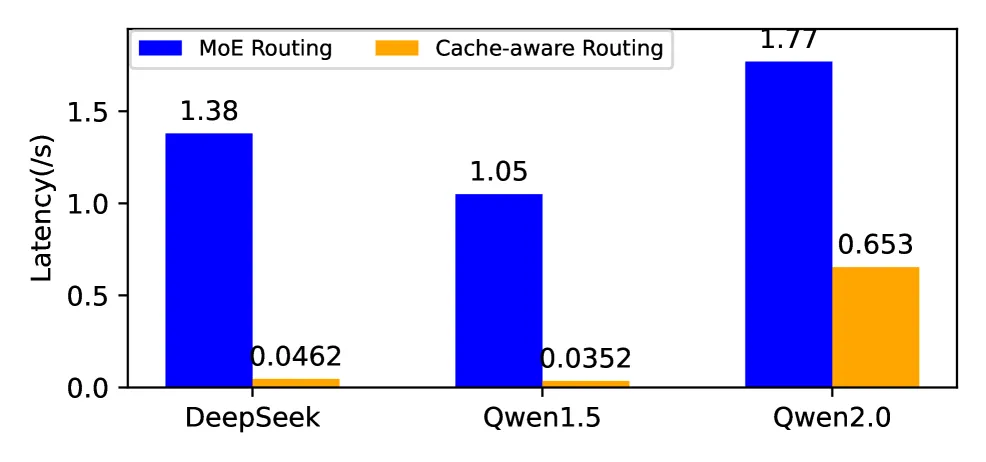
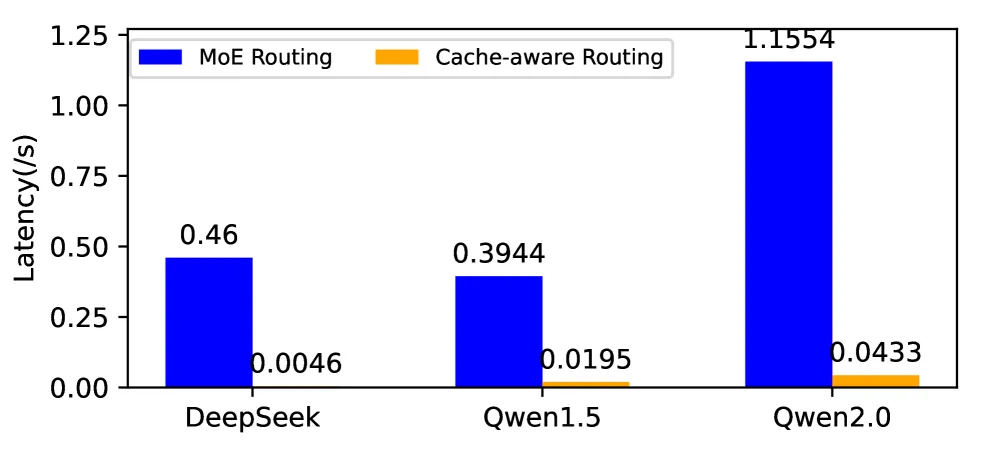
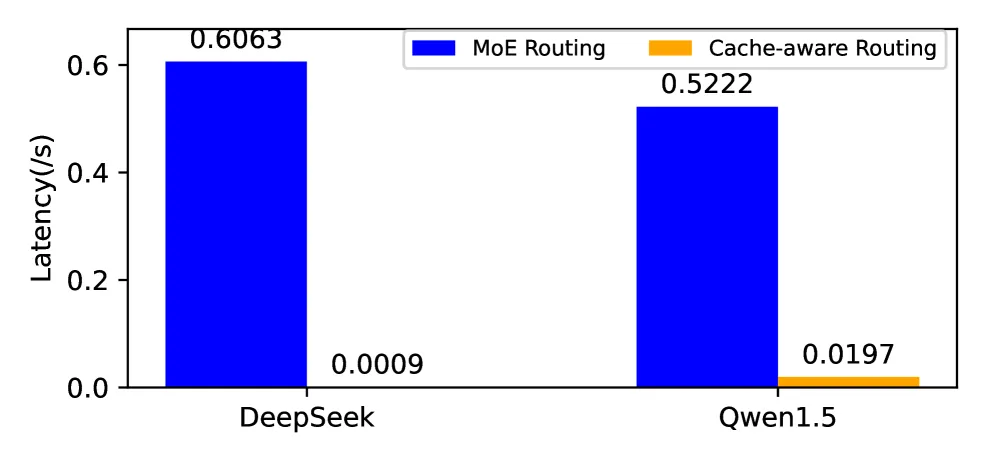
Figure 11: 有无缓存感知路由的延迟对比。
延迟降低:
- DeepSeek/Qwen1.5:延迟降低96.65%+
- Qwen2.0:延迟降低55.58%(已有共享专家设计,改善较小但仍有显著收益)
六、相关工作
可稀疏激活与推理优化
| 方法 | 特点 | 与本文关系 |
|---|---|---|
| ProMoE | 预测性MoE推理 | 基线对比,ExpertFlow准确率更高 |
| Yandex pre-gate | 预门控预测 | 基线对比,ExpertFlow准确率+21.79% |
路由与负载均衡
| 方法 | 特点 | 与本文关系 |
|---|---|---|
| 固定步长跨层预测 | 静态预测距离 | ExpertFlow动态自适应 |
| 标准LRU缓存 | 单级驱逐队列 | ExpertFlow两级LRU |
七、总结
核心贡献
-
ExpertFlow框架:自适应跨层预测的MoE推理动态预取框架
-
动态步长机制:基于运行时统计(带宽、参数维度、反馈信号)实时调整预测距离
-
跨层预测器:Random Forest模型结合token语义和激活历史,准确率提升30%+
-
两级LRU缓存:区分高/低复用潜力专家,减少不必要的驱逐
-
缓存感知路由:重叠缓存未命中处理与计算,延迟降低96%+
技术影响
- 内存受限推理:在20GB GPU内存限制下实现高效MoE推理
- 跨平台适应:在A6000、H20、Ascend 910B上均有效
- 运行时优化:纯运行时方案,无需修改模型结构
局限性
- 代码未开源:无法复现
- 预测器训练:需要收集激活元数据进行离线训练
- Ascend 910B限制:不支持INT4量化,Qwen2.0无法在该平台测试
- H20异常:H20延迟高于A6000,推测是内存带宽未与算力成比例扩展